
엑셀 대소문자 오류 진단: UPPER·LOWER·PROPER와 EXACT 비교
엑셀 대소문자 오류를 진단할 때는 글자 모양을 바꾸는 일과 일치 여부를 판단하는 일을 구분해야 합니다. UPPER, LOWER, PROPER는 변환 함수이고, EXACT는 대소문자를 구분해 비교하는 함수입니다. Samsung과 samsung을 못 찾는다는 이유만으로 모든 셀을 대문자로 덮어쓰면, 실제 원인인 공백을 놓치거나 구별해야 할 식별자를 합칠 수 있습니다.
이 글은 변환 여섯 사례, 비교 여섯 검사, 정제 열두 사례를 같은 다운로드 파일에 연결합니다. 먼저 대소문자만 다른 입력에서 비교 결과를 확인하고, 다음으로 승인한 표시명 규칙만 적용한 뒤 고유 키 중복을 보류합니다. 제시한 결과는 수식에 따른 기대값이며 데스크톱 Excel에서 실행을 마쳤다는 증빙은 아닙니다.
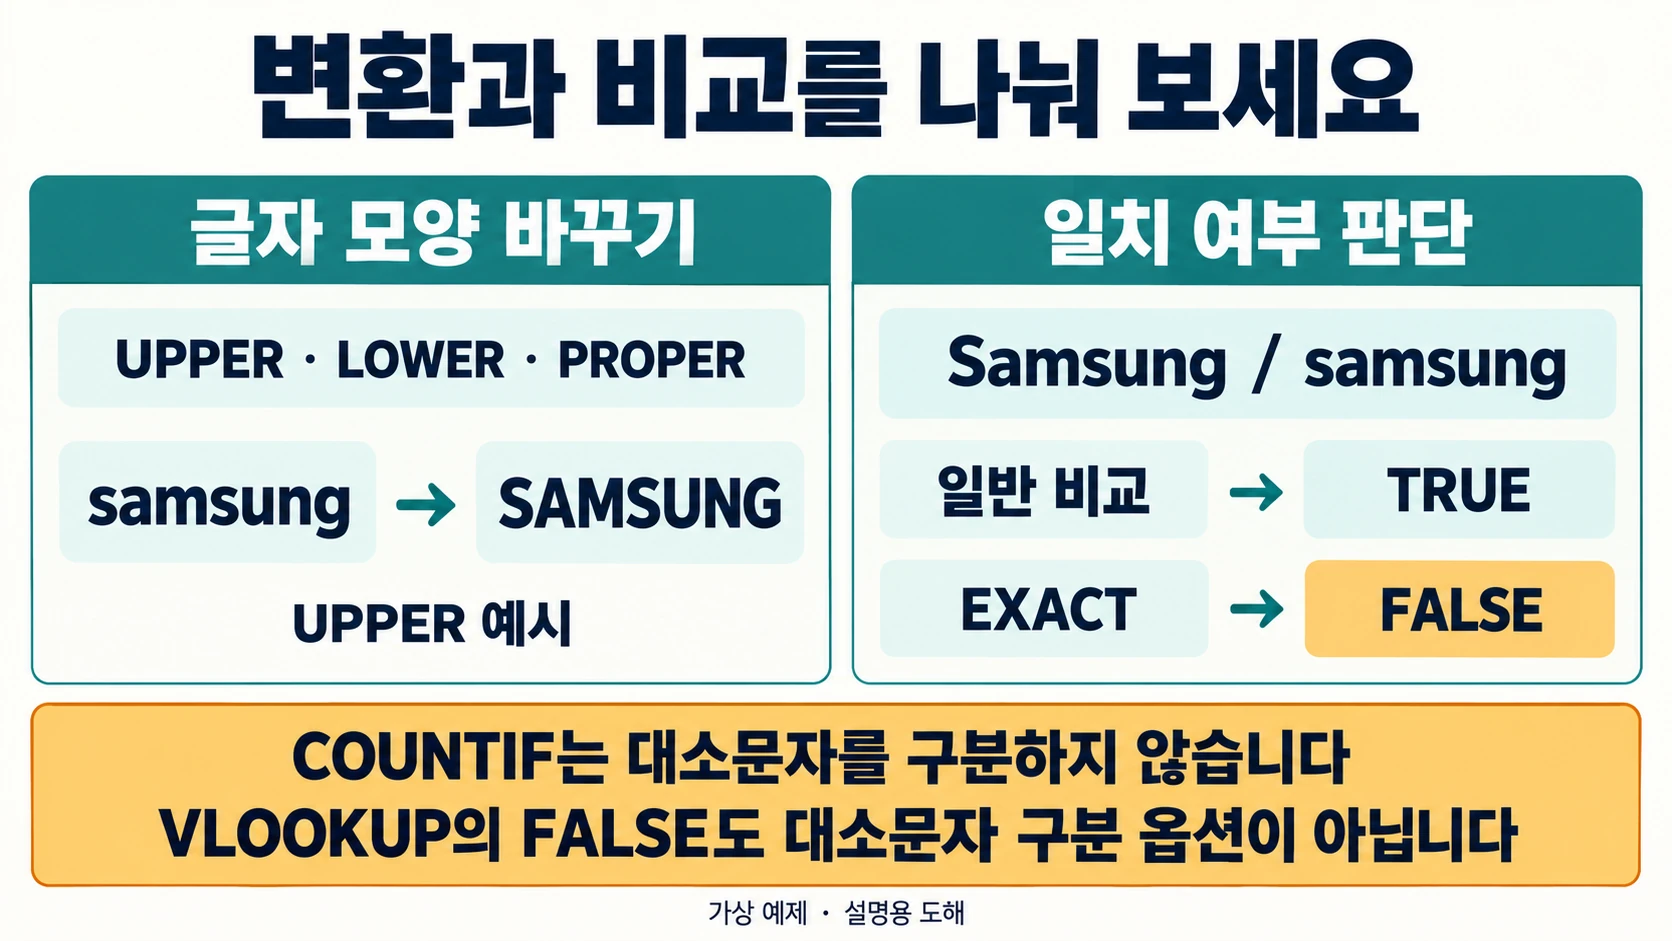
본문의 절차를 설명하는 이미지입니다. 실제 Excel 실행 결과 화면이 아닙니다.
먼저 고칠 오해: COUNTIF의 조건은 대소문자를 구분하지 않는다
COUNTIF는 텍스트의 대문자와 소문자를 구분하지 않습니다. 조건을 SAMSUNG으로 바꿨다는 이유만으로 Samsung과 samsung이 서로 다른 항목이 되지 않습니다. 공백·따옴표 차이·인쇄되지 않는 문자가 결과에 영향을 줄 수 있으므로, 대소문자 외의 차이도 확인합니다. Microsoft COUNTIF 설명
VLOOKUP의 FALSE는 정확 일치를 찾는 옵션이지 대소문자 구분 옵션이 아닙니다. Microsoft의 VLookup 문서는 대문자와 소문자 텍스트를 동등하게 취급하며, 정확 일치 후보가 여러 개면 첫 번째 값을 사용한다고 설명합니다. Microsoft VLookup 문서
반대로 EXACT는 대소문자를 구분합니다. 두 텍스트가 같으면 TRUE, 다르면 FALSE를 반환하되 글꼴 같은 서식 차이는 비교하지 않습니다. Microsoft EXACT 설명
따라서 대소문자를 구분해야 하는 ID를 먼저 UPPER로 바꾸고 EXACT로 비교하면 목적과 반대입니다. 구별에 필요한 원본 정보를 이미 없앤 뒤 비교하기 때문입니다.
준비: 원본과 표시명 후보를 별도 열에 두기
실습은 실제 고객 데이터가 아닌 제공 예제에서 시작합니다. 파일에는 매크로나 외부 시스템으로 값을 보내는 기능이 없습니다.
-
다운로드한 파일의
README에서 시트별 입력·기대값 위치를 확인합니다. -
원본 열을 그대로 두고 변환 결과와 검산을 옆 열에서 계산합니다.
-
변환 대상이 사람이 읽는 표시명인지, 대소문자가 의미 있는 식별자인지 먼저 분류합니다.
-
공백 축약과 줄바꿈 대체가 허용되는 자료에만 실습 규칙을 적용합니다.
-
기대값·중복·보류 사유를 대조한 뒤 별도 업무 승인 절차를 거칩니다.
이 파일에서 사용후보는 예제 범위의 검사 조건을 충족했다는 뜻입니다. 원본 시스템에 반영해도 된다는 자동 승인이 아닙니다. 수식을 값으로 붙여넣는 작업도 검산 이후 별도 사본에서만 하고, 원본과 수식이 있는 사본을 보관합니다.
1. UPPER·LOWER·PROPER의 변환 결과 비교
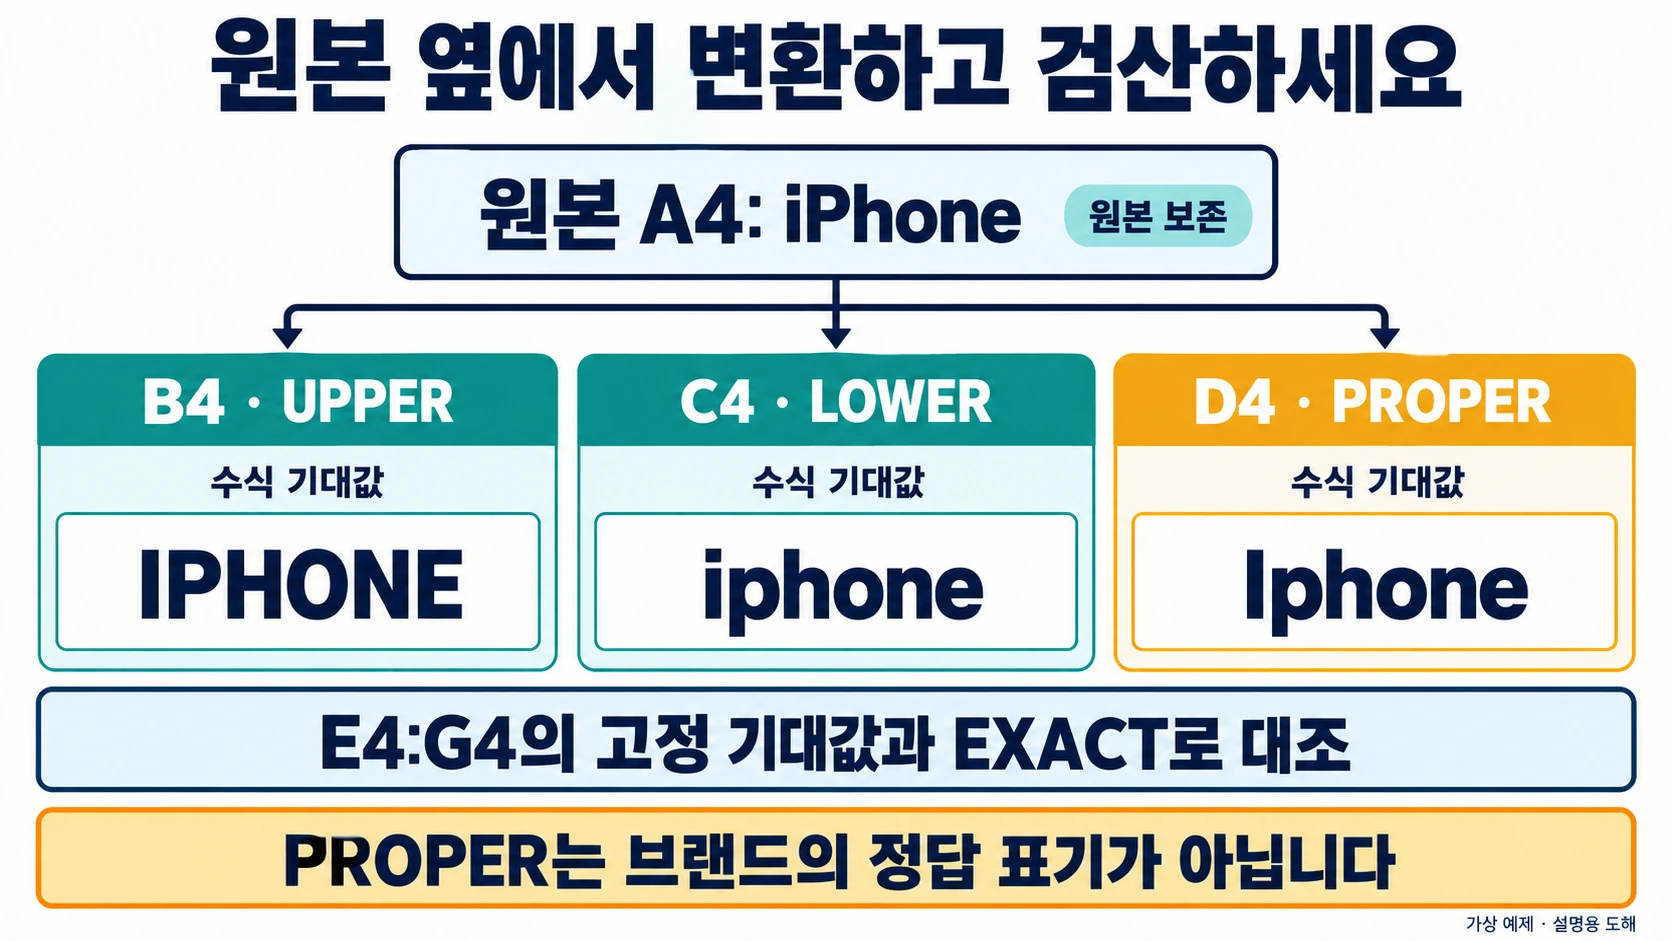
변환 시트 A2:A7에 예제가 들어 있습니다. B·C·D열은 각각 아래 수식이며, E·F·G열에는 독립적으로 적은 기대 결과가 있습니다.
=UPPER(A2)
=LOWER(A2)
=PROPER(A2)UPPER는 영문을 대문자로, LOWER는 소문자로 변환합니다. PROPER는 첫 글자와 문자 이외의 기호 다음 글자를 대문자로 하고 나머지를 소문자로 바꾸는 규칙입니다. 이름이나 브랜드의 올바른 철자를 판단하는 기능은 아닙니다. Microsoft 텍스트 정리 안내
| 행 | 원본 A열 | B열 UPPER 기대값 | C열 LOWER 기대값 | D열 PROPER 기대값 |
|---|---|---|---|---|
| 2 | Samsung Electronics | SAMSUNG ELECTRONICS | samsung electronics | Samsung Electronics |
| 3 | APPLE inc. | APPLE INC. | apple inc. | Apple Inc. |
| 4 | iPhone | IPHONE | iphone | Iphone |
| 5 | NASA api | NASA API | nasa api | Nasa Api |
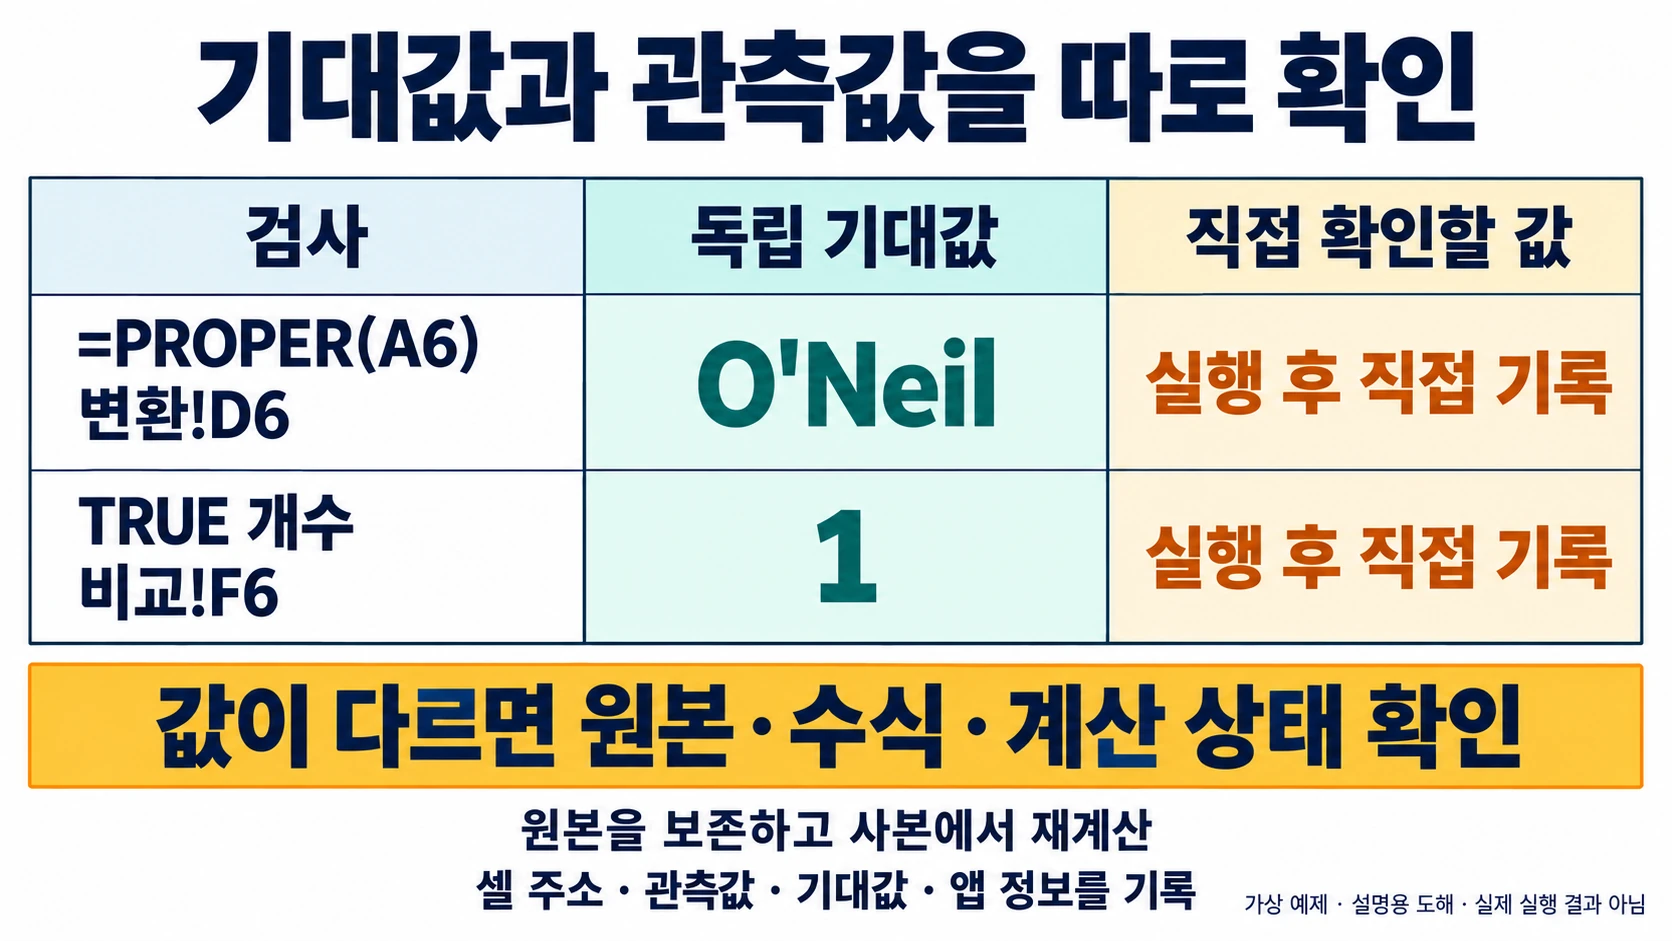
| 6 | o'neil | O'NEIL | o'neil | O'Neil |
| 7 | 한글 AbC 123 | 한글 ABC 123 | 한글 abc 123 | 한글 Abc 123 |
H2의 검산식은 세 결과를 모두 대소문자까지 확인합니다. H7까지 같은 구조로 채워져 있습니다.
=IF(AND(EXACT(B2,E2),EXACT(C2,F2),EXACT(D2,G2)),"일치","불일치")H2:H7의 기대값은 모두 일치입니다. 그렇더라도 Iphone이나 Nasa Api를 공식 표기로 채택하면 안 됩니다. 수식의 규칙대로 변환됐다는 것과 업무에 맞는 표기라는 것은 다릅니다. 고정 철자가 필요한 이름은 별도의 승인된 표기표를 사용합니다.
2. 대소문자만 다른 입력으로 오류를 재현하기
비교 시트에는 다음 세 행이 들어 있습니다.
| 셀 행 | A열 원본 키 | B열 반환값 |
|---|---|---|
| 2 | Samsung | 항목-1 |
| 3 | samsung | 항목-2 |
| 4 | APPLE INC. | 항목-3 |
E2:E7은 검사 이름, F2:F7은 수식 결과, G2:G7은 고정 기대값, H2:H7은 검산입니다.
| 결과 셀 | 수식 | 기대 결과 | 의미 |
|---|---|---|---|
| F2 | =A2=A3 |
TRUE | 일반 비교에서 대소문자만 다른 두 입력을 같게 봄 |
| F3 | =EXACT(A2,A3) |
FALSE | EXACT에서는 두 입력의 대소문자가 다름 |
| F4 | =COUNTIF(A2:A4,"SAMSUNG") |
2 | 대소문자가 다른 두 행을 함께 셈 |
| F5 | =VLOOKUP("samsung",A2:B4,2,FALSE) |
항목-1 | 소문자 행만 선택하지 않고 첫 일치 행을 반환 |
| F6 | =COUNTIF(C2:C4,TRUE) |
1 | 원본을 대상으로 한 EXACT 보조열의 참 개수 |
| F7 | =EXACT("AbC-01","abc-01") |
FALSE | 대소문자가 의미 있는 식별자는 원본 비교 |
C2에는 =EXACT(A2,$J$2)가 있고 C4까지 채워져 있습니다. J2의 기준은 Samsung이므로 C2:C4의 기대값은 차례로 TRUE, FALSE, FALSE입니다.
특히 F5가 항목-1이라고 나오는 것은 수식 오류가 아닙니다. 이 표에서는 대소문자 무시 기준으로 두 행이 일치하며 첫 행이 반환되는 것입니다. 원하는 대상이 두 번째 행이라면 대소문자를 보존한 별도 비교 기준이나 고유 식별자가 필요합니다. 대문자로 바꾸는 것만으로 중복 문제가 해결되지 않습니다.
3. 공백은 없애기 전에 어떤 문자인지 구분하기
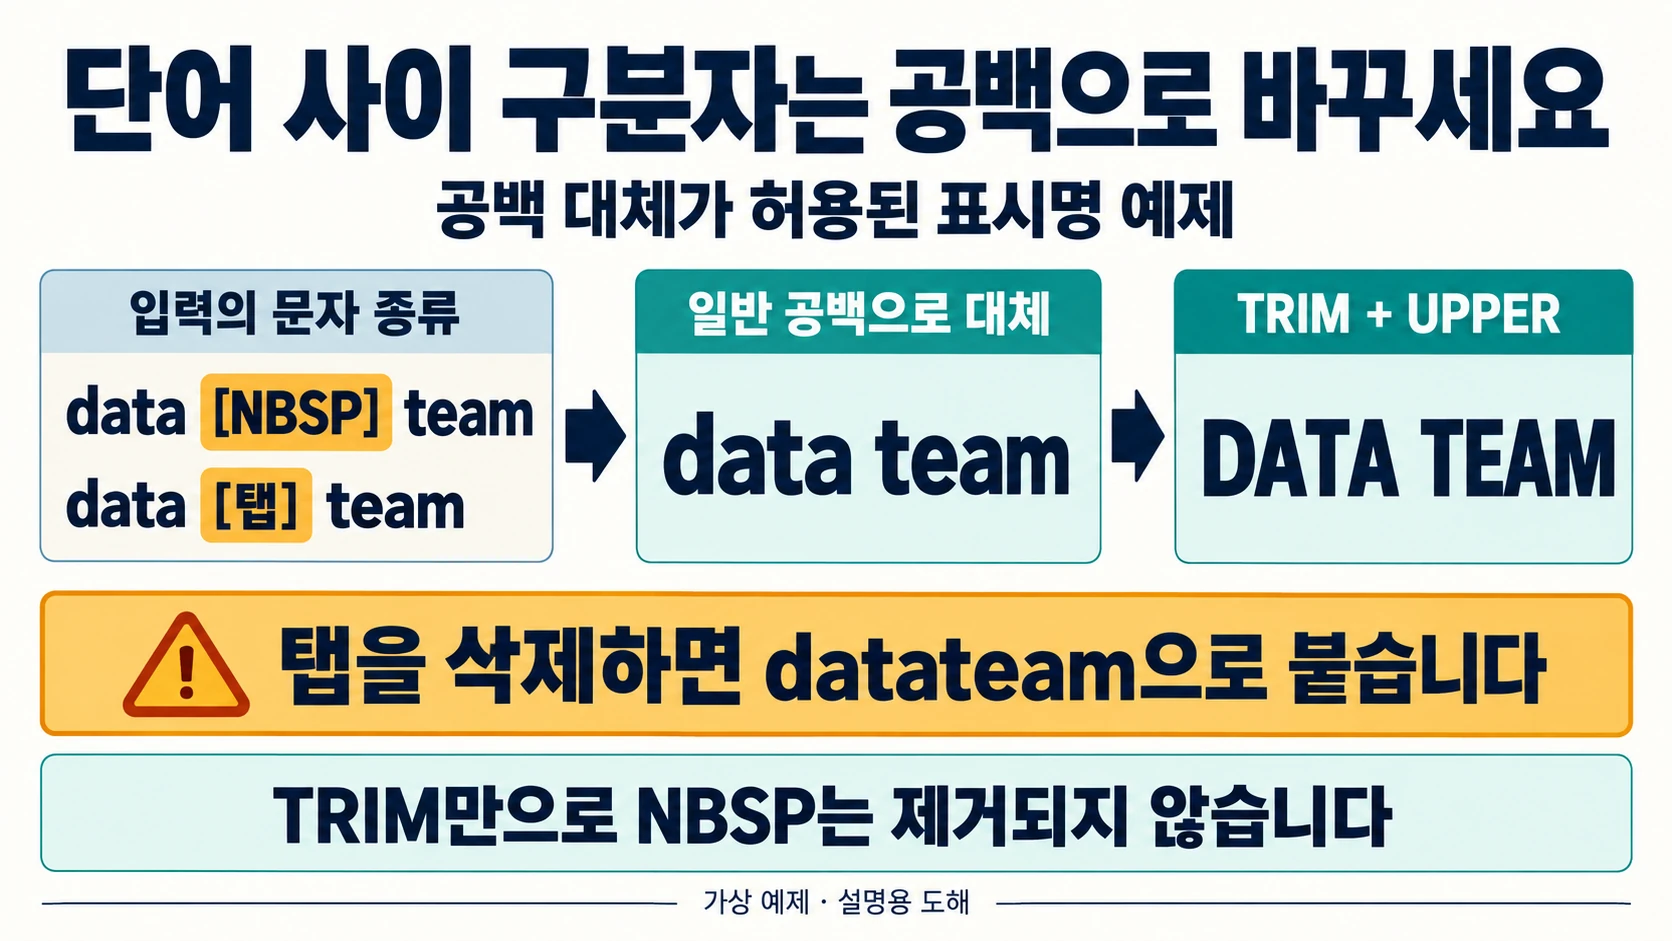
TRIM은 일반 공백을 정리하지만 NBSP를 단독으로 제거하지 않습니다. 따라서 화면에서 똑같이 띄어 쓴 것처럼 보이더라도 결과가 다를 수 있습니다. Microsoft TRIM 설명
또한 CLEAN은 모든 유니코드의 보이지 않는 문자를 제거하는 만능 함수가 아닙니다. 기본 대상은 ASCII의 처음 32개 제어 문자입니다. 탭이나 줄바꿈을 바로 삭제하면 단어 경계도 사라질 수 있습니다. Microsoft 공백·제어 문자 정리 안내
예를 들어 이 실습에서 data와 team 사이의 탭은 단어 구분자입니다. 삭제해서 datateam으로 붙이는 대신 일반 공백으로 바꿉니다. NBSP도 같은 이유로 빈 문자열이 아니라 " "으로 바꾼 뒤 TRIM을 적용합니다.
아래는 NBSP·탭·줄바꿈을 직접 만드는 입력 수식입니다. UNICHAR는 지정한 유니코드 숫자의 문자를 반환합니다. 현재 첨부의 정제!B8과 B9에는 모두 LF(문자 코드 10)가 저장되어 있어, B9의 CR 표시는 실제 문자와 다릅니다. CR 사례는 사본에서 아래 UNICHAR(13) 수식으로 직접 만들고, 저장 후 다시 열어 문자 코드 13이 유지되는지 확인하세요. Microsoft UNICHAR 설명
="data"&UNICHAR(160)&"team"
="data"&UNICHAR(9)&"team"
="Excel"&UNICHAR(10)&"Lab"
="Excel"&UNICHAR(13)&"Lab"
이 규칙은 줄바꿈을 공백으로 바꿔도 되는 표시명 예제에 한정합니다. 주소·문장·파일 형식 등에서 줄바꿈이 다른 의미를 가진다면 동일하게 적용하지 않습니다. 보이지 않는 문자의 추가 진단은 CLEAN 함수와 숨은 문자 확인을 참고하되, 원본을 먼저 보존합니다.
4. 단어 경계를 남기는 정제 수식
정제 시트의 B열은 원본, C열은 규칙 분류, D열은 구분자 대체 결과, E열은 정제 키입니다. D2는 NBSP·탭·LF·CR 네 문자만 일반 공백으로 바꿉니다.
=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(B2,UNICHAR(160)," "),UNICHAR(9)," "),UNICHAR(10)," "),UNICHAR(13)," ")E2에서는 일반 공백을 정리하고 대문자로 통일합니다.
=UPPER(TRIM(D2))F열의 고정 기대값과 대조하는 G2는 다음과 같습니다.
=EXACT(E2,F2)세 수식은 파일에서 13행까지 채워져 있습니다. 원본을 건드리지 않고 중간 결과를 볼 수 있도록 한 수식에 모두 숨기지 않았습니다.
| 행 | B열 입력 설명 | C열 규칙 분류 | E열 수식 기대값 | I열 기대 판정 |
|---|---|---|---|---|
| 2 | 앞뒤 일반 공백이 있는 Samsung | 표시명 | SAMSUNG | 보류:키중복 |
| 3 | samsung | 표시명 | SAMSUNG | 보류:키중복 |
| 4 | SAMSUNG | 표시명 | SAMSUNG | 보류:키중복 |
| 5 | sAmSuNg | 표시명 | SAMSUNG | 보류:키중복 |
| 6 | data와 team 사이 NBSP | 표시명 | DATA TEAM | 보류:키중복 |
| 7 | data와 team 사이 탭 | 표시명 | DATA TEAM | 보류:키중복 |
| 8 | Excel과 Lab 사이 LF | 표시명 | EXCEL LAB | 보류:키중복 |
| 9 | Excel과 Lab 사이 LF(현재 첨부에서 CR로 잘못 표기됨) | 표시명 | EXCEL LAB | 보류:키중복 |
| 10 | Plain label | 표시명 | PLAIN LABEL | 사용후보 |
| 11 | Data와 Team 사이 제로폭 문자 | 검토필요 | 제로폭 문자가 남은 대문자 텍스트 | 보류:규칙확인 |
| 12 | AbC-01 | 식별자 | ABC-01 | 보류:원본보존 |
| 13 | 빈 입력 | 표시명 | 빈칸 | 보류:빈입력 |
11행의 원본은 ="Data"&UNICHAR(8203)&"Team"으로 재현할 수 있습니다. 이 문자는 위 대체 대상에 없으므로 남아 있는 것이 수식의 예상 동작입니다. F열에도 같은 문자가 들어 있어 G열이 TRUE여도, C열이 미확인 규칙인 이상 사용후보가 되지 않습니다. 모르는 문자를 지웠다고 가정하지 않습니다.
12행은 변환하면 식별자의 대소문자가 달라진다는 반례입니다. E열은 비교용 결과일 뿐이고 B열 원본은 그대로 남습니다.
5. 정제에 성공해도 중복 키는 보류하기
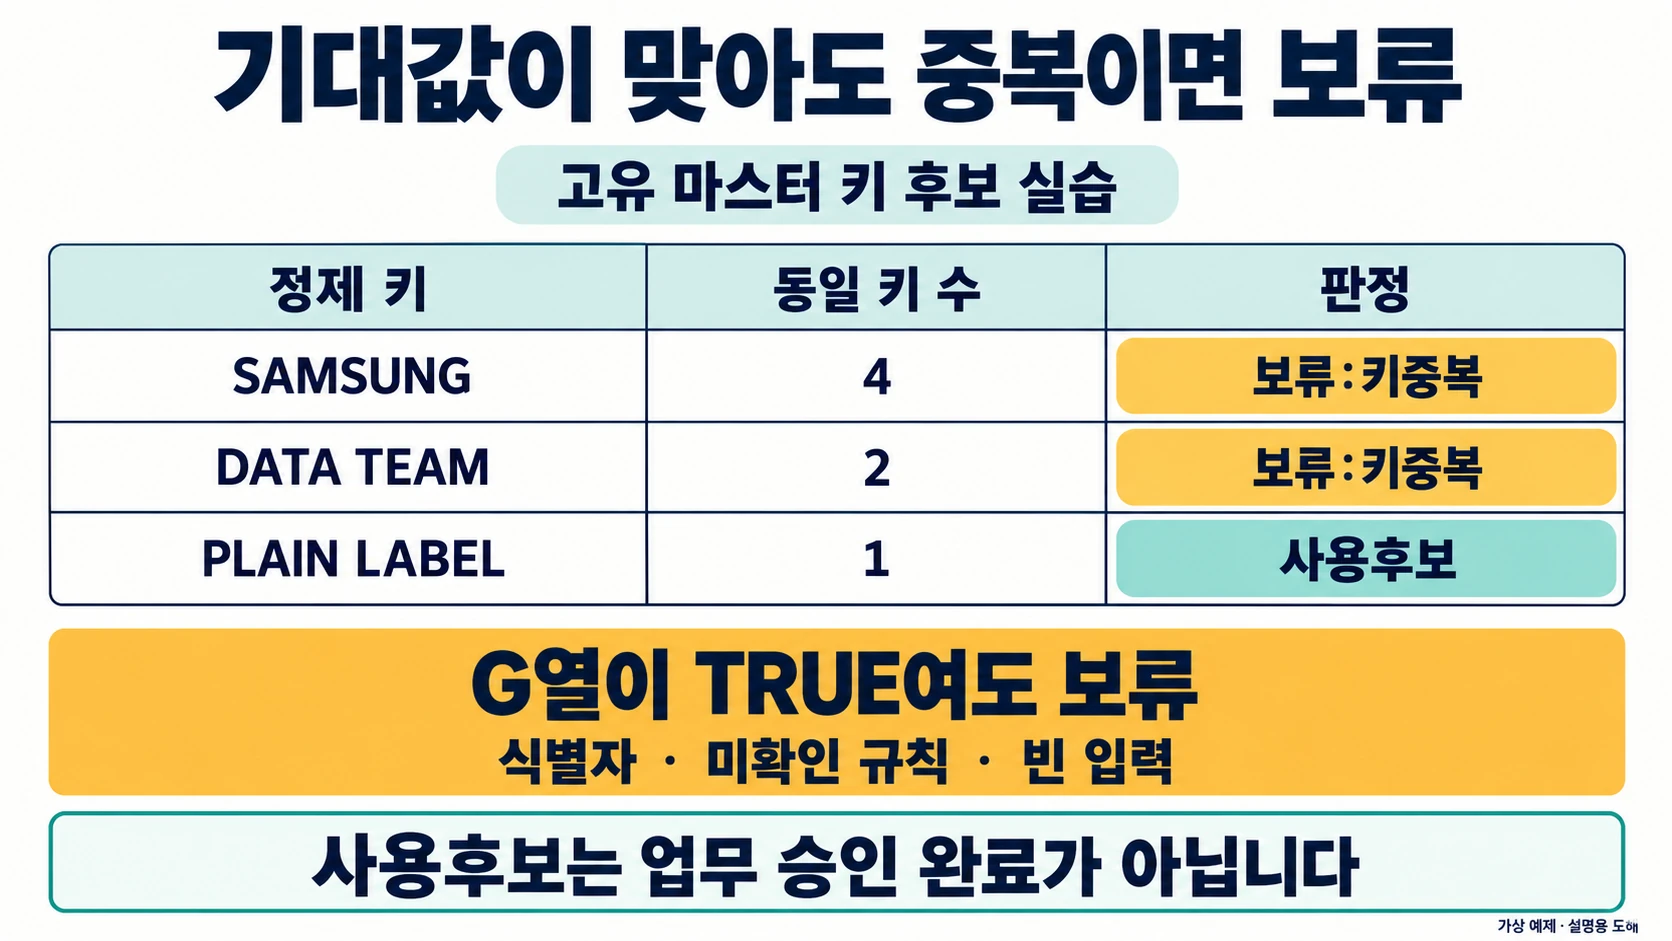
H열은 같은 정제 키가 예제 범위에 몇 개 있는지 셉니다. 키 안의 별표·물음표·물결표가 COUNTIF의 와일드카드로 해석되지 않도록 문자 그대로 비교할 조건을 만듭니다.
=IF(E2="","",COUNTIF($E$2:$E$13,"="&SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(E2,"~","~~"),"*","~*"),"?","~?")))이 예제의 키는 이미 대문자로 통일돼 있습니다. 원본 대소문자를 구분해야 하는 별도 과업에 이 개수 검사를 그대로 사용하지 않습니다.
I열은 다음 순서로 판단합니다.
-
C열이
식별자이면보류:원본보존입니다. -
C열이
표시명이 아니면보류:규칙확인입니다. -
원본이나 정제 키가 빈칸이면
보류:빈입력입니다. -
G열의 기대값 검산이 거짓이면
보류:기대값불일치입니다. -
H열 동일 키 수가 1이 아니면
보류:키중복입니다. -
나머지만
사용후보이며, 계산 오류는보류:입력오류로 남깁니다.
이 중복 규칙은 고유 마스터 키를 만들려는 실습 목적에 맞춘 것입니다. 거래 목록에서 같은 고객이 여러 번 등장하는 것까지 모두 오류로 취급하라는 뜻이 아닙니다. 중복 두 행을 실제로 하나로 합칠지는 원본 시스템의 식별자와 업무 규칙으로 결정해야 합니다.
조건별 개수를 별도로 살필 때는 COUNTIF 조건부 집계 가이드와 함께 확인합니다. 서로 다른 조회 기준을 섞어 쓰지 않는 것이 우선입니다.
검산 결과와 완료 기준
파일을 열어 다음 값을 직접 대조합니다. 아래 수치는 제공한 고정 예제의 기대값이지, 실제 업무 데이터의 통계나 Excel 실행 보고가 아닙니다.
| 시트·범위 | 기대값 | 뜻 |
|---|---|---|
| 변환 H2:H7 | 모두 일치 | 세 변환 함수가 고정 기대값과 일치 |
| 비교 F2:F7 | TRUE, FALSE, 2, 항목-1, 1, FALSE | 일반 비교·EXACT·조회 방식을 구분 |
| 비교 H2:H7 | 모두 일치 | 결과와 기대값의 대조 |
| 정제 G2:G13 | 모두 TRUE | 이 수식의 예상 출력과 일치 |
| 정제 H2:H5 | 모두 4 | SAMSUNG 키가 네 행에서 생성됨 |
| 정제 H6:H9 | 모두 2 | DATA TEAM과 EXCEL LAB의 각 중복 |
| 정제 K16 | 12 | 열두 행의 판정이 고정 기대 판정과 일치 |
| 정제 K17 | 1 | 이 범위에서 사용후보는 한 행 |
빈칸끼리 비교한 13행의 G열도 TRUE일 수 있지만 I열에서는 반드시 빈 입력으로 보류해야 합니다. 키의 문자열이 기대값과 맞는지만 보고 전체 작업을 완료 처리하면 안 되는 이유입니다.
증상별 원인 분기와 복구
COUNTIF가 0인데 눈에는 같은 글자로 보인다
원본 수식의 참조 범위와 조건을 먼저 확인하고, LEN으로 길이를 비교합니다. 일반 공백과 NBSP를 구분해 D열의 대체 결과를 살핍니다. 대소문자만 바꾸는 조치로 끝내지 않습니다. 위 비교 시트의 고정 입력에서는 F4의 기대값이 2입니다.
VLOOKUP이 다른 행의 값을 반환한다
FALSE를 썼는지 확인하고, 기준 키가 여러 행에 있는지 셉니다. 이번 예제의 F5는 첫 일치 값인 항목-1이 정상 기대값입니다. 대소문자 구분이 필요한데 원본을 먼저 통일했다면 원본 사본으로 돌아가 비교 기준부터 다시 정합니다. 반환값만 원하는 값으로 덮어쓰지 않습니다.
CLEAN을 쓴 뒤 두 단어가 붙었다
제어 문자가 단어 구분자였는지 살핍니다. 원본에서 다시 시작해 승인된 구분자만 일반 공백으로 바꾼 뒤 TRIM을 적용합니다. data와 team의 실습 기대값은 DATA TEAM이며 DATATEAM이 아닙니다. 이미 원본을 지웠다면 결과를 억지로 복원하지 말고 백업을 확보합니다.
PROPER 결과가 이름이나 브랜드와 다르다
함수 오작동이 아니라 변환 규칙과 표기 규칙이 다른 상황일 수 있습니다. 원본과 승인된 표기표를 대조하고, PROPER 결과를 정답으로 자동 확정하지 않습니다. 실습의 iPhone은 Iphone으로 변환되는 것이 기대값이지만, 원래 이름을 보존하려는 업무에서는 채택하지 않습니다.
피벗에서 비슷한 이름이 여러 행으로 보인다
그 현상만으로 대소문자가 원인이라고 단정하지 않습니다. 피벗의 원본 범위, 실제 문자, 보조열과 원본 열 중 어느 열을 사용했는지, 새로 고침 상태를 순서대로 기록합니다. 이 글의 파일에는 피벗 실행 결과가 없으므로 특정 피벗 환경의 그룹화 동작을 검증했다고 주장하지 않습니다.
G열은 TRUE인데 I열이 보류다
예제의 11·12·13행처럼 규칙·식별자·빈 입력 검사가 우선일 수 있습니다. 보류 사유를 없애려고 C열을 무조건 표시명으로 바꾸거나 기대값을 현재 결과에 맞춰 수정하지 않습니다. 실제 자료의 규칙을 확인한 뒤 새 사본에서 적용 범위를 정합니다.
적용하지 말아야 할 대상과 중단 기준
이 실습은 표시명 정리입니다. 인증 정보, 대소문자가 의미 있는 코드, URL 경로, 이메일 주소를 통째로 자동 변환하는 정책으로 확대하지 않습니다. 날짜나 숫자 셀의 표시 형식을 보존하는 작업도 별도 과업입니다. 원본이 텍스트인지부터 확인하고 범용 텍스트 정제로 해결했다고 간주하지 않습니다.
수식이 지원되지 않아 #NAME? 등이 나오거나, 의미를 알 수 없는 문자가 남거나, 중복 키가 서로 다른 대상을 가리키면 자동 반영을 중단합니다. 원본 셀 주소, 실제 값과 길이, 사용한 수식, 중간 결과, 기대값, 앱과 파일 정보를 기록해 원본 데이터 담당자에게 전달합니다.
고정 입력과 기대값이 맞는지 확인하지 않은 채 행을 추가하지 않습니다. 실습 범위를 확장하려면 수식 범위뿐 아니라 독립적인 기대값과 업무 판정도 함께 작성해야 합니다.
파일은 변환, 비교, 정제, README 네 시트로 구성됩니다. 본문의 셀 주소와 동일하게 배치했으며, 기대값과 보류 사례를 포함합니다. 파일 생성과 제공은 데스크톱 Excel 재계산이나 실제 운영 데이터 검증을 완료했다는 뜻이 아닙니다.
공식 출처와 확인 범위
-
Microsoft 텍스트 정리 안내: 대소문자 변환과 공백·제어 문자 정리의 범위.
-
Microsoft COUNTIF 설명: 대소문자 무시와 와일드카드 조건.
-
Microsoft VLookup 문서: 대소문자 동등 취급, 정확 일치와 첫 일치 반환.
-
Microsoft EXACT 설명: 대소문자를 구분하는 텍스트 비교.
-
Microsoft TRIM 설명: 일반 공백과 NBSP의 차이.
-
Microsoft UNICHAR 설명: 유니코드 숫자로 문자 지정.
문서 확인일은 2026-09-12입니다. 함수 동작은 위 문서를 근거로 설명했고, 키 중복 보류 규칙과 입력·기대값은 이 실습의 목적에 맞춰 작성했습니다.
작성자 소개
