엑셀 CLEAN 함수: 보이지 않는 문자 진단과 공백 정리
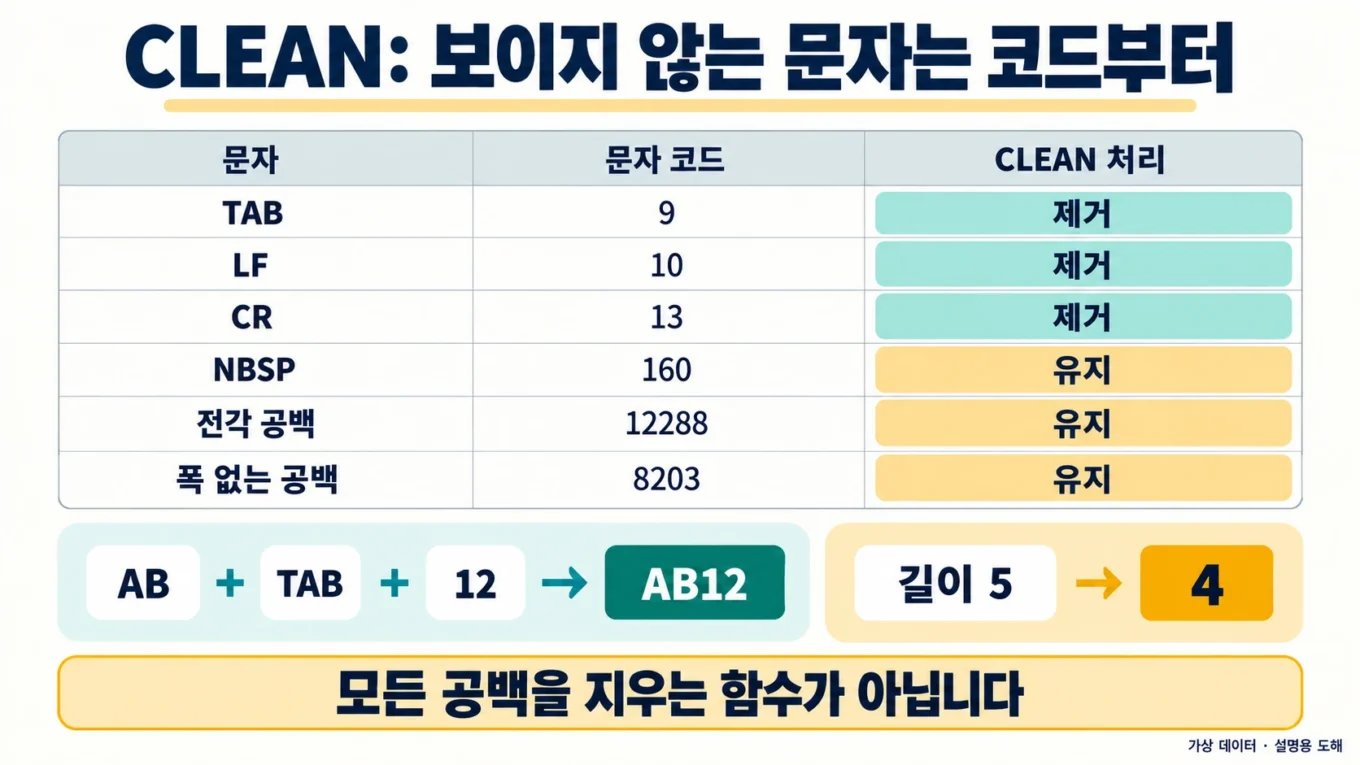
화면에서 AB12처럼 보이는 값이 마스터와 맞지 않을 때는 먼저 문자 코드를 봐야 합니다. CLEAN은 모든 공백을 삭제하는 함수가 아닙니다. 탭·줄바꿈, 일반 공백, NBSP, 전각 공백, 폭 없는 공백을 같은 대상으로 묶으면 제품 코드나 문장의 의미가 달라질 수 있습니다.
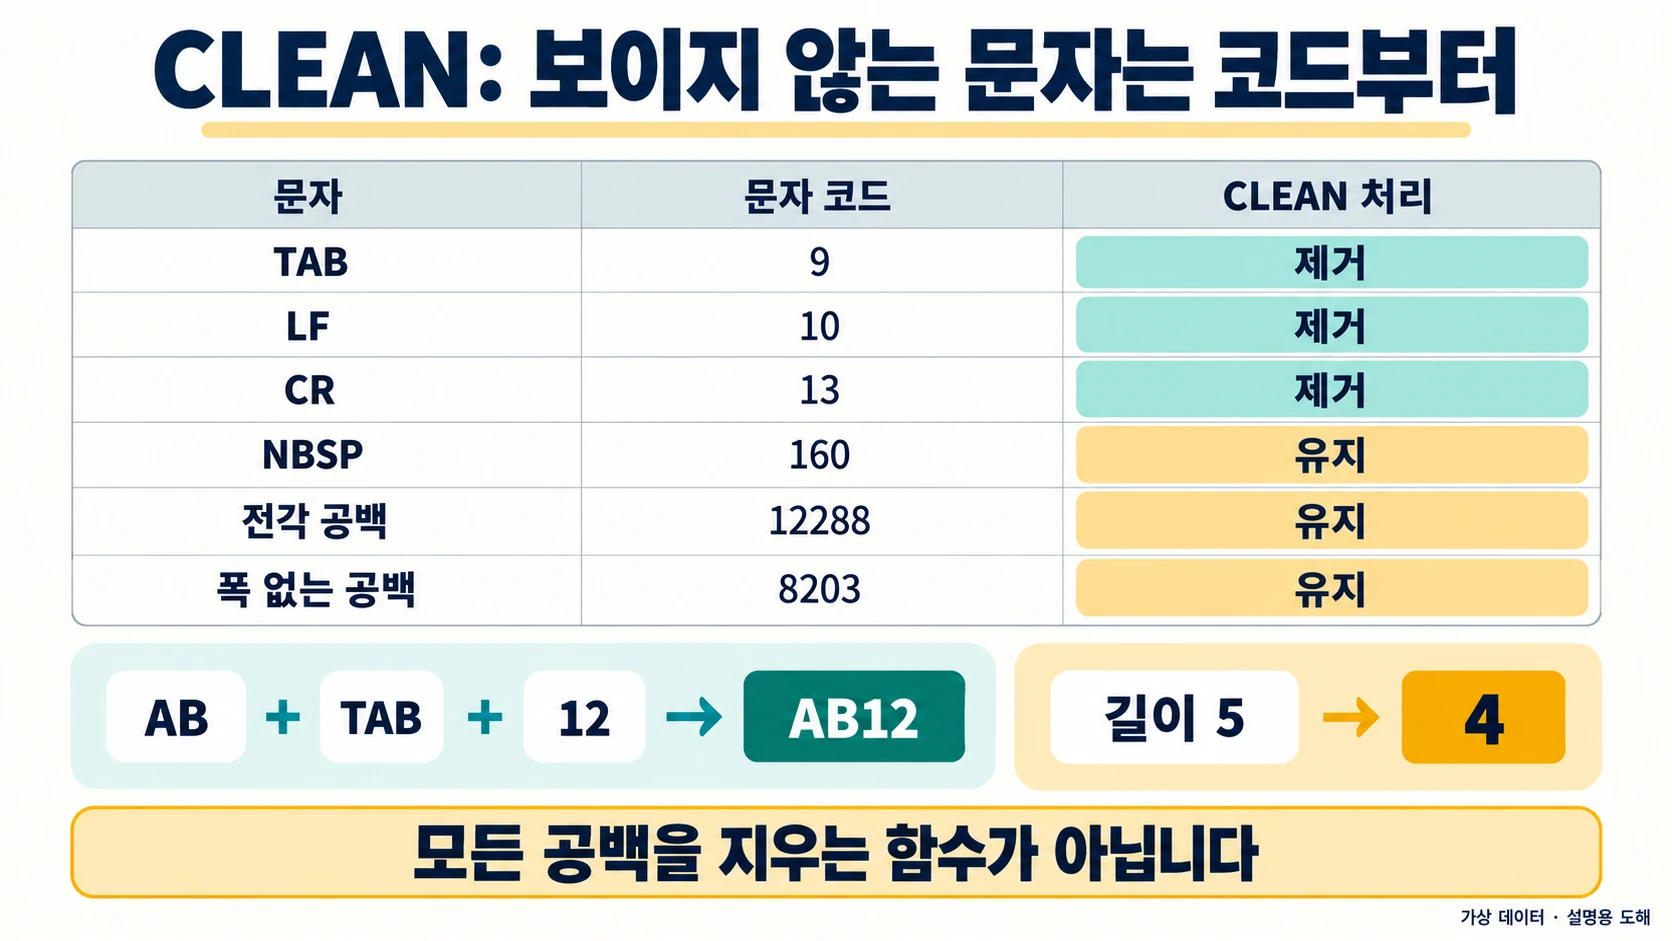
도해의 문자 종류와 정리 결과를 실습 파일의 진단·코드정리·문장정리 시트에서 대조하세요. 세 시트는 합성 입력을 서로 다른 규칙으로 다룹니다.
눈에 보이지 않는 한 글자를 숫자로 확인하기
진단 B5:B13에는 문자열과 실제 빈 셀이 있습니다. 탭·LF·CR은 CHAR 수식으로, 유니코드 문자는 UNICHAR로 넣었습니다. C열은 검사할 위치이며 D열에서 UNICODE(MID(원본,위치,1))를 계산합니다. 위치가 정수가 아니거나 원본 길이 밖이면 검사 없음입니다.
숨은 문자를 직접 넣고 위치를 검사하기
진단!B5에 아래 수식을 넣으면 AB와 12 사이에 탭 하나가 생깁니다. C5에는 검사 위치인 숫자 3을 넣습니다. 키보드 Tab을 눌러 옆 셀로 이동하는 것과 문자열 안에 탭 문자를 넣는 것은 다릅니다.
="AB"&CHAR(9)&"12"진단!D5: 위치 검사 후 문자 코드
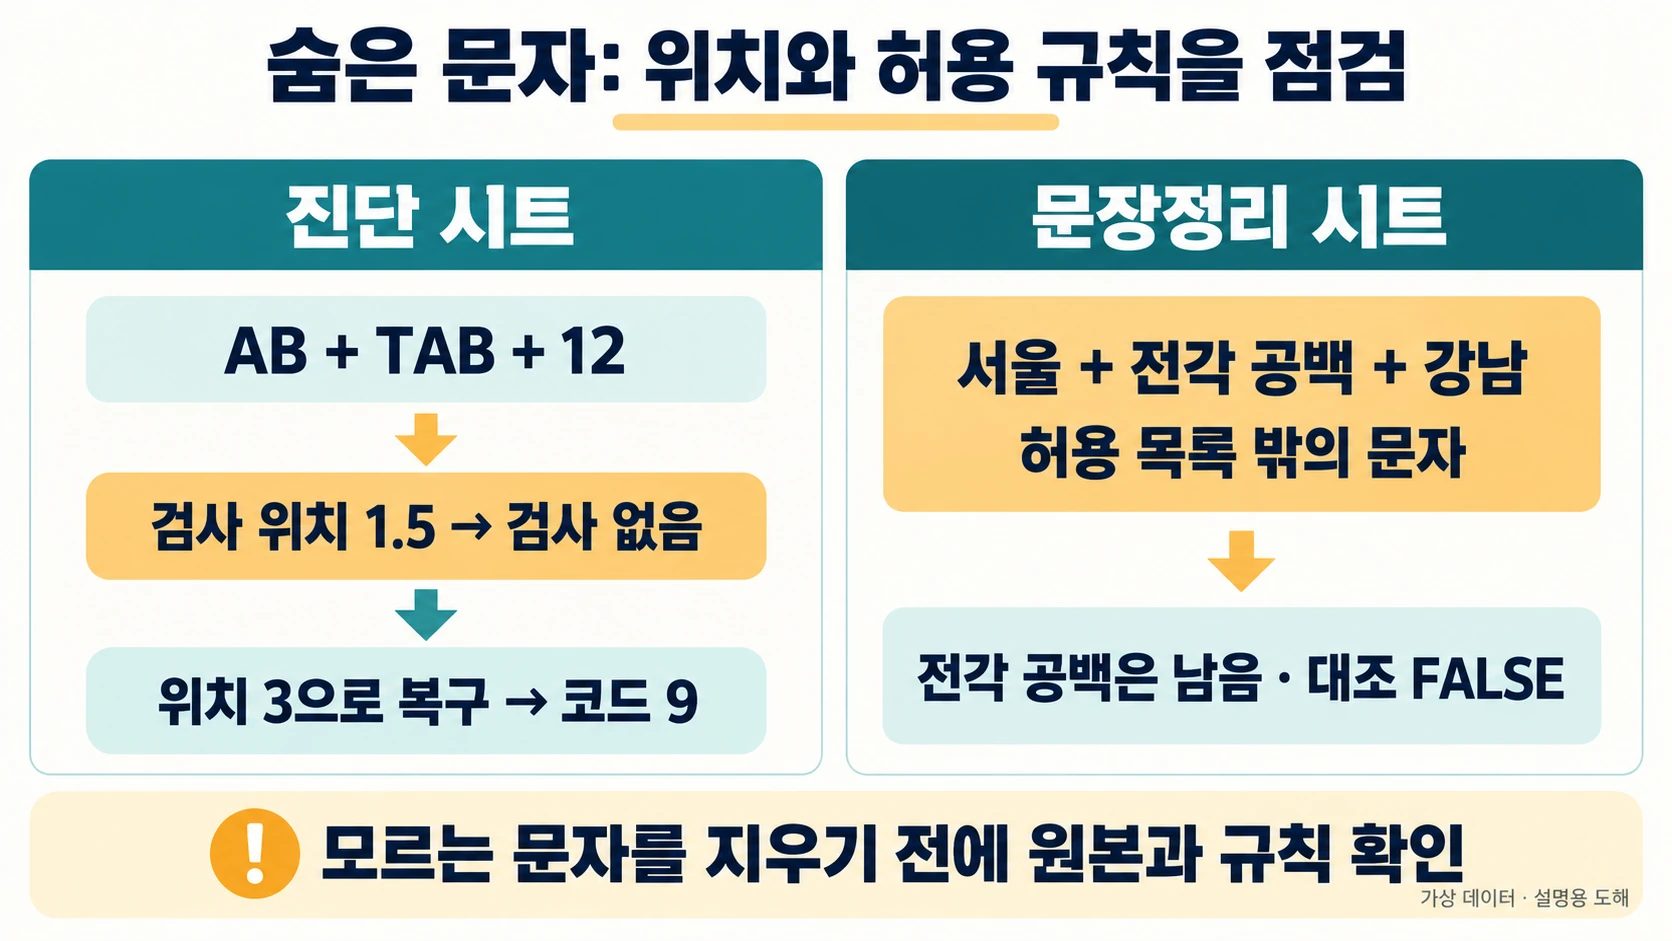
=IFERROR(IF(OR(NOT(ISNUMBER(C5)),C5<1,C5<>INT(C5),C5>LEN(B5)),"검사 없음",UNICODE(MID(B5,C5,1))),"검사 없음")이 식은 첨부의 진단 수식과 같은 구조입니다. D5를 D13까지 아래로 복사하면 원본 B열과 위치 C열도 같은 행으로 이동합니다. UNICODE(B5)만 쓰면 첫 글자 A의 65를 얻으므로, 탭이 있는 세 번째 글자를 MID로 먼저 골라야 합니다. C5=3에서 9, C5=1에서 65, C5=1.5 또는 6에서는 검사 없음인지 확인한 뒤 3으로 되돌립니다. 오류를 0으로 바꾸지 않습니다. 코드 0도 실제 문자 코드라 검사 실패와 구분해야 하기 때문입니다.
E5에 =LEN(B5), F5에 =LEN(CLEAN(B5)), G5에 =CLEAN(B5)를 넣으면 기대값은 5·4·AB12입니다. LF·CR·NBSP·전각·폭 없는 공백은 아래 표의 코드로 원본을 만든 뒤 같은 검사를 합니다. UNICODE와 UNICHAR의 공식 적용 대상에는 Excel 2016·2019·2021·2024와 Microsoft 365가 포함됩니다. 이 수식은 단일 셀에 Enter로 입력합니다.
| 종류·행 | 합성 원본의 구조 | 검사 위치 | 기대 코드 | CLEAN 뒤 |
|---|---|---|---|---|
| TAB·5 | AB + 탭 + 12 | 3 | 9 | AB12 |
| LF·6 | AB + LF + 12 | 3 | 10 | AB12 |
| CR·7 | AB + CR + 12 | 3 | 13 | AB12 |
| 일반 공백·8 | 앞 두 칸 + AB + 한 칸 + 12 + 뒤 한 칸 | 1 | 32 | 공백 유지 |
| NBSP·9 | AB + NBSP + 12 | 3 | 160 | NBSP 유지 |
| 전각 공백·10 | AB + 전각 공백 + 12 | 3 | 12288 | 전각 공백 유지 |
| 폭 없는 공백·11 | AB + 폭 없는 공백 + 12 | 3 | 8203 | 해당 문자 유지 |
-
D5:D11의 코드부터 위 표와 비교해 같은지 확인합니다. 표시 모양만 보고 공백 종류를 결정하지 않습니다.
-
E열의 원본 길이와 F열의 CLEAN 길이를 비교합니다. TAB·LF·CR 행은 길이 5에서 4가 되고, NBSP 등은 5가 그대로입니다.
-
정상 AB12와 빈 입력의 대조값도 확인합니다. 정상 AB12 행은 첫 글자 A의 코드 65, 실제 빈 B13은 길이 0·
검사 없음입니다. I열의 TRUE는 이 고정 코드 대조 결과이지 해당 값을 삭제해도 된다는 승인이 아닙니다.
CLEAN 공식 설명의 적용 범위를 먼저 확인하세요. CLEAN은 ASCII 코드 0~31의 비인쇄 문자를 제거하도록 설계됐습니다. UNICODE 문서는 첫 문자의 코드 포인트를 반환한다고 설명하고, UNICHAR 문서는 그 숫자에 대응하는 문자를 반환한다고 설명합니다. 첨부가 UNICODE·UNICHAR를 인식하지 못하는 Excel 환경이면 삭제를 진행하지 말고 지원 환경부터 확인하세요.
코드에서는 허용된 문자만 제거하고 마지막에 TRIM
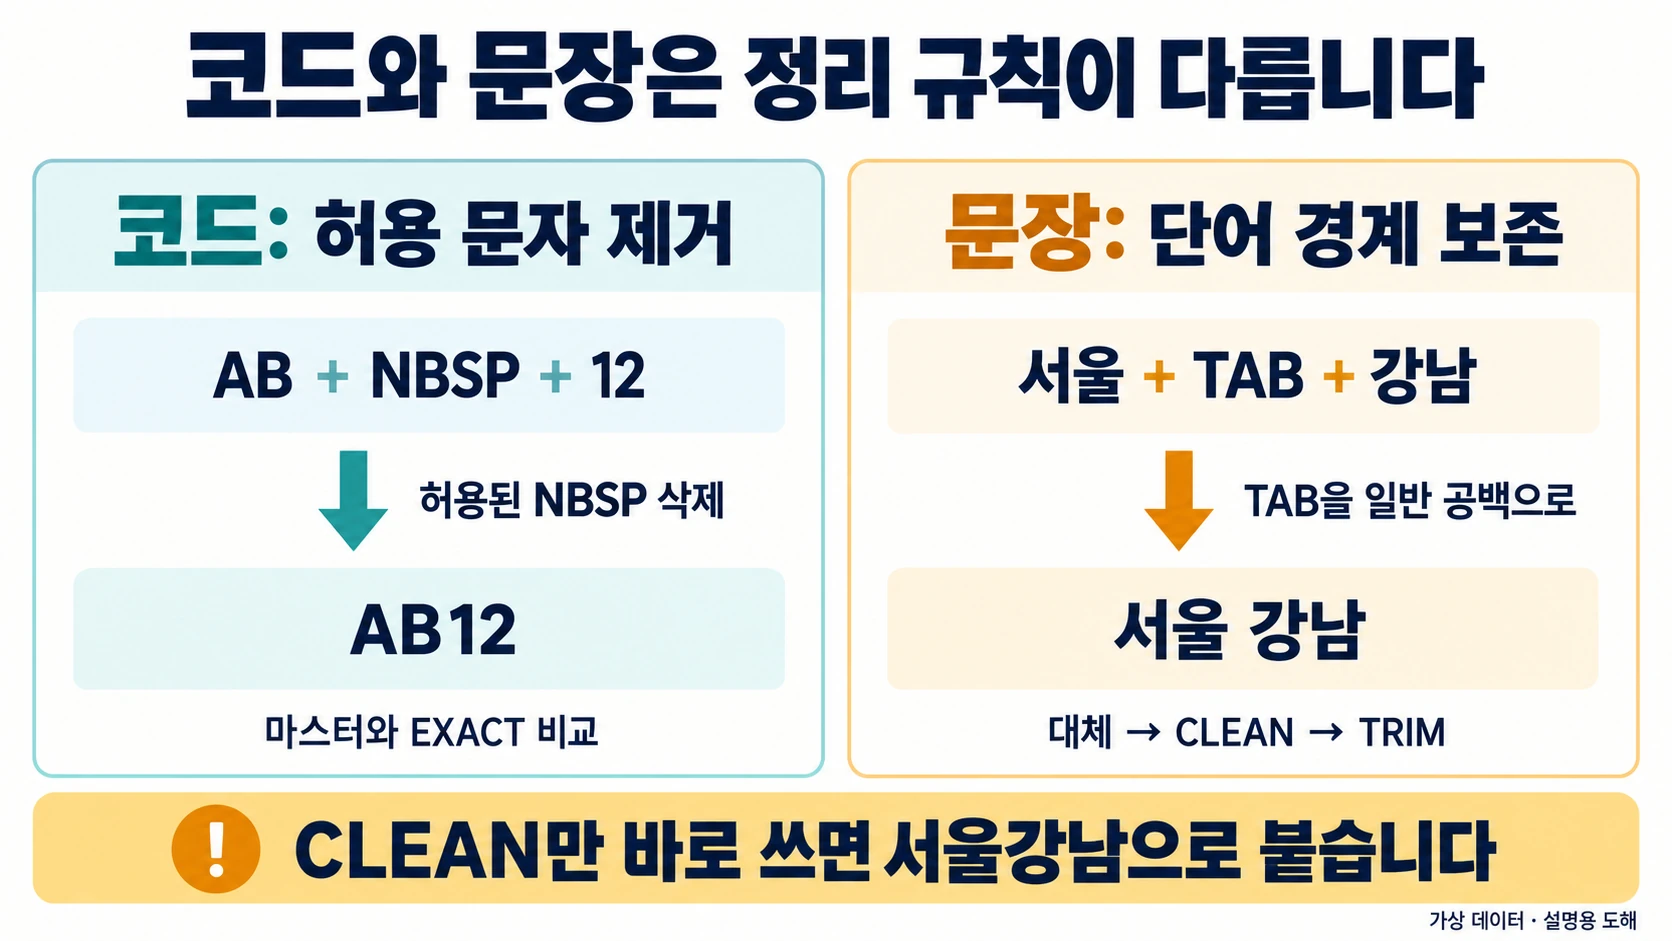
코드정리의 가상 마스터 B2는 AB12입니다. 이 시트에서는 합성 코드의 탭과 NBSP 삭제를 허용했다고 가정합니다. B열 CLEAN, C열 NBSP 삭제, D열 TRIM 순서로 처리하고 G열에서 마스터와 EXACT 대조를 합니다.
=SUBSTITUTE(B5,UNICHAR(160),"")
=TRIM(C5)
=IF(EXACT(D5,$B$2),"일치","보류")
A5는 일반 공백·탭·일반 공백·AB12·일반 공백입니다. 올바른 순서의 D5는 AB12지만, H5처럼 TRIM을 먼저 하고 CLEAN을 나중에 하면 탭 제거 후 생긴 맨 앞 한 칸이 남아 AB12입니다. 그래서 문자열 정리의 순서도 실제 입력으로 검산해야 합니다.
A6의 NBSP는 허용 규칙에 따라 제거되어 D6=AB12입니다. A7의 일반 내부 공백이 있는 AB 12, A8의 전각 공백, A9의 폭 없는 공백은 이 코드 정책에서 임의 제거하지 않으므로 G열이 보류입니다. TRIM만으로는 NBSP를 제거하지 않습니다. TRIM만 적용했다고 모든 유니코드 공백이 사라지지는 않습니다.
허용한 문자를 정리한 뒤에도 대소문자나 중복 키 때문에 조회 대상이 달라질 수 있습니다. EXACT 비교와 정제 키 중복 보류에서 원본을 보존한 채 표시명 변환 결과와 키 개수를 나눠 대조하고, 식별자를 통일해도 되는지 확인하세요.
문장에서는 삭제보다 구분자 대체가 먼저
문장정리 A5:A9는 서울과 강남 사이에 TAB·LF·CRLF·NBSP·일반 공백을 넣은 가상 문장입니다. 코드와 달리 단어 구분이 필요하므로 B열에서 네 종류를 일반 공백으로 대체한 뒤 CLEAN, TRIM을 순서대로 적용합니다.
단어 사이 공백을 보존하는 전체 수식
첨부와 같은 문장을 직접 만들 때 A5에는 ="서울"&CHAR(9)&"강남", A6에는 ="서울"&CHAR(10)&"강남", A7에는 ="서울"&CHAR(13)&CHAR(10)&"강남"을 입력합니다. A8은 ="서울"&UNICHAR(160)&"강남", A9는 =" 서울 강남 "입니다. 실제 회사 문장을 붙여 넣지 않아도 다섯 입력 차이를 재현할 수 있습니다.
문장정리!B5: TAB·LF·CR·NBSP를 일반 공백으로 대체
=SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(SUBSTITUTE(A5,CHAR(9)," "),CHAR(10)," "),CHAR(13)," "),UNICHAR(160)," ")C5: 남은 비인쇄 문자 처리
=CLEAN(B5)D5: 일반 공백 정리
=TRIM(C5)B5:D5를 9행까지 아래로 복사합니다. SUBSTITUTE의 세 번째 인수는 빈 문자열 ""이 아니라 공백 한 칸 " "입니다. A7의 CR과 LF는 B7에서 각각 공백으로 바뀌어 중간 두 칸이 되고 D7에서 한 칸으로 줄어듭니다. F5에 =EXACT(D5,"서울 강남")을 넣고 F9까지 복사하면 기본 다섯 행은 TRUE입니다. SUBSTITUTE는 지정한 텍스트를 바꾸고, TRIM은 일반 ASCII 공백을 정리합니다.
코드정리 시트의 B5에는 =CLEAN(A5)를 넣고, 앞 절의 NBSP 제거는 C5, TRIM은 D5, 마스터 비교는 G5에 넣습니다. 같은 CLEAN이라도 코드에서는 문자를 없애고 문장에서는 구분자로 바꾼 뒤 처리하므로 두 흐름을 섞지 않습니다. 이 실습은 표에 없는 제어문자를 가진 실제 문장까지 뜻이 보존된다고 보장하지 않습니다. 허용하지 않은 문자를 발견하면 대량 변환 전에 원문과 처리 규칙부터 확인하세요.
D5:D9의 기대값은 모두 서울 강남입니다. CRLF가 일반 공백 두 개로 바뀌어도 마지막 TRIM이 한 칸으로 정리합니다. 반면 A5에 CLEAN만 바로 적용한 E5는 서울강남으로 붙습니다. 코드용 삭제 수식을 문장에 그대로 복사하면 안 되는 이유입니다.
이 방법은 한 줄 검색용 문구를 만드는 예제입니다. 줄바꿈 자체가 문단·주소·단계 구분인 자료에는 원문을 그대로 보존해야 합니다. 전각 공백을 이 정책의 허용 목록에 넣지는 않았습니다.
문자 위치와 허용 목록 반례로 실패를 확인하기
검사 위치에 소수를 넣는 입력 오류부터 재현합니다. 진단 C5를 1.5로 바꾼 사본에서는 D5가 검사 없음입니다. 위치 3으로 다시 입력하면 코드 9로 복구됩니다. 1.5를 임의로 정수화해 다른 문자를 지우지 않습니다.
코드정리 A7을 AB+NBSP+12로 바꾸면 D7=AB12·G7=일치가 되지만 고정 기대 E7은 AB 12이므로 F7은 FALSE입니다. 가상 입력을 바꾼 실험과 최초 기대값을 구분한 결과입니다. 원래 AB 12로 되돌리면 F7은 TRUE·G7은 보류로 복구됩니다.
문장정리 A5를 서울+전각 공백+강남으로 바꾸면 해당 문자가 그대로 남아 F5가 FALSE입니다. 모르는 문자를 무조건 지우지 말고, 실제 업무에서 구분자인지 원본의 일부인지 확인한 뒤 허용 규칙과 기대값을 같이 수정하세요.
저장과 검산의 한계
이번 첨부는 탭·LF·CR·CRLF의 실제 저장 문자열과 코드, TRUE/FALSE의 논리형, 실제 빈 셀을 별도로 대조했습니다. 특히 CR을 LF로 바꿔 저장하면 원본 검사 의미가 달라지므로 CR 코드 13과 CRLF 두 문자가 보존되는지 확인했습니다. 수식은 LibreOffice에서 독립 재계산했으며 Microsoft Excel 앱 실행은 하지 않았습니다. 이 규칙은 모든 언어의 공백·제어문자·식별자 정규화 정책을 대신하지 않습니다.
UNICODE는 텍스트 첫 문자의 코드 포인트를 반환합니다.
UNICHAR는 주어진 숫자 값에 대응하는 유니코드 문자를 반환합니다.
출처 원문 수집일: S1 2026-09-24; S2 2026-09-24; S3 2026-09-24; S4 2026-09-24.
작성자 소개
