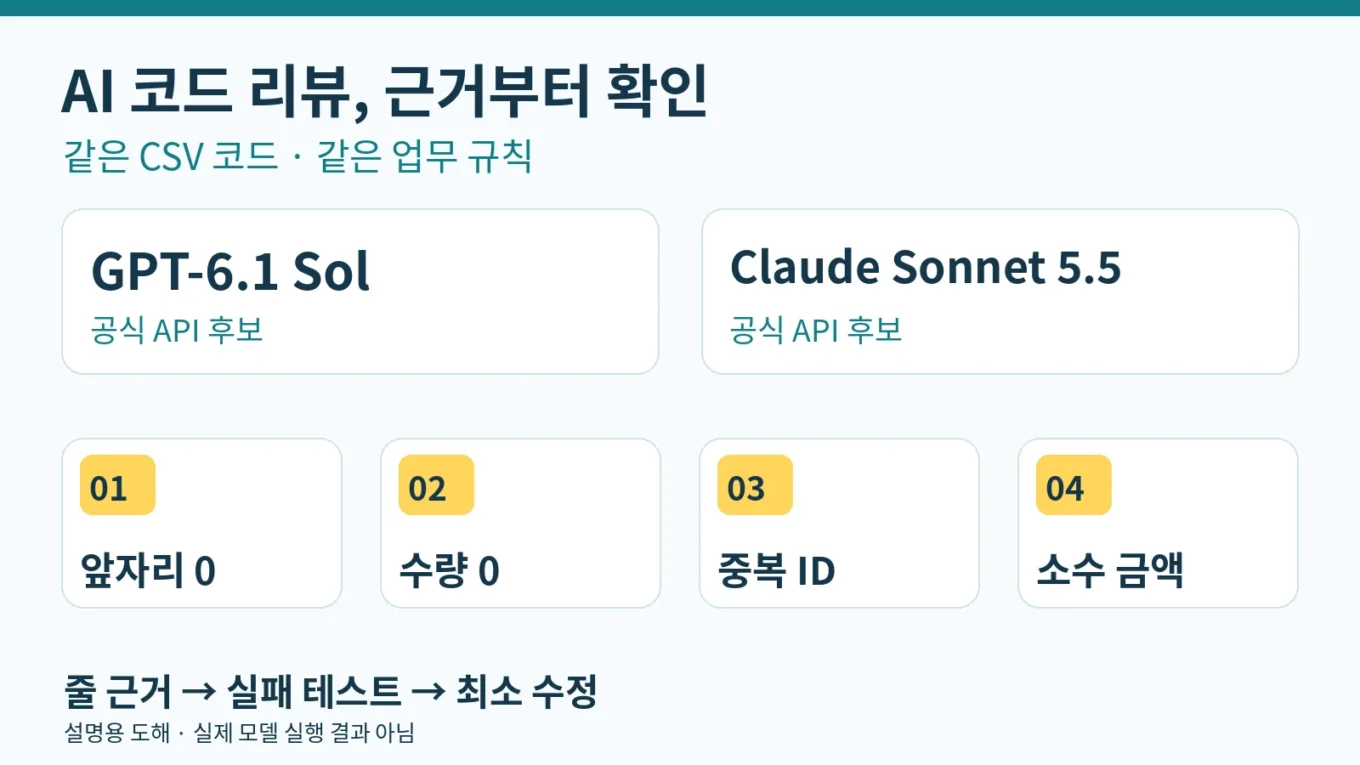
GPT-6.1 Sol·Claude Sonnet 5.5 코드 리뷰 비교: CSV 오류 4곳 검수
AI에게 코드를 검토해 달라고 했더니 오류 네 곳을 찾았다고 합니다. 설명이 길고 자신 있어 보여도 원본의 어느 줄이 업무 규칙을 어기는지, 수정 후에도 정상 행이 보존되는지는 따로 확인해야 합니다.
이번 글은 GPT-6.1 Sol과 Claude Sonnet 5.5로 짧은 Python CSV 로더를 검토하는 방법을 비교합니다. 두 모델의 현재 기본 입력·출력 단가는 같습니다. 기존 OpenAI 또는 Claude 연동에서 같은 코드와 계약으로 시작하고, 줄 근거·회귀 테스트·수정 범위를 대조하는 것이 실용적입니다. 어느 모델이 오류를 더 잘 찾는지는 이 글에서 측정하지 않았습니다.
공식 자료 확인과 오프라인 실습 검수 기준일은 2026년 10월 11일 한국시간입니다. 유료 API 호출은 0회이며, 아래 기대 리뷰와 수정 코드는 작성자가 만든 참조입니다. 실제 모델 응답·속도·정확도 결과가 아닙니다. 앱 구독료와 API 사용료도 구분합니다.
대표 이미지는 두 후보에 같은 CSV 코드와 업무 계약을 주는 설명용 도해입니다. 실제 앱 화면이나 모델 실행 결과를 재현하지 않았습니다.
같은 기본 단가에서 비교할 두 후보
공식 OpenAI 모델 문서와 Anthropic 모델 문서에서 일반 API 식별자를 확인했습니다. 비교 대상은 gpt-6.1-sol과 claude-sonnet-5-5입니다. OpenAI의 API 변경 기록은 Sol 6.1을 9월 29일에, Claude 문서는 Sonnet 5.5를 9월 28일에 출시한 것으로 안내합니다. 내부 도구 이름을 공개 모델의 출시 근거로 삼지 않았습니다. Sol 공식 모델 문서, OpenAI API 변경 기록, Sonnet 공식 모델 문서
| 후보 | 시작하기 좋은 상황 | 설정과 제한 |
|---|---|---|
| GPT-6.1 Sol | Responses API로 업무를 이미 관리하며 리뷰 결과를 후속 처리하는 경우 | reasoning.effort 기본은 medium. low·medium·high·xhigh·max를 지원하며 none·minimal은 지원하지 않습니다. 도구 호출은 Responses API 경로를 사용합니다. |
| Claude Sonnet 5.5 | Claude API의 메시지 흐름과 코드 검토 절차를 이미 쓰는 경우 | Adaptive thinking이 기본이며 API effort 기본은 high입니다. temperature·top_p·top_k를 기본과 다르게 지정하면 오류가 납니다. |
위 내용은 공식 기능과 기존 연동을 바탕으로 한 시험 시작 기준입니다. 같은 이름의 추론 수준이 동일 계산량을 뜻하지 않습니다. 두 모델 모두 이번 실습에서는 텍스트만 받고 도구를 사용하지 않도록 합니다. 실제 비교 기록에는 API 경로, 모델 ID, 추론 설정, 출력 한도, 원문 해시를 남기세요. Sol 설정, Sonnet 설정
현재 공식 가격과 가정 비용
아래는 Standard API의 미국 달러/100만 토큰 요율입니다. Sol은 입력 272K토큰 이하 요청, Sonnet은 현재 Claude API 기본 요율을 기준으로 합니다. 조회일은 2026-10-11 KST입니다. 소개 요금 종료일이 정해진 표가 아니라 현재 단가이며 향후 요청 때 다시 확인해야 합니다.
| 과금 항목 | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|
| 일반 입력 | $2.00 | $2.00 |
| 캐시 적중 입력 | $0.10 | $0.10 |
| 캐시 쓰기 | $2.50 | $2.50 (5분) / $4.00 (1시간) |
| 출력 | $10.00 | $10.00 |
현재 OpenAI 가격표와 Claude 가격표를 사용했습니다. Sonnet 출시문은 캐시 읽기를 $0.20로 적었지만 현재 모델 상세와 가격표는 $0.10으로 일치합니다. 이번 표는 현재 요금 문서를 기준으로 했습니다. 캐시 쓰기 요율은 일반 입력 요율에 더하는 추가 요금으로 계산하지 않습니다. 입력 토큰을 일반 입력·캐시 쓰기·캐시 적중에 맞게 나누어 계산해야 합니다.
Sol은 입력이 272K를 넘으면 요청 전체의 입력·캐시 요율이 2배, 출력 요율은 1.5배가 됩니다. OpenAI 캐시는 기본 활성화되어 있어 첫 쓰기가 발생할 수 있으며, 같은 코드 재사용이 항상 캐시 적중으로 이어지지는 않습니다. Sol의 최소 캐시 가능 가시 prefix는 1,024토큰, Sonnet의 최소 캐시 가능 길이는 512토큰입니다. Claude의 5분과 1시간 캐시도 구분합니다. OpenAI 캐시 조건, Sonnet 캐시 조건
산술 예: 캐시 쓰기·적중 없이 입력 8,000토큰 모두 일반 요율, 과금 출력 2,000토큰으로 가정하면 양쪽 모두 $2 × 8,000 ÷ 1,000,000 + $10 × 2,000 ÷ 1,000,000 = $0.036입니다. 같은 가상 요청 100회는 $3.60입니다. 이 실습의 토큰을 측정한 값이 아니며 실제 기본 캐싱이 있는 요청의 청구액을 예측한 표도 아닙니다. 추론 출력, 재시도, 도구, Batch, 속도 옵션, 지역 요금, 세금과 환율은 실제 사용 조건에 따라 따로 계산합니다.
검토할 코드와 네 가지 업무 계약
연습 자료는 실제 주문이나 개인정보를 쓰지 않은 합성 CSV입니다. 헤더는 id,qty,price,memo이며 정상 읽기·입력 검사는 동봉한 csv_contract.py가 맡습니다. 모델이 검토할 대상은 아래 flawed_loader.py의 load_items 함수입니다.
- id는 ASCII 숫자 1~32자리 문자열입니다. 앞자리 0을 보존하며
001과1은 서로 다른 ID입니다. - qty는 ASCII 숫자 1~6자리의 0 이상 정수입니다. 정상 수량 0을 1로 바꾸지 않습니다.
- price는 정수부 1~12자리와 소수부 정확히 두 자리인 0 이상 금액입니다. 원문 문자열에서 Decimal로 읽고 float를 경유하지 않습니다.
- 동일한 원문 ID가 반복되면 ValueError로 전체 읽기를 거부합니다. 첫 행이나 마지막 행으로 대체하지 않습니다.
메모는 해석된 문자열 기준 1,000자 이하이며 쉼표·따옴표·개행과 빈 문자열을 CSV 규칙대로 보존합니다. 잘못된 헤더, 열 수, 값은 제공 helper가 거부하며 모든 구현은 입력 파일을 읽기 전용으로 사용합니다. BOM 지원·성능·스타일 등은 이번 채점 범위에 없습니다.
"""Supplied review target. Four deliberate contract violations; read-only input."""
from csv_contract import iter_valid_rows


def load_items(path):
    items = {}
    for row in iter_valid_rows(path):
        key = str(int(row["id"]))
        qty = int(row["qty"]) or 1
        price = float(row["price"])
        items[key] = {"id": key, "qty": qty, "price": price, "memo": row["memo"]}
    return items
허용 오류 종류 네 개를 요청문에 미리 알려 줍니다. 따라서 이 과제는 정해진 계약과 줄 근거를 확인하는 제한된 리뷰 실습입니다. 미지의 오류를 찾는 능력을 측정하는 블라인드 벤치마크로 쓰지 않습니다.
두 모델에 같은 입력을 전달하는 방법
첨부의 review_input.txt 전체를 두 모델에 똑같이 전달합니다. 이 파일에는 공통 요청문과 파일별 행 번호 시작점을 설명한 원본 코드·정상 helper가 들어 있습니다. common_prompt_KO.txt는 같은 요청문을 따로 읽기 위한 파일입니다. 작성자 정답과 fixed_loader는 최초 입력에서 빼세요. 실제 모델 ID와 실행 ID를 미리 정해 요청문에 함께 적고, 같은 파일 해시를 사용합니다. 다음은 동봉된 공통 요청 전문입니다.
다음 합성 Python CSV 로더를 읽기 전용으로 검토하세요.
이 프롬프트는 어떤 모델에도 동일하게 사용합니다. 네트워크, 모델/API 호출, 설치, 파일 변경, subprocess는 수행하지 마세요. 코드 수정본을 실행하거나 원본 파일을 덮어쓰지 마세요.

입력 계약:
UTF-8 CSV 헤더는 id,qty,price,memo 순서입니다. csv_contract.py는 제공된 정상 읽기/검증 구현입니다. id는 ASCII 숫자 1~32자리 문자열이며 선행 0을 보존합니다. 001과 1은 다른 ID입니다. qty는 ASCII 숫자 1~6자리의 0 이상 정수이며 0을 보존합니다. price는 ASCII 숫자 1~12자리의 정수부와 정확히 두 자리 소수부이며 Decimal로 원문에서 직접 변환해야 합니다. 같은 원문 ID가 반복되면 ValueError로 전체 로드를 거부해야 합니다. memo는 최대 1,000개 디코딩 문자 길이이며, CSV 규칙으로 인코딩한 쉼표·따옴표·개행이 있을 수 있고 문자열을 보존합니다. 1,000개 문자 초과는 helper가 ValueError로 거부합니다. 잘못된 헤더/열 수/ID/수량/가격은 제공 helper가 거부합니다.

평가 범위:
아래 허용 ID에서 실제 계약 위반만 하나씩 보고하세요.
ID_LEADING_ZERO / QTY_ZERO / MONEY_FLOAT / DUPLICATE_ID
선행 0 제거에 따른 식별자 충돌은 ID_LEADING_ZERO의 영향입니다. 별도 결함으로 중복 집계하지 마세요. 임의 ID, 선택적 개선, CSV 수식 삽입, 성능, BOM, 스타일 등 계약 밖의 항목을 추가하지 마세요.

출력 형식:
Markdown 또는 코드펜스 없이 JSON 객체 하나만 반환하세요. 루트 키는 schema_version,provenance,model,run_id,source_sha256,findings입니다. schema_version은 "1.0", provenance는 "model_review"입니다. model과 run_id는 사용자가 전달한 실제 실행 식별자를 그대로 사용하세요. 사용자가 식별자를 전달하지 않았다면 model="USER_MUST_FILL_ACTUAL_MODEL", run_id="USER_MUST_FILL_ACTUAL_RUN"으로 남기며 실제 실행 정보를 지어내지 마세요.
source_sha256은 c18e096a2361659c764cdccc329c3622ce40bb78066fa2ca53d23a1c3b8dea48입니다.
findings의 각 객체 키는 id,file,line,snippet,explanation,recommendation입니다. file은 "flawed_loader.py"이고 line은 원본의 1부터 시작하는 정확한 행 번호입니다. snippet은 해당 원본 행에서 들여쓰기를 제외한 완전한 문장을 복사하세요. explanation과 recommendation은 한국어로 해당 계약, 실제 영향, 최소 수정 방향을 설명하세요. 실제로 실행하지 않은 테스트를 실행했다고 말하지 마세요.

검토 대상 원본은 review_input.txt에 제공됩니다. 그 안의 flawed_loader.py 부분과 csv_contract.py 부분을 읽으세요. 작성자 참조 정답이나 fixed_loader.py를 모델 입력으로 주지 않습니다.
프롬프트로 JSON을 요청해도 올바른 근거와 설명이 자동으로 보장되지는 않습니다. API의 구조화 출력 기능을 추가할 때는 지원 범위와 실제 요청 설정을 따로 기록합니다. 이번 실습 검사기는 모델 코드를 실행하지 않고 제출한 JSON만 읽습니다.
원본의 어느 줄을 확인할까요
다음 표는 작성자 참조 기준입니다. 숫자와 표현을 무조건 암기시키기보다, 해당 줄이 계약에 어떤 영향을 주는지 설명하게 하세요.
| 원본 줄 | 오류와 영향 | 최소 수정 방향 |
|---|---|---|
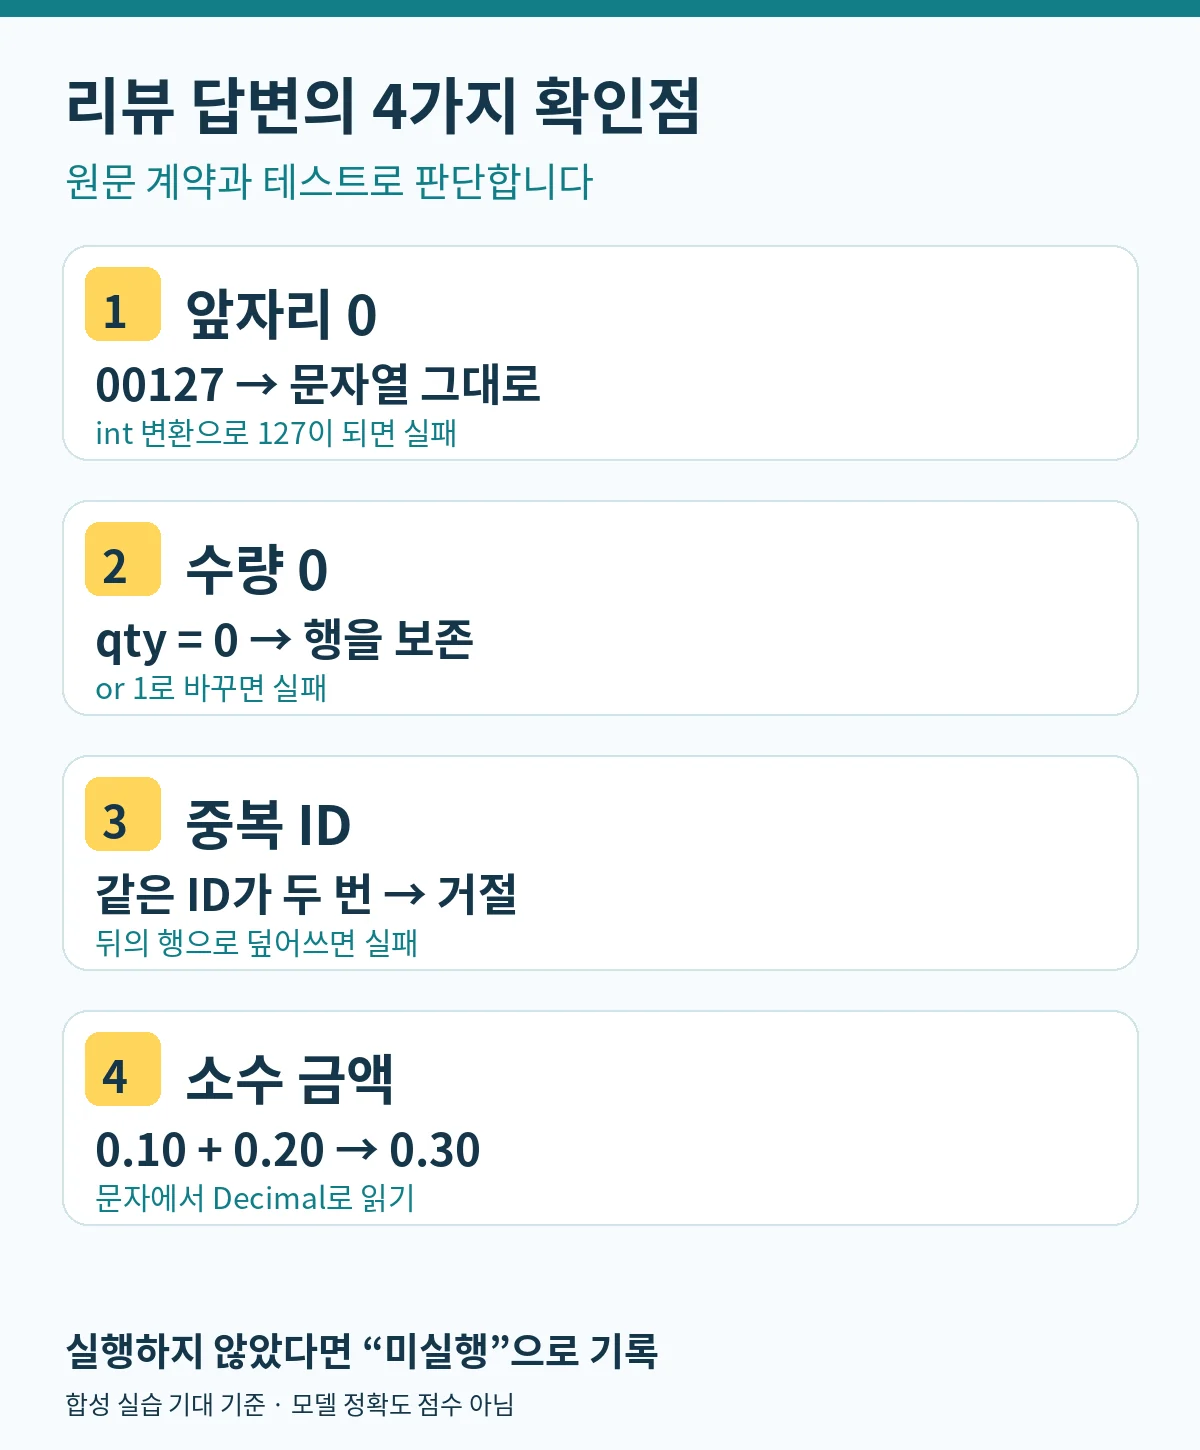
| 8 | str(int(row[“id”]))는 00127을 127로 바꿉니다. 001과 1의 충돌도 이 변환의 영향입니다. | 원문 row[“id”] 문자열을 그대로 사용합니다. |
| 9 | int(row[“qty”]) or 1은 수량 0을 1로 바꿉니다. | int 변환 결과를 그대로 사용합니다. |
| 10 | float(row[“price”])는 정확한 십진 금액 계약을 어깁니다. 0.10 + 0.20은 float에서 0.30000000000000004가 될 수 있습니다. | Decimal을 원문 문자열에서 직접 만듭니다. |
| 11 | 같은 키에 다시 대입하면 앞의 행을 덮어씁니다. | 원문 ID의 중복을 대입 전에 검사하고 ValueError를 발생시킵니다. |
실제 오류라고 볼 근거 없이 보안 문제나 성능 개선을 덧붙이지 않습니다. 앞자리 0 제거와 그로 인한 충돌을 두 개의 독립 결함으로 세면 같은 원인을 중복 집계하게 됩니다. float와 십진수의 차이는 Python 부동소수점 설명과 Decimal 공식 문서에서도 확인할 수 있습니다.
수정 코드는 실패 테스트부터 확인합니다
첨부의 fixed_loader.py는 작성자 참조 코드입니다. 원문 ID를 유지하고 중복을 거절하며 가격은 Decimal로 읽습니다. total_value는 이 로더가 만든 소수부 두 자리 금액만 받아 정수 센트로 합산한 뒤 Decimal을 구성합니다. 호출자의 Decimal 정밀도 설정에 기대지 않으며 파일을 저장하지 않습니다. 임의 Decimal 객체를 받는 일반 금액 계산기가 아닙니다.
작성자 참조 수정 코드 전체 보기
"""Author reference implementation; this is not an output from either model."""
from decimal import Decimal
from csv_contract import iter_valid_rows


def load_items(path):
    items = {}
    for row in iter_valid_rows(path):
        key = row["id"]
        if key in items:
            raise ValueError(f"duplicate id: {key}")
        items[key] = {
            "id": key,
            "qty": int(row["qty"]),
            "price": Decimal(row["price"]),
            "memo": row["memo"],
        }
    return items


def total_value(items):
    """Exact cents arithmetic, independent of the caller's Decimal context.

    Accepts only records produced by load_items (two fractional price digits).
    No float conversion, rounding, mutation, file write, or network operation.
    """
    cents = 0
    for item in items.values():
        value = item["price"].as_tuple()
        coefficient = int("".join(str(digit) for digit in value.digits))
        cents += coefficient * item["qty"]
    digits = tuple(int(digit) for digit in str(cents))
    return Decimal((0, digits, -2))
코드를 제안했다는 말과 테스트를 실제 실행했다는 말을 구별하세요. 최초 리뷰는 읽기 전용으로 받고, 수정본은 원본과 별도 사본으로 보관합니다. 사람이 변경 내용을 확인한 뒤 네트워크·비밀정보 없는 별도 실습 환경에서 다음 사례를 검사합니다.
- leading_zero.csv: 원문 ID가 바뀌지 않고 001과 1이 별도 키로 남는지
- zero.csv: qty 0 행이 남고 수량도 0인지
- duplicate.csv: 동일 ID 반복이 ValueError이며 부분 결과를 반환하지 않는지
- money.csv: 수량 1의 0.10과 0.20을 합쳐 Decimal(‘0.30’)이 되는지
- normal.csv와 multiline.csv: 정상 값과 여러 줄 메모가 보존되는지
- 잘못된 헤더·열 수·음수·NaN·공백·지수 금액 등: 계약대로 거부되고 입력 바이트가 바뀌지 않는지
실습 ZIP을 내려받아 검산하기
ZIP 크기는 22871바이트이며 SHA-256은 cbda103dae52b7bad3232a4c5573ec63c9c4ffd323922262aa6ab70d415a3faf입니다. Python 3.10 이상과 표준 라이브러리만 사용합니다. API 키·개인정보·매크로·자동 모델 호출이 없습니다.
전체를 새 폴더에 풀고 동봉된 README의 순서대로 검사합니다.
python3 verify_manifest.py
python3 -m unittest discover -s tests -v
python3 verify_review.py expected_reference_review.json --allow-author-reference
python3 verify_review.py response.json
앞의 세 명령은 패키지 해시·작성자 참조·오프라인 테스트를 확인합니다. 마지막 명령은 모델 원본 JSON을 response.json으로 저장한 뒤 사용하는 제출 응답 검사입니다. 참조 정답에는 author_reference 표식이 있어 별도 옵션 없이 모델 응답처럼 검사하면 거부됩니다. 빈 템플릿도 정답 응답으로 통과하지 않습니다.
게시 전 검수에서는 Linux의 Python 3.12.14에서 동봉된 52개 단위테스트 메서드(로더 25개·검사기 27개)를 확인했습니다. 이는 작성자 코드와 검사기의 유한한 합성 사례 검증입니다. 같은 테스트를 다시 실행한 횟수나 한 메서드 안의 반복 입력을 새 테스트 수로 더하지 않았습니다. 두 모델의 검출률을 뜻하지 않습니다.
검사기는 JSON 키·자료형·네 ID의 중복과 누락·정확한 원본 줄 번호와 문장·원본 해시를 검사합니다. explanation과 recommendation이 비어 있는지도 봅니다. 그러나 설명의 의미, 수정의 안전성, 실제 모델 실행 여부는 증명하지 않습니다. 문자열만 그럴듯하게 채워도 구조 검사를 통과할 수 있어 사람이 계약·영향·수정 방향을 읽어야 합니다. 자동 통과 문구를 ‘모델 리뷰 완성’으로 바꾸지 마세요.
오류가 나면 복구할 위치를 좁힙니다
- 줄 번호·원문이 다르면 먼저 파일 해시와 줄 번호 시작점을 맞춥니다. 모델 답을 손으로 수정하기 전에 원본 응답을 보관하고 불일치를 새 요청에 전달합니다.
- 원문 밖 결함을 만들거나 같은 원인을 중복 보고하면 네 계약과 허용 ID를 다시 제시합니다. 최초 리뷰의 오탐은 수정 후 사라졌어도 기록에 남깁니다.
- JSON 오류·출력 잘림은 내용 평가와 구분합니다. 완료 상태와 출력 한도를 확인하고 새 실행 ID로 다시 받습니다.
- 수정 코드가 정상 행을 잃거나 입력을 쓰려 하면 적용을 보류합니다. 작은 사본과 실패 테스트에서 다시 확인한 뒤 전체 회귀 테스트를 돌립니다.
- 인증·권한·한도 문제는 모델 능력의 실패로 세지 않습니다. 계정 보안이나 결제 설정부터 바꾸지 않습니다.
어느 모델을 선택할까요
이 짧은 작업에서는 두 모델의 기본 단가가 같으므로 기존 API 연동을 유지하는 후보부터 시험하는 편이 부담이 적습니다. Sol은 Responses 중심 후속 처리에, Sonnet은 기존 Claude 메시지 흐름에 연결할 때의 편의성을 따져볼 수 있습니다. 두 모델 모두 실제 줄 근거와 테스트에서 확인해야 하며, 단가표만으로 버그 검출 능력이나 처리 속도를 선택할 수는 없습니다.
run_records.csv는 빈 기록 양식입니다. 모델·설정·첫 리뷰의 근거 충족과 오탐·사람의 검토 시간·수정 횟수·실제 입력/캐시/출력 사용량·실제 청구액을 구분해 남깁니다. 같은 고정 과제의 첫 리뷰와 수정 리뷰를 하나의 새 성공 과제로 두 번 세지 않습니다. 실행하지 않은 값은 비워 둡니다.
제조사의 출시문에는 자체 코딩 평가가 있고 SWE-bench Verified는 실제 저장소 문제를 다루는 평가입니다. 사용한 에이전트·도구·추론 설정·시도 예산이 다를 수 있어 여러 발표 점수를 합쳐 단일 순위를 만들지 않았습니다. 특히 여기의 허용 오류 ID가 공개된 작은 CSV 실습은 그 평가와 다른 과제입니다. OpenAI 자체 발표, Anthropic 자체 발표, SWE-bench Verified 평가 설명
이번 글에서 확인한 것은 현재 공식 모델·단가·기능과 동봉한 합성 실습의 검수 기준입니다. 두 모델의 같은 조건 첫 응답, 수정 횟수, 속도와 실제 비용 비교는 후속 실행 자료가 필요한 상태입니다. 전체 모델 선택 배경은 GPT·Claude·Gemini 5종 비교를 참고하세요.
원고 작성: GPT-6.1 Sol. 공식 자료 대조·합성 실습 코드 검수 기준일: 2026-10-11 KST. 작성자 참조와 실제 모델 실행을 구분했습니다.
작성자 소개
