GPT·Claude·Gemini Batch 비교: 대량 요청 결과의 누락·중복 확인
AI에 공지 1,000건을 한꺼번에 맡기고 결과 파일에서 1,000줄을 받았다면 작업이 끝난 걸까요? 같은 요청의 결과가 두 번 들어오고 다른 요청 하나가 빠졌다면 줄 수가 맞아도 원본과 일치하지 않습니다. 대량 처리에서는 각 결과를 원본 요청에 정확히 연결하는 검수가 필요합니다.
이번 글은 GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash의 Batch API를 결과 대조와 실패 복구 관점에서 비교합니다. 기존 API 연동에서 요청 ID, 완료 상태, 성공·오류 결과를 관리하는 방법과 비용을 함께 살펴봅니다. 동일 자료로 정확도·처리 시간·실패율을 측정한 모델 순위는 제시하지 않습니다.
공식 문서 확인 기준일은 한국시간 2026년 10월 14일입니다. 이 비교를 위해 실행한 유료 모델 API 호출은 0회입니다. 아래 공지, 결과 로그, 기대 분류는 작성자가 만든 합성 자료입니다. 실제 서비스 장애 기록이나 모델 응답이 아니며, 실습은 인터넷과 API 키 없이 결과를 대조하는 연습입니다.
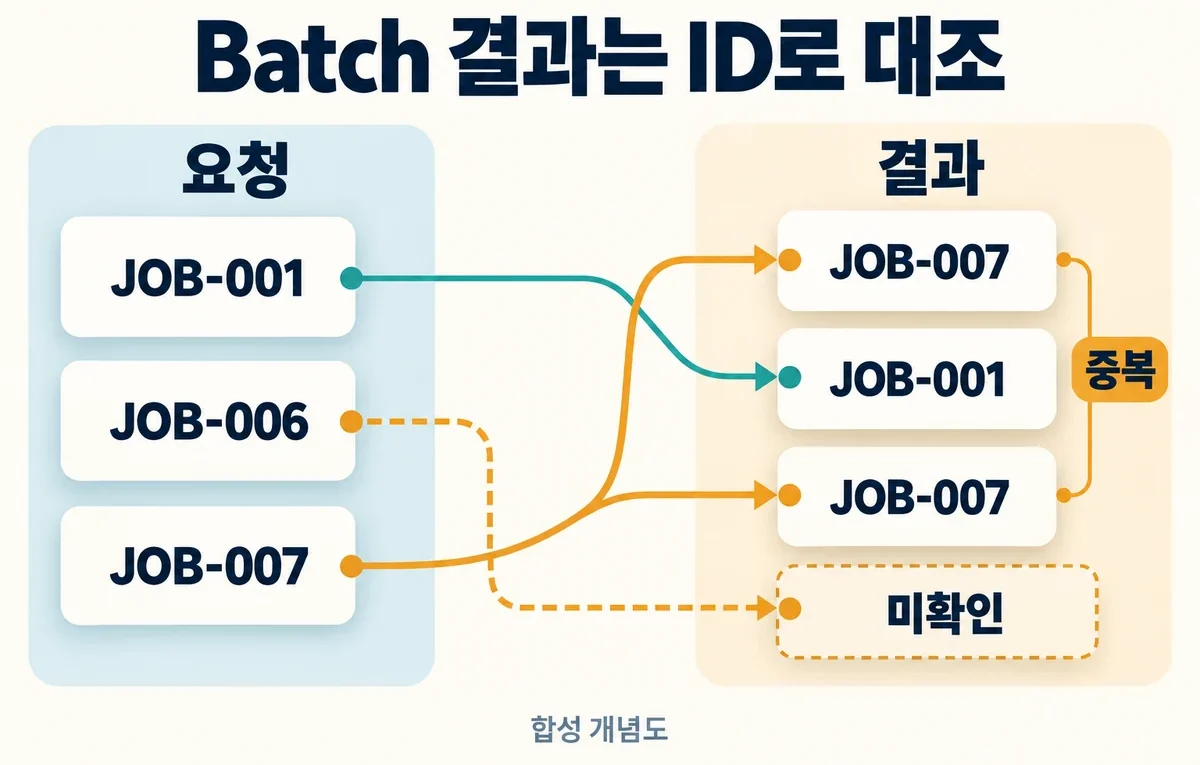
대표 도해: 작성자가 만든 합성·오프라인 결과 대조 개념도이며 일부 ID만 보여 줍니다. 실제 모델 응답·API 화면·성능 순위가 아닙니다.
Batch는 답을 기다릴 수 있는 작업에 씁니다
Batch는 여러 요청을 비동기로 처리하는 방식입니다. 요청 묶음이 접수된 상태와 각 요청의 최종 결과가 나온 상태를 구분해야 합니다. 고객에게 곧바로 보여 줄 답변이나 정해진 시각까지 반드시 끝내야 하는 업무에는 처리 조건부터 확인하세요.
OpenAI는 Batch의 24시간 처리 창과 Standard 대비 50% 할인을 안내합니다. Claude는 24시간 안에 완료되지 않은 요청이 만료될 수 있다고 설명하고, Gemini는 24시간을 목표 처리 시간으로 안내합니다. 이 설명들을 ‘모든 요청이 어떤 상황에서도 24시간 안에 성공한다’는 공통 보장으로 해석하면 안 됩니다. OpenAI Batch, Claude Batch, Gemini Batch
모델과 API 경로를 함께 고정합니다
| 후보와 공식 API ID | 이번 비교의 경로 | 결과 대조에서 확인할 점 |
|---|---|---|
| GPT-6.1 Sol · gpt-6.1-sol | Batch의 /v1/responses 요청 | 성공 output_file_id와 오류 error_file_id를 모두 확인하고 custom_id로 원본 요청에 연결 |
| Claude Sonnet 5.5 · claude-sonnet-5-5 | Message Batches | ended는 처리 종료를 뜻함. 각 custom_id의 succeeded·errored·canceled·expired를 따로 확인 |
| Gemini 3.8 Flash · gemini-3.8-flash | generateContent의 Batch | Interactions와 구분. 입력 형식과 SDK·REST 경로에 맞춰 결과와 요청 메타데이터를 보관 |
세 모델의 공식 문서에서 Batch 지원 또는 Batch 요금을 확인했습니다. 모델명만 기록하지 말고 정확한 API ID와 사용 경로를 함께 남기세요. 공개 문서에 지원이 표시되어 있어도 특정 계정의 실제 호출 권한을 확인한 것은 아닙니다. Sol 모델, Sonnet 모델, Flash 모델
결과 순서는 제공사별로 확인합니다
OpenAI와 Claude는 출력 순서가 입력 순서와 다를 수 있다고 명시합니다. 입력과 출력의 첫 번째 행끼리 연결하지 말고 custom_id로 대조하세요. OpenAI에서 성공 파일만 내려받고 오류 파일을 놓치면 실패한 요청이 단순 누락처럼 보일 수 있습니다. OpenAI 결과 조회, Claude 결과 조회
Gemini 가이드는 JSONL 입력에 key를 붙이는 예를 보여 줍니다. REST 참조는 requests의 metadata와 응답 metadata를 정의하고, 해당 output의 파일·inline 결과를 입력과 같은 순서로 반환한다고 설명합니다. 따라서 세 제공사의 출력 순서가 모두 뒤섞인다고 단정하면 부정확합니다. SDK의 dest.file_name과 REST의 output.responsesFile도 구분해야 합니다. 실제 사용하는 경로의 ID·메타데이터·순서 규약을 확인하고 원응답을 보관하세요. 이번 실습의 공통 JSONL은 작성자가 만든 별도 형식으로, 제공사의 원응답을 그대로 읽는 기능은 없습니다. Gemini 입력 예, Gemini REST의 InlinedRequest·GenerateContentBatchOutput·InlinedResponse
ID는 원본과 결과를 연결하는 열쇠입니다. 같은 ID로 다시 요청한다고 서비스가 중복 실행을 자동으로 막아 주는 것은 아닙니다. 원본 업무 ID와 함께 제공사(provider), 모델, 작업 ID(job ID), 시도 ID, 입력 해시를 관리해야 최초 요청과 재요청을 구별할 수 있습니다.
현재 Batch 단가와 1,000건의 가정 비용
아래는 각 제공사의 직접 API를 사용하는 유료 텍스트 요청의 비캐시 Batch 단가입니다. 단위는 미국 달러/100만 토큰이며, Sol은 개별 요청의 입력이 272,000토큰 이하인 조건입니다.
| 모델 | Batch 입력 | Batch 과금 출력 | Standard 입력 / 출력 |
|---|---|---|---|
| GPT-6.1 Sol | $1.00 | $5.00 | $2.00 / $10.00 |
| Claude Sonnet 5.5 | $1.00 | $5.00 | $2.00 / $10.00 |
| Gemini 3.8 Flash | $0.375 | $1.875 | $0.75 / $3.75 |
Flash의 표에 적힌 가격은 2026-12-31까지 적용되는 소개 요금입니다. 2027-01-01부터 Batch 입력·출력은 $0.75/$3.75로 공지되어 있습니다. Sol의 장문 할증은 개별 요청의 입력 길이에 적용됩니다. 작은 요청 1,000개의 토큰 합계가 272K를 넘었다는 이유만으로 각 요청에 장문 요금을 적용하지 않습니다. OpenAI 가격표, Claude Batch 가격, Gemini 가격표의 모델별 Batch 탭
요청마다 과금 입력 1,500토큰, 과금 출력 250토큰을 사용하고 이런 요청이 1,000건이라고 가정하겠습니다. Batch 합계는 Sol과 Sonnet이 각각 $2.75, Flash가 $1.03125입니다. 같은 가정으로 계산한 Standard 합계는 각각 $5.50, $5.50, $2.0625입니다.
Sol의 Batch 계산식은 (1,500 × $1 + 250 × $5) ÷ 1,000,000 × 1,000 = $2.75입니다. 이 토큰 수와 금액은 뒤에 나오는 짧은 공지를 실제로 토큰화하거나 청구받은 결과가 아닙니다. 같은 한국어 입력도 모델마다 토큰 수가 다를 수 있습니다. 과금 출력에는 해당 API가 청구하는 추론 분량을 포함하고, 캐시·도구·지역 요금·세금·환율·재요청 비용은 별도로 계산하세요.
현재 공개 목록과 저비용 후보도 확인합니다
2026-10-14에 조회한 공식 Gemini 목록에는 Gemini 4 Argon의 공개 API ID gemini-4-argon과 Stable 상태가 표시되어 있습니다. 모델 문서도 Batch 지원을 명시합니다. 현재 Batch 소개 요금은 입력 $1·출력 $5로 2026-11-30까지 적용되며, 2026-12-01부터는 $2/$10입니다. Free tier와 Google AI Pro에서는 이용할 수 없다고 안내합니다. 10월 6일의 기존 5종 비교에 기록한 제한 배포 상태를 현재 상태로 읽지 않도록 확인 날짜를 구분하세요. 현재 Gemini 목록, Argon 모델, 현재 Argon 요금
짧고 단순한 추출 업무라면 저비용 후보도 별도 표본으로 시험할 수 있습니다. GPT-6 Luna는 개별 요청의 입력이 272,000토큰 이하일 때 Batch 입력·출력 단가가 $0.05/$0.25입니다. 이를 넘으면 요청 전체에 $0.10/$0.375를 적용합니다. Claude Haiku 5.5는 개별 prompt가 100,000토큰 이하일 때 $0.05/$0.25이며, 이보다 긴 요청은 $0.25/$1.25입니다. 가격이 낮다는 이유로 같은 정답률을 기대해서는 안 됩니다. 세 비교 후보와 저비용 후보의 기록을 구분하고, 같은 공지와 검수 기준으로 비교하세요. Luna 가격, Haiku 모델과 길이 조건, Haiku Batch 가격
요청 목록을 먼저 고정합니다
실습에서는 가상 공지 8개의 날짜와 행사명을 각각 추출한다고 가정합니다. 공지 한 문장과 공통 요청을 한 건씩 전달하며, 기대 정답은 모델에 미리 보여 주지 않습니다. 첨부의 request_manifest.json은 작성자의 기대 정답을 포함한 검수용 목록입니다. 모델 입력에는 정답 없는 input_notices.txt의 원문 한 문장과 prompt.txt만 사용하세요.
공통 요청의 핵심은 다음과 같습니다.
제공한 공지 한 문장에서 날짜와 행사명을 추출한다. date는 YYYY-MM-DD 문자열, event는 원문의 행사명 문자열이다. 두 키만 가진 JSON 객체 하나를 반환한다. 원문에 없는 정보를 추측하지 않는다. 요청 ID나 실행 정보를 본문에서 만들어 내지 않는다.
전송·시도 ID는 요청을 만드는 쪽에서 붙입니다. 실제 API의 구조화 출력을 사용할 때는 지원하는 스키마와 완료·거절 상태를 별도로 확인하세요. 첨부의 기대 정답은 날짜와 행사명이 모두 명시된 공지 8개에만 적용됩니다. 날짜가 없는 공지 등 다른 입력의 처리까지 검증한 일반 추출기는 아닙니다.
9줄 결과에서 8개 원본을 대조합니다
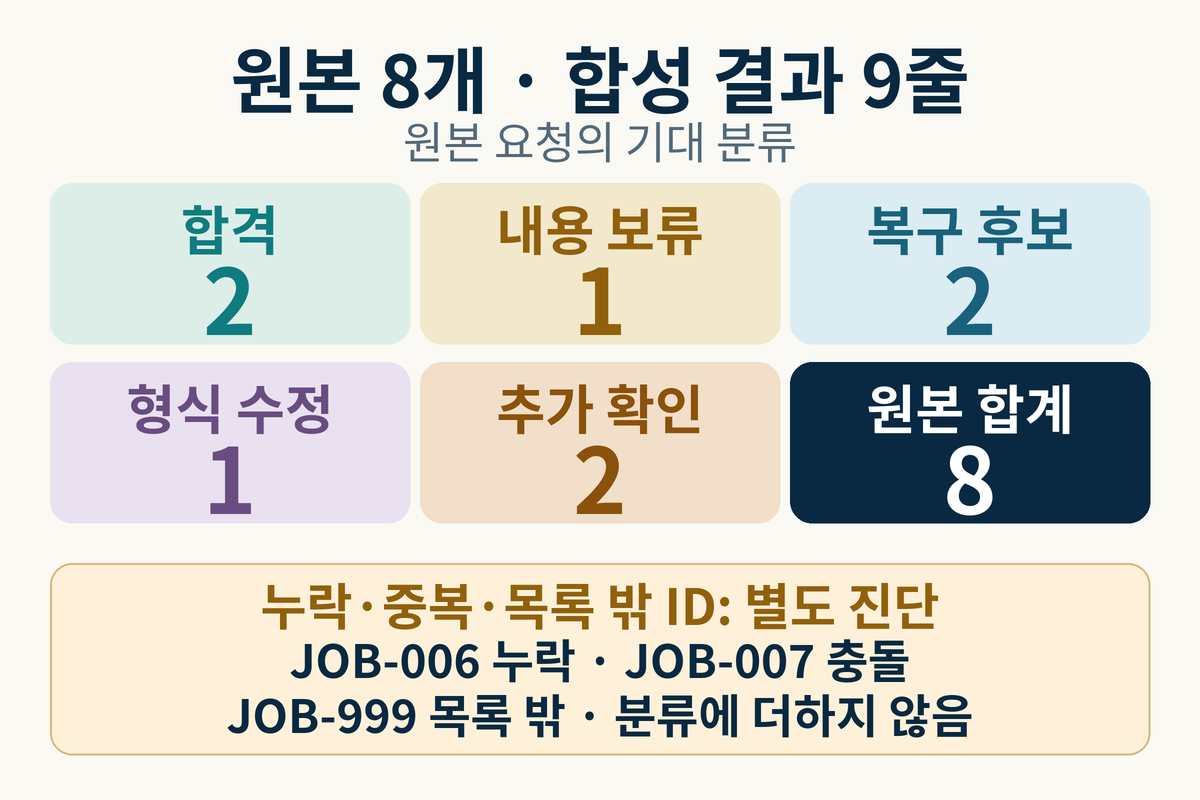
synthetic_results.jsonl은 결과 순서를 섞고 누락·중복·오류를 넣은 작성자의 합성 로그입니다. JOB-007의 결과가 두 번 나오고, 원본에 없는 JOB-999의 결과가 한 줄 들어 있습니다. JOB-006의 결과는 없습니다. 결과가 9줄이라는 이유로 원본 요청 8개를 모두 처리했다고 판단하면 안 됩니다.
| 원본 요청 | 합성 로그에서 확인한 내용 | 기대 처리 |
|---|---|---|
| JOB-001 | success, 날짜·행사명이 기대 정답과 일치 | accepted |
| JOB-002 | success, 정답 날짜는 2026-10-21이나 결과는 2026-10-22 | quality_hold |
| JOB-003 | errored, server_error | retry_candidate |
| JOB-004 | errored, invalid_request | fix_before_retry |
| JOB-005 | expired | retry_candidate |
| JOB-006 | 결과 없음 | investigate |
| JOB-007 | 서로 충돌하는 성공 결과 두 줄 | investigate |
| JOB-008 | success, 날짜·행사명이 기대 정답과 일치 | accepted |
JOB-999는 원본 요청 목록 밖의 결과로 분리합니다. accepted 2건, quality_hold 1건, retry_candidate 2건, fix_before_retry 1건, investigate 2건을 더하면 원본 요청 8건입니다. 누락·중복·목록 밖 ID는 별도 진단이므로 이 숫자를 최종 분류에 더하지 않습니다.
retry_candidate는 복구를 검토할 후보라는 뜻입니다. 실습 파일을 실행해도 요청을 재전송하지 않습니다. 실제 재요청은 API별 상태와 청구 조건, 원본·시도 기록을 확인한 뒤 필요한 건만 별도로 실행해야 합니다.
누락과 실패를 분리해 복구합니다
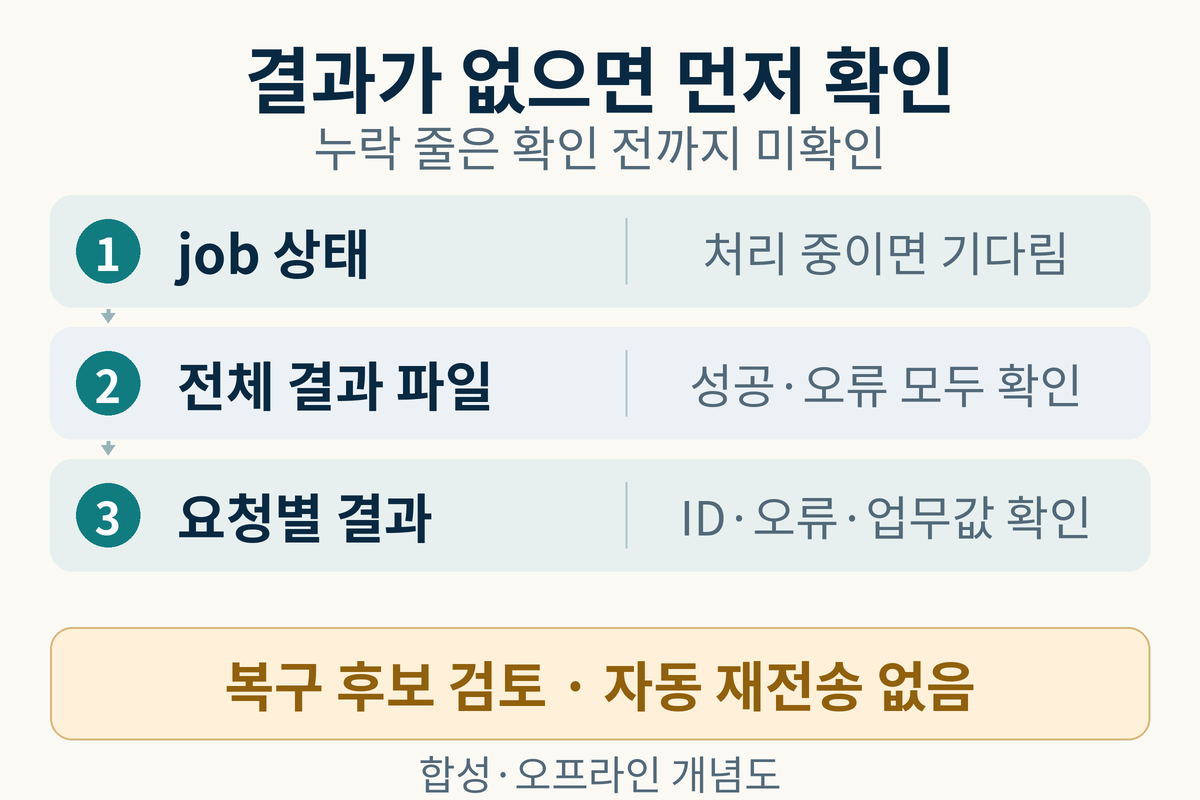
- 전체 작업(job)의 상태를 확인합니다. 아직 실행 중이라면 결과가 보이지 않는 요청은 기다려야 할 대상일 수 있습니다.
- 성공·오류 파일과 다운로드 범위를 확인합니다. 내려받은 파일 일부에 결과가 없다는 사실만으로 요청 실패를 확정하지 않습니다.
- 각 결과를 제출 목록에 연결합니다. 알 수 없는 ID와 중복 결과는 분리해 보관하고, 마지막 줄로 앞선 결과를 덮어쓰지 않습니다.
- 전송 성공을 확인한 뒤 날짜·행사명도 대조합니다. 전송 성공(transport success)과 업무 검수 통과를 각각 기록합니다.
- 오류 원인에 맞춰 복구 후보를 정합니다. invalid_request는 요청 형식을 고친 뒤 검토합니다. 만료·서버 오류는 실제 상태와 재시도 가능 조건부터 확인합니다.
- 다시 요청한다면 별도의 시도 ID와 작업 ID로 기록합니다. 승인한 결과 버전을 명시해, 뒤늦게 도착한 최초 결과가 새 결과를 덮어쓰지 않게 합니다.
OpenAI는 만료된 묶음에서도 완료된 요청의 결과를 제공하고, 완료된 요청에서 소비한 토큰에 과금한다고 안내합니다. Claude는 errored·canceled·expired 요청에 과금하지 않는다고 설명합니다. 이 규칙을 Gemini나 모든 종류의 요청 오류에 그대로 적용하지 마세요. 원응답의 usage와 계정 청구 내역을 보관하고 제공사별로 검산해야 합니다. OpenAI 만료 처리, Claude 결과 유형
오프라인 실습 파일로 확인하는 순서
첨부에는 검수용 요청 목록, 공지 원문·공통 요청, 작성자의 합성 결과, 기대 요약, Python 대조기와 단위검사, 빈 실행 기록표가 들어 있습니다. API 키·개인정보·실제 모델 응답은 없으며 유료 API를 호출하지 않습니다. 대조기는 실습용 공통 형식만 읽습니다. 실제 세 API의 원응답을 자동 변환하는 클라이언트는 포함하지 않습니다.
ZIP을 새 폴더에 풀고 README_KO.md를 읽으세요. Python 3.10 이상과 표준 라이브러리만 사용합니다. 압축을 푼 폴더에서 다음 두 명령을 실행합니다.
python -B reconcile.py
python -B -m unittest discover -v
첫 번째 명령의 출력을 expected_summary.json과 대조하세요. 두 번째 명령은 대조 로직의 단위검사를 실행합니다. 두 명령은 제공된 입력·결과 파일을 덮어쓰지 않으며 출력은 화면으로 나옵니다. 잘못된 입력은 종료 코드 2로 거부하고, 일부 정상 행만 먼저 합격 처리하지 않습니다. 실습 ZIP 다운로드 · 17,480바이트 · ZIP CRC 검사 통과.
SHA-256:
267518aac2c4c90817deddfe25b450be28b6267ab8f246c7ea8a95fc5475235b로컬 검수에서 대조기의 단위검사 39개가 모두 통과했습니다. 작성자가 만든 대조 로직과 정해진 합성 사례를 검증한 결과입니다. 모델 시험 39회, 실측 정확도, 재시도 성공률을 의미하지 않습니다.
Python 없이도 원본 요청 ID 8개를 기준으로 각 ID가 결과에 몇 번 나오는지 확인할 수 있습니다. 요청 목록에서 한 건씩 대조하는 것이 핵심입니다. 이 예제에서는 행 순서대로 연결하거나 중복 ID를 마지막 결과로 덮어쓰면 올바른 검수 결과를 얻을 수 없습니다.
실제 API에 연결하려면 별도 어댑터가 필요합니다. 사용하는 경로의 요청 식별자를 내부 request_id에 연결하고, 제공사별 결과 상태를 실습 스키마에 옮기는 기준부터 정하세요. 변환 전 원응답과 오류 정보, usage, 모든 시도의 기록을 보관하고 성공·오류 산출물을 빠짐없이 확보했는지도 확인해야 합니다. 첨부는 이 변환이나 산출물 완전성 확인을 구현하지 않습니다.
공개 벤치마크의 평가 범위도 구분합니다
GDP.xlsx의 공개 절차는 Harbor·OpenHands 도구 환경에서 과제당 5회 시도하고 최종 답변의 채점 항목을 평가합니다. 오류가 발생한 시도는 평균에서 제외하고 정상 결과가 없는 과제는 누락으로 남깁니다. 이는 엑셀 추론 평가의 조건입니다. Batch 다운로드의 완전성, 재요청 중복, 업무 결과 채택률을 측정한 값으로 사용할 수는 없습니다. 이번 합성 로그의 검산 결과도 세 모델의 실측 정확도에 포함하지 않습니다. GDP.xlsx 평가·집계 방법
내 업무에서 선택할 때 남길 기록
기존 Responses 연동에서 성공·오류 파일을 관리할 수 있다면 Sol, Claude의 결과 유형별 회수를 이미 운영한다면 Sonnet, generateContent Batch의 파일·메타데이터를 관리한다면 Flash부터 같은 표본으로 시험할 수 있습니다. 저비용 Luna·Haiku나 현재 공개 API ID가 확인된 Argon을 추가할 때도 같은 추출 계약과 검수표를 적용하세요. 이 시작 순서는 기존 운영 조건과 공식 단가를 기준으로 한 제안입니다.
비교 기록에는 다음 항목을 남기세요.
- 모델·API 경로·추론 설정, 원본 입력 해시
- 제출·완료·다운로드 시각, 제공사 작업 ID, 시도 ID
- 전송 성공 수, 업무 검수 통과 수, 보류·재요청 수
- 실제 API 비용과 사람의 검수 시간
최초 요청과 재요청의 API 비용 합계를 검수에 통과한 고유 업무 ID 수로 나누면 유효 결과당 API 비용을 계산할 수 있습니다. 같은 업무 ID의 재시도를 분모에 여러 번 넣지 마세요. 통과한 ID가 0개라면 계산 불가로 남깁니다.
첨부의 run_log.csv는 독자가 직접 측정한 값을 적는 빈 기록틀입니다. 대조기가 실제 비용·시간이나 작업 ID를 자동 수집하지 않으며, 산출물 완전성 확인 열이 있다는 이유로 완전성이 검증된 것은 아닙니다. 측정하지 않은 값은 0으로 채우지 말고 빈칸으로 두세요.
Batch를 선택할 때는 할인율과 함께 모든 제출 ID의 상태를 설명할 수 있는지 확인해야 합니다. 검수 통과·보류·확인된 실패·추가 확인 대상까지 원본 요청에 연결되어야 다음 처리를 결정할 수 있습니다. 관련 비용 설계는 반복 질문의 프롬프트 캐시 비교에서, 모델 선택의 배경은 5종 성능·가격 비교에서 이어서 볼 수 있습니다.
작성자 소개
