병합 셀이 있는 양식에서 헤더와 데이터 행을 구분해 읽기
엑셀 양식의 맨 위에 큰 병합 제목이 있고 그 아래에 표가 이어지면, 첫 번째 줄을 헤더로 읽는 코드부터 어긋날 수 있습니다. 데이터 중간의 병합도 주의해야 합니다. 화면에서 하나로 보이는 수량을 여러 행에 나눠 넣을지, 한 행에만 기록할지는 셀 모양만으로 결정하기 어렵습니다.
이 실습은 읽을 위치를 먼저 정합니다. Data 시트의 2행을 헤더, 3~5행을 데이터, A~C열을 대상 열로 사용합니다. 제목의 A1:C1 병합은 허용하고, 헤더나 데이터 영역에 닿는 병합은 진단을 남긴 뒤 전체 추출을 거부합니다. 원본 XLSX를 저장하지 않고 새 JSON 파일만 만듭니다.
병합 양식 읽기 실습 ZIP 다운로드에는 전체 코드, 가상 XLSX, 기대 JSON과 검증 자료가 들어 있습니다. 실제 개인정보를 사용하지 않았습니다. 조사·실행 검수일은 2026년 10월 11일이며, Linux의 Python 3.12.14와 openpyxl 3.1.5에서 확인했습니다.
1. 제목, 헤더, 데이터의 위치를 따로 정하기
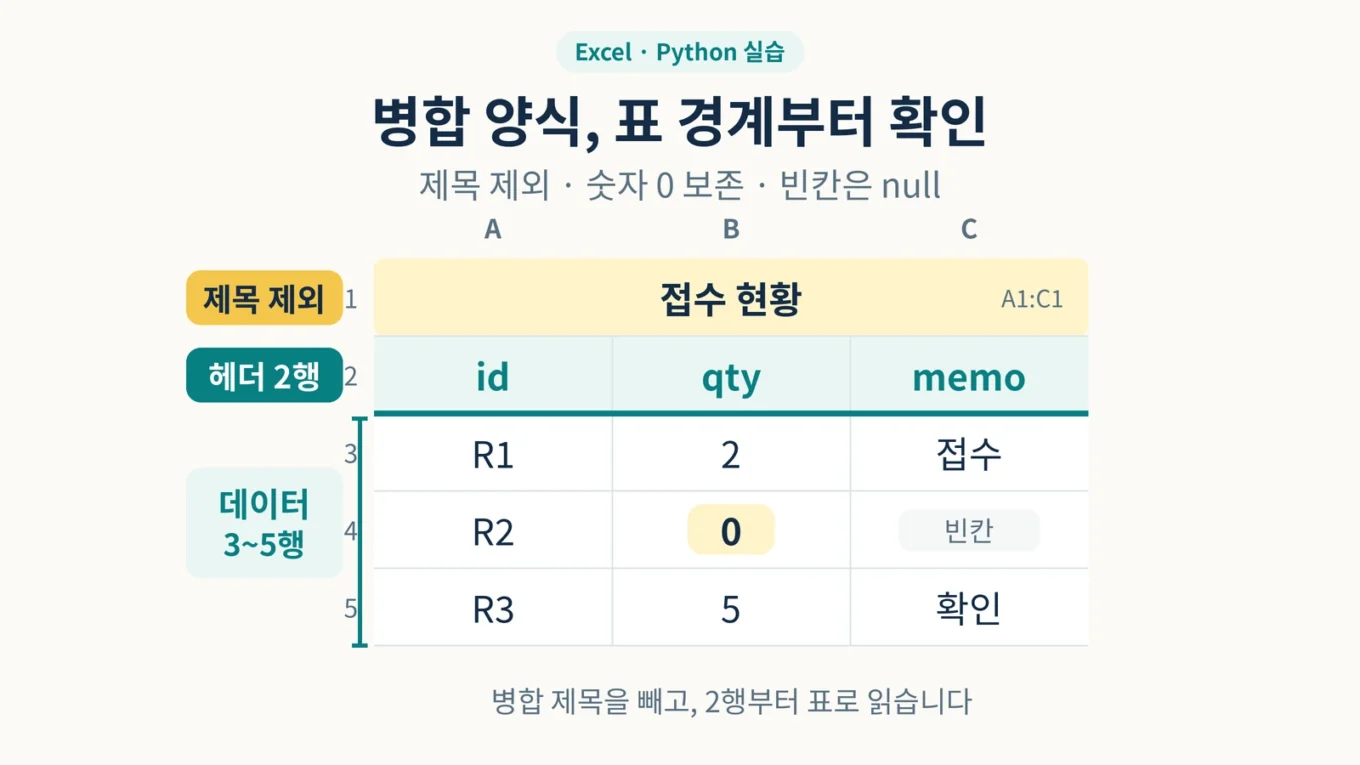
동봉한 fixtures/normal.xlsx의 Data 시트는 아래 구조입니다. 첫 행의 ‘접수 현황’은 A1에 저장된 병합 제목이고, 실제 열 이름은 두 번째 행에 있습니다. C4는 메모를 입력하지 않은 실제 빈 셀입니다.
휴대폰에서는 표를 좌우로 움직여 모든 열을 확인하세요.
| 엑셀 행 | A열 | B열 | C열 | 읽는 방법 |
|---|---|---|---|---|
| 1 | 접수 현황 (A1:C1 병합) | 제목, 결과에서 제외 | ||
| 2 | id | qty | memo | 헤더 A2:C2 |
| 3 | R1 | 2 | 접수 | 데이터 |
| 4 | R2 | 0 | 빈 셀 | 데이터, 0과 빈칸 보존 |
| 5 | R3 | 5 | 확인 | 데이터 마지막 행 |
코드의 SHEET, HEADER_ROW, FIRST_DATA_ROW, LAST_DATA_ROW, FIRST_COL, LAST_COL이 이 경계를 나타냅니다. HEADERS는 ('id', 'qty', 'memo')로 고정합니다. 마지막 행이나 헤더를 자동 탐색하지 않으므로, 양식이 달라지면 계약과 기대값을 함께 바꿔야 합니다.
데이터는 지정한 세 행을 모두 검사합니다. id는 비어 있지 않은 문자열, qty는 유한한 0 이상 숫자, memo는 문자열 또는 빈 셀이어야 합니다. qty의 불리언 값이나 문자 "0"은 허용하지 않습니다. 숫자 0을 빈 값으로 처리하지 않고, 메모의 None은 JSON의 null로 남깁니다.
2. 빈칸을 채우기 전에 병합 범위 검사하기
openpyxl에서 병합 범위는 좌상단 셀을 기준으로 다룹니다. 나머지 위치는 MergedCell이며, 공식 MergedCell 문서에 따르면 그 값은 항상 None입니다. 값을 읽었을 때 None이 나왔다고 해서 모두 사용자가 비워 둔 칸으로 볼 수는 없습니다.
먼저 ws.merged_cells.ranges의 각 범위를 헤더 A2:C2, 데이터 A3:C5와 비교합니다. Worksheet 공식 소스도 기존 merged_cell_ranges 대신 이 속성을 안내합니다. 범위 비교에는 CellRange.isdisjoint()를 사용해 겹치지 않는지를 확인합니다.
정상 파일의 A1:C1은 두 영역과 겹치지 않으므로 통과합니다. 정상 자료에서 B4의 수량은 0입니다. B3:B4를 병합한 표에서 B3의 2를 아래 행에도 복제하면 이 기대값과 달라집니다. 실제 양식의 병합 아래 칸은 None이므로, 그 의미를 확인하지 않고 수량을 채울 수는 없습니다. 이 코드는 병합을 해제하거나 좌상단 값을 아래로 채우지 않습니다. 병합을 발견한 상태에서 완성 데이터를 내보내지 않는 것이 이 실습의 기준입니다.
3. 정상 파일 실행과 기대 JSON 확인하기
ZIP을 새 연습 폴더에 풀고 p42_merged_cell_practice 폴더를 터미널의 작업 위치로 사용합니다. Python이 준비되어 있다면 필요에 따라 가상환경을 만든 뒤 아래 명령으로 동봉한 버전을 설치합니다. 설치 이후 코드 실행은 입력 파일을 로컬에서 읽습니다.
python -m pip install -r requirements.txt
python read_form.py fixtures/normal.xlsx --output result.json --diagnostics result.diagnostics.json
python -m json.tool result.json
성공하면 종료 코드 0이며, 콘솔에 {"status": "ok", "file": "result.json"}이 표시됩니다. 새로 만들어지는 파일은 result.json 하나입니다. --diagnostics로 지정한 파일은 거부가 발생했을 때만 사용하므로 정상 실행에서는 생기지 않습니다.
아래는 expected/normal.json의 전체 내용입니다. 행·열 수가 3×3이고 qty 합계가 7인지 확인하되, R2의 qty가 0인지와 memo가 null인지도 같이 대조하세요. 제목 ‘접수 현황’은 헤더나 데이터에 들어가지 않아야 합니다.
{
  "schema_version": 1,
  "status": "ok",
  "sheet": "Data",
  "boundary": {
    "header_row": 2,
    "first_data_row": 3,
    "last_data_row": 5,
    "first_col": "A",
    "last_col": "C"
  },
  "headers": [
    "id",
    "qty",
    "memo"
  ],
  "rows": [
    {
      "id": "R1",
      "qty": 2,
      "memo": "접수"
    },
    {
      "id": "R2",
      "qty": 0,
      "memo": null
    },
    {
      "id": "R3",
      "qty": 5,
      "memo": "확인"
    }
  ],
  "row_count": 3,
  "column_count": 3,
  "quantity_total": 7
}boundary와 headers를 결과에 함께 넣어 어느 위치를 어떤 열 이름으로 읽었는지 남겼습니다. 합계만 확인하면 잘못된 행이나 값이 우연히 맞아떨어질 수 있으므로, 실무 양식에 적용할 때도 행별 기대값을 먼저 준비하는 편이 좋습니다.
4. 세 가지 병합은 결과 대신 진단 남기기
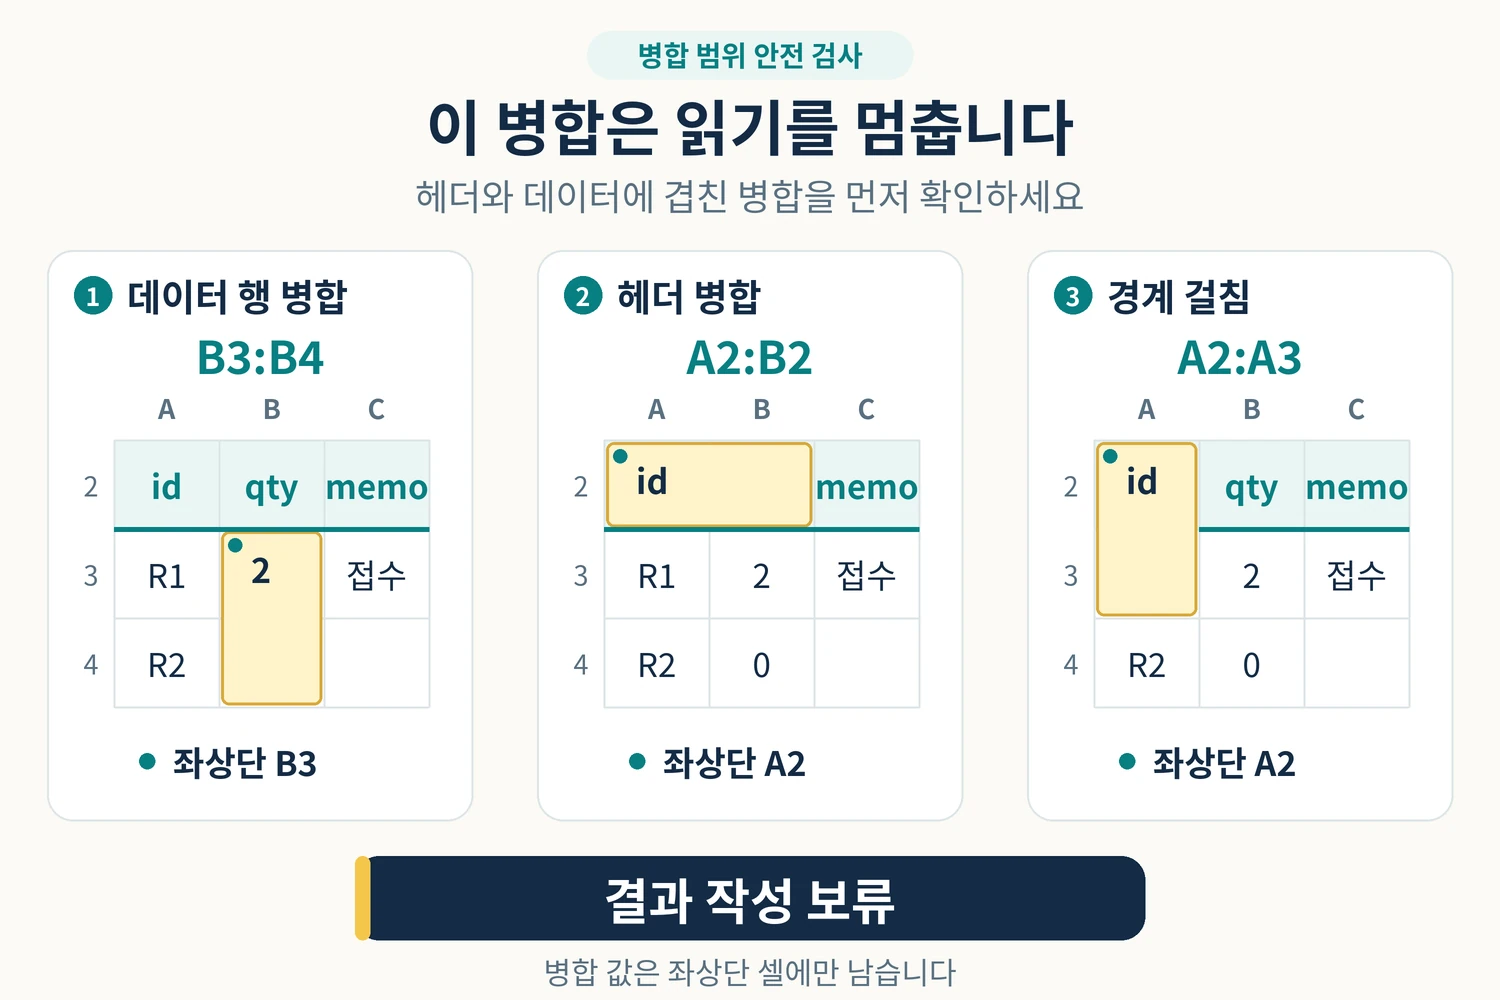
휴대폰에서는 표를 좌우로 움직여 모든 열을 확인하세요.
| 입력 파일 | range | anchor | intersects | 확인할 문제 |
|---|---|---|---|---|
| data_merge.xlsx | B3:B4 | B3 | [“data”] | 두 데이터 행의 수량 병합 |
| header_merge.xlsx | A2:B2 | A2 | [“header”] | 서로 다른 열의 헤더 병합 |
| cross_merge.xlsx | A2:A3 | A2 | [“header”, “data”] | 헤더와 첫 데이터 행에 걸친 병합 |
python read_form.py fixtures/data_merge.xlsx --output rejected.json --diagnostics data_merge.diagnostics.json
python read_form.py fixtures/header_merge.xlsx --output header.json --diagnostics header.diagnostics.json
python read_form.py fixtures/cross_merge.xlsx --output cross.json --diagnostics cross.diagnostics.json
각 명령은 종료 코드 2로 끝납니다. --output의 데이터 파일은 만들지 않고, --diagnostics에 지정한 진단 파일만 생성합니다. 오류 코드는 모두 MERGE_IN_BOUNDARY, reason은 헤더/데이터 경계와 겹치는 병합은 값을 복제하지 않고 거부합니다.입니다.
첫 번째 명령의 진단은 아래와 같습니다. extracted_rows: 0은 일부 행을 성공 데이터로 돌려주지 않았다는 뜻입니다. 파일이 정상 처리된 것처럼 0행짜리 결과 JSON을 만드는 방식과 구별해서 확인하세요.
{
  "schema_version": 1,
  "status": "rejected",
  "extracted_rows": 0,
  "errors": [
    {
      "code": "MERGE_IN_BOUNDARY",
      "range": "B3:B4",
      "anchor": "B3",
      "intersects": [
        "data"
      ],
      "reason": "헤더/데이터 경계와 겹치는 병합은 값을 복제하지 않고 거부합니다."
    }
  ]
}
거부된 양식은 먼저 담당자가 행의 의미를 확인해야 합니다. 예를 들어 묶음 수량인지 각 행의 수량인지 확정한 뒤, 별도 사본에서 각 열과 행의 값을 명확하게 구성하고 다시 검사할 수 있습니다. 원본에서 병합을 풀기만 하면 아래 칸의 값이 자동으로 복구된다고 가정하지 마세요.
5. 재실행할 때는 두 출력 경로를 모두 새 이름으로
입력, 데이터 출력, 진단 출력은 서로 다른 경로여야 합니다. 출력 두 파일 중 하나라도 이미 있으면, 실제로 이번에 사용할 파일이 아니어도 종료 코드 3으로 멈춥니다. 기존 파일을 덮어쓰지 않으며, 출력 폴더도 자동으로 만들지 않습니다. 폴더가 있는지 확인하고 새 이름을 지정하세요.
python read_form.py fixtures/normal.xlsx --output result_02.json --diagnostics result_02.diagnostics.json경로 충돌의 콘솔 오류 코드는 OUTPUT_CONFLICT이며 reason은 입력/출력 경로가 겹치거나 결과 파일이 이미 있습니다. 새 파일명을 지정하세요.입니다. 출력 폴더가 없으면 OUTPUT_UNAVAILABLE과 출력 폴더가 없습니다. 기존 폴더와 새 파일명을 지정하세요.가 표시됩니다. 쓰기 실패도 같은 오류 코드에 예외 종류가 붙습니다. 출력 문제는 진단 파일이 생겼다고 가정하지 말고 콘솔의 오류를 먼저 확인합니다.
입력 내용이 거부된 경우에는 진단의 errors를 봅니다. SHEET_MISSING이면 Data 시트, HEADER_MISMATCH이면 A2:C2의 정확한 열 이름과 순서, VALUE_TYPE_UNSUPPORTED이면 진단에 행 번호가 있는 경우 해당 행의 자료형을, 합계 오류라면 수량 범위를 확인합니다. 수식이나 외부 연결을 임의로 무시하고 재시도하지 말고, 이 예제의 입력 조건에 맞는 별도 값 전용 자료를 준비해야 합니다.
6. 작은 고정 양식에 적용하는 범위와 검증 결과
통합 문서는 load_workbook(..., read_only=False, data_only=False)로 일반 로드합니다. read_only 최적화 모드의 대용량 읽기 예제는 아닙니다. 원본을 바꾸지 않는 것은 읽은 뒤 save()를 호출하지 않기 때문입니다. 수식을 계산하거나 저장된 캐시값으로 대체하지 않으며, 모든 워크시트의 수식 셀을 거부합니다. 지정한 표 바깥의 수식도 대상입니다.
- 일반 .xlsx 입력은 최대 2 MiB, 내부 ZIP 항목은 최대 100개, 전체 해제 크기는 최대 10 MiB입니다.
- 워크시트는 최대 10개, 모든 시트에 명시된 dimension 면적의 합계는 최대 50,000셀입니다.
- 셀·행·열·병합 범위의 좌표는 1,000행×50열 안에 있어야 합니다. 시트 dimension이 없는 파일도 거부합니다.
- XML은 UTF-8만 지원하고 DTD/ENTITY 선언을 거부합니다.
- .xlsm, 확장자만 .xlsx로 바꾼 매크로 패키지, 암호화/OLE 형식, 암호화 ZIP 표식, 손상 ZIP/XML, 외부 통합 문서 링크와 외부 관계·하이퍼링크는 지원하지 않습니다.
이 제한은 정해진 작은 실습 자료를 처리하기 위한 범위이며 CPU·메모리·실행시간을 강제 격리하는 안전장치는 아닙니다. 임의의 대용량 파일이나 신뢰할 수 없는 Office 파일을 검사하는 서비스로 확대하지 마세요. 암호화·매크로 거부 시험에 포함된 일부 파일은 합성 표식이며, 실제 암호화 문서의 복호화나 실행 가능한 매크로를 시험한 결과가 아닙니다.
python self_test.py
python self_test.py --report my_test_report.json
자체 시험 37개와 독립 검토 시험 62개(실제 CLI 60개, 런타임 API·소스 점검 2개)를 확인했습니다. 두 검토의 일부 시나리오는 겹치며, 새 폴더에서 반복 실행한 시험을 새 시나리오 수로 합산하지 않았습니다. 정상 결과, 세 병합 거부, 숫자 0과 null, 원본 SHA-256 불변, 입력 제한, 오류와 출력 충돌을 대조했습니다. 자체 시험의 실제 결과는 동봉한 self_test_report.json에서 볼 수 있습니다. 시험은 임시 폴더에 결과를 만들며 포함된 원본 fixture를 수정하지 않습니다.
Windows, Microsoft Excel 앱 화면, Excel 재계산은 실행하지 않았습니다(NOT_RUN). 다른 양식의 행 수를 자동으로 찾거나 병합 의미를 해석하는 기능도 없습니다. 동봉한 make_fixtures.py는 합성 입력 재생성용이므로 실습 실행에 필요하지 않으며, 다시 실행하면 배포 입력의 해시가 달라질 수 있습니다.
다운로드 파일의 크기와 SHA-256 확인
ZIP 크기: 140005바이트. 동봉한 MANIFEST.json에는 개별 파일의 크기와 SHA-256이 있습니다.
ZIP SHA-256: fce885792859cdc830b4e6787a8482dc5baeef11e63fb1e85a9ff5f749b35df6ZIP과 동일한 전체 실행 코드
read_form.py의 전체 내용입니다. 파일을 읽기 전에 크기·패키지 구조를 검사하고, 병합 검사와 헤더·값 검사를 통과한 경우에만 새 데이터 JSON을 만듭니다. 기존 파일 보호에는 open('x')의 배타적 생성 모드를 사용합니다.
read_form.py 전체 코드 펼치기
"""P42: 명시한 헤더/데이터 경계에서 병합을 거부하고 새 JSON만 만든다."""
import argparse
import io
import json
import math
import sys
import xml.etree.ElementTree as ET
from pathlib import Path, PurePosixPath
from zipfile import BadZipFile, ZipFile
from zlib import error as ZlibError

from openpyxl import load_workbook
from openpyxl.utils import get_column_letter, range_boundaries
from openpyxl.worksheet.cell_range import CellRange

# 양식의 계약: 행을 추측하거나 빈 셀을 채우지 않는다.
SHEET = 'Data'
HEADER_ROW, FIRST_DATA_ROW, LAST_DATA_ROW = 2, 3, 5
FIRST_COL, LAST_COL = 1, 3
HEADERS = ('id', 'qty', 'memo')
LIMITS = {'input_bytes': 2 * 1024 * 1024, 'expanded_bytes': 10 * 1024 * 1024,
          'members': 100, 'sheets': 10, 'rows': 1000, 'columns': 50, 'cells': 50000}
NS = '{http://schemas.openxmlformats.org/spreadsheetml/2006/main}'


class Rejected(Exception):
    def __init__(self, errors):
        self.errors = errors
        super().__init__(errors[0]['reason'])


def refuse(code, reason, **detail):
    raise Rejected([{'code': code, 'reason': reason, **detail}])


def bounded(ref, part):
    try:
        left, top, right, bottom = range_boundaries(ref)
        valid = (1 <= left <= right <= LIMITS['columns'] and
                 1 <= top <= bottom <= LIMITS['rows'])
    except (TypeError, ValueError):
        valid = False
    if not valid:
        refuse('DIMENSION_LIMIT', '지원 범위를 벗어난 좌표입니다.', part=part, range=ref, limits=LIMITS)
    return (right - left + 1) * (bottom - top + 1)


def inspect_package(source):
    if source.suffix.lower() != '.xlsx':
        refuse('UNSUPPORTED_EXTENSION', '일반 .xlsx 파일만 지원합니다.')
    try:
        if source.stat().st_size > LIMITS['input_bytes']:
            refuse('INPUT_SIZE_LIMIT', '입력은 2 MiB 이하여야 합니다.', limits=LIMITS)
        content = source.read_bytes()
        if len(content) > LIMITS['input_bytes']:
            refuse('INPUT_SIZE_LIMIT', '입력은 2 MiB 이하여야 합니다.', limits=LIMITS)
    except OSError as exc:
        refuse('INPUT_UNAVAILABLE', '입력 파일을 읽을 수 없습니다.', exception=type(exc).__name__)
    if content.startswith(bytes.fromhex('D0CF11E0A1B11AE1')):
        refuse('ENCRYPTED_OR_OLE_UNSUPPORTED', '암호화 Office 또는 구형 OLE 파일은 지원하지 않습니다.')
    try:
        with ZipFile(io.BytesIO(content)) as package:
            members = package.infolist()
            if len(members) > LIMITS['members']:
                refuse('ARCHIVE_MEMBER_LIMIT', 'ZIP 항목은 100개 이하여야 합니다.', limits=LIMITS)
            if sum(item.file_size for item in members) > LIMITS['expanded_bytes']:
                refuse('ARCHIVE_EXPANSION_LIMIT', 'ZIP 해제 크기는 10 MiB 이하여야 합니다.', limits=LIMITS)
            names = [item.filename for item in members]
            if len(set(names)) != len(names) or any(PurePosixPath(n).is_absolute() or '..' in PurePosixPath(n).parts for n in names):
                refuse('INVALID_PACKAGE', '중복 또는 안전하지 않은 ZIP 경로입니다.')
            if any(item.flag_bits & 1 for item in members):
                refuse('ENCRYPTED_OR_OLE_UNSUPPORTED', '암호화 ZIP은 지원하지 않습니다.')
            lowered = [n.lower() for n in names]
            if any('vbaproject' in n or 'vbadata' in n or '/macrosheets/' in n or '/dialogsheets/' in n for n in lowered):
                refuse('MACROS_UNSUPPORTED', '확장자 변경 여부와 관계없이 매크로 패키지를 거부합니다.')
            if any('/externallinks/' in n for n in lowered):
                refuse('EXTERNAL_LINK_UNSUPPORTED', '외부 연결이 포함된 파일은 지원하지 않습니다.')
            if '[Content_Types].xml' not in names or 'xl/workbook.xml' not in names:
                refuse('INVALID_PACKAGE', '필수 XLSX 패키지 항목이 없습니다.')
            sheets, cell_area = 0, 0
            for name in names:
                raw = package.read(name)  # CRC도 검증한다.
                if not name.endswith(('.xml', '.rels')):
                    continue
                try:
                    raw.decode('utf-8-sig')
                    if b'\x00' in raw:
                        raise UnicodeError('NUL byte')
                except UnicodeError:
                    refuse('XML_ENCODING_UNSUPPORTED', 'XML은 UTF-8만 지원합니다.', part=name)
                if b'<!DOCTYPE' in raw.upper() or b'<!ENTITY' in raw.upper():
                    refuse('XML_DECLARATION_UNSUPPORTED', 'DTD/ENTITY 선언은 지원하지 않습니다.', part=name)
                try:
                    root = ET.fromstring(raw)
                except ET.ParseError:
                    refuse('INVALID_XML', '유효하지 않은 XML입니다.', part=name)
                if name == '[Content_Types].xml':
                    types = [node.get('ContentType', '').lower() for node in root]
                    if any('macroenabled' in t or 'vba' in t or 'macrosheet' in t for t in types):
                        refuse('MACROS_UNSUPPORTED', '매크로 콘텐츠 유형을 거부합니다.')
                    if 'application/vnd.openxmlformats-officedocument.spreadsheetml.sheet.main+xml' not in types:
                        refuse('INVALID_PACKAGE', '일반 XLSX 통합 문서 유형이 아닙니다.')
                if name.endswith('.rels') and any(node.get('TargetMode', '').lower() == 'external' for node in root):
                    refuse('EXTERNAL_LINK_UNSUPPORTED', '외부 관계/하이퍼링크를 거부합니다.', part=name)
                if name.startswith('xl/worksheets/') and name.endswith('.xml'):
                    sheets += 1
                    dimension = root.find(NS + 'dimension')
                    if dimension is None:
                        refuse('DIMENSION_LIMIT', '명시된 시트 dimension이 필요합니다.', part=name)
                    cell_area += bounded(dimension.get('ref'), name)
                    for node in root.iter():
                        if node.tag in (NS + 'c', NS + 'mergeCell'):
                            bounded(node.get('r') if node.tag == NS + 'c' else node.get('ref'), name)
                        if node.tag == NS + 'row' and not 1 <= int(node.get('r', '0')) <= LIMITS['rows']:
                            refuse('DIMENSION_LIMIT', '지원 행 수를 초과했습니다.', part=name)
                        if node.tag == NS + 'col' and not 1 <= int(node.get('min', '0')) <= int(node.get('max', '0')) <= LIMITS['columns']:
                            refuse('DIMENSION_LIMIT', '지원 열 수를 초과했습니다.', part=name)
                        if node.tag == NS + 'f':
                            refuse('FORMULA_UNSUPPORTED', '수식 셀은 계산하거나 캐시값으로 대체하지 않습니다.', part=name)
            if sheets > LIMITS['sheets'] or cell_area > LIMITS['cells']:
                refuse('DIMENSION_LIMIT', '시트 수/전체 dimension 면적 제한을 초과했습니다.', limits=LIMITS)
    except (BadZipFile, ZlibError, ValueError, KeyError, RuntimeError, NotImplementedError) as exc:
        refuse('INVALID_PACKAGE', '유효한 일반 XLSX ZIP 패키지가 아닙니다.', exception=type(exc).__name__)
    return content


def extract(source):
    content = inspect_package(source)
    try:
        wb = load_workbook(io.BytesIO(content), read_only=False, data_only=False, keep_vba=False, keep_links=False)
    except Exception as exc:
        refuse('INVALID_WORKBOOK', 'openpyxl이 통합 문서를 읽지 못했습니다.', exception=type(exc).__name__)
    try:
        if SHEET not in wb.sheetnames:
            refuse('SHEET_MISSING', 'Data 시트가 없습니다.', expected=SHEET, actual=wb.sheetnames)
        ws = wb[SHEET]
        regions = {'header': CellRange(min_col=FIRST_COL, max_col=LAST_COL, min_row=HEADER_ROW, max_row=HEADER_ROW),
                   'data': CellRange(min_col=FIRST_COL, max_col=LAST_COL, min_row=FIRST_DATA_ROW, max_row=LAST_DATA_ROW)}
        errors = []
        for merged in sorted(ws.merged_cells.ranges, key=lambda r: (r.min_row, r.min_col)):
            hits = [name for name, region in regions.items() if not merged.isdisjoint(region)]
            if hits:
                errors.append({'code': 'MERGE_IN_BOUNDARY', 'range': str(merged),
                               'anchor': f'{get_column_letter(merged.min_col)}{merged.min_row}',
                               'intersects': hits, 'reason': '헤더/데이터 경계와 겹치는 병합은 값을 복제하지 않고 거부합니다.'})
        if errors:
            raise Rejected(errors)
        actual = tuple(ws.cell(HEADER_ROW, col).value for col in range(FIRST_COL, LAST_COL + 1))
        if actual != HEADERS:
            refuse('HEADER_MISMATCH', '헤더가 양식 계약과 다릅니다.', expected=list(HEADERS), actual_repr=[repr(value) for value in actual])
        rows = []
        for row in ws.iter_rows(min_row=FIRST_DATA_ROW, max_row=LAST_DATA_ROW, min_col=FIRST_COL, max_col=LAST_COL, values_only=True):
            identifier, quantity, memo = row
            if (not isinstance(identifier, str) or not identifier or type(quantity) not in (int, float) or
                    (type(quantity) is float and not math.isfinite(quantity)) or quantity < 0 or (memo is not None and not isinstance(memo, str))):
                refuse('VALUE_TYPE_UNSUPPORTED', 'id는 비어 있지 않은 문자열, qty는 유한한 0 이상 숫자, memo는 문자열/빈 셀이어야 합니다.', row=FIRST_DATA_ROW + len(rows))
            rows.append(dict(zip(HEADERS, row)))  # 0과 None을 그대로 보존한다.
        try:
            total = sum(row['qty'] for row in rows)
        except OverflowError:
            refuse('VALUE_TYPE_UNSUPPORTED', 'qty 합계 계산에서 숫자 범위를 벗어났습니다.')
        if type(total) is float and not math.isfinite(total):
            refuse('VALUE_TYPE_UNSUPPORTED', 'qty 합계가 유한한 숫자 범위를 벗어났습니다.')
        return {'schema_version': 1, 'status': 'ok', 'sheet': SHEET,
                'boundary': {'header_row': HEADER_ROW, 'first_data_row': FIRST_DATA_ROW, 'last_data_row': LAST_DATA_ROW,
                             'first_col': get_column_letter(FIRST_COL), 'last_col': get_column_letter(LAST_COL)},
                'headers': list(HEADERS), 'rows': rows, 'row_count': len(rows), 'column_count': len(HEADERS),
                'quantity_total': total}
    finally:
        wb.close()  # save()는 호출하지 않는다.


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('source', type=Path)
    parser.add_argument('--output', required=True, type=Path)
    parser.add_argument('--diagnostics', required=True, type=Path)
    args = parser.parse_args()
    output, diagnostic = args.output, args.diagnostics
    errors = []
    resolved = [p.resolve() for p in (args.source, output, diagnostic)]
    if len(set(resolved)) != 3 or any(p.exists() or p.is_symlink() for p in (output, diagnostic)):
        errors = [{'code': 'OUTPUT_CONFLICT', 'reason': '입력/출력 경로가 겹치거나 결과 파일이 이미 있습니다. 새 파일명을 지정하세요.'}]
    elif not all(p.parent.is_dir() for p in (output, diagnostic)):
        errors = [{'code': 'OUTPUT_UNAVAILABLE', 'reason': '출력 폴더가 없습니다. 기존 폴더와 새 파일명을 지정하세요.'}]
    if errors:
        print(json.dumps({'status': 'blocked', 'errors': errors}, ensure_ascii=False))
        return 3
    try:
        payload, destination, code = extract(args.source), output, 0
    except Rejected as exc:
        payload = {'schema_version': 1, 'status': 'rejected', 'extracted_rows': 0, 'errors': exc.errors}
        destination, code = diagnostic, 2
    try:
        encoded = json.dumps(payload, ensure_ascii=False, indent=2, allow_nan=False) + '\n'
        with destination.open('x', encoding='utf-8') as handle:  # 기존 파일을 절대 덮어쓰지 않는다.
            handle.write(encoded)
    except (OSError, TypeError, ValueError) as exc:
        print(json.dumps({'status': 'blocked', 'errors': [{'code': 'OUTPUT_UNAVAILABLE', 'reason': '새 결과 파일을 쓰지 못했습니다.', 'exception': type(exc).__name__}]}, ensure_ascii=False))
        return 3
    print(json.dumps({'status': payload['status'], 'file': str(destination)}, ensure_ascii=False))
    return code


if __name__ == '__main__':
    sys.exit(main())
경계가 정리된 뒤 이어서 할 작업
여러 파일의 표 구조를 확인한 다음 한 결과로 합치려면 여러 엑셀 파일을 pandas로 합치고 결과를 검산하는 방법에서 출처 행과 합계 대조를 이어갈 수 있습니다. 셀에 저장된 웹 주소나 로컬 경로를 따로 기록하려면 Excel 파일의 링크 정보를 읽기 전용 목록으로 만드는 방법을 참고하세요. 이 글의 코드는 외부 하이퍼링크를 포함한 파일을 거부하므로 링크 목록 작업은 별도 예제에서 다룹니다.
작성자 소개
