Python 합성 센서 데이터로 이동창 평균의 경계조건 검증하기
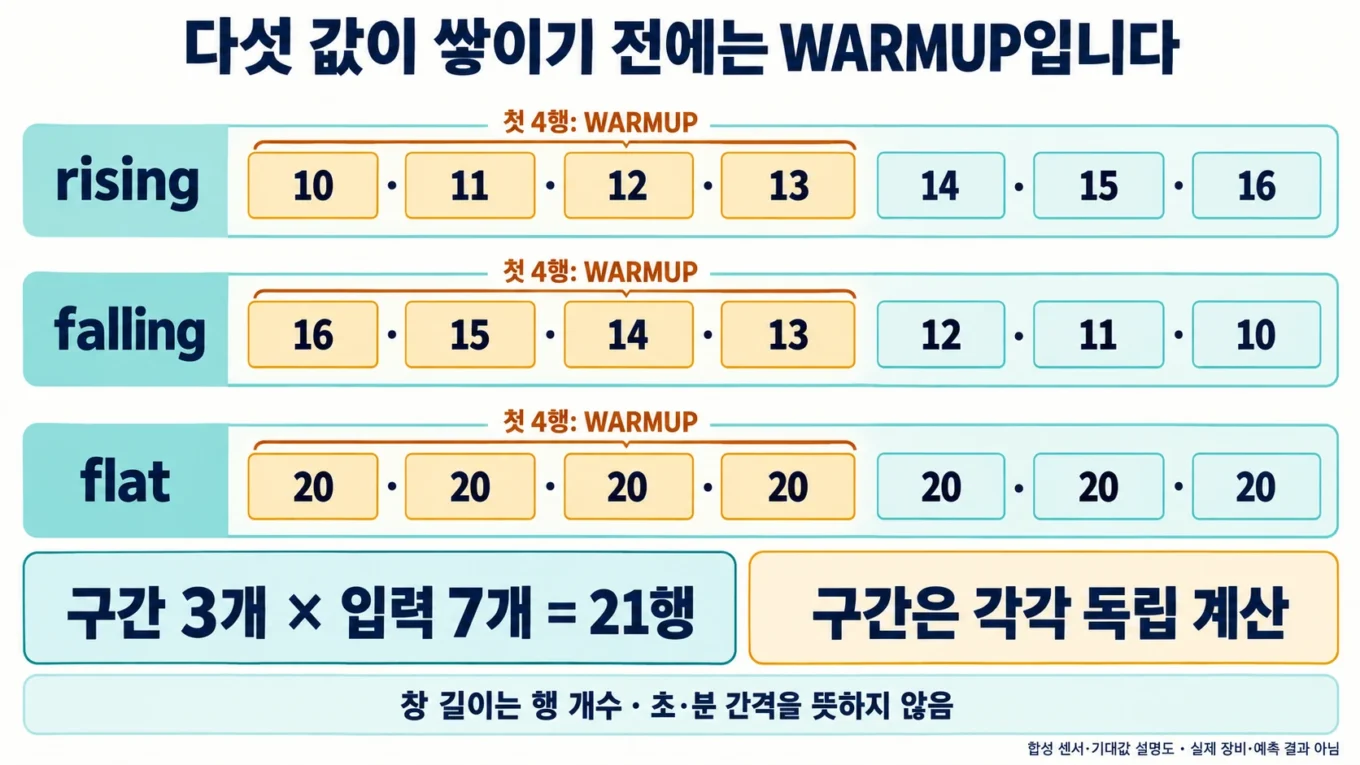
센서 값을 받아 이동평균을 계산할 때 첫 관측치부터 판정을 내리면 아직 채워지지 않은 창이 정상 결과처럼 보일 수 있습니다. 이 글은 장기 창이 다섯 개 채워지기 전에는 WARMUP으로 남기는 규칙을 작은 합성 입력으로 확인합니다. 실제 센서나 장비 제어에 연결하지 않습니다.
세 구간을 각각 독립적으로 계산하므로 앞 구간의 끝값이 다음 구간의 평균에 섞이지 않습니다. Python 3.12.14에서 첨부 코드와 같은 입력을 실행했고, 미래 예측 성능이나 실제 관측 자료의 정확성을 측정한 실험은 아닙니다.
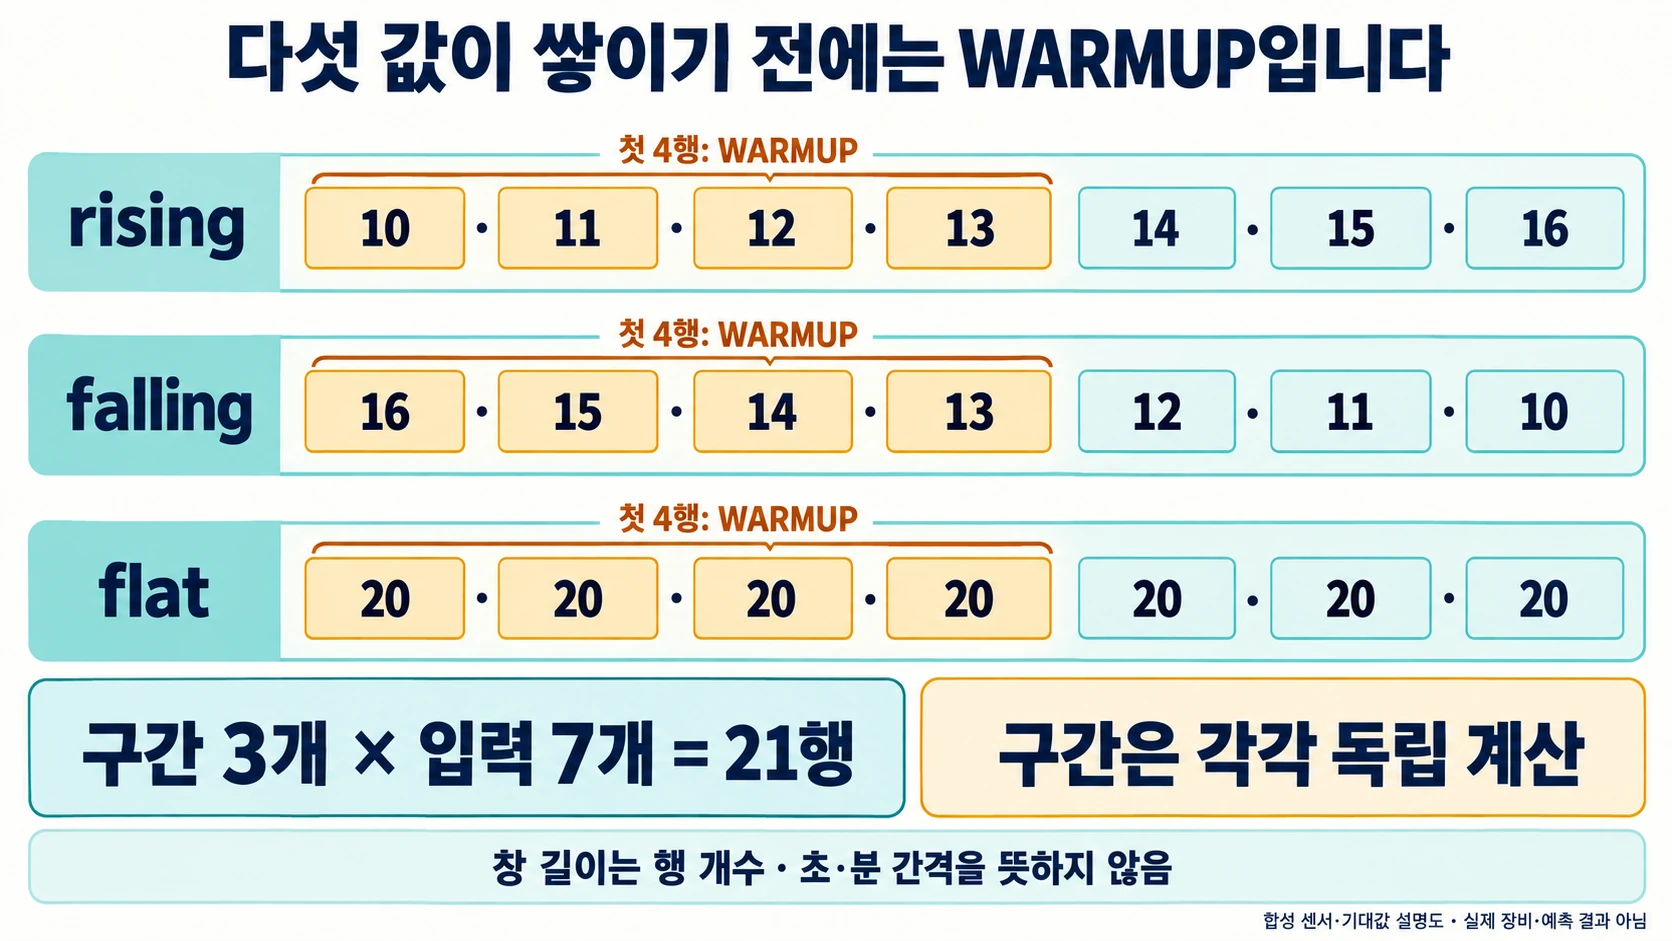
입력 21개와 다섯 번째 행의 손계산
| 구간 | 입력 7개 | 다섯 번째 행의 단기/장기 평균 | 기대 상태 |
|---|---|---|---|
| rising | 10, 11, 12, 13, 14, 15, 16 | 13 / 12 | ABOVE |
| falling | 16, 15, 14, 13, 12, 11, 10 | 13 / 14 | BELOW |
| flat | 20, 20, 20, 20, 20, 20, 20 | 20 / 20 | EQUAL |
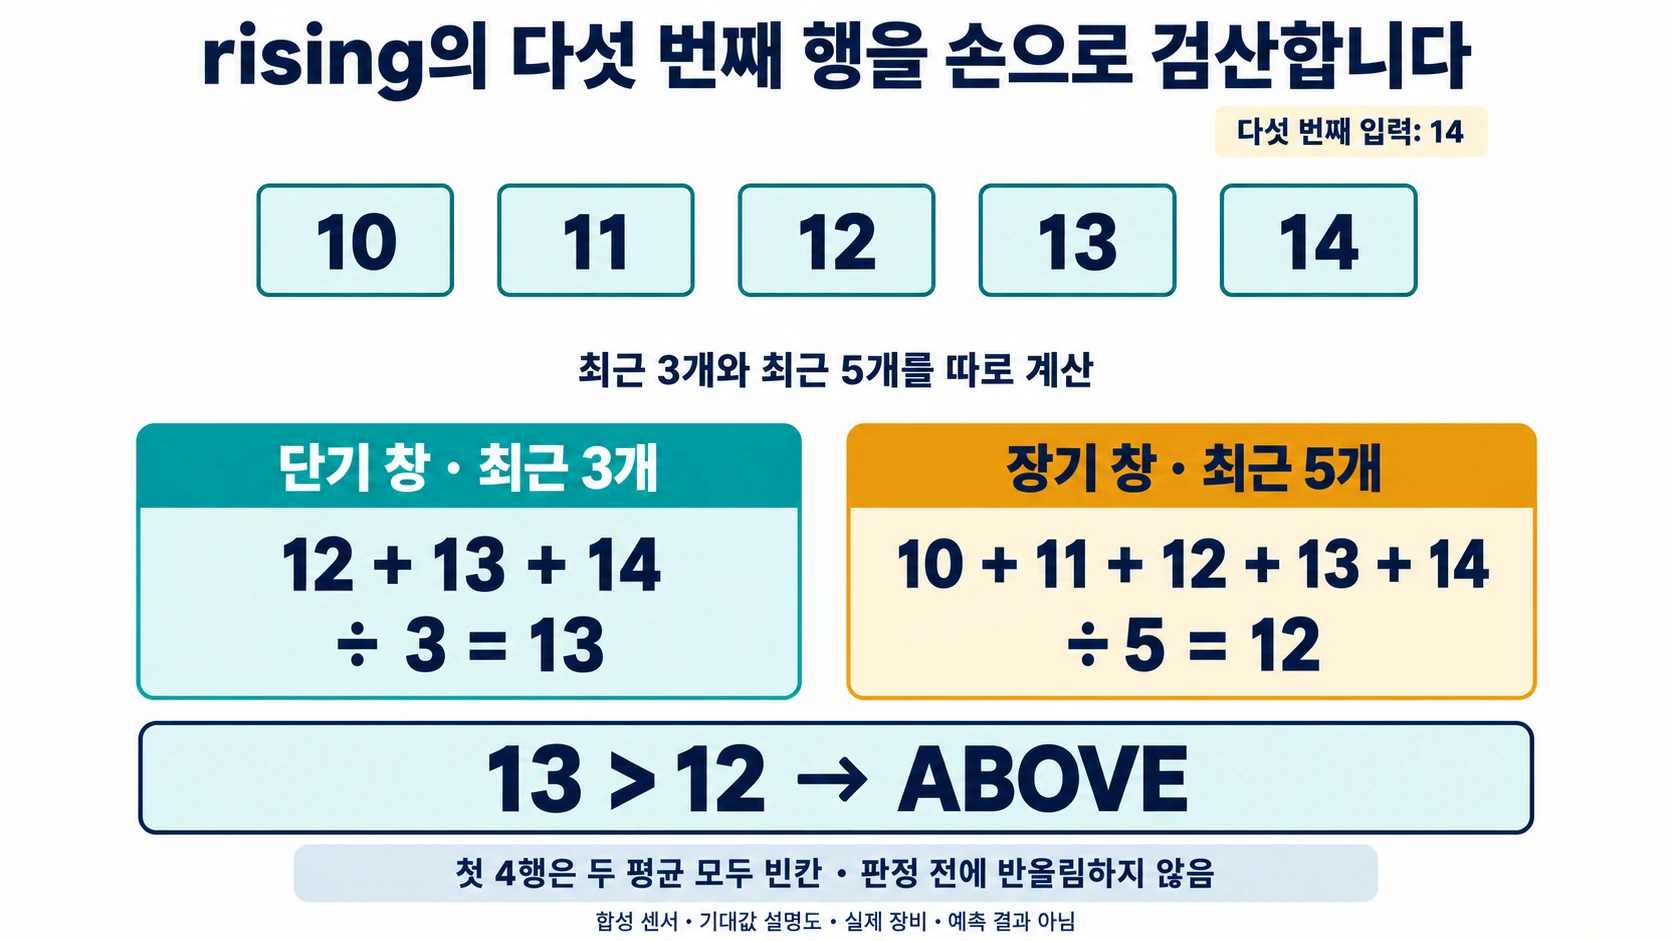
상승 구간의 다섯 번째 행은 최근 세 값 12·13·14의 평균 13과 최근 다섯 값 10·11·12·13·14의 평균 12를 비교합니다. 하락은 (14+13+12)/3=13, (16+15+14+13+12)/5=14입니다. 첫 네 행은 두 평균을 빈칸으로 출력하고 WARMUP으로 남깁니다.
Python의 statistics.fmean은 부동소수점 산술 평균을 계산합니다. 이 구현은 판정 전에 반올림하지 않습니다. 표시를 위해 먼저 반올림하면 가까운 두 평균의 대소 관계를 바꿀 수 있기 때문입니다.
준비와 실행
추가 라이브러리 없이 Python 3.12.14의 표준 라이브러리를 사용합니다. ZIP 안의 series.json을 열어 위 값이 그대로 있는지 확인한 후 실행하세요.
-
빈 실습 폴더에 ZIP을 풉니다.
-
python sensor_windows.py를 실행합니다. -
sensor-audit.csv의 21행과 구간별 첫 네 행을 확인합니다. -
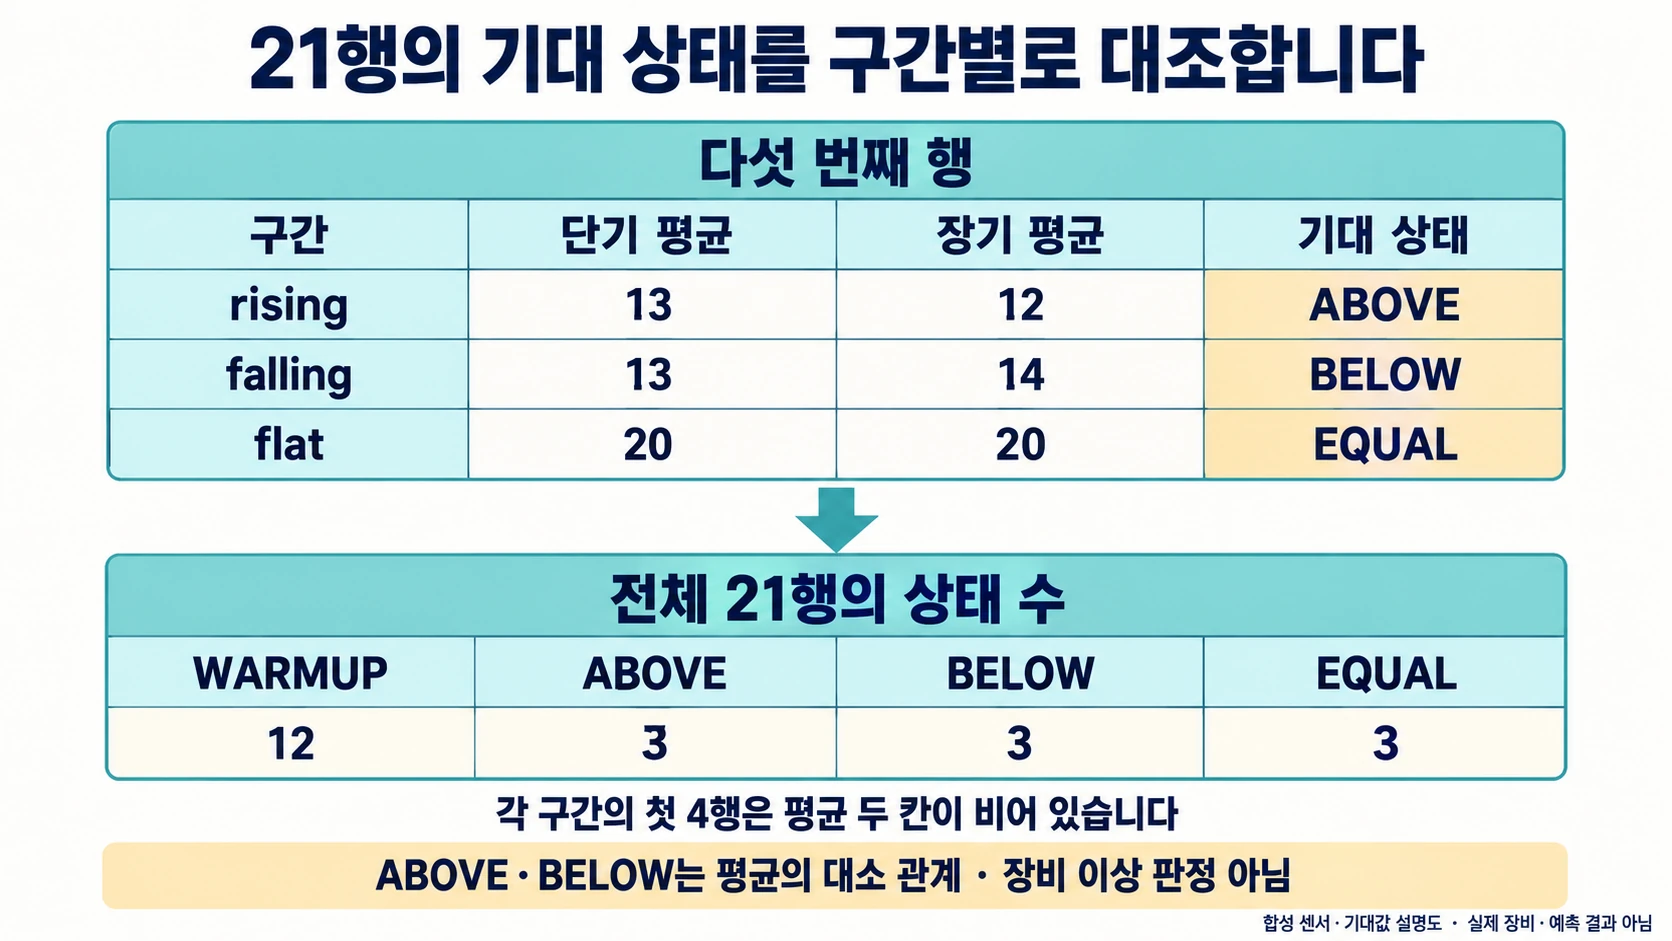
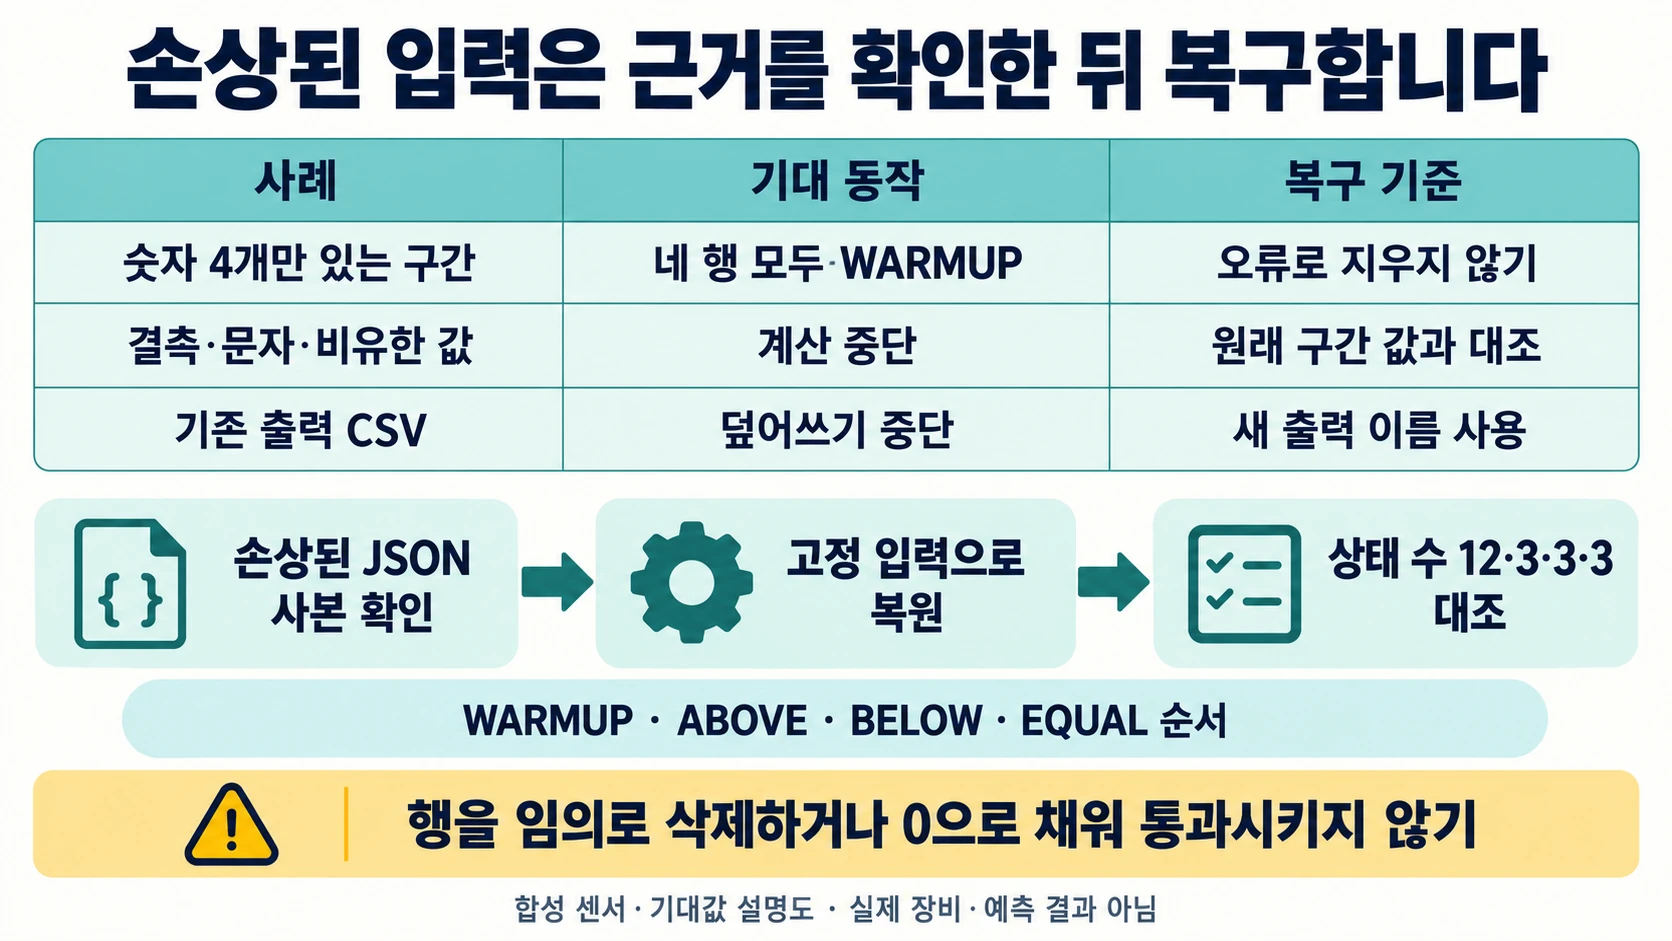
상태 수가 WARMUP 12, ABOVE 3, BELOW 3, EQUAL 3인지 확인합니다.
-
python -m unittest -v test_example.py로 경계 입력까지 검사합니다.
입력 검사를 포함한 전체 코드
ZIP의 sensor_windows.py와 동일합니다. 입력에서 결측을 없애거나 임의로 0을 채우는 처리 없이 잘못된 구간을 중단합니다.
import argparse
import csv
import json
import math
from pathlib import Path
from statistics import fmean


def calculate(series, short=3, long=5):
    if type(short) is not int or type(long) is not int or not 1 <= short < long:
        raise ValueError("창은 1 <= short < long인 정수여야 합니다")
    if not isinstance(series, dict) or not series:
        raise ValueError("구간별 숫자 목록이 필요합니다")
    rows = []
    for segment, values in series.items():
        if not isinstance(values, list) or not values:
            raise ValueError(f"{segment}: 빈 구간은 허용하지 않습니다")
        if any(type(v) not in (int, float) or not math.isfinite(v) for v in values):
            raise ValueError(f"{segment}: 결측/문자/비유한 값은 먼저 확인하세요")
        for i, value in enumerate(values):
            enough = i + 1 >= long
            small = fmean(values[i-short+1:i+1]) if enough else ""
            large = fmean(values[i-long+1:i+1]) if enough else ""
            state = "WARMUP" if not enough else "ABOVE" if small > large else "BELOW" if small < large else "EQUAL"
            rows.append([segment, i+1, value, small, large, state])
    return rows

def write_result(source, output):
    rows = calculate(json.loads(Path(source).read_text(encoding="utf-8")))
    with Path(output).open("x", encoding="utf-8-sig", newline="") as stream:
        writer = csv.writer(stream)
        writer.writerow(["segment", "index", "input", "short_mean", "long_mean", "state"])
        writer.writerows(rows)
    return {"rows": len(rows), "states": {s: sum(row[-1] == s for row in rows)
            for s in ("WARMUP", "ABOVE", "BELOW", "EQUAL")}}

if __name__ == "__main__":
    p = argparse.ArgumentParser()
    p.add_argument("--input", default="series.json")
    p.add_argument("--output", default="sensor-audit.csv")
    a = p.parse_args()
    print(write_result(a.input, a.output))
충분한 관측치와 잘못된 입력을 구분하기
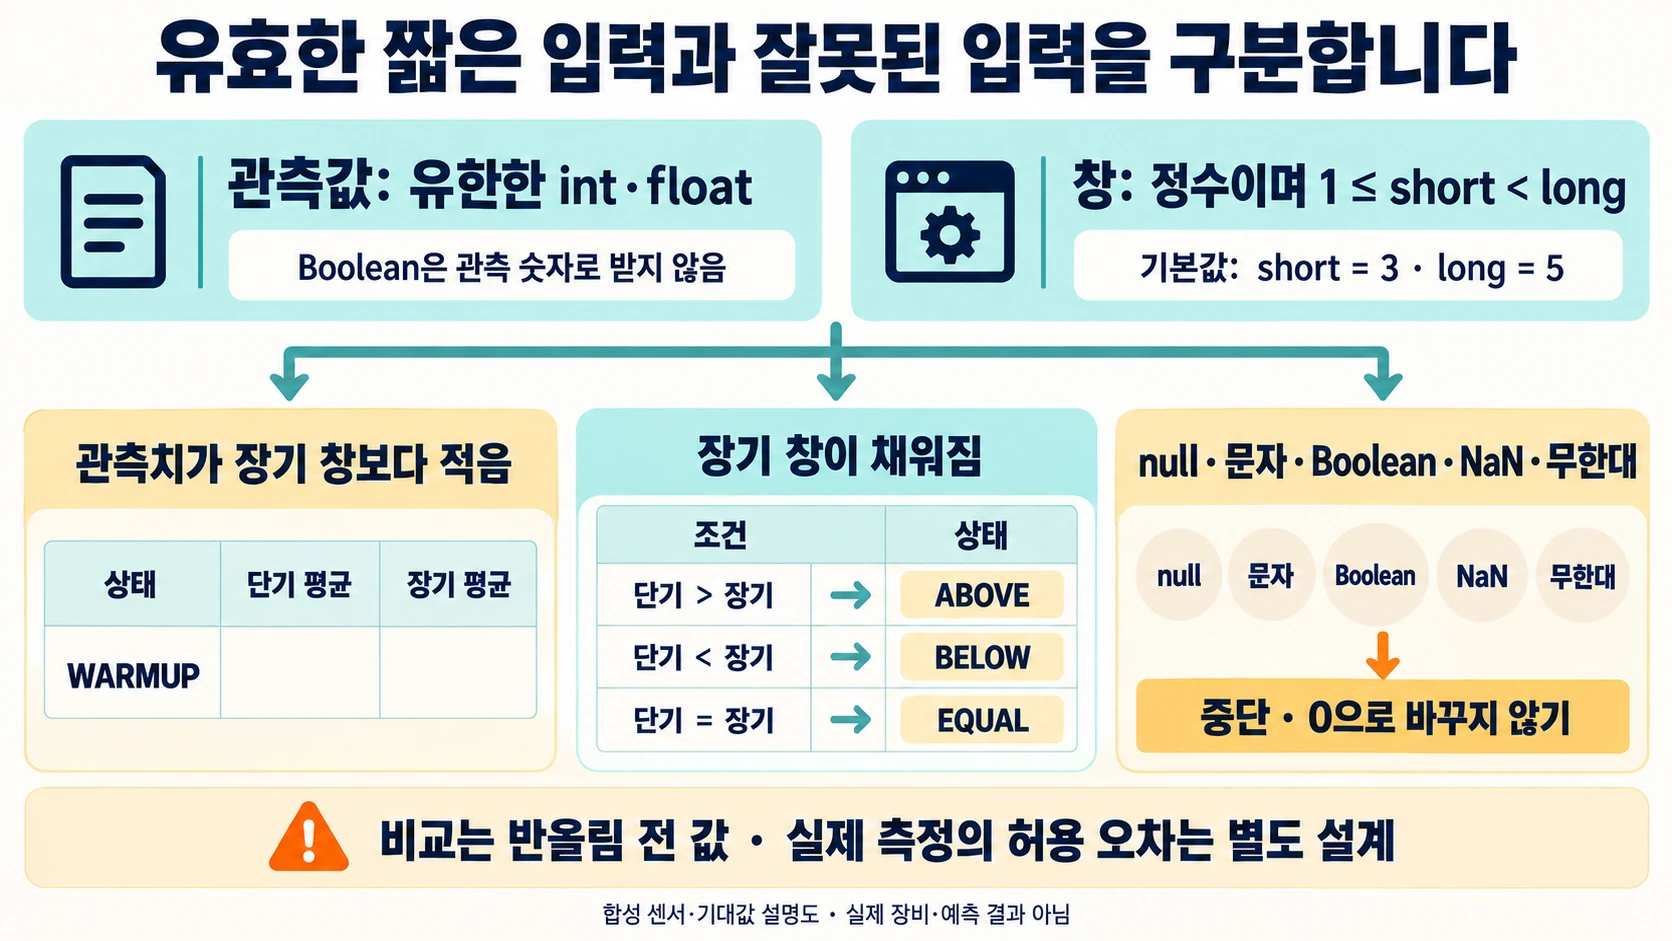
숫자 네 개만 있는 구간은 잘못된 입력이 아닙니다. 장기 창 다섯 개를 채우지 못했으므로 네 행 모두 WARMUP입니다. 반면 null, 문자열 "12", 참/거짓 값, NaN·무한대는 숫자 관측치로 받아들이지 않습니다. 특히 Python에서 bool을 숫자처럼 사용할 수 있다는 이유로 True를 1로 계산하지 않도록 타입을 따로 제한합니다.
다섯 개 테스트는 고정 입력의 다섯 번째 행, 짧은 입력, 결측·문자·비유한값, 잘못된 창 길이, 출력과 재실행 보호를 확인했습니다. 창은 정수이며 1 <= short < long 조건을 만족해야 합니다. 창 두 개가 같은 길이이면 항상 비슷한 결과가 나와 검증 목적이 달라지므로 이 예제에서는 중단합니다.
실패를 복구하는 순서
결측/문자/비유한 값 오류가 나면 어느 구간인지 메시지에서 확인하고 원래 값을 대조하세요. 실제 값이 없는 행을 지우면 시간 간격이 바뀔 수 있으므로 무조건 삭제하지 않습니다. 이 실습에서는 손상시킨 JSON 사본을 ZIP의 고정 입력으로 되돌려 다시 확인합니다.
이미 출력 파일이 있으면 --output sensor-audit-2.csv처럼 다른 이름을 사용합니다. 이전 결과를 보존하고 상태 수가 바뀐 이유를 입력의 변화와 연결해 비교합니다. 성공할 때까지 임계값을 바꾸는 방식으로 오류를 숨기지 않습니다.
해석의 한계
창 길이는 행 개수이며 실제 초·분 간격을 다루지 않습니다. 누락 시간, 센서 교정, 이상치 제거, 장비별 허용 오차는 별도 설계가 필요합니다. 부동소수점의 정확한 ==를 쓰기 때문에 실제 측정에서 작은 오차를 같은 상태로 묶으려면 목적에 맞는 허용 오차를 먼저 정해야 합니다. ABOVE나 BELOW는 예제 평균의 대소 관계일 뿐 장비 이상이나 미래 방향을 뜻하지 않습니다.
유한값 검사만으로 평균 계산 중의 오버플로까지 막지는 못합니다. 매우 큰 값(예: 1e308 다섯 개)은 fmean 계산 중 OverflowError로 중단될 수 있습니다. 이 고정 실습의 입력은 10~20 범위이며, 실제 값으로 확장하기 전에는 센서 단위와 허용 범위를 정하고 중단 원인을 입력과 대조하세요. 오류를 없애려고 값을 임의로 0으로 바꾸거나 성공한 것으로 처리하지 않습니다.
CSV 파일을 쓸 때 newline을 빈 문자열로 지정합니다. 코드의 CSV 저장부에 이 설정을 포함했습니다.
이 실습은 rising, falling, flat이라는 고정 구간명만 사용합니다. 외부 JSON의 구간명을 받아 쓰도록 확장하면 이 코드는 그 문자열을 CSV의 segment 열에 그대로 저장합니다. =, +, -, @ 등으로 시작하는 외부 구간명은 스프레드시트에서 수식으로 해석될 수 있으며, csv.writer의 따옴표 처리는 이를 막는 보안 검사가 아닙니다. 확장할 때는 구간명을 신뢰할 수 있는 허용 목록으로 제한하고, 생성한 CSV는 먼저 텍스트 편집기로 확인하세요.
Python 3.12.14 문서를 참고 자료로 사용했습니다. ZIP에 실행 기록을 함께 넣었습니다.
공식 자료
statistics — Mathematical statistics functions
csv — CSV File Reading and Writing
pathlib — Object-oriented filesystem paths
출처 원문 수집일: S1 2026-09-23; S2 2026-09-23; S3 2026-09-23.
이어서 연습할 글
계산 전에 기록 순번의 중복·누락부터 확인하는 별도 연습은 WebSocket 수신 로그 감사 예제에서 볼 수 있습니다.
작성자 소개
