Python WebSocket 로그 감사: 중복·누락·토큰 불일치 검산
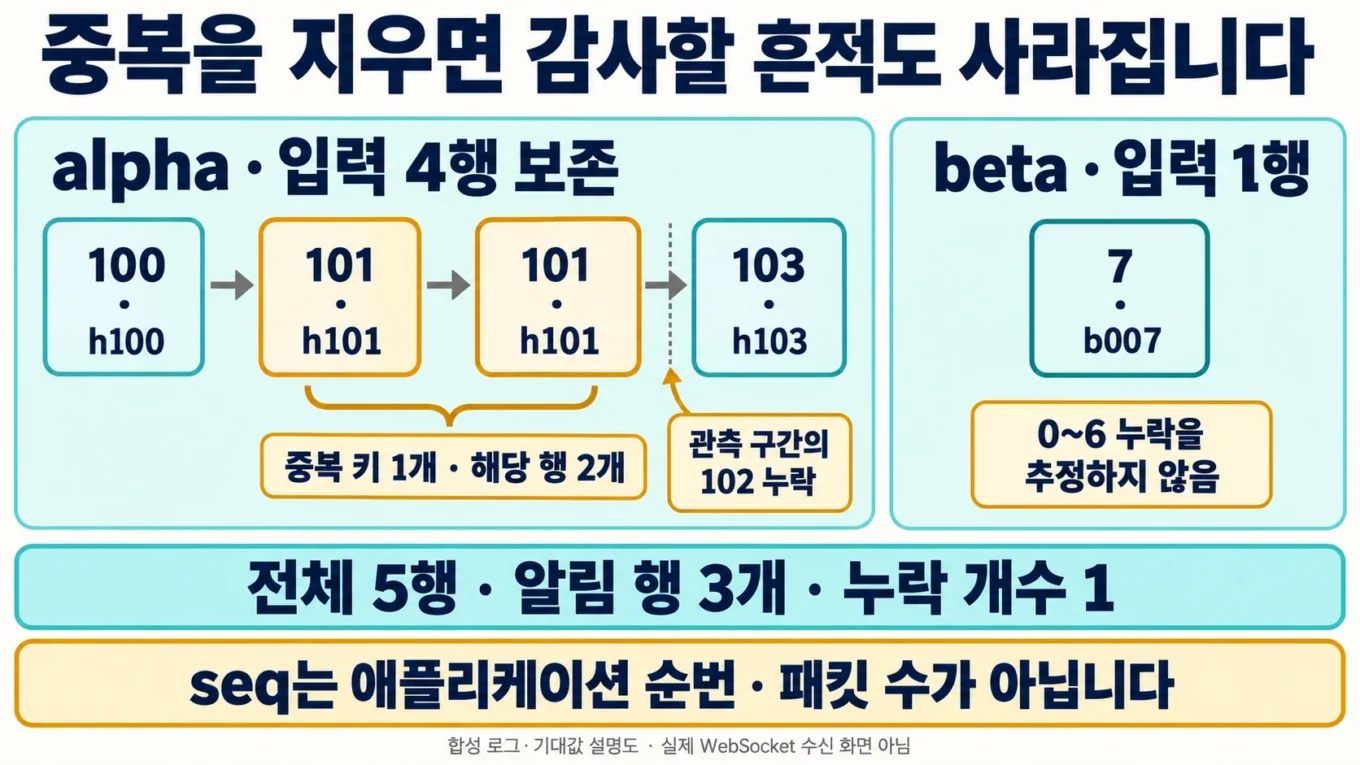
WebSocket으로 받은 자료를 점검할 때 같은 순번을 먼저 삭제하면 서로 다른 내용이 섞인 흔적까지 사라집니다. 이 글은 연결 프로그램이 아니라 이미 저장된 메시지 로그를 감사하는 예제입니다. 가상의 다섯 행을 모두 남긴 채 중복, 같은 순번의 다른 토큰, 관측 구간 안의 누락을 구분합니다. 실제 서버에 연결하거나 메시지를 전송하지 않았습니다.
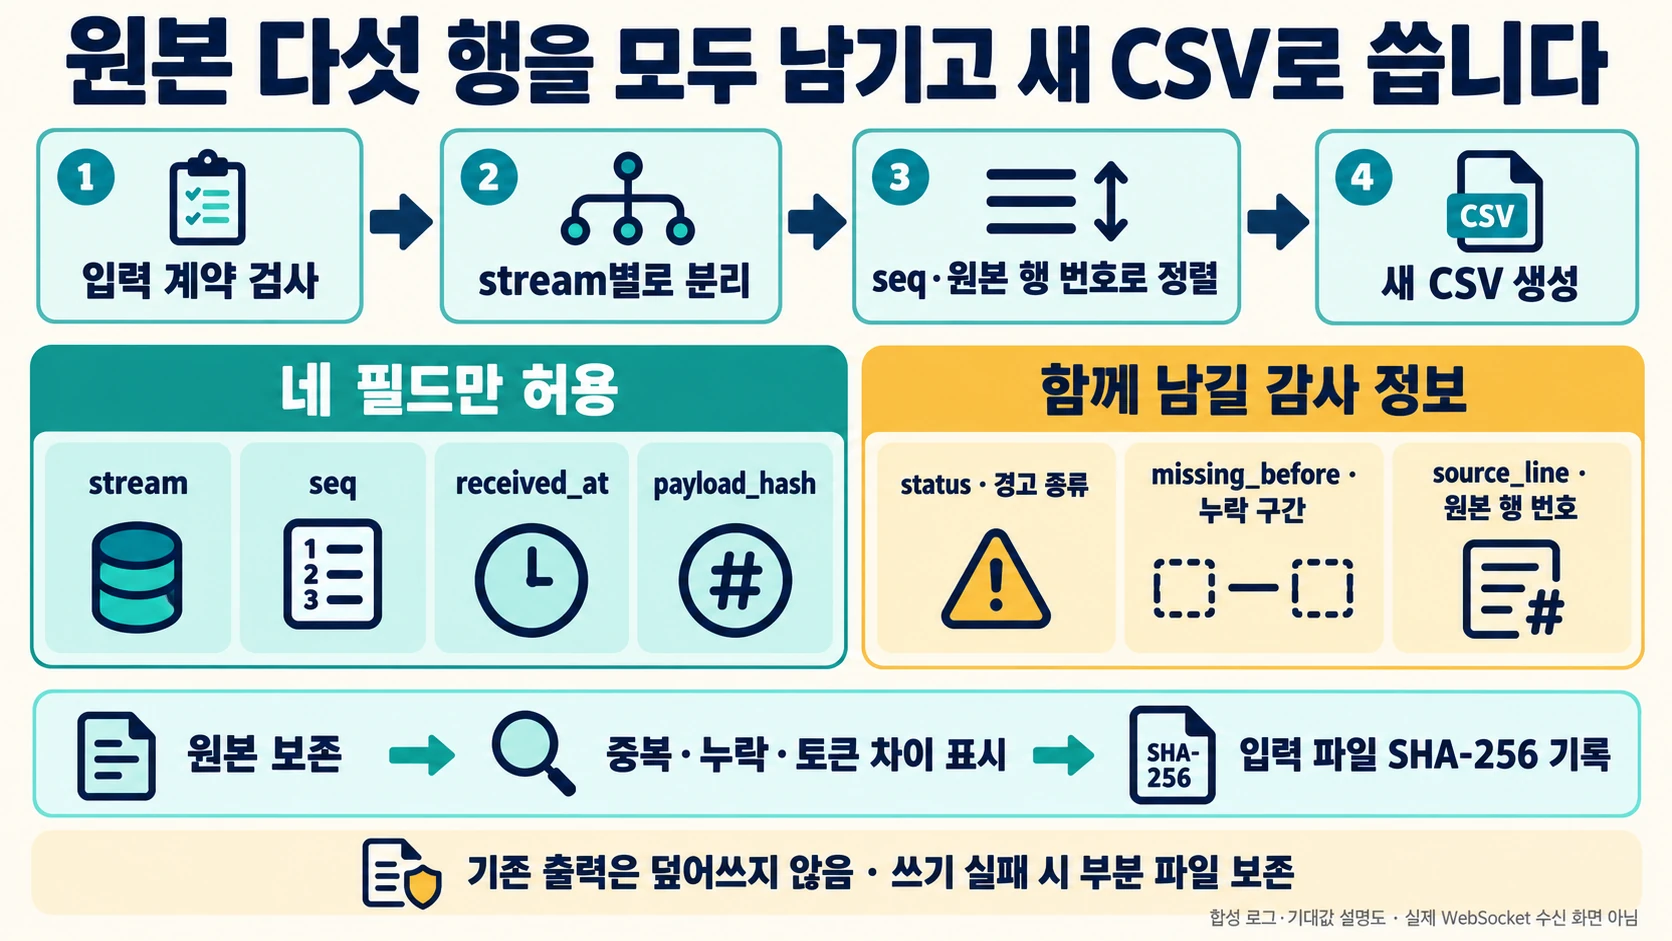
입력 계약: 네 필드의 가상 로그
events.ndjson은 한 줄마다 JSON 객체 하나를 둡니다. 시각과 stream 이름, 비교 토큰은 모두 합성 자료입니다. seq는 이 실습 애플리케이션이 정한 순번이며 WebSocket 프로토콜이 자동으로 붙인 순번이 아닙니다. RFC 6455는 WebSocket 메시지와 네트워크 프레이밍이 반드시 일대일로 대응하지는 않는다고 설명합니다. 따라서 프레임 수나 패킷 수를 이 로그의 메시지 수로 해석하지 않습니다.
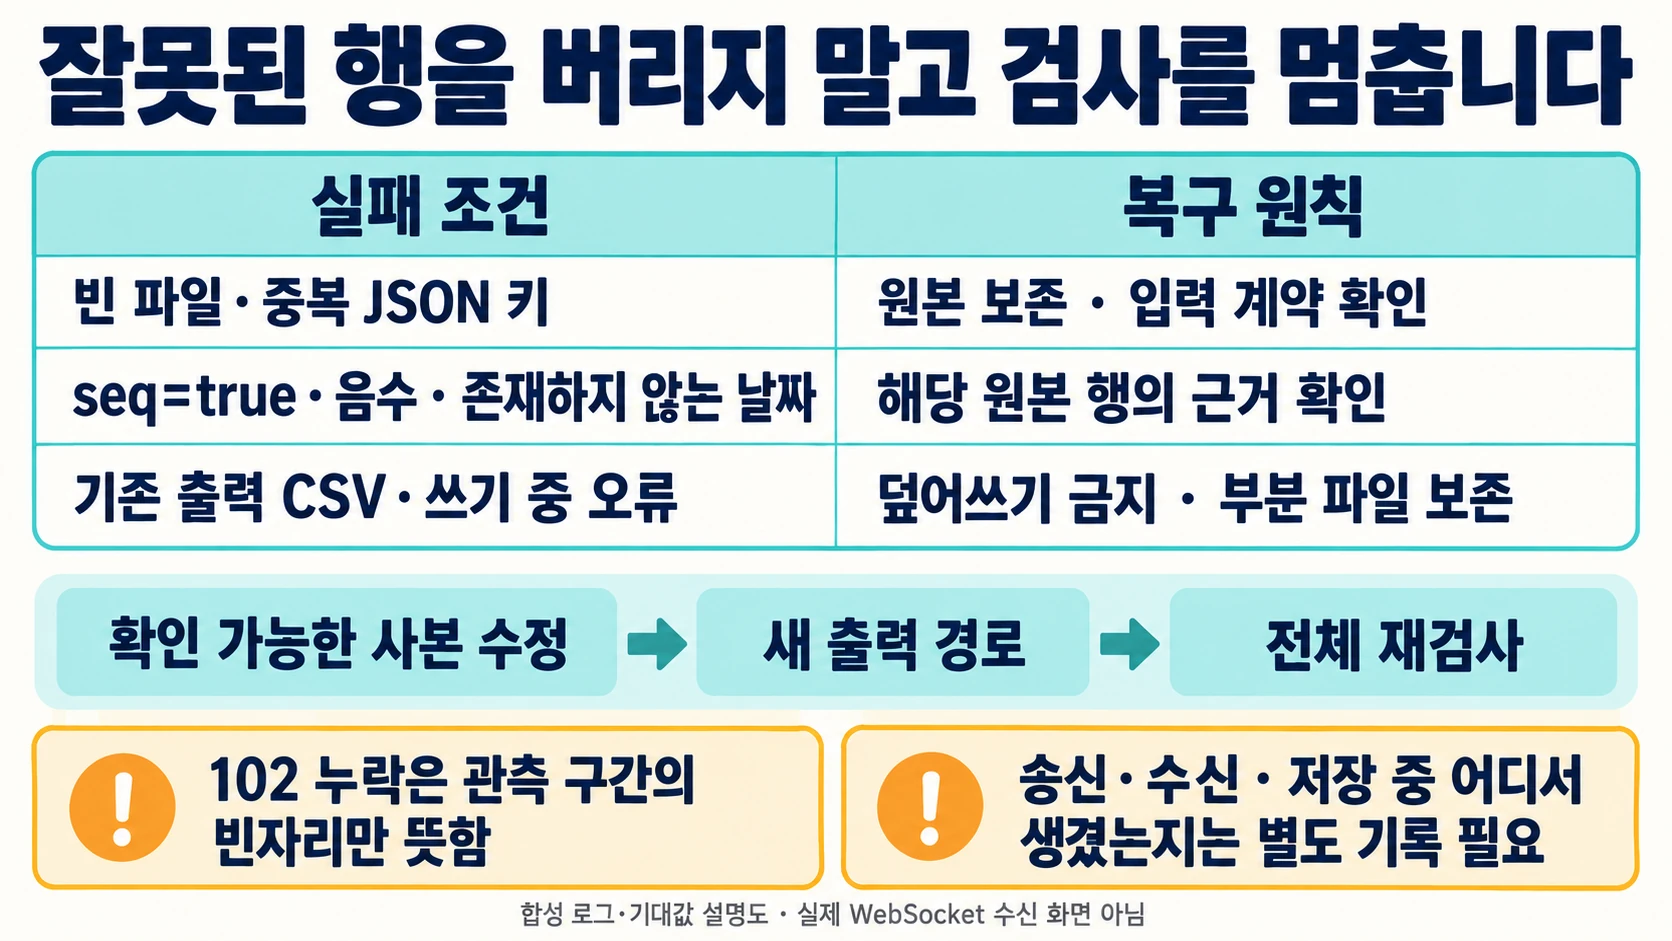
이 검사 코드가 읽는 단위는 패킷 캡처가 아니라 애플리케이션이 저장한 JSON 한 행입니다. 아래의 가상 입력에서 102 누락은 같은 stream에서 관측한 순번 사이의 빈자리라는 뜻입니다. 전송 중 유실됐는지, 수신 뒤 저장하지 못했는지, 송신자가 그 순번을 만들지 않았는지는 이 파일만으로 판정하지 않습니다. 원인을 찾으려면 송신·수신·저장 기록을 별도로 대조해야 하며 이 실습은 그 기록을 생성하지 않습니다.
{"stream":"alpha","seq":100,"received_at":"2026-09-06T00:00:00Z","payload_hash":"h100"}
{"stream":"alpha","seq":101,"received_at":"2026-09-06T00:00:01Z","payload_hash":"h101"}
{"stream":"alpha","seq":101,"received_at":"2026-09-06T00:00:02Z","payload_hash":"h101"}
{"stream":"alpha","seq":103,"received_at":"2026-09-06T00:00:03Z","payload_hash":"h103"}
{"stream":"beta","seq":7,"received_at":"2026-09-06T00:00:04Z","payload_hash":"b007"}
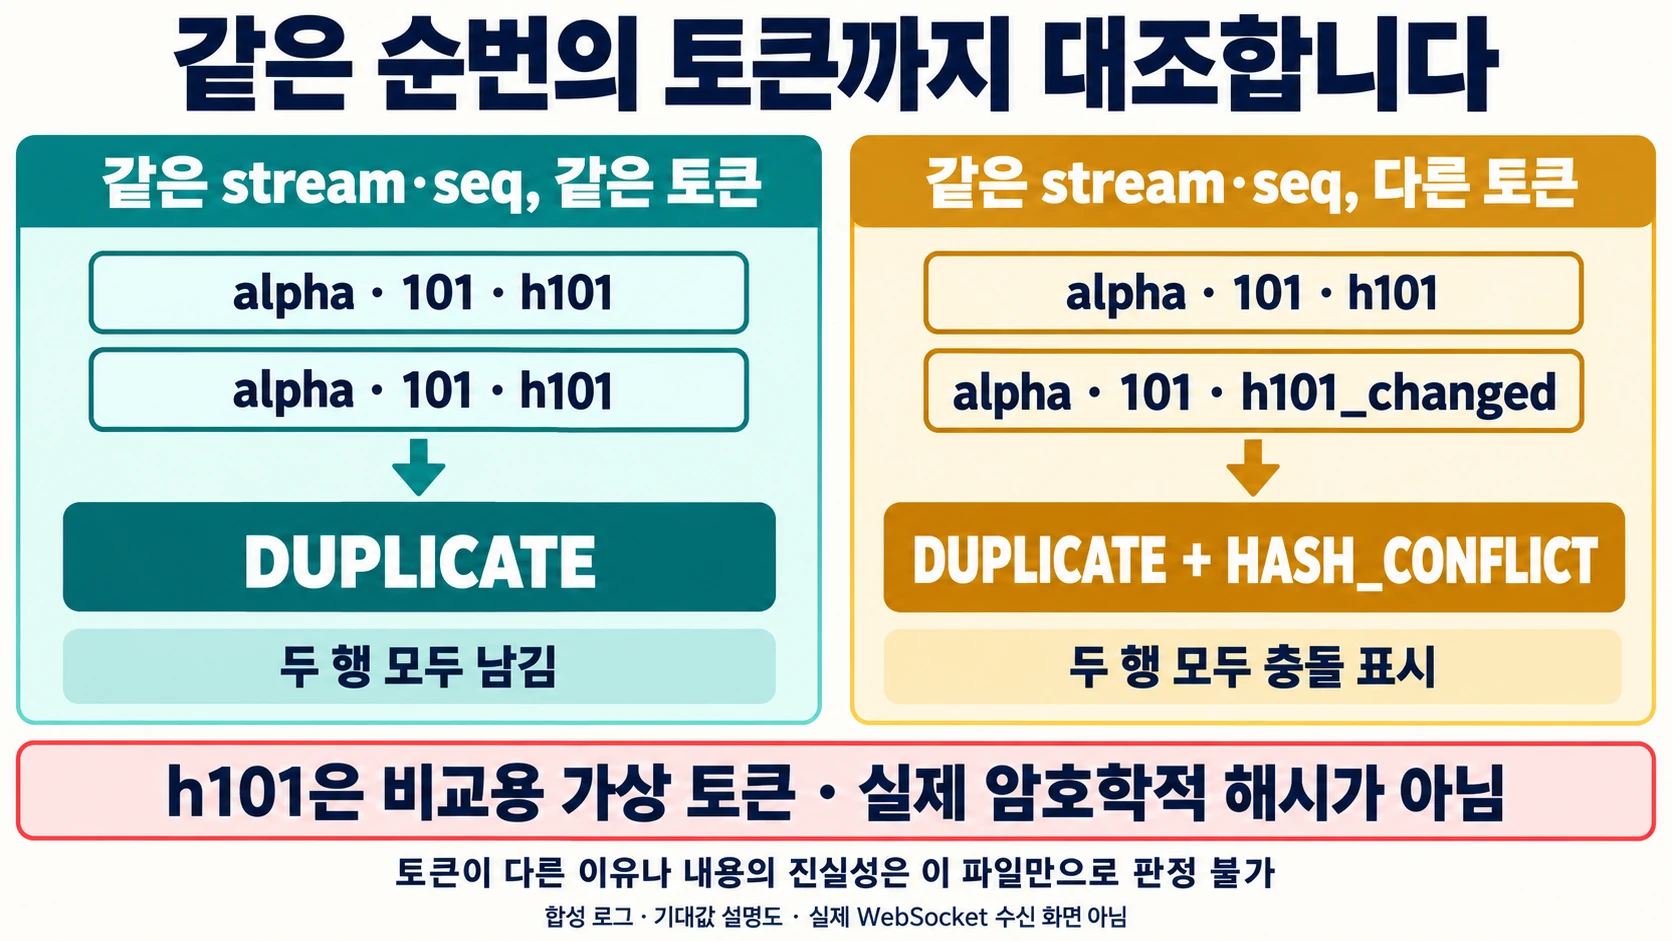
alpha에서는 100, 101, 101, 103이 보이므로 101이 중복이고 102가 관측 구간 안에서 빠져 있습니다. beta의 첫 순번이 7이어도 0부터 6을 누락이라고 추정하지 않습니다. 기록 시작 이전과 종료 이후에 무엇이 있어야 하는지는 이 입력만으로 알 수 없습니다. payload_hash의 h100 같은 값은 암호학적 해시를 계산한 것이 아니라 비교용 가상 토큰입니다. 이 코드의 HASH_CONFLICT는 같은 stream·seq의 비교 토큰이 다를 때 쓰는 표시이며, 암호학적 해시 충돌을 검출했다는 뜻은 아닙니다.
전체 코드: 중복을 보존하고 누락은 한 번만 세기
json.loads()는 object_pairs_hook 인수로 객체의 키·값 쌍을 처리할 수 있습니다. 여기서는 중복 JSON 키를 발견하면 중단하도록 해당 콜백을 사용합니다. 또한 Boolean을 정수 순번으로 받아들이지 않고 NaN이나 잘못된 UTC 날짜를 거부합니다. 각 stream을 순번으로 정렬하므로 수신 순서 역전 자체를 누락으로 잘못 세지 않습니다.
import argparse
import csv
import hashlib
import json
import os
import re
from collections import Counter, defaultdict
from datetime import datetime
from pathlib import Path

FIELDS = ["stream", "seq", "received_at", "payload_hash",
          "status", "missing_before", "source_line"]
REQUIRED = {"stream", "seq", "received_at", "payload_hash"}
LIMIT = 1_000_000

def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("Repeated JSON key.")
        result[key] = value
    return result

def reject_constant(value):
    raise ValueError("Nonstandard JSON numeric constant.")

def load_events(source):
    with source.open("rb") as handle:
        raw = handle.read(LIMIT + 1)
    if len(raw) > LIMIT:
        raise ValueError("Input exceeds the practice size limit.")
    events = []
    for line_no, text in enumerate(raw.decode("utf-8-sig").splitlines(), 1):
        if not text.strip():
            continue
        try:
            item = json.loads(text, object_pairs_hook=unique_object,
                              parse_constant=reject_constant)
            if type(item) is not dict or set(item) != REQUIRED:
                raise ValueError("Expected exactly the four contracted fields.")
            if type(item["seq"]) is not int or not 0 <= item["seq"] <= 999_999_999:
                raise ValueError("seq must be a nonnegative bounded JSON integer.")
            if not isinstance(item["stream"], str) or not re.fullmatch(
                r"[A-Za-z][A-Za-z0-9_-]{0,31}", item["stream"]
            ):
                raise ValueError("Invalid stream label.")
            if not isinstance(item["payload_hash"], str) or not re.fullmatch(
                r"[A-Za-z0-9][A-Za-z0-9_-]{0,63}", item["payload_hash"]
            ):
                raise ValueError("Invalid comparison token.")
            stamp = item["received_at"]
            if not isinstance(stamp, str) or not re.fullmatch(
                r"[0-9]{4}-[0-9]{2}-[0-9]{2}T[0-9]{2}:[0-9]{2}:[0-9]{2}Z", stamp
            ):
                raise ValueError("Use UTC YYYY-MM-DDTHH:MM:SSZ.")
            datetime.strptime(stamp, "%Y-%m-%dT%H:%M:%SZ")
            item["line_no"] = line_no
            events.append(item)
            if len(events) > 10_000:
                raise ValueError("Too many practice rows.")
        except (ValueError, TypeError, RecursionError) as exc:
            raise ValueError(f"Input line {line_no}: {exc}") from None
    if not events:
        raise ValueError("No events; an empty file is not an all-clear result.")
    return events, hashlib.sha256(raw).hexdigest()

def analyze(events):
    counts = Counter((x["stream"], x["seq"]) for x in events)
    tokens = defaultdict(set)
    groups = defaultdict(list)
    for item in events:
        key = (item["stream"], item["seq"])
        tokens[key].add(item["payload_hash"])
        groups[item["stream"]].append(item)
    rows = []
    missing_count = 0
    missing_ranges = 0
    for stream, items in sorted(groups.items()):
        previous = None
        for item in sorted(items, key=lambda x: (x["seq"], x["line_no"])):
            key = (stream, item["seq"])
            flags = []
            if counts[key] > 1:
                flags.append("DUPLICATE")
            if len(tokens[key]) > 1:
                flags.append("HASH_CONFLICT")
            gap = ""
            if previous is not None and item["seq"] > previous + 1:
                start, end = previous + 1, item["seq"] - 1
                gap = f"{start}-{end}"
                missing_count += end - start + 1
                missing_ranges += 1
                flags.append("GAP_AFTER_PREVIOUS")
            rows.append({
                "stream": stream, "seq": item["seq"],
                "received_at": item["received_at"],
                "payload_hash": item["payload_hash"],
                "status": "|".join(flags) if flags else "OK",
                "missing_before": gap, "source_line": item["line_no"],
            })
            if previous is None or item["seq"] > previous:
                previous = item["seq"]
    summary = {
        "rows": len(rows),
        "alerts": sum(row["status"] != "OK" for row in rows),
        "duplicate_keys": sum(count > 1 for count in counts.values()),
        "conflict_keys": sum(len(value) > 1 for value in tokens.values()),
        "missing_ranges": missing_ranges,
        "missing_count": missing_count,
    }
    return rows, summary

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", default="events.ndjson")
    parser.add_argument("--out", default="events_audit.csv")
    args = parser.parse_args()
    source, target = Path(args.input), Path(args.out)
    if target.suffix.lower() != ".csv" or source.resolve() == target.resolve():
        raise ValueError("Use a separate NEW CSV output.")
    events, digest = load_events(source)
    rows, summary = analyze(events)
    # Exclusive creation prevents replacing existing audits, including symlinks.
    with target.open("x", encoding="utf-8-sig", newline="") as handle:
        writer = csv.DictWriter(handle, fieldnames=FIELDS)
        writer.writeheader()
        writer.writerows(rows)
        handle.flush()
        os.fsync(handle.fileno())
    summary.update(input_sha256=digest, output=str(target))
    print(json.dumps(summary))

if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError, csv.Error) as exc:
        print("STOP:", type(exc).__name__, str(exc))
        print("No all-clear claim. Preserve input and any partial output; use a new reviewed output path.")
        raise SystemExit(1) from None
기본 실행과 예상 CSV
python3 audit_stream.py
python3 audit_stream.py --input events_conflict.ndjson --out conflict_audit.csv
python3 audit_stream.py --input events_gap_duplicate.ndjson --out gap_duplicate_audit.csv
python3 -m unittest -v test_example.py
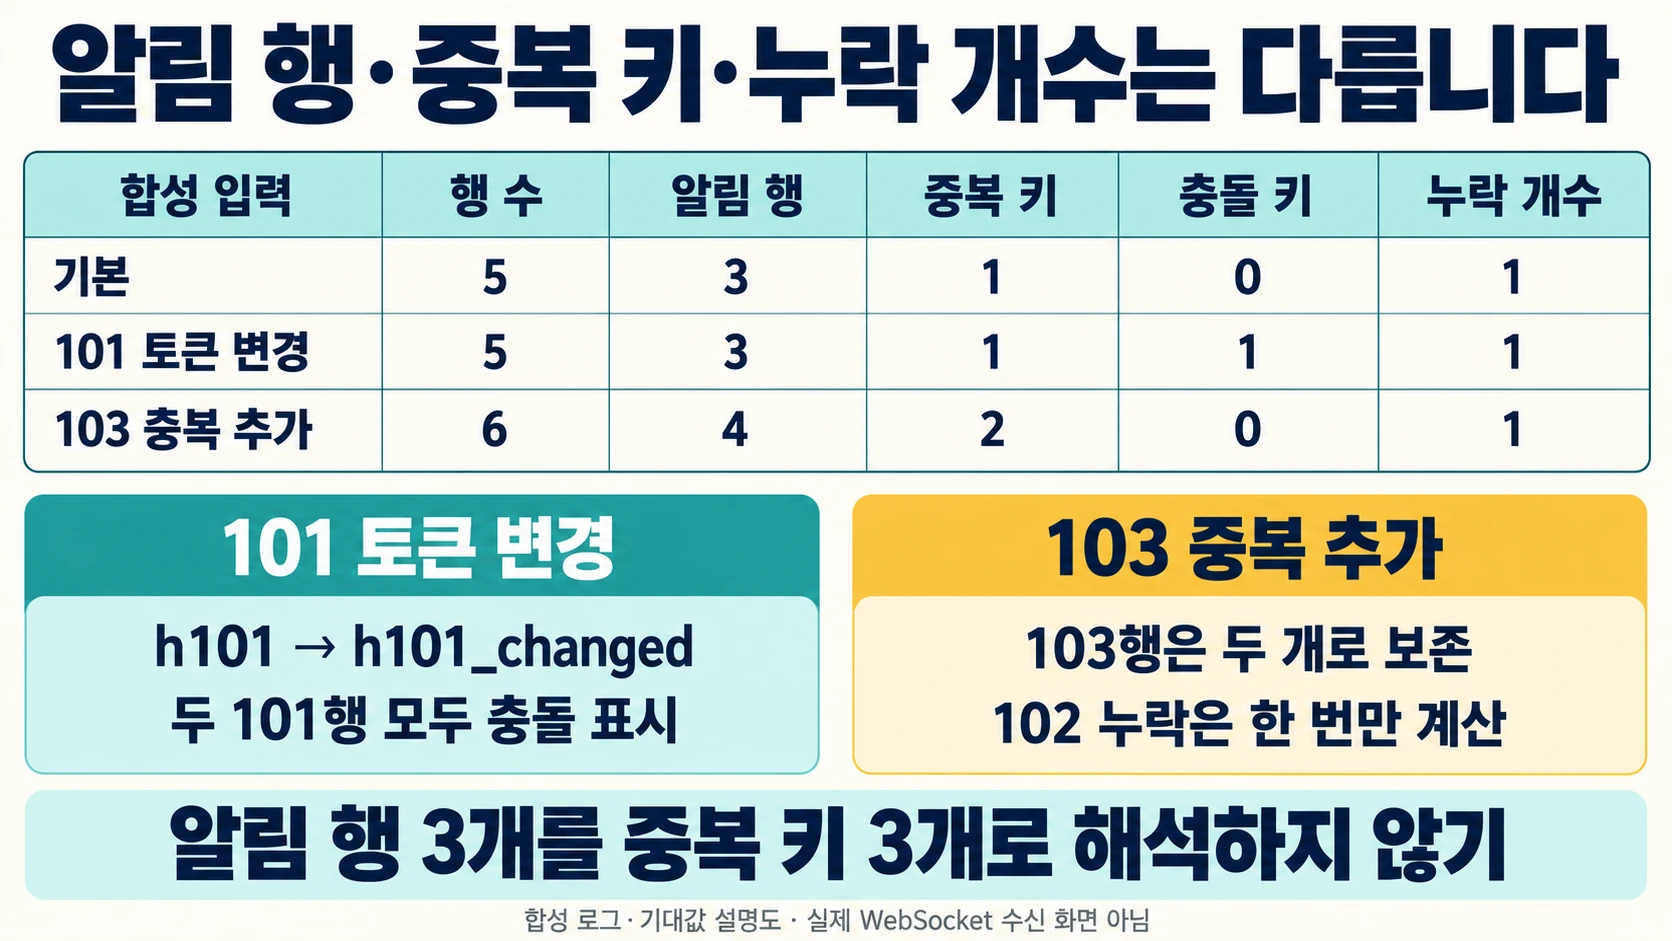
기본 출력 events_audit.csv는 입력 다섯 행을 모두 담습니다. 두 101 행의 status는 각각 DUPLICATE이고, 103 행은 GAP_AFTER_PREVIOUS와 missing_before=102-102를 담습니다. 100과 beta 7은 OK입니다. 알림 행이 3이라는 숫자는 중복 키가 3개라는 뜻이 아닙니다.
입력 파일: events.ndjson
- 행 수: 5
- 알림 행: 3
- 중복 키: 1
- 충돌 키: 0
- 누락 개수: 1
입력 파일: events_conflict.ndjson
- 행 수: 5
- 알림 행: 3
- 중복 키: 1
- 충돌 키: 1
- 누락 개수: 1
입력 파일: events_gap_duplicate.ndjson
- 행 수: 6
- 알림 행: 4
- 중복 키: 2
- 충돌 키: 0
- 누락 개수: 1
충돌 파일은 세 번째 행의 h101만 h101_changed로 바꿉니다. 두 101 행 모두 HASH_CONFLICT가 추가됩니다. 마지막 파일은 alpha 103을 한 번 더 넣지만 102 누락을 다시 세지 않습니다. 실제 Python으로 세 CLI 실행과 테스트 6개를 확인했고, 비교용 CSV를 ZIP의 expected 폴더에 넣었습니다.
실패했을 때 원본 로그를 남기는 이유
오류 복구는 원본을 보존한 사본에서 진행합니다. 잘못된 날짜를 확인 가능한 기록에 맞게 수정하거나, JSON 키 중복 원인을 해결한 다음 새 출력 경로로 다시 검사합니다. 임의의 값을 넣어 통과시키지 않습니다. 빈 파일은 문제가 없다는 뜻이 아니므로 중단합니다. 같은 JSON 키를 두 번 적은 행, seq=true, 음수 순번, 존재하지 않는 날짜, 계약 밖 필드는 거부합니다. 입력 행 번호를 오류에 남겨 해당 원문을 찾을 수 있게 합니다. 잘못된 행을 조용히 버리면 로그 전체가 정상처럼 보일 수 있으므로 자동 삭제하지 않습니다.
이미 출력 CSV가 있으면 FileExistsError로 멈춥니다. 이전 감사 결과는 보존하고 다른 --out 경로로 다시 실행하세요. 쓰기 도중 실패하면 부분 파일을 유지하며 정상 완료로 보고하지 않습니다. 원본과 출력의 관계는 JSON에 출력된 input_sha256으로 확인할 수 있습니다.
적용 범위와 한계
입력은 최대 1 MB와 10000행으로 제한한 파일 실습입니다. 값 문법은 CSV에 수식처럼 시작하는 라벨이 들어오지 않도록 좁게 정했습니다. 실제 payload의 진실성이나 토큰 생성 방식, 재연결 복구와 수신 보장은 검사하지 않습니다. 다른 stream 간 순번은 비교하지 않으며, 예상 시작·종료 순번이 없는 한 관측 범위 밖 누락은 판정할 수 없습니다.
실행 순서 정리
-
audit_stream.py와 세 NDJSON 입력 파일을 같은 빈 실습 폴더에 저장합니다.
-
위 세 명령을 각각 다른 출력 경로로 실행해 모든 입력 행을 보존한 CSV를 생성합니다.
-
기본·충돌·103 중복 결과를 예상 표와 비교하고 test_example.py로 잘못된 날짜와 순번 거부를 확인합니다.
예제 흐름 그림
공식 자료
https://www.rfc-editor.org/rfc/rfc6455.html
json — JSON encoder and decoder
출처 원문 수집일: S1 2026-09-24; S2 2026-09-24.
이어서 연습할 글
연결 성공과 저장 실패를 먼저 나누어 관찰하는 연습은 루프백 HTTP 점검에서, 입력을 보존한 채 계산 경계를 확인하는 연습은 합성 센서의 이동창 평균 검산에서 이어집니다.
작성자 소개
