CSV 행별 금액이 수량×단가와 맞는지 Python으로 검산하기
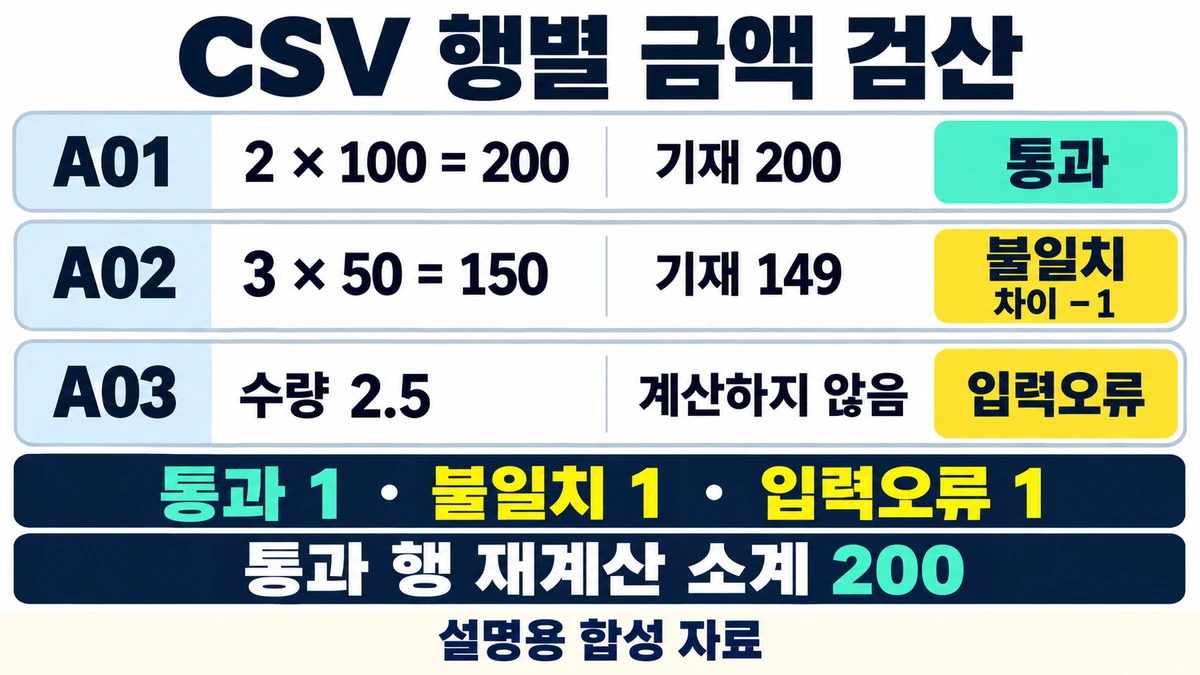
설명용 합성 자료의 도해이며 실제 거래·앱 화면이 아닙니다. 소계 200은 통과한 한 행만 포함합니다.
CSV에 금액 열이 이미 있어도 그 숫자를 그대로 합치기 전에 같은 행의 수량과 단가로 다시 계산해 보세요. 이 실습은 세 행을 통과 1·금액불일치 1·입력오류 1로 나누고, 불일치 행의 예상금액 150과 차이 −1을 보고서에 남깁니다. 통과한 행의 재계산 소계는 200입니다.
입력은 모두 직접 만든 합성 자료입니다. 실제 고객·매출 자료나 거래 규칙이 아닙니다. 로컬 CSV만 읽으며 API 호출과 외부 서버 연결은 없습니다. Python 기초와 터미널 명령 실행을 아는 독자를 위한 예제입니다.
1 먼저 금액의 뜻과 허용오차를 정합니다
이번 금액은 수량×단가만으로 만든 금액입니다. 부가세·할인·배송비·환율 변환과 반올림은 적용하지 않습니다. 실제 파일의 금액이 그 항목을 포함한다면 이 검사식을 바로 적용하지 말고 계산 계약부터 확인하세요.
비교는 다음 세 단계입니다.
expected_amount = qty × unit_price로 예상금액을 독립 계산합니다difference = amount − expected_amount로 방향이 있는 차이를 남깁니다abs(difference) <= tolerance이면 통과합니다
--tolerance의 기본값은 0입니다. 표기가 0.30과 0.3이어도 숫자가 같으면 정확 일치로 통과합니다. 허용오차는 동일한 금액 단위의 절대 차이이며 비율이나 반올림 자릿수가 아닙니다. --tolerance 0.01을 지정하면 차이의 절댓값이 정확히 0.01인 행까지 통과합니다.
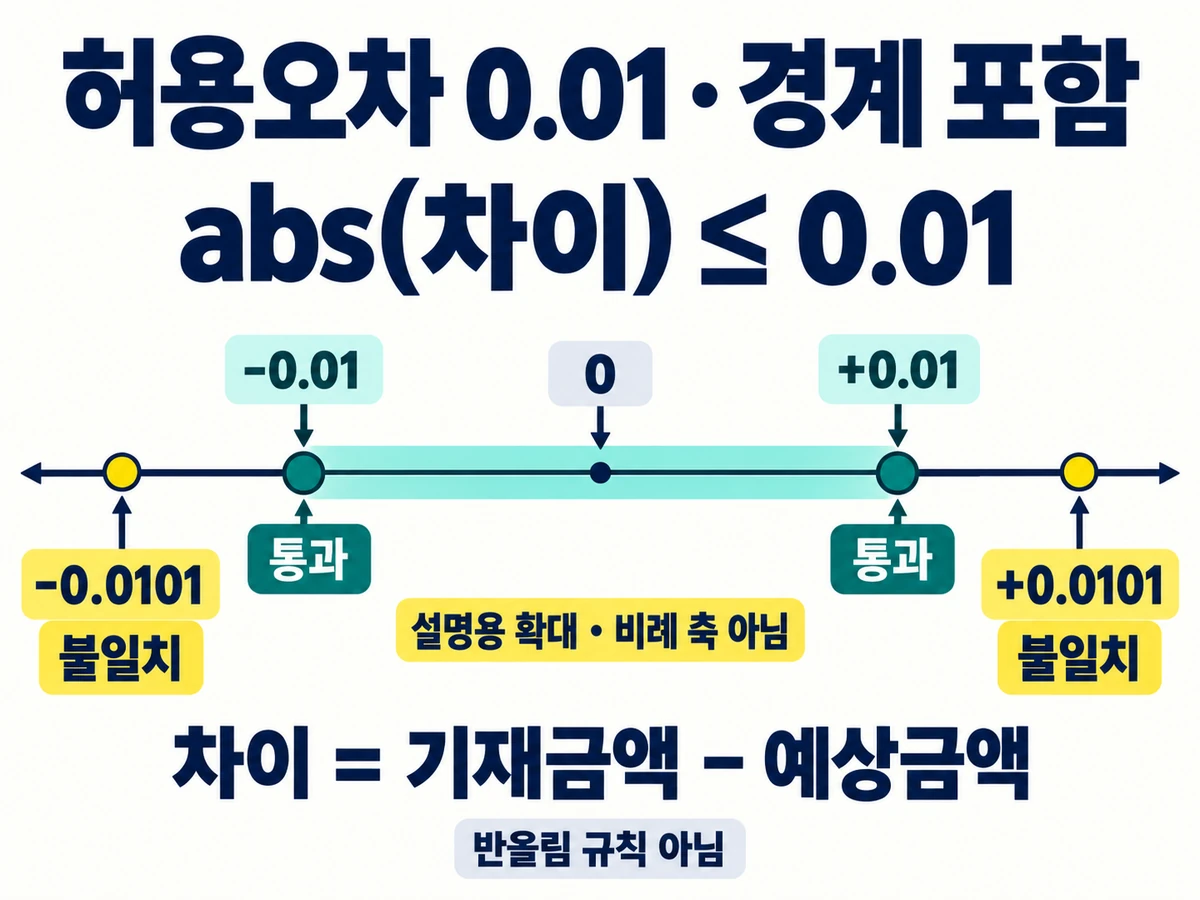
허용오차는 데이터에서 적당히 추측하는 값이 아닙니다. 결과를 보기 전에 승인된 기준으로 정하고 보고서의 tolerance와 함께 보관하세요. 차이의 원인을 확인하지 않고 허용오차를 늘리면 오류 행을 통과시킬 수 있습니다.

2 같은 세 행과 입력 계약을 확인합니다
실습 ZIP 받기: 행별 금액 검산 파일을 새 빈 로컬 폴더에 풀고 fixtures/main.csv를 텍스트 편집기로 엽니다.
id,qty,unit_price,amount
A01,2,100,200
A02,3,50,149
A03,2.5,10,25
직접 계산한 기준은 다음과 같습니다.
| ID | 수량×단가 | 기재금액 | 차이 | 기본 허용오차 0의 판정 |
|---|---|---|---|---|
| A01 | 2×100=200 | 200 | 0 | pass |
| A02 | 3×50=150 | 149 | −1 | amount_mismatch |
| A03 | 계산하지 않음 | 25 | 계산하지 않음 | invalid, qty_format |
A02는 숫자로 읽을 수 있지만 열 사이 관계가 맞지 않습니다. A03은 낱개 정수 수량 표기에 맞지 않으므로 2로 잘라 계산하거나, 25가 맞는 것처럼 승인하지 않습니다.
이 예제가 받는 범위는 아래와 같습니다.
- 파일: UTF-8 또는 UTF-8 BOM, 쉼표 CSV, 1,000,000바이트 이하, 데이터 1~10,000행
- 구조: 머리글이 정확히
id,qty,unit_price,amount순서이고 매 레코드는 네 열 - ID: ASCII 영문으로 시작해 영문·숫자·밑줄·하이픈만 사용, 1~32자, 대소문자 구분, 중복 불허
- 수량:
0또는 0이 아닌 숫자로 시작하는 ASCII 정수, 범위 0~999999 - 단가: 부호 없는 ASCII 정수 또는 일반 소수, 불필요한 앞자리 0 없이 소수 1~4자리, 범위 0~999999.9999
- 기재금액과 허용오차: 단가와 같은 표기, 범위 0~999999999999.9999
2.0, +2, 01, 빈 수량은 받지 않습니다. 금액의 NaN, Infinity, 1e2, 1_000, 앞뒤 공백, 소수 5자리도 받지 않습니다. "1,000"은 CSV에서는 한 필드이지만 허용한 금액 표기가 아닙니다. 자동 공백 제거나 기호 제거도 하지 않습니다. CSV 필드 하나의 파서 한도는 131072자이며 이 한도를 넘으면 파일 전체를 중단합니다.
모든 금액에 같은 하나의 단위를 쓴다는 전제입니다. 통화 열이 없으므로 원·달러가 섞인 파일을 찾아내거나 환산할 수 없습니다. 범위 숫자는 연습용 입력 계약이며 회계·세금 규정이 아닙니다.
Python csv.reader 문서는 기본 필드를 문자열로 돌려준다고 설명합니다. 이 코드는 자동 float 변환 옵션을 사용하지 않고 원문을 먼저 검사합니다. strict=True의 CSV 구문 검사 외에 헤더·열 수·ID 조건도 별도로 확인합니다.
3 전체 코드를 저장합니다
아래는 ZIP의 code/row_amount_checks.py와 같은 전체 코드입니다. Python 3.12 표준 라이브러리만 사용하며 추가 패키지나 API 키가 필요하지 않습니다.
"""Check synthetic CSV cross-column amounts without trusting stated totals."""
import argparse
import csv
import hashlib
import io
import json
import os
from pathlib import Path
import re
import stat
import sys
import tempfile
from decimal import Context, Decimal, DecimalException, Inexact, localcontext

HEADER = ['id', 'qty', 'unit_price', 'amount']
ID = re.compile(r'[A-Za-z][A-Za-z0-9_-]{0,31}\Z')
QTY = re.compile(r'(?:0|[1-9][0-9]{0,5})\Z')
PRICE = re.compile(r'(?:0|[1-9][0-9]{0,6})(?:\.[0-9]{1,4})?\Z')
AMOUNT = re.compile(r'(?:0|[1-9][0-9]{0,11})(?:\.[0-9]{1,4})?\Z')
MAX_PRICE = Decimal('999999.9999')
MAX_AMOUNT = Decimal('999999999999.9999')
MAX_BYTES, MAX_ROWS, MAX_FIELD = 1_000_000, 10_000, 131_072


def safe_path(value):
    path = Path(value)
    if '..' in path.parts:
        raise ValueError('.. 경로 대신 직접 경로를 지정하세요')
    path = path.absolute()
    for part in [path, *path.parents]:
        if part.is_symlink():
            raise ValueError('심볼릭 링크와 링크 폴더는 사용하지 않습니다')
    return path


def read_source(source):
    source = safe_path(source)
    info = source.stat()
    if not stat.S_ISREG(info.st_mode) or info.st_nlink != 1:
        raise ValueError('입력은 하드 링크가 아닌 일반 파일이어야 합니다')
    flags = os.O_RDONLY | getattr(os, 'O_NOFOLLOW', 0) | getattr(os, 'O_NONBLOCK', 0)
    with os.fdopen(os.open(source, flags), 'rb') as handle:
        opened = os.fstat(handle.fileno())
        if (opened.st_dev, opened.st_ino) != (info.st_dev, info.st_ino):
            raise ValueError('읽기 전 입력 파일이 바뀌었습니다')
        if not stat.S_ISREG(opened.st_mode) or opened.st_nlink != 1:
            raise ValueError('입력 파일 유형 또는 링크 수를 확인하세요')
        raw = handle.read(MAX_BYTES + 1)
        after = os.fstat(handle.fileno())
    if (opened.st_size, opened.st_mtime_ns) != (after.st_size, after.st_mtime_ns):
        raise ValueError('읽는 중 입력 파일이 바뀌었습니다')
    if len(raw) > MAX_BYTES:
        raise ValueError('입력 한도 1,000,000바이트 초과')
    return raw


def number(raw, pattern, maximum, field):
    if not pattern.fullmatch(raw):
        return None, field + '_format'
    value = Decimal(raw)
    if not value.is_finite() or not Decimal('0') <= value <= maximum:
        return None, field + '_range'
    return value, None


def plain(value):
    text = format(value, 'f')
    if '.' in text:
        text = text.rstrip('0').rstrip('.')
    return '0' if value == 0 else text


def inspect(source, tolerance='0'):
    tol, issue = number(tolerance, AMOUNT, MAX_AMOUNT, 'tolerance')
    if issue:
        raise ValueError('허용오차는 부호 없는 유한 십진수, 소수 최대 4자리입니다')
    raw = read_source(source)
    try:
        text = raw.decode('utf-8-sig', errors='strict')
    except UnicodeDecodeError as error:
        raise ValueError('UTF-8 해석 실패: 인코딩을 자동 추정하지 않습니다') from error
    rows, seen = [], set()
    total = Decimal('0')
    old_limit = csv.field_size_limit(MAX_FIELD)
    try:
        reader = csv.reader(io.StringIO(text, newline=''), strict=True)
        if next(reader, None) != HEADER:
            raise ValueError('머리글은 id,qty,unit_price,amount 순서여야 합니다')
        # At most 12 integer + 4 fraction digits per product, 10,000 rows.
        # A sum needs at most 16 integer + 4 fraction digits; precision 28 suffices.
        with localcontext(Context(prec=28)) as context:
            context.traps[Inexact] = True
            for record, fields in enumerate(reader, 2):
                if record - 1 > MAX_ROWS:
                    raise ValueError('행 한도 10,000행 초과')
                if len(fields) != 4:
                    raise ValueError(f'레코드 {record}: 열 수는 4개여야 합니다')
                ident, q, p, a = fields
                if not ID.fullmatch(ident) or ident in seen:
                    raise ValueError(f'레코드 {record}: ID 형식 또는 중복을 확인하세요')
                seen.add(ident)
                qty, qi = number(q, QTY, Decimal('999999'), 'qty')
                price, pi = number(p, PRICE, MAX_PRICE, 'unit_price')
                amount, ai = number(a, AMOUNT, MAX_AMOUNT, 'amount')
                issues = [x for x in (qi, pi, ai) if x]
                expected = difference = None
                status = 'invalid'
                if not issues:
                    expected = qty * price
                    difference = amount - expected
                    status = 'pass' if difference.copy_abs() <= tol else 'amount_mismatch'
                    if status == 'pass':
                        total += expected
                rows.append({
                    'source_record': record, 'id': ident, 'raw_qty': q,
                    'raw_unit_price': p, 'raw_amount': a, 'status': status,
                    'issues': issues,
                    'expected_amount': None if expected is None else plain(expected),
                    'difference': None if difference is None else plain(difference),
                })
    except csv.Error as error:
        raise ValueError('CSV 구문 또는 필드 길이 오류: ' + str(error)) from error
    except DecimalException as error:
        raise ValueError('Decimal 계산 실패: 범위·정밀도 계약을 확인하세요') from error
    finally:
        csv.field_size_limit(old_limit)
    if not rows:
        raise ValueError('데이터 행이 1개 이상 필요합니다')
    counts = {s: sum(r['status'] == s for r in rows) for s in ('pass', 'amount_mismatch', 'invalid')}
    return {
        'input_rows': len(rows), 'pass_count': counts['pass'],
        'mismatch_count': counts['amount_mismatch'], 'invalid_count': counts['invalid'],
        'validated_amount_total': plain(total),
        'all_rows_pass': counts['pass'] == len(rows), 'tolerance': plain(tol),
        'difference_definition': 'stated_amount_minus_qty_times_unit_price',
        'comparison': 'abs(difference) <= tolerance',
        'total_scope': 'recomputed expected amounts of pass rows only',
        'rows': rows, 'source_sha256': hashlib.sha256(raw).hexdigest(),
    }


def write_report(source, target, tolerance='0'):
    source, target = safe_path(source), safe_path(target)
    if source == target:
        raise ValueError('입력과 보고서는 서로 다른 경로여야 합니다')
    if target.suffix.lower() != '.json':
        raise ValueError('보고서는 새 .json 파일로 지정하세요')
    if os.path.lexists(target):
        raise ValueError('기존 보고서 보존: 새 --report 이름을 지정하세요')
    report = inspect(source, tolerance)
    rendered = json.dumps(report, ensure_ascii=False, indent=2) + '\n'
    target.parent.mkdir(parents=True, exist_ok=True)
    safe_path(target)
    temporary, committed = None, False
    try:
        with tempfile.NamedTemporaryFile(mode='w', encoding='utf-8', newline='\n',
                delete=False, dir=target.parent, prefix='.row-amount-', suffix='.tmp') as handle:
            temporary = Path(handle.name)
            handle.write(rendered)
            handle.flush()
            os.fsync(handle.fileno())
        # Same directory: publish only a fully written new file, never overwrite.
        os.link(temporary, target)
        committed = True
    finally:
        if temporary is not None:
            try:
                temporary.unlink(missing_ok=True)
            except OSError as error:
                if not committed:
                    raise
                print('경고: 완성 보고서는 저장됐지만 임시 파일 정리에 실패했습니다: '
                      + str(error), file=sys.stderr)
    return report


def main():
    parser = argparse.ArgumentParser(description='CSV 행별 수량×단가와 기재금액 검산')
    parser.add_argument('--input', required=True)
    parser.add_argument('--report', required=True)
    parser.add_argument('--tolerance', default='0', help='절대 허용오차, 기본값 0')
    args = parser.parse_args()
    try:
        report = write_report(args.input, args.report, args.tolerance)
    except (ValueError, OSError) as error:
        print('오류: ' + str(error), file=sys.stderr)
        return 2
    print(f"입력 {report['input_rows']}행 / 통과 {report['pass_count']} / "
          f"금액불일치 {report['mismatch_count']} / 입력오류 {report['invalid_count']} / "
          f"통과 행 재계산 소계 {report['validated_amount_total']} / 허용오차 {report['tolerance']}")
    return 0 if report['all_rows_pass'] else 1


if __name__ == '__main__':
    raise SystemExit(main())
숫자 열에 부적합한 값이 있으면 행을 invalid로 기록하고 원문과 issues를 보존합니다. 다른 정상 행은 검산하지만 invalid 행에는 예상금액과 차이를 null로 남깁니다. 같은 행에 형식 문제가 여러 개면 각각의 이유를 남깁니다.
계산에는 문자열에서 바로 만든 Decimal을 씁니다. Decimal 생성자는 특수값과 다양한 표기도 받을 수 있으므로 생성 성공만으로 업무 숫자를 승인하지 않습니다. 정규식과 유한값·범위 검사부터 통과시킵니다.
Decimal도 정밀도가 부족하면 연산 결과가 반올림될 수 있습니다. 이번 최대 곱은 999999×999999.9999=999998999900.0001이며 정수부 12자리·소수부 4자리입니다. 이를 최대 10,000행 더해도 정수부 16자리·소수부 4자리 안에 들어가므로 28자리 정밀도로 계산합니다. localcontext 문서의 계산 범위를 쓰고 Inexact 예외를 켜서 뜻하지 않은 값 손실을 중단합니다. 입력 한도를 늘리면 이 근거와 시험도 다시 정해야 합니다.
보고서 숫자는 JSON 문자열입니다. plain()은 0.30을 0.3으로 표시하고 끝의 0만 줄일 뿐 값을 반올림하지 않습니다. 원래 표기는 raw_qty, raw_unit_price, raw_amount에 남습니다. source_record는 헤더를 1로 센 논리 레코드 번호이며 따옴표 안 줄바꿈이 있으면 물리 줄 번호와 다를 수 있습니다.
4 통과 1과 소계 200을 함께 읽습니다
ZIP을 푼 폴더에서 명령을 하나씩 실행합니다. 검수 환경은 Linux의 CPython 3.12.14입니다.
python --version
python code/row_amount_checks.py --input fixtures/main.csv --report out/main.json
화면의 결과는 다음과 같습니다.
입력 3행 / 통과 1 / 금액불일치 1 / 입력오류 1 / 통과 행 재계산 소계 200 / 허용오차 0
이 실행의 종료코드는 1입니다. 오류 때문에 보고서가 없다는 뜻이 아니라, 완성된 보고서에 확인할 행이 남았다는 뜻입니다. out/main.json에서 다음 값을 대조합니다.
pass_count=1,mismatch_count=1,invalid_count=1, 세 수의 합이 입력 3행과 같음- A02:
status=amount_mismatch,expected_amount="150",difference="-1" - A03:
status=invalid,issues=["qty_format"], 예상금액과 차이는null validated_amount_total="200",all_rows_pass=false,tolerance="0"
validated_amount_total은 통과한 행의 수량×단가만 더한 소계입니다. 149나 25를 더해 세 행 전체의 확정 금액처럼 표시하지 않습니다. 허용오차가 0보다 큰 경우에도 소계는 재계산한 예상금액을 더하며, 입력의 기재금액을 더한 값과 다를 수 있습니다.
종료코드의 의미는 다음과 같습니다.
| 종료코드 | 보고서와 판정 | 다음 행동 |
|---|---|---|
| 0 | 새 보고서 생성, 모든 행 통과 | 이 검사 범위 안의 결과를 대조 |
| 1 | 새 보고서 생성, 불일치 또는 부적합 행 존재 | 행 ID·원문·차이·이유 검토 |
| 2 | 옵션·입력·구조·경로·저장 오류 | 새 최종 보고서 없음, 원인 복구 |
모든 행 통과도 실제 판매 수량이나 단가의 진위를 보증하지 않습니다. 잘못된 수량·단가·금액이 서로 맞아떨어질 수 있으므로 원본 거래와의 대조는 별도입니다. 첫 실행처럼 종료코드 1을 의도한 명령을 &&로 이어 쓰면 다음 명령이 실행되지 않을 수 있습니다.
5 허용오차의 경계와 바로 바깥을 시험합니다
fixtures/tolerance.csv는 다음 네 행입니다. 예상금액은 각 행 모두 1입니다.
id,qty,unit_price,amount
T01,1,1,1.01
T02,1,1,1.0101
T03,1,1,0.99
T04,1,1,0.9899
python code/row_amount_checks.py --input fixtures/tolerance.csv --report out/tolerance_001.json --tolerance 0.01
python code/row_amount_checks.py --input fixtures/tolerance.csv --report out/tolerance_exact.json
| ID | 기재금액−예상금액 | 허용오차 0.01 | 기본 0 |
|---|---|---|---|
| T01 | 0.01 | pass, 정확 경계 | amount_mismatch |
| T02 | 0.0101 | amount_mismatch | amount_mismatch |
| T03 | −0.01 | pass, 정확 경계 | amount_mismatch |
| T04 | −0.0101 | amount_mismatch | amount_mismatch |
허용오차 0.01에서는 통과 2·불일치 2·입력오류 0, 재계산 소계 2입니다. 기본 0에서는 통과 0·불일치 4·소계 0입니다. 두 실행 모두 종료코드 1입니다. 손계산 기대값은 expected/tolerance_001.json과 expected/tolerance_exact.json에 각각 있습니다.
--tolerance -0.01, --tolerance NaN, --tolerance Infinity는 종료코드 2로 거부합니다. 0.01이 특정 통화나 청구에 적절하다는 뜻은 아닙니다. 단위를 확인한 업무 기준으로 따로 정하세요.
6 숫자 오류와 파일 오류를 나누어 복구합니다
다음 명령은 17행의 숫자 반례를 검사해 새 보고서를 만듭니다.
python code/row_amount_checks.py --input fixtures/bad_numbers.csv --report out/bad_numbers.json
이 파일에는 단가·금액의 NaN와 Infinity, True 수량, 지수·천 단위 구분·빈칸·공백·소수 5자리·앞자리 0·음수·+ 부호·범위 초과·전각 숫자·밑줄 표기가 있습니다. 통과 0·불일치 0·입력오류 17·소계 0, 종료코드 1이 기대값입니다. 숫자 의미가 확인되지 않은 값을 금액불일치로 단정하지 않으며 모두 계산 전 invalid로 남깁니다.
반면 다음 세 명령은 파일 검사 단계에서 종료코드 2로 멈추고 지정한 새 최종 보고서를 만들지 않습니다.
python code/row_amount_checks.py --input fixtures/failures/wrong_header.csv --report out/rejected_header.json
python code/row_amount_checks.py --input fixtures/failures/invalid_utf8.csv --report out/rejected_encoding.json
python code/row_amount_checks.py --input fixtures/not_here.csv --report out/rejected_missing.json
| 관찰한 상태 | 먼저 확인할 것 | 복구 후 대조 |
|---|---|---|
| amount_mismatch | 같은 행의 수량·단가·기재금액 및 세금·할인 계약 | 승인된 사본으로 새 보고서, 차이와 적용 규칙 확인 |
| invalid | 원문 표기·범위·낱개 수량 단위 | 임의 절삭·0 대체 없이 근거 있는 수정 |
| 머리글·열 수·중복 ID 오류 | 공급 파일 구조와 식별 기준 | 모든 행 다시 검사, 부분 결과 사용 안 함 |
| UTF-8 해석 실패 | 실제 인코딩과 내보내기 설정 | 원본 보존 후 UTF-8 사본의 내용 대조 |
| 입력 없음·저장 오류 | 파일 위치·폴더 권한·하드 링크 지원 | 새 로컬 실습 폴더와 새 결과 이름 |
ZIP의 fixtures/failures에는 위 사례 외에 추가 열, 중복 ID, 잘못된 ID, 닫히지 않은 따옴표, 헤더만 있는 파일, 빈 레코드가 있습니다. 이 8개는 각각 전체 중단 사례입니다. 구조가 틀린 파일의 앞쪽 정상 행만 보고서로 내보내지 않습니다.
A02의 149를 곧바로 150으로 고치지 마세요. 단가가 틀렸는지, 계약에 할인액이 있는지 먼저 원본에서 확인해야 합니다. 계약이 확인되지 않으면 불일치 상태로 보류합니다.
7 기존 결과를 보존하고 같은 입력을 재검산합니다
첫 명령을 같은 out/main.json으로 다시 실행하면 종료코드 2로 기존 결과를 보존합니다. 새 결과가 필요하면 이름을 바꿉니다.
python code/row_amount_checks.py --input fixtures/main.csv --report out/main_again.json
python -m unittest discover -s tests -p "test_*.py" -v
python code/verify_examples.py
단위시험 20개가 통과했고, 예제 재검산기는 CLI 19건의 기대 종료코드·고정 JSON·기존 출력 보존·실패 출력 부재를 확인했습니다. 제공한 CSV 12개의 실행 전후 SHA-256도 같았습니다. 최대 곱과 최대 10,000행의 합, 10,000자리 수량 거부, 허용오차의 양·음 경계, fsync·하드 링크 실패를 주입한 경우의 최종 보고서 부재도 시험에 포함했습니다. unittest의 discover 안내에서 위 명령 옵션을 확인할 수 있습니다.
코드는 입력과 같은 출력 경로, 기존 파일, 심볼릭 링크 입력·출력·부모 폴더, 하드 링크 입력, ..를 포함한 경로를 거부합니다. 새 보고서는 출력 폴더의 임시 파일에 모두 쓰고 동기화한 다음 os.link로 최종 이름을 만듭니다. 기존 이름을 덮어쓰는 방식은 없습니다. 임시 파일에는 NamedTemporaryFile을 사용합니다.
처리한 쓰기 오류에서는 최종 보고서가 생기지 않도록 했습니다. 완료 뒤 임시 파일 정리만 실패하면 완성 보고서를 보존하고 경고를 냅니다. .row-amount-로 시작하는 임시 파일은 완료 보고서로 읽지 마세요. 강제 종료·정전·악의적인 동시 경로 변경까지 완전히 보장하는 구조는 아니며, SHA-256도 입력을 잠그는 기능은 아닙니다. 다른 프로그램이 자료를 바꾸지 않는 별도 로컬 실습 폴더를 사용하세요.
첨부 ZIP에는 전체 코드, 같은 합성 CSV와 실패 반례, 독립 기대 JSON 5개·손계산표, README, 시험 코드와 SHA-256 목록만 들어 있습니다. 검수용 로그와 실제 출력은 독자 파일에 섞지 않았습니다. 고정 기대값을 입력과 함께 바꿔 결과를 맞추면 이 실습의 독립 대조가 사라집니다.
자주 묻는 질문
허용오차를 0.01로 주면 소수 둘째 자리로 반올림하나요?
아닙니다. 원래 예상금액과 기재금액의 차이를 반올림 없이 계산하고 절댓값이 0.01 이하인지 비교합니다.
통과 행만 소계를 내면 전체 금액도 알 수 있나요?
확인할 행이 남아 있으면 전체 금액은 아직 확정하지 않습니다. all_rows_pass=false와 불일치·입력오류 목록을 함께 보세요. 허용오차를 사용한 통과 소계도 기재금액 합이 아니라 재계산 예상금액 합입니다.
부가세나 할인이 있는 CSV에도 그대로 쓸 수 있나요?
이번 식은 그 항목을 포함하지 않습니다. 수량×단가와 기재금액의 관계를 승인된 규칙으로 먼저 정하고, 필요한 열과 새 기대값·반례를 추가한 별도 검사로 만들어야 합니다.
확인 범위와 이어서 볼 내용
기술 자료 확인일은 2026-10-06입니다. 공식 링크는 Python 3.12 계열이며 확인 당시 3.12.15 문서로 표시됐습니다. 실제 실행은 Linux CPython 3.12.14였고 Windows·macOS·Excel 앱, 실제 거래 데이터와 대용량 성능은 시험하지 않았습니다.
수량 열 자체의 허용 표기는 CSV 수량 열의 소수·음수·빈칸 분리에서, 반올림 단계의 차이는 Decimal CSV 반올림 기준에서 이어서 볼 수 있습니다. 이번 실습의 완료 기준은 세 숫자 열이 읽혔다는 것에 그치지 않고 같은 행의 계산 관계·허용오차·차이·보류 사유가 남는 것입니다.
작성자 소개
