CSV 수량 열에서 소수·음수·빈칸을 분리해 검토하기
수량 0은 입력된 값이고 빈칸은 입력이 빠진 상태입니다. 소수 2.5를 정수 2로 줄이거나 잘못된 값을 모두 0으로 바꾸면 원래 무엇을 확인해야 했는지 사라집니다. 수량을 합치기 전에 정상 행과 검토할 행을 나누고, 검토할 행의 ID·원문·이유를 함께 남기세요.
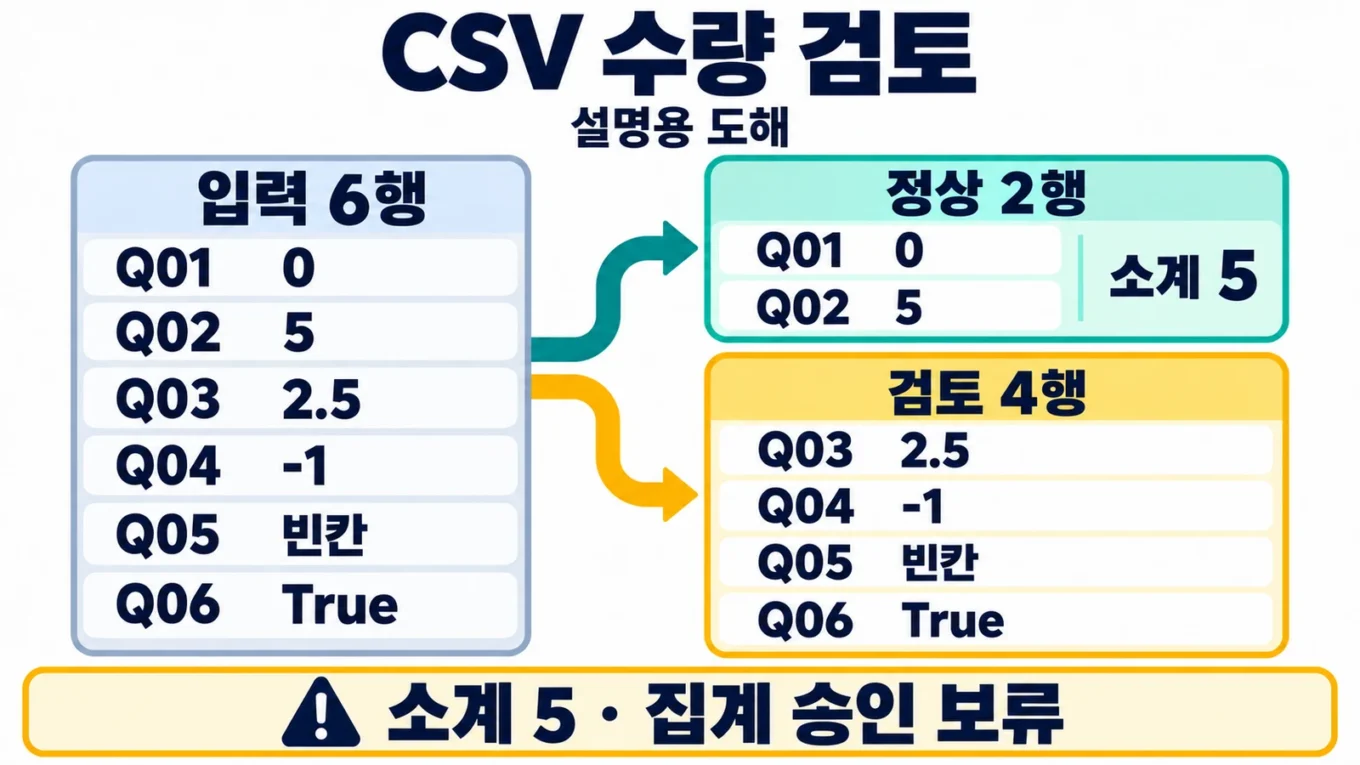
이 실습은 가상 CSV 여섯 행에서 0과 5만 정상 수량으로 받습니다. 정상은 2행, 정상 합계는 5이며 소수·음수·빈칸·True 문자열 네 행은 검토 목록에 남습니다. 원본 CSV는 수정하지 않고 새 JSON 보고서 하나를 만듭니다. 보고서의 합계 5는 정상 두 행의 소계이며, 여섯 행 전체의 확정 수량으로 사용하지 않습니다.
1 허용할 수량 표기를 먼저 정합니다
이번 실습은 낱개 수량을 다룹니다. 허용 범위는 0~999999, 표기는 ASCII 숫자로 쓴 0 또는 0이 아닌 숫자로 시작하는 정수입니다. 앞뒤 공백을 지우거나 다른 표기로 자동 변환하지 않습니다.
| 입력 원문 | 처리 | 이유 |
|---|---|---|
0, 5, 999999 | 정상 | 허용 표기와 범위에 맞음 |
2.5, 2.0 | 검토 | 소수점 표기 거부 |
-1, -0 | 검토 | 음수 부호가 있는 표기 거부 |
| 빈 문자열 | 검토 | 수량 입력 누락 |
True, False | 검토 | 정수 수량 표기가 아닌 문자열 |
+2 | 검토 | 명시적인 + 부호 거부 |
01, 00 | 검토 | 앞자리 0이 있는 표기 거부 |
1e2, 1E+2 | 검토 | 지수 표기 거부 |
NaN, Infinity, inf | 검토 | 비유한값 표기 거부 |
공백 한 칸, 5, 5 | 검토 | 공백 문자가 포함됨 |
1000000, 아주 큰 정수 문자열 | 검토 | 허용 범위 초과 |
5, 1_000, 1,000 | 검토 | 허용한 ASCII 정수 표기와 다름 |
2.0은 값으로 보면 정수 2와 같아도 이 실습에서는 소수점이 들어간 표기를 확인 대상으로 남깁니다. 소수점 표기를 허용하는 업무라면 원문을 유지한 채 허용 규칙부터 바꿔야 합니다. kg·m처럼 소수가 정상인 자료에 이 낱개 규칙을 적용하지 마세요.
CSV의 True는 Python의 논리값이 아니라 읽어들인 문자열입니다. Python csv 공식 문서에 설명된 기본 reader는 필드를 문자열 목록으로 돌려줍니다. 여기서는 QUOTE_NONNUMERIC처럼 자동으로 float로 바꾸는 옵션을 사용하지 않습니다.
int(float("2.5"))는 2가 됩니다. Python int 공식 문서의 설명처럼 float를 int로 바꾸면 소수 부분이 0 방향으로 잘립니다. 이 코드는 먼저 원문 표기와 자릿수를 검사하고, 허용한 최대 여섯 자리 문자열에만 int()를 적용합니다. 10000자리 숫자도 정수 변환을 시도하지 않고 범위 초과로 남깁니다.
2 원본 ID와 여섯 행을 확인합니다
실습 ZIP을 새 빈 폴더에 풀고 fixtures/quantities.csv를 텍스트 편집기로 엽니다. 머리글을 포함한 내용은 다음과 같습니다.
id,qty
Q01,0
Q02,5
Q03,2.5
Q04,-1
Q05,
Q06,True
Q05,는 두 번째 필드가 빈 행입니다. 줄 전체가 빈 행이나 Q05처럼 두 번째 열 자체가 없는 행과 구분합니다. "1,000"은 CSV에서 한 필드지만 허용한 수량 표기는 아닙니다. 따옴표 없이 Q01,1,000으로 적으면 세 열이 되어 구조 오류로 중단합니다.
입력 계약은 UTF-8 또는 UTF-8 BOM, 머리글 id,qty 순서, 정확히 두 열입니다. ID는 영문자로 시작하는 영문·숫자·밑줄·하이픈 조합으로 최대 32자이며 대소문자를 구분합니다. 같은 ID가 두 번 나오면 수량이 정상인지와 관계없이 전체 검토를 멈춥니다. 중복 두 행을 임의로 합치거나 하나만 남기지 않습니다.
데이터는 1~10000행, 파일은 1000000바이트 이하로 제한합니다. CSV 필드 하나는 최대 131072자이며 이 파서 한도를 넘으면 행별 검토 대신 전체 중단입니다. 큰 숫자의 원문도 이 한도 안에서만 보존합니다. 이 수치는 실습 범위를 정한 것이며 성능 보장이 아닙니다.
3 정상과 검토를 나누는 전체 코드
다음 코드는 ZIP의 code/qty_review.py와 동일합니다. Python 3.12 표준 라이브러리만 사용하며 패키지 설치나 API 키가 필요하지 않습니다.
"""Separate accepted and rejected synthetic CSV quantities without coercion."""
import argparse
import csv
import hashlib
import io
import json
import os
import re
import sys
import tempfile
from pathlib import Path

MAX_BYTES = 1_000_000
MAX_ROWS = 10_000
MAX_FIELD_CHARS = 131_072
MAX_QTY = 999_999
ID_PATTERN = re.compile(r"[A-Za-z][A-Za-z0-9_-]{0,31}\Z")
REASONS = {
    "empty_qty": "수량이 빈칸입니다",
    "whitespace_qty": "수량에 공백 문자가 있습니다",
    "non_finite_qty": "NaN·Infinity는 수량이 아닙니다",
    "negative_qty": "음수 표기는 허용하지 않습니다",
    "explicit_plus": "수량에 + 부호를 붙이지 않습니다",
    "exponent_qty": "지수 표기는 허용하지 않습니다",
    "decimal_qty": "소수점 표기는 허용하지 않습니다",
    "leading_zero_qty": "앞자리 0이 있는 정수 표기는 허용하지 않습니다",
    "out_of_range_qty": "수량 범위 0~999999를 벗어났습니다",
    "non_integer_qty": "ASCII 정수 표기가 아닙니다",
}


def quantity(raw):
    if raw == "":
        code = "empty_qty"
    elif any(character.isspace() for character in raw):
        code = "whitespace_qty"
    elif raw.casefold().lstrip("+-") in {"nan", "inf", "infinity"}:
        code = "non_finite_qty"
    elif re.fullmatch(r"-[0-9]+(?:\.[0-9]+)?(?:[eE][+-]?[0-9]+)?", raw):
        code = "negative_qty"
    elif re.fullmatch(r"\+[0-9]+(?:\.[0-9]+)?(?:[eE][+-]?[0-9]+)?", raw):
        code = "explicit_plus"
    elif re.fullmatch(r"[0-9]+(?:\.[0-9]+)?[eE][+-]?[0-9]+", raw):
        code = "exponent_qty"
    elif re.fullmatch(r"[0-9]+\.[0-9]+", raw):
        code = "decimal_qty"
    elif re.fullmatch(r"0[0-9]+", raw):
        code = "leading_zero_qty"
    elif re.fullmatch(r"(?:0|[1-9][0-9]*)", raw):
        if len(raw) <= 6:
            value = int(raw)
            if value <= MAX_QTY:
                return value, None
        code = "out_of_range_qty"
    else:
        code = "non_integer_qty"
    return None, code


def inspect(source):
    source = Path(source)
    if source.is_symlink() or not source.is_file():
        raise ValueError("입력은 심볼릭 링크가 아닌 일반 CSV 파일이어야 합니다")
    with source.open("rb") as handle:
        raw_bytes = handle.read(MAX_BYTES + 1)
    if len(raw_bytes) > MAX_BYTES:
        raise ValueError("입력 한도 1,000,000바이트를 초과했습니다")
    try:
        text = raw_bytes.decode("utf-8-sig", errors="strict")
    except UnicodeDecodeError as error:
        raise ValueError("UTF-8 해석 실패: 다른 인코딩을 자동 추측하지 않습니다") from error
    accepted, rejected, seen = [], [], set()
    old_limit = csv.field_size_limit(MAX_FIELD_CHARS)
    try:
        reader = csv.reader(io.StringIO(text, newline=""), strict=True)
        if next(reader, None) != ["id", "qty"]:
            raise ValueError("머리글은 id,qty 순서의 두 열이어야 합니다")
        for record_number, fields in enumerate(reader, 2):
            if record_number - 1 > MAX_ROWS:
                raise ValueError("입력 행 한도 10,000행을 초과했습니다")
            if len(fields) != 2:
                raise ValueError(f"레코드 {record_number}: 열 수는 2개여야 합니다")
            ident, raw = fields
            if not ID_PATTERN.fullmatch(ident):
                raise ValueError(f"레코드 {record_number}: ID 형식을 확인하세요")
            if ident in seen:
                raise ValueError(f"레코드 {record_number}: 중복 ID {ident}")
            seen.add(ident)
            row = {"source_record": record_number, "id": ident, "raw_qty": raw}
            value, reason_code = quantity(raw)
            if reason_code is None:
                accepted.append({**row, "qty": value})
            else:
                rejected.append({**row, "reason_code": reason_code,
                                 "reason": REASONS[reason_code]})
    except csv.Error as error:
        raise ValueError("CSV 구문 또는 필드 길이 오류: " + str(error)) from error
    finally:
        csv.field_size_limit(old_limit)
    if not seen:
        raise ValueError("데이터 행이 없어 검토 보고서를 만들지 않습니다")
    return {
        "quantity_rule": "ASCII canonical integer text; 0..999999; no trimming",
        "input_rows": len(seen), "accepted_count": len(accepted),
        "rejected_count": len(rejected),
        "accepted_qty_sum": sum(row["qty"] for row in accepted),
        "aggregate_ready": not rejected,
        "accepted": accepted, "rejected": rejected,
        "source_sha256": hashlib.sha256(raw_bytes).hexdigest(),
        "source_changes_written": 0,
    }


def write_report(source, target):
    source, target = Path(source), Path(target)
    if source.resolve() == target.resolve():
        raise ValueError("입력과 보고서는 서로 다른 경로여야 합니다")
    if target.suffix.lower() != ".json":
        raise ValueError("보고서는 새 .json 파일로 지정하세요")
    if target.exists() or target.is_symlink():
        raise ValueError("기존 보고서 보존: 새 --report 이름을 지정하세요")
    report = inspect(source)
    target.parent.mkdir(parents=True, exist_ok=True)
    temporary = None
    committed = False
    try:
        with tempfile.NamedTemporaryFile(
            mode="w", encoding="utf-8", newline="\n", delete=False,
            dir=target.parent, prefix=".qty-review-", suffix=".tmp",
        ) as handle:
            temporary = Path(handle.name)
            json.dump(report, handle, ensure_ascii=False, indent=2)
            handle.write("\n")
            handle.flush()
            os.fsync(handle.fileno())
        try:
            os.link(temporary, target)
            committed = True
        except FileExistsError as error:
            raise ValueError("기존 보고서 보존: 새 --report 이름을 지정하세요") from error
    finally:
        if temporary is not None:
            try:
                temporary.unlink(missing_ok=True)
            except OSError as error:
                if not committed:
                    raise
                print("경고: 완성 보고서는 저장됐지만 임시 파일 정리에 실패했습니다: "
                      + str(error), file=sys.stderr)
    return report


def main():
    parser = argparse.ArgumentParser(description="CSV 정수 수량의 원문별 승인·거부 검토")
    parser.add_argument("--input", required=True)
    parser.add_argument("--report", required=True)
    args = parser.parse_args()
    try:
        report = write_report(args.input, args.report)
    except (ValueError, OSError) as error:
        print("오류: " + str(error), file=sys.stderr)
        return 2
    status = "범위 내 통과" if report["aggregate_ready"] else "집계 승인 보류"
    print(f"입력 {report['input_rows']}행 / 정상 {report['accepted_count']}행 / "
          f"검토 {report['rejected_count']}행 / 정상 합계 {report['accepted_qty_sum']} / {status}")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
quantity()는 정상 값과 거부 이유를 돌려줍니다. 거부한 행에는 숫자 0을 채우지 않고 raw_qty 원문과 reason_code, 읽을 수 있는 reason을 저장합니다. 코드에서 None은 함수 내부의 거부 표시이며 보고서의 정상 수량으로 저장하지 않습니다.
이유가 겹치는 표기는 코드의 위쪽 검사부터 적용합니다. 예를 들어 -1은 공백, -2.5는 음수 표기, +2.0은 + 부호 이유가 먼저 남습니다. 보고서의 이유 하나가 그 문자열의 모든 문제를 열거한다는 뜻은 아닙니다.
source_record는 머리글을 1로 센 논리 레코드 번호입니다. 따옴표 안에 줄바꿈이 들어 있으면 물리 줄 번호와 달라질 수 있습니다. raw_qty는 CSV 파서가 해석한 필드 문자열로, CSV의 구분용 따옴표까지 복사한 파일 원문은 아닙니다. 원본 파일은 그대로 보관하고 source_sha256으로 읽은 바이트의 지문을 남깁니다.
CSV 구문은 strict=True로 읽고, 헤더·열 수·ID·행 수는 별도로 검사합니다. csv의 strict 공식 설명은 잘못된 CSV 입력에 예외를 발생시키는 옵션입니다. 이 옵션만으로 열 계약이나 모든 외부 CSV 규격을 검증하는 것은 아닙니다. 인코딩 오류도 문자를 대체해 숨기지 않고 중단합니다.
4 합계 5와 검토 네 행을 함께 읽습니다
터미널을 ZIP을 푼 폴더로 옮긴 뒤 다음 명령을 실행합니다. 정상 입력 검토가 끝나면 out 폴더가 필요에 따라 생깁니다.
python code/qty_review.py --input fixtures/quantities.csv --report out/quantities.json
화면에는 다음 문구가 나옵니다.
입력 6행 / 정상 2행 / 검토 4행 / 정상 합계 5 / 집계 승인 보류
out/quantities.json의 accepted에는 Q01의 0과 Q02의 5가 들어 있습니다. 0은 정상 수량이므로 제거하지 않습니다. rejected는 다음 네 행입니다.
| 레코드 | ID | raw_qty | reason_code |
|---|---|---|---|
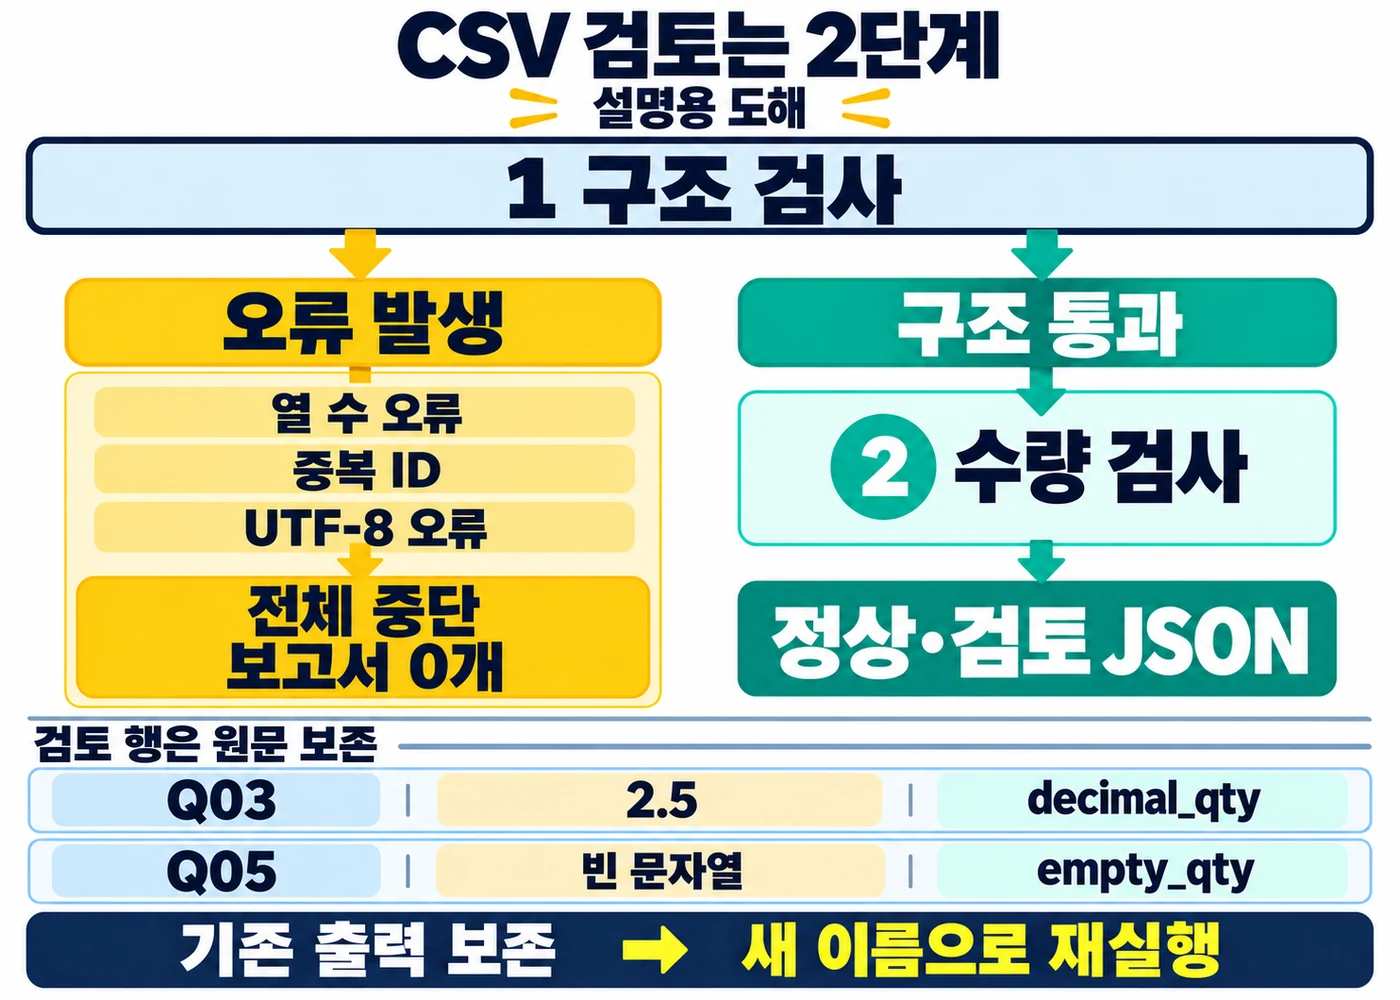
| 4 | Q03 | 2.5 | decimal_qty |
| 5 | Q04 | -1 | negative_qty |
| 6 | Q05 | 빈 문자열 | empty_qty |
| 7 | Q06 | True | non_integer_qty |
input_rows=6, accepted_count=2, rejected_count=4, accepted_qty_sum=5를 대조합니다. 정상 수와 검토 수의 합도 입력 여섯 행과 같아야 합니다. aggregate_ready=false는 검토할 수량이 남았다는 뜻입니다. 정상 합계 5만 다른 집계표에 넘기면 네 행의 누락을 숨길 수 있으므로 먼저 원인을 확인하세요.
보고서 생성에 성공하면 종료코드는 0입니다. 이는 검토 보고서가 만들어졌다는 의미이며 모든 행의 수량 승인을 뜻하지 않습니다. 모든 행이 거부된 파일도 검토 보고서는 만들 수 있습니다. 그때 정상 합계는 0, 정상 행은 0, aggregate_ready는 false입니다. 구조 오류로 파일 전체가 중단된 경우와 구분합니다.
5 소수점 표기와 큰 수 반례를 대조합니다
두 번째 가상 파일은 표기가 다른 열 행을 담고 있습니다.
python code/qty_review.py --input fixtures/notations.csv --report out/notations.json
N01~N08의 수량은 순서대로 2.0, +2, 01, 1e2, NaN, Infinity, 공백 한 칸, 아주 큰 정수입니다. N09는 999999, N10은 1000000입니다. 정상은 N09 한 행뿐이며 합계 999999, 검토는 9행입니다. expected/notations.json에서 각 ID의 원문과 이유를 함께 대조할 수 있습니다.
공백을 빈 문자열로 바꾸지 않았으므로 N07의 raw_qty는 한 칸으로 남습니다. 큰 숫자도 앞 여섯 자리를 잘라 쓰거나 float로 근사하지 않습니다. 입력을 고치려면 원본을 보존한 새 CSV 사본을 만들고 근거를 확인한 다음, 새 보고서 이름으로 다시 실행하세요.
6 파일 전체를 멈추는 오류를 구분합니다
아래 다섯 명령은 구조·식별·인코딩 반례입니다. 각각 종료코드 2로 끝나고 지정한 새 보고서가 생기지 않아야 합니다.
python code/qty_review.py --input fixtures/duplicate_id.csv --report out/rejected_id.json
python code/qty_review.py --input fixtures/bad_structure.csv --report out/rejected_structure.json
python code/qty_review.py --input fixtures/unclosed_quote.csv --report out/rejected_quote.json
python code/qty_review.py --input fixtures/invalid_utf8.csv --report out/rejected_utf8.json
python code/qty_review.py --input fixtures/header_only.csv --report out/rejected_empty.json
duplicate_id.csv는 Q01이 두 번 나와 원문을 ID로 식별할 기준이 겹칩니다bad_structure.csv는 한 데이터 행에 세 열이 있습니다unclosed_quote.csv는 따옴표가 닫히지 않았습니다invalid_utf8.csv는 UTF-8로 읽을 수 없는 바이트를 포함합니다header_only.csv는 머리글만 있고 데이터가 없습니다
앞에서 만든 보고서를 같은 경로로 다시 지정해도 기존 파일은 그대로 보존합니다. 다음 명령은 종료코드 2가 예상됩니다.
python code/qty_review.py --input fixtures/quantities.csv --report out/quantities.json
재실행하려면 --report out/quantities_again.json처럼 새 이름을 지정하세요. 입력과 출력 경로를 같게 주는 경우, 출력 확장자가 .json이 아닌 경우, 심볼릭 링크 입력도 거부합니다. 기존 출력이 심볼릭 링크여도 링크나 그 대상 파일을 수정하지 않습니다.
보고서는 출력 폴더의 임시 파일에 모두 쓴 뒤 os.link 공식 문서의 하드 링크로 새 결과 이름을 만듭니다. 같은 이름이 이미 있으면 이 단계가 실패하므로 기존 결과를 덮어쓰지 않습니다. NamedTemporaryFile 공식 문서의 delete=False를 사용한 임시 파일은 코드의 finally에서 정리합니다. 쓰기 도중 예외가 생기면 임시 파일을 정리하고 최종 보고서는 만들지 않습니다. 다만 저장 장치나 권한 문제로 정리까지 실패하면 임시 파일이 남을 수 있습니다. 최종 보고서 이름이 이미 만들어진 뒤 임시 파일 정리만 실패한 경우에는 완성 보고서를 보존하고 경고를 출력하며 종료코드 0으로 끝납니다. .qty-review-로 시작하는 잔여 임시 파일은 완료 보고서로 쓰지 마세요.
하드 링크를 지원하는 로컬 실습 폴더에서 사용하세요. 하드 링크를 지원하지 않는 저장 장치에서는 오류를 내고 멈춥니다. 새 로컬 실습 폴더를 사용하고, 처리 중 다른 프로그램이 원본이나 출력 경로를 바꾸지 않게 하세요. 네트워크·동기화 폴더는 피하세요. 강제 종료로 임시 파일이 남으면 완료 보고서로 읽지 말고 원본과 새 출력 경로를 먼저 확인하세요. 원본 지문도 이후 변경을 막는 잠금은 아닙니다.
7 같은 입력과 실패 조건을 다시 시험합니다
ZIP에는 본문과 같은 코드, 가상 CSV, 원문·이유가 담긴 기대 JSON, README, 시험 코드가 들어 있습니다. expected/quantities.json은 첫 예제의 고정 정답이고 expected/notations.json은 두 번째 예제의 정답입니다. 입력을 바꾼 뒤에도 이 기대값을 같이 고치면 원래 실습의 대조가 되지 않습니다.
python -m unittest discover -s code -p "test_qty_review.py" -v
python code/verify_examples.py
첫 명령은 별도 임시 폴더에서 정상·거부 표기, 구조 오류, 기존 파일·링크 보존, 쓰기 예외 뒤 임시 파일 제거를 검사합니다. 두 번째 명령은 가상 입력 사본으로 본문의 정상 두 건·실패 여섯 건을 실행해 기대 JSON, 입력 바이트 보존, 실패 보고서 부재를 확인합니다. unittest 공식 문서에서 시험 파일을 찾는 discover 명령을 확인할 수 있습니다.
실제 자료에 적용하기 전에는 수량 단위와 허용 범위, ID의 유일성을 먼저 확인하세요. 이 보고서가 통과시킨 것은 정해진 표기와 범위입니다. 수량이 실제 재고와 맞는지, 어느 시점의 자료인지, 발주해도 되는지는 별도 확인이 필요합니다.
작성자 소개
