CSV를 로컬 SQLite에 넣고 중복 ID와 수량 오류 거부하기
대표 사진은 AI로 만든 연출 이미지이며, 실제 SQLite 적재·제약 검사·롤백 결과를 보여 주지 않습니다.
검수된 CSV SQLite 제약 적재 실습 ZIP 다운로드
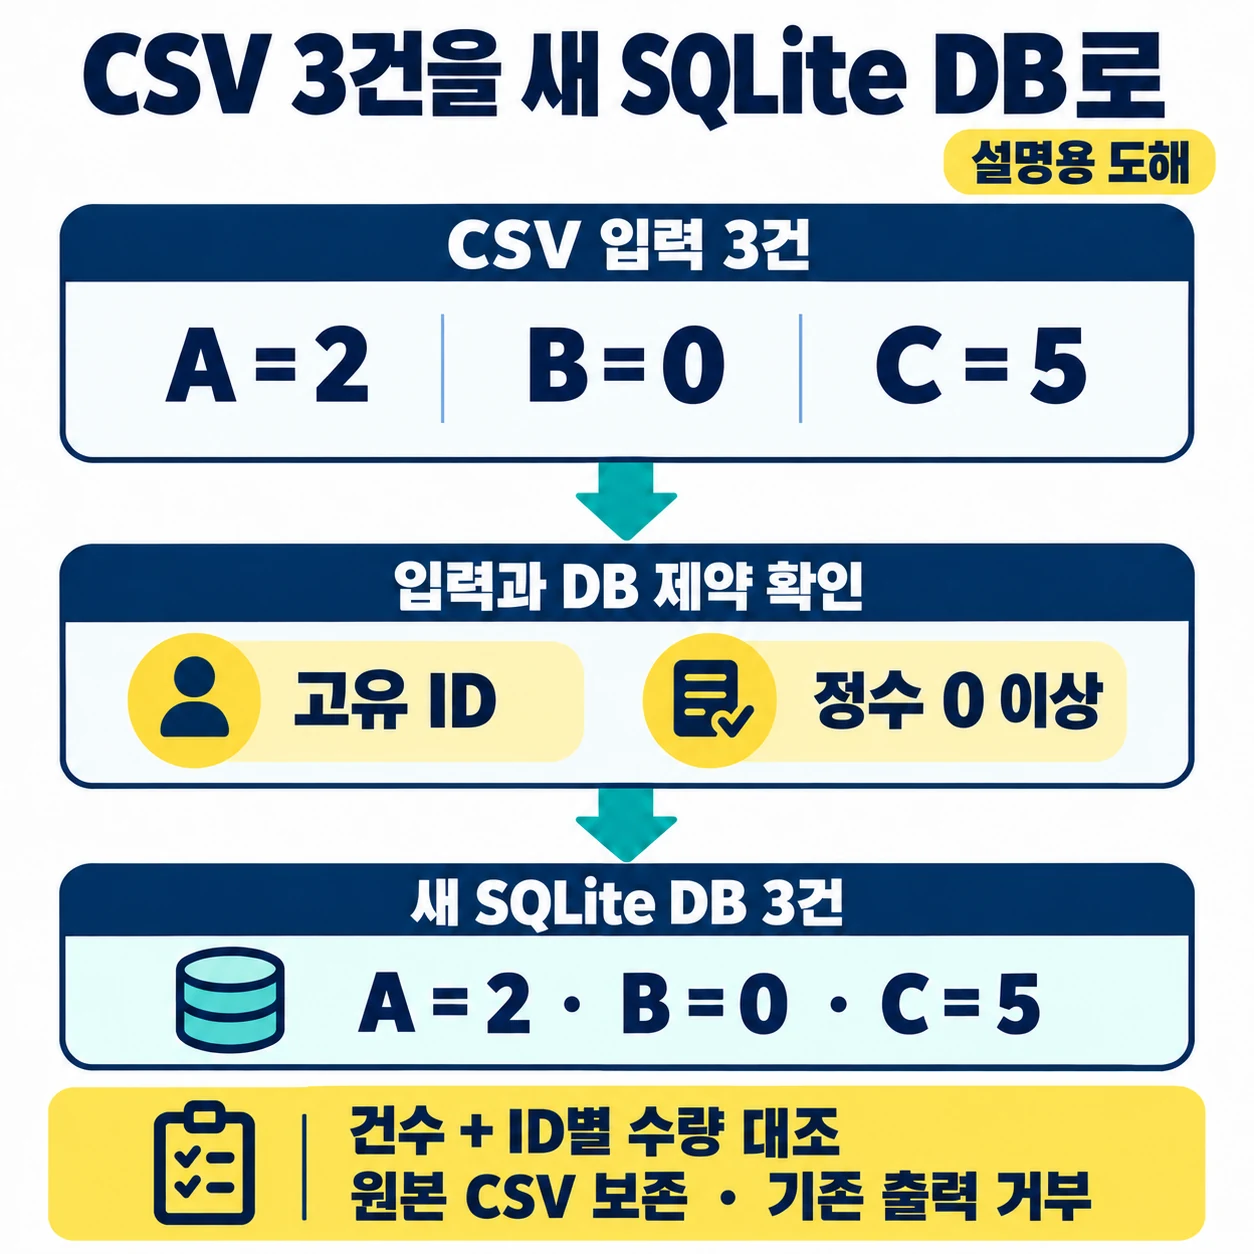
CSV의 세 행을 데이터베이스로 옮겼는데 ID가 겹치거나 수량이 1.5라면 어떻게 처리해야 할까요? 이번 실습은 A,2, B,0, C,5를 새 로컬 SQLite 파일에 넣고, 중복 ID 또는 잘못된 수량이 하나라도 있으면 전체 적재를 취소합니다. 성공 기준은 입력 3건과 DB 3건이 같고 ID별 수량도 그대로인 것입니다.
Python 표준 라이브러리만 사용합니다. 원본 CSV는 읽기만 하며, 이미 존재하는 출력 폴더나 DB에는 연결하지 않습니다. 정상 실행은 새 폴더 안에 inventory.sqlite3를 만들고, 같은 출력 이름으로 다시 실행하면 OUTPUT_EXISTS로 거부합니다. 기존 DB에 추가하는 방법, 다른 표와 결합하는 방법은 이번 범위에 포함하지 않습니다.
먼저 입력 계약을 정합니다
첨부 csv-to-sqlite-practice.zip의 fixtures/normal.csv는 다음과 같습니다. 모두 가상 자료입니다.
id,qty
A,2
B,0
C,5
이번에 허용하는 형태는 다음과 같습니다.
- 인코딩은 UTF-8이며 맨 앞의 UTF-8 BOM은 허용합니다
- 머리글은 순서까지 정확히
id,qty여야 합니다 - 데이터가 최소 한 레코드 있어야 하며 빈 레코드도 건너뛰지 않습니다
- ID는 영문자로 시작하고 영문자·숫자·밑줄·하이픈만 쓰는 1~32자입니다
- ID의 대소문자는 구별합니다.
A와a는 서로 다른 ID입니다 - qty는
0또는 0이 아닌 숫자로 시작하는 ASCII 십진 정수이며 최댓값은 9223372036854775807입니다 -1,1.5,+1,02,1e2, 빈 값, 앞뒤 공백, 전각 숫자2는 거부합니다- 연습용 한도는 파일 1,000,000바이트와 머리글 뒤 데이터 10,000레코드입니다
02를 수량 2로 고쳐 넣거나 빈 수량을 0으로 채우지 않습니다. 이런 변환이 필요한 업무라면 원본을 보존한 별도 사본과 변환 규칙부터 정해야 합니다. 이 실습의 정수 형식은 SQLite 전체의 입력 규칙이 아니라 CSV를 받아들이는 우리 코드의 계약입니다.
Python csv 문서는 기본 reader가 각 행의 값을 문자열 목록으로 돌려준다고 설명합니다. 따라서 CSV의 2를 읽었다고 바로 정수 검증이 끝나지는 않습니다. 코드는 UTF-8 바이트를 읽은 뒤 줄바꿈 처리를 맡긴 StringIO와 csv.reader(..., strict=True)로 파싱합니다. 따옴표 등 CSV 구문 오류와 업무상 값 오류도 따로 확인합니다.
INTEGER 선언만으로 형식 검사가 끝나지 않습니다
일반 SQLite 테이블은 동적 타입을 사용합니다. 컬럼의 타입 선언은 보통 저장할 값의 변환에 영향을 주는 타입 선호도이며, qty INTEGER만 적었다고 모든 문자열을 거부하는 것은 아닙니다. SQLite 자료형 문서는 타입이 값에 연결되는 동작과 타입 선호도를 구분합니다.
이번 테이블은 다음 제약을 사용합니다.
CREATE TABLE items (
    id TEXT PRIMARY KEY NOT NULL,
    qty INTEGER NOT NULL CHECK (qty >= 0)
) STRICT
PRIMARY KEY는 ID 중복을 막고, NOT NULL은 NULL을 막으며, CHECK는 음수를 막습니다. STRICT는 지정한 타입으로 손실 없이 변환할 수 없는 값을 거부합니다. 다만 숫자 문자열 '2'처럼 정수로 손실 없이 바뀌는 값은 STRICT INTEGER 컬럼에 들어갈 수 있습니다. STRICT가 CSV의 공백·선행 0·원래 표기까지 모두 검증해 주지는 않습니다.
그래서 CSV에서는 정규식과 범위로 검사하고 Python int로 바꾼 뒤 INSERT합니다. DB에는 타입·고유성·값 범위 제약을 다시 둡니다. SQLite STRICT 문서에 따르면 STRICT 테이블은 SQLite 3.37.0 이상에서 지원합니다. 코드는 더 오래된 런타임에서 STRICT를 빼고 진행하지 않고 중단합니다. Python 버전과 내장 SQLite 버전은 별개이므로 둘 다 확인해야 합니다.
하나의 트랜잭션에서 적재와 대조를 끝냅니다
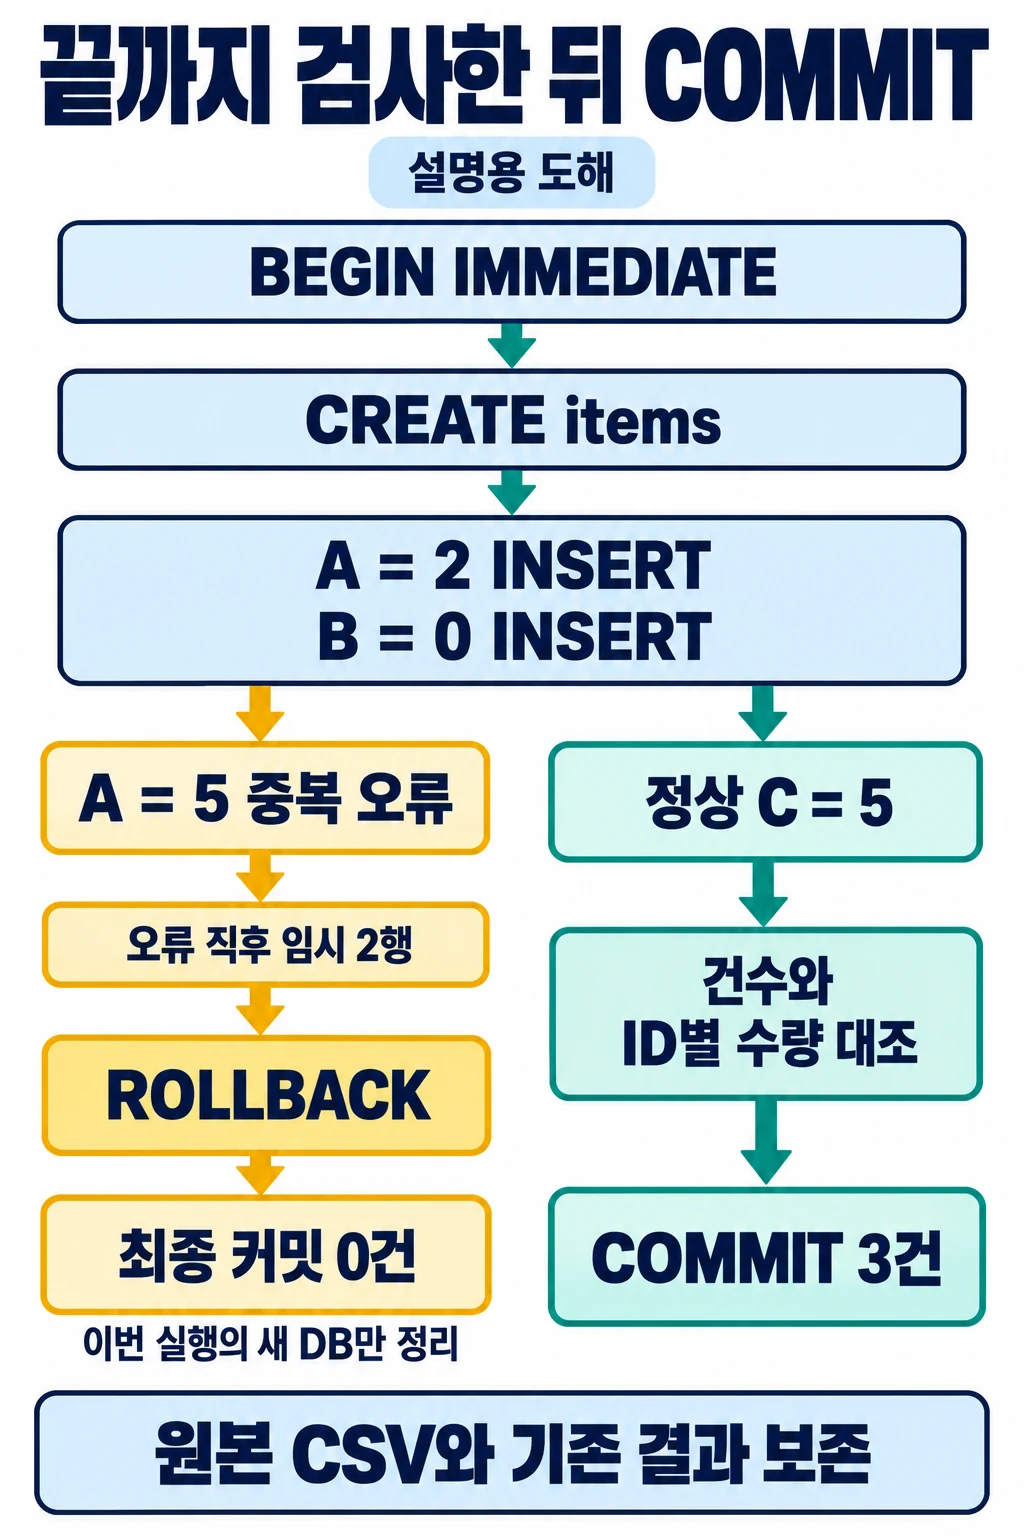
중복 fixture는 A,2, B,0, A,5입니다. 세 번째 데이터의 INSERT만 실패했다고 앞의 A·B를 그대로 커밋하면 두 행만 들어간 결과가 남습니다. SQLite의 일반적인 제약 오류는 실패한 문장을 중단하더라도 앞에서 성공한 문장까지 항상 되돌리는 것은 아닙니다.
코드는 BEGIN IMMEDIATE를 한 번 실행하고 테이블 생성·모든 INSERT·건수/내용 대조를 그 안에서 처리합니다. 어느 단계든 오류가 나면 ROLLBACK을 실행합니다. 모든 검사가 끝났을 때만 COMMIT합니다. SQLite 트랜잭션 문서는 명시적 BEGIN과 COMMIT·ROLLBACK, 오류 뒤 남는 트랜잭션 상태를 설명합니다.
이번 연결은 Python 3.12에서 추가된 autocommit=True를 명시합니다. 이 설정에서 연결 객체의 commit()·rollback()은 효과가 없으므로 코드에서는 SQL COMMIT·ROLLBACK을 직접 실행합니다. with connection:만 쓰면 이 연결 설정에서는 필요한 전체 취소를 얻지 못합니다. 연결도 close()로 따로 닫습니다. 근거는 Python sqlite3 트랜잭션 제어 문서입니다.
건수는 머리글 뒤에서 파싱한 레코드 수, 성공한 INSERT 수, SELECT COUNT(*)의 DB 행 수를 비교합니다. 여기에 ID와 qty 목록도 정렬해 대조합니다. 세 숫자가 3으로 같아도 ID별 값이 달라질 수 있으므로 건수만으로 완료 판정하지 않습니다.
새 출력 폴더를 지정해야 합니다
실행 명령의 두 번째 인수는 DB 파일 이름이 아니라 새로 만들 출력 폴더입니다. 기존 폴더 안에 같은 DB 이름으로 연결하면 기존 데이터를 수정할 위험이 있어서, 이번에는 폴더 자체가 이미 있으면 거부합니다. 비어 있는 폴더도 예외가 아닙니다.
코드는 기존 경로 여부를 확인하고, 실제 생성은 mkdir()의 기본 동작으로 수행합니다. 확인 후 다른 작업이 같은 경로를 먼저 만들어도 생성 단계에서 거부됩니다. 파일·기존 폴더·끊어진 심볼릭 링크와 충돌하는 경우도 검사했습니다. Python pathlib 문서의 Path.mkdir 동작을 따릅니다.
오류로 롤백한 뒤에는 이번 실행이 만든 DB 파일과 폴더만 정리하려고 합니다. 알 수 없는 파일을 폴더째 강제로 지우는 방식은 사용하지 않습니다. cleanup_notes에 정리 오류가 있으면 남은 연습 출력부터 확인하고, 기존 결과를 지우는 대신 다른 새 이름으로 다시 실행하세요. 실행 중 다른 프로그램이 원본이나 새 출력 폴더를 바꾸지 않는 개인 연습 환경을 전제로 합니다.
전체 코드를 저장합니다
첨부의 csv_to_sqlite.py와 다음 코드는 같습니다. 직접 입력할 때는 일부 함수만 복사하지 말고 전체를 같은 이름으로 저장합니다. 외부 패키지는 설치하지 않습니다.
import argparse
import csv
import hashlib
import io
import json
import os
import platform
import re
import sqlite3
import sys
from pathlib import Path

MAX_BYTES = 1_000_000
MAX_ROWS = 10_000
MAX_QTY = 9_223_372_036_854_775_807
ID_PATTERN = re.compile(r'[A-Za-z][A-Za-z0-9_-]{0,31}')
QTY_PATTERN = re.compile(r'0|[1-9][0-9]*')
SCHEMA = '''CREATE TABLE items (
    id TEXT PRIMARY KEY NOT NULL,
    qty INTEGER NOT NULL CHECK (qty >= 0)
) STRICT'''


class IngestError(Exception):
    def __init__(self, code, message):
        super().__init__(message)
        self.code = code
        self.report = {}


def digest(data):
    return hashlib.sha256(data).hexdigest()


def load_records(source):
    try:
        raw = source.read_bytes()
    except OSError as error:
        raise IngestError('INPUT_IO', str(error)) from error
    if len(raw) > MAX_BYTES:
        raise IngestError('INPUT_LIMIT', 'CSV exceeds 1,000,000 bytes')
    try:
        text = raw.decode('utf-8-sig')
    except UnicodeError as error:
        raise IngestError('BAD_ENCODING', 'Use UTF-8 CSV') from error
    try:
        rows = list(csv.reader(io.StringIO(text, newline=''), strict=True))
    except csv.Error as error:
        raise IngestError('BAD_CSV', str(error)) from error
    if not rows or rows[0] != ['id', 'qty']:
        raise IngestError('BAD_HEADER', 'Header must be exactly id,qty')
    records = rows[1:]
    if not records:
        raise IngestError('EMPTY_INPUT', 'At least one data record is required')
    if len(records) > MAX_ROWS:
        raise IngestError('INPUT_LIMIT', 'CSV exceeds 10,000 data records')
    return records, digest(raw)


def parse_record(fields, record_number):
    if len(fields) != 2:
        raise IngestError('BAD_ROW', f'Record {record_number}: exactly 2 fields required')
    item_id, text = fields
    if ID_PATTERN.fullmatch(item_id) is None:
        raise IngestError('BAD_ID', f'Record {record_number}: invalid ID')
    if (QTY_PATTERN.fullmatch(text) is None or len(text) > 19
            or int(text) > MAX_QTY):
        raise IngestError('BAD_QTY', f'Record {record_number}: qty must be 0..{MAX_QTY} in canonical decimal')
    return item_id, int(text)


def ingest(source_path, output_path):
    con = None
    owned = False
    committed = False
    inserted = 0
    input_count = 0
    target = None
    db = None
    try:
        if sys.version_info < (3, 12):
            raise IngestError('PYTHON_VERSION', 'Python 3.12 or later is required')
        if sqlite3.sqlite_version_info < (3, 37, 0):
            raise IngestError('SQLITE_VERSION', 'SQLite 3.37.0 or later is required for STRICT')
        output_path = Path(output_path)
        if output_path.name in ('', '.', '..'):
            raise IngestError('OUTPUT_IO', 'Specify a new output directory name')
        try:
            target = output_path.parent.resolve(strict=True) / output_path.name
        except OSError as error:
            raise IngestError('OUTPUT_IO', str(error)) from error
        if os.path.lexists(target):
            raise IngestError('OUTPUT_EXISTS', 'Output path already exists; choose a new directory name')
        records, source_hash = load_records(Path(source_path))
        input_count = len(records)
        # mkdir is exclusive: a file, directory or dangling symlink causes refusal.
        try:
            target.mkdir()
        except FileExistsError as error:
            raise IngestError('OUTPUT_EXISTS', 'Output appeared; choose a new directory name') from error
        except OSError as error:
            raise IngestError('OUTPUT_IO', str(error)) from error
        owned = True
        db = target / 'inventory.sqlite3'
        con = sqlite3.connect(db, autocommit=True)
        # With autocommit=True, use SQL BEGIN/COMMIT/ROLLBACK explicitly.
        con.execute('BEGIN IMMEDIATE')
        con.execute(SCHEMA)
        expected = []
        for number, fields in enumerate(records, start=2):
            row = parse_record(fields, number)
            try:
                con.execute('INSERT INTO items(id, qty) VALUES(?, ?)', row)
            except sqlite3.IntegrityError as error:
                raise IngestError('DUPLICATE_ID', f'Record {number}: duplicate ID {row[0]}') from error
            inserted += 1
            expected.append(row)
        db_count = con.execute('SELECT COUNT(*) FROM items').fetchone()[0]
        actual = con.execute('SELECT id, qty FROM items ORDER BY id').fetchall()
        if not (input_count == inserted == db_count and actual == sorted(expected)):
            raise IngestError('RECONCILIATION', 'Input and database rows differ')
        if digest(Path(source_path).read_bytes()) != source_hash:
            raise IngestError('SOURCE_CHANGED', 'Source changed during the run; retry from a stable copy')
        con.execute('COMMIT')
        committed = True
        con.close()
        con = None
        return {'status': 'PASS', 'input_records': input_count,
                'committed_rows': db_count, 'count_match': True,
                'rows': actual, 'source_sha256': source_hash,
                'source_preserved': True, 'database': str(db),
                'python': platform.python_version(),
                'sqlite': sqlite3.sqlite_version}
    except Exception as error:
        notes = []
        if con is not None:
            try:
                if con.in_transaction:
                    con.execute('ROLLBACK')
            except sqlite3.Error as rollback_error:
                notes.append(f'Rollback error: {rollback_error}')
            try:
                con.close()
            except sqlite3.Error as close_error:
                notes.append(f'Close error: {close_error}')
        # Only remove the database and directory created by THIS failed run.
        # Unknown files are never recursively deleted.
        if owned and not committed:
            try:
                if db is not None:
                    db.unlink(missing_ok=True)
                target.rmdir()
            except OSError as cleanup_error:
                notes.append(f'Cleanup error: {cleanup_error}')
        if not isinstance(error, IngestError):
            error = IngestError('RUNTIME_ERROR', str(error))
        error.report = {'status': 'REJECTED', 'error_code': error.code,
                        'message': str(error), 'input_records': input_count,
                        'rows_inserted_in_transaction': inserted,
                        'committed_rows': inserted if committed else 0,
                        'cleanup_notes': notes}
        raise error


def main():
    parser = argparse.ArgumentParser(description='Import a small UTF-8 CSV into a NEW SQLite output directory')
    parser.add_argument('csv_file')
    parser.add_argument('new_output_directory')
    args = parser.parse_args()
    try:
        report = ingest(args.csv_file, args.new_output_directory)
    except IngestError as error:
        print(json.dumps(error.report, ensure_ascii=False))
        return 1
    print(json.dumps(report, ensure_ascii=False))
    return 0


if __name__ == '__main__':
    sys.exit(main())
INSERT의 ?는 값 바인딩용 자리표시자입니다. ID나 수량을 SQL 문자열에 이어 붙이지 않습니다. 테이블 이름과 SQL 구조는 코드에 고정하고 입력 값만 전달합니다. 관련 사용법은 Python sqlite3 자리표시자 문서에서 확인할 수 있습니다.
압축을 풀고 정상 입력부터 실행합니다
- 새 연습 폴더에 ZIP을 압축 해제합니다.
csv_to_sqlite.py,test_ingest.py,fixtures가 같은 위치에 있어야 합니다 - 터미널에서 그 폴더로 이동합니다. 운영 자료 폴더나 기존 DB 폴더를 실행 대상으로 고르지 않습니다
- 다음 명령으로 실제 Python과 내장 SQLite 버전을 확인합니다
python3 -c "import platform,sqlite3; print(platform.python_version()); print(sqlite3.sqlite_version)"코드는 Python 3.12 이상과 SQLite 3.37.0 이상을 요구합니다. 실제 검증한 조합은 Linux의 CPython 3.12.14와 SQLite 3.53.1입니다. 다른 버전 전체나 Windows·macOS의 실행 호환성은 검증하지 않았습니다. python3 명령이 없으면 설치한 Python의 실행 명령을 먼저 확인하세요.
- 아래 명령을 실행합니다.
out-normal폴더를 미리 만들면 충돌로 거부되므로 만들지 않습니다
python3 csv_to_sqlite.py fixtures/normal.csv out-normal정상 입력에서 확인한 결과의 핵심 필드는 다음과 같습니다. 실제 출력은 한 줄의 JSON이며 DB의 절대 경로·원본 SHA-256·실행 버전도 함께 표시합니다.
status: PASS
input_records: 3
committed_rows: 3
count_match: true
rows: [["A", 2], ["B", 0], ["C", 5]]
source_preserved: true
새 파일: out-normal/inventory.sqlite3
종료 코드: 0
수량 0인 B도 저장됩니다. 0은 잘못된 값이나 빈 값이 아닙니다. 저장 후 별도의 읽기 전용 연결로 행 목록과 typeof(qty)='integer'도 확인했습니다. 원본은 실행 전후 SHA-256이 같았습니다.
- 같은 명령을 한 번 더 실행합니다. 새 결과를 덮어쓰지 않고
OUTPUT_EXISTS, 종료 코드 1로 끝나야 합니다. 이전inventory.sqlite3의 SHA-256도 그대로인지 첨부 테스트가 대조합니다
중복과 수량 오류를 재현합니다
각 실패 시험에도 서로 다른 새 출력 이름을 씁니다.
python3 csv_to_sqlite.py fixtures/duplicate.csv out-duplicate
python3 csv_to_sqlite.py fixtures/bad_qty.csv out-bad-qty
python3 csv_to_sqlite.py fixtures/empty.csv out-empty
python3 csv_to_sqlite.py fixtures/bad_schema.csv out-bad-schemaduplicate.csv는 세 데이터 중 마지막 ID가 A로 겹칩니다. 실제 결과는 DUPLICATE_ID, rows_inserted_in_transaction=2, committed_rows=0, 종료 코드 1이었습니다. 앞에서 INSERT한 2는 성공한 최종 적재 건수가 아니라 취소 전 시도 내에서 넣은 행 수입니다. 전체 롤백 후 새 DB와 출력 폴더가 남지 않았습니다.
bad_qty.csv는 B의 수량이 1.5입니다. A 한 행을 넣은 뒤 BAD_QTY로 거부하고 최종 커밋은 0건입니다. empty.csv는 머리글만 있어서 EMPTY_INPUT, bad_schema.csv는 qty 대신 quantity 머리글을 써서 BAD_HEADER로 거부됩니다. 머리글·비어 있음 검사에서 실패하면 출력 폴더를 만들기 전 중단합니다.
input_records는 올바른 머리글을 확인하고 얻은 데이터 레코드 수입니다. 머리글 파싱 단계에서 실패한 보고서의 0을 “원본에 물리적인 줄이 없었다”는 뜻으로 읽지 않습니다. 오류 메시지의 Record 번호는 머리글을 1로 센 CSV 레코드 번호이며, 따옴표 안 줄바꿈이 있는 파일에서는 텍스트 편집기의 줄 번호와 다를 수 있습니다.
복구할 때는 다음 순서로 봅니다.
DUPLICATE_ID: 어느 ID를 유지할지 원본 기준으로 결정한 뒤 별도 수정 사본을 만듭니다. 중복을 자동 삭제하거나 마지막 행으로 덮지 않습니다BAD_QTY: 소수·음수·빈 값·공백 등 실제 원인을 고칩니다. 확인되지 않은 수량을 0으로 채워 통과시키지 않습니다BAD_HEADER·BAD_ROW: 머리글 이름과 순서, 필드 개수, 빈 레코드를 확인합니다BAD_ENCODING·BAD_CSV: UTF-8 내보내기와 CSV 따옴표 구문을 확인합니다OUTPUT_EXISTS: 이전 결과를 그대로 두고out-normal-2처럼 아직 없는 이름으로 실행합니다PYTHON_VERSION·SQLITE_VERSION: 실행 버전을 확인합니다. STRICT를 빼거나 제약을 완화해 통과시키지 않습니다
원본 파일에서 바로 수정하지 말고 사본에서 고쳐 새 출력 이름으로 재실행합니다. 성공 후에도 입력 건수·DB 건수·ID별 수량을 다시 대조합니다.
첨부 검증을 실행합니다
python3 test_ingest.py실제 검사 37개가 모두 통과했습니다. 정상 적재와 재실행 거부, 중복·소수·음수·빈 수량·선행 0·공백·지수 표기·전각 숫자·64비트 범위 초과, 최대 정수, 빈 파일·머리글만 있는 파일·잘못된 스키마·필드 개수·빈 ID, UTF-8 오류·CSV 구문 오류, BOM과 CRLF, 기존 출력 파일·기존 DB·끊어진 심볼릭 링크, 누락된 입력·출력 부모 폴더를 검사했습니다. 10,000/10,001레코드 경계·파일 크기 한도·ID 32/33자 경계·SQLite 구버전 차단 분기는 실제 런타임 3.53.1에서 버전 검사 값만 3.36.0으로 바꾸어 시험했습니다.
원본이 COMMIT 전에 외부에서 변경되는 상황, 경로 확인과 생성 사이에 다른 작업이 출력 폴더를 만드는 상황, 정리 중 알 수 없는 파일이 있어 폴더를 지울 수 없는 상황도 별도 시험했습니다. 원본 변경은 롤백했고 먼저 생긴 출력과 알 수 없는 파일은 보존했습니다.
독립 메모리 DB 시험에서는 A·B 두 행을 넣은 뒤 중복 A의 문장이 실패한 직후에는 두 행이 남아 있음을 확인하고, 명시적인 ROLLBACK 뒤에는 테이블 생성까지 되돌아감을 확인했습니다. STRICT INTEGER에 '2'를 직접 넣으면 integer로 저장되지만 'abc', 1.5, -1, NULL은 각 제약에 걸리는 것도 시험했습니다. 이렇게 CSV 표기 검사와 DB 제약의 역할을 구분했습니다.
첨부에는 expected/cases.json, 정상 행 목록, logs/actual_runs.json, logs/unittest_actual.txt, logs/runtime.json, 파일별 SHA-256 목록이 있습니다. 실제 실행 로그에는 시험에 복사한 모든 fixture의 실행 전후 해시가 같다는 결과가 들어 있습니다. 테스트가 쓰는 DB와 fixture 사본은 격리된 임시 폴더에 만들고 테스트가 끝나면 정리합니다.
일반 실행에서 원본 해시는 적재 전 읽은 바이트와 COMMIT 직전 다시 읽은 바이트를 비교합니다. 다른 프로그램의 이후 변경이나 강제 종료·전원 장애, 악의적인 파일 경로 교체까지 막는 장치는 아닙니다. 강제 종료로 출력이 남았다면 자동 재사용하지 말고 남은 상태를 확인한 뒤 새 출력 이름으로 다시 연습합니다. COMMIT 뒤 연결 닫기에서 예외가 발생하면 DB는 이미 커밋되었을 수 있으므로 오류 상태와 함께 committed_rows를 확인합니다. 파일 크기 한도는 읽은 뒤 검사하는 수용 기준이며 큰 파일의 메모리 사용을 제한하는 장치는 아닙니다. 이 코드는 작은 로컬 연습 자료를 메모리에 읽으며 대용량 속도·네트워크 공유 폴더·동시 작업은 측정하지 않았습니다.
함께 볼 자료
- Python sqlite3 문서: 값 바인딩, 런타임 버전, 연결과 트랜잭션 제어
- Python csv 문서: 문자열 입력과 CSV 파싱
- SQLite 자료형 문서: 동적 타입과 타입 선호도
- SQLite STRICT 테이블 문서: 지원 버전과 손실 없는 타입 변환
- SQLite 트랜잭션 문서: BEGIN·COMMIT·ROLLBACK과 오류 상태
기존 파일의 집계를 읽고 대조하는 연습은 Excel VBA ADO 조회와 원본 건수 검산에서 이어 볼 수 있습니다. SELECT 결과의 누락·중복·NULL을 확인하려면 SQL의 행 수와 NULL 처리 확인을 참고하세요. 이번 실습의 완료 기준은 새 로컬 테이블의 제약을 통과한 입력만 전체 단위로 적재하고, 원본과 기존 결과를 보존하는 것입니다.
작성자 소개
