AI가 만든 SQL에서 행 수와 NULL 처리 확인하기
AI가 만든 SQL이 오류 없이 실행됐어도 결과가 맞는지는 따로 확인하세요. 행 수가 같아도 한 주문이 빠지고 다른 주문이 두 번 들어갔을 수 있습니다. 이 글은 SQL과 Python 기초를 아는 독자를 위한 실습입니다. 가상 주문표에서 주문이 빠지지 않았는지, 값이 없거나 아직 모르는 상태인 NULL을 어떻게 처리했는지, 고객표와 연결하며 주문이 중복되지는 않았는지 비교합니다.
질의 후보와 기대 결과는 직접 작성했습니다. 실제 AI 응답, 실제 고객 데이터, 운영 데이터베이스에 대한 실행 기록이 아닙니다. Python의 메모리 SQLite에서 VALUES로 만든 가상 표에 SELECT만 실행합니다. 생성·삽입·수정·삭제 SQL이나 외부 연결은 사용하지 않습니다.
먼저 포함할 주문과 모르는 값의 의미를 정하기
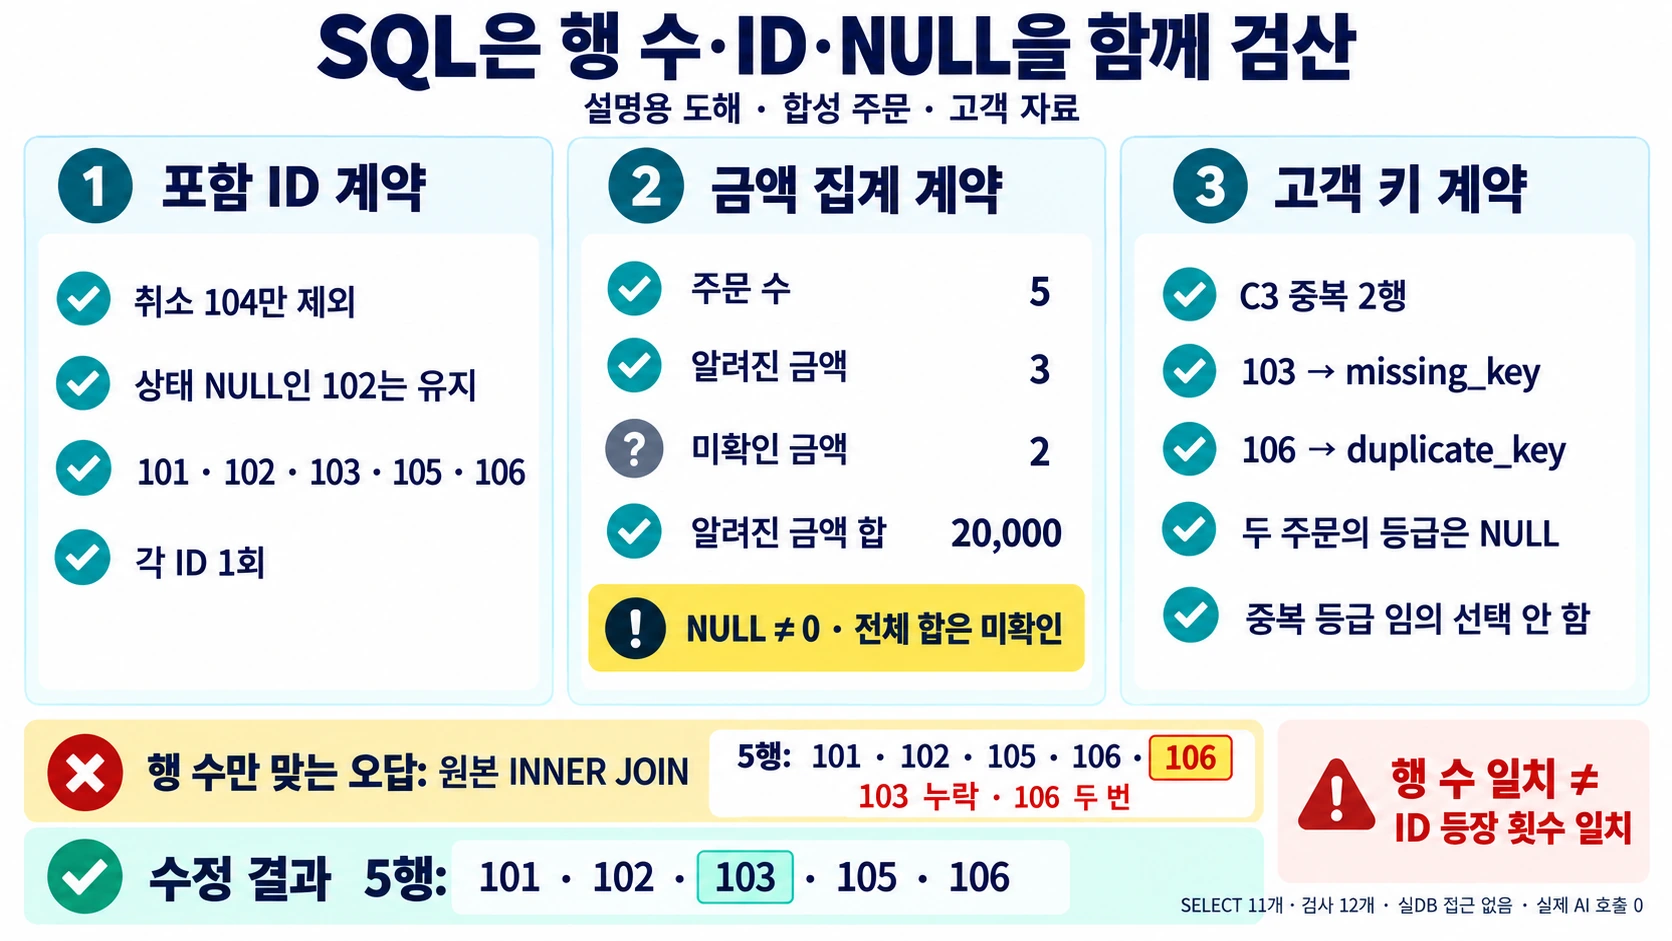
이번 정책은 취소 주문만 제외하고 상태가 아직 없는 주문은 검토 대상으로 유지하는 것입니다. 금액 NULL은 미확인, 숫자 0은 확인된 금액 0입니다. 고객 연결 정보가 없거나 중복이면 주문을 없애지 않고 문제 상태를 표시합니다.
| 주문 ID | 고객 키 | 상태 | 금액 |
|---|---|---|---|
| 101 | C1 | paid | 12,000 |
| 102 | C2 | NULL | NULL |
| 103 | NULL | paid | 8,000 |
| 104 | C9 | cancelled | 5,000 |
| 105 | C1 | paid | 0 |
| 106 | C3 | paid | NULL |
고객 표는 C1/gold, C2/silver, C3/gold, C3/legacy의 네 행입니다. C3 두 행은 의도적으로 만든 중복 키이며 어떤 등급이 최신인지 알려 주는 날짜는 없습니다. gold나 legacy 중 하나를 마음대로 고르면 정보가 확인된 것처럼 보이므로 이번 계약에서는 중복 상태를 남기고 등급은 NULL로 보류합니다.
사람이 먼저 정한 포함 ID는 101·102·103·105·106 다섯 개입니다. 이 목록과 각 ID의 등장 횟수가 기준입니다. 금액을 확인한 행은 101·103·105 세 개, 미확인 행은 102·106 두 개입니다. 알려진 금액의 합은 12,000+8,000+0=20,000이고, 미확인 금액까지 포함한 전체 금액은 아직 모릅니다.
상태 NULL도 제외하는 업무라면 다른 계약이 됩니다. 아래 조건을 SQL의 일반 정답으로 외우지 말고 업무상 포함·제외 규칙부터 정합니다.
첫 질의에서 NULL 상태 주문의 누락 찾기
다음 후보는 취소와 다르면 포함한다고 읽히지만 102를 빠뜨립니다.
SELECT order_id
FROM orders
WHERE status <> 'cancelled'
ORDER BY order_id;
실제 가상 결과는 101·103·105·106 네 행입니다. NULL과 cancelled의 비교는 참이 되지 않으므로 WHERE를 통과하지 않습니다. SQLite SELECT 문서는 WHERE가 참인 행만 포함하고 거짓이나 NULL인 행은 제외한다고 설명합니다.
상태 미확인 주문도 남기기로 정했으므로 이번 수정 조건은 다음과 같습니다.
SELECT order_id
FROM orders
WHERE status <> 'cancelled' OR status IS NULL
ORDER BY order_id;
수정 결과는 기대 ID 다섯 개와 일치했습니다. NULL을 확인할 때는 = NULL을 쓰지 않습니다. 이 표에서 amount = NULL은 빈 목록, amount IS NULL은 102·106을 반환했습니다. SQLite 식 문서는 NULL을 포함한 일반 비교와 IS 계열의 차이를 설명합니다.
OR를 붙일 때 다른 조건도 있으면 괄호로 의도한 묶음을 표시하세요. 예를 들어 기간 조건 AND 뒤에 위 OR를 괄호 없이 이어 쓰면 원하는 포함 범위가 달라질 수 있습니다. 이번 코드는 필터 계약을 KEEP 문자열 한 곳에 두고 집계·결합에서 같은 조건을 사용합니다.
둘째 질의에서 주문 수와 알려진 금액 수 나누기
다음 후보에서 COUNT(amount)를 주문 수로 읽으면 다섯 주문을 세 주문으로 잘못 기록하게 됩니다.
SELECT COUNT(amount), SUM(amount)
FROM orders
WHERE status <> 'cancelled' OR status IS NULL;
결과는 3과 20,000입니다. COUNT(amount)는 NULL이 아닌 금액의 개수입니다. 105의 숫자 0은 포함하고 102·106의 NULL은 세지 않습니다. SQLite 집계 함수 문서는 COUNT(*)와 COUNT(값)를 구분하고 SUM이 NULL이 아닌 입력을 더한다고 설명합니다.
이번 집계는 네 숫자를 함께 반환하도록 고칩니다.
SELECT COUNT(*) AS order_count,
       COUNT(amount) AS known_amount_count,
       COUNT(*) - COUNT(amount) AS unknown_amount_count,
       SUM(amount) AS known_amount_sum
FROM orders
WHERE status <> 'cancelled' OR status IS NULL;
실제 결과는 주문 5 / 알려진 금액 3 / 미확인 금액 2 / 알려진 금액 합 20,000입니다. 20,000을 미확인 주문까지 포함한 최종 매출로 표시하지 않습니다. 필드 이름에 known을 남겨 합계의 범위를 드러냅니다.
NULL인 두 주문 102·106만 골라 SUM(amount)를 실행하면 결과는 NULL입니다. 같은 결과를 COALESCE로 0으로 바꾸는 질의도 실행해 (NULL, 0, 0)을 확인했습니다. 마지막 0은 COUNT(amount)입니다. “확인된 금액이 한 개도 없음”과 “확인된 합계가 0”을 같은 값으로 보이게 만들 수 있으므로, 보기 좋다는 이유만으로 모든 집계를 0으로 채우지 않습니다.
셋째 질의에서 중복 고객 키가 주문을 늘리는지 보기
LEFT JOIN을 사용해도 오른쪽 표의 키가 중복이면 주문이 늘어납니다. 합성 고객 표의 C3가 두 번 있으므로 주문 106에 gold와 legacy가 각각 붙습니다. 그대로 결합한 실제 출력은 여섯 행입니다.
| 질의 | 실제 행 수 | ID 대조에서 드러난 문제 |
|---|---|---|
| 원본 고객표 LEFT JOIN | 6 | 106 두 번 |
| 원본 고객표 INNER JOIN | 5 | 103 누락, 106 두 번 |
| 중복을 표시한 고객 요약표 LEFT JOIN | 5 | 포함 ID 다섯 개가 한 번씩 유지 |
INNER JOIN의 다섯 행은 기대 행 수와 같습니다. 하지만 ID 목록은 101·102·105·106·106으로, 빠진 103과 중복된 106이 서로 상쇄됩니다. 행 수 하나만 비교하는 검사로 놓치는 반례입니다. 본문 코드는 Counter로 ID의 등장 횟수를 비교해 이 차이를 실제로 확인했습니다.
우선 다음 진단 SELECT로 중복 키를 드러냅니다. 실제 결과는 C3, 2입니다.
SELECT customer_id, COUNT(*)
FROM customers
GROUP BY customer_id
HAVING COUNT(*) > 1;
원본 고객표를 수정하거나 DISTINCT로 전체 결과를 덮지 않습니다. 두 등급이 달라서 DISTINCT만으로 해결되지도 않습니다. 실제로 등급을 확정해야 한다면 권한 있는 원본에서 최신·유효 기준을 확인합니다.
이번 가상 보고서는 문제를 남기는 것을 목표로 하므로 고객 키별 개수를 만든 뒤, 정확히 한 행인 키에서만 등급을 가져옵니다. 코드의 MASTER 부분이 그 SELECT입니다. MIN(tier)는 한 행인 경우에만 사용하고 중복 키의 값 선택에는 사용하지 않습니다.
| 주문 ID | 결과 등급 | 연결 판정 |
|---|---|---|
| 101 | gold | matched |
| 102 | silver | matched |
| 103 | NULL | missing_key |
| 105 | gold | matched |
| 106 | NULL | duplicate_key |
고객 키가 없다는 missing_key와 키가 있지만 매칭되지 않는 unmatched_key도 구분하는 분기를 넣었습니다. 다만 이번 포함 주문의 fixture에는 unmatched_key 사례가 없으므로 그 분기를 별도 통과 시험했다고 주장하지 않습니다. 취소 주문 104의 C9는 포함 대상에서 이미 빠집니다. 추가 정책을 확장할 때 그 분기의 합성 사례도 넣어야 합니다.
실DB 없이 실행하는 전체 코드
다음 코드 전체를 sql_contract_checks.py로 저장합니다. Python 3의 sqlite3 표준 모듈을 사용하며 외부 패키지는 설치하지 않습니다. 파일로 된 DB를 열지 않고 :memory: 연결에 고정된 VALUES와 SELECT만 실행합니다. 실제 AI SQL 문자열을 임의로 실행하는 도구가 아닙니다.
import json
import sqlite3
from collections import Counter

# Synthetic VALUES only: no database files, CREATE, INSERT, UPDATE or DELETE.
FIXTURE = """WITH
orders(order_id, customer_id, status, amount) AS (VALUES
  (101, 'C1', 'paid', 12000),
  (102, 'C2', NULL, NULL),
  (103, NULL, 'paid', 8000),
  (104, 'C9', 'cancelled', 5000),
  (105, 'C1', 'paid', 0),
  (106, 'C3', 'paid', NULL)
),
customers(customer_id, tier) AS (VALUES
  ('C1', 'gold'), ('C2', 'silver'),
  ('C3', 'gold'), ('C3', 'legacy')
)
"""
KEEP = "(o.status <> 'cancelled' OR o.status IS NULL)"
MASTER = """, master AS (
  SELECT customer_id, COUNT(*) AS key_count,
         CASE WHEN COUNT(*) = 1 THEN MIN(tier) ELSE NULL END AS tier
  FROM customers GROUP BY customer_id
)
"""
QUERIES = {
    "filter_naive": "SELECT order_id FROM orders WHERE status <> 'cancelled' ORDER BY order_id",
    "filter_fixed": "SELECT order_id FROM orders WHERE status <> 'cancelled' OR status IS NULL ORDER BY order_id",
    "counts_naive": "SELECT COUNT(amount), SUM(amount) FROM orders o WHERE " + KEEP,
    "counts_fixed": "SELECT COUNT(*), COUNT(amount), COUNT(*)-COUNT(amount), SUM(amount) FROM orders o WHERE " + KEEP,
    "duplicate_keys": "SELECT customer_id, COUNT(*) FROM customers GROUP BY customer_id HAVING COUNT(*) > 1 ORDER BY customer_id",
    "join_left_naive": "SELECT o.order_id, c.tier FROM orders o LEFT JOIN customers c ON o.customer_id=c.customer_id WHERE " + KEEP + " ORDER BY o.order_id, c.tier",
    "join_inner_naive": "SELECT o.order_id, c.tier FROM orders o JOIN customers c ON o.customer_id=c.customer_id WHERE " + KEEP + " ORDER BY o.order_id, c.tier",
    "join_fixed": MASTER + """SELECT o.order_id, m.tier,
  CASE WHEN o.customer_id IS NULL THEN 'missing_key'
       WHEN m.key_count IS NULL THEN 'unmatched_key'
       WHEN m.key_count > 1 THEN 'duplicate_key'
       ELSE 'matched' END AS master_status
FROM orders o LEFT JOIN master m ON o.customer_id=m.customer_id
WHERE """ + KEEP + " ORDER BY o.order_id",
    "null_equal_naive": "SELECT order_id FROM orders WHERE amount = NULL ORDER BY order_id",
    "null_is_fixed": "SELECT order_id FROM orders WHERE amount IS NULL ORDER BY order_id",
    "all_unknown_sum": "SELECT SUM(amount), COALESCE(SUM(amount), 0), COUNT(amount) FROM orders WHERE order_id IN (102,106)",
}
EXPECTED_IDS = [101, 102, 103, 105, 106]
EXPECTED_JOIN = [(101, "gold", "matched"), (102, "silver", "matched"),
                 (103, None, "missing_key"), (105, "gold", "matched"),
                 (106, None, "duplicate_key")]

def main():
    with sqlite3.connect(":memory:") as connection:
        results = {name: connection.execute(FIXTURE + sql).fetchall()
                   for name, sql in QUERIES.items()}
    checks = [
        results["filter_naive"] == [(101,), (103,), (105,), (106,)],
        [r[0] for r in results["filter_fixed"]] == EXPECTED_IDS,
        results["counts_naive"] == [(3, 20000)],
        results["counts_fixed"] == [(5, 3, 2, 20000)],
        results["duplicate_keys"] == [("C3", 2)],
        len(results["join_left_naive"]) == 6,
        len(results["join_inner_naive"]) == len(EXPECTED_IDS),
        Counter(r[0] for r in results["join_inner_naive"]) != Counter(EXPECTED_IDS),
        results["join_fixed"] == EXPECTED_JOIN,
        results["null_equal_naive"] == [],
        results["null_is_fixed"] == [(102,), (106,)],
        results["all_unknown_sum"] == [(None, 0, 0)],
    ]
    if not all(checks):
        raise AssertionError({"checks": checks, "results": results})
    print(json.dumps({"sqlite_version": sqlite3.sqlite_version,
                      "select_queries_executed": len(QUERIES),
                      "checks_passed": len(checks), "results": results,
                      "expected_order_ids": EXPECTED_IDS,
                      "real_database_access": False, "live_ai_calls": 0,
                      "result": "PASS"}, ensure_ascii=False))

if __name__ == "__main__":
    main()
python sql_contract_checks.py코드의 orders와 customers는 CTE의 이름이며 실제 DB 테이블이 아닙니다. Python sqlite3 문서는 :memory: 메모리 연결을 설명합니다. 각 질의에 같은 가상 입력이 붙으므로 원본 파일이나 운영 권한이 필요 없습니다.
Linux Python 3.12.14와 SQLite 3.53.1에서 SELECT 11개를 실행하고 기대 결과에 대한 검사 12개를 통과했습니다. 출력의 result=PASS는 잘못된 후보의 누락·중복·NULL 결과까지 의도한 반례로 재현됐다는 뜻입니다. 후보들이 모두 올바른 업무 질의라는 뜻이 아닙니다.
filter_fixed: [101, 102, 103, 105, 106]
counts_fixed: [5, 3, 2, 20000]
duplicate_keys: [C3, 2]
join_left_naive: 6 rows
join_inner_naive: 5 rows, ID 등장 횟수 불일치
join_fixed: 5 rows, missing_key=103, duplicate_key=106
null_is_fixed: [102, 106]
all_unknown_sum: [NULL, 0, 0]
select_queries_executed=11, checks_passed=12, live_ai_calls=0
위는 콘솔 JSON의 요약이며 실제 출력에는 각 질의의 모든 행과 SQLite 버전이 들어 있습니다. 정렬 없는 질의의 우연한 출력 순서를 기대값으로 고정하지 않도록 ID 목록 질의에는 ORDER BY를 넣었습니다. 이 실습은 작은 자료의 내용 검산이며 인덱스·실행 계획·대용량 속도는 측정하지 않았습니다.
AI 요청과 검토 기록에 포함할 계약
SQLite SELECT 후보를 검토하세요. 아래 VALUES는 합성 자료입니다.
취소만 제외하고 상태 NULL 주문은 유지합니다.
금액 NULL은 미확인이며 0과 다릅니다.
포함 ID는 101,102,103,105,106이고 각 ID가 한 번씩 나와야 합니다.
금액 집계는 주문 수·알려진 금액 수·미확인 수·알려진 합을 따로 표시합니다.
고객 키가 중복이면 등급을 임의 선택하지 말고 중복 상태와 NULL을 남깁니다.
출력: 필터·집계·결합 SELECT, 각 질의의 포함/제외 이유, 예상 ID 목록.
실행하지 않은 결과는 예상이라고 쓰고 실DB 연결·수정 SQL은 넣지 마세요.
실제 SQL 후보를 받으면 원문 계약과 최초 후보를 보존하고 먼저 로컬 합성 자료로 검토합니다. 운영 연결 문자열이나 실제 고객 행을 대화창에 추가하지 않습니다. 읽기 전용 SELECT도 데이터 노출·큰 계산 비용을 만들 수 있으므로 운영 실행은 승인된 권한·조회 범위·자료 처리 기준을 따라야 합니다.
질문과 업무 계약 버전:
사용 DB 엔진·버전:
가상 입력 또는 승인된 조회 범위:
포함·제외할 ID와 이유:
NULL의 의미:
오른쪽 키의 고유성 점검:
최초 SQL / 수정 SQL 버전:
기대 행 수·ID 등장 횟수·집계값:
실제 출력과 차이:
미확인·중복을 남긴 필드:
미실행 분기와 다음 검사:
검토자·확인 날짜:
102가 빠지면 상태 NULL의 포함 정책을 먼저 보고 필터를 고칩니다. 106이 두 번이면 조인 오른쪽 키를 점검합니다. 행 수를 맞추려고 임의로 첫 행만 고르거나 기대 ID를 바꾸지 않습니다. 수정 후에는 필터·집계·결합을 함께 재실행해 동일한 포함 집합을 유지하는지 확인합니다.
검증 범위와 적용 한계
기술 기준일은 2026-10-04 KST입니다. SQLite 공식 문서를 직접 확인했고 실행 버전은 위와 같이 따로 기록했습니다. 다른 DB 엔진의 타입·NULL·정렬·집계 동작에는 해당 엔진의 문서와 별도 검사가 필요합니다. 실제 모델 호출과 실DB 접근은 하지 않았습니다.
업무 합계를 독립 입력으로 정하는 과정은 AI 데이터 분석 프롬프트의 취소 주문 분리 검산과 연결됩니다. 이 글에서는 합계뿐 아니라 포함 ID의 등장 횟수와 미확인 금액·고객 키 문제까지 남기는 것을 완료 기준으로 삼습니다.
작성자 소개
