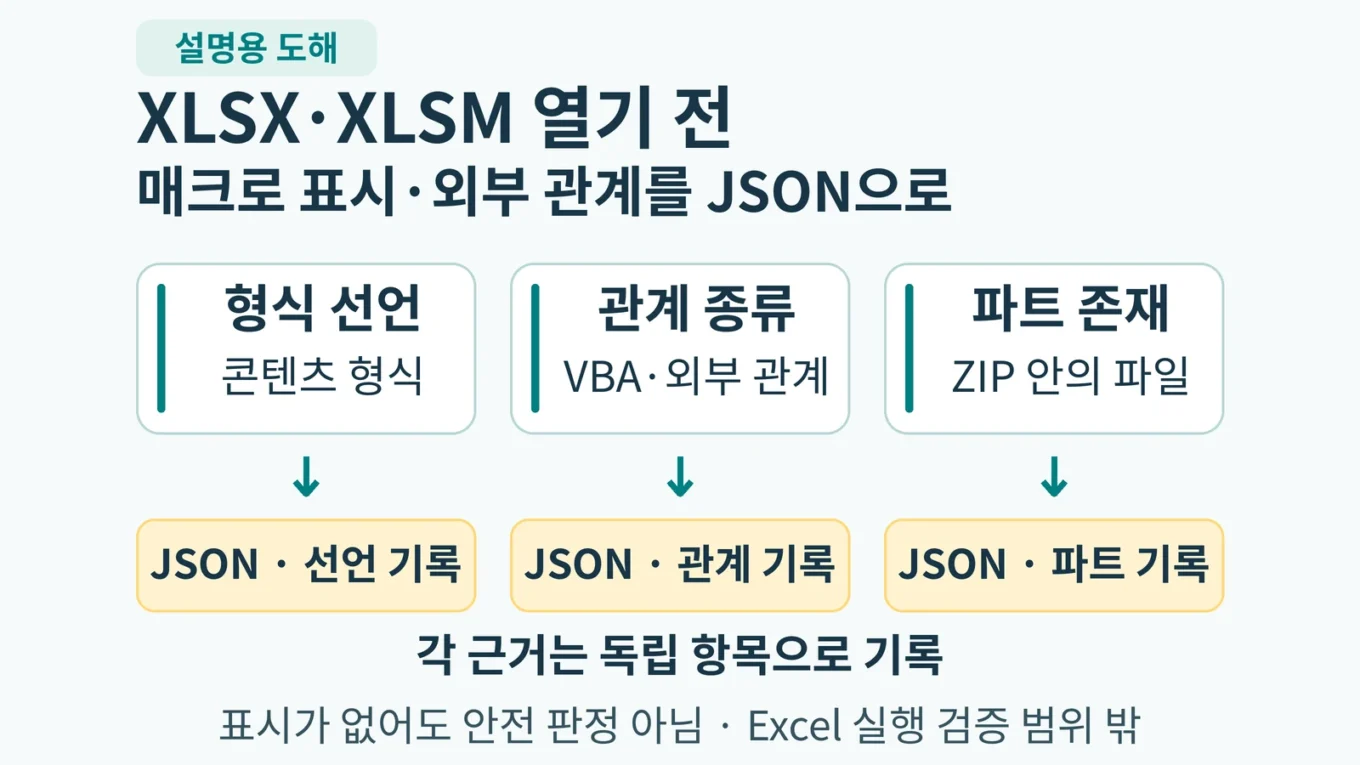
XLSX·XLSM을 열기 전 매크로 표시와 외부 관계를 목록으로 기록하기
메일이나 공유 폴더에서 받은 .xlsx·.xlsm 파일을 열기 전에, 패키지 안에 어떤 매크로 형식 선언과 외부 관계가 기록되어 있는지 남겨 두고 싶을 때가 있습니다. 파일 이름만 보고 내용까지 판단하면 확장자가 바뀐 파일이나 선언과 실제 파트가 다른 파일을 놓칠 수 있습니다.
이 글에서는 Python 표준 라이브러리로 ZIP과 XML 메타데이터를 읽어 콘텐츠 형식 선언, 관계 종류, 관련 파트의 존재를 각각 JSON 증거행으로 기록합니다. 관계가 있으면 출처 관계 파일, 관계 ID, Type, TargetMode, Target도 함께 보존합니다. Excel을 실행하거나 외부 주소로 접속하지 않습니다.
XLSX·XLSM 패키지 표시 목록 실습 ZIP 다운로드에는 전체 코드, 작은 합성 패키지, 고정 기대 JSON, 자동 시험과 README가 들어 있습니다. 실제 조사·실행 검수일은 2026년 10월 11일이며 검수 환경은 Linux의 CPython 3.12.14입니다. 표시 게시일과 실제 검수일은 구분합니다.
결과의 뜻: 이 목록은 코드에 지정한 형식·관계·파트 표시를 관측한 기록입니다. 실행 가능한 VBA가 있다는 증명이나 악성·안전 판정으로 사용할 수 없습니다. 지표 0도 “매크로가 없다” 또는 “모든 연결을 확인했다”는 뜻이 아닙니다. 제공 파일에는 실제 VBA 코드가 없으며, 합성 패키지가 Excel에서 열리는지, 더미 VBA 파트가 유효한지, 연결이 갱신되는지는 시험하지 않았습니다.
1. 선언·관계·파트를 따로 기록하는 이유
OOXML 패키지는 ZIP 안의 파트와 관계로 정보를 표현합니다. [Content_Types].xml에는 파트의 콘텐츠 형식이 선언되어 있고, .rels 파일에는 다른 파트나 외부 대상으로 향하는 관계가 들어 있습니다. 실제 ZIP 항목이 존재하는지도 따로 확인해야 합니다.
- 형식 선언: 통합 문서가 macro-enabled 형식으로 선언되었는지, VBA·연결 관련 콘텐츠 형식이 선언되었는지 기록합니다.
- 관계 종류: VBA·외부 링크·연결 관련 관계와
TargetMode="External"관계를 기록합니다. 외부 hyperlink는 그 밖의 외부 관계와 구분합니다. - 파트 존재: 선언이나 내부 관계가 가리키는 관련 파트 및 코드가 지정한 관련 이름의 항목이 ZIP에 있는지 기록합니다.
예를 들어 macro-enabled 통합 문서 선언만 있는 합성 파일에서는 그 선언을 기록합니다. VBA 콘텐츠 형식과 관계, xl/vbaProject.bin 더미 파트가 함께 있는 파일에서는 세 출처를 합쳐 한 번만 세지 않고 각각 남깁니다. 어느 한 근거가 다른 근거를 자동으로 대신하지 않도록 하는 것입니다.
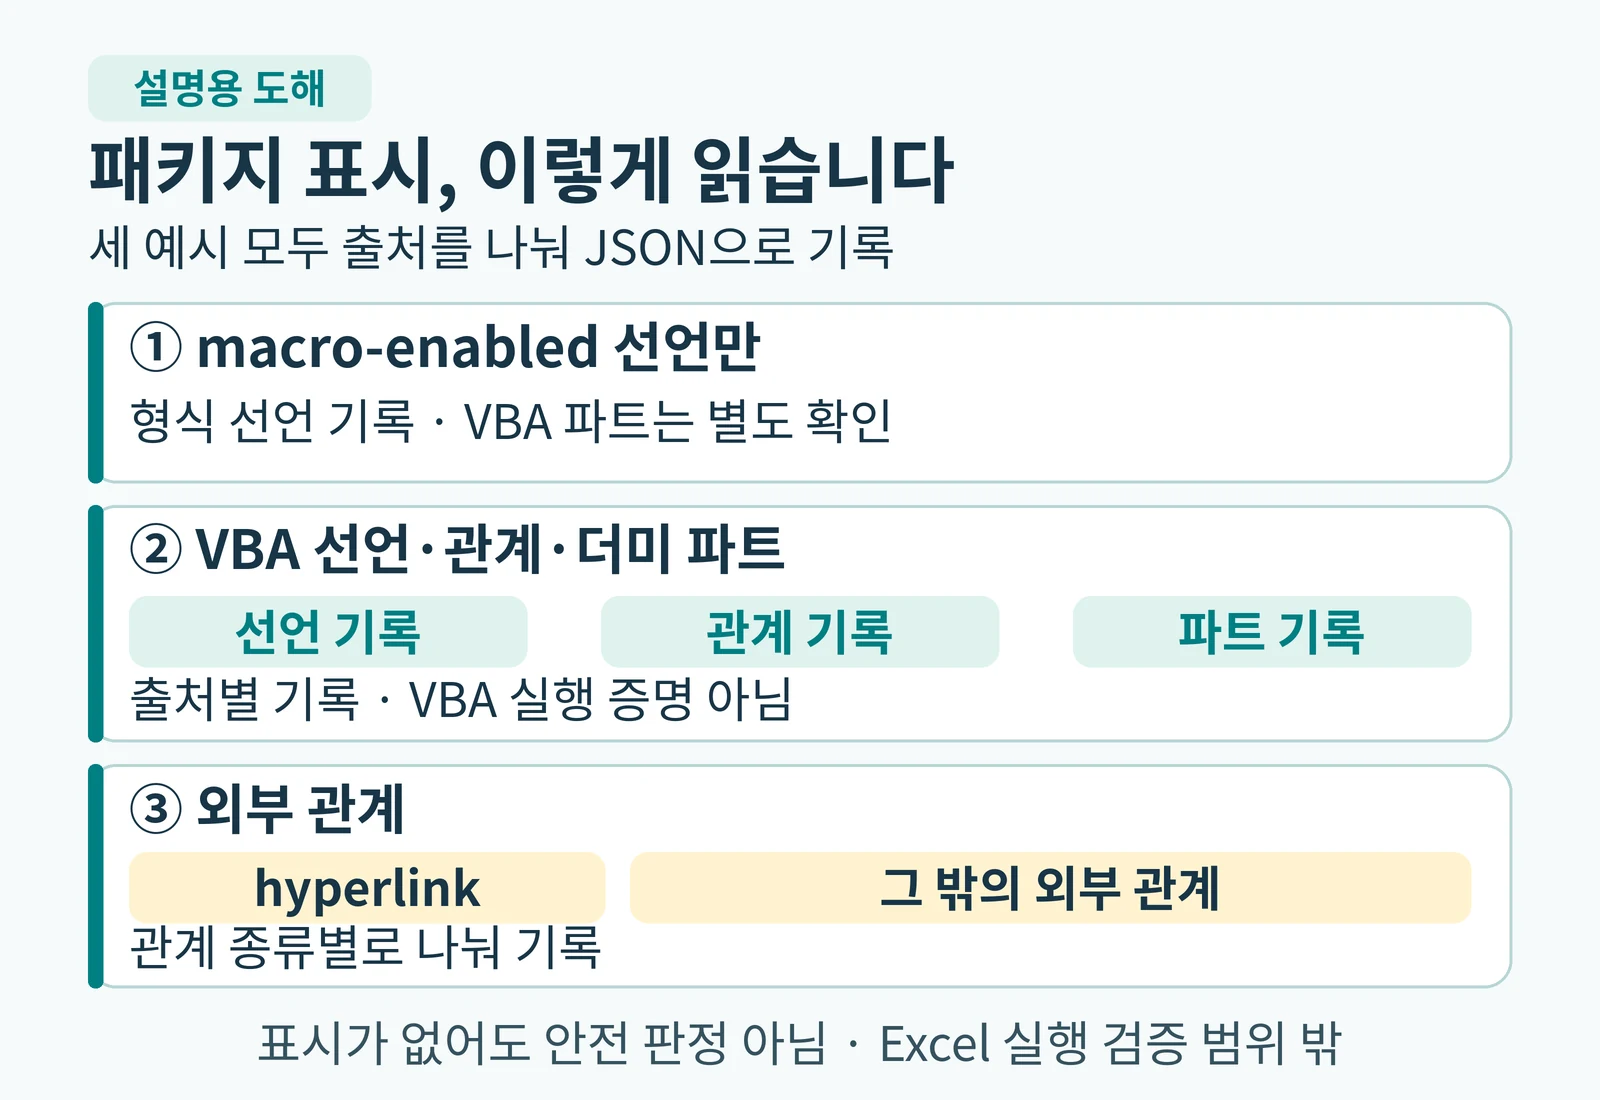
Microsoft Open XML SDK의 VbaProjectPart 공식 문서는 VBA 프로젝트 파트의 콘텐츠 형식과 관계 형식을 보여 줍니다. AddExternalRelationship 문서는 외부 hyperlink를 별도 방식으로 다루도록 안내합니다. 이 구분을 목록의 종류에도 반영합니다.
2. 실습 파일과 기대 결과 확인하기
실제 업무 파일 대신 작고 직접 만든 합성 패키지부터 사용합니다. 패키지는 메타데이터 목록의 동작을 검증하기 위한 자료입니다. Excel 사용 가능성이나 파일 형식 전체의 적합성을 인증한 문서가 아닙니다. 외부 Target도 실습용 가상 값이며 접속하지 않습니다.
| fixtures 파일 | 입력 차이 | 지표 수 | 증거행 | 읽을 점 |
|---|---|---|---|---|
| 01_zero.xlsx | 지정한 표시가 없는 패키지 | 0 | 0 | 안전 판정으로 해석하지 않음 |
| 02_macrotype_only.xlsm | macro-enabled 선언만 | 1 | 2 | VBA 존재를 추론하지 않음 |
| 03_vba_indicators.xlsm | VBA 선언·관계·더미 파트 | 4 | 7 | 각 근거를 별도 행에 기록 |
| 04_hyperlink_only.xlsx | 외부 hyperlink 관계만 | 1 | 1 | 외부 대상의 존재 검사 없음 |
| 05_external_connections.xlsx | 비하이퍼링크 외부 관계·connections | 3 | 4 | 외부 관계와 연결 파트 구분 |
| 06_same_bytes.xlsx / .xlsm | 03과 동일 바이트, 확장자만 다름 | 각 4 | 각 7 | xlsx에 형식 선언 불일치 기록 |
| 07_declared_missing.xlsm | VBA 선언만 있고 대상 파트 누락 | 2 | 4 | declared_part_missing |
indicator_count는 related_part_presence를 제외한 관측 행 수입니다. 전체 records에는 선언·관계가 가리킨 파트의 존재 확인 행도 포함됩니다. 03의 지표 4개는 macro-enabled 선언, VBA 콘텐츠 형식 선언, VBA 관계, 알려진 VBA 파트 이름이며 전체 근거행은 7개입니다.
extension은 입력 파일 이름의 확장자이고, 형식 선언은 패키지 안에서 읽은 값입니다. 동일한 바이트를 .xlsx와 .xlsm으로 저장한 두 예시는 입력 SHA-256이 같습니다. 이름이 달라져도 패키지 근거를 지우거나 새로 만들지 않고, 이름과 선언의 불일치는 별도 항목으로 남깁니다.
대상 파트가 없는 예시도 파트가 존재하는 예시와 구별합니다. XML을 읽었다는 사실과 그 선언이 가리키는 파트가 존재한다는 사실은 다릅니다. 불일치가 있으면 원본과 출처를 확인할 수 있도록 결과에 남깁니다.
3. 새 결과 파일로 목록 만들기
ZIP을 새 폴더에 풀고 p47_opc_indicator_inventory 폴더를 터미널의 작업 폴더로 지정하세요. 외부 패키지는 필요하지 않습니다. 검수 명령은 python3를 사용했습니다. Windows에서 같은 코드를 실행할 때는 설치 환경에 맞게 py -3 등으로 바꿀 수 있지만, Windows와 macOS 화면 조작은 이번 검수에 포함하지 않았습니다.
아래 명령은 새 JSON을 만듭니다. 이미 같은 이름의 결과가 있으면 덮어쓰지 않고 오류로 멈춥니다. 반복 실습에서는 새 파일명을 쓰세요. 입력 파일은 읽기만 하며 실행 전후 SHA-256이 같은지 시험합니다.
python3 opc_inventory.py fixtures/01_zero.xlsx -o zero_report.json
python3 opc_inventory.py fixtures/03_vba_indicators.xlsm -o vba_report.json
python3 opc_inventory.py fixtures/05_external_connections.xlsx -o external_report.json
python3 opc_inventory.py fixtures/06_same_bytes.xlsx -o renamed_report.json
python3 opc_inventory.py fixtures/07_declared_missing.xlsm -o missing_part_report.json
정상 실행의 터미널 메시지는 다음과 같습니다. 지표 수는 JSON의 indicator_count를 위 표와 비교하세요. 성공 상태는 지정된 메타데이터 읽기가 끝났다는 뜻입니다. 파일 내용의 안전성이나 Excel 실행 성공을 의미하지 않습니다.
completed: zero_report.json
completed: vba_report.json
completed: external_report.json
completed: renamed_report.json
completed: missing_part_report.json
전체 기대값은 ZIP의 expected 폴더에 있습니다. 파일별 입력 SHA-256, 선언·관계·파트 증거행, 불일치 목록까지 고정된 JSON과 비교합니다. 눈으로 지표 수만 비교하지 않고 자동 시험도 실행하세요.
python3 -m unittest discover -v4. JSON의 출처 필드 읽기
다음은 VBA 관계를 기록한 행입니다. source를 보면 어느 관계 파일에서 읽었는지 알 수 있고, ID·Type·TargetMode·Target은 원래 XML의 값을 추적하는 데 사용합니다. 내부 대상에 한해서 해석한 part와 존재 여부를 기록합니다. 외부 Target을 ZIP 안의 파일명으로 간주하지 않습니다.
{
  "kind": "vba_relationship",
  "source": "xl/_rels/workbook.xml.rels",
  "relationship_file": "xl/_rels/workbook.xml.rels",
  "id": "rVba",
  "type": "http://schemas.microsoft.com/office/2006/relationships/vbaProject",
  "target_mode": "Internal",
  "target": "vbaProject.bin",
  "part": "xl/vbaProject.bin",
  "declared_content_type": null,
  "declaration_kind": null,
  "exists": null,
  "mismatch": [],
  "input_sha256": "6f721df4a2154406a163f51d7d7272ee44bea8ba2717de60e3f1d19d96405665",
  "extension": ".xlsm"
}
같은 파일에 VBA 콘텐츠 형식이 선언되어 있거나 관련 이름의 파트가 있으면 각각 다른 근거행으로 기록됩니다. 따라서 지표 수는 매크로 수, 외부 연결 수, 위험 점수와 일치하지 않습니다. 결과의 kind와 출처를 함께 읽어야 합니다.
외부 hyperlink만 있는 파일은 external_hyperlink_relationship로, 그 밖의 External 관계는 external_non_hyperlink_relationship로 구별합니다. 셀 주소·표시 문구별 hyperlink 목록이 필요하면 셀 하이퍼링크 메타데이터 실습을 참고하세요. 이번 목록은 패키지 근거가 중심이며 셀별 링크 표를 만들지 않습니다.
xl/connections.xml처럼 관련 이름의 파트가 있어도 이 코드는 연결 문자열이나 자격 정보를 읽어 해석하지 않습니다. 수식의 외부 참조, DDE, 모든 확장 파트와 기능을 완전하게 탐지하는 코드도 아닙니다. 단순한 정규 파트 이름과 UTF-8 XML, Stored·Deflate 압축만 지원합니다. 퍼센트 인코딩 경로나 다른 XML 인코딩 같은 지원 밖 표현은 추정해서 처리하지 않고 보류합니다. 기록하는 알려진 상수와 이름은 전체 코드에서 확인할 수 있습니다.
실제 업무 파일의 외부 Target에는 서버 주소, 내부 경로 등 공개하면 안 되는 정보가 들어 있을 수 있습니다. 결과 JSON을 확인 없이 공개 업로드하거나 전달하지 마세요. 이 글의 첨부자료에는 가상 Target만 넣었습니다.
5. 전체 실행 코드
코드는 입력 크기와 ZIP 항목의 선언 크기를 점검합니다. ZIP의 파일 항목은 디스크 추출 없이 읽어 CRC를 확인하며, 필요한 콘텐츠 형식·관계 XML만 메타데이터로 해석합니다. VBA 더미 파트와 연결 파트의 내용은 기능이나 유효성 검증에 사용하지 않습니다. 패키지 내부 파일을 디스크에 추출하거나 Office 프로그램을 실행하지 않습니다. 외부 주소와 연결 대상에 네트워크 요청을 보내는 함수도 사용하지 않습니다.
표준 zipfile은 파일의 선언 정보와 실제 읽기 과정에서 오류를 확인하는 도구입니다. 입력 SHA-256 계산은 전체 입력을 스트리밍해 읽으므로 파일 크기 한도를 적용하기 전에도 읽기 작업이 발생합니다. 기본 한도는 입력 64MiB, ZIP 항목 4,096개, 항목당 압축해제 크기 32MiB, 합계 64MiB, 메타데이터 XML 1MiB, 압축률 200배입니다. 절대적인 실행 시간·메모리 사용량 제한은 아닙니다. 아래 한도와 XML 거절 규칙은 이 실습의 처리 경계이며, 신뢰할 수 없는 파일을 위한 보안 격리나 완전한 악성 파일 검사를 입증하지 않습니다. 실제 업무 자료에 적용할 때는 조직의 파일 취급 절차를 함께 따르세요.
전체 실행 코드 펼치기: opc_inventory.py
#!/usr/bin/env python3
"""XLSX/XLSM 패키지 표시 목록. Office 실행·추출·네트워크 요청 없음."""
import argparse
from dataclasses import dataclass
import hashlib
import json
from pathlib import Path
import posixpath
import re
import sys
import stat
import unicodedata
from urllib.parse import urlsplit
import xml.etree.ElementTree as ET
import zipfile
import zlib

CT_NS = 'http://schemas.openxmlformats.org/package/2006/content-types'
REL_NS = 'http://schemas.openxmlformats.org/package/2006/relationships'
OFFICE = 'http://schemas.openxmlformats.org/officeDocument/2006/relationships/'
STRICT = 'http://purl.oclc.org/ooxml/officeDocument/relationships/'
VBA_REL = 'http://schemas.microsoft.com/office/2006/relationships/vbaProject'
VBA_CT = 'application/vnd.ms-office.vbaProject'
MACRO_CT = {'application/vnd.ms-excel.sheet.macroEnabled.main+xml',
            'application/vnd.ms-excel.template.macroEnabled.main+xml',
            'application/vnd.ms-excel.addin.macroEnabled.main+xml'}
CONNECTION_CT = {
    'application/vnd.openxmlformats-officedocument.spreadsheetml.connections+xml': 'connections',
    'application/vnd.openxmlformats-officedocument.spreadsheetml.externalLink+xml': 'external_link',
}
INTERESTING_REL = {VBA_REL: 'vba_relationship'}
for prefix in (OFFICE, STRICT):
    INTERESTING_REL.update({prefix + 'connections': 'connections_relationship',
                           prefix + 'externalLink': 'external_link_relationship'})
HYPERLINK_REL = {p + 'hyperlink' for p in (OFFICE, STRICT)}


@dataclass(frozen=True)
class Limits:
    input_bytes: int = 64 * 1024 * 1024
    members: int = 4096
    member_bytes: int = 32 * 1024 * 1024
    total_bytes: int = 64 * 1024 * 1024
    xml_bytes: int = 1024 * 1024
    ratio: int = 200


class StopInventory(Exception):
    def __init__(self, code, source, message, status='deferred'):
        self.code, self.source, self.message, self.status = code, source, message, status


def stop(code, source, message, status='deferred'):
    raise StopInventory(code, source, message, status)


def member_name(raw):
    """보수적 지원 범위. 모호한 이름을 고쳐 추정하지 않는다."""
    name = unicodedata.normalize('NFC', raw)
    pieces = name.rstrip('/').split('/')
    if (not name or name.startswith('/') or any(c in name for c in '\\:%\x00')
            or any(p in ('', '.', '..') for p in pieces)):
        stop('unsupported_member_path', raw, '정규 ZIP 파트 이름 지원 범위를 벗어났습니다.')
    return '/'.join(pieces)


def internal_target(owner, target):
    uri = urlsplit(target)
    if uri.scheme or uri.netloc or uri.query or uri.fragment or '\\' in target or '%' in target:
        stop('unsupported_internal_target', owner, '내부 Target URI 지원 범위를 벗어났습니다.')
    pieces = [] if target.startswith('/') else posixpath.dirname(owner).split('/')
    pieces = [p for p in pieces if p]
    for piece in target.lstrip('/').split('/'):
        if piece in ('', '.'):
            continue
        if piece == '..':
            if not pieces:
                stop('target_escapes_package', owner, '내부 Target이 패키지 루트를 벗어납니다.', 'failed')
            pieces.pop()
        else:
            pieces.append(piece)
    if not pieces:
        stop('unsupported_internal_target', owner, '빈 내부 파트 Target입니다.')
    return member_name('/'.join(pieces))


def relationship_owner(name):
    if name == '_rels/.rels':
        return ''
    folder, base = posixpath.split(name)
    if not folder.endswith('/_rels') or not base.endswith('.rels'):
        stop('unsupported_relationship_path', name, '관계파일 경로 지원 범위를 벗어났습니다.')
    return posixpath.join(folder[:-6], base[:-5])


def read_members(archive, limits):
    infos = archive.infolist()
    if len(infos) > limits.members:
        stop('too_many_members', 'ZIP', 'ZIP 항목 수 제한을 넘었습니다.')
    entries, keys, total = {}, set(), 0
    for info in infos:
        name = member_name(info.orig_filename)
        key = name.casefold()
        if key in keys:
            stop('duplicate_or_ambiguous_member', info.filename, '중복·대소문자·정규화 충돌입니다.')
        keys.add(key)
        if info.flag_bits & (1 | 64):
            stop('encrypted_zip_member', info.filename, '암호화 ZIP 항목은 읽지 않습니다.')
        if info.compress_type not in (zipfile.ZIP_STORED, zipfile.ZIP_DEFLATED):
            stop('unsupported_compression', info.filename, '이 예제는 Stored/Deflate만 지원합니다.')
        total += info.file_size
        if info.file_size > limits.member_bytes or total > limits.total_bytes:
            stop('member_or_total_too_large', info.filename, '압축해제 크기 제한을 넘었습니다.')
        if info.file_size > max(1, info.compress_size) * limits.ratio:
            stop('compression_ratio_limit', info.filename, '압축률 제한을 넘었습니다.')
        metadata = name == '[Content_Types].xml' or name.endswith('.rels')
        if metadata and info.file_size > limits.xml_bytes:
            stop('xml_too_large', info.filename, '메타데이터 XML 크기 제한을 넘었습니다.')
        if not info.is_dir():
            entries[name] = (info, metadata)
    # CRC 검사도 읽기로 수행한다. 내부 파일을 디스크에 추출하지 않는다.
    xml = {}
    for name, (info, metadata) in entries.items():
        chunks, size = [], 0
        with archive.open(info, 'r') as handle:
            while chunk := handle.read(65536):
                size += len(chunk)
                if size > limits.member_bytes or size > info.file_size:
                    stop('member_read_limit', name, '실제 읽기 크기가 제한·선언을 넘었습니다.')
                if metadata:
                    chunks.append(chunk)
        if size != info.file_size:
            stop('member_size_mismatch', name, 'ZIP 항목 크기 불일치입니다.', 'failed')
        if metadata:
            xml[name] = b''.join(chunks)
    return set(entries), xml


def parse_xml(data, source, expected):
    # UTF-8/ASCII만 지원. DTD·ENTITY는 파서에 보내기 전에 보류한다.
    try:
        text = data.decode('utf-8-sig')
    except UnicodeError:
        stop('unsupported_xml_encoding', source, 'UTF-8 메타데이터만 지원합니다.')
    declaration = re.match(r'\s*<\?xml\s+([^?]*)\?>', text)
    encoding = (re.search(r'''encoding\s*=\s*['"]([^'"]+)['"]''', declaration[1], re.I)
                if declaration else None)
    if encoding and encoding[1].casefold() not in ('utf-8', 'us-ascii'):
        stop('unsupported_xml_encoding', source, 'UTF-8/ASCII 선언만 지원합니다.')
    upper = text.upper()
    if '\x00' in text or '<!DOCTYPE' in upper or '<!ENTITY' in upper:
        stop('unsupported_xml_construct', source, 'DTD·ENTITY·NUL XML은 지원하지 않습니다.')
    try:
        root = ET.fromstring(text)
    except ET.ParseError:
        stop('xml_parse_failed', source, '메타데이터 XML 파싱에 실패했습니다.', 'failed')
    if root.tag != expected:
        stop('unsupported_xml_root', source, '메타데이터 루트·네임스페이스가 다릅니다.')
    return root


def collect_records(parts, xml, extension):
    records = []

    def add(kind, source, **fields):
        row = dict(kind=kind, source=source, relationship_file=None, id=None,
                   type=None, target_mode=None, target=None, part=None,
                   declared_content_type=None, declaration_kind=None,
                   exists=None, mismatch=[])
        row.update(fields)
        records.append(row)

    def presence(source, part, missing, **fields):
        add('related_part_presence', source, part=part, exists=part in parts,
            mismatch=[] if part in parts else [missing], **fields)

    if '[Content_Types].xml' not in xml:
        stop('content_types_missing', 'ZIP', '[Content_Types].xml이 없습니다.', 'failed')
    root = parse_xml(xml['[Content_Types].xml'], '[Content_Types].xml', f'{{{CT_NS}}}Types')
    seen = set()
    for item in root:
        declaration = item.tag.removeprefix(f'{{{CT_NS}}}')
        if declaration not in ('Default', 'Override'):
            stop('unsupported_content_type_element', '[Content_Types].xml', '알 수 없는 선언입니다.')
        key = item.get('PartName') if declaration == 'Override' else item.get('Extension')
        ct = item.get('ContentType')
        if not key or not ct or (declaration, key.casefold()) in seen:
            stop('invalid_content_type_declaration', '[Content_Types].xml', '누락·중복 선언입니다.', 'failed')
        seen.add((declaration, key.casefold()))
        if declaration == 'Override':
            if not key.startswith('/'):
                stop('invalid_override_part', '[Content_Types].xml',
                     'Override PartName은 /로 시작해야 합니다.', 'failed')
            matches = [internal_target('', key)]
        else:
            matches = sorted(p for p in parts if Path(p).suffix[1:].casefold() == key.casefold())
        if ct == VBA_CT:
            kind = 'vba_content_type'
        elif ct in MACRO_CT:
            kind = 'macro_enabled_content_type'
        elif ct in CONNECTION_CT:
            kind = CONNECTION_CT[ct] + '_content_type'
        else:
            kind = None
        if not kind:
            continue
        fields = dict(declared_content_type=ct, declaration_kind=declaration)
        mismatch = ['extension_macro_enabled_content_type'] if ct in MACRO_CT and extension == '.xlsx' else []
        # Default 선언 자체는 1행. 이를 적용받는 존재 파트는 별도 행이다.
        declared_part = matches[0] if declaration == 'Override' else None
        add(kind, '[Content_Types].xml', part=declared_part, target=key,
            mismatch=mismatch, **fields)
        for part in matches:
            presence('[Content_Types].xml', part, 'declared_part_missing', **fields)
    for relfile in sorted(n for n in xml if n.endswith('.rels')):
        owner = relationship_owner(relfile)
        if owner and owner not in parts:
            stop('relationship_owner_missing', relfile, '관계의 원본 파트가 없습니다.', 'failed')
        root = parse_xml(xml[relfile], relfile, f'{{{REL_NS}}}Relationships')
        ids = set()
        for item in root:
            rid, typ, target = (item.get(n) for n in ('Id', 'Type', 'Target'))
            mode = item.get('TargetMode', 'Internal')
            if (item.tag != f'{{{REL_NS}}}Relationship' or not rid or not typ
                    or not target or rid in ids or mode not in ('Internal', 'External')):
                stop('invalid_relationship', relfile, '관계 필수값·Id·TargetMode 오류입니다.', 'failed')
            ids.add(rid)
            fields = dict(relationship_file=relfile, id=rid, type=typ, target_mode=mode, target=target)
            if mode == 'External':
                kind = ('external_hyperlink_relationship' if typ in HYPERLINK_REL
                        else 'external_non_hyperlink_relationship')
                add(kind, relfile, **fields)
                # External Target은 내부 파트로 해석하거나 존재 검사를 하지 않는다.
            else:
                part = internal_target(owner, target)
                if typ in INTERESTING_REL:
                    add(INTERESTING_REL[typ], relfile, part=part, **fields)
                    presence(relfile, part, 'relationship_part_missing', **fields)
    for part in sorted(parts):
        if part == 'xl/vbaProject.bin':
            kind = 'vba_known_name'
        elif part == 'xl/connections.xml':
            kind = 'connections_known_name'
        elif part.startswith('xl/externalLinks/') and part.endswith('.xml') and '/_rels/' not in part:
            kind = 'external_link_known_name'
        else:
            continue
        add(kind, 'ZIP entry name', part=part, exists=True)
    return records


def inspect_package(path, limits=Limits()):
    path = Path(path)
    report = dict(schema_version=1, file=path.name, extension=path.suffix.lower(),
                  input_sha256=None, status='failed', indicator_count=None,
                  scope='metadata_inventory_only', records=[], issues=[])
    try:
        if not stat.S_ISREG(path.stat().st_mode):
            stop('unsupported_input_kind', path.name, '일반 파일만 지원합니다. 입력 바이트를 읽지 않았습니다.')
        with path.open('rb') as handle:
            digest = hashlib.sha256()
            while chunk := handle.read(1024 * 1024):
                digest.update(chunk)
            report['input_sha256'] = digest.hexdigest()
            size = handle.tell()
            if size > limits.input_bytes:
                stop('input_too_large', path.name, '입력 파일 크기 제한을 넘었습니다.')
            if report['extension'] not in ('.xlsx', '.xlsm'):
                stop('unsupported_extension', path.name, 'XLSX/XLSM 확장자만 지원합니다.')
            handle.seek(0)
            if handle.read(8) == bytes.fromhex('d0cf11e0a1b11ae1'):
                stop('compound_container', path.name, '암호화 OOXML 또는 구형 복합컨테이너는 지원하지 않습니다.')
            handle.seek(0)
            with zipfile.ZipFile(handle, 'r') as archive:
                parts, xml = read_members(archive, limits)
                records = collect_records(parts, xml, report['extension'])
            handle.seek(0)
            final = hashlib.sha256()
            while chunk := handle.read(1024 * 1024):
                final.update(chunk)
            if final.hexdigest() != report['input_sha256']:
                stop('input_changed', path.name, '검사 도중 입력 바이트가 변경되었습니다.', 'failed')
        for row in records:
            row.update(input_sha256=report['input_sha256'], extension=report['extension'])
        report.update(status='completed', records=records,
                      indicator_count=sum(r['kind'] != 'related_part_presence' for r in records))
    except StopInventory as error:
        report['status'] = error.status
        report['issues'].append(dict(code=error.code, source=error.source, message=error.message))
    except (OSError, zipfile.BadZipFile, EOFError, RuntimeError,
            NotImplementedError, ValueError, zlib.error) as error:
        report['issues'].append(dict(code='input_or_zip_read_failed', source=path.name,
                                     message=f'입력·ZIP 읽기 실패: {type(error).__name__}'))
    return report


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('input', type=Path, help='읽기만 할 .xlsx/.xlsm 파일')
    parser.add_argument('-o', '--output', type=Path, required=True, help='새 JSON 파일; 덮어쓰기 금지')
    args = parser.parse_args()
    try:
        # 출력 경합·동일 입력 경로도 x 모드로 기존 바이트를 보존한다.
        with args.output.open('x', encoding='utf-8') as handle:
            report = inspect_package(args.input)
            json.dump(report, handle, ensure_ascii=False, indent=2)
            handle.write('\n')
    except FileExistsError:
        print('기존 출력 파일을 보존했습니다. 새 출력 경로를 지정하세요.', file=sys.stderr)
        return 3
    except OSError as error:
        print(f'출력 저장 실패: {type(error).__name__}', file=sys.stderr)
        return 3
    print(f"{report['status']}: {args.output}")
    return 0 if report['status'] == 'completed' else 2


if __name__ == '__main__':
    raise SystemExit(main())
6. 검사 실패를 지표 0으로 바꾸지 않기
암호화 표시, 처리 한도를 넘은 파일, 중복 ZIP 이름, 손상된 ZIP, 메타데이터 XML 읽기·파싱 실패, 지원하지 않는 확장자는 성공 목록을 만들지 않습니다. 종료 코드와 오류 메시지를 확인하고 해당 입력을 보류하세요. “읽지 못했으니 아무 표시도 없다”로 처리하면 실패와 지표 0을 혼동하게 됩니다.
| 결과 | 예시 | 다음 조치 |
|---|---|---|
| deferred / 종료 2 | 암호화 ZIP·복합 컨테이너·미지원 확장자·압축 방식·한도 초과·지원 밖 XML·경로 | 해당 원본은 보류하고 ZIP의 정상 합성 파일로 경로와 명령부터 확인 |
| failed / 종료 2 | ZIP 읽기·CRC·Deflate 손상·XML 파싱·필수 메타데이터·관계 오류 | issues의 source와 code를 확인하고 제공자에게 원본 구조 확인 |
| 출력 오류 / 종료 3 | 이미 같은 이름의 결과가 있거나 저장할 수 없음 | 기존 파일을 보존하고 쓰기 가능한 다른 새 경로 지정 |
검사를 끝내지 못한 JSON은 indicator_count=null, records=[]이며 issues에 사유가 있습니다. completed이면서 지표가 0인 정상 합성 예시와 구별하세요. 읽을 수 있는 입력의 SHA-256은 실패·보류 기록에도 보존합니다.
오류가 난 업무 원본을 이 실습 코드로 임의 수정하거나 암호를 해제하지 마세요. 제공한 정상 합성 파일을 새 폴더에서 먼저 실행해 경로와 명령을 확인하세요. XML이나 패키지 구조가 잘못된 원본은 제공자에게 확인하고, 제한을 넘는 원본은 처리 목적과 크기를 검토한 별도 절차로 넘깁니다.
JSON을 만드는 단계에서 저장 오류가 나면 그 결과를 완료본으로 사용하지 않습니다. 기존 파일은 보존하고 다른 새 경로에서 다시 실행합니다. 갑작스러운 프로세스 종료나 동시 변경, 디스크 고장까지 자동 복구한다고 보장하지 않습니다.
7. 실제 확인한 범위와 이어서 볼 자료
이번 검수에서는 합성 입력별 고정 기대 JSON, 같은 바이트의 확장자 차이, 선언 대상 누락, 외부 hyperlink와 그 밖의 외부 관계의 분류, 오류 입력의 실패 처리, 입력 SHA-256과 기존 결과 보존을 시험했습니다. 실습 ZIP의 CRC와 파일 해시, 본문의 전체 코드와 ZIP의 코드 일치도 확인했습니다.
시험은 Linux CPython 3.12.14의 ZIP·XML 읽기와 새 JSON 출력에 한정합니다. Excel 열림, VBA 바이너리 유효성·실행, 실제 연결 갱신과 개인정보가 든 업무 파일, Windows·macOS UI는 검증하지 않았습니다. 암호화된 Office 파일이나 예전 .xls 파일은 이 실습에서 지원하지 않습니다.
- Python 3.12 zipfile 공식 문서: ZIP 항목 정보, 읽기, 암호화와 큰 파일 취급의 제약
- Microsoft Open XML SDK VbaProjectPart: VBA 파트의 콘텐츠 형식과 관계 종류
- Microsoft AddExternalRelationship: 외부 관계와 hyperlink 처리의 구분
- XLSX의 셀 하이퍼링크를 읽기 전용 JSON으로 정리하기: 셀별 링크 목록이 필요한 경우
파일 이름, 형식 선언, 관계, 실제 파트 존재를 나란히 남기면 어떤 근거를 확인했고 무엇이 불일치하는지 설명할 수 있습니다. 근거의 출처를 보존하고, 검사 실패는 실패로 남기는 것이 이 실습의 핵심입니다.
작성자 소개
