Excel 변환 사본에 저장된 드롭다운 규칙이 남았는지 대조하기
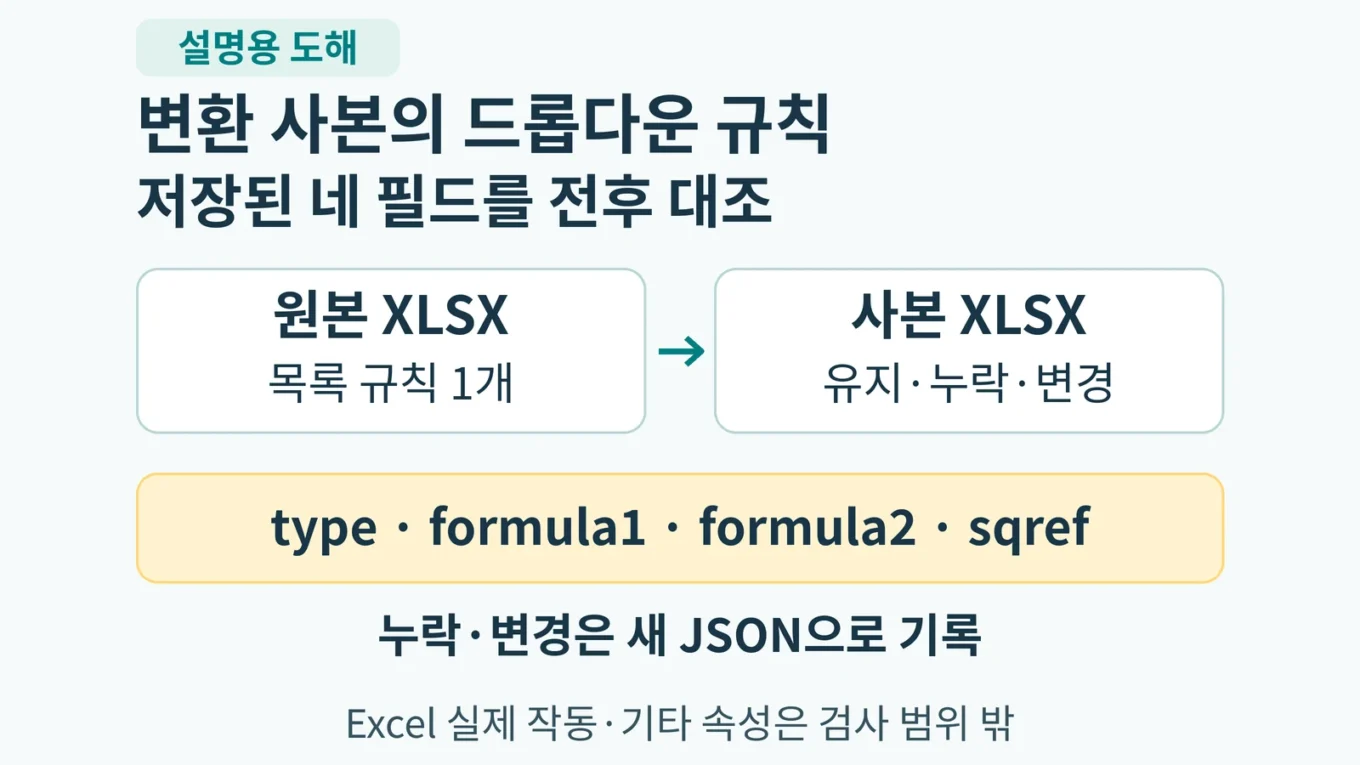
Excel 파일을 다른 도구로 변환하거나 다시 저장한 뒤에는 셀 값이 잘 보여도 드롭다운의 목록 규칙이 빠졌을 수 있습니다. 이 글에서는 원본과 사본에 저장된 목록 규칙 네 필드를 Python으로 대조합니다. 규칙을 다시 만들거나 입력 파일을 저장하지 않고, 차이를 새 JSON 파일에 기록합니다.
확인 범위: 시트 이름과 목록형 데이터 유효성 검사(type=list)의 type, formula1, formula2, sqref입니다. 결과가 같아도 Excel에서 화살표가 보이고 잘못된 값이 차단된다는 뜻은 아닙니다. showDropDown, allowBlank, 오류 메시지 등 다른 속성과 실제 Excel 입력 평가는 별도로 확인해야 합니다.
실습 파일은 2026년 10월 11일 Linux·Python 3.12.14·openpyxl 3.1.5에서 만든 합성 예제입니다. 실제 변환 프로그램이나 Excel 앱을 실행한 결과로 소개하지 않습니다.
1. 무엇을 비교할까요?
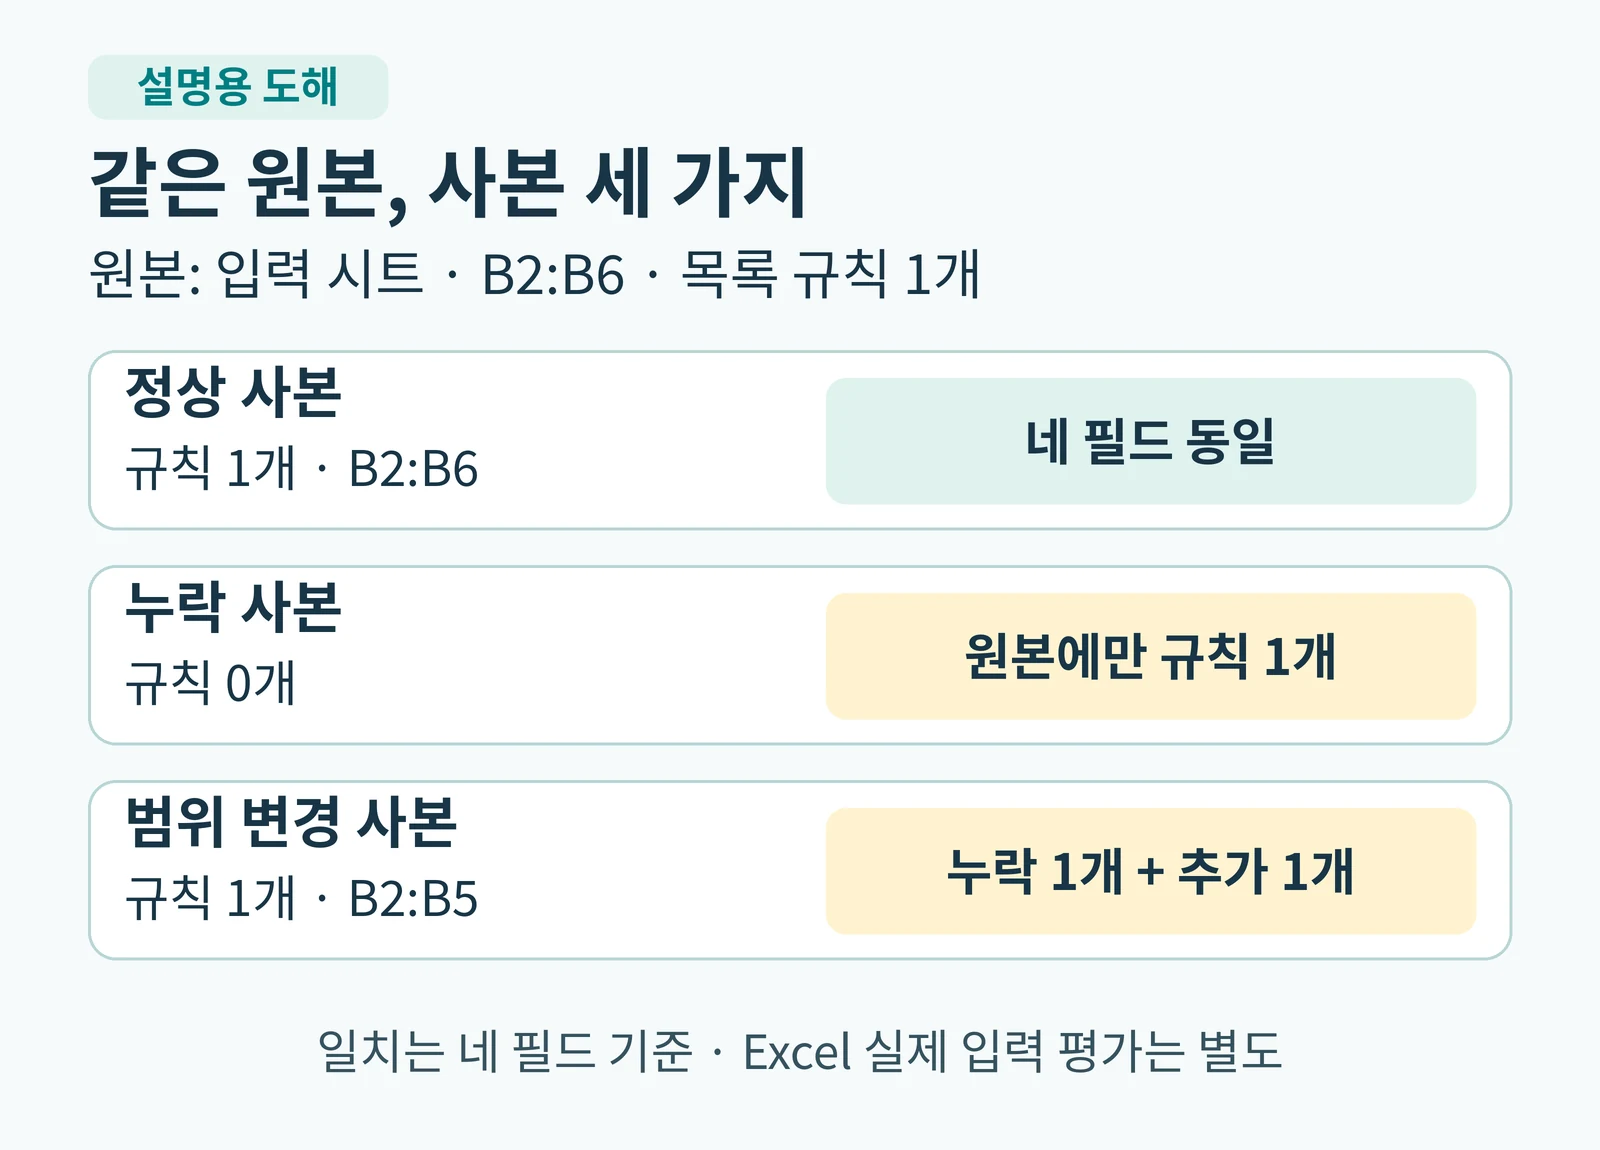
주문 상태를 적는 입력 시트의 B2:B6에 대기, 진행, 완료 목록을 지정했다고 가정합니다. 원본에는 목록 규칙 하나가 있고, 사본마다 규칙을 유지하거나 누락하거나 적용 범위를 바꿉니다. 같은 데이터가 들어 있는지는 이번 검사 대상에 포함하지 않습니다.
| 항목 | 비교 방법 | 주의점 |
|---|---|---|
| 시트 이름 | 이름이 정확히 같은 시트끼리 비교 | 이름을 바꾼 시트는 누락·추가 시트로 표시 |
| type | list 규칙만 선택 | 정수·날짜·사용자 지정 규칙은 제외 개수만 기록 |
| formula1·formula2 | openpyxl이 읽은 문자열과 null을 그대로 비교 | 공백이나 표현이 다르면 의미가 같아도 차이로 기록 |
| sqref | openpyxl의 표준 범위 표현을 읽고 토큰을 정렬 | 토큰 순서, $ 유무, 대소문자, 단일 셀 반복 표기는 표준화 |
| 규칙 목록 | 규칙의 순서는 무시하고 중복 개수는 유지 | 똑같은 규칙 두 개를 한 개로 바꾸면 차이 |
이 도구는 원시 XML 문자열을 그대로 비교하지 않습니다. openpyxl이 읽은 범위에서 $B$2:$B$6과 b2:b6은 B2:B6으로, B2:B2는 B2로 표준화됩니다. 이 세 경우는 같은 것으로 처리하며, sqref 안에 같은 범위 토큰이 반복된 경우도 하나로 정리됩니다. 이것은 규칙 객체 자체의 중복 개수 보존과 별개입니다. B2:B6과 B2:B4 B5:B6은 같은 셀을 덮지만 이 도구에서는 다르게 기록합니다. 범위를 합쳐 셀의 포함 관계를 계산하지 않기 때문입니다. 수식에 앞쪽 =을 붙였거나 같은 의미의 이름 정의로 바꾼 경우도 직접 확인하세요. 차이는 검토할 단서이며, 기능 손상 판정은 아닙니다.
2. 실습 ZIP 준비하기
ZIP에는 전체 비교 코드, 합성 XLSX, 고정 기대 JSON, 자동 테스트, README와 파일 해시가 들어 있습니다. 압축을 풀고 compare_validation.py가 있는 폴더에서 명령을 실행하세요. expected 폴더의 JSON은 기대값이며, 직접 실행하면 새 결과가 만들어집니다. 원본 업무 파일은 먼저 별도로 복사한 뒤 이용하는 편이 좋습니다.
python3 -m venv .venv
# Linux/macOS
source .venv/bin/activate
python3 -m pip install -r requirements.txt
# Windows PowerShell에서는 활성화 없이 다음 명령 사용
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
Windows PowerShell에서는 이후 비교 명령과 테스트 명령의 python3도 .\.venv\Scripts\python.exe로 바꿔 같은 가상환경의 Python을 사용하세요. 활성화 스크립트를 실행할 필요는 없습니다. 아래 실행 결과는 Linux에서 확인한 것이며, Windows 경로나 Excel 파일 잠금 상태는 실제 Windows에서 시험하지 않았습니다.
3. 정상 사본과 규칙 누락 사본 비교
python3 compare_validation.py fixtures/source.xlsx fixtures/same_copy.xlsx -o same_report.json
python3 compare_validation.py fixtures/source.xlsx fixtures/missing_copy.xlsx -o missing_report.json
python3 compare_validation.py fixtures/source.xlsx fixtures/range_changed_copy.xlsx -o range_report.json
정상 사본은 선택한 네 필드가 같고, 누락 사본은 원본에만 목록 규칙 하나가 남습니다. 범위 변경과 수식 변경 사본은 원본에만 한 개, 사본에만 한 개가 기록됩니다. 이 도구는 두 규칙을 임의로 짝지어 특정 속성 변경이라고 단정하지 않습니다.
| 사본 파일 | 목록 규칙 수 | status | 종료 코드 | 읽을 점 |
|---|---|---|---|---|
| same_copy.xlsx | 1 → 1 | selected_fields_equal | 0 | 차이 없음 |
| missing_copy.xlsx | 1 → 0 | selected_fields_different | 1 | 원본에만 1 |
| range_changed_copy.xlsx | 1 → 1 | selected_fields_different | 1 | 원본에만 1·사본에만 1 |
| formula_changed_copy.xlsx | 1 → 1 | selected_fields_different | 1 | 원본에만 1·사본에만 1 |
| ignored_attribute_copy.xlsx | 1 → 1 | selected_fields_equal | 0 | 다른 속성은 검사 범위 밖 |
| split_range_copy.xlsx | 1 → 1 | selected_fields_different | 1 | 범위 분할 동치 추론 없음 |
| warning_extension_copy.xlsx | 1 → 1 | inspection_incomplete | 2 | 확장 경고 보존·판정 보류 |
순서가 다른 범위 두 파일(reordered_ranges_source.xlsx, reordered_ranges_copy.xlsx)은 서로 비교하면 일치합니다. 절대참조·소문자·단일 셀 반복·범위 토큰 중복의 원시 XML 반례 4쌍도 표준 범위 표현으로 읽힌 뒤 일치합니다. ZIP의 README와 expected/cases.json에 전체 21쌍의 입력·기대 결과가 있습니다.
터미널의 상태와 종료 코드를 먼저 확인하고 JSON의 status, inspection_complete, comparison.sheets를 확인하세요. 두 입력의 SHA-256 전후 값도 JSON에 남습니다. 통합 문서를 읽는 동안 경고나 오류가 있으면 네 필드 일치 판정을 완료한 것으로 처리하지 않습니다.
4. 차이 JSON 읽기
{
  "status": "selected_fields_different",
  "inspection_complete": true,
  "comparison": {
    "sheet_name_membership_equal": true,
    "observed_selected_fields_equal": false,
    "sheets": [
      {
        "sheet_name": "입력",
        "original_present": true,
        "converted_present": true,
        "observed_selected_fields_equal": false,
        "missing_from_converted": [
          {
            "type": "list",
            "formula1": "\"대기,진행,완료\"",
            "formula2": null,
            "sqref": "B2:B6",
            "count": 1
          }
        ],
        "added_in_converted": [
          {
            "type": "list",
            "formula1": "\"대기,진행,완료\"",
            "formula2": null,
            "sqref": "B2:B5",
            "count": 1
          }
        ]
      }
    ]
  }
}
missing_from_converted는 원본에만 있는 규칙, added_in_converted는 사본에만 있는 규칙입니다. 각 항목의 count는 같은 네 필드 조합이 몇 번 나타나는지 보여 줍니다. B2:B6에서 B2:B5로 바뀐 경우에는 같은 셀의 값이 바뀐 것인지까지 알 수 없으므로 두 항목의 sqref를 직접 대조합니다.
ignored_attribute_copy.xlsx는 showDropDown, allowBlank, errorStyle을 원본과 다르게 만든 반례입니다. 네 필드는 같아서 selected_fields_equal이지만 이 속성 차이는 도구가 검사하지 않습니다. 화살표 표시나 빈칸 허용까지 같다고 해석하면 안 됩니다.
5. 오류·경고가 나오면
| 상태 / 종료 | 의미 | 다음 조치 |
|---|---|---|
| selected_fields_equal / 0 | 선택한 네 필드와 시트 이름이 같음 | Excel 실제 작동·다른 속성은 별도 시험 |
| selected_fields_different / 1 | 누락·추가 규칙 또는 시트 이름 차이 | JSON의 수식·범위를 원본과 사본에서 확인 |
| inspection_incomplete / 2 | 통합 문서 로딩 경고 | 입력별 warnings 원문 확인, 해당 기능은 별도 도구로 검토 |
| inspection_error / 2 | 읽기·형식 오류, 두 입력이 같은 파일, 검사 중 입력 변경 | errors의 code 확인 후 서로 다른 정상 .xlsx 사본 준비 |
| 출력 거부 / 3 | 기존 JSON·입력 별칭·없는 폴더·쓸 수 없는 경로 | 기존 파일을 보존하고 새 이름/쓰기 가능한 폴더 지정 |
이 코드의 지원 입력은 Transitional OOXML 형식의 일반 .xlsx입니다. Strict OOXML의 workbook·worksheet 네임스페이스, 열기 암호로 암호화된 파일, .xls·.xlsm·.xlsb, 손상된 ZIP/XML은 이 실습 코드로 비교를 끝낼 수 없습니다. 파일 제공자에게 일반 .xlsx 사본을 요청하거나 알맞은 별도 도구로 확인하세요. 파일 확장자만 바꿔 지원 형식으로 꾸미지 마세요.
openpyxl이 지원하지 않는 확장 기능 경고를 내면 두 입력별 경고 원문이 JSON에 남고 결과는 보류됩니다. 경고가 나왔다는 이유로 코드를 바꾸어 원본을 다시 저장하지 마세요. warning_extension_copy.xlsx에는 지원하지 않는 확장 요소를 넣었습니다. 기본 규칙 네 필드가 같게 관측되더라도 inspection_incomplete로 남습니다.
이 도구는 작은 실습 파일을 위한 예제입니다. 일반 읽기 모드로 통합 문서를 메모리에 불러오며, 압축 해제 크기·파일 크기·메모리 상한은 구현하지 않았습니다. 대용량·출처 불명 파일은 실행 환경의 메모리와 보안 정책을 먼저 확인하세요. 외부 링크 대상이나 수식을 실행하거나 연결하지 않습니다.
6. 테스트와 전체 코드
python3 -m unittest discover -v첨부 자동 테스트 76개 메서드와 그 안의 최상위 assertion 헬퍼 호출 349회를 구분해 집계했으며, 최종 전체 실행에서 실패·오류·건너뛰기 없이 통과했습니다. 독립 검수에서는 별도로 만든 OOXML 입력을 이용한 55개 메서드·55회 비교 assertion을 확인했습니다. 실제 Excel에서 드롭다운을 펼치거나 잘못된 값을 입력한 시험은 수행하지 않았습니다. 같은 네 필드이지만 다른 속성인 반례와 범위 문자열만 다른 반례를 포함해, 결과를 과대 해석하지 않도록 확인했습니다.
compare_validation.py 전체 코드 펼치기
#!/usr/bin/env python3
"""Inspect stored list dataValidation fields in two .xlsx files. No Excel execution."""
from __future__ import annotations

import argparse
from collections import Counter
import hashlib
from io import BytesIO
import json
import os
from pathlib import Path
import platform
import posixpath
import sys
import warnings
from xml.etree import ElementTree
from zipfile import BadZipFile, ZipFile

import openpyxl
from openpyxl import load_workbook

FIELDS = ("type", "formula1", "formula2", "sqref")
SCOPE = {
    "supported_format": "unencrypted Transitional OOXML .xlsx; Strict/unknown workbook or declared worksheet namespaces refused",
    "rule_type_filter": "list",
    "selected_fields": list(FIELDS),
    "sheet_grouping": "exact worksheet names; worksheet-name membership also compared",
    "formula_comparison": "exact stored strings including whitespace; no evaluation or semantic equivalence",
    "sqref_normalization": "openpyxl-parsed standard range representation, then sort whitespace-separated tokens; no general merge/split equivalence",
    "sqref_parser_normalizations": ["absolute markers removed: $B$2:$B$6 -> B2:B6", "coordinate case normalized: b2:b6 -> B2:B6", "singleton repeated endpoint collapsed: B2:B2 -> B2", "duplicate sqref tokens removed: B2:B6 B2:B6 -> B2:B6"],
    "rule_collection_comparison": "sorted multiset; duplicate rule counts preserved",
    "excluded_attributes": ["showDropDown", "allowBlank", "errorStyle", "operator", "showErrorMessage", "showInputMessage", "error", "errorTitle", "prompt", "promptTitle", "imeMode", "all other dataValidation attributes"],
    "excluded_checks": ["raw XML byte equality", "non-list validation rules", "chartsheets", "actual Excel UI", "drop-down arrow visibility", "formula evaluation", "list-item evaluation", "invalid-input blocking", "conversion execution", "other workbook contents"],
    "actual_excel_execution": "NOT_RUN",
    "warning_policy": "preserve every load/parse warning per input; any such warning makes inspection partial",
    "input_policy": ".xlsx only; open input bytes for reading; never save either workbook",
}


class OutputRefusal(Exception):
    """The requested new JSON cannot be created safely."""


class UnsupportedOOXMLNamespace(Exception):
    """Prevent silent skips of unsupported workbook or worksheet content."""


def sha256_bytes(payload):
    return hashlib.sha256(payload).hexdigest()


def rule_sort_key(rule):
    return json.dumps(rule, ensure_ascii=False, sort_keys=True)


def validate_ooxml_namespaces(archive):
    """Gate workbook/declared worksheet namespaces; do not parse rules."""
    main_ns = "http://schemas.openxmlformats.org/spreadsheetml/2006/main"
    document_rel_ns = "http://schemas.openxmlformats.org/officeDocument/2006/relationships"
    types = ElementTree.fromstring(archive.read("[Content_Types].xml"))
    parts = [node.attrib.get("PartName", "").lstrip("/") for node in types
             if node.attrib.get("ContentType") == "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet.main+xml"]
    if len(parts) != 1:
        raise ValueError("Transitional .xlsx의 워크북 본문을 한 개 찾을 수 없습니다.")
    workbook_part = parts[0]
    workbook = ElementTree.fromstring(archive.read(workbook_part))
    if workbook.tag != f"{{{main_ns}}}workbook":
        raise UnsupportedOOXMLNamespace("워크북이 Transitional OOXML 네임스페이스가 아닙니다. Strict OOXML은 지원하지 않습니다.")
    declared_ids = set()
    for sheet in workbook.findall(f"{{{main_ns}}}sheets/{{{main_ns}}}sheet"):
        rid = sheet.attrib.get(f"{{{document_rel_ns}}}id")
        if rid is None:
            raise UnsupportedOOXMLNamespace("선언된 시트의 관계 네임스페이스가 지원되지 않거나 관계 ID가 없습니다.")
        declared_ids.add(rid)
    folder, filename = posixpath.split(workbook_part)
    rels_part = posixpath.join(folder, "_rels", filename + ".rels")
    relationships = ElementTree.fromstring(archive.read(rels_part))
    matched_ids = set()
    for relationship in relationships:
        rid = relationship.attrib.get("Id")
        if rid not in declared_ids:
            continue
        matched_ids.add(rid)
        kind = relationship.attrib.get("Type", "")
        if not kind.endswith("/worksheet"):
            continue
        if kind != document_rel_ns + "/worksheet":
            raise UnsupportedOOXMLNamespace("워크시트 관계가 Transitional OOXML 형식이 아닙니다.")
        if relationship.attrib.get("TargetMode") == "External":
            raise ValueError("외부 워크시트 본문은 지원하지 않습니다.")
        target = relationship.attrib.get("Target", "")
        part = target.lstrip("/") if target.startswith("/") else posixpath.normpath(posixpath.join(folder, target))
        worksheet = ElementTree.fromstring(archive.read(part))
        if worksheet.tag != f"{{{main_ns}}}worksheet":
            raise UnsupportedOOXMLNamespace("선언된 워크시트가 Transitional OOXML 네임스페이스가 아닙니다. Strict OOXML은 지원하지 않습니다.")
    if matched_ids != declared_ids:
        raise ValueError("선언된 시트의 본문 관계를 모두 찾을 수 없습니다.")


def inspect_workbook(path):
    """Read a byte snapshot and inspect the selected fields without saving input."""
    path = Path(path)
    result = {"path": str(path), "sha256_before": None, "sha256_after": None,
              "input_unchanged": None, "inspected": False, "partial_inspection": False,
              "warnings": [], "error": None, "list_rule_count": 0,
              "non_list_rule_count_skipped": 0, "worksheets": []}
    payload = None
    wb = None
    captured = []
    try:
        if path.suffix.lower() != ".xlsx":
            result["error"] = {"code": "unsupported_extension", "message": ".xlsx 파일만 지원합니다. .xls/.xlsm 및 다른 형식은 검사하지 않습니다."}
            return result
        payload = path.read_bytes()
        result["sha256_before"] = sha256_bytes(payload)
        if payload.startswith(bytes.fromhex("d0cf11e0a1b11ae1")):
            result["error"] = {"code": "encrypted_or_legacy_container", "message": "OLE 컨테이너입니다. 암호화 OOXML 또는 구형 Excel 형식일 수 있어 검사할 수 없습니다. 암호를 해제한 정상 .xlsx 사본을 준비하세요."}
        else:
            with ZipFile(BytesIO(payload)) as archive:
                if any(info.flag_bits & 1 for info in archive.infolist()):
                    raise ValueError("암호화된 ZIP 항목은 지원하지 않습니다.")
                types = archive.read("[Content_Types].xml")
                if b"macroEnabled" in types or b"vbaProject" in types:
                    raise ValueError("매크로 형식을 .xlsx로 바꾼 파일은 지원하지 않습니다.")
                validate_ooxml_namespaces(archive)
            with warnings.catch_warnings(record=True) as captured:
                warnings.simplefilter("always")
                # read_only=True does not expose this metadata reliably. The
                # normal parser reads a BytesIO snapshot; there is no save call.
                wb = load_workbook(BytesIO(payload), read_only=False, data_only=False, keep_links=False)
                for ws in sorted(wb.worksheets, key=lambda sheet: sheet.title):
                    selected = []
                    skipped = 0
                    for validation in ws.data_validations.dataValidation:
                        if validation.type != "list":
                            skipped += 1
                            continue
                        selected.append({"type": validation.type,
                                         "formula1": validation.formula1,
                                         "formula2": validation.formula2,
                                         "sqref": " ".join(sorted(str(validation.sqref).split()))})
                    selected.sort(key=rule_sort_key)
                    result["worksheets"].append({"sheet_name": ws.title,
                                                 "list_rules": selected,
                                                 "non_list_rule_count_skipped": skipped})
                    result["list_rule_count"] += len(selected)
                    result["non_list_rule_count_skipped"] += skipped
                result["inspected"] = True
    except UnsupportedOOXMLNamespace as exc:
        result["error"] = {"code": "unsupported_ooxml_namespace", "message": str(exc)}
    except OSError as exc:
        result["error"] = {"code": "input_read_error", "message": f"입력 파일을 읽을 수 없습니다: {exc}"}
    except Exception as exc:
        # Includes invalid ZIP, malformed OOXML/XML, unsupported workbook data,
        # and encrypted ZIP members. No errors are reclassified as equality.
        result["error"] = {"code": "invalid_or_unsupported_xlsx", "message": f"정상적으로 검사할 수 없는 .xlsx입니다 ({type(exc).__name__}): {exc}"}
    finally:
        if wb is not None:
            wb.close()
        result["warnings"] = [{"category": item.category.__name__, "message": str(item.message)} for item in captured]
        result["partial_inspection"] = bool(result["warnings"])
        if payload is not None:
            try:
                result["sha256_after"] = sha256_bytes(path.read_bytes())
                result["input_unchanged"] = result["sha256_before"] == result["sha256_after"]
                if not result["input_unchanged"]:
                    result["error"] = {"code": "input_changed_during_inspection", "message": "검사 중 입력 바이트가 달라졌습니다. 결과를 보존 여부 판정에 사용하지 마세요."}
            except OSError as exc:
                result["input_unchanged"] = False
                result["error"] = {"code": "input_changed_during_inspection", "message": f"검사 후 입력 SHA-256을 확인할 수 없습니다: {exc}"}
    return result


def counter_for(rules):
    return Counter(tuple(rule[field] for field in FIELDS) for rule in rules)


def counter_records(counter):
    records = [dict(zip(FIELDS, key), count=count) for key, count in counter.items()]
    return sorted(records, key=rule_sort_key)


def compare_snapshots(original, converted):
    left = {sheet["sheet_name"]: sheet for sheet in original["worksheets"]}
    right = {sheet["sheet_name"]: sheet for sheet in converted["worksheets"]}
    name_membership_equal = set(left) == set(right)
    equal = name_membership_equal
    sheets = []
    for name in sorted(set(left) | set(right)):
        a = counter_for(left.get(name, {}).get("list_rules", []))
        b = counter_for(right.get(name, {}).get("list_rules", []))
        this_equal = name in left and name in right and a == b
        equal = equal and this_equal
        sheets.append({"sheet_name": name, "original_present": name in left,
                       "converted_present": name in right,
                       "observed_selected_fields_equal": this_equal,
                       "missing_from_converted": counter_records(a - b),
                       "added_in_converted": counter_records(b - a)})
    return {"sheet_name_membership_equal": name_membership_equal,
            "observed_selected_fields_equal": equal, "sheets": sheets}


def input_paths_alias(original, converted):
    if original.resolve() == converted.resolve():
        return True
    try:
        return os.path.samefile(original, converted)
    except OSError:
        return False


def build_report(original_path, converted_path):
    original_path, converted_path = Path(original_path), Path(converted_path)
    original = inspect_workbook(original_path)
    converted = inspect_workbook(converted_path)
    errors = [{"input": role, **item["error"]} for role, item in (("original", original), ("converted", converted)) if item["error"]]
    if input_paths_alias(original_path, converted_path):
        errors.insert(0, {"input": "both", "code": "input_alias", "message": "원본과 변환 사본이 같은 파일 또는 같은 파일의 별칭입니다. 서로 다른 파일을 지정하세요."})
    partial = original["partial_inspection"] or converted["partial_inspection"]
    comparison = {"sheet_name_membership_equal": None, "observed_selected_fields_equal": None, "sheets": []}
    if not errors and original["inspected"] and converted["inspected"]:
        comparison = compare_snapshots(original, converted)
    if errors:
        status, exit_code = "inspection_error", 2
    elif partial:
        status, exit_code = "inspection_incomplete", 2
    elif comparison["observed_selected_fields_equal"]:
        status, exit_code = "selected_fields_equal", 0
    else:
        status, exit_code = "selected_fields_different", 1
    report = {"schema_version": "1.0", "status": status,
              "inspection_complete": not errors and not partial,
              "scope": SCOPE,
              "runtime": {"python": platform.python_version(), "openpyxl": openpyxl.__version__},
              "inputs": {"original": original, "converted": converted},
              "comparison": comparison, "errors": errors}
    return report, exit_code


def validate_new_output(path):
    path = Path(path)
    # lexists also detects dangling symlinks. Exclusive creation below repeats
    # this protection at write time, closing the exists/check-create race.
    if os.path.lexists(path):
        raise OutputRefusal(f"출력 경로가 이미 존재합니다. 덮어쓰지 않습니다: {path}")
    if path.suffix.lower() != ".json":
        raise OutputRefusal("출력 파일 이름은 .json으로 끝나야 합니다.")
    if not path.parent.is_dir():
        raise OutputRefusal(f"출력 폴더가 없거나 폴더가 아닙니다: {path.parent}")


def write_report_exclusive(path, report):
    """Create a new UTF-8 JSON only. Never replace an existing path."""
    path = Path(path)
    text = json.dumps(report, ensure_ascii=False, indent=2) + "\n"
    try:
        with path.open("x", encoding="utf-8", newline="\n") as handle:
            handle.write(text)
    except OSError as exc:
        raise OutputRefusal(f"출력 JSON을 새로 만들 수 없습니다. 폴더와 쓰기 권한을 확인하세요: {exc}") from exc


def main(argv=None):
    parser = argparse.ArgumentParser(description="두 .xlsx의 저장된 목록(type=list) 규칙 네 필드를 읽기 전용으로 비교합니다. 실제 Excel 동작 검사는 하지 않습니다.")
    parser.add_argument("original", type=Path, help="원본 .xlsx")
    parser.add_argument("converted", type=Path, help="변환된 사본 .xlsx")
    parser.add_argument("-o", "--output", required=True, type=Path, help="새로 만들 JSON 경로 (덮어쓰기 불가)")
    args = parser.parse_args(argv)
    try:
        validate_new_output(args.output)
        report, exit_code = build_report(args.original, args.converted)
        write_report_exclusive(args.output, report)
    except OutputRefusal as exc:
        print(f"출력 거부: {exc}", file=sys.stderr)
        return 3
    print(f"{report['status']} | JSON: {args.output}", file=sys.stderr)
    return exit_code


if __name__ == "__main__":
    raise SystemExit(main())
7. 확인 결과를 어떻게 쓸까요?
- 입력 두 파일과 실행 당시 SHA-256을 보관합니다.
- 경고·오류·시트 누락을 먼저 확인합니다.
- 누락·추가 규칙의 수식 문자열과 적용 범위를 대조합니다.
- 일치해도 화살표 표시, 허용 빈칸, 오류 알림 등 필요한 속성을 별도로 확인합니다.
- 마지막으로 사용할 Excel에서 목록 선택과 잘못된 값 입력을 직접 시험합니다.
실제 Excel에서 드롭다운을 설정하거나 붙여넣기 후 복구하는 방법은 Excel 데이터 유효성 검사 드롭다운 가이드에서 이어서 볼 수 있습니다. 이미 입력된 상품 코드 값의 오류를 찾는 작업과는 검사 대상이 다릅니다.
공식 자료와 검증 범위
openpyxl 데이터 유효성 검사 공식 문서는 규칙을 설정해도 openpyxl이 값을 평가하거나 강제하지 않는다고 설명합니다. 범위가 없는 규칙은 저장 때 무시되며, showDropDown=True는 Excel·LibreOffice에서 화살표를 숨기는 쪽으로 해석됩니다.
openpyxl 파일 불러오기 공식 안내를 함께 확인하세요. 이 글은 통합 문서를 메모리로 읽지만 save()를 호출하지 않습니다. 읽기 전용 작업이라는 표현은 입력 파일을 변경하지 않는다는 의미이며, openpyxl의 read_only=True 옵션을 사용했다는 의미는 아닙니다.
실제 제작·검증일은 2026년 10월 11일입니다. 글의 표시 게시일과 기술 실행 기록을 구분해 보관했습니다. 공식 stable 문서 페이지 표기는 3.1.3이며, 첨부 코드의 실제 검증 라이브러리는 openpyxl 3.1.5입니다.
작성자 소개
