음성으로 AI에 말할 때 제품 코드 오인식 잡기
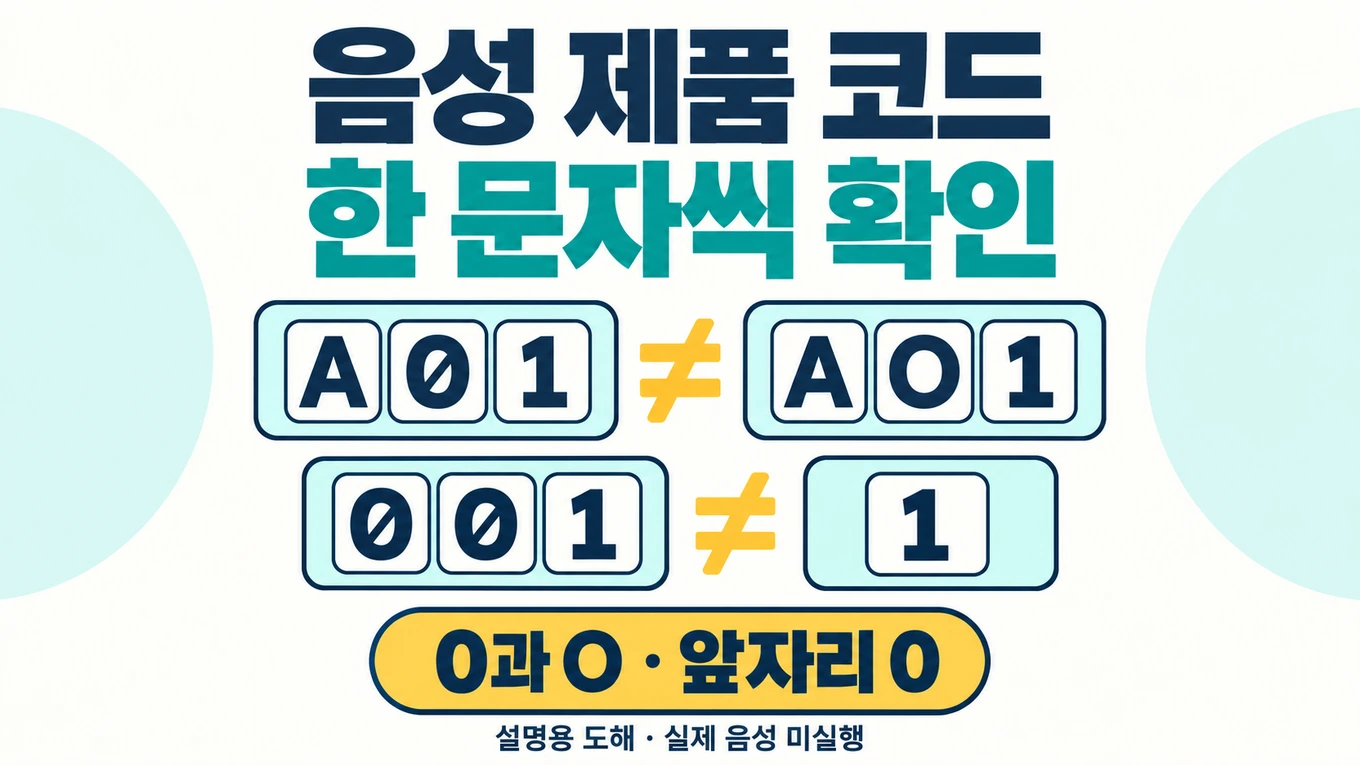
음성으로 제품 코드를 말한 뒤에는 보낼 텍스트의 코드를 원본과 한 문자씩 대조합니다. ‘에이 영 일’이라고 말하려던 코드가 A01인지 AO1인지, 영문 O인지 숫자 0인지 구분해야 합니다. 문장이 자연스럽게 전사됐다고 식별자까지 맞는 것은 아닙니다.
이번 글의 제품 코드, 발음 안내, 오류 전사는 모두 직접 만든 가상 자료입니다. 녹음하거나 음성 서비스에 요청한 결과가 아닙니다. 문자 비교와 복구 조건만 로컬 Python에서 실행했으며 실제 음성 인식 정확도나 제품별 오류율은 측정하지 않았습니다.
실시간 음성 대화와 보내기 전 받아쓰기를 나누기
ChatGPT Voice 공식 안내는 실시간 대화용 Voice와, 말을 프롬프트 텍스트로 바꾸는 voice dictation을 구분합니다. Prompting 안내는 받아쓴 텍스트를 입력창에서 검토하고 수정한 뒤 보낼 수 있다고 설명합니다.
제품 코드가 중요한 요청이라면 이 ‘전송 전 검토’ 지점을 활용합니다. 아래 순서는 사용할 앱에 그런 검토 화면이 있을 때의 확인 방법입니다. 현재 계정에서 음성 기능을 켜거나 마이크 권한을 부여하는 실습이 아닙니다.
- 말할 코드를 권한 있는 원본 목록에서 확인합니다
- 음성 입력 뒤 전사된 텍스트를 먼저 읽습니다
- 제품 코드의 문자와 자리 수를 원본과 비교합니다
- 틀린 부분을 원본에 근거해 직접 수정합니다
- 코드와 수량·단위를 다시 확인한 뒤 요청을 보냅니다
실시간 대화에서 이미 행동을 요청했다면 나중에 남는 전사만 고쳐도 그 행동이 되돌아간다고 볼 수 없습니다. 코드 확인이 필요한 단계에서는 실행·주문·전송을 멈추고, 정확한 코드가 확인될 때까지 검토 단계에 둡니다. 특히 구매 요청이라면 제품명·옵션·수량까지 별도로 확인해야 합니다.
원본으로 삼을 일곱 가상 제품 코드
이번 예제의 원본 목록은 아래 일곱 코드 전부입니다. 사용 문자는 대문자 ASCII 영문과 ASCII 숫자이며 공백은 없습니다. 001도 수량이 아니라 세 자리 문자열 식별자입니다. 이것은 실제 제조사의 코드 규칙을 대신하지 않습니다.
| 가상 코드 | 문자별로 구분해서 읽을 안내 | 원본 문자 세 자리 |
|---|---|---|
| A01 | 대문자 에이 / 숫자 영 / 숫자 일 | A, 0, 1 |
| B10 | 대문자 비 / 숫자 일 / 숫자 영 | B, 1, 0 |
| O08 | 대문자 오 / 숫자 영 / 숫자 팔 | O, 0, 8 |
| I11 | 대문자 아이 / 숫자 일 / 숫자 일 | I, 1, 1 |
| Z02 | 대문자 제트 / 숫자 영 / 숫자 이 | Z, 0, 2 |
| S05 | 대문자 에스 / 숫자 영 / 숫자 오 | S, 0, 5 |
| 001 | 숫자 영 / 숫자 영 / 숫자 일 | 0, 0, 1 |
이 발음 안내는 사람에게 문자를 설명하기 위한 표현입니다. 어떤 음성 인식기에서도 정확히 인식되는 발음법으로 검증한 것이 아닙니다. 길거나 중요한 코드는 음성으로 반복하기보다 원본을 직접 복사해 넣고 대조하는 편이 확인하기 쉽습니다.
O08의 첫 글자를 0으로 바꾸면 같은 숫자처럼 보이더라도 다른 코드입니다. I11의 I도 숫자 1이 아닙니다. 제품 목록에 우연히 두 문자열이 모두 존재하면 형식 검사만으로 잘못된 제품 선택을 찾기 어려우므로, 해당 제품의 원본 행과 제품명도 함께 봅니다.
의도적으로 만든 오류 전사 아홉 건
다음 전사 열은 오류를 설명하려고 직접 쓴 문자열입니다. 실제 마이크로 읽은 결과라고 기록하지 않습니다. V08은 비교기가 정상 문자열도 통과시키는지 확인할 대조 사례입니다.
| ID | 원본 코드 | 직접 만든 전사 | 먼저 확인할 문제 |
|---|---|---|---|
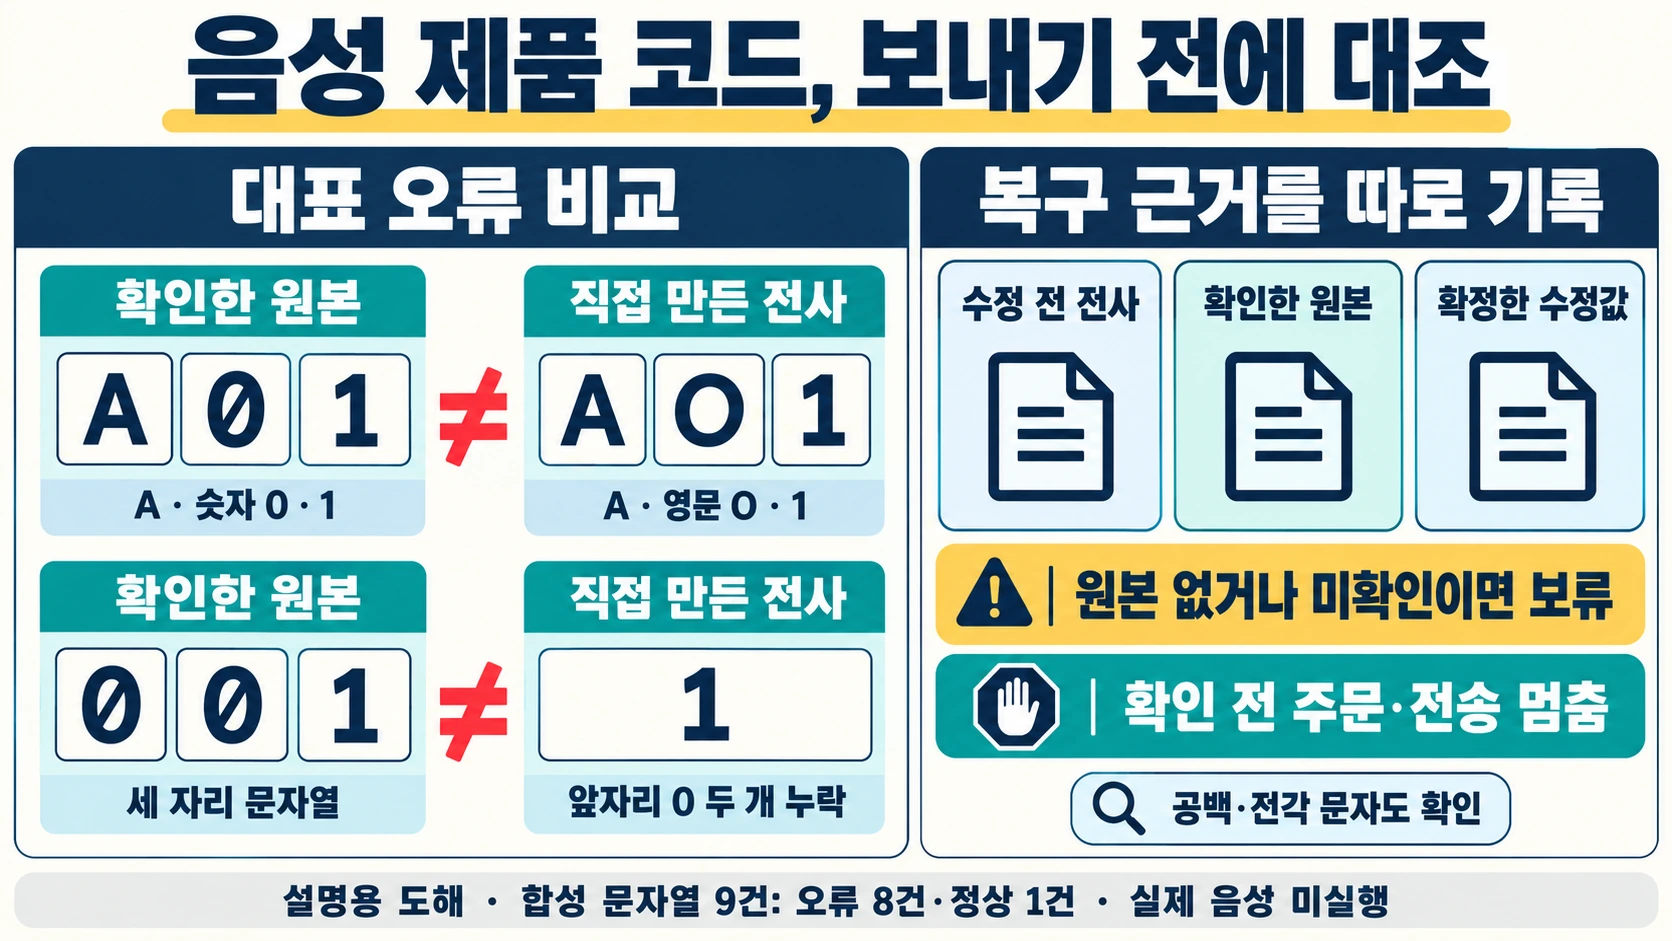
| V01 | A01 | AO1 | 두 번째 숫자 0이 영문 O로 바뀜 |
| V02 | B10 | BIO | 숫자 1·0이 영문 I·O로 바뀜 |
| V03 | O08 | 008 | 첫 번째 영문 O가 숫자 0으로 바뀜 |
| V04 | I11 | 111 | 첫 번째 영문 I가 숫자 1로 바뀜 |
| V05 | Z02 | ZO2 | 두 번째 숫자 0이 영문 O로 바뀜 |
| V06 | S05 | S 05 | 공백이 들어가 네 자리가 됨 |
| V07 | A01 | A01 | 세 문자가 모두 전각 문자로 바뀜 |
| V08 | B10 | B10 | 원본과 정확히 같음 |
| V09 | 001 | 1 | 앞자리 0 두 개가 빠져 세 자리 식별자가 한 자리로 바뀜 |
V07은 모양만 비교하면 놓칠 수 있습니다. 전각 A·0·1은 ASCII A·0·1과 다른 문자입니다. V06도 공백을 지워 정상처럼 만드는 대신 수정 전 문자열을 남깁니다. 원본과 다른 입력이 있었는지 기록해야 같은 문제를 다시 확인할 수 있습니다.
이번 비교는 각 자리의 정확한 문자 일치입니다. V06처럼 중간에 문자가 추가되면 뒤의 자리도 밀려 여러 차이가 표시됩니다. 이 목록은 최소 수정 횟수나 음성 인식기의 오류 원인을 계산한 것이 아닙니다. V09도 정수로 바꾸어 001과 1을 같은 값으로 처리하지 않습니다. 제품 코드에는 앞자리 0과 전체 자릿수가 포함되므로 원본 001을 확인한 뒤 세 문자 그대로 복구합니다.
원본을 모르는데 O를 전부 0으로 바꾸지 않기
O와 0을 일괄 치환하면 V01은 고쳐질 수 있지만 O08의 첫 글자까지 손상됩니다. I를 1로 바꾸는 규칙도 실제 영문 I를 포함한 코드를 훼손할 수 있습니다. ‘영문 하나와 숫자 두 개처럼 보인다’는 규칙은 정답 제품을 확인한 근거가 아닙니다.
복구는 다음 세 값으로 나눕니다.
- 수정 전 전사: 실제 확인한 문자열을 그대로 보관
- 확인한 원본: 제품 목록·라벨 등 권한 있는 자료에서 직접 확인
- 확정한 수정값: 원본과 일치하는지 사람이 다시 확인
원본이 없으면 A01이라고 추측하지 않습니다. 코드가 읽히지 않으면 확인 필요로 남기고 더 선명한 원본이나 담당자의 확인을 구합니다. AI에게 “틀린 코드를 알아서 고쳐 달라”고 부탁해 정상처럼 보이는 문자열을 얻는 것으로 끝내지 않습니다.
문자 대조와 복구 보류를 실행하는 전체 코드
아래 코드를 UTF-8로 저장하고 voice_code_check.py로 이름을 정합니다. Python 3의 표준 라이브러리만 사용합니다. 음성 파일·마이크·계정에 접근하지 않고 코드 문자열을 자동 정규화하지도 않습니다.
import json
from itertools import zip_longest

CASES = [
    ("V01", "A01", "AO1"),
    ("V02", "B10", "BIO"),
    ("V03", "O08", "008"),
    ("V04", "I11", "111"),
    ("V05", "Z02", "ZO2"),
    ("V06", "S05", "S 05"),
    ("V07", "A01", "A01"),
    ("V08", "B10", "B10"),
    ("V09", "001", "1"),
]

def compare(reference, transcription):
    differences = []
    for position, (expected, actual) in enumerate(
            zip_longest(reference, transcription, fillvalue=None), 1):
        if expected != actual:
            differences.append({"position": position,
                                "expected": expected, "actual": actual})
    return differences

def repair(raw, reference, proposed, approved):
    if reference is None or not approved:
        return raw, "hold"
    if proposed != reference:
        raise ValueError("proposal differs from confirmed reference")
    return proposed, "confirmed"

mismatches = []
for case_id, reference, raw in CASES:
    differences = compare(reference, raw)
    if differences:
        mismatches.append(case_id)
    if case_id == "V01":
        assert differences == [{"position": 2, "expected": "0", "actual": "O"}]
    if case_id == "V07":
        assert len(differences) == 3
assert mismatches == ["V01", "V02", "V03", "V04", "V05", "V06", "V07", "V09"]
assert repair("AO1", "A01", "A01", False) == ("AO1", "hold")
assert repair("AO1", None, "A01", True) == ("AO1", "hold")
assert repair("AO1", "A01", "A01", True) == ("A01", "confirmed")
assert repair("1", "001", "001", True) == ("001", "confirmed")
assert compare("001", "1") and len("001") != len("1")
try:
    repair("AO1", "A01", "O01", True)
except ValueError:
    rejected = 1
else:
    raise AssertionError("unconfirmed code was accepted")
print(json.dumps({"comparison_cases": len(CASES),
                  "mismatch_ids": mismatches,
                  "unchanged_without_basis_or_approval": 2,
                  "confirmed_repairs": 2,
                  "wrong_proposals_rejected": rejected,
                  "actual_audio_requests": 0, "result": "PASS"}, ensure_ascii=False))
python voice_code_check.py를 실행한 출력은 다음과 같습니다.
{"comparison_cases": 9, "mismatch_ids": ["V01", "V02", "V03", "V04", "V05", "V06", "V07", "V09"], "unchanged_without_basis_or_approval": 2, "confirmed_repairs": 2, "wrong_proposals_rejected": 1, "actual_audio_requests": 0, "result": "PASS"}아홉 문자열 중 의도한 오류 여덟 건이 표시되고 정상 V08은 차이가 없었습니다. 원본이 없거나 확인하지 않은 복구 두 건은 원문을 유지하며 hold로 남았습니다. 원본이 확인되고 수정값도 일치한 A01·001 두 건만 confirmed가 되었고, 원본 A01과 다른 O01 제안은 거부했습니다.
코드의 approved는 가상 검사에서 사람이 확인했다는 입력값입니다. 실제 앱에서 확인을 받았다는 기록이 아니며 주문이나 외부 요청을 승인하는 기능도 없습니다. 실무 기록에서는 누가 무엇을 확인했는지 별도로 남깁니다.
문자 위치와 원본 근거를 남기는 기록
기록 ID:
확인 날짜와 사용한 입력 방식:
코드를 확인한 원본 이름·버전·위치:
말하려던 제품 코드:
발음 안내와 문자 구분:
수정 전 전사 문자열:
문자 위치별 차이:
다시 확인한 원본 코드:
직접 수정한 문자열:
보류한 부분과 이유:
최종 코드 확인자·확인 시각:
전송 전 코드와 수량·단위 재확인:
실제 음성 시험 여부: 미실행 / 실행
V01의 완성 예는 ‘원본 A01, 수정 전 AO1, 2번 자리 원본 숫자 0/전사 영문 O, 원본 목록 v1과 대조, 수정값 A01’입니다. 이 글에서는 실제 음성을 시험하지 않았으므로 그 칸은 미실행으로 기록합니다. 발음 안내를 써 놓았다고 실제 발음을 들었다는 증거로 삼지 않습니다.
제품 코드가 맞았더라도 뒤의 ‘2개’가 ‘20개’로 전사되면 요청은 여전히 잘못됩니다. 마지막 검토에서는 식별자와 수량·단위를 한 요청의 묶음으로 봅니다. 녹음·전사 원문에 다른 사람의 개인정보나 업무상 비밀이 들어 있다면 전체 내용을 불필요하게 공유하지 않습니다.
보내기 전 검토용 요청 예
아래는 가상 자료만 넣은 미전송 요청 예입니다. 제품 코드를 고치는 작업과 주문을 실행하는 작업을 분리합니다.
다음은 직접 만든 전사 오류 연습입니다.
원본 제품 목록: A01, B10, O08, I11, Z02, S05, 001
확인 대상 원본: A01
수정 전 전사: AO1

원본과 전사의 다른 문자 위치를 표시해 주세요.
영문 O와 숫자 0을 구분해 설명하고 원본은 바꾸지 마세요.
코드를 자동 치환하지 말고, 사람이 확인할 수정 후보를 별도로 적어 주세요.
원본을 확인할 수 없는 경우에는 추측하지 말고 보류해 주세요.
제품 조회·주문·외부 전송은 하지 마세요.
기대 확인은 2번 자리의 차이와 원본 A01입니다. 실제 AI 응답을 얻은 예가 아닙니다. 자신의 제품 목록에 적용할 때는 지금 전달할 코드가 어느 원본 행에서 나온 것인지 확인한 뒤 필요한 범위만 제공합니다.
공식 안내 확인과 로컬 문자열 검사 날짜는 2026년 10월 4일 KST이며, 실행 환경은 Linux의 Python 3.12.14입니다. 결과는 직접 만든 아홉 문자열과 복구 조건에 한정합니다. 특정 기기·언어·소음 환경에서의 음성 인식 성능을 보장하지 않습니다.
제품 코드가 아닌 문장 전체의 숫자·이름 변경을 확인하려면 AI 문장 교정 뒤 숫자와 고유명사 대조 안내를 함께 확인하세요.
작성자 소개
