처리 중인 CSV가 완성본처럼 보이지 않게 저장하기: Python 임시 파일·검산 실습
CSV를 만드는 프로그램이 다섯 행 가운데 세 행만 저장하고 멈췄다고 가정해 보겠습니다. 파일 이름이 이미 result.csv라면 폴더를 보는 사람이나 다음 자동화 작업은 이것을 완성된 결과로 받아들일 수 있습니다. 파일이 있다는 사실만으로 처리가 끝났다고 판단할 때 생기는 문제입니다.
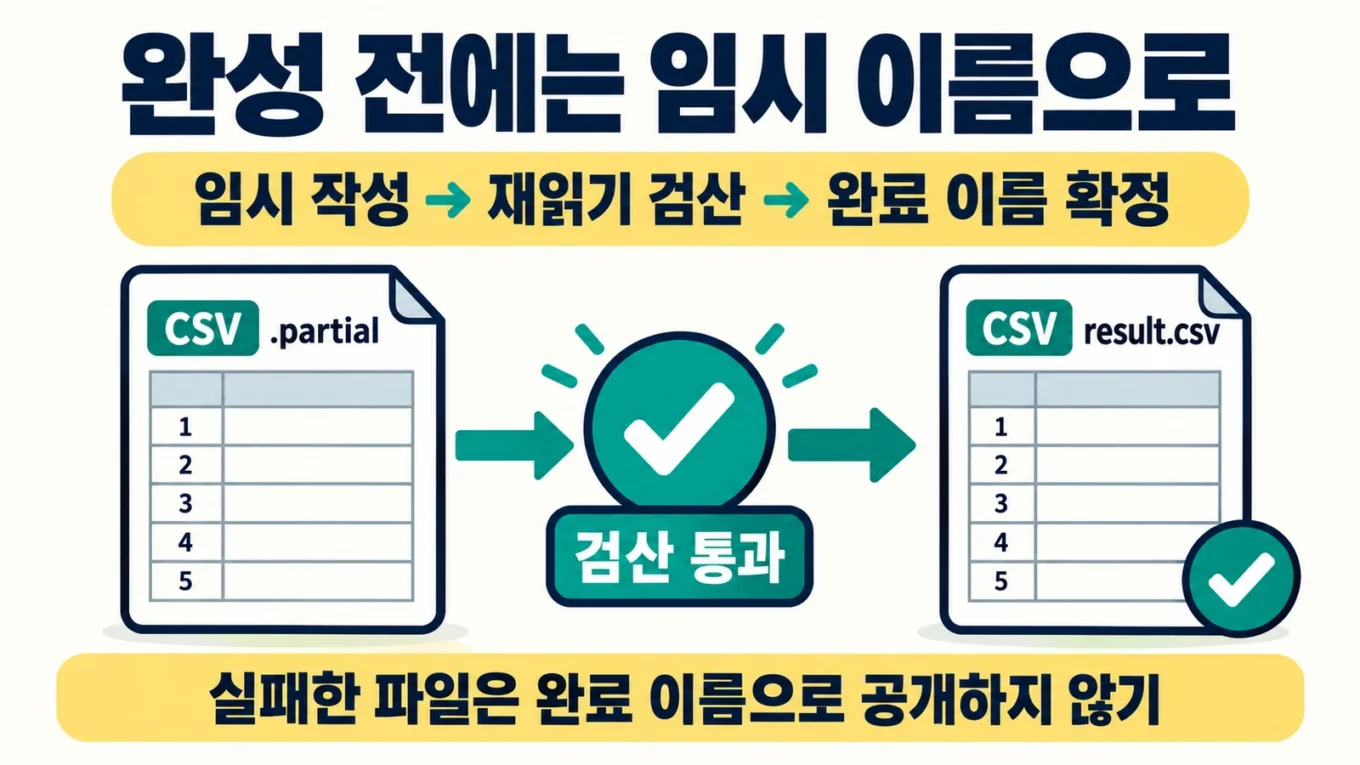
이번 실습에서는 기록 중인 파일과 검산을 통과한 결과에 서로 다른 이름을 사용합니다. 먼저 고유한 .partial 파일에 CSV를 쓰고, 닫은 파일을 다시 읽어 행과 값을 대조합니다. 모든 검사가 끝난 뒤에만 새 완료 이름을 만듭니다. 같은 이름의 결과가 있으면 덮어쓰지 않고 멈춥니다.
가상의 판매 자료 다섯 행으로 정상 완료, 세 행 뒤 강제 실패, 기존 결과 충돌을 비교합니다. 실제 업무 자료나 운영 폴더는 사용하지 않습니다. 이 글의 목표는 파일을 만드는 쪽에서 완료 이름이 나타나는 시점을 관리하는 것입니다.
1. 최종 이름에 바로 쓰면 언제부터 완성본처럼 보일까
아래처럼 최종 이름을 먼저 열면 CSV 전체를 쓰기 전부터 그 경로가 만들어집니다.
# 저장 순서를 설명하는 반례입니다. 실행용 완성 코드는 아래에 있습니다.
with open("result.csv", "w", encoding="utf-8", newline="") as file:
    writer = csv.writer(file)
    writer.writerow(["item_id", "item", "quantity", "unit_price", "line_total"])
    for row in calculated_rows:
        writer.writerow(row)
프로그램이 중간에 멈추면 헤더와 일부 행만 들어 있는 result.csv가 남을 수 있습니다. 기존 result.csv가 있었다면 w 모드로 여는 순간 내용이 잘립니다. 파일 열기 모드의 의미는 Python open 공식 문서에서 확인할 수 있습니다.
x 모드로 최종 파일을 새로 만들면 기존 파일을 덮어쓰는 문제는 막을 수 있습니다. 다만 최종 이름이 기록 시작 시점에 나타나는 순서는 그대로입니다. 그래서 이번 실습은 쓰기 모드뿐 아니라 작업파일을 완성본으로 공개하는 순서도 바꿉니다.
읽는 쪽의 규칙도 함께 정해야 합니다. 후속 작업이 폴더 안 모든 파일을 읽거나 .partial까지 가져가면 임시 이름을 나누는 효과가 줄어듭니다. 다음 작업은 약속한 완료 경로만 읽도록 합니다. 파일 탐색기에서 이름을 구분하는 것은 접근권한을 제한하는 기능과도 다릅니다.
2. 이번 실습의 저장 규칙을 먼저 정하기
실습 프로그램은 다음 순서로 움직입니다.
- 입력 형식과 값, 출력 경로를 확인합니다. 기존 완료 경로가 있으면 일찍 멈춥니다.
- 최종 파일의 부모 폴더에 실행마다 다른
.partial파일을 새로 만듭니다. - 계산한 행을 작업파일에 쓰고 파일을 닫습니다.
- 작업파일을 다시 열어 헤더, 행 수, 모든 셀이 예상 결과와 같은지 검사합니다.
- 검산이 끝난 파일에
os.link()로 새 완료 이름을 붙입니다. 그 이름이 이미 있으면 거부됩니다. - 성공한 실행이 직접 만든 임시 이름만 지웁니다.
tempfile.mkstemp()는 이름만 미리 구하는 함수가 아닙니다. 임시 파일을 실제로 만들고 열린 파일 디스크립터와 경로를 돌려줍니다. 이번 코드는 dir에 최종 파일의 부모 폴더를 지정합니다. 시스템 기본 임시 폴더에 만들었다가 다른 드라이브로 옮기는 흐름을 피하려는 선택입니다. 임시 파일 정리는 호출한 코드의 책임입니다. Python mkstemp 공식 문서
작업파일 이름의 임의 문자열은 실행마다 달라집니다. 따라서 예제 화면의 이름을 그대로 입력하지 말고, 자신의 실행 메시지에 나온 경로를 확인하세요. 실패한 작업파일은 원인을 살펴볼 자료로 남깁니다. 다음 실행은 남은 파일에 이어 쓰지 않고 새 작업파일을 만듭니다.
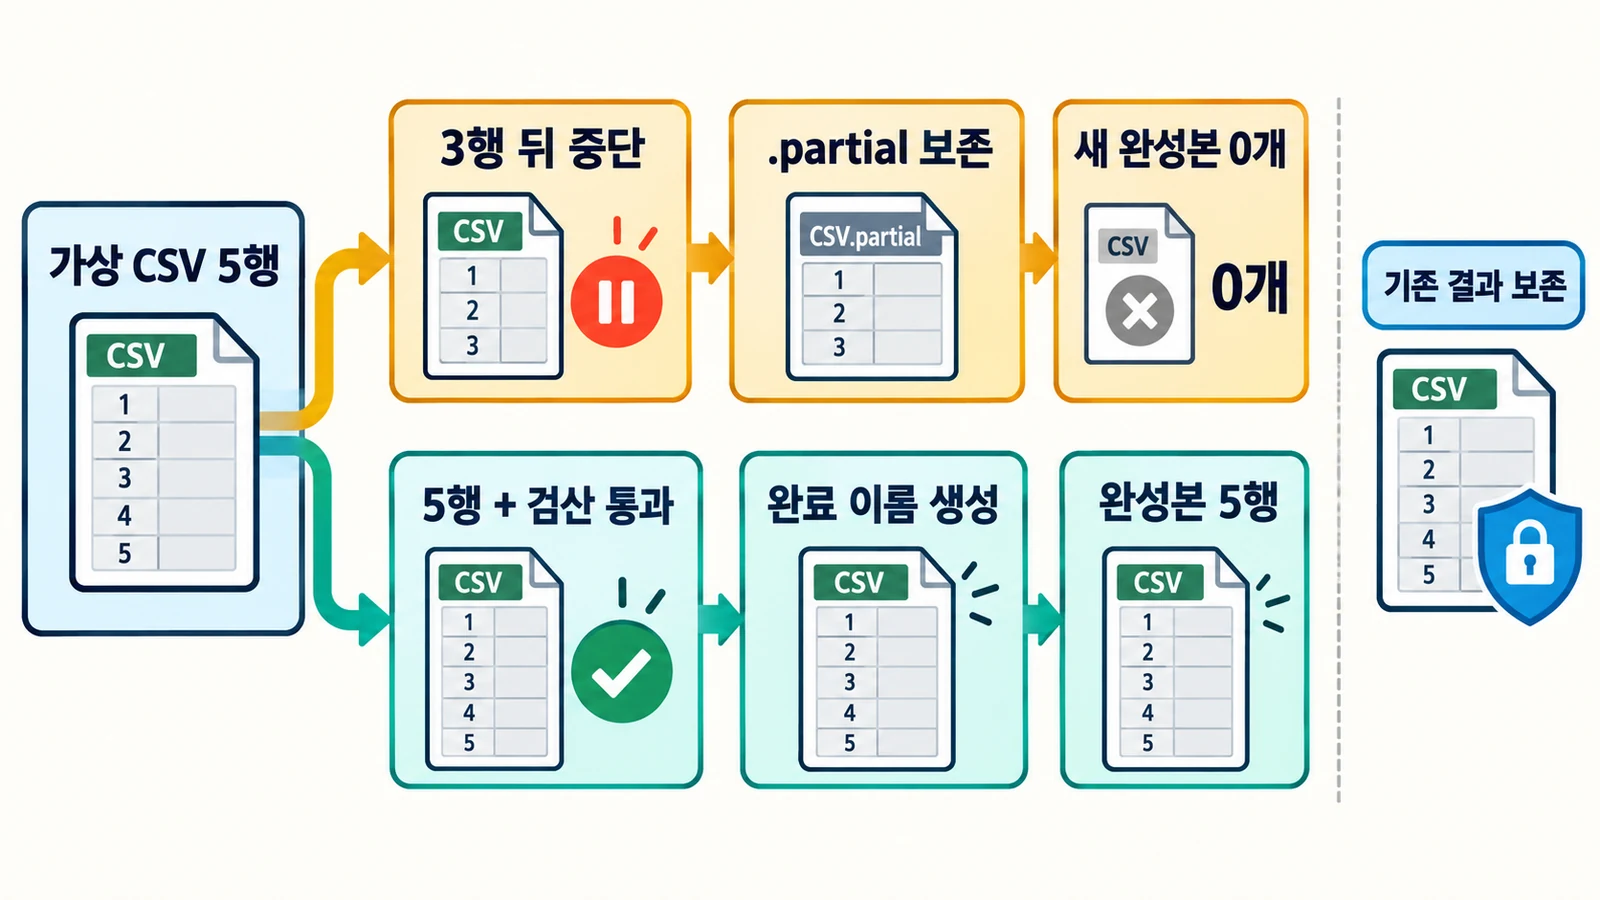
그림의 자물쇠는 기존 이름을 덮어쓰지 않는 규칙을 나타냅니다. 실제 파일 잠금이나 보안 설정을 구현한다는 뜻은 아닙니다.
여기서 os.link()는 CSV를 복사하는 함수가 아닙니다. 작업파일의 같은 데이터에 새 이름을 추가합니다. 완료 이름을 만드는 호출이 성공하는 시점을 이 실습의 공개 지점으로 삼습니다. 그 뒤 임시 이름을 없애도 완료 이름으로는 같은 데이터를 읽을 수 있습니다. 두 이름이 잠시 함께 존재한다는 점은 뒤의 오류 복구에서도 중요합니다.
3. 가상 입력과 검산 기준 준비하기
실습 ZIP 내려받기에서 자료를 받아 새 빈 로컬 연습 폴더에 직접 풉니다. 회사 공유 폴더, 동기화 폴더, 실제 판매 자료가 있는 폴더는 사용하지 마세요. README.md가 있는 폴더에서 터미널을 엽니다.
p40_staged_csv_practice/
  README.md
  staged_csv_cli.py
  staged_csv_core.py
  MANIFEST.sha256
  verification.json
  fixtures/
    orders_5.csv
    expected_result.csv
    invalid_amount.csv
    invalid_schema.csv
  tests/
    test_staged_csv.py
  evidence/
    demo_verification.json
    rename_counterexample.json
    tests_final.txt
    tests_python313.txt
ZIP에는 위의 14개 파일이 들어 있습니다. MANIFEST.sha256는 배포 파일의 바이트를 대조하는 목록이며, 실행 결과 검산과는 별도로 사용합니다.
필요한 것은 Python 3.12와 표준 라이브러리입니다. 별도 패키지 설치나 API 키가 없습니다. 명령의 python은 자신의 Python 3.12 실행 명령으로 바꿀 수 있습니다. Windows에서 py -3.12를 사용하는 경우에는 명령 앞부분만 바꾸세요. Windows 실제 실행은 이 글에서 검증하지 않았습니다.
fixtures/orders_5.csv의 전체 내용입니다. 다섯 건은 모두 가상 자료입니다. 수량은 양의 정수, 단가는 소수 둘째 자리까지 있는 음수 아닌 문자열로 제한합니다. 금액의 통화 단위는 따로 정하지 않은 연습용 숫자입니다.
item_id,item,quantity,unit_price
A001,노트,2,12.50
A002,펜,3,8.20
A003,키보드,1,99.99
A004,클립,4,0.75
A005,파일,2,15.00
결과의 line_total은 quantity × unit_price입니다. 계산 중에는 단가를 100배 한 정수로 다루고, 저장할 때 다시 소수 둘째 자리 문자열로 바꿉니다. 예를 들어 12.50은 정수 1250으로 계산합니다. 부동소수점 float로 합계를 구하지 않습니다. 아래 값은 실행하기 전에 정해 둔 기준입니다. 성공 메시지에서 나온 숫자를 나중에 기준으로 삼으면 잘못된 결과가 자기 자신과 일치하는 상황을 놓치기 쉽습니다.
item_id,item,quantity,unit_price,line_total
A001,노트,2,12.50,25.00
A002,펜,3,8.20,24.60
A003,키보드,1,99.99,99.99
A004,클립,4,0.75,3.00
A005,파일,2,15.00,30.00
- 데이터 행 수: 5행. 헤더는 데이터 행 수에 포함하지 않습니다.
- 수량 합계: 12
- 금액 합계: 182.59
합계만 같다고 모든 행이 올바른 것은 아닙니다. 두 행의 값이 서로 바뀌거나 한 행의 오차가 다른 행의 오차와 상쇄될 수 있습니다. 이 프로그램은 각 행의 순서와 값도 예상 결과와 대조합니다. 합계는 사람이 읽기 쉬운 추가 검산 기준으로 사용합니다.
입력의 크기와 행 수에도 상한이 있습니다. 최대 1 MiB(1,048,576바이트), 데이터 1~1,000행, 행당 수량 1~1,000, 단가 0.00~1,000,000.00, 전체 금액 1,000,000,000.00 이하로 제한합니다. 상품 ID 중복과 헤더 순서가 다른 입력도 거부합니다. 실습은 작은 CSV를 메모리에 읽어 예상 결과를 고정하는 방식입니다. 대용량 파일용 처리기를 구현한 예제는 아니며, 실행 중 원본이나 작업 폴더를 다른 프로그램이 바꾸지 않는 조건에서 사용합니다.
4. 세 행 뒤 멈춰 보고 남은 파일 확인하기
먼저 아직 없는 이름 output_fail/result.csv으로 실패를 재현합니다. 출력 폴더는 미리 있어야 하므로 아래 첫 명령으로 만듭니다. 이미 같은 폴더가 있다면 기존 내용을 지우지 말고 새 빈 연습 폴더에서 시작하세요.
python -c "from pathlib import Path; Path('output_fail').mkdir()"
python staged_csv_cli.py fixtures/orders_5.csv output_fail/result.csv --fail-after 3
--fail-after 3은 오류를 우연히 기다리는 대신 세 번째 데이터 행을 쓴 뒤 의도적으로 중단하는 실습 옵션입니다. 실제 업무 코드에 이 옵션을 사용할 이유는 없습니다.
아래는 실제 실행에서 경로 앞부분만 ...로 줄인 JSON 예시입니다. 임시 이름의 임의 문자열은 실행마다 달라집니다.
{"final": "output_fail/result.csv", "message": "injected failure", "published": false, "rows_written": 3, "stage": ".../output_fail/.result.csv.f0nppcat.partial", "status": "intentional_failure"}
이 실행의 종료 코드는 3입니다. 출력된 임시 경로에는 헤더와 데이터 세 행이 남습니다. 이때 output_fail/result.csv은 만들어지지 않아야 합니다. 이는 다른 실행이 없는 새 연습 폴더에서 확인하는 실패 시나리오의 기준입니다.
파일 목록과 임시 CSV 내용을 확인하는 명령은 다음과 같습니다.
python -c "import csv; from pathlib import Path; d=Path('output_fail'); p=next(d.glob('*.partial')); f=p.open(encoding='utf-8-sig',newline=''); rows=list(csv.reader(f)); f.close(); print('final=',(d/'result.csv').exists(),'data_rows=',len(rows)-1)"
final= False data_rows= 3
위 명령은 방금 만든 새 폴더의 임시 파일 하나를 읽습니다. 종료 코드 확인은 Linux·macOS 셸에서 echo $?, PowerShell에서 $LASTEXITCODE, cmd에서 echo %ERRORLEVEL%입니다. 확인 명령이 아니라 생성 명령 직후 실행하세요.
이 관찰에서 확인할 것은 “오류 메시지가 나왔는가”뿐이 아닙니다. 완료 경로가 없는지, 실패한 실행의 임시 파일이 따로 남았는지, 그 안에 몇 행이 들어 있는지를 함께 봅니다. 일부 행이 기록된 CSV라도 최종 이름을 받기 전에는 완성본으로 취급하지 않습니다.
실패한 임시 파일의 확장자를 .csv로 바꿔 결과로 넘기지 마세요. 남아 있는 세 행을 메모장이나 읽기 전용 도구로 살펴볼 수는 있지만, 다섯 행을 대상으로 한 검산을 통과한 자료는 아닙니다. 재실행할 때는 원본에서 다시 계산합니다.
5. 정상 완료와 기존 결과 충돌 비교하기
이번에는 강제 실패 옵션 없이 새 이름으로 실행합니다.
python -c "from pathlib import Path; Path('output_ok').mkdir()"
python staged_csv_cli.py fixtures/orders_5.csv output_ok/result.csv
완료 경로의 앞부분을 줄이면 다음과 같습니다.
{"cleanup_warning": null, "final": ".../output_ok/result.csv", "published": true, "rows": 5, "stage": null, "status": "success", "total": "182.59"}
성공 보고의 종료 코드 0, 데이터 5행, 금액 합계 182.59을 확인합니다. 수량 합계 12은 이어지는 재열기 점검에서 별도로 계산합니다. 프로그램은 작업파일을 닫고 다시 읽어 검사한 뒤에 완료 이름을 만듭니다. 이번 정상 실행이 만든 임시 이름은 제거됩니다. 앞 단계에서 일부러 남긴 실패 작업파일까지 지우지는 않습니다.
완료 CSV도 실제로 열어 확인합니다. 이 실습은 utf-8-sig 인코딩을 사용합니다. 읽을 때 UTF-8 BOM이 있으면 처리하고, 출력에는 BOM을 기록합니다. CSV 입출력에는 newline=""와 인코딩을 명시합니다. 줄바꿈 처리는 csv 모듈에 맡기고, 운영체제별 기본 인코딩에 기대지 않기 위한 설정입니다. Python csv 공식 문서
python -c "import csv; from decimal import Decimal; from pathlib import Path; f=Path('output_ok/result.csv').open(encoding='utf-8-sig',newline=''); rows=list(csv.DictReader(f)); f.close(); print('data_rows=',len(rows),'quantity_total=',sum(int(r['quantity']) for r in rows),'amount_total=',sum(Decimal(r['line_total']) for r in rows))"
data_rows= 5 quantity_total= 12 amount_total= 182.59
이 점검은 저장된 line_total을 Decimal로 읽어 합산합니다. 핵심 저장 함수의 검산은 예상 CSV의 모든 셀과 실제 파일을 대조하고, 여기서는 그 결과를 별도로 다시 읽어 수량·금액 합계까지 확인합니다.
같은 정상 완료 명령을 한 번 더 실행하면 어떻게 될까요? output_ok/result.csv이 이미 있으므로 종료 코드 4로 멈춥니다. 이번 예제는 기존 결과를 갱신하는 프로그램이 아닙니다. 결과를 비교해야 한다면 result_v2.csv처럼 아직 없는 새 이름을 지정합니다.
{"final": "output_ok/result.csv", "message": "final name already exists", "published": false, "rows_written": 0, "stage": null, "status": "collision"}
published: false는 이번 실행이 새 완료 이름을 공개하지 않았다는 뜻입니다. 다른 실행이나 이전 실행의 완료 파일까지 없다는 의미는 아닙니다.
처음의 존재 여부 검사는 불필요한 계산을 줄여 주는 빠른 검사입니다. 두 실행이 거의 동시에 시작하면 둘 다 처음에는 “없음”을 볼 수 있습니다. 그래서 공개 순간에도 os.link()의 새 이름 생성으로 충돌을 거부합니다. 실습 테스트에서는 두 별도 프로세스가 같은 완료 이름을 두고 실제로 경쟁하게 하여 한 실행만 완료 이름을 얻는지 확인했습니다. 실제 로컬 Linux 시험에서 승자 하나와 충돌한 실행 하나, 남은 작업파일 하나를 확인했습니다. 네트워크 저장소의 동작을 대신 검증한 결과는 아닙니다.
이름을 얻지 못한 실행은 기존 완료 파일을 건드리지 않고 자기 작업파일을 보존합니다. 그 작업파일은 기록과 검산을 마쳤을 수도 있지만, 약속한 완료 경로의 결과로 공개되지는 않았습니다. 파일 이름과 종료 상태를 함께 확인해야 합니다.
상태별 종료 코드는 0(공개 성공), 2(입력 오류), 3(의도한 중단), 4(이름 충돌), 5(재열기 검산 오류), 6(기록·공개 I/O 오류)입니다. 공개 뒤 임시 이름 정리 실패는 종료 코드 0과 success_with_stage_alias 경고로 보고합니다. 아래 복구 설명처럼 이미 생긴 완료 이름과 남은 별칭을 함께 확인합니다.
6. 실행 코드와 저장 코드 전체 보기
명령줄 처리·입력 검증·금액 계산은 staged_csv_cli.py, CSV 기록·재열기 검산·공개는 staged_csv_core.py에 나누었습니다. 아래는 첨부 파일의 전체 코드입니다. 일부 함수나 예외 처리만 생략한 발췌본이 아니므로, 직접 입력하려면 두 파일을 같은 폴더에 저장하세요. 다운로드 파일을 그대로 사용하면 복사 중 들여쓰기나 문자 변형을 피할 수 있습니다.
staged_csv_cli.py
"""P40 bounded synthetic CSV exercise, Python 3.12+, standard library only."""
import argparse
import csv
import io
import json
import os
from pathlib import Path
import re
import stat
import sys

from staged_csv_core import PublishError, publish_csv

MAX_INPUT_BYTES = 1_048_576
MAX_ROWS = 1_000
MAX_QUANTITY = 1_000
MAX_PRICE_CENTS = 100_000_000       # 1,000,000.00
MAX_TOTAL_CENTS = 100_000_000_000   # 1,000,000,000.00
INPUT_HEADER = ["item_id", "item", "quantity", "unit_price"]
OUTPUT_HEADER = INPUT_HEADER + ["line_total"]


class JsonParser(argparse.ArgumentParser):
    def error(self, message):
        raise ValueError(message)


def money(cents):
    return f"{cents // 100}.{cents % 100:02d}"


def bounded_rows(source):
    """Read at most 1 MiB + 1 byte, then strictly validate a small CSV snapshot."""
    if not stat.S_ISREG(source.stat().st_mode):
        raise ValueError("input must be a regular file")
    with source.open("rb") as stream:
        raw = stream.read(MAX_INPUT_BYTES + 1)
    if len(raw) > MAX_INPUT_BYTES:
        raise ValueError("input exceeds 1 MiB")
    text = raw.decode("utf-8-sig", errors="strict")
    reader = csv.reader(io.StringIO(text, newline=""), strict=True)
    if next(reader, None) != INPUT_HEADER:
        raise ValueError("header must be item_id,item,quantity,unit_price in that order")
    result, seen, total = [], set(), 0
    for number, row in enumerate(reader, 1):
        if number > MAX_ROWS:
            raise ValueError("input exceeds 1000 data rows")
        if len(row) != 4:
            raise ValueError(f"row {number}: exactly four fields required")
        item_id, item, quantity, price = row
        if not re.fullmatch(r"[A-Z][A-Z0-9]{0,15}", item_id) or item_id in seen:
            raise ValueError(f"row {number}: invalid or duplicate item_id")
        # Synthetic teaching schema deliberately forbids formulas/control chars.
        if not re.fullmatch(r"[A-Za-z가-힣0-9 _]{1,40}", item) or not item.strip():
            raise ValueError(f"row {number}: invalid item text")
        if not re.fullmatch(r"[1-9][0-9]{0,3}", quantity):
            raise ValueError(f"row {number}: quantity must be canonical positive integer")
        count = int(quantity)
        if count > MAX_QUANTITY:
            raise ValueError(f"row {number}: quantity exceeds 1000")
        if not re.fullmatch(r"(?:0|[1-9][0-9]{0,6})\.[0-9]{2}", price):
            raise ValueError(f"row {number}: price requires nonnegative two-decimal text")
        whole, fraction = price.split(".")
        cents = int(whole) * 100 + int(fraction)
        if cents > MAX_PRICE_CENTS:
            raise ValueError(f"row {number}: price exceeds 1000000.00")
        line_cents = count * cents
        total += line_cents
        if total > MAX_TOTAL_CENTS:
            raise ValueError("total exceeds 1000000000.00")
        seen.add(item_id)
        result.append([item_id, item, str(count), money(cents), money(line_cents)])
    if not result:
        raise ValueError("at least one data row required")
    return result, total


def checked_paths(source_argument, final_argument):
    """Refuse input/output alias and preserve any pre-existing output entry."""
    source = Path(source_argument).resolve(strict=True)
    target = Path(final_argument).absolute()
    if target.name in ("", ".", "..") or target.suffix.lower() != ".csv":
        raise ValueError("final name must end in .csv")
    parent = target.parent.resolve(strict=True)
    if not parent.is_dir():
        raise ValueError("output parent must be an existing directory")
    final = parent / target.name
    if final == source:
        raise ValueError("input/output alias refused")
    if os.path.lexists(final):
        try:
            alias = os.path.samefile(source, final)
        except OSError:  # dangling/looping/unreadable links are still collisions
            alias = False
        if alias:
            raise ValueError("input/output hardlink alias refused")
        raise PublishError("collision", "final name already exists", 4)
    return source, final


def main(argv=None):
    parser = JsonParser(description=__doc__)
    parser.add_argument("input_csv")
    parser.add_argument("final_csv")
    parser.add_argument("--fail-after", metavar="N", help="inject failure after N data rows")
    final_argument = None
    try:
        args = parser.parse_args(argv)
        final_argument = args.final_csv
        source, final = checked_paths(args.input_csv, args.final_csv)
        rows, total = bounded_rows(source)
        fail_after = None
        if args.fail_after is not None:
            if not re.fullmatch(r"[1-9][0-9]{0,3}", args.fail_after):
                raise ValueError("--fail-after requires a positive integer within row count")
            fail_after = int(args.fail_after)
            if fail_after > len(rows):
                raise ValueError("--fail-after exceeds data row count")
        report = publish_csv(final, OUTPUT_HEADER, rows, fail_after=fail_after)
        report["total"] = money(total)
        code = 0  # success_with_stage_alias is published success plus cleanup warning
    except PublishError as exc:
        report = {"status": exc.status, "published": False, "final": final_argument,
                  "stage": str(exc.stage) if exc.stage is not None else None,
                  "rows_written": exc.rows_written, "message": str(exc)}
        code = exc.exit_code
    except (OSError, csv.Error, UnicodeError, ValueError, RuntimeError) as exc:
        report = {"status": "input_error", "published": False, "final": final_argument,
                  "stage": None, "rows_written": 0, "message": str(exc)}
        code = 2
    print(json.dumps(report, ensure_ascii=False, sort_keys=True))
    return code


if __name__ == "__main__":
    sys.exit(main())
staged_csv_core.py
"""Small teaching core: validated rows, trusted isolated local output folder.

Visibility is atomic at os.link, with no overwrite. This is not a power-loss
transaction or a defense against hostile directory/path replacement.
"""
import csv
import os
from pathlib import Path
import tempfile


class PublishError(Exception):
    def __init__(self, status, message, exit_code, stage=None, rows_written=0):
        super().__init__(message)
        self.status, self.exit_code = status, exit_code
        self.stage, self.rows_written = stage, rows_written


def validate_stage(stage, header, rows):
    """Reopen the CLOSED stage and compare every cell and the complete row count."""
    with Path(stage).open("r", encoding="utf-8-sig", newline="") as stream:
        actual = list(csv.reader(stream, strict=True))
    expected = [list(header)] + [list(row) for row in rows]
    if actual != expected:
        raise ValueError("reopened stage differs from expected header/rows/values")


def publish_csv(final, header, rows, *, fail_after=None):
    """Publish already-validated bounded string rows; never overwrite final.

    On precommit failure, keep the unique .partial as evidence. After commit,
    unlink ONLY our stage name. A failed cleanup leaves a MUTABLE HARDLINK ALIAS.
    Never write through either name after commit. Use a trusted output folder.
    """
    final = Path(final).absolute()
    header = tuple(header)
    rows = tuple(tuple(row) for row in rows)
    if fail_after is not None and not 1 <= fail_after <= len(rows):
        raise PublishError("input_error", "fail_after must be within row count", 2)
    if os.path.lexists(final):  # also catches directories and dangling symlinks
        raise PublishError("collision", "final name already exists", 4)
    stage, written, phase = None, 0, "create_stage"
    try:
        fd, name = tempfile.mkstemp(
            prefix=f".{final.name}.", suffix=".partial", dir=final.parent)
        stage = Path(name)
        phase = "write"
        with os.fdopen(fd, "w", encoding="utf-8-sig", newline="") as stream:
            writer = csv.writer(stream, lineterminator="\n")
            writer.writerow(header)
            for row in rows:
                writer.writerow(row)
                written += 1
                if written == fail_after:
                    raise PublishError("intentional_failure", "injected failure", 3,
                                       stage, written)
        # with has flushed/closed the writer before validation or publication.
        phase = "validate"
        validate_stage(stage, header, rows)
        phase = "publish"
        os.link(stage, final)  # exclusive new name; existing destination is kept
    except PublishError:
        raise
    except (OSError, csv.Error, UnicodeError, ValueError, NotImplementedError) as exc:
        if phase == "publish" and isinstance(exc, FileExistsError):
            status, code = "collision", 4
        elif phase == "validate":
            status, code = "validation_error", 5
        else:
            status, code = "io_error", 6
        raise PublishError(status, f"{phase}: {exc}", code, stage, written) from exc
    # os.link returned: final is already published. Cleanup cannot undo that.
    result = {"status": "success", "published": True, "final": str(final),
              "stage": None, "rows": written, "cleanup_warning": None}
    try:
        os.unlink(stage)  # exact self-created name; no glob or foreign deletion
    except OSError as exc:
        result.update(status="success_with_stage_alias", stage=str(stage),
                      cleanup_warning=f"{exc}; do not edit the retained hardlink alias")
    return result
코드를 읽을 때는 다음 연결을 따라가면 됩니다.
- 입력 읽기: 필요한 열과 정수 값을 확인하고 예상 결과를 만듭니다. 입력 오류가 있으면 완료 결과를 만들지 않습니다.
- 임시 기록:
mkstemp()로 만든 열린 파일에 쓰므로, 만들어 둔 이름을 다시 열어 기존 파일을 덮어쓰는 순서를 사용하지 않습니다. - 재열기 검산: 쓰기를 끝낸 실제 파일에서 읽은 값과 앞서 계산한 기대값을 비교합니다.
- 완료 공개: 검산을 통과한 작업파일에 새 완료 이름을 추가합니다. 충돌이나 링크 오류를 일반 복사로 대신 처리하지 않습니다.
- 정리: 완료 이름 생성이 성공한 뒤에만 자신의 임시 이름을 제거합니다. 실패 자료를 일괄 삭제하지 않습니다.
합성 입력을 대상으로 한 검산은 이 프로그램이 정한 계산 규칙을 확인하는 과정입니다. 단가나 수량 자체가 업무적으로 맞는지, 원본 자료가 빠짐없이 수집됐는지까지 확인해 주지는 않습니다. 실제 업무에 적용할 때는 원본의 승인 상태와 계산 규칙을 별도로 정해야 합니다.
7. 이름만 바꾸면 덮어쓰기를 막을 수 있을까
작업파일을 쓴 다음 rename으로 옮기는 방식은 널리 사용됩니다. 그러나 새 이름이 이미 있을 때 어떻게 처리되는지를 따져야 합니다. 다음 코드는 이 글의 덮어쓰기 금지 규칙을 충족하지 못하는 반례입니다.
# 사용하지 않는 반례: 검사와 이름 변경 사이에 다른 실행이 끼어들 수 있습니다.
if not final.exists():
    os.rename(partial, final)
exists()와 rename()은 서로 다른 호출입니다. 첫 실행이 존재 여부를 확인한 직후 다른 실행이 final을 만들 수 있습니다. 이처럼 검사 시점과 사용 시점 사이에 상태가 달라지는 문제를 TOCTOU라고 부릅니다. 처음에 검사했다는 사실만으로 나중의 덮어쓰기를 막을 수는 없습니다.
Unix에서 원본과 대상이 모두 파일이고 권한이 있으면 os.rename()은 기존 대상 파일을 조용히 교체할 수 있습니다. Windows에서는 대상이 존재하면 FileExistsError가 발생합니다. os.replace()는 대상 파일을 교체하는 용도이므로 이 실습의 금지 규칙에 맞지 않습니다. 이름 변경이 원자적으로 이루어진다는 설명과 기존 파일을 덮어쓰지 않는다는 조건은 따로 읽어야 합니다. Python rename과 replace 공식 문서
첨부 테스트는 이 간격을 로컬 가상 파일로 재현합니다. 빈 상태를 확인한 다음 “다른 실행이 만든 기존 결과”를 생성하고 rename()을 호출합니다. Linux에서 대상 내용이 바뀌는 것을 확인하는 반례이며, 사용자의 기존 결과를 대상으로 실행하지 않습니다. 존재 검사와 이름 변경 사이에 경쟁자 파일 생성을 의도적으로 끼워 넣은 결정적 재현이며, 앞의 실제 두 프로세스 동시 경합 시험과 구분합니다.
이 글에서는 os.link(partial, final)로 없는 완료 이름 하나를 새로 만드는 호출을 선택했습니다. Linux link(2) 문서는 대상 이름이 있으면 덮어쓰지 않으며 EEXIST 오류가 난다고 설명합니다. 생성된 두 이름은 같은 파일을 가리킵니다. 하드링크를 지원하는 같은 파일시스템에서 사용해야 하며 권한 때문에 실패할 수도 있습니다. Linux man-pages link 공식 문서
따라서 “임시 파일에 다 쓴 후 최종 이름을 만든다”와 “기존 최종 파일은 보존한다”는 두 규칙을 함께 지킵니다. 최종 이름으로 복사하다가 멈출 수 있는 대체 경로는 넣지 않습니다. 링크 생성이 안 되는 환경에서는 조건을 확인하고 중단합니다.
8. 실패 후 복구와 이 방식의 한계
복구할 때는 먼저 완료 이름을 만들기 전의 실패인지, 만든 뒤 정리 단계의 문제인지를 구분합니다.
완료 이름이 만들어지기 전에 멈춘 경우
입력 오류, 세 행 강제 실패, 검산 불일치, 링크 생성 거부 등이 해당합니다. 로그의 임시 경로와 원인을 확인하고, 원본을 보존한 채 새 완료 이름으로 다시 실행하세요. 임시 파일이 남았다는 사실은 다음 실행이 이어 쓸 위치를 뜻하지 않습니다. 실패 자료를 계속 둘지 지울지는 확인한 사람이 결정합니다.
기존 완료 이름과 충돌했다면 그 결과가 누구의 실행에서 만들어졌는지 먼저 확인합니다. 덮어쓰기를 허용하는 함수로 바꾸거나 기존 결과를 지워서 통과시키는 식으로 처리하지 마세요. 새 이름을 사용하면 이전 결과와 다시 만든 결과를 나란히 비교할 수 있습니다.
완료 이름을 만든 뒤 임시 이름 정리에 실패한 경우
링크 생성은 성공했는데 임시 이름을 지울 권한이 없거나 그 사이 실행이 끊기면, 완료 이름과 .partial 이름이 함께 남을 수 있습니다. 두 이름은 같은 데이터를 가리키므로 남은 임시 이름으로 내용을 수정하면 완료 CSV도 바뀔 수 있습니다. 정리 경고를 확인하고 어느 이름이 완료 결과인지 기록하세요. 잔여 파일을 독립된 사본처럼 편집하지 않습니다.
이번 코드는 정상적인 정리 실패를 경고로 구분합니다. 강제 종료나 전원 차단처럼 코드가 더 실행되지 못하는 상황에서는 경고를 출력할 기회 자체가 없을 수 있습니다. 종료 코드만 보고 모든 정리 단계가 끝났다고 추측하지 말고 파일 상태도 확인합니다.
환경과 보장 범위 확인하기
- 실제 실행 검증은 Python 3.12.14의 로컬 Linux 연습 폴더에서 했습니다. Windows, macOS, NAS와 클라우드 동기화 폴더는 실제 검증 범위에 포함하지 않습니다.
- Windows에서도 Python은
os.link()를 제공하지만 파일시스템, 권한, 사용 중인 파일과 앱의 잠금 방식에 따라 동작이 달라질 수 있습니다. 완료 이름을 만들기 전에 파일을 닫고, 사용 환경에서 실패·충돌 테스트를 따로 해 보세요. 실패하면 복사나 덮어쓰기로 우회하지 않습니다. - 같은 부모 폴더에 임시 파일을 만드는 것은 파일시스템 경계를 넘지 않기 위한 구성입니다. 하드링크 지원과 쓰기·링크·정리 권한은 별도로 필요합니다.
- 공개할 이름 하나를 만드는 동작과 그 뒤 임시 이름을 없애는 동작은 두 단계입니다. 전체 과정이 하나의 트랜잭션이 되는 것은 아닙니다.
- 완료 이름을 만들었다고 그 파일이 이후 수정 불가능해지지는 않습니다. 후속 프로그램과 사람이 완료 CSV를 덮어쓰거나 편집하지 않는 규칙도 필요합니다.
- 이 예제는 파일과 디렉터리의
fsync()를 수행하지 않습니다. 전원 차단 뒤 데이터와 새 이름이 디스크에 남는 내구성을 보장하지 않습니다.fsync()하나를 추가했다고 모든 운영체제·스토리지에서 정전 안전성이 완성됐다고 표현할 수도 없습니다. Python fsync 공식 문서 - 네트워크 공유의 실패 응답과 캐시 동작을 로컬 Linux 시험으로 보장하지 않습니다. Linux
link(2)문서에는 NFS 서버가 링크를 만든 뒤 응답 전에 중단되면 반환값이 실제 생성 상태와 다를 수 있다는 주의가 있습니다. 중요한 배포에는 해당 저장소의 지원 조건과 확인 절차가 필요합니다.
또한 이 코드는 사용자가 관리하는 격리된 연습 폴더를 전제로 합니다. 읽기와 검산, 공개 사이에 누군가 경로를 바꾸거나 파일을 수정하는 공격을 방어하는 보안 도구로 소개하지 않습니다. 작업 중 입력을 바꾸지 말고, 여러 프로그램이 동일 폴더를 수정하는 운영 환경에 그대로 적용하지 마세요.
9. 내 자동화에 적용하기 전에 확인할 것
핵심 규칙은 완료 이름이 만들어지기 전에 기록과 검산을 끝내는 것입니다. 작은 CSV라면 예상 행과 실제 저장 행을 직접 비교하는 방식으로 시작할 수 있습니다. 완료 여부를 파일 존재 하나로만 판단하던 코드라면, 쓰는 쪽과 읽는 쪽의 이름 규칙부터 맞춰 보세요.
- 아직 없는 새 출력 이름으로 정상 완료를 실행하고 행 수·각 값·합계를 확인합니다.
- 중간 실패를 재현해 완료 이름이 생기지 않는지 확인합니다.
- 같은 이름의 결과를 둔 상태에서 재실행하고 기존 내용이 보존되는지 확인합니다.
- 동시 실행을 허용한다면 마지막 공개 단계의 충돌도 시험합니다.
- 임시 이름 정리 실패와 실제 사용 환경의 파일 잠금·권한 제한을 점검합니다.
- 저장소가 바뀌면 하드링크 지원과 내구성 요구를 다시 확인합니다.
첨부에는 정상 입력과 오류 입력, 기대 CSV, 실행 코드, 테스트, 실제 검증 기록, 파일 목록과 SHA-256이 들어 있습니다. 표준 라이브러리 unittest의 27개 테스트가 통과했으며, 본문의 생성·실패·재열기 점검·충돌 명령도 별도의 새 가상 연습 폴더에서 실행했습니다. 링크 미지원, 파일시스템 경계(EXDEV), 권한 오류와 임시 이름 정리 실패는 오류 주입으로 확인한 항목입니다. 해당 파일시스템이나 Windows를 실제 사용해 통과했다는 뜻은 아닙니다. 검증일은 2026년 10월 10일 한국 시간입니다. 실행 버전 Python 3.12.14와 별개로, 공식 자료는 확인 당시의 Python 3.12.15 문서를 기준으로 읽었습니다. 해당 Python 문서에는 2026년 10월 1일 15:25 UTC에 갱신됐다고 표시돼 있습니다.
함께 읽을 글
- 여러 엑셀 파일을 pandas로 합치고 결과를 검산하는 방법: 합친 자료의 내용과 결과를 확인하는 실습입니다.
- AI가 만든 파일을 내려받았을 때 이름과 내용 확인하기: 내려받는 쪽에서 파일을 점검하는 방법입니다.
- 필요한 실습 파일만 ZIP에 넣고 내용 목록을 검산하기: 배포 ZIP에 넣을 파일을 정하고 내부 목록을 대조합니다. 이번 CSV 실습은 처리 도중 멈췄을 때 완료 이름이 어떻게 보이는지에 초점을 둡니다.
공식 자료
- Python tempfile 문서: 임시 파일 생성과 정리 책임
- Python os 문서: 하드링크와 이름 변경 함수
- Python csv 문서: CSV 입출력과 줄바꿈
- Python open 문서: 파일 열기 모드
- Linux man-pages link(2): 새 이름의 충돌, 파일시스템 조건과 네트워크 환경 주의. 확인한 판은 Linux man-pages 6.19이며 문서 날짜는 2026년 2월 11일입니다.
작성자 소개
