필요한 실습 파일만 ZIP에 넣고 내용 목록을 검산하기
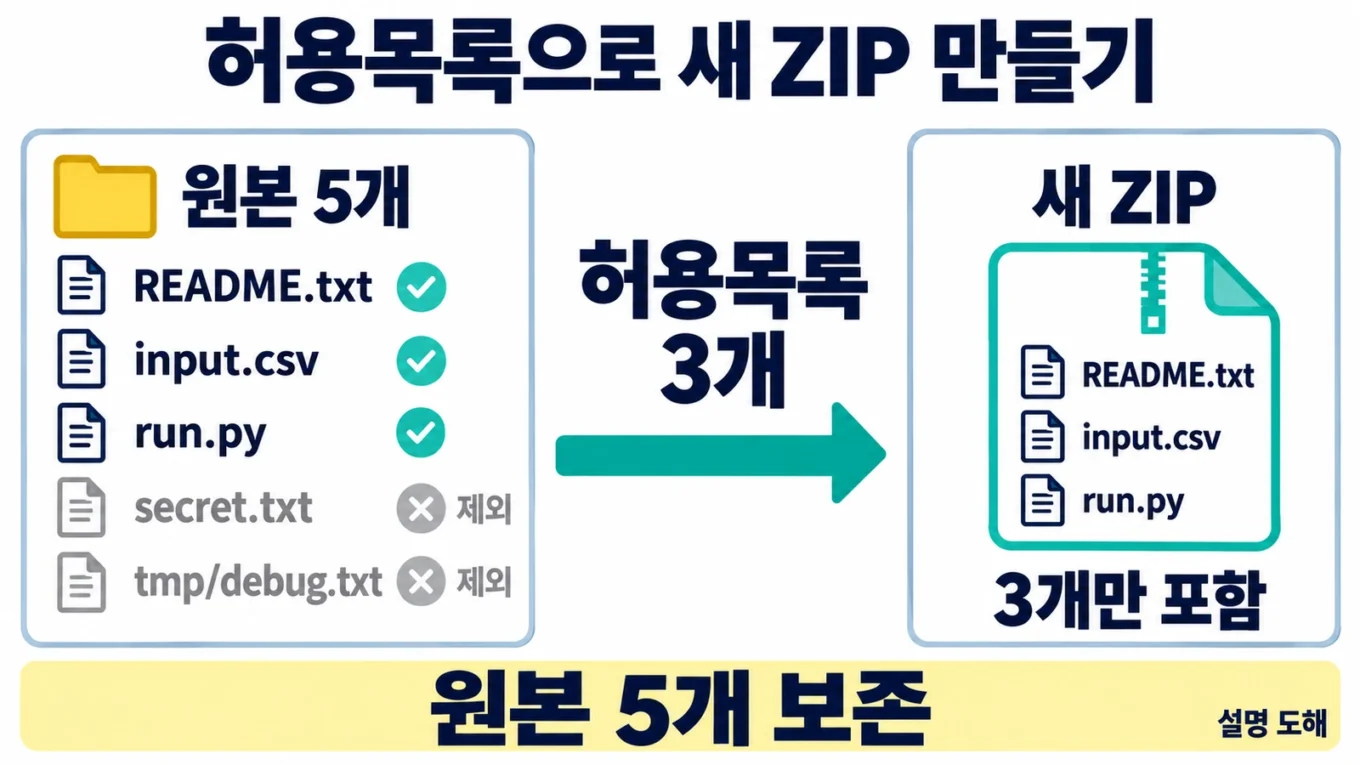
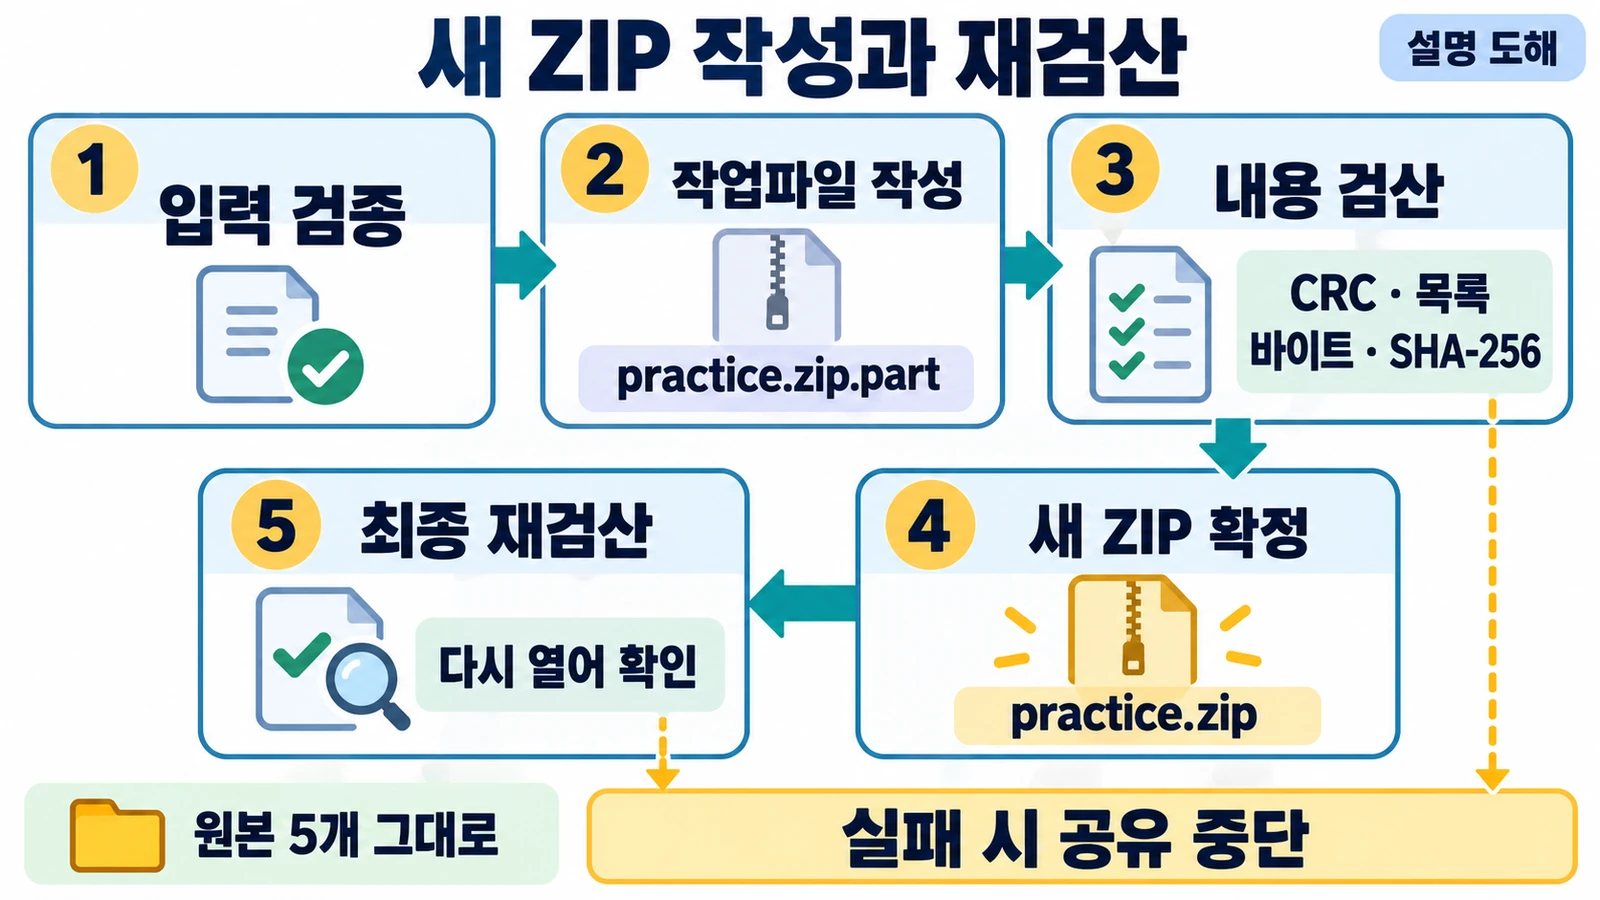
실습 자료를 보낼 때는 넣을 파일을 먼저 적고 그 목록으로 새 ZIP을 만드세요. 같은 폴더의 메모와 임시 파일이 함께 들어가지 않도록, 이 예제는 allowlist.json에 적은 세 파일만 읽습니다. 입력 검증을 마친 뒤 작업파일을 쓰고, 재열기 검산을 통과했을 때만 practice.zip이라는 새 완성본을 확정합니다.
가상 원본에는 다섯 파일이 있지만 결과 ZIP에는 README.txt, input.csv, run.py만 있어야 합니다. secret.txt와 tmp/debug.txt는 제외됩니다. 원본 파일을 이동하거나 지우지 않고, 원본 폴더 전체를 자동으로 압축하지 않습니다.
넣을 세 파일을 먼저 고정하기
다운로드한 실습 자료를 새 빈 연습 폴더에 직접 풀고 README.txt가 있는 폴더에서 시작하세요. 자기 소유의 로컬 연습 사본만 사용합니다. 실제 업무 폴더나 동기화 폴더를 --source로 지정하지 마세요.
source/
  README.txt        허용
  input.csv         허용
  run.py            허용
  secret.txt        제외
  tmp/debug.txt     제외
allowlist.json
pack_allowlist.py
allowlist.json의 전체 내용은 다음과 같습니다. ZIP 안 이름은 원본 폴더를 기준으로 한 상대경로입니다. 순서도 이 실습의 기준에 포함됩니다.
[
  "README.txt",
  "input.csv",
  "run.py"
]
source/README.txt는 다음 두 줄입니다.
Synthetic practice package.
Read input.csv; run.py is an optional local example.
source/input.csv는 헤더와 데이터 두 행으로 구성됩니다.
item,qty
A100,3
B200,2
source/run.py는 선택적으로 읽어 볼 수 있는 작은 예제입니다. ZIP 작성 프로그램은 이 코드를 실행하지 않습니다.
"""Optional synthetic example; no network or file writes."""
import csv
from pathlib import Path

with (Path(__file__).parent / "input.csv").open(encoding="utf-8", newline="") as f:
    print(sum(int(row["qty"]) for row in csv.DictReader(f)))
secret.txt에는 “This is a fictional excluded sentence, not a real secret.”, tmp/debug.txt에는 가상 디버그 문장을 넣었습니다. 실제 비밀이나 업무 기록은 없습니다. 파일은 UTF-8과 LF 줄바꿈으로 제공하며 마지막 줄바꿈도 바이트 비교에 포함됩니다. 같은 문장이라도 줄바꿈을 바꾸어 저장하면 해시가 달라질 수 있습니다.
입력을 모두 확인한 뒤 작업파일 만들기
코드는 이름에 .., 절대경로, 드라이브, 역슬래시, . 또는 빈 경로 구성요소가 있으면 중단합니다. 완전히 같은 이름과 대소문자를 접었을 때 같은 이름도 거부합니다. 예를 들어 README.txt와 readme.txt, Data/a.txt와 data/b.txt를 동시에 넣지 않습니다. 이는 이 실습에서 정한 배포 경로 규칙입니다.
각 경로 구성요소에서 CON, PRN, AUX, NUL, COM1부터 COM9, LPT1부터 LPT9도 거부합니다. COM¹, COM², COM³, LPT¹, LPT², LPT³와 그 이름 뒤의 확장자 역시 포함합니다. Microsoft는 위 첨자 숫자도 예약 장치 이름으로 설명합니다. 이 검사는 모든 Windows 경로 해석을 재현하는 기능은 아닙니다. Windows 파일 이름 규칙
입력은 일반 파일만 허용합니다. 파일 자체뿐 아니라 원본·상위 폴더·허용목록·출력 상위 폴더의 심볼릭 링크와 junction/reparse point도 거부합니다. Path.lstat()는 링크 대상 대신 링크 자체의 정보를 읽습니다. Path.is_junction()은 Python 3.12에 추가됐으며 junction은 Windows에서 지원합니다. pathlib lstat 문서, junction 문서
stat.S_ISREG()로 일반 파일 형식을 확인하고 열린 파일의 상태와 읽은 바이트 수도 대조합니다. 디렉터리·FIFO·장치 파일을 실습 입력으로 읽지 않습니다. stat 일반 파일 검사 문서
허용 입력은 최대 16개, 파일당 1,048,576바이트, 합계 2,097,152바이트입니다. 허용목록 JSON은 16,384바이트 이하여야 합니다. 모든 이름 검사와 파일 읽기가 끝나기 전에는 출력 폴더나 작업파일을 만들지 않습니다. 출력의 부모 폴더도 이미 있어야 합니다.
작업파일은 원본 밖의 practice.zip.part입니다. open("xb")로 배타적으로 만들어 기존 경로를 차단합니다. 열린 작업파일 객체를 ZipFile(..., "x")에 넘겨 ZIP을 새로 작성합니다. x는 새 파일 전용 모드입니다. 읽어 둔 바이트를 writestr()로 넣고 ZIP을 닫은 다음 다시 엽니다. 파일 열기 모드 문서, ZipFile 모드 문서, writestr 문서
ZIP을 직접 작성하는 전체 코드
다음은 첨부의 pack_allowlist.py 전체입니다. 별도 라이브러리 설치나 API 키는 필요 없습니다. 원본 파일을 읽고 새 ZIP을 쓰는 표준 라이브러리 예제입니다.
"""Allowlist-only ZIP for a controlled practice folder; never extract or upload."""
import argparse
import hashlib
import json
import os
import stat
import sys
import zipfile
from pathlib import Path, PureWindowsPath

MAX_FILES = 16
MAX_FILE_BYTES = 1_048_576
MAX_TOTAL_BYTES = 2_097_152
MAX_LIST_BYTES = 16_384


def validate_names(items):
    if not isinstance(items, list) or not 1 <= len(items) <= MAX_FILES:
        raise ValueError("allowlist must contain 1..16 names")
    seen, prefixes = set(), {}
    reserved = {"CON", "PRN", "AUX", "NUL"}
    reserved |= {f"{prefix}{i}" for prefix in ("COM", "LPT") for i in range(1, 10)}
    reserved |= {f"{prefix}{i}" for prefix in ("COM", "LPT") for i in "¹²³"}
    for name in items:
        if (not isinstance(name, str) or not name or len(name) > 240
                or name.startswith("/") or "\\" in name or ":" in name
                or PureWindowsPath(name).drive or any(ord(c) < 32 for c in name)):
            raise ValueError("invalid relative ZIP member name")
        parts = name.split("/")
        if any(not x or x in (".", "..") or x.endswith((".", " "))
               or any(c in x for c in '<>"|?*')
               or x.split(".")[0].upper() in reserved for x in parts):
            raise ValueError("invalid ZIP path component")
        key = name.casefold()
        if key in seen:
            raise ValueError("duplicate or casefold collision")
        seen.add(key)
        for i in range(1, len(parts) + 1):
            prefix = "/".join(parts[:i])
            old = prefixes.setdefault(prefix.casefold(), prefix)
            if old != prefix:
                raise ValueError("casefold collision in parent components")
    for name in items:
        if any("/".join(name.split("/")[:i]).casefold() in seen
               for i in range(1, len(name.split("/")))):
            raise ValueError("file name also used as a parent directory")
    return items


def absolute(path):
    path = Path(path)
    if ".." in path.parts:
        raise ValueError("filesystem arguments must not contain ..")
    return Path(os.path.abspath(path))


def checked(path, kind):
    path = absolute(path)
    for node in [*reversed(path.parents), path]:
        info = node.lstat()
        reparse = getattr(info, "st_file_attributes", 0) & 0x400
        if stat.S_ISLNK(info.st_mode) or node.is_junction() or reparse:
            raise ValueError("symbolic link, junction or reparse point rejected")
        wanted = stat.S_ISREG if node == path and kind == "file" else stat.S_ISDIR
        if not wanted(info.st_mode):
            raise ValueError("plain regular file or directory required")
    return path


def read_regular(path, limit):
    path = checked(path, "file")
    flags = os.O_RDONLY | getattr(os, "O_BINARY", 0)
    flags |= getattr(os, "O_NOFOLLOW", 0) | getattr(os, "O_NONBLOCK", 0)
    with os.fdopen(os.open(path, flags), "rb") as f:
        before = os.fstat(f.fileno())
        if not stat.S_ISREG(before.st_mode) or before.st_size > limit:
            raise ValueError("not a regular file or byte limit exceeded")
        data = f.read(limit + 1)
        after = os.fstat(f.fileno())
    stamp = lambda s: (s.st_dev, s.st_ino, s.st_size, s.st_mtime_ns, s.st_ctime_ns)
    if len(data) > limit or len(data) != before.st_size or stamp(before) != stamp(after):
        raise ValueError("file changed while reading or byte limit exceeded")
    return data


def inputs(source, allowlist):
    source = checked(source, "dir")
    names = validate_names(json.loads(read_regular(allowlist, MAX_LIST_BYTES).decode("utf-8")))
    payload, total = {}, 0
    for name in names:
        data = read_regular(source.joinpath(*name.split("/")), MAX_FILE_BYTES)
        total += len(data)
        if total > MAX_TOTAL_BYTES:
            raise ValueError("total input byte limit exceeded")
        payload[name] = data
    return source, payload


def same_inputs(source, allowlist, payload):
    current = inputs(source, allowlist)[1]
    return list(current) == list(payload) and current == payload


def verify_archive(path, payload):
    checked(path, "file")
    with zipfile.ZipFile(path, "r") as z:
        infos = z.infolist()
        if [i.filename for i in infos] != list(payload):
            raise ValueError("ZIP member order, count or names differ")
        if any(i.is_dir() or i.file_size != len(payload[i.filename]) for i in infos):
            raise ValueError("ZIP member kind or byte size differs")
        if z.testzip() is not None:
            raise ValueError("ZIP CRC or file header check failed")
        rows = []
        for info in infos:
            data = z.read(info)
            original = payload[info.filename]
            digest = hashlib.sha256(data).hexdigest()
            if data != original or digest != hashlib.sha256(original).hexdigest():
                raise ValueError("ZIP readback bytes or SHA-256 differ")
            rows.append({"name": info.filename, "bytes": len(data), "sha256": digest})
    return {"count": len(rows), "members": rows, "extra_members": [], "crc": "OK"}


def unlink_owned(path, identity):
    try:
        info = path.lstat()
    except FileNotFoundError:
        return
    if (info.st_dev, info.st_ino) != identity or not stat.S_ISREG(info.st_mode):
        raise RuntimeError(f"cleanup refused a replaced path: {path.name}")
    path.unlink()


def pack(source, allowlist, output):
    source, payload = inputs(source, allowlist)  # All input reads precede output creation.
    output = absolute(output)
    checked(output.parent, "dir")  # Existing parent only; no mkdir.
    if output.is_relative_to(source) or output.suffix.lower() != ".zip":
        raise ValueError("output must be a .zip outside source")
    work = output.with_name(output.name + ".part")
    if os.path.lexists(output) or os.path.lexists(work):
        raise FileExistsError("output or .part already exists; neither will be overwritten")
    identity, published = None, False
    try:
        with work.open("xb") as f:  # Exclusive create; an existing work file is untouched.
            info = os.fstat(f.fileno())
            identity = (info.st_dev, info.st_ino)
            with zipfile.ZipFile(f, "x", compression=zipfile.ZIP_DEFLATED) as z:
                for name, data in payload.items():
                    member = zipfile.ZipInfo(name, date_time=(2026, 1, 1, 0, 0, 0))
                    member.external_attr = (stat.S_IFREG | 0o644) << 16
                    z.writestr(member, data, compress_type=zipfile.ZIP_DEFLATED)
            f.flush()
            os.fsync(f.fileno())
        verify_archive(work, payload)
        if not same_inputs(source, allowlist, payload):
            raise ValueError("source or allowlist changed before publish")
        os.link(work, output)  # A new name only; do not use rename/replace fallbacks.
        published = True
        result = verify_archive(output, payload)
        if not same_inputs(source, allowlist, payload):
            raise ValueError("source or allowlist changed during final check")
        unlink_owned(work, identity)
        result["source_unchanged"] = True
        return result
    except BaseException as error:
        cleanup_errors = []
        for path in ([output] if published else []) + ([work] if identity else []):
            try:
                unlink_owned(path, identity)
            except OSError as cleanup_error:
                cleanup_errors.append(str(cleanup_error))
            except RuntimeError as cleanup_error:
                cleanup_errors.append(str(cleanup_error))
        if cleanup_errors:
            raise RuntimeError("cleanup failed; quarantine files and do not share: "
                               + "; ".join(cleanup_errors)) from error
        raise


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--source", default="source")
    parser.add_argument("--allowlist", default="allowlist.json")
    parser.add_argument("--output", default="practice.zip")
    parser.add_argument("--check", action="store_true", help="read an existing ZIP; write nothing")
    args = parser.parse_args()
    try:
        if args.check:
            source, payload = inputs(args.source, args.allowlist)
            result = verify_archive(args.output, payload)
            if not same_inputs(source, args.allowlist, payload):
                raise ValueError("input changed during check")
            result["source_unchanged"] = True
        else:
            result = pack(args.source, args.allowlist, args.output)
        print(json.dumps(result, ensure_ascii=False, indent=2))
    except (OSError, ValueError, RuntimeError, zipfile.BadZipFile) as error:
        print(f"STOP: {error}", file=sys.stderr)
        return 1
    return 0


if __name__ == "__main__":
    sys.exit(main())
작업파일을 검증한 뒤 os.link()로 같은 폴더에 새 최종 이름을 만듭니다. 이 코드에는 기존 경로를 덮는 replace() 대체 절차가 없습니다. 하드 링크를 지원하지 않으면 중단합니다. os.link()는 Unix와 Windows에 제공되지만, 파일시스템 지원과 권한 조건은 별도로 충족돼야 합니다. os.link 문서
실행 순서와 재열기 검산
터미널의 현재 폴더를 실습 README.txt가 있는 곳으로 정하고 다음 명령을 한 줄씩 실행하세요. python이 다른 버전을 가리키면 자신의 Python 3.12 실행 파일을 선택합니다.
python --version
python check_sha256.py
python -m unittest -v
python pack_allowlist.py --source source --allowlist allowlist.json --output practice.zip
python pack_allowlist.py --source source --allowlist allowlist.json --output practice.zip --check
첫 SHA 검사에서 불일치가 나오면 파일을 실행하지 말고 보존한 다운로드 사본과 대조하세요. SHA256SUMS.txt는 제공 파일의 SHA-256 목록이며 자기 자신과 나중에 생기는 실행 출력은 포함하지 않습니다. 고정 목록 검사를 하는 check_sha256.py의 전체 코드는 다음과 같습니다.
"""Read-only SHA-256 check for the supplied practice files."""
import hashlib
import re
import sys
from pathlib import Path

import pack_allowlist as p


def main():
    root = Path(__file__).parent
    lines = p.read_regular(root / "SHA256SUMS.txt", 65_536).decode("utf-8").splitlines()
    pairs = [line.split("  ", 1) for line in lines]
    if not pairs or any(len(row) != 2 or not re.fullmatch(r"[0-9a-f]{64}", row[0])
                        for row in pairs):
        raise ValueError("invalid SHA256SUMS.txt")
    # The archive builder's 16-file limit does not apply to the reader bundle manifest.
    names = [row[1] for row in pairs]
    if len(names) != len(set(n.casefold() for n in names)):
        raise ValueError("duplicate manifest names")
    for digest, name in pairs:
        p.validate_names([name])
        data = p.read_regular(root.joinpath(*name.split("/")), p.MAX_TOTAL_BYTES)
        if hashlib.sha256(data).hexdigest() != digest:
            raise ValueError(f"SHA-256 differs: {name}")
    print(f"SHA-256 manifest: OK ({len(pairs)} files)")


if __name__ == "__main__":
    try:
        main()
    except (OSError, ValueError) as error:
        print(f"STOP: {error}", file=sys.stderr)
        sys.exit(1)
정상 작성 명령은 source 밖에 새 practice.zip을 만듭니다. --check 명령은 그 ZIP을 재열어 읽기만 합니다. 결과 목록은 같은 순서의 세 항목이어야 하고, 허용목록 밖의 항목 수는 0입니다. 따라서 제외한 두 파일도 없습니다.
testzip()은 항목을 읽어 CRC와 파일 헤더를 검사하며 문제가 없으면 None을 반환합니다. 코드는 이에 더해 각 항목을 다시 읽어 원본 바이트, 바이트 수, SHA-256과 대조합니다. testzip 문서, hashlib 문서
제공된 입력의 합계는 347바이트입니다. 아래 값은 expected/package.json과 같습니다. 작성 결과와 --check 결과에서 이름별 바이트 수와 64자리 SHA-256을 각각 대조하세요.
{
  "count": 3,
  "members": [
    {
      "name": "README.txt",
      "bytes": 81,
      "sha256": "d67b7a006479a21af177e64748397cbc113c219fd4aa83122f335ee0fbb551ee"
    },
    {
      "name": "input.csv",
      "bytes": 23,
      "sha256": "ed09a12b651598dc1597fa551991a755c7d3dcaf98241c0e962c93f83b7d8554"
    },
    {
      "name": "run.py",
      "bytes": 243,
      "sha256": "ff69b00092d0858575246a9adeb957a1c8d87e2ce56cb0bd8a30780c93cfa4ea"
    }
  ],
  "extra_members": [],
  "crc": "OK",
  "source_unchanged": true
}
source_unchanged는 최종 검산 때 허용 입력을 다시 읽어 처음 읽은 값과 같았다는 뜻입니다. 정상 테스트에서는 제외용 가상 파일을 포함한 원본 다섯 파일의 경로와 바이트도 전후로 비교했습니다. ZIP 안 파일을 디스크에 추출하지 않고 읽은 바이트로 검산합니다.
실패했을 때 기존 파일을 보존하기
첨부의 테스트 22개는 Python 3.12.14와 Linux에서 실행했습니다. 정상 3항목, 원본 보존, 재실행 충돌, 잘못된 경로와 중복, 링크, 파일·합계 크기 한도, 읽기·쓰기·검증 실패를 포함합니다. CRC가 틀어진 ZIP, 제외 파일이 추가된 ZIP, 내용이 달라진 ZIP도 거부했습니다. Windows에서 실행한 결과는 없습니다. junction 검사는 Linux에서 해당 판단 분기에 실패를 주입한 시험입니다.
output or .part already exists: 기존 ZIP과 작업파일을 그대로 둡니다. 기존 완성본을 다시 확인하려면--check를 사용하세요. 다시 만들 때는--output practice_v2.zip처럼 새 이름을 정합니다invalid relative ZIP member name,casefold collision: 허용목록을 확인하고 가상 원본의 정확한 상대경로로 복구합니다. 통과시키려고..를 지우거나 파일 이름을 자동 정리하는 기능은 없습니다- 링크 또는 일반 파일 오류: 실제 업무 링크를 풀거나 보안 설정을 바꾸지 말고, 새 연습 폴더에 제공 자료를 직접 다시 풉니다
- 입력 읽기 오류: 처음 입력을 읽다 실패하면 출력이 없습니다. 게시 직전이나 최종 검사 때 입력 재읽기에 실패해도 이 실행이 만든 출력만 정리하고 중단합니다
- 중간 쓰기·CRC·목록·바이트·최종 검증 오류: 이 실행이 만든
.part와 최종 ZIP을 정리합니다. 검증에 실패한 ZIP을 완성본으로 전달하지 않습니다
정리할 때는 생성 당시의 파일 식별자가 같은지 확인합니다. 게시 시점에 다른 파일이 최종 이름을 차지하면 그 파일을 덮거나 지우지 않습니다. 정리 권한을 잃거나 경로가 다른 파일로 바뀌면 cleanup failed로 중단하므로 남은 파일을 공유하지 마세요.
프로세스 강제 종료나 전원 차단에서는 .part가 남을 수 있습니다. 남은 파일을 .zip으로 이름만 바꾸지 말고 그대로 보존한 채 새 연습 폴더에서 다시 시작하세요. 이 예제는 강제 종료 후 자동 재개 도구가 아닙니다.
통과 결과를 사용할 수 있는 범위
다른 프로그램의 쓰기 작업을 멈춘 통제된 연습 사본에서만 실행하세요. 경로 검사와 재읽기는 실수를 줄이는 장치이며 운영체제의 동시 변경 race를 완전히 막는 보안 보증은 아닙니다. 네트워크 드라이브·동기화 폴더·다중 사용자 작업 폴더에는 이 코드를 그대로 적용하지 않습니다. Windows의 junction·잠금·권한 동작도 실제 환경에서 추가 확인해야 합니다.
허용목록과 해시가 맞아도 파일 내용의 배포 적합성, 악성코드 여부, 작성자 신원까지 검증한 것은 아닙니다. 넣을 파일을 사람이 먼저 읽고 승인한 뒤 ZIP 작성 단계에 사용하세요. 프로그램은 자동 추출·업로드·외부 전송을 하지 않습니다.
다운로드받은 단일 파일의 내용 확인은 파일 이름과 내용 확인하기에서 이어서 볼 수 있습니다. 이 글의 결과는 원본을 보존하며 허용목록에서 직접 작성한 새 배포 ZIP입니다.
실습 자료
전체 코드, 허용목록, 같은 가상 입력, 고정 기대값, 실제 예제 ZIP과 22개 테스트 기록을 담았습니다. 전체 다운로드 ZIP에는 제외용 가상 파일도 들어 있습니다. 실행 후 만드는 practice.zip에는 허용한 세 파일만 있어야 합니다. 압축을 직접 풀고 README부터 확인하세요.
공식 자료와 확인일
- Python 3.12 ZipFile
- Python 3.12 writestr
- Python 3.12 testzip
- Python 3.12 hashlib
- Python 3.12 pathlib lstat
- Python 3.12 pathlib is_junction
- Python 3.12 stat 일반 파일 판정
- Python 3.12 파일 열기 모드
- Python 3.12 os.link
- Microsoft Windows 파일 이름 규칙
공식 자료 확인일: 2026-10-05. 실제 실행 버전은 Python 3.12.14이며 현재 공개된 3.12 계열 문서 페이지의 표시는 3.12.15입니다.
작성자 소개
