AI가 만든 파일을 내려받았을 때 이름과 내용 확인하기
AI 답변에 다운로드 링크가 있더라도 내려받은 파일을 직접 확인하세요. 파일이 비어 있거나, 방금 요청한 내용 대신 이전 버전이 들어 있을 수 있습니다.
먼저 파일이 실제로 저장됐는지와 이름을 확인한 뒤 필요한 내용이 들어 있는지 살펴봅니다. 이 글에서는 데이터가 두 행 들어 있는 작은 CSV로 빈 파일, 이전 파일, 오류 메시지를 저장한 파일을 구분합니다. Python 검사는 파일의 크기와 내용을 대조해 보는 선택 실습입니다.
실습은 Python 3.12.14의 로컬 파일 예제입니다. 본문에는 코드와 가상 입력을 실었으며, 별도 공개 첨부나 다운로드 링크는 제공하지 않습니다.
링크 문장과 파일 기록을 나누기
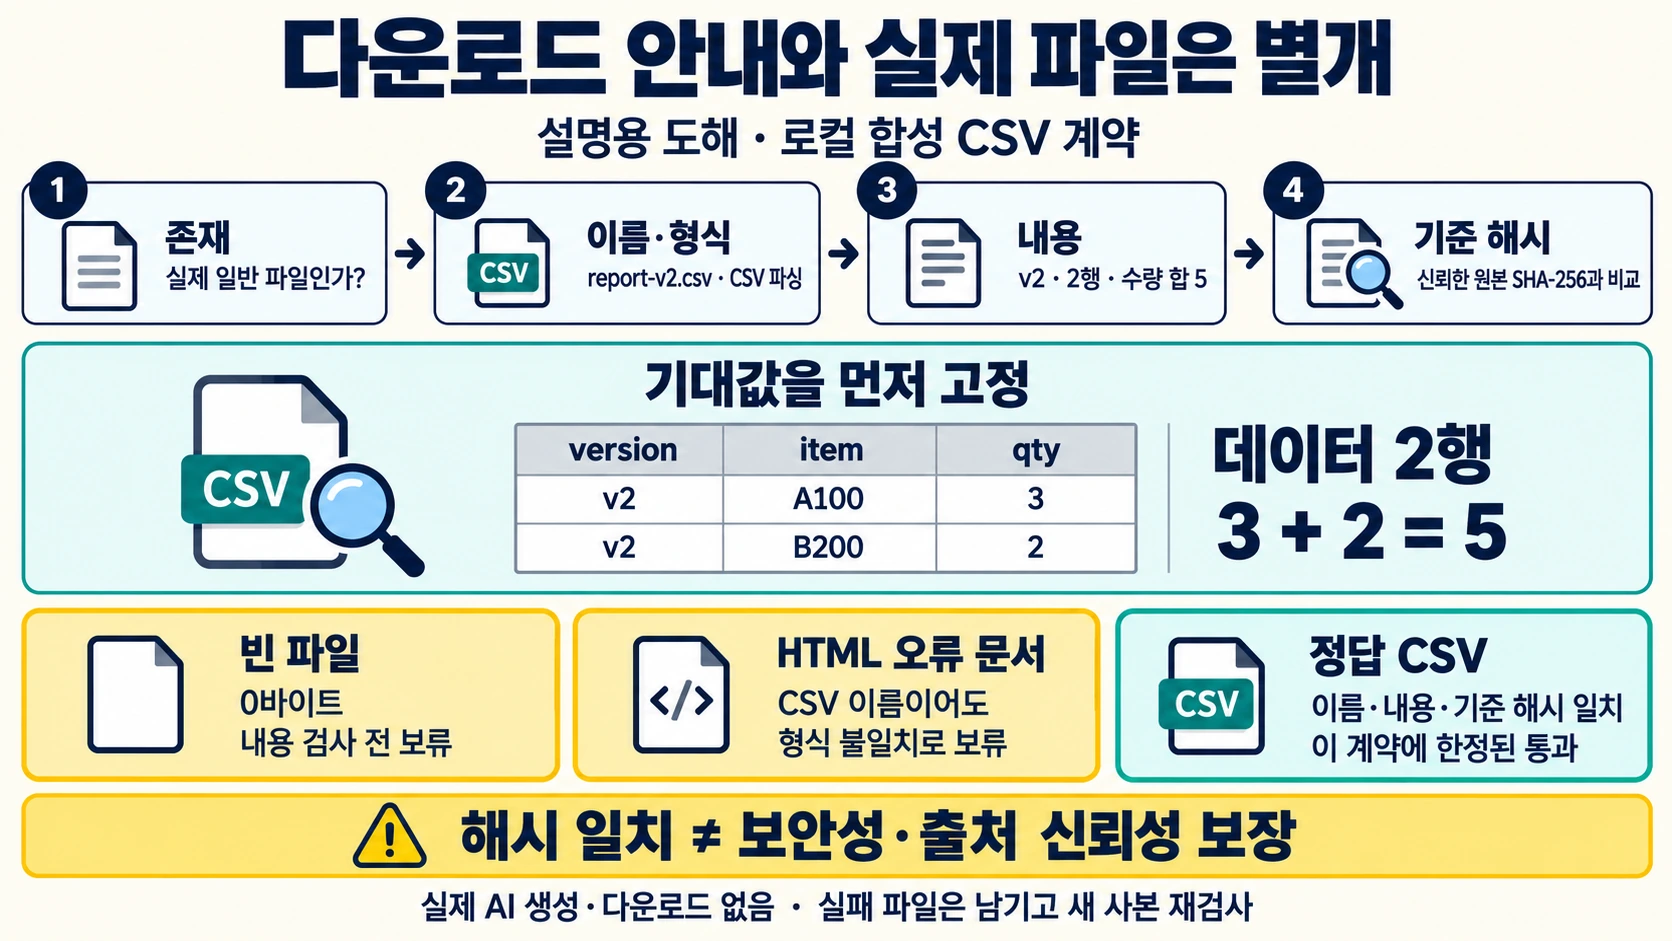
답변에 적힌 주소가 입력의 주소와 같은지는 AI 답변 URL 점검의 범위입니다. 여기서는 주소 문자열을 비교하지 않습니다. 실제로 손에 들어온 파일이 약속한 결과물인지 봅니다. 주소가 정확해도 파일이 없을 수 있고, 파일이 있어도 내용이 다른 버전일 수 있습니다.
| 확인 지점 | 확인할 증거 | 이것만으로 알 수 없는 것 |
|---|---|---|
| 안내 문장 | 결과 파일명과 생성 상태를 설명한 답변 | 파일이 실제 저장됐는지 |
| 실제 존재 | 직접 확인한 저장 경로의 일반 파일 | 파일 내용이 맞는지 |
| 이름과 형식 | report-v2.csv 이름과 CSV 파싱 결과 | 두 행의 값이 정확한지 |
| 내용 | 버전 v2, 품목 A100·B200, 수량 3·2 | 승인된 원본과 바이트가 같은지 |
| 해시 | 신뢰한 원본의 SHA-256과 비교 | 원본 자체가 올바른지, 악성 내용이 없는지 |
브라우저에서 받을 때에는 해당 서비스의 결과물 표시와 브라우저 다운로드 목록, 실제 저장 폴더를 차례로 확인하고 경로를 기록합니다. 이 과정은 독자가 자기 환경에서 해야 하는 확인 절차이며 이 글에서 실행한 관측 결과가 아닙니다. 로그인 주소, 일회성 링크, 인증값을 확인 기록에 그대로 복사하지 않습니다.
정답 파일의 계약을 먼저 고정하기
이 예제의 기대 파일명은 report-v2.csv입니다. UTF-8로 저장하는 작은 가상 파일이며, 마지막 줄 뒤에도 줄바꿈 하나가 있습니다. 헤더를 제외한 데이터는 2행이고 수량 합은 5입니다. 품목 순서도 이 실습에서는 고정합니다.
version,item,qty
v2,A100,3
v2,B200,2
정답 바이트의 SHA-256은 6ed30c63b815fdb545f1925c97cc7e6e7c3f7179603fa1b5aa5b95a09256b420입니다. 이 값은 위 가상 바이트에서 로컬로 계산했습니다. 실제 AI가 만든 파일에 대해 확인한 해시가 아닙니다.
Python pathlib 문서는 경로의 존재·파일 여부 확인과 바이트 읽기를 설명합니다. csv 문서는 DictReader와 CSV 읽기 동작을 설명하며, hashlib 문서는 SHA-256 등의 해시 계산 방법을 설명합니다. 아래의 v2·두 행·합 5·품목 순서는 이 글이 별도로 정한 계약입니다.
전체 검증 코드를 복사해 실행하기
다음 내용을 inspect_generated_file.py로 저장한 뒤 python inspect_generated_file.py를 실행합니다. 별도 패키지나 API 키는 필요 없습니다. 코드는 자신이 만든 임시 연습 폴더에만 파일을 쓰고 끝나면 그 폴더를 정리합니다. 실제 업무 파일을 고치거나 다운로드하지 않습니다.
"""Local synthetic CSV inspection only. No URL, API, or file download."""
import csv
import hashlib
import io
import tempfile
from pathlib import Path

GOOD = b'version,item,qty\nv2,A100,3\nv2,B200,2\n'
CONTRACT = {
    'name': 'report-v2.csv',
    'sha256': hashlib.sha256(GOOD).hexdigest(),
    'headers': ['version', 'item', 'qty'],
    'version': 'v2', 'rows': 2, 'total_qty': 5,
}

def inspect_file(path, contract):
    """Return reasons; an empty list means this narrow contract passed."""
    path = Path(path)
    if path.is_symlink():
        return ['SYMLINK_REQUIRES_REVIEW']
    if not path.exists():
        return ['MISSING_FILE']
    if not path.is_file():
        return ['NOT_REGULAR_FILE']
    if path.name != contract['name'] or path.suffix.lower() != '.csv':
        return ['NAME_OR_EXTENSION_MISMATCH']
    try:
        raw = path.read_bytes()
    except OSError:
        return ['READ_FAILED']
    if not raw:
        return ['EMPTY_FILE']
    if raw.lstrip()[:256].lower().startswith((b'<!doctype html', b'<html')):
        return ['HTML_INSTEAD_OF_CSV']
    errors = []
    if hashlib.sha256(raw).hexdigest() != contract['sha256']:
        errors.append('HASH_MISMATCH')
    try:
        text = raw.decode('utf-8-sig')
        reader = csv.DictReader(io.StringIO(text, newline=''), strict=True)
        rows = list(reader)
        valid = (
            reader.fieldnames == contract['headers']
            and len(rows) == contract['rows']
            and all(set(row) == set(contract['headers']) for row in rows)
            and all(row['version'] == contract['version'] for row in rows)
            and all(row['qty'] is not None and row['qty'].isdigit() for row in rows)
            and sum(int(row['qty']) for row in rows) == contract['total_qty']
            and [row['item'] for row in rows] == ['A100', 'B200']
        )
    except (UnicodeDecodeError, csv.Error, ValueError, TypeError, KeyError):
        valid = False
    if not valid:
        errors.append('CONTENT_MISMATCH')
    return errors

def run_demo():
    cases = {
        'good': GOOD,
        'missing': None,
        'empty': b'',
        'html_error': b'<!doctype html><html>Error 403</html>',
        'old_version': GOOD.replace(b'v2', b'v1'),
        'wrong_name': GOOD,
        'bad_total': GOOD.replace(b'B200,2', b'B200,9'),
    }
    expected = {
        'good': [], 'missing': ['MISSING_FILE'], 'empty': ['EMPTY_FILE'],
        'html_error': ['HTML_INSTEAD_OF_CSV'],
        'old_version': ['HASH_MISMATCH', 'CONTENT_MISMATCH'],
        'wrong_name': ['NAME_OR_EXTENSION_MISMATCH'],
        'bad_total': ['HASH_MISMATCH', 'CONTENT_MISMATCH'],
    }
    with tempfile.TemporaryDirectory(prefix='file-contract-') as folder:
        root = Path(folder)
        for label, data in cases.items():
            case = root / label
            case.mkdir()
            name = 'report-v1.csv' if label == 'wrong_name' else CONTRACT['name']
            path = case / name
            if data is not None:
                path.write_bytes(data)
            result = inspect_file(path, CONTRACT)
            assert result == expected[label], (label, result)
            print(label, 'PASS' if not result else ','.join(result))
        recovery = root / 'recovery' / CONTRACT['name']
        recovery.parent.mkdir()
        recovery.write_bytes(GOOD)
        assert inspect_file(recovery, CONTRACT) == []
        assert (root / 'empty' / CONTRACT['name']).read_bytes() == b''
        print('recovery PASS; original_empty_preserved=True')
        print('expected_sha256', CONTRACT['sha256'])
        print('network_requests=0; ai_service_downloads=0')

if __name__ == '__main__':
    run_demo()
검사 순서는 존재와 일반 파일 여부, 이름·확장자, 빈 파일, 대표 HTML 시작 문자열, 해시, CSV 내용입니다. 앞 단계에서 중단한 파일은 뒷 단계가 검증됐다는 뜻이 아닙니다. 예를 들어 EMPTY_FILE은 내용 검사 이전에 멈춘 결과입니다.
코드의 HTML 검사는 공백 뒤에 <!doctype html 또는 <html로 시작하는 대표 반례만 잡습니다. 모든 오류 페이지·모든 위장 파일을 판별하는 보안 도구가 아닙니다. HTML 주석이나 다른 시작 문구를 가진 파일은 해시·내용 검사를 함께 거쳐야 합니다. PDF·XLSX·ZIP은 CSV 파서로 확인할 수 없으므로 각 형식에 맞는 검증 방법이 따로 필요합니다.
실제 로컬 실행에서 확인한 정상과 반례
다음은 위 코드를 실행한 출력입니다. good 외의 여섯 사례는 실패 조건을 일부러 만든 합성 자료입니다. AI가 이 오류를 냈다는 기록이 아닙니다.
good PASS
missing MISSING_FILE
empty EMPTY_FILE
html_error HTML_INSTEAD_OF_CSV
old_version HASH_MISMATCH,CONTENT_MISMATCH
wrong_name NAME_OR_EXTENSION_MISMATCH
bad_total HASH_MISMATCH,CONTENT_MISMATCH
recovery PASS; original_empty_preserved=True
expected_sha256 6ed30c63b815fdb545f1925c97cc7e6e7c3f7179603fa1b5aa5b95a09256b420
network_requests=0; ai_service_downloads=0| 사례 | 일부러 만든 상태 | 관측 결과 | 재확인할 대상 |
|---|---|---|---|
| good | 계약과 같은 바이트 | PASS | 이 계약에 한정된 통과 |
| missing | 경로 문자열만 있고 파일 미생성 | MISSING_FILE | 생성 완료와 저장 경로 |
| empty | 이름은 있지만 0바이트 | EMPTY_FILE | 파일 생성·전달 과정 |
| html_error | csv 이름 아래 HTML 오류 문서 | HTML_INSTEAD_OF_CSV | 실제 응답 내용과 파일 형식 |
| old_version | 같은 이름에 v1 내용 | 해시·내용 모두 불일치 | 기대 버전과 승인된 원본 |
| wrong_name | 올바른 바이트를 report-v1.csv에 저장 | 이름·확장자 불일치 | 선택한 파일이 맞는지 |
| bad_total | B200 수량을 2에서 9로 바꿈 | 해시·내용 모두 불일치 | 값과 기대 합계 |
파일명이 같다는 이유로 이전 버전을 허용하지 않습니다. 반대로 해시가 다르다고 곧바로 데이터 손상이라고 단정하지도 않습니다. 줄바꿈, BOM, 인코딩만 달라져도 바이트 해시는 바뀔 수 있습니다. 그래서 해시 일치와 내용 일치를 별도 기록합니다. 이 계약에서는 승인된 바이트까지 같아야 PASS입니다.
복구는 실패 파일을 남긴 채 새 사본으로 확인하기
실습의 recovery는 정상 가상 바이트를 새 폴더에 다시 쓴 것입니다. 실제 서비스에서 파일을 다시 생성하거나 링크를 복구한 과정은 아닙니다. 원래의 빈 파일이 그대로 남는지도 assert로 확인했습니다. 실패 자료를 덮어쓰면 어떤 단계가 잘못됐는지 나중에 비교하기 어렵습니다.
실제 작업에서는 다음 항목을 복사해 채웁니다. 파일 존재와 파일명을 확인할 수 없으면 해시 칸을 먼저 채우지 않습니다. 없는 파일을 “다시 다운로드하면 해결”이라고 처리하기 전에 결과물이 생성됐다는 증거부터 찾습니다.
결과물 요구: 파일명 / 형식 / 버전 / 필수 내용
관측: 실제 저장 경로 / 확인 시각 / 일반 파일 여부 / 바이트 크기
내용: 헤더 / 데이터 행 수 / 핵심 값 / 기대 합계
해시: 신뢰한 기준 파일의 출처 / 기준 SHA-256 / 관측 SHA-256
실패 단계: 없음 / 존재 / 이름 / 형식 / 내용 / 바이트 일치
복구 사본: 새 경로 / 재확인 결과 / 기존 실패 파일 보존 여부
미검증: AI 서비스 생성 상태 / 다운로드 권한 / 실제 앱에서 열기
원본과 받은 파일에서 각각 해시를 계산해야 비교의 의미가 생깁니다. 받은 파일의 해시를 기준 칸과 관측 칸에 똑같이 복사하면 무엇도 검증하지 못합니다. 기준 파일의 출처를 믿을 수 없다면 해시가 맞더라도 승인된 결과물이라고 판단할 수 없습니다.
적용 한계와 다음 행동
이 코드는 몇십 바이트의 자기 소유 CSV 예제를 위한 것입니다. 큰 파일을 메모리에 통째로 읽는 방식, 검사 중 파일 교체, 권한·장치 오류, 네트워크 저장소의 동시 변경을 다루는 운영용 검사기는 아닙니다. 심볼릭 링크는 따로 보류하고, 이름이 같은 디렉터리도 파일로 인정하지 않습니다. 의심스러운 다운로드를 실행하거나 매크로를 활성화하지 마세요.
통과의 뜻은 report-v2.csv 계약을 만족했다는 것입니다. 링크 유효기간, 특정 AI 서비스의 현재 다운로드 기능, 파일의 보안성까지 확인했다는 뜻은 아닙니다. 내용 확인 이후 사람의 최종 승인 기록이 필요하면 엑셀 AI 결과 승인대장에서 원본과 승인값을 나누는 방법을 이어서 볼 수 있습니다.
작성자 소개
