두 CSV를 SQLite에 함께 넣고 외래키 실패 시 추가분 되돌리기
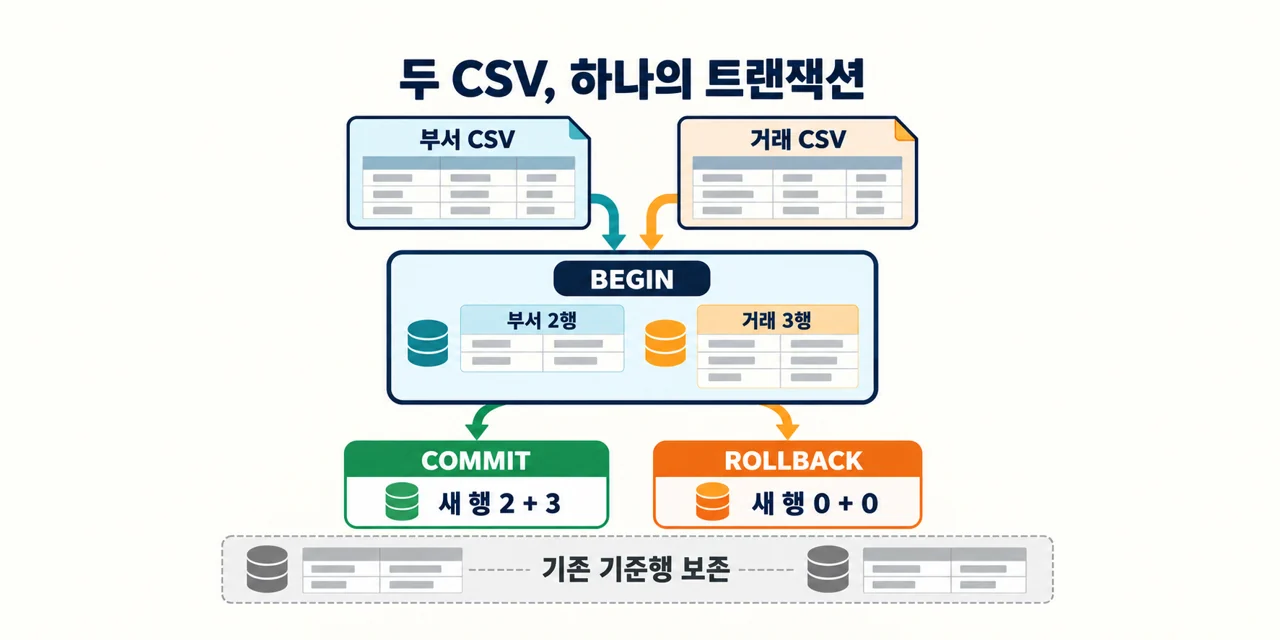
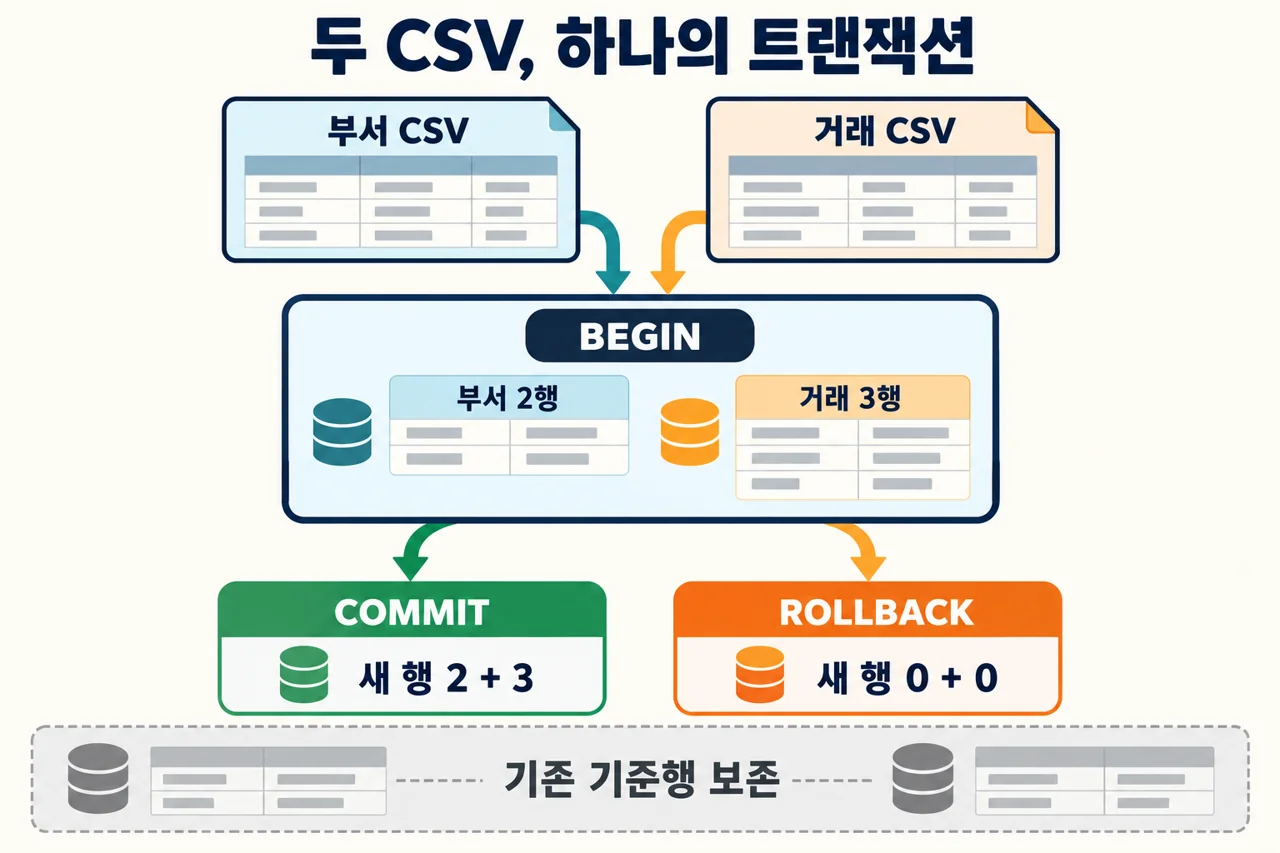
부서 CSV는 들어갔는데 거래 CSV 중 한 행이 없는 부서를 가리켜 실패했습니다. 이때 부서 두 행만 남기면 두 파일을 한 묶음으로 반영하려던 의도가 깨집니다. 이번 실습은 부서 2행과 거래 3행을 같은 트랜잭션으로 넣고, 실패하면 이번 추가분을 두 표에서 모두 취소합니다. 이미 있던 기준 부서와 거래는 그대로 남는지도 확인합니다.
실제 업무 DB에는 연결하지 않습니다. 매번 새 출력 폴더에 연습 DB를 만들고 가상 기준행을 먼저 넣습니다. 그 뒤 두 CSV를 적재하므로, 실행 이전부터 있던 행과 이번에 추가한 행의 경계를 안전한 로컬 예제로 볼 수 있습니다. 원본 CSV는 읽기만 합니다.
1. 기존 기준행과 새로 들어갈 행을 나눕니다
코드는 새 DB를 만들자마자 departments에 D0·기존부서 한 행, transactions에 T0·D0·수량 7 한 행을 저장합니다. 이 두 행은 이번 적재의 BEGIN 이전에 커밋된 기준입니다. 실패 뒤 비어 있는 DB만 확인하는 대신, 기존 내용이 보존됐는지를 직접 비교하기 위한 장치입니다.
fixtures/departments.csv는 다음 두 행입니다.
id,name
D1,영업
D2,지원
fixtures/transactions.csv는 세 거래입니다. T2의 수량 0도 정상 값입니다.
id,department_id,qty
T1,D1,2
T2,D2,0
T3,D1,5| 상태 | 이번 추가 부서·거래 | DB 전체 부서·거래 | 남는 ID |
|---|---|---|---|
| 적재 전 | 0 · 0 | 1 · 1 | D0 / T0 |
| 정상 커밋 | 2 · 3 | 3 · 4 | D0,D1,D2 / T0,T1,T2,T3 |
| 적재 실패·롤백 | 0 · 0 | 1 · 1 | D0 / T0 |
실패 결과의 추가 0·0을 DB 전체가 0행이라는 뜻으로 읽지 마세요. 반대로 정상 결과의 전체 3·4를 이번 CSV에서 읽은 행 수로 쓰면 기준행이 한 번씩 과다 집계됩니다. JSON은 before·after와 added를 따로 저장합니다.
2. 외래키는 BEGIN 전에 켜고 연결에서 확인합니다
거래의 department_id는 departments의 id를 참조합니다. 거래 T2가 X를 가리키는데 부서 X가 없으면 외래키 제약으로 거부해야 합니다. 두 CSV를 따로 읽었다는 사실만으로 관계가 검증되지는 않습니다.
PRAGMA foreign_keys=ON;
PRAGMA foreign_keys;
SQLite 외래키 문서에 따라 활성화는 연결별로 확인하고, 트랜잭션이 없는 상태에서 수행합니다. BEGIN 안에서 켜려고 하면 적용되지 않을 수 있습니다. 코드의 seed 함수는 먼저 ON을 설정하고 반환값이 1인지 확인합니다. import_pair도 적재 직전에 다시 1인지 검사하며 꺼져 있으면 진행하지 않습니다.
테이블 선언만 보고 외래키가 검사될 것이라고 가정하지 않는 것이 중요합니다. 이번 단위 검사에는 foreign_keys를 OFF로 바꾸고 적재가 FOREIGN_KEYS_OFF로 거부되는 반례가 포함됩니다. 이 설정 변경은 임시 메모리 DB 연결에만 적용하며 컴퓨터나 운영 서버 설정을 바꾸지 않습니다.
3. 두 파일의 INSERT와 검산을 같은 범위에 둡니다
범위는 BEGIN IMMEDIATE → 부서 INSERT → 거래 INSERT → 기대 행 대조 → COMMIT입니다. 거래 적재 중 오류가 나면 ROLLBACK 뒤 전체 행 목록이 before와 같은지 다시 확인합니다. 부서를 넣은 직후 중간 COMMIT을 하지 않습니다.
예를 들어 unknown_department.csv의 두 번째 거래는 X를 참조합니다. 앞에서 부서 D1·D2와 거래 T1을 넣었어도, 실패한 T2 한 문장만 거부된 것으로 끝내지 않고 이번 범위의 모든 INSERT를 되돌립니다. SQLite 트랜잭션 문서가 설명하듯 일부 오류는 실패한 문장만 중단할 수 있으므로 오류 처리에서 명시적 ROLLBACK을 수행합니다.
Python 연결은 autocommit=True로 만들며 SQL COMMIT·ROLLBACK을 직접 실행합니다. 이 설정에서 연결 객체의 commit()·rollback() 메서드에 기대어 같은 결과를 얻는 코드로 바꾸지 마세요. Python sqlite3 트랜잭션 제어 문서에서 설정별 동작을 확인할 수 있습니다. 이미 진행 중인 트랜잭션이 있으면 ACTIVE_TRANSACTION으로 거부하여 다른 작업의 경계를 가져오지 않습니다.
4. 실행할 전체 코드
ZIP의 atomic_import.py와 아래 코드는 같습니다. Python 3.12 이상이 필요합니다. ID는 대문자 ASCII로 시작하는 1~32자이며, 수량은 0~999999999의 정수 표기만 받습니다. 1.5·음수·빈칸·앞뒤 공백·선행 0을 임의로 변환하지 않습니다. 부서 이름은 공백만 있는 값이나 앞뒤 공백, 80자를 넘는 값을 거부합니다.
"""Disposable teaching DB only: fixed baseline plus two related CSV inputs."""
import argparse
from contextlib import closing
import csv
import hashlib
import io
import json
import platform
import re
import sqlite3
import sys
from pathlib import Path


def snapshot(con):
    return {
        'departments': [list(r) for r in con.execute('SELECT id,name FROM departments ORDER BY id')],
        'transactions': [list(r) for r in con.execute('SELECT id,department_id,qty FROM transactions ORDER BY id')],
    }


def seed(con):
    con.execute('PRAGMA foreign_keys=ON')
    if con.execute('PRAGMA foreign_keys').fetchone() != (1,):
        raise ValueError('FOREIGN_KEYS_OFF')
    con.execute('CREATE TABLE departments(id TEXT PRIMARY KEY NOT NULL, name TEXT NOT NULL)')
    con.execute('CREATE TABLE transactions(id TEXT PRIMARY KEY NOT NULL, department_id TEXT NOT NULL REFERENCES departments(id), qty INTEGER NOT NULL CHECK(typeof(qty)=\'integer\' AND qty>=0))')
    con.execute('INSERT INTO departments VALUES(?,?)', ('D0','기존부서'))
    con.execute('INSERT INTO transactions VALUES(?,?,?)', ('T0','D0',7))


def check_id(value):
    if re.fullmatch(r'[A-Z][A-Z0-9_-]{0,31}', value) is None:
        raise ValueError('BAD_ID: use 1..32 ASCII uppercase ID characters')
    return value


def import_pair(con, departments, transactions):
    if con.in_transaction:
        raise ValueError('ACTIVE_TRANSACTION: do not take over an existing transaction')
    if con.execute('PRAGMA foreign_keys').fetchone() != (1,):
        raise ValueError('FOREIGN_KEYS_OFF')
    if not departments or not transactions:
        raise ValueError('EMPTY_INPUT: both CSV files need data')
    before = snapshot(con)
    con.execute('BEGIN IMMEDIATE')
    try:
        for row in departments:
            if len(row) != 2:
                raise ValueError('BAD_DEPARTMENT_ROW')
            key, name = row
            check_id(key)
            if not name or name != name.strip() or len(name) > 80:
                raise ValueError('BAD_NAME')
            con.execute('INSERT INTO departments(id,name) VALUES(?,?)', (key,name))
        for row in transactions:
            if len(row) != 3:
                raise ValueError('BAD_TRANSACTION_ROW')
            key, department, qty = row
            check_id(key)
            check_id(department)
            if re.fullmatch(r'0|[1-9][0-9]{0,8}',qty) is None:
                raise ValueError('BAD_QTY: use an integer 0..999999999')
            con.execute('INSERT INTO transactions(id,department_id,qty) VALUES(?,?,?)',
                        (key,department,int(qty)))
        expected = {
            'departments': sorted(before['departments'] + [list(r) for r in departments]),
            'transactions': sorted(before['transactions'] + [[r[0],r[1],int(r[2])] for r in transactions]),
        }
        after = snapshot(con)
        if after != expected or con.execute('PRAGMA foreign_key_check').fetchall():
            raise ValueError('RECONCILIATION_FAILED')
        con.execute('COMMIT')
    except Exception:
        if con.in_transaction:
            con.execute('ROLLBACK')
        if snapshot(con) != before:
            raise RuntimeError('ROLLBACK_NOT_VERIFIED')
        raise
    return {'before': before, 'after': after, 'added': [len(departments),len(transactions)]}


def load(path, header):
    raw=Path(path).read_bytes()
    if len(raw)>1_000_000:
        raise ValueError('INPUT_LIMIT')
    rows=list(csv.reader(io.StringIO(raw.decode('utf-8-sig'),newline=''),strict=True))
    if not rows or rows[0]!=header:
        raise ValueError('BAD_HEADER: '+','.join(header))
    if len(rows)>10001:
        raise ValueError('INPUT_LIMIT')
    return rows[1:],hashlib.sha256(raw).hexdigest()


def main():
    p=argparse.ArgumentParser(description='Create a NEW disposable practice DB; never open an existing DB')
    p.add_argument('departments_csv')
    p.add_argument('transactions_csv')
    p.add_argument('new_output_directory')
    a=p.parse_args()
    con=None
    try:
        if sys.version_info < (3,12):
            raise ValueError('PYTHON_3_12_REQUIRED')
        ds,dsha=load(a.departments_csv,['id','name'])
        ts,tsha=load(a.transactions_csv,['id','department_id','qty'])
        out=Path(a.new_output_directory)
        # Exclusive directory creation: never connect to a user-supplied existing DB.
        out.mkdir()
        db=out/'practice.sqlite3'
        con=sqlite3.connect(db,autocommit=True)
        seed(con)
        before=snapshot(con)
        report={'python':platform.python_version(),'sqlite':sqlite3.sqlite_version,
                'foreign_keys':con.execute('PRAGMA foreign_keys').fetchone()[0],
                'input_sha256':{'departments':dsha,'transactions':tsha}}
        try:
            report.update(import_pair(con,ds,ts))
            report['status']='COMMITTED'
            code=0
        except (ValueError,sqlite3.IntegrityError) as error:
            after=snapshot(con)
            if after!=before:
                raise RuntimeError('BASELINE_CHANGED')
            report.update(status='ROLLED_BACK',error=str(error),before=before,after=after,added=[0,0])
            code=1
        con.close()
        con=None
        # Verify persisted logical rows using a separate read-only connection.
        with closing(sqlite3.connect(db.resolve().as_uri()+'?mode=ro',uri=True)) as readback:
            if snapshot(readback)!=report['after']:
                raise RuntimeError('READBACK_MISMATCH')
        report['readback_verified']=True
        with (out/'report.json').open('x',encoding='utf-8') as f:
            json.dump(report,f,ensure_ascii=False,indent=2)
            f.write('\n')
        print(json.dumps(report,ensure_ascii=False))
        return code
    except (OSError,ValueError,UnicodeError,csv.Error,sqlite3.Error,RuntimeError) as error:
        print('PRACTICE_FAILED: '+str(error),file=sys.stderr)
        return 2
    finally:
        if con is not None:
            con.close()


if __name__=='__main__':
    sys.exit(main())
값은 SQL에 붙여 넣지 않고 ? 자리표시자로 전달합니다. 테이블 이름과 SQL 구조는 코드에 고정되어 있습니다. CSV 헤더·순서가 다르거나 UTF-8로 읽지 못하면 출력 폴더를 만들기 전에 중단합니다. 자세한 CSV 문자열·레코드 처리 기준은 Python csv 문서를 참고하세요.
5. 정상 파일과 실패 파일을 새 폴더에서 실행합니다
- ZIP을 새 연습 폴더에 풀고 README.txt를 읽습니다.
- 터미널에서 압축을 푼 폴더로 이동합니다.
- 버전을 확인한 뒤 정상 입력부터 실행합니다. out-normal은 미리 만들지 않습니다.
python3 -c "import platform,sqlite3; print(platform.python_version(),sqlite3.sqlite_version)"
python3 atomic_import.py fixtures/departments.csv fixtures/transactions.csv out-normal
정상 결과는 종료 0, status COMMITTED, added [2,3], foreign_keys 1, readback_verified true입니다. out-normal/report.json의 after를 expected/normal_rows.json과 대조하세요. 기존 기준행까지 포함해 부서는 D0·D1·D2, 거래는 T0·T1·T2·T3이며 수량은 7·2·0·5입니다.
같은 명령을 다시 실행하면 이미 있는 out-normal 때문에 종료 2로 거부합니다. 기존 practice.sqlite3를 열어 추가하거나 덮지 않습니다. 새 시험은 out-normal-2처럼 사용하지 않은 폴더명을 지정하세요.
python3 atomic_import.py fixtures/departments.csv fixtures/unknown_department.csv out-unknown
python3 atomic_import.py fixtures/departments.csv fixtures/duplicate_transaction.csv out-duplicate
python3 atomic_import.py fixtures/departments.csv fixtures/bad_quantity.csv out-bad-quantity| 입력 | 의도한 실패 | 기대 결과 |
|---|---|---|
| unknown_department.csv | T2가 없는 부서 X 참조 | 외래키 실패, 추가 0·0 |
| duplicate_transaction.csv | 세 번째 거래 ID가 T1 중복 | 고유성 실패, 추가 0·0 |
| bad_quantity.csv | T2 수량이 1.5 | BAD_QTY, 추가 0·0 |
세 명령은 모두 종료 1이고 status ROLLED_BACK입니다. 각 폴더에는 report.json과 practice.sqlite3가 남습니다. after가 expected/rollback_rows.json과 같고, 부서 D0·기존부서와 거래 T0·D0·7만 남았는지 확인합니다. 오류 파일을 지워 실패 흔적을 없애지 않습니다.
이때 DB 파일 바이트의 SHA가 적재 전과 같다고 요구하지 않습니다. DB 내부 페이지나 저널 처리는 논리적인 행 내용과 다른 문제입니다. 이 실습은 별도 읽기 전용 연결로 다시 열어 ID와 값이 before와 같은지 검산합니다.
6. 실패 원인을 고칠 때도 관계를 유지합니다
- 없는 부서 X: 원래 부서 코드가 잘못됐는지, 부서 CSV가 누락됐는지 확인합니다. 통과시키려고 외래키를 끄지 않습니다.
- 중복 거래 T1: 같은 거래를 두 번 받은 것인지, 서로 다른 거래에 ID를 잘못 붙인 것인지 확인합니다. INSERT OR REPLACE로 기존 행을 덮지 않습니다.
- 수량 1.5: 정수 수량이라는 입력 계약이 맞는지 확인하고 근거 있는 수정 사본을 만듭니다. 무조건 반올림하지 않습니다.
- 기존 D0 충돌: 이미 존재하는 부서를 새 부서로 다시 넣고 있는지 확인합니다. 기존 기준행의 이름을 새 값으로 변경하는 작업은 이 예제의 범위가 아닙니다.
- 종료 2: 입력·경로·저장 또는 예상 밖 실행 오류입니다. 남은 파일을 완료 자료로 쓰지 말고 오류와 DB 상태부터 확인합니다.
종료 2가 났다고 DB에 아무것도 저장되지 않았다고 단정하면 안 됩니다. 예를 들어 COMMIT 다음 report.json 저장이 실패하면 DB에는 새 행이 이미 있을 수 있습니다. SQLite 트랜잭션은 CSV 읽기·JSON 쓰기·폴더 생성을 하나의 원자적 작업으로 묶어 주지 않습니다. 이 예제는 새 경로만 받으므로 이전 결과를 자동 재사용하지 않습니다.
7. 직접 실행한 검산과 적용 범위
python3 test_import.py첨부의 python3 test_cli.py로 CLI 반례 18개도 다시 실행할 수 있습니다. 기존 검사와 겹치는 사례를 포함한 별도 재실행 묶음이며 새 임시 폴더에서만 출력하고 원본·기대값·제공 로그를 덮어쓰지 않습니다.
Linux CPython 3.12.14와 SQLite 3.53.1에서 단위 검사 11개와 CLI 실행 7개를 확인했습니다. 정상 2·3행 적재, 외래키 실패, 거래 중복, 기존 부서 충돌, 수량 오류, 외래키 OFF 거부, 빈 ID·빈 입력, 기존 부서 D0 참조, 이미 열린 트랜잭션 거부, 성공 뒤 같은 입력 재적재의 원본 행 보존을 다룹니다. CLI에서는 새 폴더 정상·실패 결과를 별도 연결로 읽고 기존 출력 재실행 거부, 잘못된 헤더, 누락 입력을 확인했습니다.
logs/runtime.json에 실행 버전, logs/unittest.txt에 단위 결과, logs/cli_actual.json에 명령별 실제 종료코드와 출력이 있습니다. 시험 전후 fixture SHA-256이 같았고, 실패 DB에는 기준행만 남는 것을 별도 조회했습니다. Windows·macOS, 동시 쓰기, 전원 장애와 네트워크 공유 폴더는 시험하지 않았습니다. 입력당 1MB·10,000레코드 수용 한도는 읽은 뒤 검사하는 기준이며 대용량 메모리 보장은 아닙니다.
한 CSV의 ID·수량 제약을 처음 익힌다면 CSV를 새 SQLite 표에 적재하고 오류 거부하기부터 보세요. 조회 값의 따옴표 처리는 SQLite 매개변수 정확 일치 조회에서 이어집니다. 이번 글은 두 표 사이의 참조 관계와 기존 행·이번 추가분의 경계를 검산하는 연습입니다.
작성·검증 기준일: 2026년 10월 8일 KST. 자료·부서명·거래는 모두 합성이며 운영 DB를 변경한 기록이 아닙니다.
작성자 소개
