쉼표와 줄바꿈이 들어 있는 메모를 CSV에 그대로 왕복 저장하기
메모에 쉼표가 있거나 Enter로 줄을 나눴다면, CSV를 저장한 뒤 같은 메모가 한 필드로 돌아오는지 확인하세요. 쉼표로 직접 이어 붙이면 열이 늘어날 수 있고, 줄바꿈을 없애면 원문이 달라집니다. 여기서는 Python의 csv.writer로 저장하고 csv.reader로 다시 읽어 두 행의 모든 문자열을 비교합니다.
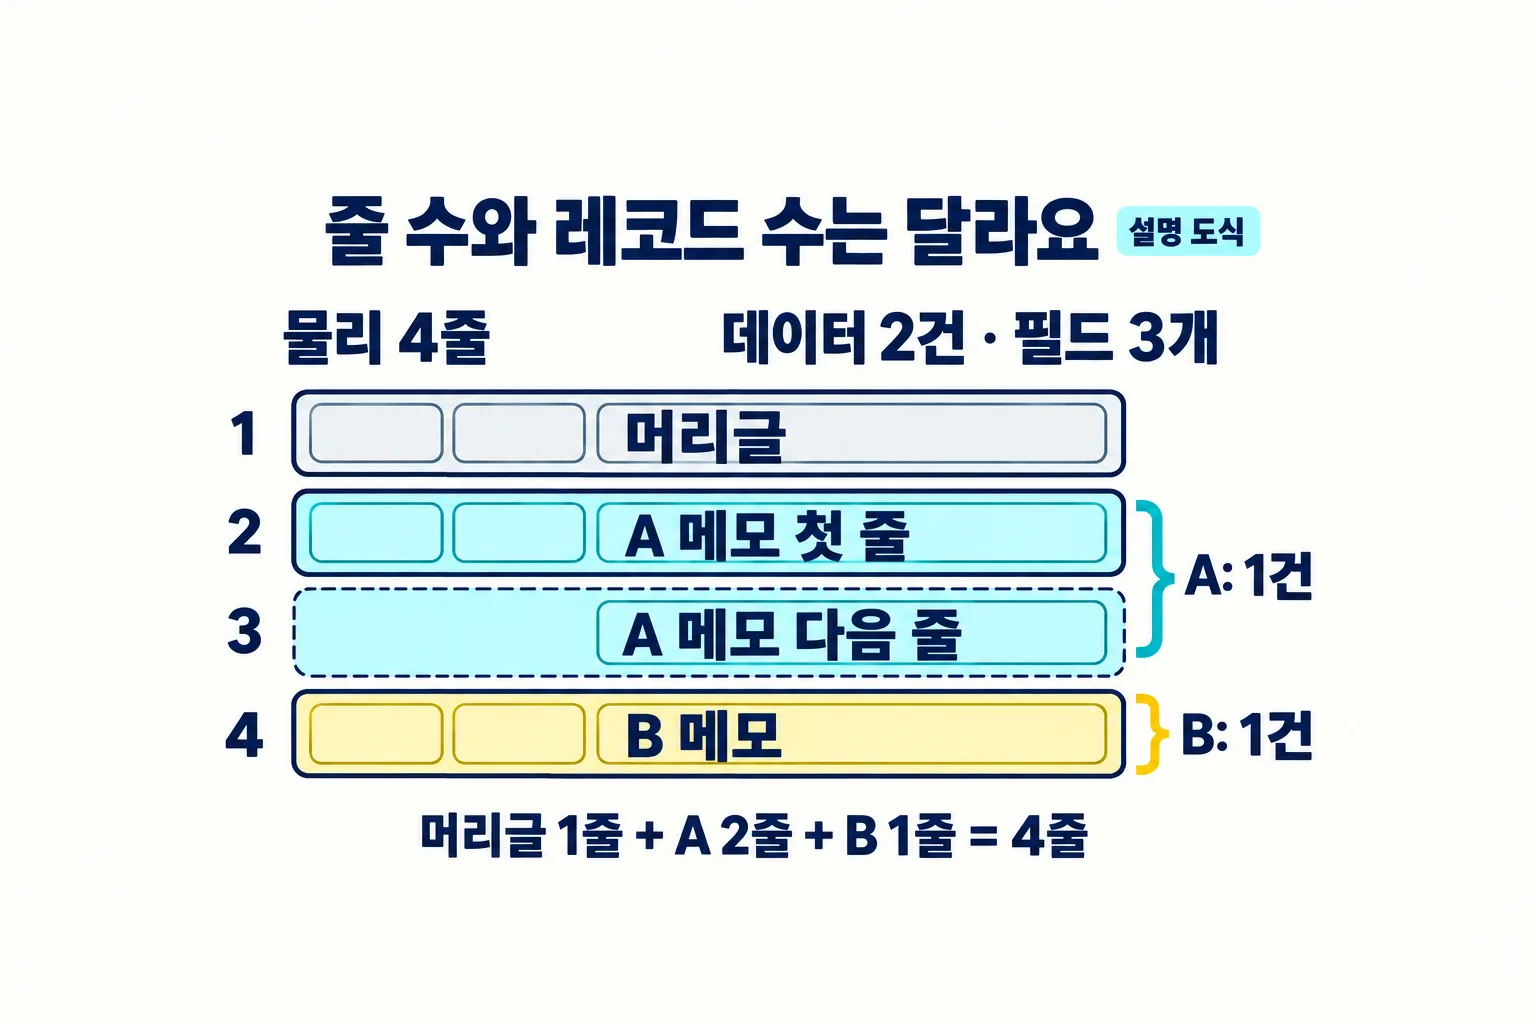
가상 입력에는 쉼표, 큰따옴표, 메모 안의 줄바꿈, 앞자리 0, 앞뒤 공백을 넣었습니다. 정상 결과는 데이터 2건·필드 3개이며 CSV의 물리 줄은 머리글을 포함해 4줄입니다. 파일 개수나 화면의 줄 수만 보고 성공을 판정하지 않습니다.
1. 바꾸지 않을 문자열을 먼저 정합니다
이번 입력은 BOM 없는 UTF-8 JSON 파일이며, 각 행은 id·qty·memo 순서의 문자열 세 개입니다. 머리글은 코드가 CSV에 별도로 씁니다. JSON 안에 머리글 행을 추가하지 마세요.
"02"는 문자열 그대로 남깁니다. 정수 2로 바꿔 합계를 계산하지 않습니다.- 빈 메모
"", 공백, 탭, LF·CRLF·단독 CR도 문자열 값으로 보존합니다. 공백을 지우는strip()이나 줄바꿈 치환을 하지 않습니다. - 문자열이 아닌 숫자·불리언·
null, 필드가 부족하거나 넘치는 행은 저장 전에 거부합니다. CSV writer는None을 빈 문자열로 쓸 수 있어 원래 값으로 되돌릴 수 없으므로 이 실습에서는 받지 않습니다. - 입력은 100,000바이트 이하의 일반 파일만 받습니다. 최종 경로의 심볼릭 링크·폴더·FIFO는 열기 전에 거부합니다.
빈 목록 []은 데이터 0건, 머리글만 있는 CSV로 저장됩니다. 빈 행 []이 목록 안에 들어 있는 [[]]은 세 필드 규칙에 어긋나 거부됩니다. 이 규칙은 실습의 입력 계약이며 업무 자료의 필수값이나 수량 범위를 승인하는 검사가 아닙니다.
CSV를 읽는 reader는 기본적으로 필드를 문자열 목록으로 돌려줍니다. 구분자와 인용 설정은 writer·reader에 맞추고, 레코드 끝은 writer에 CRLF로 지정합니다. 줄바꿈 처리는 CSV 모듈에 맡깁니다. Python 3.12 csv.reader 문서, csv.writer 문서
2. 메모 두 개에서 CSV 네 줄이 나옵니다
검수한 실습 ZIP 다운로드를 새 개인 연습 폴더에 풉니다. 코드, 가상 입력, 기대 결과, 테스트, README와 실행 기록이 들어 있습니다. 별도 Python 패키지는 필요하지 않습니다. 먼저 fixtures/memos.json을 텍스트 편집기로 확인하세요.
[
  ["A", "02", "입고, \"파랑\" 확인\n다음 줄에 메모"],
  ["B", "3", "  앞뒤 공백 유지  "]
]
JSON의 \n은 읽힌 뒤 실제 LF 한 글자가 됩니다. \"는 메모 내용의 큰따옴표 한 글자입니다. 첫 메모는 입고, "파랑" 확인과 다음 줄에 메모 사이에 LF를 포함하며, 두 번째 메모는 앞뒤 공백 두 칸씩을 포함합니다.
기대 CSV를 텍스트로 펼치면 아래 네 줄입니다. 보기용 블록은 줄을 LF로 표시했습니다. 실제 파일의 레코드 끝은 CRLF이고 첫 메모 내부의 LF는 그대로여서, 파일 전체의 줄 끝을 일괄 치환하면 값이 달라집니다.
id,qty,memo
A,02,"입고, ""파랑"" 확인
다음 줄에 메모"
B,3,  앞뒤 공백 유지
첫 메모를 감싼 바깥 큰따옴표는 CSV 문법입니다. 메모 속 "파랑"의 큰따옴표는 CSV에 ""파랑""으로 저장되고 reader가 다시 한 개씩 복원합니다. A의 메모가 두 물리 줄에 걸쳐도 데이터는 A와 B 두 레코드입니다. 머리글 1줄 + A 2줄 + B 1줄 = 4줄입니다.
3. 새 폴더에 저장하고 기대값과 대조합니다
압축을 푼 practice 폴더에서 터미널을 열고 Python 실행 이름과 버전을 먼저 확인합니다. 이 글의 명령은 python3이며, 자신의 PC에서 같은 인터프리터를 가리키는 이름이 다르면 그 이름으로 바꿉니다. 명령을 찾지 못하면 실행 환경부터 확인하세요.
python3 --version
python3 -m unittest -v test_csv_roundtrip.py
python3 csv_roundtrip.py fixtures/memos.json ../p14_run_01../p14_run_01은 아직 없는 새 출력 폴더여야 합니다. 부모 폴더는 이미 있어야 합니다. 정상 명령의 종료 코드는 0이고, 터미널과 summary.json에 다음 값이 나옵니다.
{
  "header": [
    "id",
    "qty",
    "memo"
  ],
  "data_records": 2,
  "fields_per_record": 3,
  "physical_lines": 4,
  "record_terminator": "CRLF",
  "roundtrip_equal": true
}
data_records: 2는 머리글을 제외한 데이터 레코드 수입니다.fields_per_record: 3은 각 레코드의 필드 수입니다.physical_lines: 4는 reader가 읽은 물리 줄 수이며 머리글도 포함합니다.reader.line_num은 레코드 개수와 다를 수 있습니다.roundtrip_equal: true는 CSV에서 재읽은 전체 행 목록이 입력 목록과 같다는 뜻입니다. 메모뿐 아니라 ID·수량 문자열·행 순서도 비교합니다.
새 폴더에는 memo.csv, restored.json, summary.json 세 파일이 생깁니다. restored.json의 값은 위 입력 목록과 같아야 합니다. 원본 JSON의 들여쓰기나 파일 바이트를 똑같이 복제하는 목표는 아니며, 파싱한 모든 문자열의 동일성을 검산합니다. ZIP의 expected 폴더에는 대조할 정상 결과가 들어 있습니다. 기존 기대 파일을 출력 대상으로 덮어쓰지 않습니다.
4. 줄바꿈과 인용 처리를 코드에서 확인합니다
다음은 다운로드의 csv_roundtrip.py 전체 코드입니다. CSV 저장과 재읽기 모두 encoding='utf-8', newline=''을 사용합니다. 레코드 끝은 \r\n, 필요한 필드만 인용하는 QUOTE_MINIMAL, 내용의 큰따옴표를 두 번 쓰는 doublequote=True를 명시했습니다.
#!/usr/bin/env python3
"""Keep string fields exactly: UTF-8 JSON rows -> CSV -> UTF-8 JSON rows."""
import argparse
import csv
import json
from pathlib import Path
import stat
import sys

HEADER = ['id', 'qty', 'memo']
MAX_INPUT_BYTES = 100_000


def load_rows(path):
    info = path.lstat()  # Check the final path before opening; no final symlinks.
    if not stat.S_ISREG(info.st_mode):
        raise ValueError('input must be a regular file, not a symlink or directory')
    if info.st_size > MAX_INPUT_BYTES:
        raise ValueError(f'input exceeds {MAX_INPUT_BYTES} bytes')
    with path.open('rb') as stream:
        raw = stream.read(MAX_INPUT_BYTES + 1)
    if len(raw) > MAX_INPUT_BYTES:
        raise ValueError(f'input exceeds {MAX_INPUT_BYTES} bytes')
    try:
        rows = json.loads(raw.decode('utf-8'))
    except UnicodeDecodeError as error:
        raise ValueError('input must be UTF-8') from error
    except json.JSONDecodeError as error:
        raise ValueError(f'invalid JSON: {error}') from error
    if not isinstance(rows, list):
        raise ValueError('JSON root must be a list of three-string rows')
    for number, row in enumerate(rows, 1):
        if not isinstance(row, list) or len(row) != len(HEADER):
            raise ValueError(f'JSON row {number} must be a list of three fields')
        if not all(isinstance(value, str) for value in row):
            raise ValueError(f'JSON row {number}: all fields must be strings; null is rejected')
    return rows


def read_csv(path):
    with path.open('r', encoding='utf-8', newline='') as stream:
        reader = csv.reader(stream, delimiter=',', quotechar='"',
                            doublequote=True, strict=True)
        if next(reader, None) != HEADER:
            raise ValueError('CSV header must be exactly id,qty,memo in that order')
        restored = []
        for number, row in enumerate(reader, 1):
            if len(row) != len(HEADER):
                raise ValueError(f'CSV row {number}: expected three fields, got {len(row)}')
            restored.append(row)
        physical_lines = reader.line_num
    return restored, physical_lines


def write_json(path, value):
    with path.open('x', encoding='utf-8', newline='\n') as stream:
        json.dump(value, stream, ensure_ascii=False, indent=2)
        stream.write('\n')


def roundtrip(source, output):
    source, output = Path(source), Path(output)
    rows = load_rows(source)
    output.mkdir()  # Exclusive: an existing file/directory is an error.
    csv_path = output / 'memo.csv'
    with csv_path.open('x', encoding='utf-8', newline='') as stream:
        writer = csv.writer(stream, delimiter=',', quotechar='"',
                            doublequote=True, quoting=csv.QUOTE_MINIMAL,
                            lineterminator='\r\n')
        writer.writerow(HEADER)
        writer.writerows(rows)
    restored, physical_lines = read_csv(csv_path)
    if restored != rows:
        raise ValueError('CSV roundtrip changed a field or row order')
    write_json(output / 'restored.json', restored)
    summary = {'header': HEADER, 'data_records': len(rows),
               'fields_per_record': len(HEADER), 'physical_lines': physical_lines,
               'record_terminator': 'CRLF', 'roundtrip_equal': True}
    write_json(output / 'summary.json', summary)
    return summary


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('source', type=Path, help='UTF-8 JSON list of three-string rows')
    parser.add_argument('output', type=Path, help='new directory; parent must already exist')
    args = parser.parse_args()
    try:
        summary = roundtrip(args.source, args.output)
    except (OSError, ValueError, csv.Error, UnicodeError) as error:
        print(f'ERROR: {error}', file=sys.stderr)
        return 2
    print(json.dumps(summary, ensure_ascii=False, indent=2))
    return 0


if __name__ == '__main__':
    sys.exit(main())
newline=''은 CSV 모듈이 줄바꿈 처리를 맡도록 하는 설정입니다. 재읽을 때 기본 줄바꿈 변환을 적용하면 메모의 CRLF가 LF로 바뀔 수 있습니다. 쓰는 쪽에서도 플랫폼의 줄 끝 변환이 겹치지 않도록 같은 설정을 둡니다. Python csv 줄바꿈 주의사항, QUOTE_MINIMAL 설명
입력 목록을 먼저 검증한 다음 mkdir()로 새 출력 폴더를 만듭니다. 파일도 x 모드로 새로 만들며, 같은 이름의 기존 파일을 덮어쓰지 않습니다. CSV를 재읽은 결과가 입력과 다르면 복원 JSON과 완료 요약을 쓰기 전에 멈춥니다. open의 x 모드, Path.mkdir 문서
5. 오류를 고칠 때 이전 결과를 남깁니다
방금 쓴 명령을 같은 출력 이름으로 다시 실행하면 ERROR와 종료 코드 2가 나와야 합니다. 기존 결과를 지우지 말고 새 이름으로 재실행하세요. 같은 입력에서 생성한 두 새 폴더의 결과 세 파일은 바이트까지 같습니다.
python3 csv_roundtrip.py fixtures/memos.json ../p14_run_01
python3 csv_roundtrip.py fixtures/memos.json ../p14_run_02
첫 명령은 기존 폴더 충돌을 확인하는 실패 시험, 두 번째는 새 폴더를 만드는 정상 재실행입니다. 이미 p14_run_02도 있다면 아직 없는 다른 이름을 정합니다.
fixtures/invalid_null.json은 문자열 자리에 null을 넣은 반례입니다. 아래 명령은 종료 코드 2로 멈추고 출력 폴더를 만들지 않아야 합니다. 입력을 억지로 빈 문자열로 바꾸지 말고, 누락값과 빈 메모를 원본 규칙에 따라 구별하세요.
python3 csv_roundtrip.py fixtures/invalid_null.json ../p14_null_rejected- JSON 문법이 잘못되면 오류 메시지의 위치와 원본을 대조합니다. JSON 파일에는 주석이나 줄 번호를 추가하지 않습니다.
- UTF-8이 아니거나 100,000바이트를 넘으면 원본 생성 설정·범위를 확인하고, 검증한 작은 별도 사본으로 연습합니다. 읽기 오류를
ignore로 숨기지 않습니다. - 필드가 2개·4개이거나 숫자 값이 섞이면 입력 계약을 확인합니다.
"02"와2를 같은 원문으로 취급하지 않습니다. - 쓰기 권한이 없거나 부모 폴더가 없으면 이미 허용된 연습 위치에 새 이름을 지정합니다. 보안 설정을 바꾸는 코드는 없습니다.
폴더를 만든 뒤 저장·재읽기·검산이 실패하면 부분 결과를 그대로 남깁니다. 파일이 보인다는 이유만으로 완료 결과로 사용하지 마세요. 종료 코드 0, 요약의 정상 값, 복원 문자열 대조가 함께 통과해야 합니다. 실패한 폴더는 원인을 검토하고 다음 실행에는 새 이름을 사용합니다.
6. 데이터 보존과 Excel에서의 안전한 열기를 구별합니다
쉼표와 큰따옴표를 올바르게 인용해도 스프레드시트의 수식 실행을 막는 보안 처리가 되지는 않습니다. 예를 들어 fixtures/formula_string.json의 메모 "=1+1"은 Python 왕복 뒤에도 같은 문자열로 남습니다. 이 시험에서는 수식을 계산하거나 Excel을 열지 않습니다.
외부에서 받은 CSV를 Excel 같은 앱으로 열면 수식처럼 시작하는 값이 해석될 위험이 있습니다. 원문 보존용 결과는 자동으로 더블클릭해 열지 말고, 출처를 검토한 뒤 소비 프로그램의 문서에 맞는 텍스트 가져오기 정책을 별도로 확인하세요. 사람에게 보여 줄 안전한 출력이 필요하면 별도 파일과 별도 검증으로 준비하고, 바뀐 값이 원문과 동일하다고 표시하지 않습니다. 따옴표나 탭·작은따옴표 접두어가 모든 앱에서 안전하다고 단정하지 않습니다. OWASP CSV Injection 설명
7. 실제 확인한 범위와 다음 적용 조건
가상 입력과 전체 코드는 2026-10-10에 CPython 3.12.14, Linux에서 실제 실행했습니다. 제공 테스트와 별도 독립 시험에서 정상 2×3·물리 4줄, LF·CRLF·단독 CR·메모 끝 LF·빈 메모·큰따옴표·공백·앞자리 0의 문자열 보존, 잘못된 JSON·비문자열·최종 링크·출력 충돌·재실행·부분 결과 보존을 확인했습니다. 자세한 실제 기록과 버전은 ZIP의 README와 evidence 폴더에 있습니다.
Windows 실행, 실제 Excel UI의 가져오기·표시·재저장·계산은 검증하지 않았습니다. 공식 Python 3.12 문서는 같은 조사일에 확인했으며 페이지 표기는 3.12.15였습니다. 실행 패치 버전 3.12.14와 구별합니다.
원본을 수정·이동·삭제하는 코드는 없습니다. 입력의 최종 경로만 링크 검사하며 조상 경로의 링크·Windows junction 전체를 거부하는 구현은 아닙니다. 검사와 파일 열기 사이의 경쟁 조건이나 다른 프로세스의 변경을 막는 잠금 기능도 없습니다. 직접 만든 링크 없는 개인 연습 폴더와 쓰기가 끝난 오프라인 사본을 사용하세요. 이 작은 실습은 동시 수정 중인 운영 파일의 안전한 백업·변경 감시 도구가 아닙니다.
인코딩 변환이 필요하면 한글 CSV UTF-8 변환 검산, 기존 파일의 열 수가 틀리면 CSV 필드 수와 원문 위치 진단, 구분자가 다르면 구분자 직접 지정하기를 이어서 보세요. 이번 저장의 완료 기준은 저장된 CSV를 다시 읽어 모든 문자열이 같은지 확인하는 것입니다.
작성자 소개
