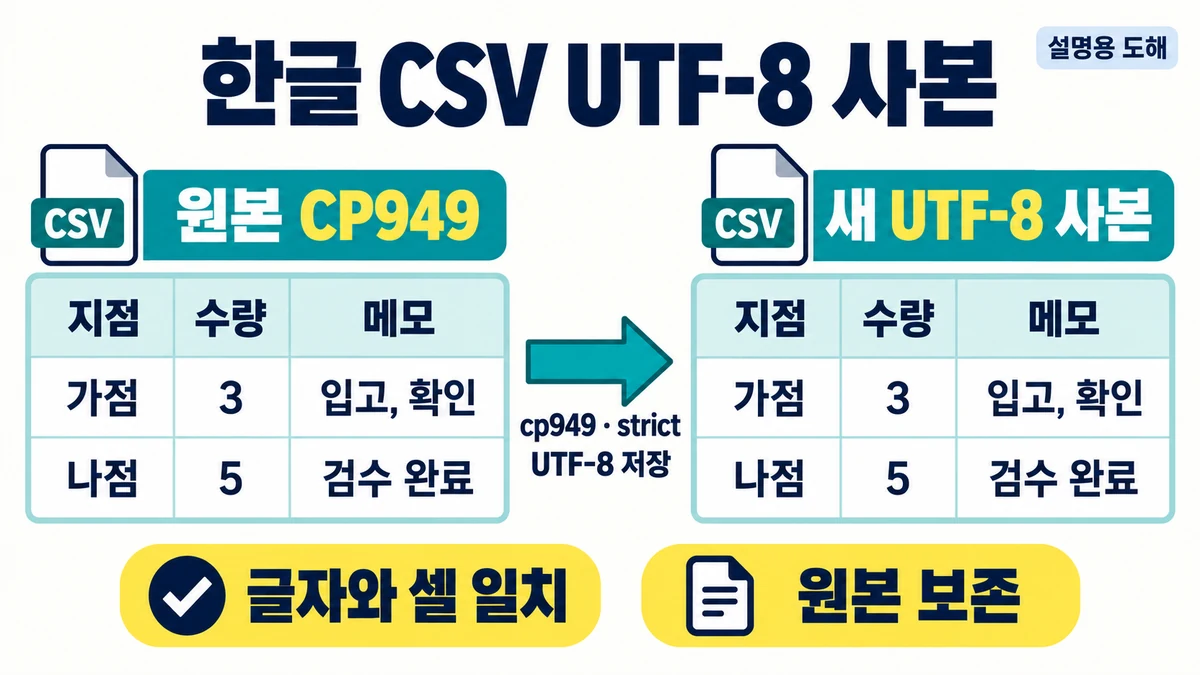
한글 CSV를 UTF-8로 바꾸고 글자가 그대로인지 검산하기
한글 CSV를 다른 프로그램에 넘겨야 한다면 원본 인코딩을
확인하고, 별도의 UTF-8 파일로 바꾼 뒤 글자와 셀 값을 다시
비교하세요. 원본 파일은 그대로 둡니다. 이 예제는 읽을 수 없는
바이트를 만나면 저장 전에 멈추며, 이미 있는 결과 파일도 덮어쓰지
않습니다.
예를 들어 지점별 수량 파일을 cp949로 받은 뒤 UTF-8만
받는 업무 도구에 제출하는 상황입니다. 파일명 끝을 .csv로
바꾸는 것으로는 인코딩이 바뀌지 않습니다. 여기서는 두 지점의 가상 자료로
변환과 검산을 함께 해 봅니다.
1. 원본 인코딩과 작업 범위
정하기
파일을 만든 프로그램의 내보내기 설정이나 보낸 사람에게 확인한
인코딩을 사용합니다. 이 코드가 받는 값은 다음 세 가지입니다.
| 확인한 원본 형식 | 명령에 넣을 값 | 처리 방식 |
|---|---|---|
| CP949 | cp949 |
바이트를 CP949로 엄격하게 읽음 |
| BOM 없는 UTF-8 | utf-8 |
UTF-8로 읽음. 이미 UTF-8이어도 별도 사본을 만들 수 있음 |
| 선두 BOM이 있는 UTF-8 | utf-8-sig |
선두 BOM 한 개만 인코딩 표시로 처리함 |
Python의 strict 처리는 읽을 수 없는 바이트가 있으면
오류를 냅니다. ignore는 잘못된 부분을 지나칠 수 있으므로 이
실습에서는 사용하지 않습니다. utf-8-sig는 선두 BOM을 읽을
때 제외하고, 다시 같은 인코딩으로 바꾸면 BOM을 붙입니다. 이 동작을 원본
바이트 왕복검사에 사용합니다. Python
codecs 공식 문서, UTF-8
BOM 설명
엄격한 읽기와 왕복검사를 통과해도 원본 인코딩을 맞게 고른
것까지 증명되지는 않습니다. 다른 인코딩으로도 오류 없이 읽히는
바이트가 있을 수 있습니다. 결과의 지점명처럼 의미를 아는 값도 원래
자료와 대조해야 합니다. 인코딩을 모르면 값을 바꿔 가며 통과시키지 말고
원본 생성 설정부터 확인하세요.
실습은 쉼표로 구분된 CSV, 헤더 한 행과 데이터 기록 한 개 이상, 입력
1,000,000바이트 이하를 대상으로 합니다. 기본 CSV 파서가 거부하는
구문이나 너무 긴 필드도 멈출 수 있습니다. 필수 열, 열 개수, 숫자 범위는
검사하지 않습니다. 변환 프로그램이 수량의 업무상 정확성을 승인하는 것은
아닙니다.
2. 가상 CSV와 다운로드 구성
확인하기
실습 ZIP 다운로드를 새 빈 폴더에 풉니다.
code, fixtures, tests,
expected 폴더와 README.md가 보이면 준비된
것입니다. 원본 업무 파일을 처음부터 넣지 말고 동봉한 자료로 결과를
확인하세요. 외부 패키지는 필요하지 않습니다.
fixtures/branches_cp949.csv의 내용은 아래와 같습니다.
실제 파일은 CP949, 줄 끝은 CRLF입니다.
지점,수량,메모
가점,3,"입고, 확인"
나점,5,검수 완료
메모의 쉼표는 따옴표 안에 있으므로 입고, 확인이라는 셀
하나입니다. 숫자 문자열 3과 5도 계산하거나
다시 형식화하지 않습니다. 코드가 CSV를 새로 조립하지 않고 전체 글자를
UTF-8로 바꾸므로 원래 따옴표와 줄 끝도 유지합니다.
같은 내용에 UTF-8 BOM을 붙인 branches_utf8_bom.csv와
잘못된 바이트가 들어간 invalid_cp949.csv도 동봉했습니다.
expected/converted_utf8.csv는 정상 변환을 대조할
파일입니다. 이 파일을 출력 경로로 지정하면 기존 파일이므로
거부됩니다.
3. 새 UTF-8 사본 만들기
압축을 푼 폴더에서 터미널을 열고 Python을 먼저 확인합니다.
python3 --version이 글의 실행 명령은 python3입니다. PC에서 쓰는 Python
실행 이름이 다르면 같은 인터프리터를 가리키는 이름으로 바꿔 사용하세요.
명령을 찾지 못하거나 버전 확인이 실패하면 변환을 실행하지 말고 Python
설치와 실행 환경을 먼저 확인합니다.
다음 명령은 동봉한 CP949 파일을 읽어 현재 폴더에 새
converted_utf8.csv를 만듭니다.
python3 code/csv_utf8_copy.py --input fixtures/branches_cp949.csv --source-encoding cp949 --out converted_utf8.csv정상 출력은 다음과 같습니다.
{"status": "OK", "data_records": 2, "source_byte_roundtrip_equal": true, "utf8_text_equal": true, "csv_cells_equal": true, "source_unchanged_observed": true, "output_bom": false}data_records가2이면 헤더를 제외한 CSV
기록 두 개를 읽은 것입니다. 빈 줄처럼 필드가 하나도 없는 CSV 기록은
개수에서 빼되 파일의 글자는 그대로 보존합니다. 헤더 뒤에 그런 빈 기록만
있으면 멈춥니다. 따옴표로 표시한 빈 셀은 필드가 있는 기록으로 셉니다. 셀
값의 유효성은 이 코드에서 검사하지 않습니다. 따옴표 안 줄바꿈이 있다면
화면의 줄 수와 기록 수는 다를 수 있습니다.source_byte_roundtrip_equal은 읽은 글자를 원본
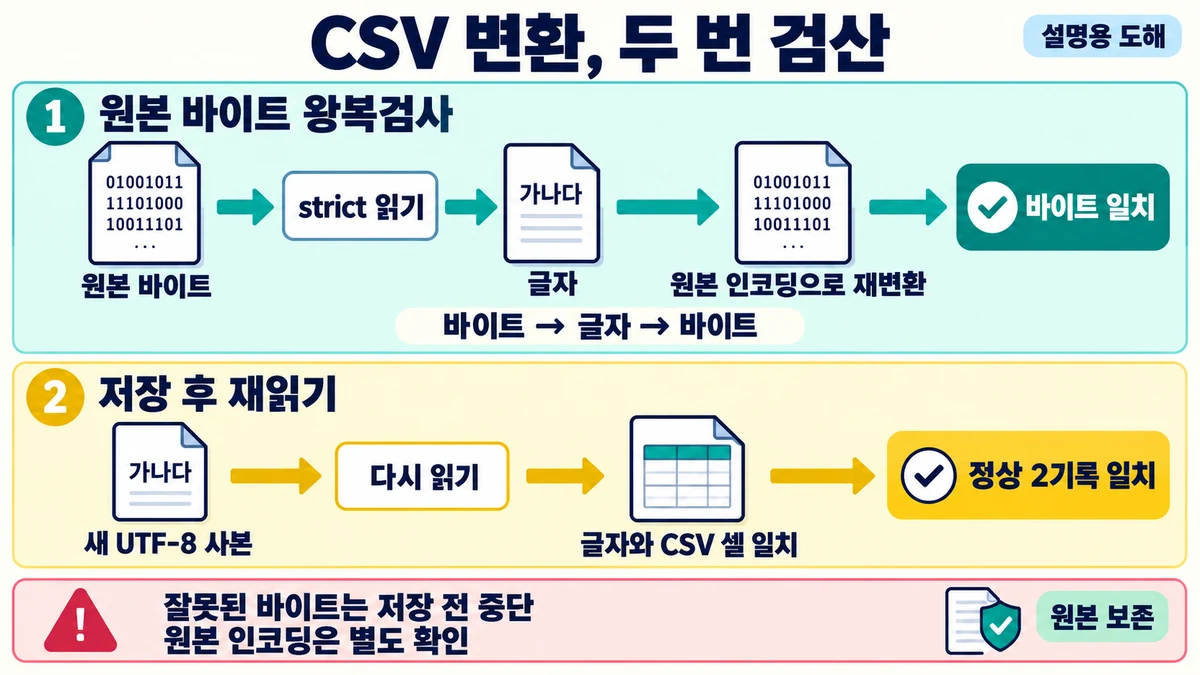
인코딩으로 다시 바꿨을 때 처음 읽은 바이트와 같다는 뜻입니다.utf8_text_equal과csv_cells_equal은 저장한
UTF-8 파일을 다시 읽어 글자 전체와 파싱된 셀 목록을 각각 비교했다는
뜻입니다.source_unchanged_observed는 저장 전후 다시 읽은 원본
바이트가 처음과 같았다는 뜻입니다. 파일을 잠그거나 다른 프로그램의
수정을 계속 감시하는 기능은 아닙니다.output_bom: false는 이 정상 결과가 선두 BOM 없는
UTF-8이라는 뜻입니다.
converted_utf8.csv를 UTF-8로 읽었을 때 헤더는
지점,수량,메모, 데이터는 가점·3·입고, 확인과 나점·5·검수
완료가 되어야 합니다. 인코딩을 바꿨으므로 CP949 원본과 UTF-8 출력의
바이트 수가 같을 필요는 없습니다.
UTF-8 BOM 입력은 출력 이름과 원본 인코딩을 바꿔 실행합니다.
python3 code/csv_utf8_copy.py --input fixtures/branches_utf8_bom.csv --source-encoding utf-8-sig --out bom_copy_utf8.csv위 정상 JSON과 같은 결과가 나오고, 두 출력 CSV의 바이트가 같습니다.
이 예제는 utf-8-sig를 골랐을 때 실제 선두 BOM이 있어야
합니다. BOM 없이 이 값을 고르면 멈추며, BOM이 두 번 이어진 경우도
자동으로 지우지 않습니다. 파일 내부의 공백이나 글자는 정리하지
않습니다.
4. 전체 코드와 검사 순서 읽기
다운로드의 code/csv_utf8_copy.py와 아래 코드는
같습니다.
import argparse
import codecs
import csv
import io
import json
from pathlib import Path
import sys

MAX_BYTES = 1_000_000
ENCODINGS = ('cp949', 'utf-8', 'utf-8-sig')


class PracticeError(ValueError):
    pass


def read_limited(path):
    with path.open('rb') as handle:
        raw = handle.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise PracticeError('INPUT_OVER_1000000_BYTES')
    return raw


def parse_rows(text):
    try:
        rows = list(csv.reader(io.StringIO(text, newline=''), strict=True))
    except csv.Error as exc:
        raise PracticeError('CSV_PARSE_ERROR') from exc
    if not rows or not rows[0]:
        raise PracticeError('NO_HEADER')
    if not any(rows[1:]):
        raise PracticeError('NO_DATA_RECORDS')
    return rows


def convert(source, target, encoding):
    source, target = Path(source), Path(target)
    if encoding not in ENCODINGS:
        raise PracticeError('UNSUPPORTED_SOURCE_ENCODING')
    if source.suffix.lower() != '.csv' or target.suffix.lower() != '.csv':
        raise PracticeError('USE_CSV_FILENAMES')
    if source.is_symlink():
        raise PracticeError('INPUT_SYMLINK_NOT_ALLOWED')
    if source.resolve() == target.resolve():
        raise PracticeError('USE_SEPARATE_OUTPUT')
    raw = read_limited(source)
    if encoding == 'utf-8-sig' and not raw.startswith(codecs.BOM_UTF8):
        raise PracticeError('UTF8_SIG_REQUIRES_LEADING_BOM')
    if encoding == 'utf-8' and raw.startswith(codecs.BOM_UTF8):
        raise PracticeError('BOM_INPUT_USE_UTF8_SIG')
    try:
        text = raw.decode(encoding, errors='strict')
        source_again = text.encode(encoding, errors='strict')
    except UnicodeError as exc:
        raise PracticeError('INVALID_BYTES_FOR_DECLARED_ENCODING') from exc
    if text.startswith('\ufeff'):
        raise PracticeError('EXTRA_LEADING_BOM_NOT_REMOVED')
    if source_again != raw:
        raise PracticeError('SOURCE_BYTE_ROUNDTRIP_MISMATCH')
    rows = parse_rows(text)
    encoded = text.encode('utf-8', errors='strict')
    if encoded.decode('utf-8', errors='strict') != text:
        raise PracticeError('UTF8_TEXT_ROUNDTRIP_MISMATCH')
    if read_limited(source) != raw:
        raise PracticeError('INPUT_CHANGED_BEFORE_SAVE')
    # Exclusive creation: existing files and symlinks are not overwritten.
    with target.open('xb') as handle:
        handle.write(encoded)
    saved = target.read_bytes()
    saved_text = saved.decode('utf-8', errors='strict')
    if saved != encoded or saved_text != text or parse_rows(saved_text) != rows:
        raise PracticeError('SAVED_COPY_MISMATCH_PRESERVE_OUTPUT')
    if read_limited(source) != raw:
        raise PracticeError('INPUT_CHANGED_AFTER_SAVE_PRESERVE_OUTPUT')
    return {
        'status': 'OK',
        'data_records': sum(bool(row) for row in rows[1:]),
        'source_byte_roundtrip_equal': True,
        'utf8_text_equal': True,
        'csv_cells_equal': True,
        'source_unchanged_observed': True,
        'output_bom': False,
    }


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--input', required=True)
    parser.add_argument('--source-encoding', required=True, choices=ENCODINGS)
    parser.add_argument('--out', required=True)
    args = parser.parse_args()
    try:
        result = convert(args.input, args.out, args.source_encoding)
    except FileExistsError:
        result = {'status': 'ERROR', 'reason': 'OUTPUT_ALREADY_EXISTS'}
    except (PracticeError, OSError, UnicodeError) as exc:
        result = {'status': 'ERROR', 'reason': str(exc)}
    print(json.dumps(result, ensure_ascii=False))
    return 0 if result['status'] == 'OK' else 2


if __name__ == '__main__':
    sys.exit(main())
코드는 원본 바이트를 읽고, 명시한 인코딩으로 글자를 만든 뒤 원본
바이트로 되돌려 비교합니다. 그다음 UTF-8 바이트를 만들고, 실제 파일에
저장한 것을 다시 읽어 비교합니다. CSV 셀 비교에는
csv.reader와 줄바꿈을 그대로 다루는
StringIO(..., newline='')를 사용합니다. CSV의 따옴표와
줄바꿈 처리는 Python CSV 파서에 맡깁니다. Python csv 공식
문서
저장은 xb 모드로 새 파일만 만들도록 했습니다. 이미 있는
경로는 실패하고 내용이 지워지지 않습니다. 별도 출력 경로라는 검사도 먼저
합니다. 입력 파일의 심볼릭 링크는 이 실습에서 받지 않습니다. Python
open 공식 문서
5. 잘못된 바이트와 기존
결과를 다루기
동봉한 실패 파일을 실행합니다.
python3 code/csv_utf8_copy.py --input fixtures/invalid_cp949.csv --source-encoding cp949 --out invalid_copy.csv예상 출력은 다음과 같고 종료 코드는 2입니다.
invalid_copy.csv는 만들어지지 않습니다.
{"status": "ERROR", "reason": "INVALID_BYTES_FOR_DECLARED_ENCODING"}이때 errors='ignore'로 바꾸거나 깨진 글자를 임의로
삭제해서 제출 파일을 만들지 마세요. 원본 인코딩이 맞는지 확인하고,
파일이 전송 과정에서 손상됐거나 이미 깨져 저장된 것은 아닌지 원본
제공자에게 확인합니다. 이미 잘못된 글자로 저장된 CSV는 이 변환만으로
되살릴 수 없습니다.
| 오류 표시 | 다음 확인 |
|---|---|
OUTPUT_ALREADY_EXISTS |
기존 결과를 보존하고 --out에 아직 없는 다른 이름지정 |
USE_SEPARATE_OUTPUT |
원본과 다른 새 CSV 경로 지정 |
BOM_INPUT_USE_UTF8_SIG |
원본이 UTF-8 BOM임을 확인한 뒤 utf-8-sig로 지정 |
UTF8_SIG_REQUIRES_LEADING_BOM |
원본 생성 설정에서 BOM 여부 확인. BOM이 없고 UTF-8임이 확인됐다면utf-8 사용 |
EXTRA_LEADING_BOM_NOT_REMOVED |
선두 표시가 중복된 이유를 원본에서 확인. 자동 삭제하지 않음 |
CSV_PARSE_ERROR |
따옴표, 구분자 형식, 필드 길이를 원본 생성 프로그램에서 확인 |
NO_HEADER 또는 NO_DATA_RECORDS |
빈 파일이나 헤더만 내보낸 것은 아닌지 확인 |
INPUT_OVER_1000000_BYTES |
실습 한도 초과. 한도를 무작정 없애지 말고 더 큰 파일을 처리할 방법 별도 검토 |
INPUT_CHANGED_BEFORE_SAVE |
원본 작성·동기화를 멈추고 고정된 사본을 새 경로로 다시 검증 |
정상 명령을 같은 출력 이름으로 다시 실행하면
OUTPUT_ALREADY_EXISTS와 종료 코드 2가
나옵니다. 첫 결과는 그대로 남습니다. 기존 결과가 있다는 이유로 원본이나
결과를 지우는 코드는 없습니다.
저장 도중 권한·디스크 오류가 나거나 저장 후 검산에 실패하면 새 경로에
불완전한 파일이 남을 수 있습니다.
SAVED_COPY_MISMATCH_PRESERVE_OUTPUT 또는
INPUT_CHANGED_AFTER_SAVE_PRESERVE_OUTPUT이면 그 파일을
완료본으로 쓰지 말고 오류 문구와 함께 보존하세요. 원인을 확인한 뒤
고정된 원본 사본과 새 출력 이름으로 다시 검사합니다. 이 코드는 실패
파일도 자동 삭제하지 않습니다.
6. 검산을 재실행하고 제출
전에 확인하기
동봉한 테스트는 가상 자료만 별도 임시 폴더에 만들어 실행합니다. 실행
명령은 다음과 같습니다.
python3 -m unittest discover -s tests -v이 자료는 Linux의 Python 3.12.14에서 CP949·UTF-8 BOM 정상 변환,
잘못된 바이트, 기존 출력 보호, 따옴표 안 줄바꿈, 입력 크기 경계를 포함한
29개 테스트가 통과했습니다. 권한 오류와 읽는 중 변경·저장 후 불일치는
테스트에서 조건을 주입한 모의 검사이며, 실제 권한 장애를 일으킨 것은
아닙니다. 실행 환경과 원본 SHA-256 전후 값은 ZIP의
test_results.json에 담았습니다.
업무 파일에 적용할 때는 파일을 쓰는 프로그램을 닫고 원본을 별도로
보관한 뒤 사본에서 진행합니다. 다음 항목을 확인한 결과만 제출하세요.
- 생성 프로그램에서 확인한 원본 인코딩과 명령의 값이 같음
- 결과가
OK이고 입력 기록의 지점명·수량·메모를 실제
원본과 대조함 - 입력과 출력 이름이 다르고 원본을 덮어쓰지 않음
- 제출받는 도구가 BOM 없는 UTF-8을 받는지 확인함
- 숫자·필수 열·수식 해석 등 업무 규칙은 필요한 검사로 따로 확인함
출력이 OK여도 다른 프로그램이 CSV를 어떤 열 형식으로
가져오는지는 별도입니다. 수량 합계를 만들려면 CSV
점포 수량을 합쳐 XLSX 저장값을 검산하는 예제처럼 입력 계약과 저장값
검사가 추가로 필요합니다. Python 실행 환경이 준비되지 않았다면 Python
실행 경로와 설치 환경을 확인하는 안내에서 실행 경로와 설치 환경을
먼저 확인하세요.
실습 자료와 공식 문서
실습 ZIP 다운로드에는 전체 코드, 정상·실패
가상 CSV, 기대 UTF-8 결과, README, 테스트와 실제 실행 기록을 넣었습니다.
ZIP은 외부 패키지나 업무 원본 파일을 포함하지 않습니다.
XLSX의 실행안내와 입력과기대결과 시트에서 가상 지점 자료와 비교값을 읽을 수 있습니다. 원본 CSV의 인코딩·바이트 검산과 Python 실행은 ZIP의 원본 파일과 코드로 진행하세요.
공식 문서 조회일은 2026-10-05이며 조회된 문서 버전은 Python
3.14.8입니다. 이 실습을 실행한 Python은 3.12.14입니다.
작성자 소개
