openpyxl로 CSV 점포 수량 합계 만들기: 3행 입력과 저장값 검산
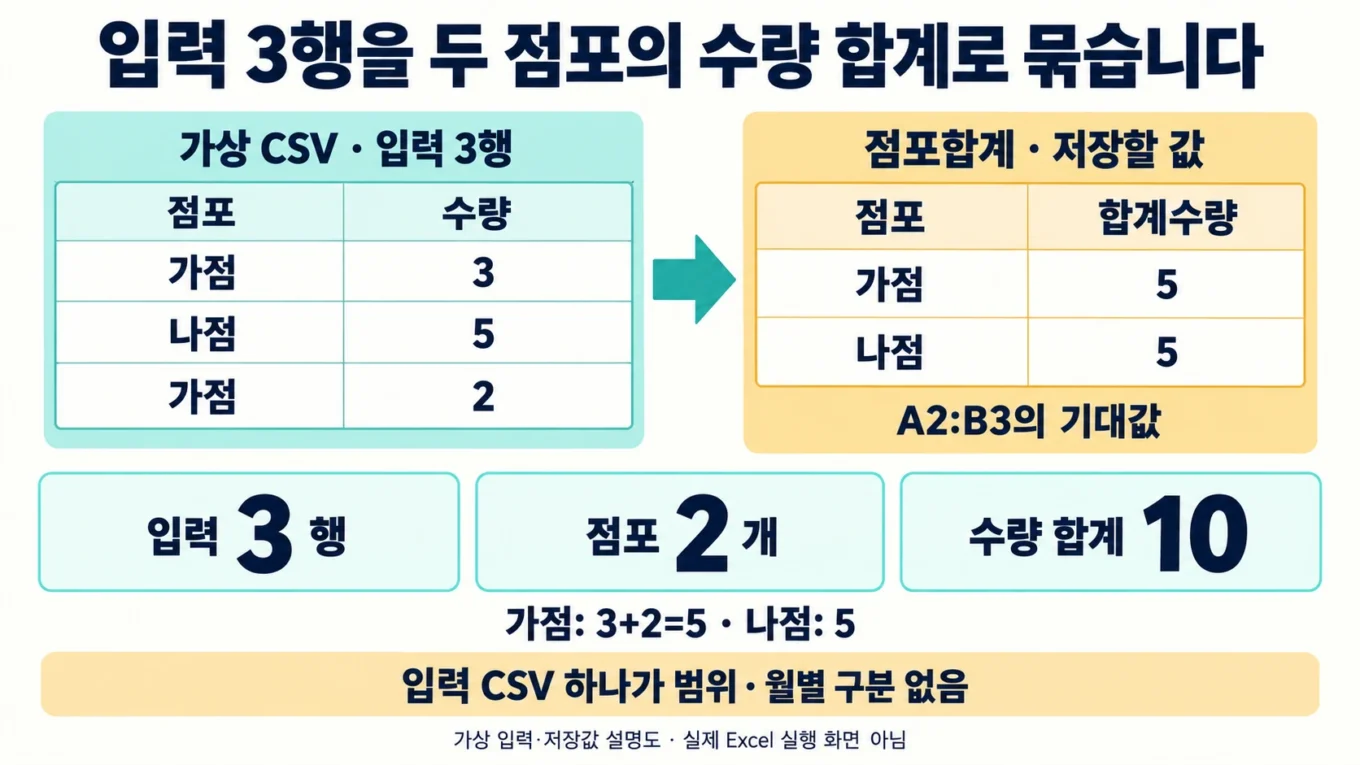
CSV에 같은 점포가 여러 번 나오면 행 개수와 합계 수량을 혼동하기 쉽습니다. 이 예제는 가점 두 행을 합쳐 5개, 나점 한 행을 5개로 저장합니다. 날짜 열이나 월별 필터는 없으므로 월간 실적이라고 부르지 않습니다. 입력 파일 하나가 집계 범위이며, 점포 이름의 앞뒤 공백만 제거합니다. 실제 매장 자료가 아닌 아래 세 행을 사용합니다.
준비: CSV 세 행과 새 출력 경로
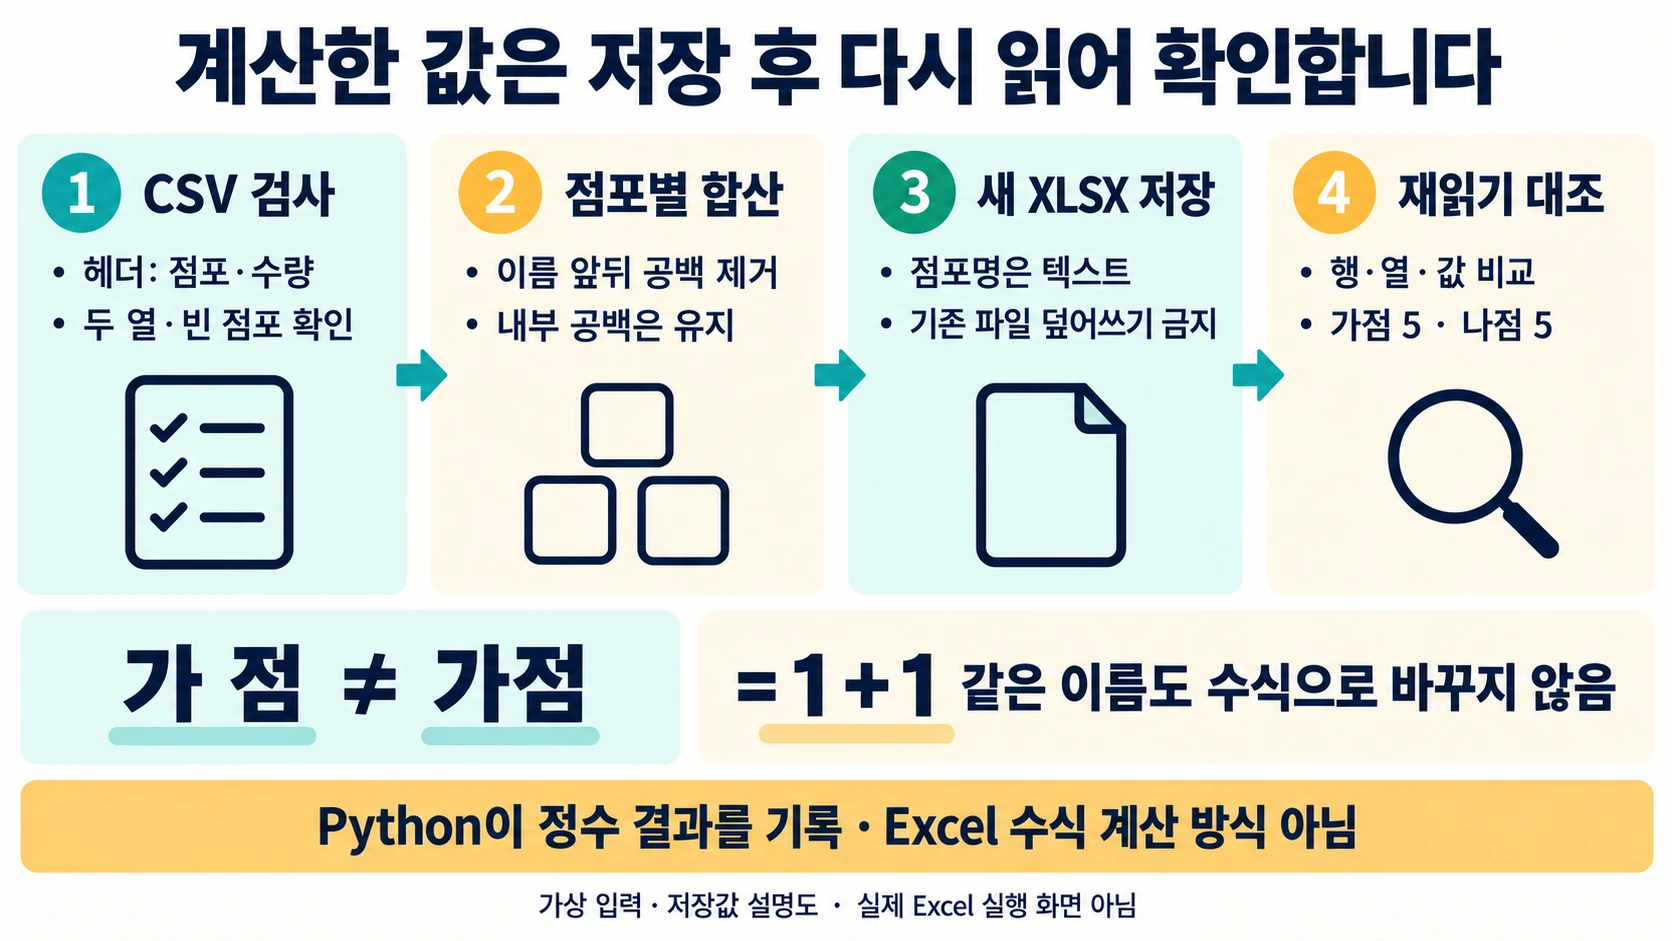
Python과 openpyxl이 설치된 환경에서 ZIP을 빈 실습 폴더에 풉니다. rows.csv와 csv_to_excel.py를 같은 폴더에 두고 그 폴더에서 실행합니다. 검산 환경은 ZIP의 verification.json에 남겼습니다. 이 예제는 수식을 Excel에 넣는 방식이 아니라 Python이 계산한 정수 결과를 셀에 기록하는 방식입니다.
점포,수량
가점,3
나점,5
가점,2
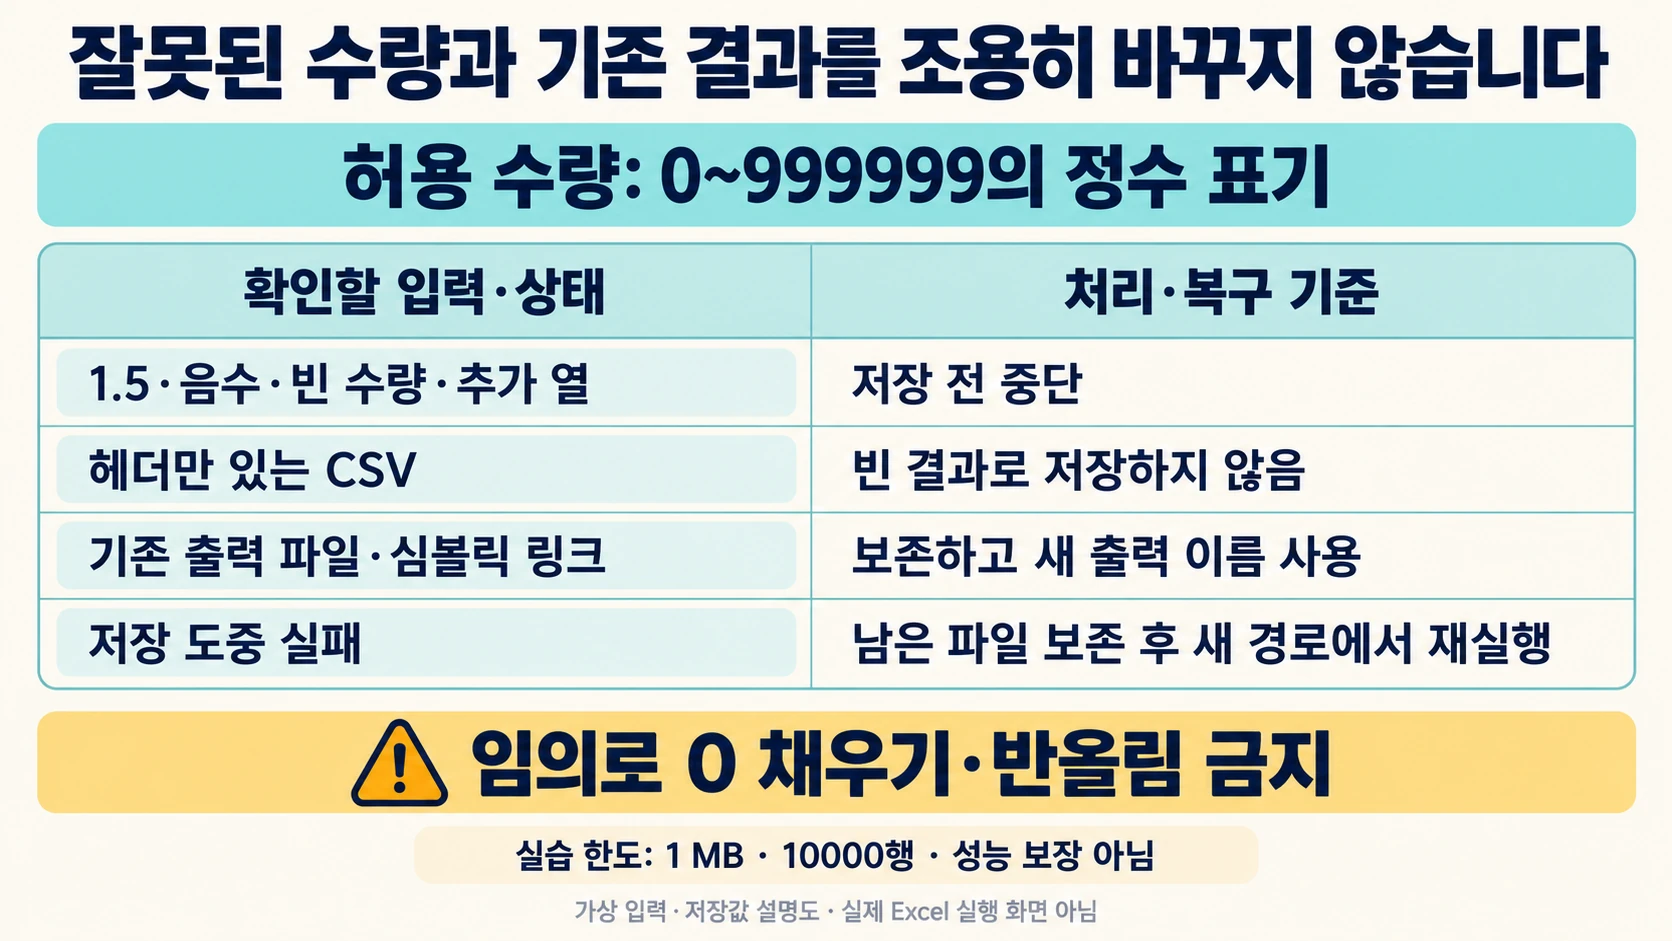
정수 수량은 0부터 999999까지 허용합니다. 1.5, 음수, 빈 수량, 추가 열은 거부하며 아무 값이나 0으로 바꾸지 않습니다. 점포 이름은 대소문자나 내부 공백을 합치지 않습니다. 예를 들어 가 점과 가점은 서로 다른 점포입니다. 헤더만 있는 파일도 빈 결과로 저장하지 않고 중단합니다.
전체 코드: 검증 후 한 번만 저장
openpyxl의 Workbook.save()는 기존 파일을 경고 없이 덮어쓸 수 있습니다. 그래서 출력은 xb 모드로 먼저 확보합니다. 이미 같은 경로의 파일이나 심볼릭 링크가 있으면 덮어쓰지 않습니다. =1+1처럼 보이는 점포명도 텍스트 자료형으로 넣어 수식으로 바뀌지 않게 합니다. csv 모듈의 reader와 writer는 행을 읽고 쓰는 객체입니다. CSV의 따옴표 처리와 행 분리는 reader에 맡기고 열 개수는 별도로 검사합니다.
import argparse
import csv
import json
import re
from collections import Counter
from pathlib import Path
from openpyxl import Workbook, load_workbook
from openpyxl.styles import Font, PatternFill

LIMIT = 1_000_000

def collect(source):
    with Path(source).open('rb') as handle:
        raw = handle.read(LIMIT + 1)
    if len(raw) > LIMIT:
        raise ValueError('Practice CSV exceeds 1 MB.')
    import io
    reader = csv.reader(io.StringIO(raw.decode('utf-8-sig'), newline=''), strict=True)
    if next(reader, None) != ['점포', '수량']:
        raise ValueError('Expected header: 점포,수량')
    totals = Counter()
    count = 0
    for line, row in enumerate(reader, 2):
        if len(row) != 2 or not row[0].strip():
            raise ValueError(f'Line {line}: expected store and quantity.')
        store, quantity = row[0].strip(), row[1]
        if not re.fullmatch(r'[0-9]{1,6}', quantity):
            raise ValueError(f'Line {line}: quantity must be 0..999999 integer text.')
        # These labels will be spreadsheet text, never interpreted as formulas.
        totals[store] += int(quantity)
        count += 1
        if count > 10000:
            raise ValueError('Practice row limit exceeded.')
    if not count:
        raise ValueError('Header-only CSV is not a result.')
    return count, totals

def convert(source, target):
    source, target = Path(source), Path(target)
    if target.suffix.lower() != '.xlsx' or source.resolve() == target.resolve():
        raise ValueError('Use a separate NEW .xlsx filename.')
    count, totals = collect(source)
    wb = Workbook()
    ws = wb.active
    ws.title = '점포합계'
    ws.append(['점포', '합계수량'])
    for store, total in sorted(totals.items()):
        ws.append([store, total])
        ws.cell(ws.max_row, 1).data_type = 's'
        ws.cell(ws.max_row, 2).number_format = '#,##0'
    for cell in ws[1]:
        cell.font = Font(name='Arial', bold=True, color='FFFFFF')
        cell.fill = PatternFill('solid', fgColor='17365D')
    ws.column_dimensions['A'].width = 24
    ws.column_dimensions['B'].width = 18
    ws.freeze_panes = 'A2'
    ws.auto_filter.ref = ws.dimensions
    # Exclusive creation protects an existing result, including a symlink.
    with target.open('xb') as handle:
        wb.save(handle)
    expected = [('점포', '합계수량')] + sorted(totals.items())
    check = load_workbook(target, read_only=True, data_only=True)
    try:
        if list(check['점포합계'].values) != expected:
            raise RuntimeError('Saved cell values differ; preserve output for inspection.')
    finally:
        check.close()
    result = {'input_rows': count, 'stores': len(totals),
              'total_quantity': sum(totals.values()), 'readback_equal': True}
    return result

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--input', default='rows.csv')
    parser.add_argument('--out', default='store_totals.xlsx')
    args = parser.parse_args()
    print(json.dumps(convert(args.input, args.out), ensure_ascii=False))

if __name__ == '__main__':
    main()
실행과 셀 단위 예상 결과
python3 csv_to_excel.py
python3 -m unittest -v test_example.py
첫 명령은 store_totals.xlsx를 새로 만듭니다. 가점은 3+2=5이고 나점은 5이므로 합계는 10입니다. 시트 점포합계의 A1:B3은 다음과 같아야 합니다.
| 셀 행 | 점포 | 합계수량 |
|---|---|---|
| 1 | 점포 | 합계수량 |
| 2 | 가점 | 5 |
| 3 | 나점 | 5 |
표의 첫 행은 헤더이며 계산 대상이 아닙니다. 출력 JSON은 input_rows=3, stores=2, total_quantity=10, readback_equal=true를 담습니다. Python으로 실제 저장 후 다시 읽었고 테스트 5개가 통과했습니다. Microsoft Excel 앱을 직접 실행한 결과나 성능 측정은 아닙니다.
실패했을 때 보존할 것
가점,1.5로 바꾸면 저장 전에 ValueError가 발생해야 합니다. 숫자 표기를 수정할지 분수 수량을 허용할지는 업무 규칙을 먼저 정해야 하므로 이 예제는 자동 반올림하지 않습니다. 기존 출력이 있으면 --out second_totals.xlsx처럼 다른 이름을 사용합니다. 저장 도중 실패했다면 남은 파일을 보존해 원인을 확인하고 새 경로에서 다시 실행합니다.
적용 범위와 한계
CSV는 UTF-8 또는 UTF-8 BOM을 지원하며 1 MB와 10000행을 실습 한도로 둡니다. 이는 처리 성능 보장이 아닙니다. 여러 파일의 중복, 점포명 표준화, 월별 구분은 구현하지 않았습니다. 다운로드의 expected/store_totals.xlsx는 위 입력으로 만든 비교용 결과이며, 원본 입력을 바꾸면 같은 숫자가 나와야 한다는 뜻은 아닙니다.
실행 순서 정리
-
빈 실습 폴더에 rows.csv와 csv_to_excel.py를 저장하고 헤더와 세 행을 확인합니다.
-
그 폴더에서 python3 csv_to_excel.py를 실행해 새 store_totals.xlsx를 만듭니다.
-
점포합계 시트 A2:B3을 가점 5·나점 5와 비교하고 test_example.py의 실패 입력 검사를 실행합니다.
예제 흐름 그림
공식 자료
Tutorial — openpyxl 3.1.3 documentation
csv — CSV File Reading and Writing
출처 원문 수집일: S1 2026-09-24; S2 2026-09-24.
작성자 소개
