주문일에 유효한 단가를 Python으로 찾고 기간 공백·겹침 보류하기
같은 품목의 단가가 2월 1일부터 바뀌었다면, 1월 31일 주문과 2월 1일 주문에 같은 값을 붙일 수 없습니다. 품목만 조회하면 여러 이력 중 첫 행을 가져오기 쉽고, 가장 최근 단가를 쓰면 과거 주문까지 새 값으로 바뀝니다.
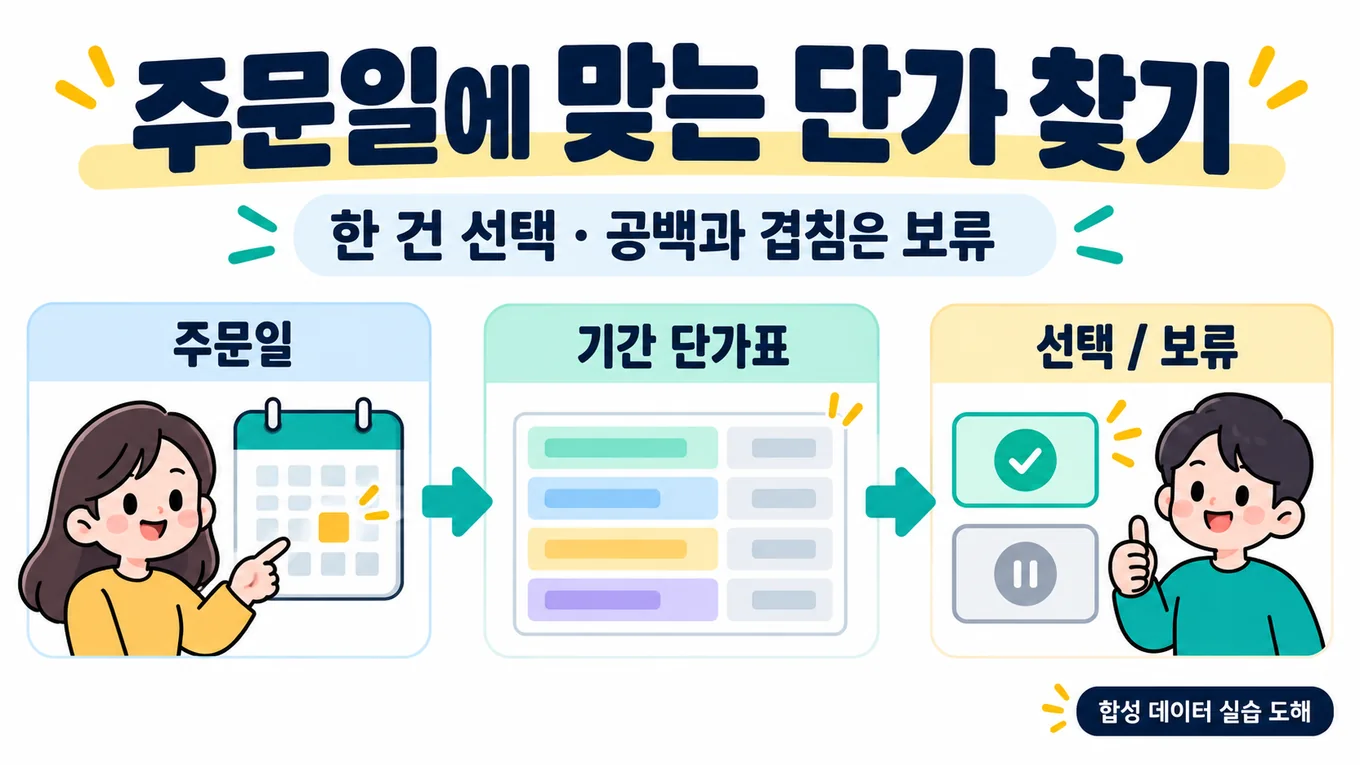
이번 실습은 주문일에 적용되는 단가가 정확히 한 건인지 확인합니다. 7행 단가표와 12행 주문표를 읽어 5건은 선택하고 7건은 이유와 함께 보류합니다. 선택한 주문의 합계는 USD 74.00, EUR 16.00이며 통화끼리 합치지 않습니다. 모든 입력은 직접 만든 합성 자료입니다. 실제 주문 승인이나 세금·회계·환율 규칙을 적용하는 도구가 아닙니다.
1. 날짜 경계와 조회 키부터 정합니다
이 파일의 적용 구간은 다음과 같습니다.
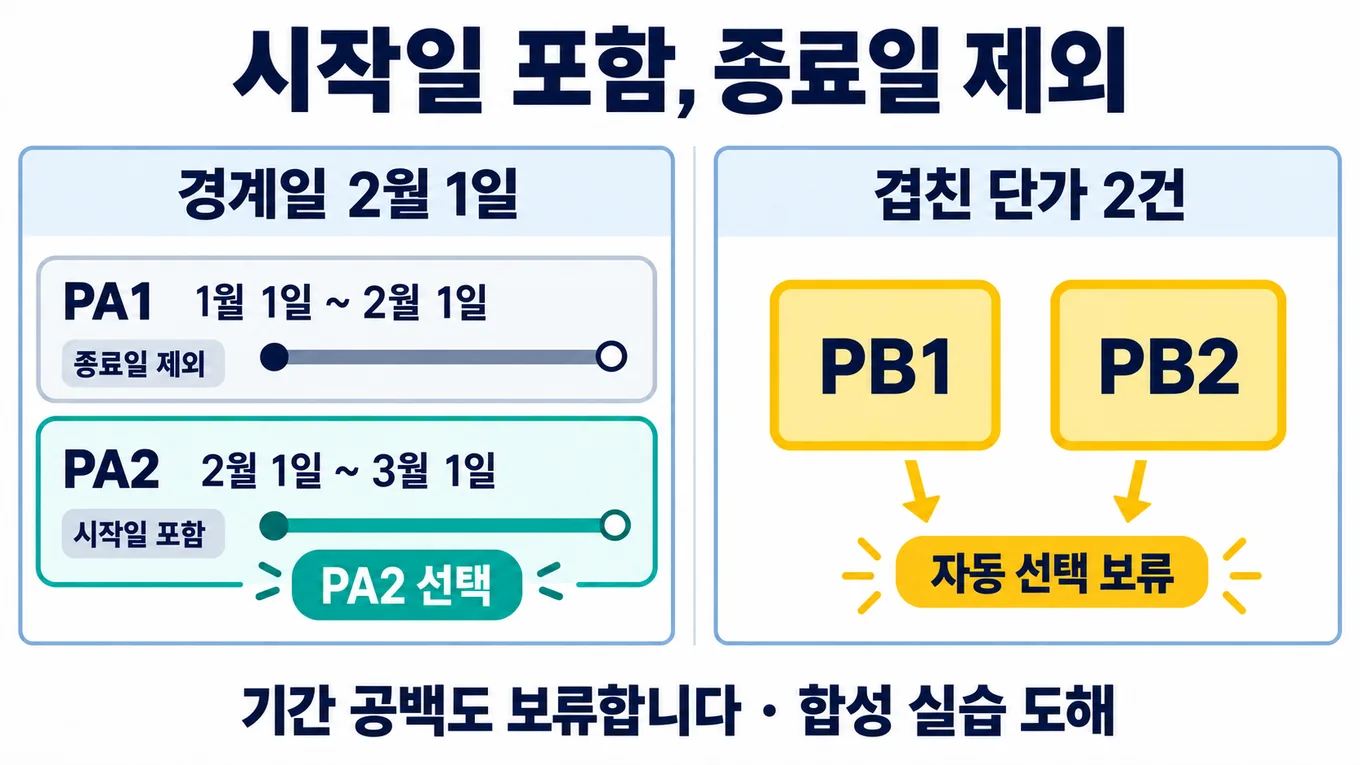
valid_from <= order_date < valid_to시작일은 포함하고 종료일은 포함하지 않습니다. A 품목의 USD 단가 PA1은 1월 1일부터 2월 1일 직전까지, PA2는 2월 1일부터 3월 1일 직전까지입니다. 따라서 2월 1일 주문 O02에는 PA2만 맞습니다. PA1의 종료일과 PA2의 시작일이 같아도 두 기간이 겹치지 않습니다.
종료일도 포함하는 업무 자료라면 이 정책을 그대로 복사하지 마세요. 원본 단가표 담당자에게 날짜의 의미를 확인한 뒤 입력 계약과 시험값을 함께 바꿔야 합니다. 시간 단위 단가나 환산 단가는 이번 범위에 없습니다.
조회 키는 item과 currency 두 값입니다. 같은 A라도 USD와 EUR는 서로 다른 단가표를 사용합니다. USD 단가가 있다고 GBP 주문을 USD로 바꾸거나 EUR 합계를 USD 합계에 더하지 않습니다.
2. 두 CSV를 준비합니다
실습 ZIP을 새 폴더에 풀고 input/prices.csv를 텍스트 편집기로 엽니다. 별도 패키지 설치 없이 Python 표준 라이브러리만 사용합니다. Python 3.12.14에서 아래 명령과 회귀시험을 실행했습니다.
price_id,item,currency,valid_from,valid_to,unit_price
PA1,A,USD,2026-01-01,2026-02-01,10.00
PA2,A,USD,2026-02-01,2026-03-01,12.00
PAE,A,EUR,2026-01-01,2026-03-01,8.00
PB1,B,USD,2026-01-01,2026-01-20,5.00
PB2,B,USD,2026-01-15,2026-02-01,6.00
PC1,C,USD,2026-01-01,2026-01-10,3.00
PC2,C,USD,2026-01-20,2026-02-01,4.00
B의 PB1과 PB2는 1월 15일부터 1월 20일 직전까지 겹칩니다. C는 1월 10일부터 1월 20일 직전까지 단가가 없습니다. 이 문제를 숨기지 않고 기간 진단표에도 남깁니다.
input/orders.csv는 다음 12행입니다. O09와 O12의 잘못된 날짜도 검토할 입력이므로 그대로 둡니다.
order_id,item,currency,order_date,qty
O01,A,USD,2026-01-31,2
O02,A,USD,2026-02-01,3
O03,A,USD,2026-03-01,1
O04,B,USD,2026-01-16,2
O05,C,USD,2026-01-15,1
O06,A,GBP,2026-01-15,1
O07,A,EUR,2026-01-15,2
O08,D,USD,2026-01-15,1
O09,A,USD,2026-02-30,1
O10,B,USD,2026-01-01,2
O11,C,USD,2026-01-20,2
O12,A,USD,2026-2-01,1
파일은 UTF-8 또는 UTF-8 BOM의 쉼표 CSV이며 열 이름과 순서가 정확히 맞아야 합니다. 가격표는 1~1,000행, 주문표는 0~10,000행, 각 파일은 4MiB 이하로 제한합니다. 주문표가 헤더만 있으면 0건으로 완료하며, 가격표가 헤더만 있으면 기준이 없어 중단합니다.
ID와 품목 코드는 전체 1~40자이며 첫 문자는 대문자 또는 숫자여야 합니다. 나머지는 대문자·숫자·밑줄·하이픈만 받습니다. 통화는 대문자 세 글자이며 실제 통화의 등록 여부까지 확인하는 기능은 없습니다. 수량은 1~1,000,000의 정수, 단가는 0 초과 999999.99 이하의 소수점 두 자리 문자열입니다. 소문자, 공백, 01 같은 수량을 임의로 정리하지 않습니다.
3. 새 결과 폴더로 실행합니다
README.md가 있는 폴더에서 터미널을 엽니다. Windows에 Python 실행기 py가 있는 경우 다음과 같이 실행합니다.
py -3 effective_prices.py --prices input/prices.csv --orders input/orders.csv --output result_01
py -3 verify_example.py result_01
macOS 또는 Linux에서는 py -3 대신 python3를 사용합니다. py가 인식되지 않으면 설치된 Python 실행 명령과 버전부터 확인하세요. 기존 업무 파일이나 보안 설정을 바꿔 해결하는 실습은 아닙니다.
첫 명령의 기대 콘솔은 다음과 같습니다.
{"matched_rows": 5, "held_rows": 7, "matched_totals_by_currency": {"EUR": "16.00", "USD": "74.00"}}두 번째 명령은 직접 작성한 expected 폴더의 고정 기대값과 결과를 대조합니다. 모든 조건이 맞으면 다음 문장이 표시됩니다.
PASS: 12 decisions, 2 period issues, USD74.00/EUR16.00 and 5+7 partitionresult_01에는 네 파일이 생깁니다.
- matched.csv: 단가를 한 건 선택한 주문 5행, 단가 ID, 단가와 계산 금액
- held.json: 보류 주문 7건의 원문, 보류 사유와 일치 후보 ID
- period_issues.csv: 가격표의 겹침 1건과 공백 1건
- summary.json: 행 수, 통화별 선택 합계, 입력 파일 SHA-256과 완료 표시
summary.json은 마지막에 씁니다. complete가 true이고 네 파일이 모두 있어야 완료한 결과로 봅니다. 원본 CSV의 해시는 코드를 읽은 바로 그 바이트에서 계산하므로 원본을 바꿨는지 대조할 수 있습니다. source_record는 헤더를 1로 세는 논리 CSV 레코드 번호이며, 여러 줄 필드가 있는 파일의 물리 줄 번호와는 다릅니다.
보류 값은 일반 텍스트 편집기로 읽는 JSON에 보관합니다. 날짜나 수량의 잘못된 원문을 수정하지 않고 남기기 위한 출력입니다. 실습 과정에서 CSV를 실제 Excel 앱으로 다시 열어 자동 형식이나 표시를 확인한 것은 아닙니다.
4. 주문별 기대 결과를 확인합니다
| 주문 | 결과 | 선택 단가·금액 또는 보류 이유 |
|---|---|---|
| O01 | 선택 | PA1, 2 × 10.00 = USD 20.00 |
| O02 | 선택 | PA2, 3 × 12.00 = USD 36.00 |
| O03 | 보류 | 3월 1일은 PA2 종료일이므로 적용 단가 없음 |
| O04 | 보류 | PB1과 PB2 두 건 일치, 후보 PB1|PB2 보존 |
| O05 | 보류 | C의 1월 15일은 단가 기간 공백 |
| O06 | 보류 | A는 있지만 GBP 단가표 없음 |
| O07 | 선택 | PAE, 2 × 8.00 = EUR 16.00 |
| O08 | 보류 | D 품목 자체가 가격표에 없음 |
| O09 | 보류 | 2026-02-30은 존재하지 않는 날짜 |
| O10 | 선택 | PB1 시작일 1월 1일 포함, USD 10.00 |
| O11 | 선택 | PC2 시작일 1월 20일 포함, USD 8.00 |
| O12 | 보류 | 2026-2-01은 정한 YYYY-MM-DD 표기와 다름 |
O04에서 가격표의 첫 행이나 가장 비싼 단가를 선택하면 보류가 사라져 버립니다. 두 건이 맞았다는 사실을 남기고 단가 담당자가 겹친 기간을 확인하도록 합니다. 반대로 PB1과 PB2가 겹치더라도 O10의 1월 1일에는 PB1 하나만 맞으므로 그 주문은 선택할 수 있습니다.
보류 이유도 구별합니다. NO_ACTIVE_PRICE 2건, MULTIPLE_ACTIVE_PRICES 1건, CURRENCY_NOT_IN_CATALOG 1건, UNKNOWN_ITEM 1건, INVALID_ORDER 2건으로 합계 7건입니다. 단가 없음과 수량 0을 같은 정상값으로 처리하지 않습니다. 보류 주문의 금액을 0으로 채워 합계에 넣지도 않습니다.
USD는 20.00 + 36.00 + 10.00 + 8.00 = 74.00, EUR는 16.00입니다. 이 합계는 선택된 5건만 포함합니다. 보류 주문까지 정상 완료한 총매출로 읽으면 안 됩니다.
5. 핵심 비교를 코드에서 확인합니다
품목·통화를 먼저 묶고 날짜 조건을 만족하는 후보를 모두 구합니다. 후보가 정확히 한 건일 때만 금액을 계산합니다.
choices = [price for price in same_item_currency
           if price_from <= order_date < price_to]
if len(choices) == 1:
    amount = Decimal(unit_price_text) * quantity
else:
    # 0건과 2건 이상을 이유가 다른 보류로 기록
    hold_order()
위 코드는 흐름을 보여 주는 축약 설명입니다. 그대로 실행하는 파일은 ZIP의 effective_prices.py이며, 아래 전체 코드와 같은 버전입니다.
날짜는 정규식으로 YYYY-MM-DD 모양을 확인한 뒤 date.fromisoformat으로 실제 날짜인지 확인합니다. Python의 fromisoformat은 버전에 따라 붙여 쓴 날짜나 주 단위 ISO 표기도 받을 수 있으므로, 이 실습의 좁은 형식 계약을 앞에서 검사합니다. Python date.fromisoformat 공식 문서
단가는 CSV 문자열에서 Decimal로 바로 만듭니다. float를 거치지 않으며 이번 입력 범위와 행 수에서 정밀도 28은 곱셈·합산을 담기에 충분합니다. 의도하지 않은 정밀도 손실은 Inexact 예외로 확인하고, 별도의 반올림은 적용하지 않습니다. Python Decimal 공식 문서
CSV는 newline=’’로 열고 strict=True로 읽습니다. CSV 구문 검사와 별도로 헤더·열 수·ID·범위를 검증합니다. Python csv 공식 문서
6. 잘못된 입력과 재실행을 시험합니다
가격표의 날짜가 잘못되면 일부 가격만 건너뛰고 계속하지 않습니다. 기준표 전체를 신뢰할 수 없으므로 출력 폴더를 만들기 전에 중단합니다. 제공한 실패 파일로 확인할 수 있습니다.
py -3 effective_prices.py --prices input/invalid_catalog.csv --orders input/orders.csv --output invalid_result기대값은 STOP으로 시작하는 오류와 종료 코드 1입니다. invalid_result 폴더는 생기지 않습니다. invalid_catalog.csv의 2월 30일을 2월 말일로 추정해 고치지 말고 원본 근거를 확인한 별도 사본으로 재실행하세요.
같은 result_01을 다시 지정해도 기존 결과를 덮어쓰지 않습니다. 기존 폴더 때문에 종료 코드 1이 나오면 result_02처럼 새 폴더를 사용합니다. 저장 도중 권한이나 디스크 오류가 난 경우 일부 파일만 남을 수 있습니다. summary.json이 없는 폴더는 미완성으로 남겨 두고 원인을 해결한 뒤 새 폴더에서 다시 시작합니다.
주문 ID 중복, 단가 ID 중복, CSV 열 수 오류와 잘못된 가격표는 전체 중단입니다. 반면 주문의 잘못된 날짜·수량·품목·통화 표기는 held.json에 원문과 이유를 남깁니다. 중복 ID를 자동으로 합치거나 주문 행을 삭제하지 않습니다.
회귀시험을 직접 실행하려면 다음 명령을 사용합니다.
py -3 -m unittest discover -s . -p "test*.py" -v제작 과정에서는 34개 테스트를 실제 실행했습니다. 종료일 제외·시작일 포함, 가격 기간 겹침과 공백, 다른 통화, 잘못된 날짜, 0·음수·소수 수량, 중복 ID, 잘못된 헤더·열 수·따옴표·인코딩, 파일 크기 한도, 기존 결과 보존과 입력 수정 후 재실행을 확인했습니다. 기대 결정과 기간 진단은 구현 출력에서 역으로 만든 값이 아니라 별도로 적은 고정 자료로 대조했습니다.
7. 실제 파일에 적용하기 전에 확인할 범위
단가는 단위 수량 1개당 금액이고 수량은 양의 정수라는 전제입니다. kg와 g, 박스와 낱개가 섞여 있거나 세금·할인·배송비를 포함한 금액이라면 그대로 곱하면 안 됩니다. 유효기간을 확인했더라도 단위와 계산 규칙을 별도로 합의해야 합니다.
기간 진단의 공백은 가격표에 있는 기간 사이만 검사합니다. 가장 앞 기간 이전이나 가장 뒤 기간 이후에 단가가 영구히 누락됐다고 단정하지 않습니다. 주문별 조회에서는 그 날짜에 단가가 없다는 이유로 보류합니다.
이 구현은 작은 연습 자료용입니다. 주문마다 해당 품목·통화 그룹을 훑고 가격표의 기간 쌍을 비교하므로 대규모 운영 자료의 속도를 보장하지 않습니다. 원본 파일이 동시에 수정되는 환경의 잠금이나 실제 거래 시스템 연동도 구현하지 않았습니다.
품목 키만으로 찾는 기본 방식은 VLOOKUP 단가 조회 실습과 비교할 수 있습니다. 이미 주어진 수량·단가·금액이 서로 맞는지 확인하려면 CSV 행별 금액 검산을 참고하세요. 이번 글의 새 단계는 금액을 계산하기 전에 주문일에 적용할 단가가 정확히 한 건인지 결정하는 것입니다.
자료·공식 문서 확인과 실제 Python 시험일: 2026년 10월 13일 KST. 화면 도해는 합성 입력의 규칙을 설명하며 실제 Excel 실행 화면이 아닙니다.
전체 실행 코드
"""Select exactly one dated price per synthetic order; never change inputs."""
import argparse
from collections import Counter, defaultdict
import csv
from datetime import date
from decimal import Decimal, Inexact, localcontext
import hashlib
import io
import json
from pathlib import Path
import re
import sys

PRICE_FIELDS = ['price_id', 'item', 'currency', 'valid_from', 'valid_to', 'unit_price']
ORDER_FIELDS = ['order_id', 'item', 'currency', 'order_date', 'qty']
MATCH_FIELDS = ['source_record'] + ORDER_FIELDS + ['price_id', 'unit_price', 'amount']
HELD_FIELDS = ['source_record'] + ORDER_FIELDS + ['reason', 'detail', 'candidate_ids']
PERIOD_FIELDS = ['item', 'currency', 'kind', 'from_date', 'to_date', 'price_ids']
ID_RE = re.compile(r'[A-Z0-9][A-Z0-9_-]{0,39}\Z')
CURRENCY_RE = re.compile(r'[A-Z]{3}\Z')
DATE_RE = re.compile(r'[0-9]{4}-[0-9]{2}-[0-9]{2}\Z')
MONEY_RE = re.compile(r'(?:0|[1-9][0-9]{0,5})\.[0-9]{2}\Z')
QTY_RE = re.compile(r'[1-9][0-9]{0,6}\Z')
MAX_BYTES = 4 * 1024 * 1024
MAX_PRICES = 1000
MAX_ORDERS = 10000


def parse_date(text):
    if not DATE_RE.fullmatch(text):
        raise ValueError('date must be YYYY-MM-DD with no spaces')
    return date.fromisoformat(text)


def check_id(text, name):
    if not ID_RE.fullmatch(text):
        raise ValueError(name + ' must be 1-40 uppercase letters/digits/_/-')


def check_currency(text):
    if not CURRENCY_RE.fullmatch(text):
        raise ValueError('currency must be three uppercase letters; no conversion')


def parse_price(text):
    if not MONEY_RE.fullmatch(text):
        raise ValueError('unit_price must have exactly two decimal places')
    value = Decimal(text)
    if not Decimal('0') < value <= Decimal('999999.99'):
        raise ValueError('unit_price must be >0 and <=999999.99')
    return value


def parse_qty(text):
    if not QTY_RE.fullmatch(text) or int(text) > 1000000:
        raise ValueError('qty must be an integer from 1 to 1000000')
    return int(text)


def read_csv(path, fields, limit):
    path = Path(path)
    with path.open('rb') as stream:
        raw = stream.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise ValueError(str(path) + ': file exceeds 4 MiB')
    reader = csv.reader(io.StringIO(raw.decode('utf-8-sig'), newline=''), strict=True)
    header = next(reader, None)
    if header != fields:
        raise ValueError(str(path) + ': header/order must be ' + ','.join(fields))
    rows = []
    for record, cells in enumerate(reader, 2):
        if len(cells) != len(fields):
            raise ValueError(str(path) + ': record ' + str(record) + ' has wrong column count')
        if len(rows) >= limit:
            raise ValueError(str(path) + ': record limit exceeded')
        row = dict(zip(fields, cells))
        row['_record'] = record
        rows.append(row)
    return rows, hashlib.sha256(raw).hexdigest()


def unique_ids(rows, key):
    seen = set()
    for row in rows:
        check_id(row[key], key)
        if row[key] in seen:
            raise ValueError('duplicate ' + key + ': ' + row[key])
        seen.add(row[key])


def period_audit(groups):
    result = []
    for (item, currency), rows in sorted(groups.items()):
        ordered = sorted(rows, key=lambda p: (p['_from'], p['_to'], p['price_id']))
        for index, left in enumerate(ordered):
            for right in ordered[index + 1:]:
                if right['_from'] >= left['_to']:
                    break
                start = max(left['_from'], right['_from'])
                end = min(left['_to'], right['_to'])
                result.append({'item': item, 'currency': currency, 'kind': 'OVERLAP',
                               'from_date': start.isoformat(), 'to_date': end.isoformat(),
                               'price_ids': '|'.join(sorted([left['price_id'], right['price_id']]))})
        frontier = ordered[0]['_to']
        frontier_id = ordered[0]['price_id']
        for current in ordered[1:]:
            if frontier < current['_from']:
                result.append({'item': item, 'currency': currency, 'kind': 'GAP',
                               'from_date': frontier.isoformat(), 'to_date': current['_from'].isoformat(),
                               'price_ids': frontier_id + '|' + current['price_id']})
            if current['_to'] > frontier:
                frontier, frontier_id = current['_to'], current['price_id']
    return sorted(result, key=lambda p: tuple(p[k] for k in PERIOD_FIELDS))


def reconcile(prices, orders):
    if not prices or len(prices) > MAX_PRICES or len(orders) > MAX_ORDERS:
        raise ValueError('prices require 1-1000 rows and orders permit 0-10000 rows')
    unique_ids(prices, 'price_id')
    unique_ids(orders, 'order_id')
    groups = defaultdict(list)
    items = set()
    for index, source in enumerate(prices, 2):
        row = dict(source)
        try:
            check_id(row['item'], 'item')
            check_currency(row['currency'])
            row['_from'] = parse_date(row['valid_from'])
            row['_to'] = parse_date(row['valid_to'])
            if row['_from'] >= row['_to']:
                raise ValueError('valid_from must be earlier than valid_to')
            row['_price'] = parse_price(row['unit_price'])
        except ValueError as exc:
            raise ValueError('catalog record ' + str(row.get('_record', index)) + ': ' + str(exc)) from exc
        groups[row['item'], row['currency']].append(row)
        items.add(row['item'])
    matched, held = [], []
    for index, source in enumerate(orders, 2):
        row = {key: source[key] for key in ORDER_FIELDS}
        row['source_record'] = source.get('_record', index)
        try:
            check_id(row['item'], 'item')
            check_currency(row['currency'])
            day = parse_date(row['order_date'])
            quantity = parse_qty(row['qty'])
        except ValueError as exc:
            held.append(dict(row, reason='INVALID_ORDER', detail=str(exc), candidate_ids=''))
            continue
        choices = sorted([price for price in groups.get((row['item'], row['currency']), [])
                          if price['_from'] <= day < price['_to']], key=lambda p: p['price_id'])
        if len(choices) == 1:
            price = choices[0]
            with localcontext() as ctx:
                ctx.prec = 28
                ctx.traps[Inexact] = True
                amount = price['_price'] * quantity
            matched.append(dict(row, price_id=price['price_id'], unit_price=price['unit_price'],
                                amount=format(amount, '.2f')))
        else:
            if len(choices) > 1:
                reason = 'MULTIPLE_ACTIVE_PRICES'
                detail = 'more than one active price; do not select first/latest'
            elif row['item'] not in items:
                reason, detail = 'UNKNOWN_ITEM', 'item has no catalog records'
            elif (row['item'], row['currency']) not in groups:
                reason, detail = 'CURRENCY_NOT_IN_CATALOG', 'item exists in a different currency'
            else:
                reason, detail = 'NO_ACTIVE_PRICE', 'no price satisfies start <= date < end'
            held.append(dict(row, reason=reason, detail=detail,
                             candidate_ids='|'.join(price['price_id'] for price in choices)))
    return matched, held, period_audit(groups)


def write_csv(path, fields, rows):
    with Path(path).open('x', encoding='utf-8-sig', newline='') as stream:
        writer = csv.DictWriter(stream, fieldnames=fields, lineterminator='\n')
        writer.writeheader()
        writer.writerows(rows)


def run(prices_path, orders_path, output):
    prices, prices_sha = read_csv(prices_path, PRICE_FIELDS, MAX_PRICES)
    orders, orders_sha = read_csv(orders_path, ORDER_FIELDS, MAX_ORDERS)
    matched, held, periods = reconcile(prices, orders)
    totals = defaultdict(lambda: Decimal('0.00'))
    with localcontext() as ctx:
        ctx.prec = 28
        ctx.traps[Inexact] = True
        for row in matched:
            totals[row['currency']] += Decimal(row['amount'])
    summary = {'complete': True, 'boundary': 'valid_from <= order_date < valid_to',
               'price_rows': len(prices), 'order_rows': len(orders), 'matched_rows': len(matched),
               'held_rows': len(held), 'period_issues': len(periods),
               'held_reasons': dict(sorted(Counter(row['reason'] for row in held).items())),
               'matched_totals_by_currency': {key: format(value, '.2f') for key, value in sorted(totals.items())},
               'input_sha256': {'prices.csv': prices_sha, 'orders.csv': orders_sha}}
    output = Path(output)
    output.mkdir()  # exclusive new folder; never overwrite an existing result
    write_csv(output / 'matched.csv', MATCH_FIELDS, matched)
    with (output / 'held.json').open('x', encoding='utf-8') as stream:
        json.dump(held, stream, ensure_ascii=False, indent=2, allow_nan=False)
        stream.write('\n')
    write_csv(output / 'period_issues.csv', PERIOD_FIELDS, periods)
    # Written last: without this marker the output is incomplete.
    with (output / 'summary.json').open('x', encoding='utf-8') as stream:
        json.dump(summary, stream, ensure_ascii=False, indent=2, allow_nan=False)
        stream.write('\n')
    return summary


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('--prices', required=True)
    parser.add_argument('--orders', required=True)
    parser.add_argument('--output', required=True, help='new folder whose parent already exists')
    args = parser.parse_args()
    try:
        summary = run(args.prices, args.orders, args.output)
    except (OSError, ValueError, csv.Error) as exc:
        print('STOP: ' + str(exc), file=sys.stderr)
        return 1
    print(json.dumps({key: summary[key] for key in ['matched_rows', 'held_rows', 'matched_totals_by_currency']}, ensure_ascii=False))
    return 0


if __name__ == '__main__':
    sys.exit(main())
실습 파일
ZIP에는 두 입력 CSV, 잘못된 가격표 예제, effective_prices.py, 고정 기대값 3개, verify_example.py, 회귀시험 파일 2개, README.md가 들어 있습니다. 새 폴더에서 실행하고 12개 주문이 선택 5건과 보류 7건으로 빠짐없이 나뉘는지 확인하세요.
작성자 소개
