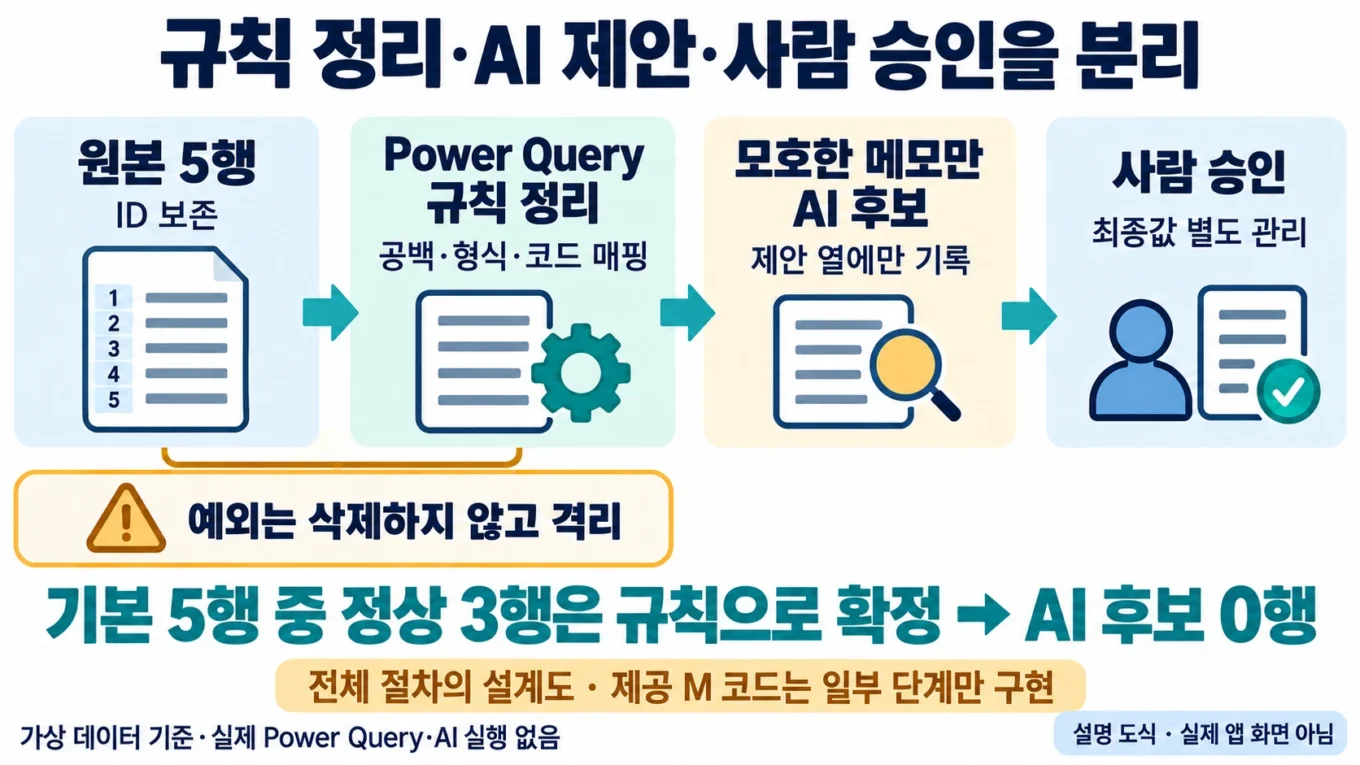
엑셀 데이터 정리에서 Power Query와 AI 역할 나누는 방법
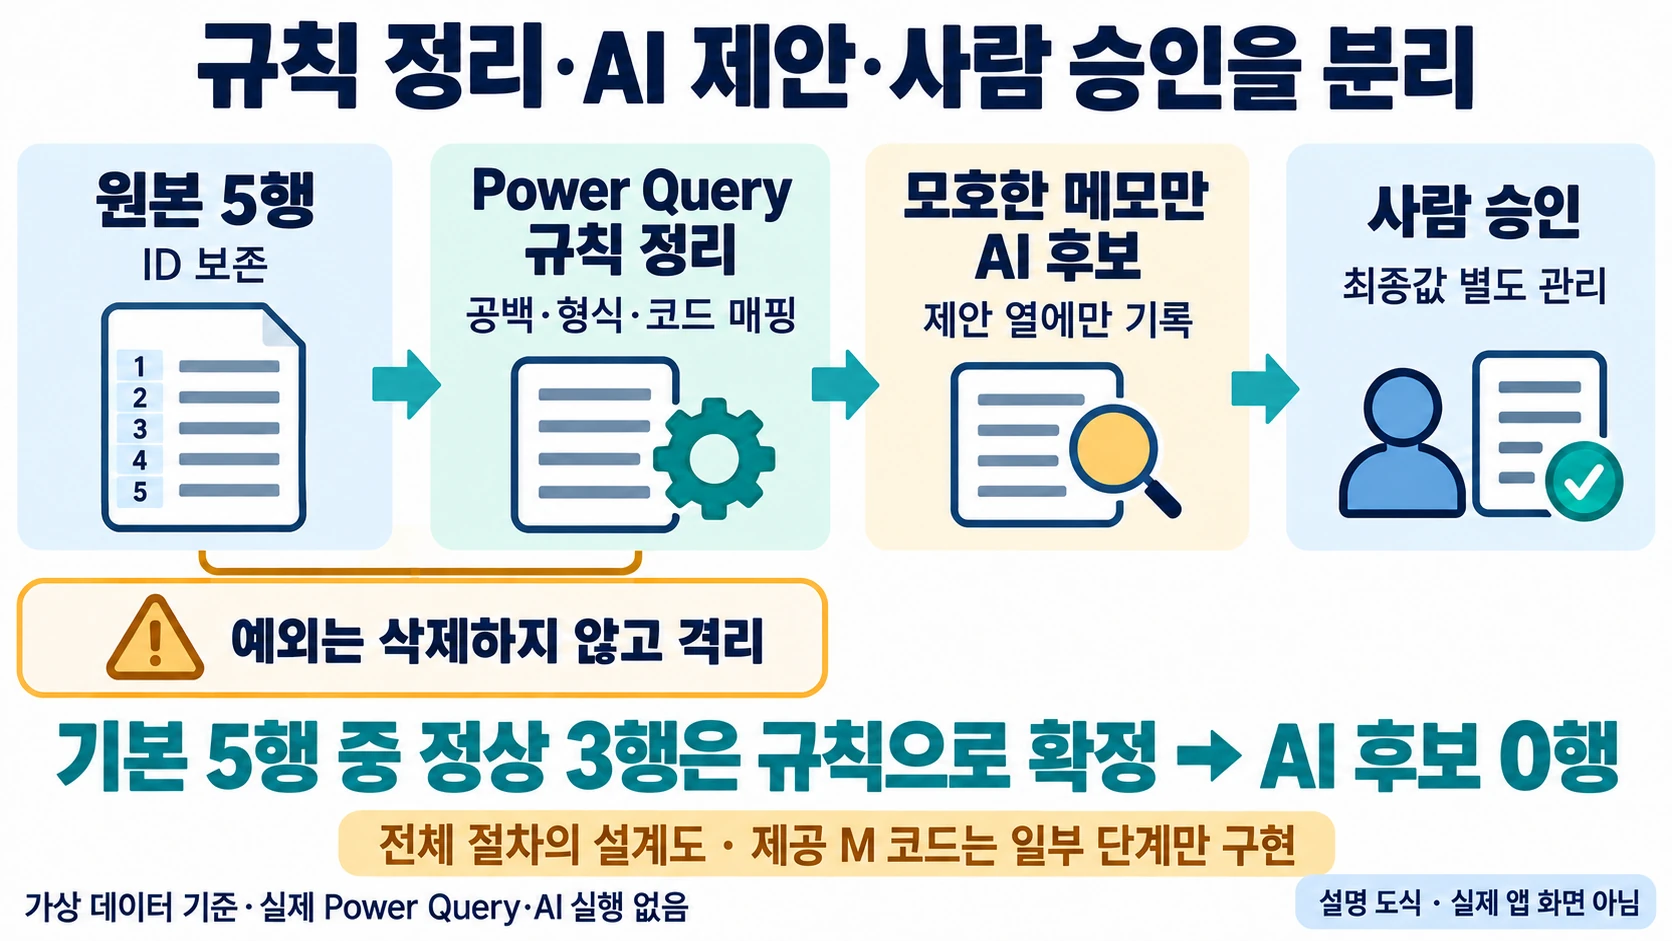
엑셀 데이터를 정리할 때 모든 단계를 AI에 맡기면 같은 입력에서도 결과 형식이 달라질 수 있고, 반대로 모든 예외를 Power Query 규칙으로 만들면 복잡한 문장 분류에 시간이 많이 듭니다. 안정적인 흐름은 열 이름, 데이터 형식, 공백, 병합처럼 규칙이 분명한 작업은 Power Query로 처리하고, 의미가 모호한 메모만 AI 제안 열로 보내 사람이 승인하는 것입니다.
이 글에서는 원본 행 수를 보존하면서 규칙정리, 예외격리, AI제안, 사람승인 단계를 분리합니다. 예제의 고객명과 메모는 모두 가상 연습 데이터입니다.
준비할 것
빈 엑셀 통합문서에 원본, 규칙정리, 예외목록, 승인결과 시트 네 개를 준비합니다. 원본 시트에는 레코드ID, 접수일, 고객명, 메모, 기존분류 열을 만듭니다. 레코드ID는 각 행을 다시 연결하는 키이므로 정리 과정에서 새로 만들거나 바꾸지 않습니다.
Power Query는 여러 데이터 원본을 가져와 변환하는 작업에 사용한다. Power Query documentation | Microsoft Learn과 Power Query 모범 사례에서 데이터 가져오기, 형식 지정, 필터 순서, 단계 문서화 원칙을 확인할 수 있습니다. 문서 확인일: 2026-09-06.
실제 개인정보나 외부 반출 금지 문장을 AI 입력에 넣지 않습니다. 연습 단계에서는 가상 문장만 사용하고, 운영 전에는 조직의 데이터 처리 기준을 확인합니다.
1단계: 작업을 규칙형과 판단형으로 나누기
먼저 정리하려는 동작을 두 열에 적습니다.
| 작업 | 규칙형 여부 | 담당 경로 | 이유 |
|---|---|---|---|
| 고객명 앞뒤 공백 제거 | 예 | Power Query | 같은 입력에 같은 변환을 적용할 수 있음 |
| 접수일 데이터 형식 통일 | 예 | Power Query | 성공과 오류를 명시적으로 구분할 수 있음 |
| 빈 메모 행 분리 | 예 | Power Query | 조건이 명확함 |
| 기존분류 코드 매핑 | 예 | Power Query | 대응표로 재현 가능함 |
| 자유 문장 의도 후보 만들기 | 아니오 | AI 제안 | 문맥 판단이 필요함 |
| 최종 분류 확정 | 아니오 | 사람 승인 | 업무 규칙과 영향 확인이 필요함 |
AI가 할 수 있는지보다 같은 결과를 재현해야 하는지를 먼저 묻습니다. 정답 규칙이 이미 있는 작업은 AI로 옮길 이유가 적습니다. 의미 판단이 필요한 작업도 AI가 최종값을 덮어쓰게 하지 않고 제안 열까지만 작성합니다.
2단계: 가상 원본 만들기
원본 시트에 다음 연습 데이터를 입력합니다.
| 레코드ID | 접수일 | 고객명 | 메모 | 기존분류 |
|---|---|---|---|---|
| R-001 | 2026-09-01 | 홍길동 (앞에 일반 공백 1개) | 배송이 아직 오지 않았어요 | D |
| R-002 | 2026-09-02 | 김하나 (뒤에 일반 공백 1개) | 결제가 두 번 된 것 같아요 | P |
| R-003 | 2026-02-30 | 박두리 | 색상을 바꿀 수 있나요 | 비워 둠 |
| R-004 | 2026-09-03 | 이세나 | 비워 둠 | Q |
| R-005 | 2026-09-04 | 최가람 | 기사님 연락이 없어요 | D |
접수일 열은 입력 전에 텍스트 형식으로 지정하고 표의 문자열을 그대로 넣습니다. 2026-02-30은 존재하지 않는 날짜로, 날짜 변환 오류를 재현하는 R-003 전용 입력입니다. 고객명 R-001은 " 홍길동", R-002는 "김하나 "에서 따옴표를 제외한 문자열로 입력하세요. 표의 괄호 설명을 셀에 쓰지 않습니다. ‘비워 둠’도 글자를 입력하지 말고 실제 빈 셀로 둡니다. 대응표는 D=배송, P=결제, Q=기타로 고정합니다.
원본 행 수는 머리글을 제외하고 다섯 개입니다. 이후 검산에서 이 수가 유지되어야 합니다.
3단계: Power Query로 구조 정리하기
원본 범위를 표로 바꾸고 데이터 가져오기 흐름으로 Power Query 편집기를 엽니다. 적용 단계 이름을 다음 순서로 정리합니다.
1. 원본불러오기
2. 레코드ID문자형
3. 고객명공백제거
4. 접수일형식변환
5. 분류표병합
6. 빈메모표시
7. 오류행격리
열 형식 지정과 공백 제거처럼 결과가 명확한 작업부터 둡니다. 사용하지 않는 열을 줄일 수는 있지만 이 실습의 원본 ID는 버리지 않습니다. 날짜 오류와 빈 메모 행은 삭제하는 대신 예외목록에 남겨, 정상 행과 예외 행의 합이 원본 다섯 행과 같게 유지합니다.
접수일 변환 오류를 빈칸으로 조용히 바꾸지 않습니다. 오류 여부 열을 추가하거나 오류 쿼리로 분리해 R-003을 찾을 수 있게 합니다. 빈 메모 R-004도 삭제하지 않고 예외 사유를 빈메모로 기록합니다.
분류표를 병합한 뒤 대응하지 않는 코드는 미분류로 남깁니다. AI에게 보내기 전에 규칙표 누락인지 문장 판단이 필요한지 구분해야 합니다.
4단계: AI로 보낼 행만 고르기
규칙정리가 끝난 뒤 다음 조건을 모두 만족하는 행만 AI제안 후보로 복사합니다.
- 레코드ID가 있습니다.
- 메모가 비어 있지 않습니다.
- 날짜 오류나 필수 열 오류가 없습니다.
- 대응표만으로 최종 분류를 확정할 수 없습니다.
- 데이터 반출 기준을 통과한 가상 또는 허용 데이터입니다.
AI에 보내는 표는 레코드ID, 비식별 메모, 허용 분류목록 세 열로 줄입니다. 고객명, 연락처, 원본 파일 경로 같은 불필요한 열은 포함하지 않습니다.
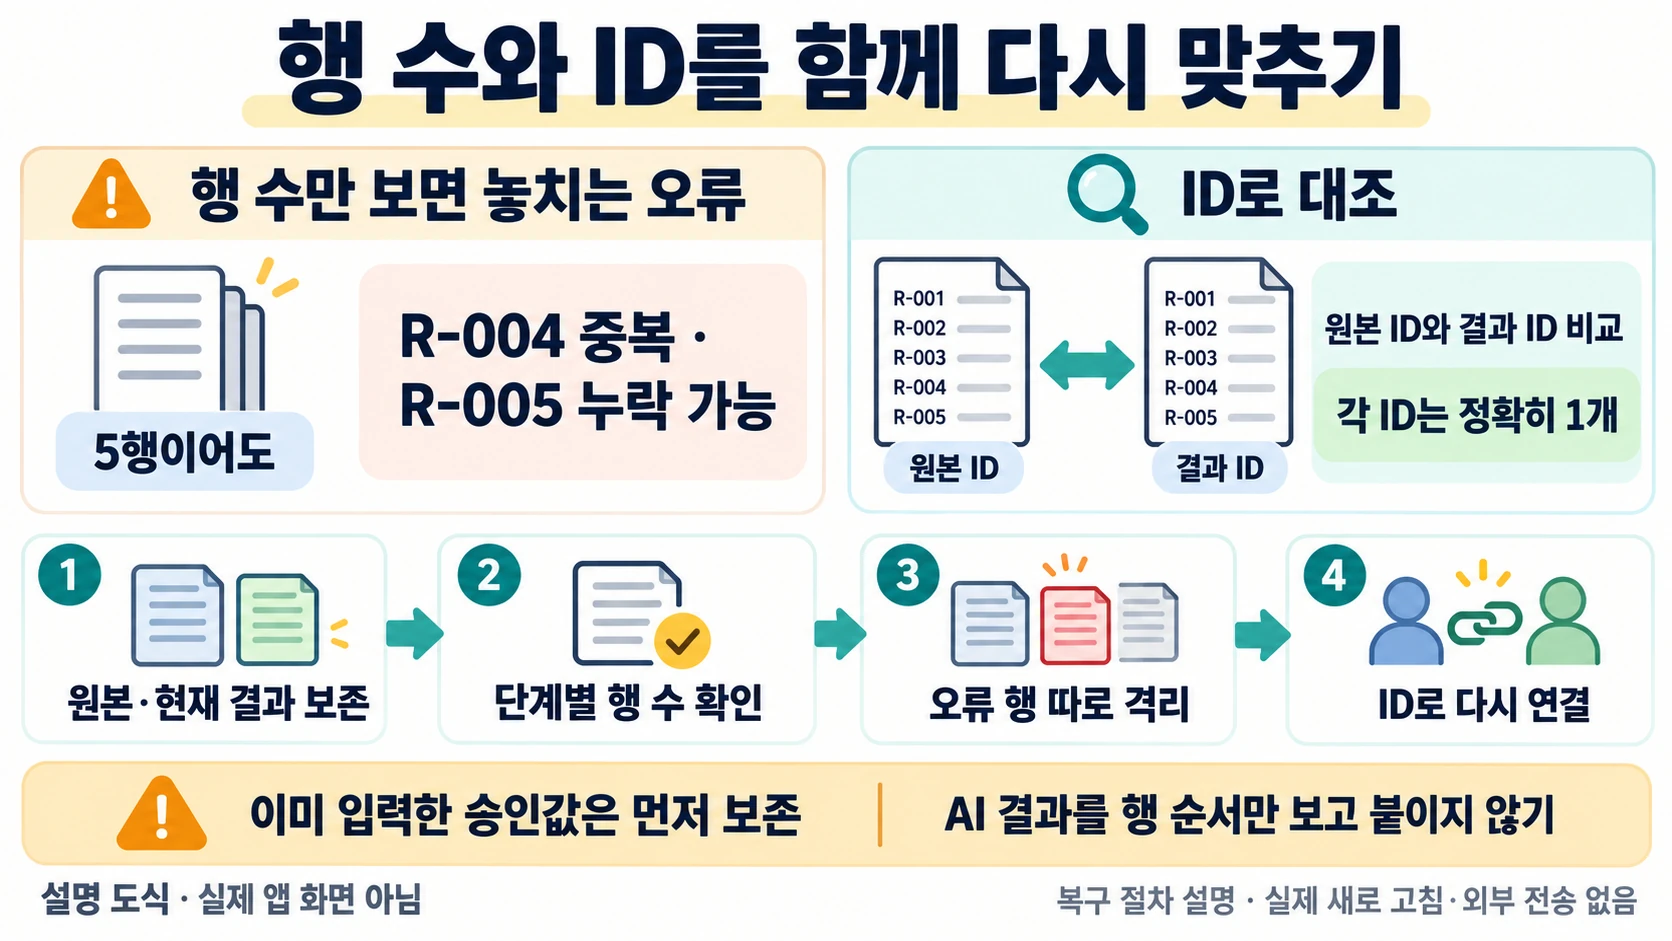
출력 형식은 레코드ID와 제안분류가 한 행씩 대응하도록 정합니다. 설명문이 필요하면 근거요약 열을 별도로 두되, 제안분류와 섞지 않습니다. 응답 순서만 믿지 말고 레코드ID로 다시 연결합니다.
5단계: 제안과 승인값 분리하기
승인결과 시트에는 다음 열을 둡니다.
| 열 | 내용 |
|---|---|
| A | 레코드ID |
| B | 정리된 메모 |
| C | 규칙분류 |
| D | AI제안 |
| E | 사람승인값 |
| F | 검토상태 |
| G | 예외사유 |
Power Query 결과는 B와 C까지 채웁니다. AI 결과는 D열에만 넣습니다. 검토자는 원본과 규칙표를 확인한 뒤 E열에 최종값을 기록하고 F열을 승인 또는 반려로 바꿉니다.
AI 제안이 규칙분류와 같아도 자동 승인하지 않습니다. 규칙으로 이미 확정할 수 있는 행이라면 애초에 AI 후보에서 제외하는 편이 낫습니다. 두 경로의 결과가 다르면 어떤 단계가 잘못됐는지 확인할 수 있도록 둘 다 보존합니다.
실습 파일 제공 범위
기존 첨부파일은 이 글에서 설명하는 네 시트와 R-001~R-005 입력 구조에 맞지 않아 다운로드 안내를 중단했습니다. 본문 예제와 일치하는 첨부파일은 현재 제공하지 않습니다.
빈 통합 문서에 원본, 규칙정리, 예외목록, 승인결과 시트를 만들고, ‘2단계: 가상 원본 만들기’의 다섯 행을 직접 입력하세요. 아래 Power Query 예제를 실행할 때는 원본 입력 범위를 표로 바꾸고 표 이름을 원본표로 지정합니다. 실제 회사 자료나 개인정보 대신 본문의 가상 데이터를 사용합니다.
6단계: 행 수와 키를 검산하기
정리 전후 행 수는 다음 관계를 만족해야 합니다.
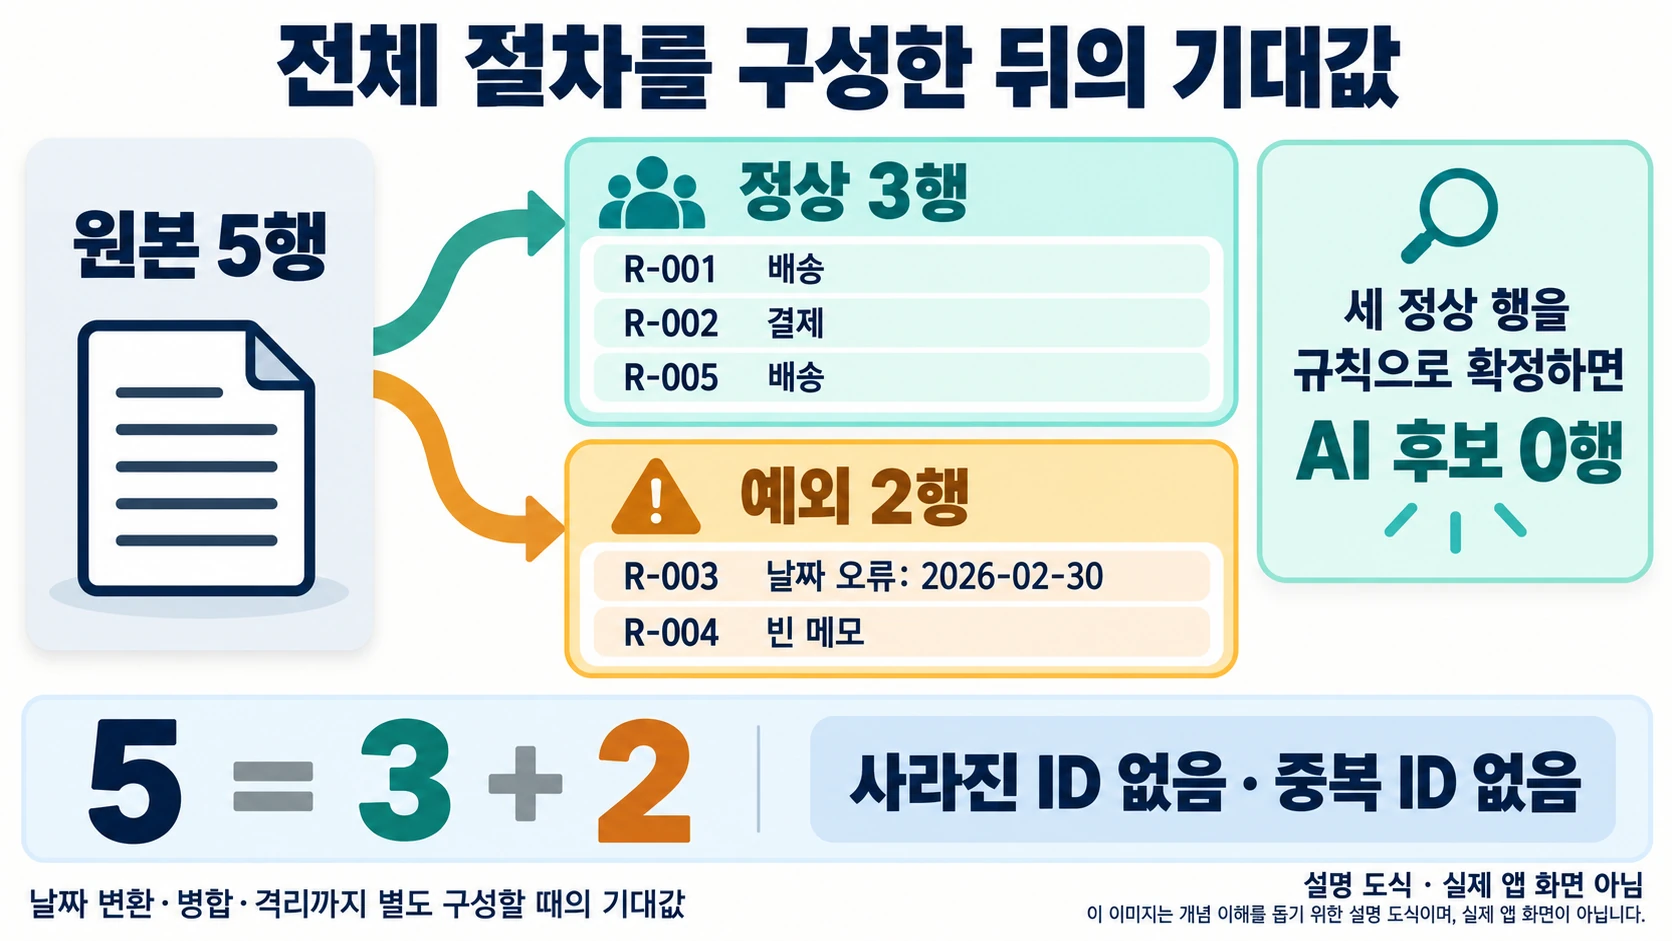
원본 행 수 = 정상 정리 행 수 + 오류 격리 행 수
중복 키 검사는 레코드ID별 개수를 세어 하나가 아닌 값을 찾습니다. 승인결과 시트에 없는 원본 ID와 원본에 없는 승인 ID도 각각 확인합니다.
가상 예제의 기대 결과는 다음과 같습니다.
| 확인 항목 | 기대 결과 |
|---|---|
| 원본 행 수 | 5 |
| 고객명 공백 제거 | R-001과 R-002가 정리됨 |
| 날짜 오류 격리 | R-003 한 행 |
| 빈 메모 예외 | R-004 한 행 |
| 정상 흐름에 남는 ID | R-001, R-002, R-005 |
| 원본에서 사라진 ID | 없음 |
R-001과 R-005는 기존 코드가 배송으로 연결되므로 규칙분류를 사용할 수 있습니다. R-002는 결제 코드에 연결됩니다. 이 세 행이 이미 규칙으로 확정됐다면 AI 호출 대상은 0행이어도 정상입니다. AI 사용량을 만들기 위해 규칙형 행을 억지로 보내지 않습니다.
7단계: 모호한 행을 추가해 분기 확인하기
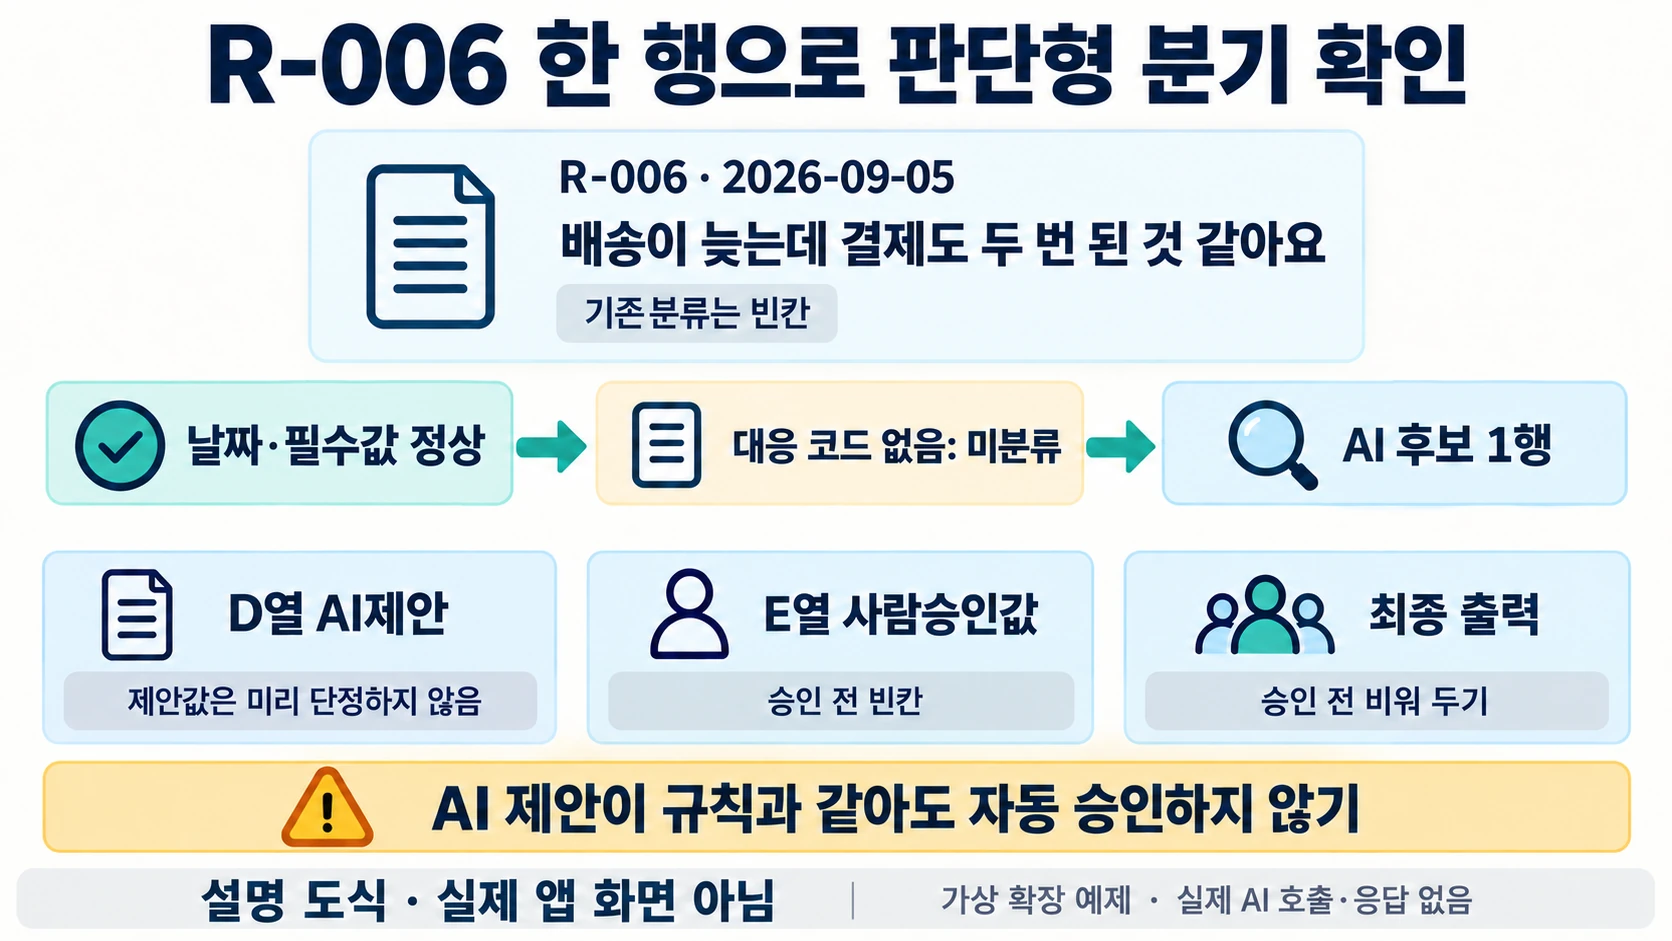
전체 규칙정리 절차를 구성한 뒤 R-006을 추가해 판단형 분기를 시험합니다. 접수일은 텍스트 2026-09-05, 고객명은 가상 이름 정다섯, 메모는 배송이 늦는데 결제도 두 번 된 것 같아요, 기존분류는 실제 빈 셀로 고정합니다. 날짜와 필수값은 정상이지만 대응 코드가 없어 미분류로 남는 것이 기대값입니다. AI의 제안값은 미리 단정하지 않고, 허용 분류와 사람의 검토를 거칩니다.
R-006만 AI제안 후보로 이동하고, AI가 만든 값은 D열에만 들어가야 합니다. 검토자가 승인하기 전에는 E열과 최종 출력이 비어 있어야 합니다. 이 한 행으로 규칙형 처리와 판단형 처리의 경계가 제대로 작동하는지 확인할 수 있습니다.
그대로 실행해 보는 Power Query 예제
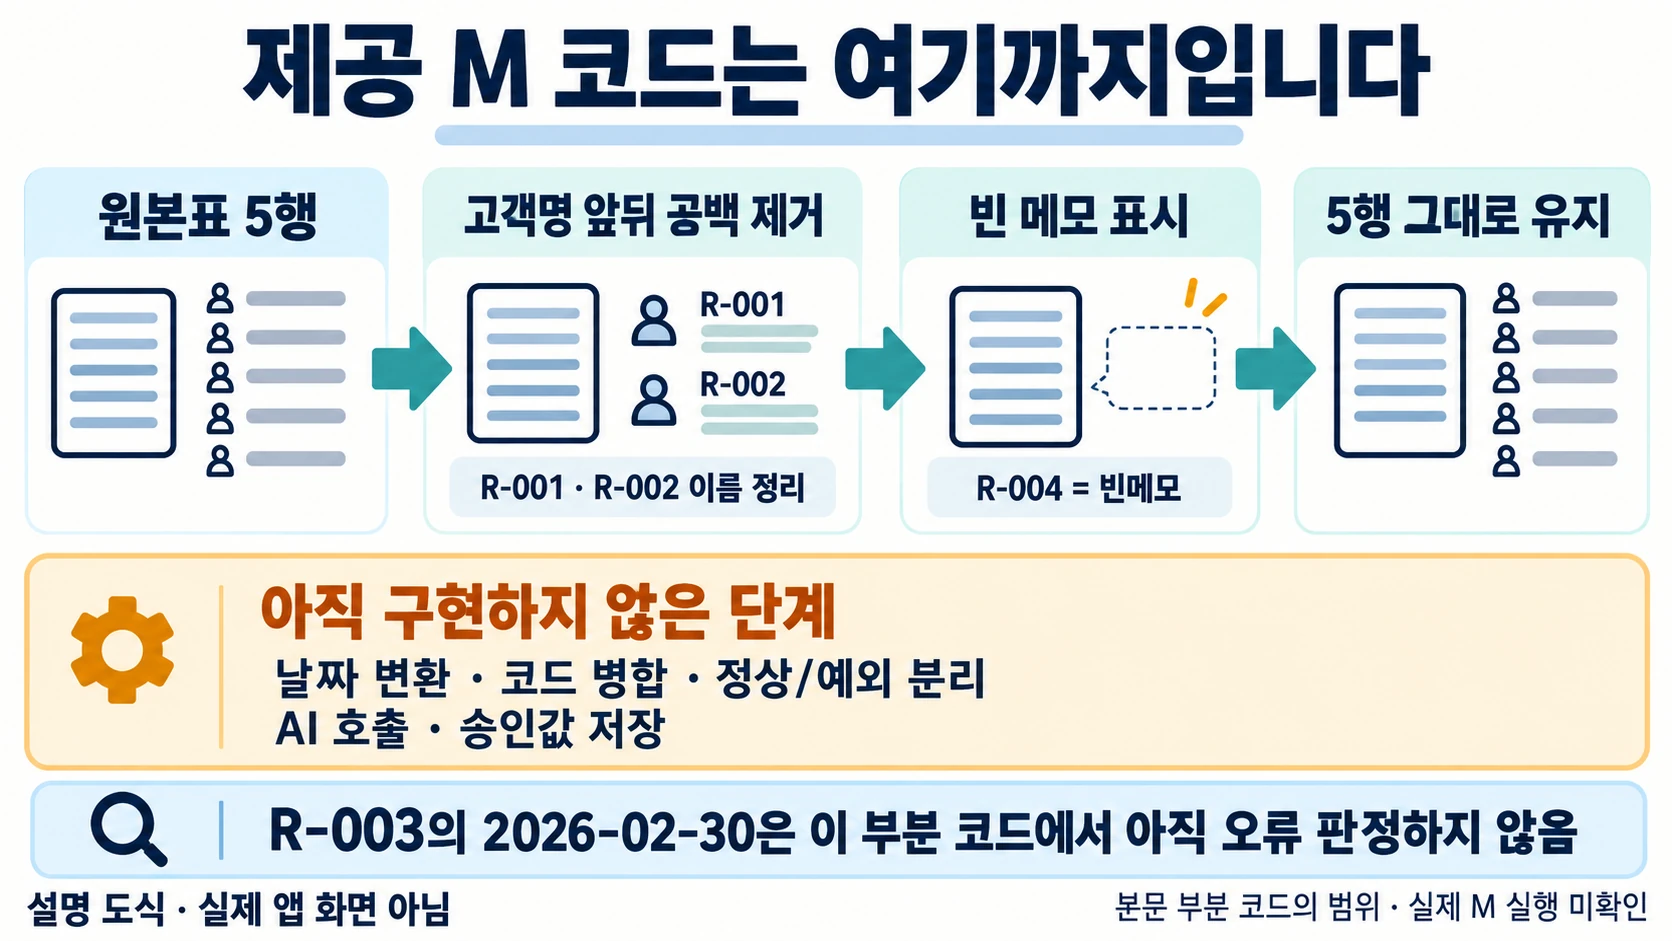
원본 범위를 표로 바꾸고 표 이름을 원본표로 지정한 다음, Power Query 고급 편집기에 아래 코드를 넣습니다. 이 코드는 전체 자동화가 아니라 공백 제거와 빈 메모 표시만 구현한 부분 예제입니다. 날짜 변환, 대응표 병합, 정상·예외 분리, AI 호출, 승인값 저장은 포함하지 않습니다. 따라서 이것만 실행하면 다섯 행이 그대로 남고 R-004에만 빈메모가 표시됩니다. R-003의 날짜 오류는 아직 판정하지 않습니다.
let
Source = Excel.CurrentWorkbook(){[Name="원본표"]}[Content],
Typed = Table.TransformColumnTypes(
Source,
{{"레코드ID", type text}, {"고객명", type text}, {"메모", type text}}
),
Trimmed = Table.TransformColumns(
Typed,
{{"고객명", Text.Trim, type text}}
),
Marked = Table.AddColumn(
Trimmed,
"예외사유",
each if [메모] = null or Text.Trim([메모]) = "" then "빈메모" else null,
type text
)
in
Marked
실행 후에는 R-001과 R-002의 고객명 공백이 제거되고, 메모가 빈 R-004에는 빈메모가 표시되어야 합니다. 입력한 5개 행이 그대로 남아 있는지도 함께 확인합니다. 이 결과가 다르면 다음 단계로 넘기지 말고 원본 열 이름과 데이터 형식을 먼저 점검합니다.
전체 절차를 구성한 뒤 결과 확인하기
아래 목록은 3~6단계의 날짜 변환·분류표 병합·예외 분리까지 별도로 구성했을 때의 점검표입니다. 위 부분 코드만으로 모두 충족되지는 않습니다. 텍스트 날짜를 M 식으로 변환할 때는 Date.FromText([접수일], [Format="yyyy-MM-dd", Culture="en-US"])처럼 입력 형식을 명시할 수 있습니다. 오류 행을 보존하는 방법까지 함께 구성하세요. 문법은 Microsoft Date.FromText 문서와 대조했습니다. 고정 날짜·행 수의 기대값은 별도 Python 계산으로 확인했으며 Power Query 또는 Excel에서 실행한 결과로 제시하지 않습니다.
새로 고침 후 다음 순서로 확인합니다.
1. 원본 행 수와 정상·오류 행 수의 합이 같은지 확인합니다.
2. 레코드ID 중복과 누락이 없는지 확인합니다.
3. 공백 제거와 날짜 형식 변환이 기대한 행에만 적용됐는지 확인합니다.
4. 규칙표에서 확정할 수 있는 행이 AI 후보에 들어가지 않았는지 확인합니다.
5. AI제안이 승인값 열을 덮어쓰지 않았는지 확인합니다.
6. 반려 또는 보류 행이 최종 출력에 포함되지 않았는지 확인합니다.
검산이 모두 끝난 뒤에만 결과 시트를 다른 시스템으로 내보냅니다.
실패했을 때 복구 순서
새로 고침 후 행이 사라졌다면 마지막 필터 단계부터 거꾸로 확인합니다. 삭제 대신 오류격리 쿼리로 보냈는지, 병합 종류가 의도와 맞는지, 레코드ID 형식이 양쪽 표에서 같은지 봅니다.
1. 원본 파일과 현재 쿼리 파일을 분리해 보존합니다.
2. 적용 단계에서 마지막으로 추가한 단계를 일시적으로 제거합니다.
3. 단계별 행 수를 기록해 처음 달라지는 지점을 찾습니다.
4. 데이터 형식 오류와 병합 미일치 행을 별도 쿼리로 보냅니다.
5. 가상 다섯 행의 기대 결과를 다시 확인합니다.
6. 기대 결과가 맞은 뒤 실제 데이터 새로 고침을 재개합니다.
AI 제안 연결이 어긋났다면 행 순서로 붙인 결과를 폐기하고 레코드ID로 다시 결합합니다. 승인값이 이미 입력된 경우에는 먼저 승인대장을 보존한 뒤 해당 ID만 다시 연결합니다.
한계와 주의사항
Power Query 규칙이 많아질수록 단계 이름과 설명을 관리해야 합니다. 원본 구조가 바뀌면 열 이름과 데이터 형식 단계가 실패할 수 있으므로 오류를 빈칸으로 숨기지 않는 것이 중요합니다.
AI 제안은 같은 입력에서도 표현이 달라질 수 있고, 허용 분류를 벗어나거나 근거가 부족할 수 있습니다. 따라서 의미 판단이 필요한 행만 제한적으로 보내고 사람 승인 전에는 최종값으로 사용하지 않습니다.
이 흐름은 데이터 반출 허가나 법적 적합성을 대신하지 않습니다. 민감 데이터, 권한, 보존 기간, 외부 서비스 사용 조건은 조직 정책에 따라 별도로 검토해야 합니다.
함께 읽으면 좋은 글
작성자 소개
