엑셀 Power Query 입문 — 매달 복붙하던 데이터 정리를 1번 설정으로
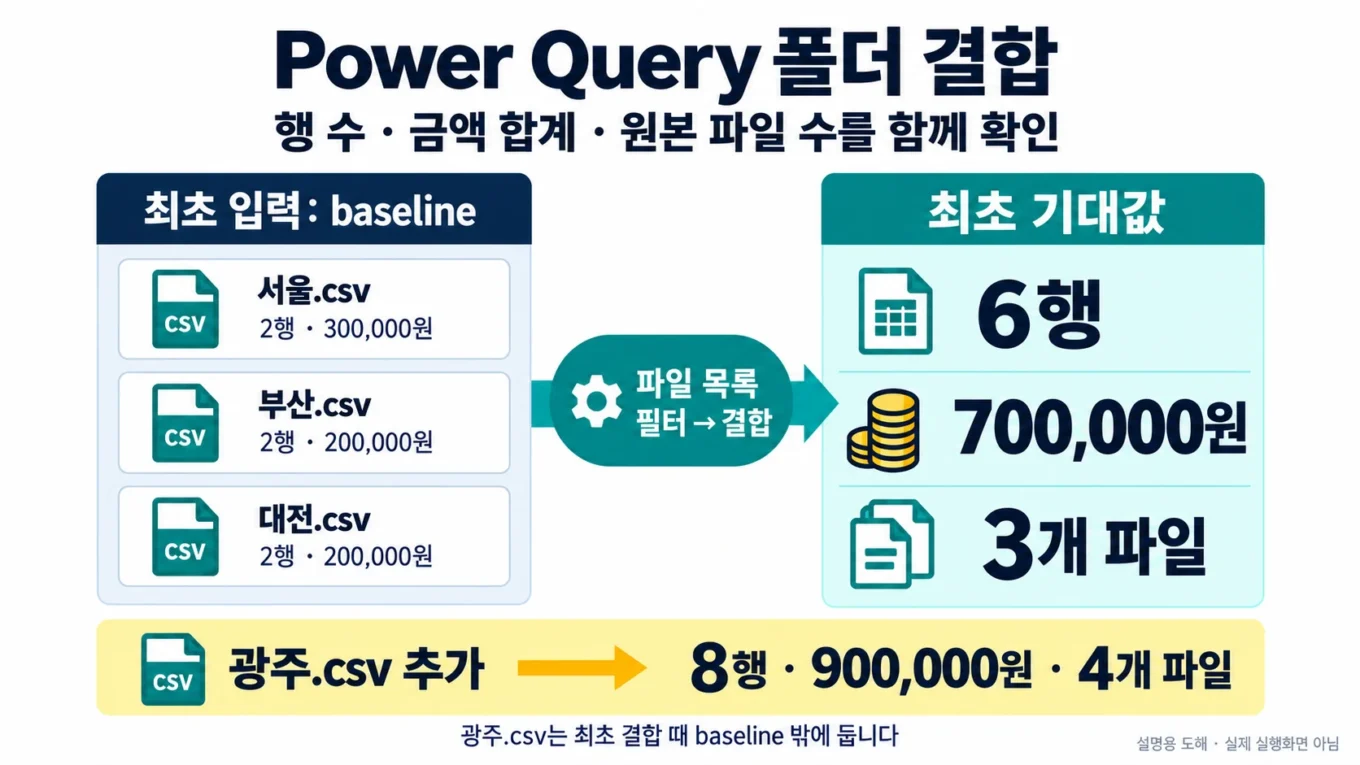
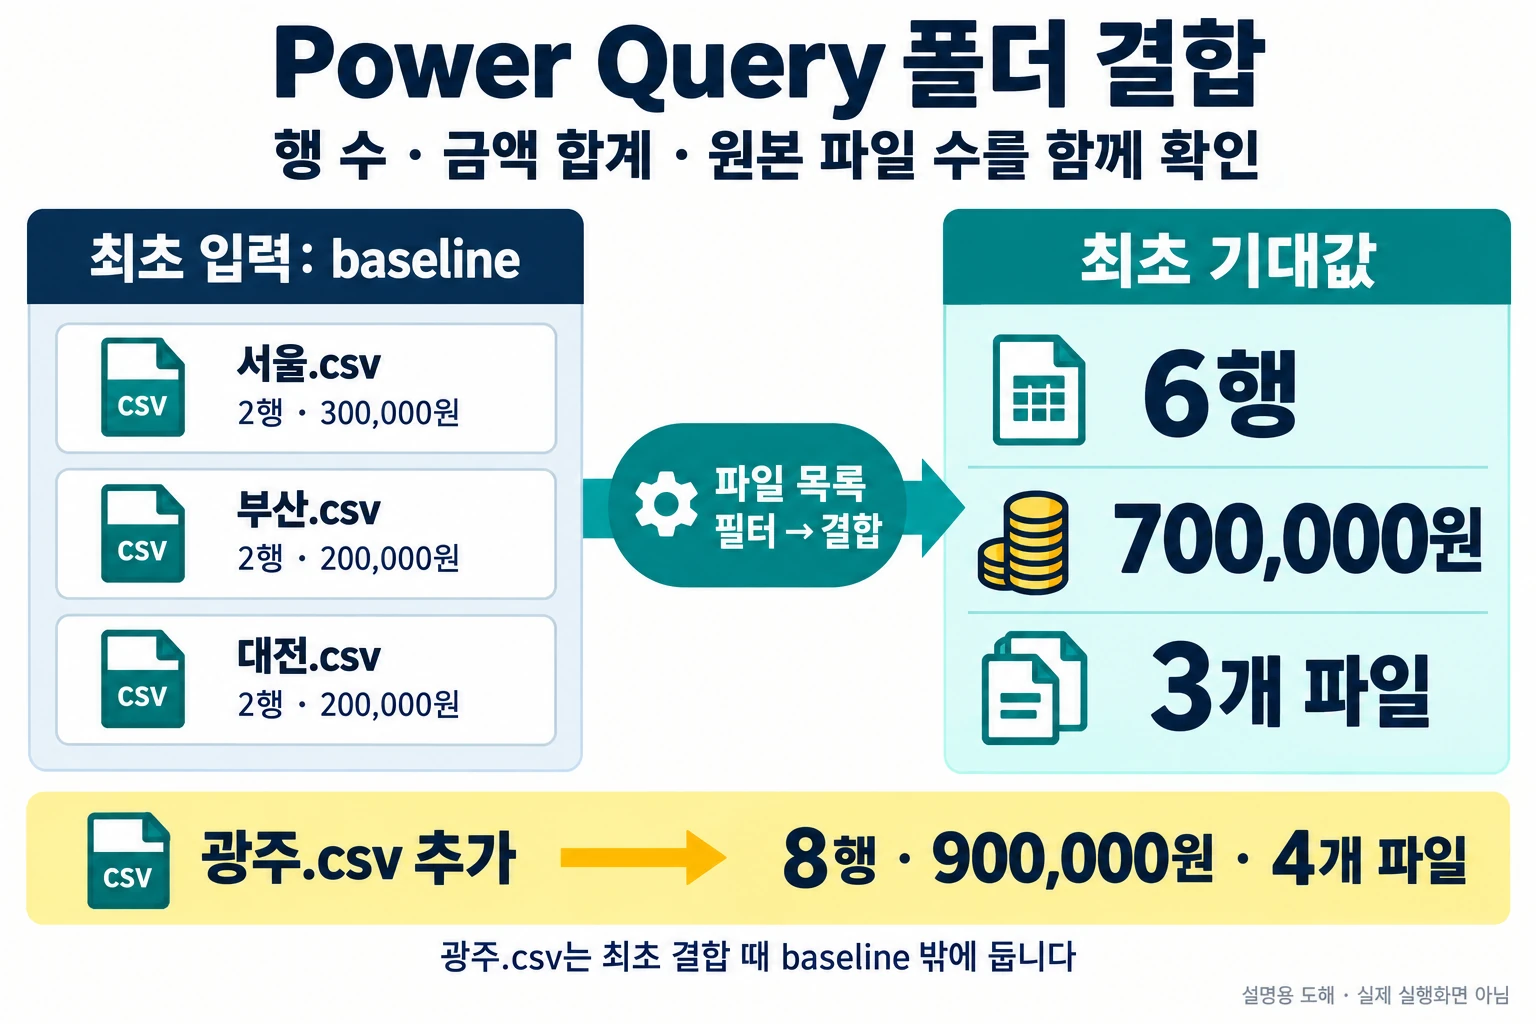
Power Query로 폴더를 합칠 때 먼저 정할 것은 어떤 파일을 포함하고 어떤 숫자로 결과를 확인할지입니다. 이 예제는 같은 머리글을 가진 가상 지점 CSV 세 개를 전용 폴더에 넣어 6행, 금액 합계 700000, 원본 파일 3개를 확인합니다. 다음 파일을 추가한 뒤에는 8행, 900000, 4개로 바뀌어야 합니다. 실제 회사 파일은 사용하지 않습니다.
대표 이미지는 본문의 가상 CSV 결합 기대값을 요약한 설명용 도해입니다. 최초 6행·700000원·파일 3개, 광주 추가 후 8행·900000원·파일 4개를 대조합니다. AI로 제작했으며 실제 Power Query 실행 화면이나 실행 검증 기록이 아닙니다.
입력 파일과 결과 표
ZIP의 baseline 폴더에는 서울.csv, 부산.csv, 대전.csv가 있습니다. 추가용 폴더의 광주.csv는 첫 결합에 넣지 않습니다. 두 폴더는 나란히 두고, 추가용을 baseline의 하위 폴더로 옮기지 마세요. Folder.Files는 지정한 폴더와 하위 폴더의 파일도 반환하기 때문입니다.
CSV는 UTF-8이며 구분자는 쉼표입니다. 각 파일의 머리글은 지점명,품목,금액으로 같습니다. 금액에 천 단위 쉼표를 넣지 않습니다.
| 원본 파일 | 지점명 | 품목 | 금액 |
|---|---|---|---|
| 서울.csv | 서울 | 노트북 | 100000 |
| 서울.csv | 서울 | 모니터 | 200000 |
| 부산.csv | 부산 | 노트북 | 150000 |
| 부산.csv | 부산 | 키보드 | 50000 |
| 대전.csv | 대전 | 모니터 | 120000 |
| 대전.csv | 대전 | 키보드 | 80000 |
결과는 원본 파일명을 보존한 하나의 표입니다. 파일별 합계는 서울 300000, 부산 200000, 대전 200000입니다. 전체 합계만 같고 파일 하나가 빠진 경우를 놓치지 않도록 행 수와 파일별 내역도 확인합니다.
폴더를 결합하기 전에 파일 목록부터 필터링
아래 메뉴는 Windows Excel의 Power Query 폴더 가져오기 흐름입니다. 설치된 Excel에 폴더에서 가져오기가 있는지 먼저 확인합니다. 파일 형식이나 메뉴 제공 여부가 다르면 같은 기능을 지원하는 환경에서 실습합니다.
-
데이터 → 데이터 가져오기 → 파일에서 → 폴더에서를 선택하고
baseline폴더를 지정합니다. -
파일 목록에서 바로 결합하지 말고 데이터 변환을 선택합니다.
-
Power Query 편집기의
Extension을.csv로 필터링합니다.Folder Path가 지정한 baseline 경로인지 확인하고,Name에 서울·부산·대전 세 파일만 남깁니다. 숨김 파일과 임시 파일은 제외합니다. -
Content열을 선택하고 파일 결합을 실행합니다. 샘플 파일의 원본 인코딩을 UTF-8, 구분자를 쉼표로 맞춥니다. 오류가 있는 파일을 건너뛰는 옵션은 켜지 않습니다. -
샘플 변환에서 첫 행을 머리글로 사용했는지 확인합니다. 결합 결과에 머리글 행이 데이터로 반복되어 들어오면 이 단계부터 수정합니다.
-
지점명과품목은 텍스트,금액은 정수로 지정합니다.Source.Name열을 남겨 파일 출처를 확인합니다. -
닫기 및 로드로 새 워크시트에 결과를 불러오고 표 이름을
지점결합으로 정합니다. 결과 통합 문서는 baseline 폴더 밖에 저장합니다.
Microsoft의 폴더 결합 문서는 데이터 변환으로 파일 목록을 연 뒤 Extension 또는 Folder Path를 필터링하고 Content 열을 결합하는 순서를 설명합니다. 결합한 뒤에는 파일 목록 열이 더 이상 남아 있지 않을 수 있으므로 확장자 필터를 뒤늦게 찾지 않습니다.

첫 결합을 숫자로 확인하기
결과 표 밖의 빈 셀에서 다음을 계산합니다.
=ROWS(지점결합[금액])
=SUM(지점결합[금액])
예상 결과는 각각 6과 700000입니다. 원본 파일 수는 원래 쿼리를 삭제하지 말고 참조 쿼리를 만들어 확인합니다. 참조 쿼리에서 Source.Name 열만 남기고 중복 제거한 뒤 행 수를 세면 3이어야 합니다. 이 중복 제거는 파일 수를 세는 참조 쿼리에만 적용하며, 실제 매출 행에서 임의로 중복을 지우지 않습니다.
금액을 Source.Name별로 합산하면 서울.csv 300000, 부산.csv 200000, 대전.csv 200000입니다. 행 수만 같고 금액이 다르면 숫자 형식과 각 파일의 값을 비교합니다. 합계만 같고 출처 수가 다르면 동일 파일이 복제됐거나 일부 파일이 누락됐는지 확인합니다. 확인 완료라는 문구가 입력돼 있다는 이유로 검산한 것으로 보지 않습니다.
새 파일을 넣고 다시 돌아오는 시험
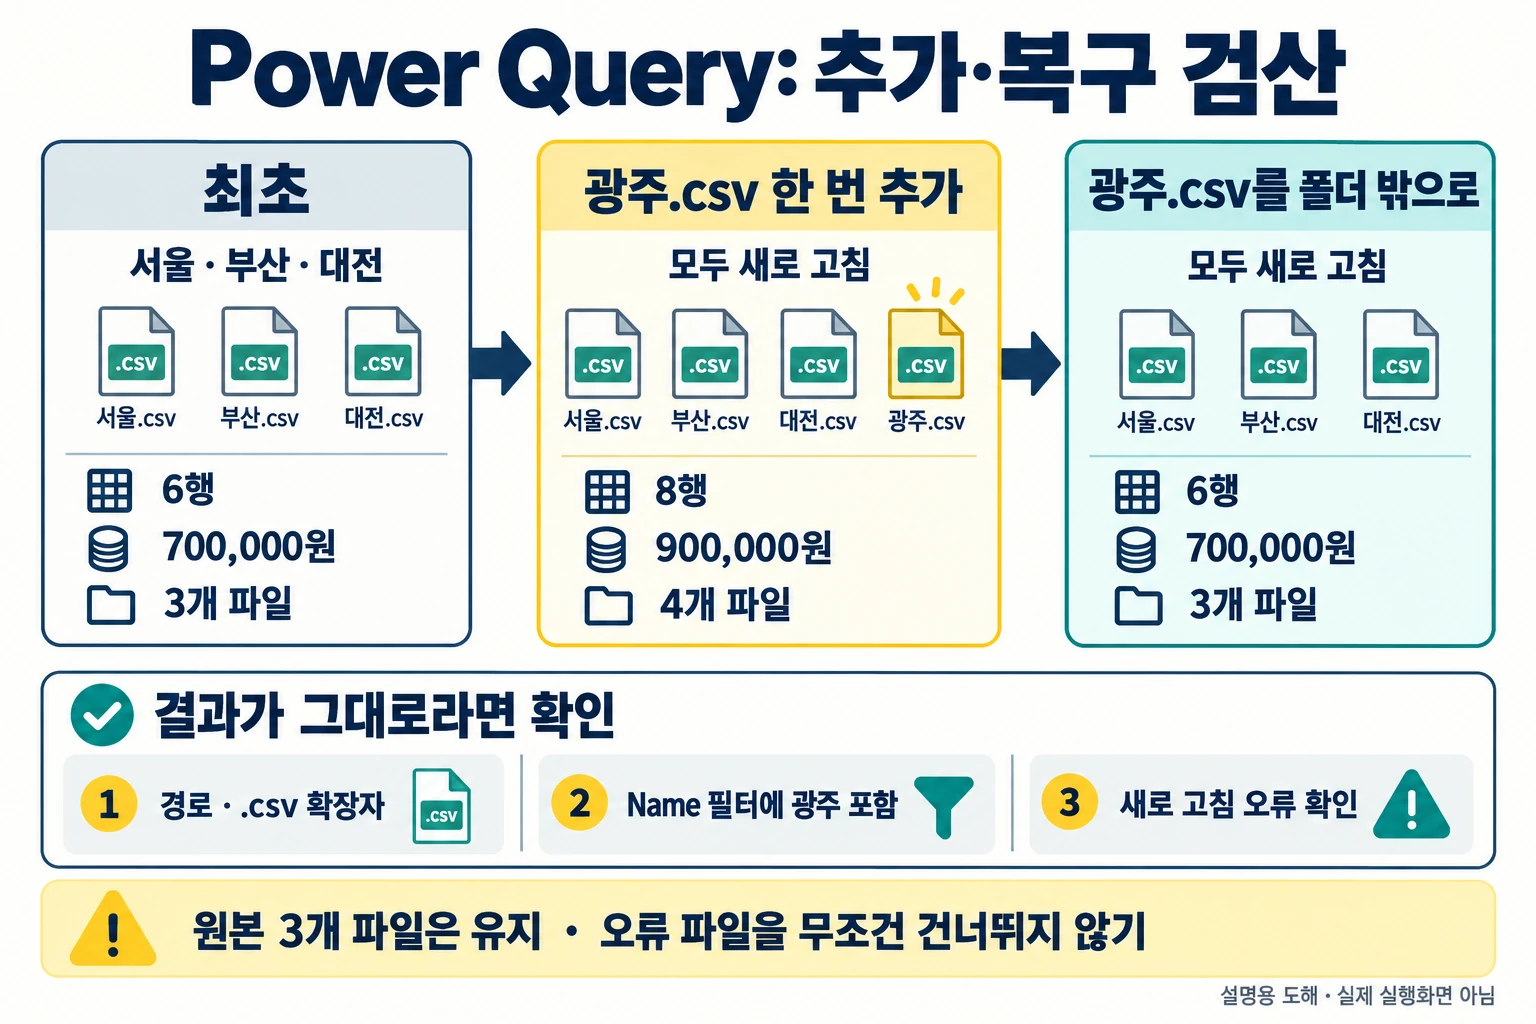
추가용/광주.csv의 두 행은 광주·마우스·90000과 광주·도킹스테이션·110000입니다. 이 파일을 baseline에 한 번만 복사하고 모두 새로 고침을 실행합니다. 결과는 8행, 합계 900000, 파일 4개여야 하며 광주의 추가 합계는 200000입니다.
행 수가 6으로 남으면 파일 경로, Name 필터가 처음 세 이름에 고정됐는지, 확장자, 새로 고침 오류를 확인합니다. 최초 확인에서 이름 목록으로 세 파일을 좁혔다면 광주도 포함하도록 Name 필터를 갱신하거나 전용 폴더 내 모든 유효 CSV를 포함하도록 바꿉니다. 필터 변경 뒤에는 예상 파일 목록을 다시 대조합니다.
복구 시험은 광주.csv를 baseline 밖으로 옮기고 새로 고침하는 것입니다. 원본 세 파일을 지우지 않고 6행·700000·3개로 복귀하는지 확인합니다. 이 수치는 가상 CSV 입력으로 계산한 기대값이며 실제 Power Query 실행 결과를 주장하는 것은 아닙니다. 제작 과정에서는 Excel/Power Query를 실행하지 않았습니다.
원본 형식이 달라졌을 때
머리글 금액이 매출액으로 바뀌거나 뒤에 공백이 붙으면 같은 스키마가 아닙니다. 오류를 지우거나 해당 파일을 자동으로 건너뛰지 말고 샘플 파일의 변환 단계와 실제 헤더를 비교합니다. 값에 통화 기호나 메모가 섞여 숫자 변환이 실패하면 원본 행과 파일명을 남긴 뒤 형식 규칙을 정합니다. 반품처럼 음수인 정상 금액이 있을 수 있으므로 단순히 금액 > 0 필터로 오류를 해결하지 않습니다.
열의 앞뒤 공백을 제거하는 작업과 인쇄할 수 없는 문자를 제거하는 작업은 다릅니다. 필요한 변환만 적용하고 변환 전후의 값 몇 개를 직접 대조합니다. 파일 열 구조가 바뀌면 기존의 적용된 단계를 그대로 믿지 말고 최초 세 숫자를 다시 검산합니다.
개인정보 수준 경고와 도구 선택
개인정보 수준 경고가 나면 연결된 원본 목록과 각 원본의 분류를 확인합니다. 경고를 없애기 위해 개인정보 수준을 무시하는 설정부터 켜지 않습니다. Microsoft 문서는 수준을 무시하면 민감한 자료가 노출될 수 있다고 경고합니다. 회사 자료에서는 담당자와 허용된 결합 경계를 확인하고, 이 글의 로컬 가상 CSV만 있는 별도 사본에서 경로를 재현합니다.
Power Query는 여러 파일의 동일 변환을 다시 실행할 때 사용할 수 있습니다. 이 예제의 쿼리는 파일을 읽어 결과 표를 만들며 원본 CSV에 다시 쓰지 않습니다. 출력 보고서의 버튼·메일·PDF 배포는 별도 작업으로 구분합니다. 연결만 만들기는 시트로 로드하지 않는 옵션이며, 데이터 모델이나 다른 쿼리·피벗에서 사용하려면 해당 로드 방식을 따로 지정해야 합니다. 메모리에만 저장된다고 단정하지 않습니다.
공식 문서
출처 원문 수집일: S1 2026-09-23; S2 2026-09-23; S3 2026-09-23. 파일 필터 순서, 하위 폴더 포함 범위와 개인정보 경고의 의미를 대조했습니다.
작성자 소개
