CSV 처리 스크립트의 성공·실패 종료와 출력 파일을 자동 시험하기
CSV 처리 코드를 고친 뒤 정상 파일 하나를 실행해 보고 끝내면, 오류 입력을 조용히 받아들이거나 기존 결과를 덮어쓰는 변경을 놓칠 수 있습니다. 성공 문구가 찍혔는데 결과 파일이 없거나, 실패했다면서 일부 결과가 남는 경우도 확인해야 합니다.
이번 실습은 CSV 프로그램을 별도 Python 프로세스로 실행하는 자동 시험을 만듭니다. 정상 입력 1개와 의도한 실패 4개에 대해 종료 코드, 입력 원본의 SHA-256, 최종 출력 상태를 함께 대조합니다. 대상 프로그램의 함수를 직접 가져와 채점하지 않고, 명령을 실행한 뒤 밖에서 관측하는 시험입니다.
실제 조사·코드 실행·검수는 2026년 10월 10일 한국시간에 수행했습니다. 핵심 사례는 가상 주문 두 행이며, 추가 경계 시험에는 별도로 만든 가상 CSV와 임시 연습 폴더를 사용했습니다. Windows·Excel 앱, 실제 업무 폴더, 유료 API는 실행하지 않았습니다.
1. 다섯 사례의 계약을 실행 전에 적기
이 글에서 회귀 시험은 코드를 고친 뒤에도 정해 둔 동작이 유지되는지 다시 확인하는 뜻입니다. 시험 입력을 fixture라고 부르며, 여기에는 CSV 바이트뿐 아니라 출력 파일이 이미 있는지 같은 시작 상태도 포함됩니다.
| 시험 입력 | 대상 종료 코드 | 출력 조건 |
|---|---|---|
| normal.csv | 0 | 헤더와 두 행 전체 일치 |
| header_missing.csv | 2 | 최종 출력 경로 없음 |
| duplicate_key.csv | 2 | 최종 출력 경로 없음 |
| impossible_date.csv | 2 | 최종 출력 경로 없음 |
| output_collision.csv + 기존 결과 | 3 | 기존 결과 SHA-256 동일 |
모든 사례에서 입력 바이트는 실행 전후 같아야 합니다. 정상 사례는 출력의 헤더와 두 행 전체도 같아야 합니다. 출력 충돌 사례는 시험기가 미리 DO NOT OVERWRITE라는 파일을 만들어 놓고 그 바이트가 보존되는지 검사합니다. 충돌용 CSV는 정상 CSV와 같은 값이며, 차이는 시작할 때 출력이 있다는 점입니다.
이 실습이 정한 종료 코드는 성공 0, 데이터·명령 사용 오류 2, 출력 충돌 3, 파일 입출력 오류 4입니다. 다른 프로그램의 2나 3도 같은 의미라는 표준은 아닙니다. 대상 프로그램의 계약을 먼저 확인해야 합니다.
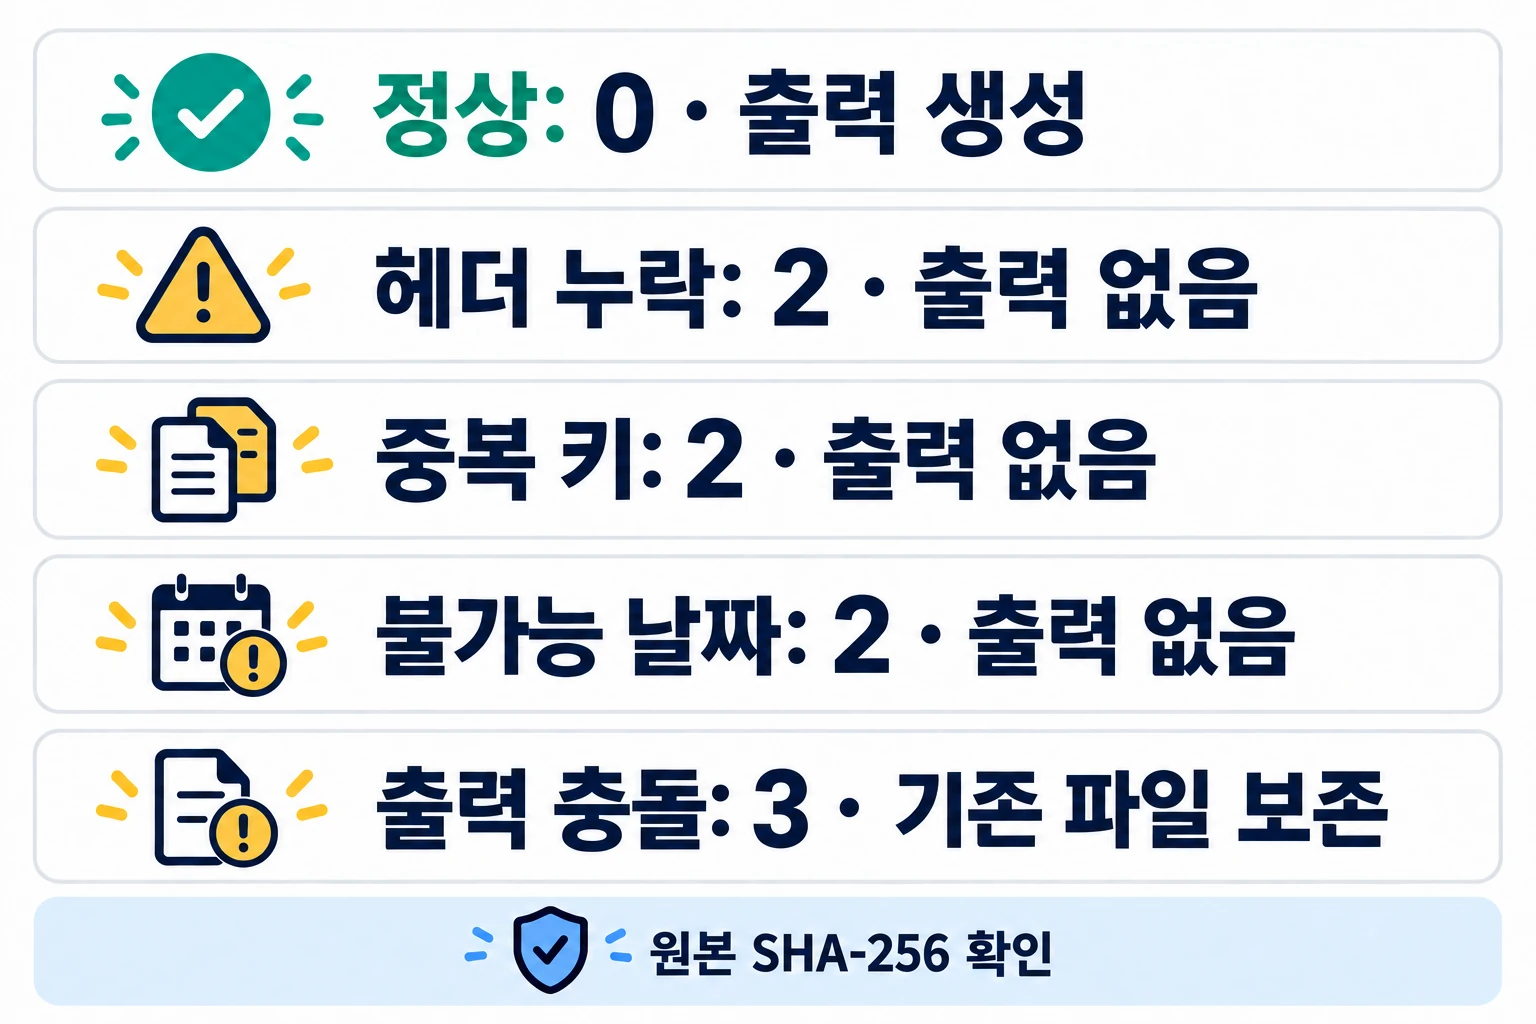
네 개의 실패 입력을 올바르게 거부하면 네 개의 시험도 통과합니다. 대상 CSV 프로그램의 종료 코드 2·3과, 시험을 실행한 unittest의 종료 코드를 구분하세요. 다섯 사례가 전부 기대대로 움직이면 시험 명령은 0으로 끝나고 OK를 표시합니다.
2. 같은 ZIP의 입력과 독립 기대값 확인하기
실습 ZIP 내려받기를 새 빈 로컬 연습 폴더에 풉니다. 회사 공유 폴더, 다른 프로그램이 쓰는 폴더, 동기화 중인 폴더는 사용하지 마세요. README_KO.md와 validate_orders.py가 있는 폴더에서 터미널을 엽니다. Python 표준 라이브러리만 필요합니다.
정상 입력 fixtures/normal.csv의 전체 내용입니다. 날짜와 금액은 실제 주문 자료가 아닙니다.
order_id,order_date,amount
ORD-001,2026-10-01,1200
ORD-002,2026-10-02,3400.5
예상 출력은 다음과 같습니다. 헤더 순서, 주문 ID, 날짜, 금액 두 자리 문자열까지 고정합니다. 금액 합계를 내는 실습은 아닙니다.
order_id,order_date,amount
ORD-001,2026-10-01,1200.00
ORD-002,2026-10-02,3400.50
시험 코드 안에 이 기대 행을 직접 적었습니다. 대상 프로그램을 실행해 나온 결과를 그대로 정답으로 저장하거나, 대상의 validated_payload를 불러 정답을 만들지 않습니다. 같은 오류를 양쪽이 공유하는 상황을 줄이기 위한 구조입니다.
실패 입력은 각각 하나의 계약을 깨뜨립니다. header_missing.csv는 amount 헤더가 없고, duplicate_key.csv는 ORD-001이 두 번입니다. impossible_date.csv에는 2026-02-30이 있습니다. CSV는 파싱되더라도 실제 달력 날짜가 성립하지 않으면 거부합니다. 파일 내용은 ZIP에서 그대로 확인할 수 있습니다.
대상은 order_id를 대문자 ASCII·숫자·밑줄·하이픈 1~32자로 제한하고, 날짜는 YYYY-MM-DD 표기와 실제 날짜를 모두 검사합니다. amount는 음수 아닌 숫자에 소수 둘째 자리까지만 허용합니다. UTF-8 또는 UTF-8 BOM 입력을 읽고 결과는 UTF-8, 줄 끝 LF로 씁니다. 이 제한은 가상 입력을 위한 규칙이며 일반 주문 시스템의 정책을 대신하지 않습니다.
3. 시험 명령 하나로 다섯 사례 실행하기
python -m unittest test_cli_regression -v각 시험은 TemporaryDirectory로 자기 작업 폴더를 만듭니다. 원래 fixture를 임시 폴더의 orders input.csv에 복사하고, orders output.csv라는 새 결과 경로를 넘깁니다. 성공 시험에서 만든 결과가 다음 실패 시험에 섞이지 않도록 사례마다 폴더를 나눕니다. 임시 폴더는 시험이 끝날 때 정리됩니다.
하네스는 다음 형태로 실행합니다. 아래는 전체 코드의 핵심 호출입니다.
[sys.executable, "-I", str(TARGET), str(source), str(destination)]sys.executable은 현재 시험을 돌리는 Python 실행 파일입니다. 문자열 명령 하나를 셸에 전달하지 않고 인수 목록과 shell=False를 사용하므로, 경로에 공백이 있어도 입력 경로와 출력 경로가 각각 하나의 인수로 전달됩니다. -I는 Python의 격리 모드 옵션이며 운영체제 샌드박스가 아닙니다. 임의로 내려받은 낯선 프로그램에 이 시험기를 연결하지 마세요.
check=False로 실행한 뒤 returncode를 직접 검사합니다. check=True였다면 데이터 오류 2처럼 예상한 실패도 먼저 예외가 됩니다. 여기서는 예상 코드와 실제 코드가 같은지를 assertEqual로 확인합니다. stdout·stderr 문구도 확인하지만 파일 상태 검사를 함께 수행합니다. Python subprocess 공식 문서
Windows에서 Python 실행 명령이 py -3.12라면 시험 명령의 앞부분을 py -3.12 -m unittest test_cli_regression -v로 바꿀 수 있습니다. 이 안내의 Windows 실행 결과는 검증하지 않았습니다. 실제 시험에 사용한 Linux·Python 버전은 아래 검수 기록에 적었습니다.
4. 종료 코드와 파일 상태를 함께 검사하기
정상 사례에서 세 가지를 확인합니다. 첫째, 종료 코드가 0이고 stdout이 OK rows=2인지 봅니다. 둘째, 새 출력이 일반 파일이며 심볼릭 링크가 아닌지 봅니다. 셋째, 파일을 제한된 크기만 읽어 CSV로 파싱하고 헤더와 두 행을 독립 기대값에 대조합니다. 행 수만 같거나 파일명만 맞는 결과는 통과하지 않습니다.
실패 사례는 종료 코드와 stderr의 오류 종류를 확인한 뒤 최종 경로가 없는지 검사합니다. Path.exists()만으로는 끊어진 심볼릭 링크를 놓칠 수 있으므로 is_symlink()도 확인합니다. 입력 오류로 실패한 경로에 이런 링크가 남아 있어도 시험 실패입니다.
출력 충돌은 이미 파일이 있다는 조건이므로 출력 없음 검사를 하지 않습니다. 시험 전에 저장한 sentinel의 SHA-256과 실행 뒤 값을 비교합니다. 대상이 덮어쓰거나 파일을 없앤 경우에는 통과하지 않습니다. 입력도 모든 사례에서 실행 전후 해시가 같아야 합니다. SHA-256 일치는 비교한 바이트의 동일성을 확인하는 것이며 파일의 업무 의미나 안전성을 인증하지는 않습니다. Python hashlib 공식 문서
원본 보존 검사는 finally 안에 두어 실행 중 예외가 발생해도 확인하도록 했습니다. 다만 한 검사에서 예외가 나면 그 뒤의 모든 assertion까지 실행됐다고 볼 수는 없습니다. timeout이나 로그 크기 초과는 해당 시험의 오류·실패로 표시하며, 완료 검산 통과로 취급하지 않습니다.
5. timeout과 크기 상한의 실제 범위
제공 대상은 입력 65,536바이트, 데이터 1,000행, CSV 필드 128자, 결과 32,768바이트로 제한합니다. 입력은 상한보다 한 바이트 더 읽어 초과를 판별하고, 결과 payload는 출력 경로를 만들기 전에 검사합니다. 이 코드는 소형 교육용 CSV를 메모리에서 검증하므로 대용량 스트리밍 처리 예제가 아닙니다.
하네스의 기본 timeout은 10초입니다. 이 값을 넘으면 subprocess.run이 직접 실행한 자식 프로세스를 종료하고 TimeoutExpired를 보고합니다. 자식이 다른 자식을 만든 상황까지 모든 후손이 종료되는 보장은 제공하지 않습니다. 제공 대상은 다른 프로그램을 실행하지 않습니다. 프로세스 생성 자체에 드는 시간이 모든 플랫폼에서 정확히 10초 안에 제한된다는 뜻도 아닙니다.
stdout·stderr는 capture_output=True로 메모리에 모으지 않고 임시 파일에 받습니다. 프로세스가 끝나면 각각 4,096바이트 이하인지 확인하고 제한된 양만 읽습니다. 진단 문구를 비교할 때 CRLF 줄 끝을 LF로 정규화하며, 상한은 정규화 전 원래 바이트 수로 검사합니다. 실행 중 로그 파일의 디스크 증가를 적극적으로 막는 hard cap은 아닙니다. 따라서 악의적이거나 로그를 무한 출력하는 프로그램에 적용할 자원 격리 도구로 사용하면 안 됩니다.
입력·결과·로그의 읽기 상한을 정했다고 전체 프로세스의 최대 메모리나 디스크 사용량을 측정한 것은 아닙니다. 시간 초과·로그 초과 경계는 추가 시험에서 실제로 확인했지만 성능 벤치마크는 하지 않았습니다.
6. 실패한 시험을 읽고 복구하기
- 종료 코드가 기대값과 다름: traceback과 stderr를 읽고 대상의 종료 계약이 바뀌었는지 확인합니다. 시험을 통과시키려고 2와 0을 같게 취급하지 않습니다.
- 정상 stdout은 맞지만 파일 없음: 결과 생성 경로와 파일 쓰기 오류를 확인합니다. 성공 문구만으로 통과시키지 않습니다.
- 정상 결과의 셀이 다름: 기대 헤더·두 행과 실제 결과를 대조합니다. 정책 변경이라면 변경 이유와 새 기대값을 따로 검토한 뒤 시험을 갱신합니다.
- 원본 해시가 달라짐: 실습을 멈추고 별도로 보존한 입력과 비교합니다. 원본을 새 결과로 덮어쓴 상태를 정상화하지 않습니다.
- 충돌 파일 해시가 달라짐: 기존 파일을 보존한 사본에서 원인을 확인하고 새 출력 이름으로 실행합니다. 기존 결과를 지워 성공을 만들지 않습니다.
- timeout 또는 로그 상한 초과: 해당 시험은 통과하지 않았습니다. 먼저 제공한 대상 파일이 맞는지와 무한 루프·과도한 출력을 확인합니다. 무작정 한도를 크게 올리지 않습니다.
한 사례만 다시 실행할 때는 다음 명령을 사용합니다. 오류 입력을 올바르게 거부하는 것이 이 시험의 성공 조건입니다.
python -m unittest test_cli_regression.CliRegressionTests.test_header_missing -v수정한 뒤에는 다섯 핵심 사례와 추가 경계를 모두 다시 실행합니다.
python -m unittest discover -v대상을 수동으로 확인하고 싶다면 아직 없는 출력 이름을 사용합니다.
python validate_orders.py fixtures/normal.csv manual_result.csv첫 정상 실행의 stdout은 OK rows=2, 종료 코드는 0입니다. 같은 이름으로 다시 실행하면 ERROR conflict가 stderr에 나오고 코드 3으로 끝나며 기존 파일을 보존합니다. 시험기는 이런 기존 결과를 사용하는 대신 각 사례의 임시 폴더를 새로 만듭니다.
7. ZIP과 같은 전체 시험 코드
핵심 하네스와 교육용 대상의 전체 파일을 그대로 실었습니다. 추가 경계 시험과 실행 증거는 ZIP에 있습니다. 단편 코드만 모아 새 파일을 만드는 대신 ZIP의 같은 파일로 실행하세요.
test_cli_regression.py
test_cli_regression.py 전체 코드 펼치기
"""P55: five independent subprocess contract tests; standard library only."""
import csv
import hashlib
import io
import subprocess
import sys
import tempfile
import unittest
from dataclasses import dataclass
from pathlib import Path

ROOT = Path(__file__).resolve().parent
TARGET = ROOT / "validate_orders.py"
TIMEOUT_SECONDS = 10
LOG_LIMIT = 4096
INPUT_LIMIT = 65536
OUTPUT_LIMIT = 32768


class OutputLimitExceeded(AssertionError):
    """The completed process wrote more diagnostic bytes than allowed."""


def read_bounded(path, limit):
    with Path(path).open("rb") as stream:
        data = stream.read(limit + 1)
    if len(data) > limit:
        raise OutputLimitExceeded(f"file exceeds {limit} bytes")
    return data


def sha256(path, limit=INPUT_LIMIT):
    return hashlib.sha256(read_bounded(path, limit)).hexdigest()


def read_log(stream, name):
    stream.seek(0, 2)
    size = stream.tell()
    if size > LOG_LIMIT:
        raise OutputLimitExceeded(f"{name} exceeds {LOG_LIMIT} bytes: {size}")
    stream.seek(0)
    decoded = stream.read(LOG_LIMIT + 1).decode("utf-8", errors="strict")
    # Normalize diagnostics only; the limit and byte counts remain raw bytes.
    return decoded.replace("\r\n", "\n"), size


@dataclass(frozen=True)
class RunResult:
    returncode: int
    stdout: str
    stderr: str
    stdout_bytes: int
    stderr_bytes: int


def run_program(argv, cwd, timeout=TIMEOUT_SECONDS):
    # Files avoid capture_output's in-memory buffering. Their disk growth is
    # checked AFTER completion, not actively capped while the child is running.
    with tempfile.TemporaryFile(dir=cwd) as out_log, \
            tempfile.TemporaryFile(dir=cwd) as err_log:
        process = subprocess.run(
            argv, cwd=cwd, stdin=subprocess.DEVNULL,
            stdout=out_log, stderr=err_log, shell=False,
            timeout=timeout, check=False,
        )
        stdout, stdout_bytes = read_log(out_log, "stdout")
        stderr, stderr_bytes = read_log(err_log, "stderr")
    return RunResult(process.returncode, stdout, stderr,
                     stdout_bytes, stderr_bytes)


def run_cli(source, destination, cwd):
    return run_program(
        [sys.executable, "-I", str(TARGET), str(source), str(destination)], cwd
    )


class CliRegressionTests(unittest.TestCase):
    def setUp(self):
        temporary = tempfile.TemporaryDirectory(prefix="p55-case-")
        self.addCleanup(temporary.cleanup)
        self.work = Path(temporary.name)
        # Spaces in names also verify argument-list handling without a shell.
        self.source = self.work / "orders input.csv"
        self.output = self.work / "orders output.csv"
        self.observations = {}

    def exercise(self, fixture, expected_code, stdout, stderr, collision=False):
        original = ROOT / "fixtures" / f"{fixture}.csv"
        original_hash = sha256(original)
        self.source.write_bytes(read_bounded(original, INPUT_LIMIT))
        before = sha256(self.source)
        sentinel_hash = None
        if collision:
            self.output.write_bytes(b"DO NOT OVERWRITE\n")
            sentinel_hash = sha256(self.output)
        try:
            result = run_cli(self.source, self.output, self.work)
        finally:
            after = sha256(self.source)
            self.observations.update(
                fixture=fixture, input_sha256_before=before,
                input_sha256_after=after, input_unchanged=before == after,
                bundled_fixture_unchanged=sha256(original) == original_hash,
            )
            self.assertEqual(after, before, "input bytes changed")
            self.assertEqual(sha256(original), original_hash)
        self.observations.update(
            expected_returncode=expected_code, actual_returncode=result.returncode,
            stdout=result.stdout, stderr=result.stderr,
            stdout_bytes=result.stdout_bytes, stderr_bytes=result.stderr_bytes,
            final_output_exists=self.output.exists() or self.output.is_symlink(),
        )
        self.assertEqual(result.returncode, expected_code)
        self.assertEqual(result.stdout, stdout)
        self.assertEqual(result.stderr, stderr)
        if collision:
            after_sentinel = sha256(self.output)
            self.observations.update(
                sentinel_sha256_before=sentinel_hash,
                sentinel_sha256_after=after_sentinel,
                sentinel_unchanged=sentinel_hash == after_sentinel,
            )
            self.assertEqual(after_sentinel, sentinel_hash)
        elif expected_code != 0:
            self.assertFalse(self.output.exists() or self.output.is_symlink(),
                             "failed run left final output")
        return result

    def test_normal(self):
        self.exercise("normal", 0, "OK rows=2\n", "")
        self.assertTrue(self.output.is_file(), "success did not create output")
        self.assertFalse(self.output.is_symlink(), "success output is a symlink")
        output_bytes = read_bounded(self.output, OUTPUT_LIMIT)
        parsed = list(csv.reader(io.StringIO(output_bytes.decode("utf-8"),
                                             newline=""), strict=True))
        # Expectations deliberately do not import the target's validation code.
        expected = [
            ["order_id", "order_date", "amount"],
            ["ORD-001", "2026-10-01", "1200.00"],
            ["ORD-002", "2026-10-02", "3400.50"],
        ]
        self.assertEqual(parsed, expected)
        self.observations.update(output_rows=parsed, output_bytes=len(output_bytes),
                                 output_sha256=sha256(self.output, OUTPUT_LIMIT))

    def test_header_missing(self):
        self.exercise("header_missing", 2, "", "ERROR data: header\n")

    def test_duplicate_key(self):
        self.exercise("duplicate_key", 2, "", "ERROR data: duplicate_key\n")

    def test_impossible_date(self):
        self.exercise("impossible_date", 2, "", "ERROR data: date\n")

    def test_output_collision(self):
        self.exercise("output_collision", 3, "", "ERROR conflict\n", collision=True)


if __name__ == "__main__":
    unittest.main(verbosity=2)
validate_orders.py
validate_orders.py 전체 코드 펼치기
"""Small trusted CLI target for P55, not a production CSV framework."""
import argparse
import csv
import io
import re
import sys
from datetime import date
from decimal import Decimal
from pathlib import Path

HEADER = ["order_id", "order_date", "amount"]
MAX_INPUT_BYTES = 65536
MAX_OUTPUT_BYTES = 32768
MAX_ROWS = 1000
MAX_FIELD_CHARS = 128


class DataError(ValueError):
    pass


def validated_payload(source):
    if not source.is_file():
        raise OSError("input is not a regular file")
    with source.open("rb") as stream:
        data = stream.read(MAX_INPUT_BYTES + 1)
    if len(data) > MAX_INPUT_BYTES:
        raise DataError("input_limit")
    try:
        text = data.decode("utf-8-sig")
    except UnicodeError as exc:
        raise DataError("encoding") from exc
    csv.field_size_limit(MAX_FIELD_CHARS)
    rows, seen = [], set()
    try:
        reader = csv.reader(io.StringIO(text, newline=""), strict=True)
        if next(reader, None) != HEADER:
            raise DataError("header")
        for number, row in enumerate(reader, start=1):
            if number > MAX_ROWS:
                raise DataError("row_limit")
            if len(row) != 3:
                raise DataError("columns")
            key, day, amount = row
            if not re.fullmatch(r"[A-Z0-9_-]{1,32}", key):
                raise DataError("key")
            if key in seen:
                raise DataError("duplicate_key")
            if not re.fullmatch(r"[0-9]{4}-[0-9]{2}-[0-9]{2}", day):
                raise DataError("date")
            try:
                date.fromisoformat(day)
            except ValueError as exc:
                raise DataError("date") from exc
            if not re.fullmatch(r"[0-9]{1,9}(?:\.[0-9]{1,2})?", amount):
                raise DataError("amount")
            seen.add(key)
            rows.append([key, day, format(Decimal(amount), ".2f")])
    except csv.Error as exc:
        raise DataError("csv") from exc
    if not rows:
        raise DataError("empty")
    buffer = io.StringIO(newline="")
    writer = csv.writer(buffer, lineterminator="\n")
    writer.writerow(HEADER)
    writer.writerows(rows)
    payload = buffer.getvalue().encode("utf-8")
    if len(payload) > MAX_OUTPUT_BYTES:
        raise DataError("output_limit")
    return payload, len(rows)


def main(argv=None):
    parser = argparse.ArgumentParser(description="Validate synthetic order CSV")
    parser.add_argument("input", type=Path)
    parser.add_argument("output", type=Path)
    args = parser.parse_args(argv)
    created = False
    try:
        if (args.output.is_symlink() or args.output.exists()
                or args.input.resolve() == args.output.resolve()):
            print("ERROR conflict", file=sys.stderr)
            return 3
        payload, count = validated_payload(args.input)
        # 'xb' fails if the destination exists; it never overwrites a sentinel.
        stream = args.output.open("xb")
        created = True
        with stream:
            stream.write(payload)
    except FileExistsError:
        print("ERROR conflict", file=sys.stderr)
        return 3
    except DataError as exc:
        print(f"ERROR data: {exc}", file=sys.stderr)
        return 2
    except (OSError, RuntimeError):  # Python 3.12 resolve() may flag a symlink loop.
        if created:
            try:
                args.output.unlink()
            except OSError:
                print("ERROR io: cleanup_failed", file=sys.stderr)
                return 4
        print("ERROR io", file=sys.stderr)
        return 4
    print(f"OK rows={count}")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
대상은 모든 입력과 결과 크기를 먼저 검증한 뒤 xb 모드로 새 출력만 만듭니다. 기존 이름을 덮어쓰지 않는 소형 예제입니다. 파일을 쓰는 동안 최종 이름이 잠시 존재할 수 있고, 강제 종료·정전·동시 변경에서 불완전 파일이 절대 남지 않는다는 보장은 하지 않습니다. 이 글의 입력 오류 세 사례는 출력 생성 전에 실패하며, 출력 충돌은 기존 파일을 보존합니다. 완료 이름을 공개하는 순서 자체를 다루는 별도 실습은 처리 중인 CSV의 임시 파일·검산 저장을 참고하세요.
8. 실제 실행 검수와 다운로드 확인
Linux의 Python 3.12.14와 Python 3.13.5에서 제공 핵심 5개·추가 경계 24개, 합계 29개를 각각 실행해 실패·오류·건너뜀 없이 통과했습니다. 별도로 작성한 독립 검수 38개도 두 버전에서 각각 통과했습니다. 날짜 표기, 원본/기존 결과 보존, 행·필드·입력·출력 상한, 잘못된 인코딩, timeout, stdout·stderr 사후 상한, 일반·끊어진·순환 출력 링크 경계를 포함합니다.
핵심 명령의 실제 출력은 다음과 같습니다. 시험 순서는 unittest가 정하므로 표의 순서와 다를 수 있습니다.
test_duplicate_key ... ok
test_header_missing ... ok
test_impossible_date ... ok
test_normal ... ok
test_output_collision ... ok
Ran 5 tests
OK
위 출력은 실행 시간과 모듈 경로를 생략한 요약입니다. 전체 로그·실제 종료 코드는 ZIP의 evidence 기록에 있습니다. 정상 대상은 코드 0, 헤더 누락·중복 키·불가능 날짜는 2, 출력 충돌은 3을 반환했고 입력 SHA-256은 전후 같았습니다. 실패 세 사례에는 최종 출력 경로가 없었고, 충돌 사례의 기존 파일 해시도 같았습니다.
자동 시험 자체의 검사력이 있는지도 확인했습니다. 성공 문구만 출력하는 대상, 다른 CSV를 쓰는 대상, 잘못된 종료 코드, 원본 변경, 기존 결과 훼손, 실패 뒤 일부 출력, 실패 뒤 끊어진 출력 링크를 남기는 합성 대상은 해당 검사를 통과하지 못했습니다. 검사를 느슨하게 바꿔 모두 통과로 만드는 방법을 사용하지 않았습니다.
제작 중 독립 검수에서 순환 링크의 Python 버전별 예외 차이와 끊어진 출력 링크를 exists()만으로 놓치는 반례를 발견해 수정했습니다. 수정 후 두 버전에서 다시 실행했습니다. 이것은 운영 폴더에 악의적인 프로그램을 실행한 기록이 아니라 격리된 임시 폴더의 합성 반례 시험입니다.
이 결과는 제공한 소형 합성 프로그램과 시험 범위의 기록입니다. 임시 폴더 정리·경로 해석·파일 잠금·권한 오류는 운영체제와 파일시스템에 따라 달라질 수 있습니다. Windows·Excel 앱·실제 모바일 기기·동시 쓰기·정전 내구성은 시험하지 않았습니다.
ZIP에는 가상 fixture 5개, 전체 대상과 시험 코드, README, 독립 기대 출력, 실제 실행 로그·버전·검증 보고서와 파일별 SHA-256 목록을 넣었습니다. 공개 업로드 뒤 실제 ZIP을 내려받아 로컬 ZIP의 SHA-256과 CRC를 대조하고 새 폴더에서 다시 실행했습니다.
ZIP SHA-256: 281f645aa395bf69f874928b4abc05dca2e782cba2221d6dfcfa9a1cd9f74b27
9. 시험 범위를 넓힐 때 유지할 기준
다른 CSV 프로그램에 연결하려면 실행 인수, 종료 코드, 입력·출력 형식, 기존 결과 정책을 먼저 바꿔 적습니다. 이번 대상의 코드 2·3과 세 헤더를 그대로 모든 프로그램에 적용하지 않습니다. 외부 네트워크·메일·결제·운영 데이터 쓰기가 있는 프로그램은 격리된 fixture 폴더만으로 안전해지지 않습니다.
함수 수정의 diff와 반환값·예외를 보는 AI 코드 수정 뒤 기존 기능 확인에서 한 단계 더 나아가, 여기서는 실제 명령의 종료와 파일 상태를 함께 관측했습니다. fetchmany 결과의 모든 ID 검산처럼 별도 데이터 완전성 계약이 필요한 프로그램이라면 그 검산도 성공 assertion에 추가해야 합니다.
공식 자료는 실제 조사일에 다시 확인했습니다. 실행 버전과 문서 판을 구분한 기록은 ZIP에 있습니다.
- Python unittest: assertEqual·실패와 오류·명령행 실행
- Python subprocess: returncode·timeout·check
- Python tempfile: TemporaryDirectory·TemporaryFile
- Python pathlib: exists·is_symlink·파일 경로
- Python csv: newline·reader·필드 제한
- Python datetime: date.fromisoformat
조사 당시 현재 /3/ subprocess·unittest 문서는 Python 3.15.0 documentation으로 표시됐고, 본문에서 연결한 /3.12/ 문서는 3.12.15 표기였습니다. 실행 검수는 3.12.14·3.13.5이며 현재 문서 버전에서 실행했다고 쓰지 않았습니다. 표시 게시일과 실제 조사·실행일도 구분했습니다.
작성자 소개
