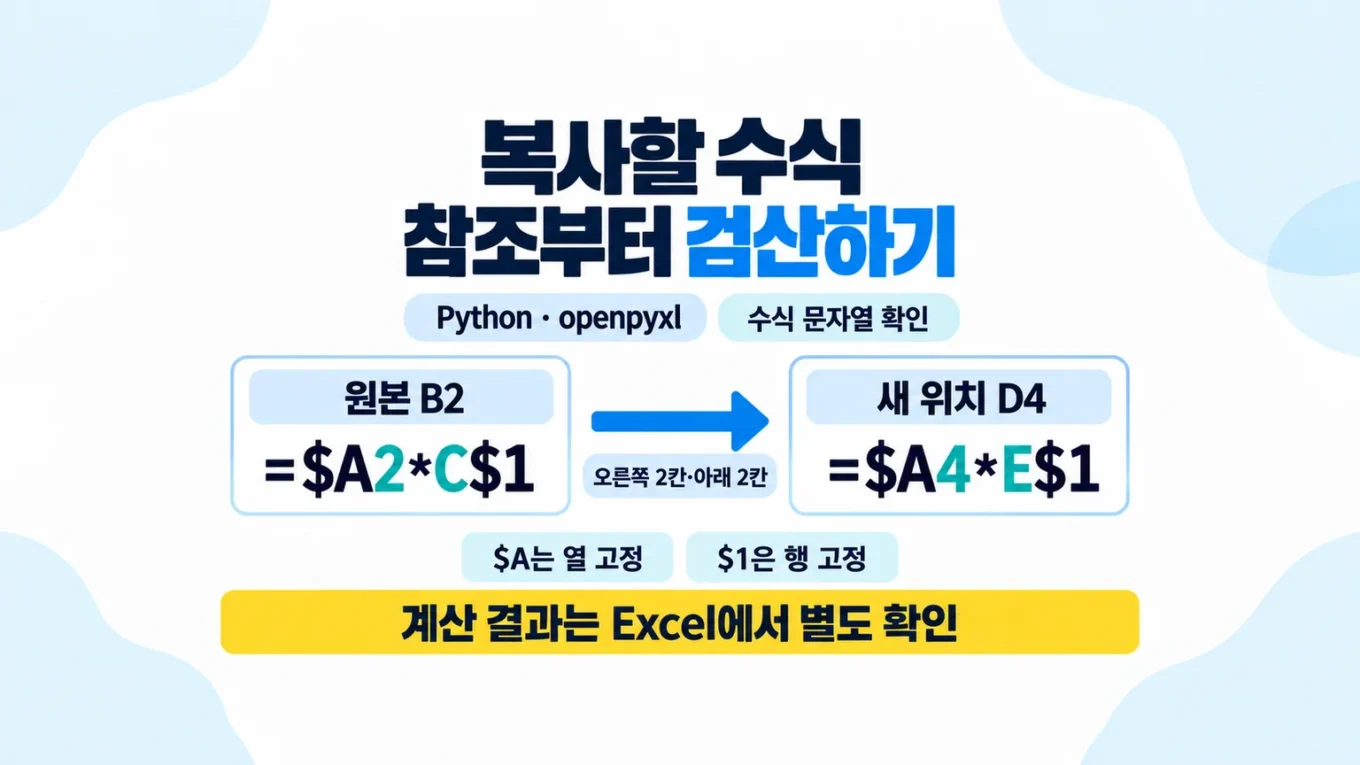
복사할 수식의 상대 참조와 고정 참조를 새 위치에서 검산하기
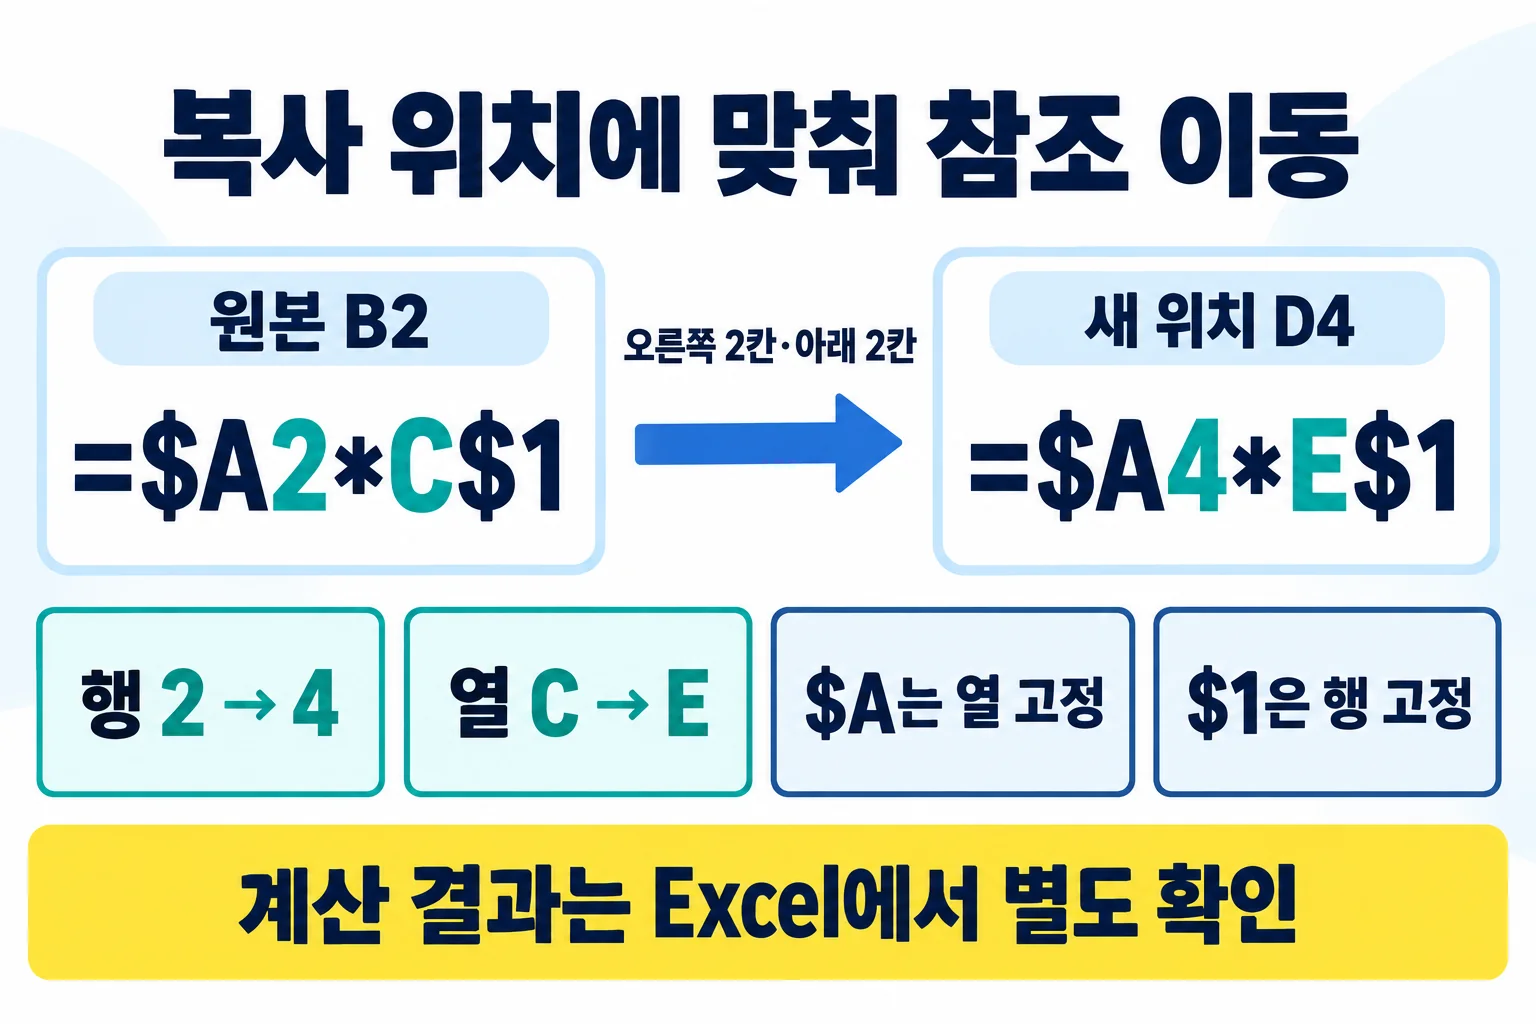
B2의 =$A2*C$1을 D4로 복사하려면 =$A4*E$1이 되어야 합니다. $A는 그대로 두고, 상대 행 2는 4로, 상대 열 C는 E로 바꾸는 이동입니다. Python의 openpyxl Translator로 이 문자열을 만든 뒤, 사람이 먼저 적어 둔 기대 수식과 대조해 보겠습니다.
이 실습의 완료 기준은 참조 문자열의 일치입니다. 원본 XLSX는 읽기 전용으로 열고, 복사 예정 위치의 수식을 CSV 보고서에 기록합니다. D4에 수식을 쓰거나 원본 통합 문서를 저장하지 않습니다. openpyxl은 수식을 계산하지 않으므로, 실제 Excel에서의 계산값과 화면 동작은 이 글의 검증 대상에 포함하지 않았습니다.
먼저 오른쪽 2칸·아래 2칸을 적용해 보세요
B2에서 D4까지는 열과 행이 각각 2씩 증가합니다. 수식 안의 각 참조에 이 이동량을 적용하되, $가 붙은 부분은 고정합니다. Microsoft의 상대·절대·혼합 참조 설명에서도 열과 행을 각각 고정하는 방식으로 정리합니다.
- $A2: A열을 고정하고 상대 행만 2 → 4로 변경하므로 $A4
- C$1: 1행을 고정하고 상대 열만 C → E로 변경하므로 E$1
- 결과: =$A4*E$1
아래의 짧은 예제는 핵심 동작만 보여 줍니다. 입력 주소·지원 문법·Excel 상한·파일 충돌 검사는 뒤의 전체 스크립트에 들어 있습니다.
from openpyxl.formula.translate import Translator

formula = "=$A2*C$1"
print(Translator(formula, origin="B2").translate_formula("B3"))
print(Translator(formula, origin="B2").translate_formula("D4"))
실제 실행한 문자열 출력은 다음과 같습니다.
=$A3*C$1
=$A4*E$1
origin은 수식이 들어 있는 기준 셀입니다. 같은 =$A2*C$1이라도 origin을 A1로 잘못 지정하면 D4까지의 이동량이 달라져 =$A5*F$1이 나옵니다. 문법상 변환이 끝났다는 사실만으로 의도한 참조가 맞다고 볼 수 없습니다.
지원 범위를 먼저 확인하세요
openpyxl 공식 변환 문서는 A1 참조만 지원하며 이름 정의를 지원하지 않는다고 설명합니다. 이 글의 스크립트는 실습을 재현하기 쉽게 그보다 좁은 문법만 허용합니다.
- 같은 시트의 A1 참조 두 개를 +, -, *, / 중 하나로 연결한 수식. 예: =$A2*C$1
- 같은 시트의 왼쪽 위 → 오른쪽 아래 사각 범위 한 개를 사용하는 SUM. 입력과 변환 결과 모두, 시작 셀의 행·열이 끝 셀의 행·열보다 크지 않아야 합니다. 예: =SUM(A2:C2)
- 주소와 함수 이름은 대문자, 공백 없이 입력. 기준·대상 주소는 B2처럼 $ 없는 단일 셀 주소
이름 정의, 테이블 구조 참조, 다른 시트 참조, 외부 링크, R1C1, 배열·동적 배열, A1#, 다른 함수, 상수와 참조의 조합, 괄호가 중첩된 식은 자동 변환을 보류합니다. 이런 식이 Excel에서 유효할 수 있어도 이 예제의 지원 범위를 넓혀 통과시키지 않습니다. 코드의 허용 목록은 openpyxl 전체 기능을 설명하는 목록이 아닙니다.
이 스크립트에는 작은 실습용 상한도 있습니다. CSV 64 KiB·100사례, XLSX 1 MiB·ZIP 내부 100항목·해제 크기 합계 5 MiB까지입니다. VBA 또는 externalLinks 항목이 있는 패키지는 거절합니다. OOXML 내부 적합성을 전부 검사하거나 알 수 없는 파일을 안전하게 분석하는 보안 도구로 쓰지 말고, 제공된 가상 파일이나 직접 만든 작은 연습 사본에서 실행하세요.
실습 파일과 준비 환경
ZIP에는 formula_check.py 전체 코드, test_formula_check.py 자동 시험, requirements.txt, 가상 입력 XLSX, 정상·실패 CSV, 사람이 정한 기대 수식, 실제 보고서, 실행 로그, 버전 기록, SHA-256 목록이 들어 있습니다. 매크로·실제 업무 정보·외부 연결은 없습니다.
ZIP SHA-256: 606066d076ff0ac6790eeca5df9ba109fd0b7e22d99efa18fd99932e7484af54
검수 환경은 Linux의 Python 3.12.14와 openpyxl 3.1.5입니다. 아래 Windows 명령은 PowerShell에서, macOS/Linux 명령은 터미널에서 사용하는 준비 경로입니다. Windows·macOS의 실제 앱이나 경로 동작까지 실행 검증한 것으로 보지 않습니다.
ZIP을 새 연습 폴더에 풀고 formula_check.py가 있는 폴더에서 실행합니다. Windows PowerShell의 준비 명령은 다음과 같습니다.
python -m venv .venv
.\.venv\Scripts\python.exe -m pip install -r requirements.txt
.\.venv\Scripts\python.exe formula_check.py fixtures/formula_source.xlsx fixtures/cases_ok.csv result-ok.csv
$LASTEXITCODE
macOS/Linux에서는 다음과 같습니다.
python3 -m venv .venv
./.venv/bin/python -m pip install -r requirements.txt
./.venv/bin/python formula_check.py fixtures/formula_source.xlsx fixtures/cases_ok.csv result-ok.csv
echo $?
python 명령을 찾을 수 없다면 설치된 Python 3.12 실행 경로부터 확인하세요. openpyxl을 찾지 못한다면 위 설치와 실행이 같은 가상 환경의 Python을 사용했는지 확인합니다. 관리 권한으로 실행할 필요는 없습니다.
fixtures/formula_source.xlsx에는 Practice 시트 하나가 있습니다. B2와 D4에는 혼합 참조 수식, B6:B9에는 다른 참조형식과 SUM, B12:B15에는 경계·지원 밖 반례가 있습니다. 숫자 입력은 모두 가상 데이터입니다. 파일에 제작 도구가 저장한 계산 캐시가 있을 수 있지만, 그 숫자를 실제 Excel 계산 검산의 근거로 사용하지 않습니다.
정상 8사례의 기대 수식을 먼저 적어 두세요
cases_ok.csv의 expected 열은 Translator가 만든 결과를 복사한 값이 아니라, 이동량과 $의 의미로 먼저 정한 기대 수식입니다. 기준 셀이 달라도 같은 이동량을 쓰는 사례를 넣었습니다. B6 → D8과 B2 → D4는 모두 오른쪽 2칸·아래 2칸입니다.
| 사례 | 기준 → 대상 | 원본 수식 | 기대 수식 |
|---|---|---|---|
mixed_down | B2 → B3 | =$A2*C$1 | =$A3*C$1 |
mixed_diagonal | B2 → D4 | =$A2*C$1 | =$A4*E$1 |
relative | B6 → D8 | =A2*C1 | =C4*E3 |
absolute | B7 → D9 | =$A$2*$C$1 | =$A$2*$C$1 |
other_mixed | B8 → D10 | =A$2*$C1 | =C$2*$C3 |
same_position | B2 → B2 | =$A2*C$1 | =$A2*C$1 |
sum_range | B9 → D11 | =SUM(A2:C2) | =SUM(C4:E4) |
reverse | D4 → B2 | =$A4*E$1 | =$A2*C$1 |
정상 실행 후 터미널에는 다음 문구가 표시되고 종료 코드는 0입니다.
MATCH=8 MISMATCH=0; formula strings only
Excel calculation/UI: NOT CHECKED
result-ok.csv의 8행이 모두 MATCH인지, mixed_diagonal 행의 translated가 =$A4*E$1인지 확인합니다. 보고서를 수식 대신 텍스트로 다루기 위한 표시 방식으로 수식 문자열 앞에 작은따옴표 '를 붙였습니다. Excel에서 CSV를 열거나 가져올 때의 실제 표시·동작은 실행 검증하지 않았습니다. 텍스트 편집기로 보면 '=$A4*E$1로 보이는 것이 정상이며 내부 비교는 작은따옴표 없는 원래 문자열로 합니다.
expected/translation_results.csv는 제작 시 실제 실행한 보고서입니다. 입력 cases_ok.csv와 결과 보고서는 용도가 다릅니다. 보고서를 입력 계획으로 다시 사용하지 마세요. 헤더도 다르게 정해져 있습니다.
틀린 기대값과 잘못된 입력을 구별해 보세요
터미널에서 사용하는 Python을 위 가상 환경 실행 경로로 바꿔 아래 명령을 실행할 수 있습니다. 네 명령은 제작 때 격리된 새 폴더에서 그대로 실행해 확인했습니다.
python formula_check.py fixtures/formula_source.xlsx fixtures/cases_ok.csv result-ok.csv
python formula_check.py fixtures/formula_source.xlsx fixtures/cases_wrong_expected.csv result-wrong.csv
python formula_check.py fixtures/formula_source.xlsx fixtures/cases_out_of_range.csv result-invalid.csv
python formula_check.py fixtures/formula_source.xlsx fixtures/cases_ok.csv result-ok.csv- 정상 계획: 종료 0, result-ok.csv 생성, MATCH 8개
- 틀린 기대값: 종료 1, result-wrong.csv 생성, MISMATCH 1개. 기대값 =$A4*C$1과 실제 변환 =$A4*E$1을 나란히 확인
- 범위 초과: 종료 2, result-invalid.csv를 만들지 않음. B12의 =A1*B1을 A11로 옮기면 참조가 A열 왼쪽·1행 위로 벗어남
- 같은 출력 이름 재실행: 종료 3, 기존 result-ok.csv 보존. 새 이름을 골라 다시 실행
종료 1은 비교 가능한 수식의 불일치입니다. 기대값을 실제 출력에 맞춰 무조건 고치지 말고, 먼저 기준 셀과 복사 위치, $ 위치를 다시 읽으세요. 종료 2는 이 실습에서 비교할 수 없는 입력입니다. 범위를 벗어난 주소를 적절한 주소로 수정하거나 지원 밖 수식을 별도 수동 검토해야 합니다. 기존 출력 충돌은 종료 3으로 구분합니다.
추가 반례는 cases_bad_address.csv, cases_no_formula.csv, cases_unsupported.csv, cases_upper_column.csv, cases_upper_row.csv에 있습니다. 각각 A0, 수식 없는 기준 셀, 이 예제에서 허용하지 않은 SUM 인수 형태, Excel 열·행 상한 초과를 확인합니다. 출력 이름을 겹치지 않게 정하면 모두 종료 2이며 새 보고서를 만들지 않습니다.
범위 검사와 원본 보존은 별도로 확인합니다
왼쪽·위쪽으로 벗어나는 참조는 TranslatorError로 거절될 수 있습니다. 그러나 검수한 openpyxl 3.1.5에서는 XFD1을 오른쪽으로 옮겼을 때 =XFE1 같은 문자열을 내보내는 반례가 있었습니다. Translator만 호출해서는 오른쪽·아래쪽 상한을 충분히 확인할 수 없었습니다.
그래서 이 예제는 변환 전후의 각 참조를 검사합니다. Microsoft의 Excel 한도에 맞춰 행 1~1,048,576, 열 A~XFD(16,384)를 넘으면 중단합니다. 범위에 도달한 절대 참조 =$XFD$1048576*$A$1은 참조가 움직이지 않아 그대로 비교할 수 있지만, 상대 참조가 경계 밖으로 이동하는 경우는 실패해야 합니다.
XLSX를 열 때는 read_only=True와 data_only=False를 함께 사용합니다. 공식 읽기 옵션에 따르면 data_only는 수식 문자열과 저장된 값 중 무엇을 읽는지 정합니다. 여기서는 문자열을 읽어야 하므로 False입니다. 읽기가 끝나면 읽기 전용 문서의 안내대로 close()를 호출합니다.
스크립트는 원본 XLSX나 계획 CSV를 저장하지 않습니다. 출력은 기존 경로를 덮어쓰지 않는 x 모드로 생성합니다. 끊어진 출력 심볼릭 링크도 충돌로 거절합니다. 입력 검사를 전부 마치기 전에 결과 파일을 만들지 않으며, 처리 중 새로 만든 보고서의 쓰기가 실패하면 해당 불완전 보고서를 정리하려고 시도합니다. 정리에 실패하면 경고를 표시합니다. 전원 중단·다른 프로세스의 경합·운영 폴더의 악의적 변경까지 원자적 저장을 보장하는 예제는 아닙니다.
전체 코드와 자동 시험
다음 전체 코드는 ZIP의 formula_check.py와 같습니다. 한 줄씩 바꿔 붙이는 대신 파일을 그대로 사용하고, 필요한 변경은 새 사본에서 시험하세요.
formula_check.py 전체 코드 펼치기
"""Read-only, narrow A1 formula-string translation exercise; no Excel calculation."""
import argparse
import csv
import io
import os
import re
import sys
import zipfile
from pathlib import Path
from xml.etree.ElementTree import ParseError

from openpyxl import load_workbook
from openpyxl.formula.translate import Translator, TranslatorError
from openpyxl.utils.cell import column_index_from_string

ADDRESS = re.compile(r'([A-Z]{1,3})([1-9][0-9]{0,6})\Z')
REF = r'\$?[A-Z]{1,3}\$?[1-9][0-9]{0,6}'
ARITHMETIC = re.compile(rf'=({REF})([+*/-])({REF})\Z')
SUM_RANGE = re.compile(rf'=SUM\(({REF}):({REF})\)\Z')
HEADER = ['case_id', 'sheet', 'origin', 'target', 'expected']
REPORT_HEADER = HEADER + ['source_formula', 'translated', 'status']


def coordinates(address):
    """Require one uppercase, unanchored A1 address inside the Excel grid."""
    if not isinstance(address, str) or not (m := ADDRESS.fullmatch(address)):
        raise ValueError(f'invalid address: {address!r}')
    col, row = column_index_from_string(m[1]), int(m[2])
    if col > 16384 or row > 1048576:
        raise ValueError(f'address outside Excel grid: {address}')
    return row, col


def formula_references(formula):
    """Accept only ref operator ref or SUM(one ordered rectangular range)."""
    if not isinstance(formula, str) or len(formula) > 128:
        raise ValueError('formula must be a supported string, at most 128 characters')
    if m := ARITHMETIC.fullmatch(formula):
        refs = (m[1], m[3])
    elif m := SUM_RANGE.fullmatch(formula):
        refs = (m[1], m[2])
        a, b = (coordinates(x.replace('$', '')) for x in refs)
        if a[0] > b[0] or a[1] > b[1]:
            raise ValueError('SUM range must be top-left to bottom-right')
    else:
        raise ValueError('unsupported formula: use two A1 references or SUM(one range)')
    for ref in refs:
        coordinates(ref.replace('$', ''))
    return refs


def translate_checked(formula, origin, target):
    coordinates(origin)
    coordinates(target)
    formula_references(formula)
    try:
        translated = Translator(formula, origin=origin).translate_formula(target)
    except TranslatorError as exc:
        raise ValueError('translated reference is below row 1 or left of column A') from exc
    # Translator 3.1.5 may emit XFE1 or row 1048577. Check the upper bound too.
    formula_references(translated)
    return translated


def read_cases(path):
    if path.is_symlink() or not path.is_file() or path.stat().st_size > 65536:
        raise ValueError('plan must be a regular CSV file of at most 64 KiB')
    with path.open(encoding='utf-8-sig', newline='') as f:
        reader = csv.DictReader(f, strict=True)
        if reader.fieldnames != HEADER:
            raise ValueError('CSV header must exactly match: ' + ','.join(HEADER))
        rows = []
        ids = set()
        for row in reader:
            if len(rows) >= 100 or None in row or any(v is None for v in row.values()):
                raise ValueError('invalid CSV width or more than 100 cases')
            cid = row['case_id']
            if not re.fullmatch(r'[a-z0-9_]{1,40}', cid) or cid in ids:
                raise ValueError('case_id must be unique lowercase letters, digits or underscores')
            ids.add(cid)
            if not row['sheet'] or len(row['sheet']) > 31:
                raise ValueError('invalid sheet name')
            coordinates(row['origin'])
            coordinates(row['target'])
            formula_references(row['expected'])
            rows.append(row)
    if not rows:
        raise ValueError('CSV needs at least one case')
    return rows


def inspect_xlsx(path):
    if path.suffix.lower() != '.xlsx' or path.is_symlink() or not path.is_file():
        raise ValueError('source must be a regular .xlsx file')
    if path.stat().st_size > 1048576:
        raise ValueError('this exercise limits the workbook to 1 MiB')
    with zipfile.ZipFile(path) as z:
        items = z.infolist()
        if len(items) > 100 or sum(i.file_size for i in items) > 5242880:
            raise ValueError('workbook package exceeds exercise limits')
        if any('externallinks/' in i.filename.lower() or 'vbaproject' in i.filename.lower() for i in items):
            raise ValueError('external-link or VBA package is outside this exercise')


def check_workbook(source, plan):
    cases = read_cases(plan)
    inspect_xlsx(source)
    wb = load_workbook(source, read_only=True, data_only=False, keep_links=False)
    results = []
    try:
        for row in cases:
            if row['sheet'] not in wb.sheetnames:
                raise ValueError(f"{row['case_id']}: sheet not found")
            cell = wb[row['sheet']][row['origin']]
            if cell.data_type != 'f' or not isinstance(cell.value, str):
                raise ValueError(f"{row['case_id']}: origin cell has no ordinary formula string")
            translated = translate_checked(cell.value, row['origin'], row['target'])
            results.append(dict(row, source_formula=cell.value, translated=translated,
                                status='MATCH' if translated == row['expected'] else 'MISMATCH'))
    finally:
        wb.close()
    return results


def csv_text(results):
    # Literal display when opened in a spreadsheet. Compare unprefixed strings above.
    def literal(value):
        return "'" + value if value.startswith(('=', '+', '-', '@')) else value
    stream = io.StringIO(newline='')
    writer = csv.DictWriter(stream, fieldnames=REPORT_HEADER, lineterminator='\n')
    writer.writeheader()
    for row in results:
        writer.writerow({key: literal(row[key]) for key in REPORT_HEADER})
    return stream.getvalue()


def main(argv=None):
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('source', type=Path)
    parser.add_argument('plan', type=Path)
    parser.add_argument('output', type=Path)
    args = parser.parse_args(argv)
    output = args.output
    # Includes broken symlinks and existing directories; never offer overwrite.
    if os.path.lexists(output):
        print('ERROR: output path already exists; choose a new filename', file=sys.stderr)
        return 3
    created = False
    try:
        results = check_workbook(args.source, args.plan)
        report = csv_text(results)  # Validate every case before creating output.
        with output.open('x', encoding='utf-8-sig', newline='') as f:
            created = True
            f.write(report)
    except FileExistsError:
        print('ERROR: output appeared before write; preserved', file=sys.stderr)
        return 3
    except (ValueError, OSError, zipfile.BadZipFile, KeyError, IndexError, UnicodeError, csv.Error, ParseError) as exc:
        if created:
            # Remove only the newly created incomplete report owned by this run.
            try:
                output.unlink()
            except OSError:
                print('WARNING: incomplete new report could not be removed', file=sys.stderr)
        print(f'ERROR: {exc}', file=sys.stderr)
        return 2
    mismatches = sum(r['status'] == 'MISMATCH' for r in results)
    print(f'MATCH={len(results)-mismatches} MISMATCH={mismatches}; formula strings only')
    print('Excel calculation/UI: NOT CHECKED')
    return 1 if mismatches else 0


if __name__ == '__main__':
    sys.exit(main())
자동 시험은 임시 폴더에 결과를 만들고 입력의 SHA-256과 출력 조건을 확인합니다. formula_check.py 폴더에서 다음 명령을 실행합니다.
python -m unittest discover -vLinux의 Python 3.12.14·openpyxl 3.1.5에서 제공 자동 시험 25개를 실행했습니다. 실패·오류·건너뜀 없이 통과했고 정상 8사례·기대값 불일치·범위 초과·기존 출력 재실행 명령의 실제 종료 코드는 각각 0·1·2·3이었습니다. 입력 XLSX와 계획 CSV의 SHA-256은 실행 전후 같았습니다.
제작 중 독립 검수에서 닫히지 않은 CSV 따옴표, 손상 XML, 잘못된 공유 문자열 번호의 오류 분류를 확인하고 수정했습니다. 수정 후 전체 시험을 다시 실행했습니다. 원본을 저장하거나 기존 보고서를 덮어쓰는 방식으로 통과시키지 않았습니다. 별도로 작성한 독립 감사 787사례도 모두 통과했습니다. 기대값은 Translator의 출력을 정답으로 재사용하지 않고 수작업 예시와 행·열·고정 여부의 별도 계산으로 정했습니다. 독립 감사는 정상 변환뿐 아니라 지원 밖 문법, 잘못된 주소, 상하좌우 경계, 입력·파일 시스템 조건을 포함합니다. 추가 대조 7개에서도 본문 예제와 제공 CSV의 일치 등을 확인했습니다.
위 검수는 수식 문자열·파일 보존·종료 계약에 관한 기록입니다. 실제 Excel 계산과 화면 조작은 실행하지 않았으며, Windows·macOS에서도 별도로 실행 검증하지 않았습니다.
본문의 MATCH는 수식 문자열의 일치입니다. openpyxl의 공식 수식 설명은 수식을 계산하지 않는다고 명시합니다. Excel 계산값·오류 표시·실제 복사 화면을 확인한 기록은 제공하지 않았습니다. 실제 업무에 적용할 때는 별도 연습 사본에서 Excel로 복사한 뒤, 수식 입력줄의 참조와 필요한 셀 값을 직접 확인하세요.
다음에 확인할 내용
이미 깨진 참조에서 누락된 값까지 복구해야 한다면 Excel #REF! 참조 복구 실습을 이어서 볼 수 있습니다. 조회 결과가 다른 제품을 가리킬 때는 INDEX MATCH의 위치·반환값 검산이 도움이 됩니다. 이 글은 그 복구·조회 실습과 달리 복사 전에 이동량과 참조 고정 의도를 확인하는 연습입니다.
실제 조사·문자열 실행 검수: 2026-10-10 KST. 공식 stable 문서는 조사 당시 openpyxl 3.1.3으로 표시됐고 실행 패키지는 3.1.5입니다. 표시 게시일과 실제 조사일을 구분했으며, 과거에 사용하거나 Excel에서 계산을 확인했다는 경험을 덧붙이지 않았습니다.
작성자 소개
