Python으로 선행작업의 임계경로와 여유시간 계산하기
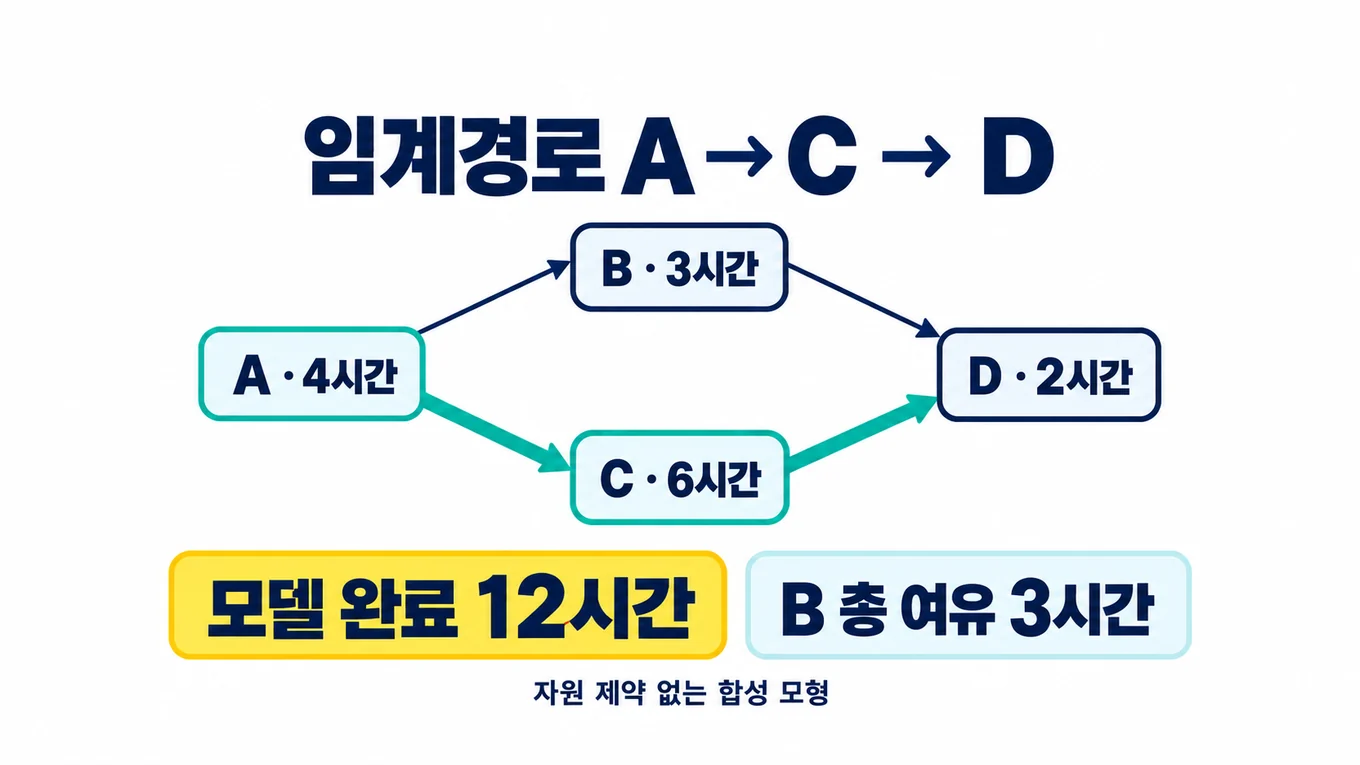
A를 끝낸 뒤 B와 C를 병렬로 시작하고, 두 작업이 모두 끝나야 D를 시작할 수 있다고 가정해 보겠습니다. 소요시간이 A 4시간, B 3시간, C 6시간, D 2시간이면 네 시간을 모두 더한 15시간이 프로젝트 길이는 아닙니다. B와 C가 겹쳐 진행되는 모형에서는 완료 길이 12시간, 임계경로 A → C → D, B의 총여유 3시간을 얻습니다.
이번 실습은 Python으로 JSON의 선행관계를 읽어 작업별 ES·EF·LS·LF·total_float와 임계 연결을 계산합니다. 직접 만든 합성 자료이며 실제 회사의 일정이나 작업 기록을 사용하지 않습니다. 같은 정수 상대시간을 사용하고, 필요한 사람이든 장비든 병렬 작업을 막지 않는다는 가정입니다. 달력 날짜·영업일·실제 일정 등록·캘린더 연동·Office 실행은 포함하지 않습니다.
1. 임계경로를 계산할 조건부터 정합니다
이 예제의 관계는 finish-to-start, 지연시간 lag 0입니다. 선행작업이 끝나야 다음 작업을 시작할 수 있습니다. 동시에 시작하는 관계, 겹쳐 진행하는 관계, 선행작업 종료 후 별도로 기다리는 시간을 입력하는 기능은 없습니다.
시간단위는 JSON의 time_unit을 HOUR로 고정합니다. duration 4는 상대 경과시간 4시간이고, 시각 4시는 아닙니다. 시작점 0에서 계산하므로 결과 12를 실제 날짜의 오후 12시나 근무일 이틀로 바꾸지 않습니다. 작업마다 시간단위가 다른 자료를 섞거나 담당자 한 명이 B와 C를 동시에 할 수 있는지 확인하지 않습니다.
Microsoft의 임계경로 설명은 프로젝트 끝에 영향을 주는 선행작업 연쇄와 총여유를 설명합니다. 아래 실습은 그 개념을 작은 정수 모형으로 계산합니다. Microsoft Project의 달력·자원·추가 제약을 구현하거나 해당 앱의 실제 실행 결과를 재현한 코드는 아닙니다.
| 작업 ID | 소요시간 | 먼저 끝나야 하는 작업 |
|---|---|---|
| A | 4 | 없음 |
| B | 3 | A |
| C | 6 | A |
| D | 2 | B, C |
A 종료는 4, B 종료는 7, C 종료는 10입니다. D는 두 선행작업을 모두 기다리므로 10에서 시작해 12에 끝납니다. D의 시작을 계산할 때 B의 종료 7과 C의 종료 10을 더하지 않고 큰 값을 선택합니다.
2. 합성 JSON과 실습 ZIP을 준비합니다
ZIP을 새 폴더에 풀면 전체 실행 파일 cpm_schedule.py, 정상 예제 검증기, 자동 시험, 한글 README, 입력 14개와 고정 기대값이 있습니다. 기본 input/tasks.json의 전체 내용은 다음과 같습니다.
{
  "time_unit": "HOUR",
  "tasks": [
    {
      "id": "A",
      "duration": 4,
      "pred": []
    },
    {
      "id": "B",
      "duration": 3,
      "pred": [
        "A"
      ]
    },
    {
      "id": "C",
      "duration": 6,
      "pred": [
        "A"
      ]
    },
    {
      "id": "D",
      "duration": 2,
      "pred": [
        "B",
        "C"
      ]
    }
  ]
}pred는 바로 앞 선행작업의 ID 목록입니다. D 앞에 A까지 반복해서 적을 필요는 없습니다. A → B → D 또는 A → C → D를 통해 A의 선행조건이 이미 연결됩니다. 작업의 행 순서를 바꿔도 ID로 연결하므로 시간 계산과 CSV 값은 같습니다. summary의 입력 SHA-256은 실제 읽은 바이트가 바뀌면 달라집니다. 출력 행과 연결은 ID의 사전순으로 고정하며, 이 순서는 실제 작업 우선순위를 뜻하지 않습니다.
코드는 다음 입력 계약을 검사합니다. 잘못된 관계를 자동으로 삭제하거나 소요시간을 추측해서 채우지 않습니다.
- 루트 키는 정확히
time_unit,tasks이고, 작업 키는 정확히id,duration,pred입니다. - 작업은 1~1,000개, 전체 선행관계는 최대 10,000개입니다. 헤더만 있는 빈 프로젝트는 받지 않습니다.
- duration은 0~1,000,000의 JSON 정수입니다.
true,false, 음수,4.0,"4"는 거부합니다. 0시간 작업은 유효한 이정표로 계산합니다. - ID는 첫 글자가 대문자 A~Z 또는 숫자 0~9이고, 이후 대문자·숫자·밑줄·하이픈을 사용하며 총 1~40자입니다. 소문자·한글·공백은 이 실습의 식별자로 받지 않습니다.
- 작업 ID와 한 작업의 선행 ID가 중복되면 오류입니다. 없는 선행 ID, 자기 자신을 선행으로 지정한 관계, 순환도 거부합니다.
- 파일은 UTF-8이며 BOM을 허용합니다. 실제 읽은 바이트는 최대 1MiB, JSON 중첩은 최대 16단계입니다. 중복 JSON 키와 NaN·Infinity, 모든 실수 표기와 12자리 초과 정수도 거부합니다.
duration은 소요시간의 관측값을 자동 생성하는 항목이 아닙니다. 자신의 업무로 바꿀 때는 그 값을 어떤 근거로 정했는지 확인해야 합니다. 마감이 없는 요청에 날짜를 임의로 붙이는 문제는 마감일 확인 질문과 후속 일정 정리에서 따로 다룹니다.
3. 새 결과 폴더 이름으로 실행합니다
Python 3.12의 표준 라이브러리만 사용하므로 별도 pip 패키지 설치가 없습니다. Python이 없다면 Python 공식 다운로드의 설치 안내를 확인하세요. 실제 제작 검증 환경은 Linux의 CPython 3.12.14입니다. Windows·macOS 및 다른 패치 버전의 실제 실행은 확인하지 않았습니다.
실제 조사·검증은 2026-10-13에 CPython 3.12.14/Linux 환경에서 진행했습니다. 표시된 발행일은 별도로 배분한 날짜입니다.
압축을 푼 E14P_CPM 폴더에서 터미널을 열고 실행합니다.
python --version
python cpm_schedule.py --input input/tasks.json --out result_01
python verify_example.py result_01
환경에 따라 python3 또는 Windows 실행기 py -3.12를 사용할 수 있습니다. 모든 명령에서 첫 단어를 같은 실행기로 바꾸세요. 입력을 찾을 수 없다면 먼저 현재 폴더가 cpm_schedule.py가 있는 실습 폴더인지 확인합니다.
result_01은 아직 존재하지 않아야 합니다. 직접 만들어 두지 마세요. 프로그램이 입력 검증과 계산을 끝낸 뒤 새 폴더를 만듭니다. 기존 결과가 있으면 result_02처럼 다른 이름을 지정합니다. 결과 폴더의 부모 폴더는 이미 있어야 합니다.
정상 계산의 종료코드는 0이고 다음 한 줄을 출력합니다.
{"critical_links": 2, "finish": 12, "tasks": 4, "time_unit": "HOUR"}정상 예제 검증기는 고정 CSV, finish와 임계 시작·종료, 입력·출력 SHA-256을 대조합니다. 통과하면 다음 문장이 나옵니다.
PASS: finish=12 HOUR; A-C-D critical; B float=3; fixed CSVs and hashesverify_example.py는 수정하지 않은 input/tasks.json 전용입니다. B의 소요시간이나 선행관계를 바꾸었다면 원래 고정 기대값과 달라질 수 있으므로 새 입력의 기대 결과를 별도로 검산해야 합니다.
4. ES·EF·LS·LF와 총여유를 읽습니다
앞으로 계산할 때는 작업을 선행조건이 풀리는 순서로 처리합니다. ES는 가장 이른 시작, EF는 가장 이른 종료입니다. 선행작업이 없다면 ES는 0이고, 있다면 선행 EF 중 가장 큰 값입니다.
뒤로 계산할 때는 프로젝트 완료 길이에서 거꾸로 내려옵니다. LS는 공통 완료 길이를 늘리지 않는 가장 늦은 시작, LF는 그 가장 늦은 종료입니다. 후행작업이 없다면 LF는 전체 finish이고, 있다면 후행 LS 중 가장 작은 값입니다.
ES = max(선행작업 EF), 선행작업이 없으면 0
EF = ES + duration
finish = max(전체 작업 EF)
LF = min(후행작업 LS), 후행작업이 없으면 finish
LS = LF - duration
total_float = LS - ES = LF - EFtask_times.csv의 값은 다음과 같습니다. 모든 시간 열은 상대시간 HOUR입니다.
| id | duration | ES | EF | LS | LF | total_float | critical |
|---|---|---|---|---|---|---|---|
| A | 4 | 0 | 4 | 0 | 4 | 0 | 1 |
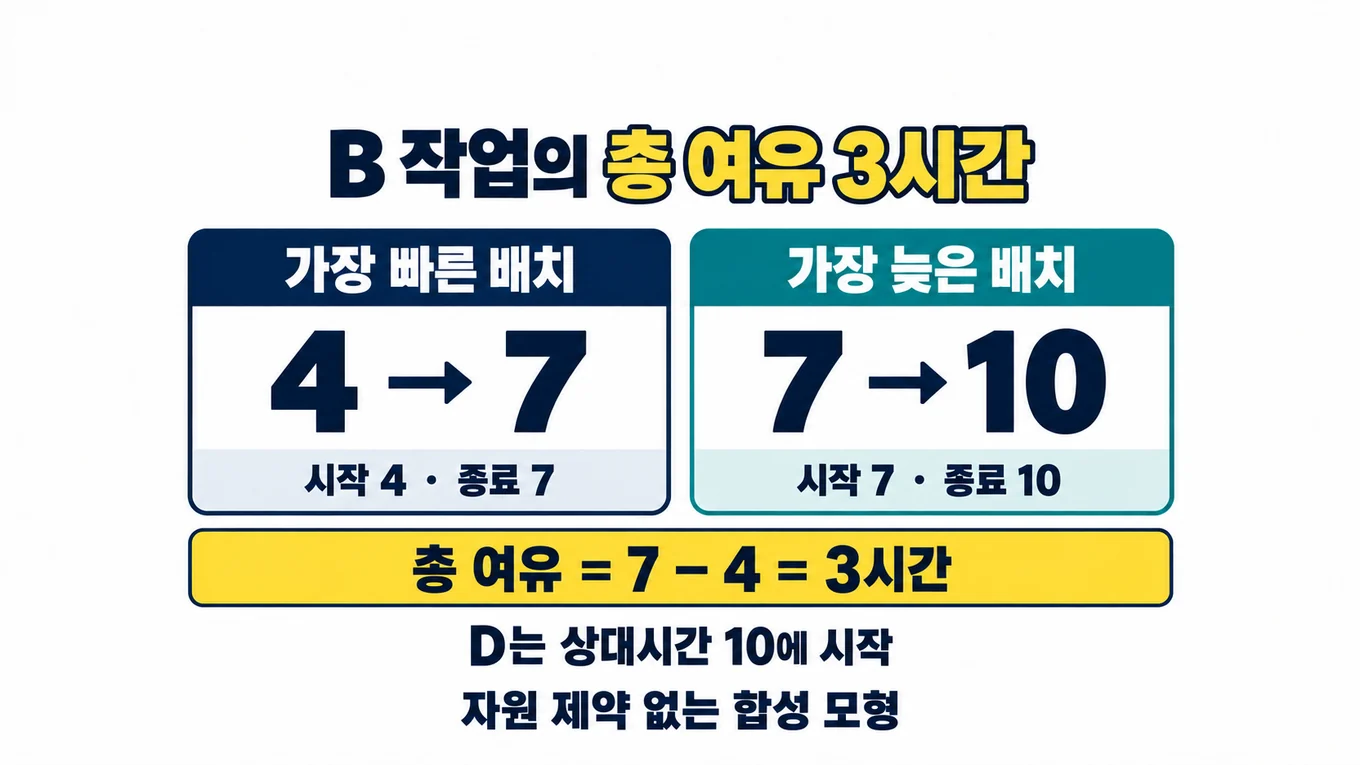
| B | 3 | 4 | 7 | 7 | 10 | 3 | 0 |
| C | 6 | 4 | 10 | 4 | 10 | 0 | 1 |
| D | 2 | 10 | 12 | 10 | 12 | 0 | 1 |
B는 일찍 시작하면 4~7, 공통 완료 12를 유지하면서 가장 늦게 배치하면 7~10입니다. 그 시작 차이 3이 총여유입니다. 이 숫자를 자동으로 휴가·업무 배정 시간으로 확정하지 않습니다. 실제 자원 충돌이나 업무 제약이 있으면 따로 판단해야 합니다.
총여유가 0인 작업은 critical=1입니다. 이어지는 두 작업이 모두 임계라는 이유만으로 모든 연결을 임계로 표시하지는 않습니다. 실제 선행관계가 있고 앞 EF와 뒤 ES가 같아야 해당 연결을 임계 연결로 남깁니다.
from_id,to_id
A,C
C,D
이 critical_links.csv가 기본 예제의 A → C → D를 나타냅니다. 길이는 4+6+2=12입니다. A → B → D는 4+3+2=9이므로 긴 갈래에 맞춰 기다릴 수 있는 3이 생깁니다.
결과 폴더에는 CSV 두 개와 summary.json이 있습니다. summary에는 finish=12, task_count=4, edge_count=4, 임계 연결 수 2, 임계 시작 A·종료 D, 계산 정책, 실제 Python 버전, 입력 해시와 두 CSV의 해시를 남깁니다. complete가 true인지 확인한 뒤 CSV 해시까지 대조하세요. summary는 마지막에 씁니다.
5. 동률·0시간·단절·복수 종료를 직접 시험합니다
동률이면 임계경로가 둘 이상입니다
input/tasks_tie_zero.json은 B의 duration을 6으로 바꾸고 D 뒤에 Z 0시간을 붙인 예제입니다.
python cpm_schedule.py --input input/tasks_tie_zero.json --out result_tiefinish는 그대로 12이고 A·B·C·D·Z의 총여유는 모두 0입니다. 임계 연결은 A → B, A → C, B → D, C → D, D → Z의 다섯 개입니다. A → B → D → Z와 A → C → D → Z가 함께 최장 갈래입니다. Z의 ES·EF·LS·LF는 모두 12입니다. 소요시간 0인 이정표도 선행관계의 끝에 놓일 수 있습니다.
코드는 임계 연결과 임계 시작·종료를 저장하며 모든 임계경로 목록을 열거하지 않습니다. 동률 갈래가 연달아 합쳐지고 나뉘면 경로 개수가 매우 커질 수 있기 때문입니다. critical_link_count는 연결 수이며 경로 개수가 아닙니다.
단절된 짧은 갈래는 공통 완료 기준의 여유를 얻습니다
input/tasks_disconnected.json에는 A 4시간 → B 3시간과 독립 X 2시간이 있습니다. 종료작업은 B와 X 두 개입니다.
python cpm_schedule.py --input input/tasks_disconnected.json --out result_disconnectedfinish는 7입니다. B의 ES·EF·LS·LF는 4/7/4/7이고, X는 0/2/5/7입니다. 두 종료의 LF를 공통 finish 7로 두므로 X의 총여유는 5입니다. 임계 연결은 A → B만 남습니다.
단절 자체는 오류가 아닙니다. 이 모형에서는 여러 독립 갈래가 같은 프로젝트 완료를 공유한다고 정했습니다. X가 아예 다른 프로젝트라면 공통 finish로 얻은 여유를 가져다 쓰지 말고 입력 파일을 분리하세요. 관계가 실수로 빠져 단절됐는지는 코드를 돌린 것만으로 알 수 없습니다.
모든 소요시간이 0이어도 계산이 가능합니다
input/tasks_all_zero.json은 A 0시간 → Z 0시간입니다.
python cpm_schedule.py --input input/tasks_all_zero.json --out result_zerofinish는 0이고 두 작업의 시간 열과 총여유도 모두 0입니다. A → Z는 임계 연결 1개입니다. 이는 합성 이정표 모형의 결과이며 실제 업무가 시간이 들지 않고 끝난다는 증거가 아닙니다.
6. 오류가 나면 원본을 보존하고 원인을 고칩니다
아래 순환 예제는 A의 선행에 D를 넣어 A → B/C → D → A로 되돌아오게 만든 자료입니다.
python cpm_schedule.py --input input/tasks_bad_cycle.json --out result_cycle종료코드는 2이고 ERROR: cycle detected; check predecessor links가 표시됩니다. 입력 검증·계산 중 멈추므로 result_cycle 폴더는 생성되지 않습니다. 순환이 있다는 사실을 확인하며, 그래프의 모든 순환 경로를 찾아 출력하는 기능은 없습니다.
| 문제 | 확인할 내용 | 원본을 보존한 다음 행동 |
|---|---|---|
| 중복 작업 ID | 다른 작업을 같은 ID로 적었는지 | 사본에서 올바른 ID와 그 선행 참조를 함께 정정 |
| 중복 선행 ID | pred에 A가 두 번 들어갔는지 |
의미를 확인하고 사본의 중복 참조를 제거 |
| 없는 선행 ID | 오타인지 작업 행이 누락됐는지 | 확인된 작업·관계를 새 입력 사본에 반영 |
| 순환·자기참조 | 선행 방향이 업무의 실제 의존성과 같은지 | 화살표를 검토하고 확인된 관계만 수정 |
| Boolean·음수·실수 duration | JSON 값과 시간단위가 맞는지 | 확인된 비음수 정수 시간으로 사본을 수정 |
| JSON 키 중복·NaN·깊이 초과 | 내보내기 형식이 계약과 맞는지 | 원본을 둔 채 허용 형식으로 다시 내보내기 |
| 바이트·작업·관계 상한 초과 | 한 프로젝트의 범위가 과도한지 | 연결을 임의로 잘라 계산하지 말고 모형 범위를 검토 |
| 기존 결과 폴더 | 예전 결과를 덮어쓰려는 이름인지 | 새 결과 폴더 이름을 지정 |
| 쓰기 권한·디스크 오류 | 부모 폴더 위치와 저장 공간 | 부분 결과를 사용하지 말고 저장 가능한 위치의 새 이름으로 재실행 |
파일 제한을 맞추려고 의존관계를 지우면 완료 길이가 달라집니다. 같은 프로젝트를 서로 연결된 부분으로 나눠 따로 돌리면 한 프로젝트의 올바른 CPM 결과를 얻는다고 볼 수 없습니다. 먼저 범위와 도구를 검토하세요.
입력은 읽기만 하고 기존 결과는 덮어쓰지 않습니다. 결과 쓰기 중 오류가 나면 이번 실행이 만든 파일만 정리하려고 시도합니다. 권한이나 잠금 때문에 정리가 실패하면 부분 폴더가 남을 수 있습니다. summary가 없거나 해시가 맞지 않으면 결과로 사용하지 말고 원본을 유지한 채 새 이름에서 다시 실행하세요. 같은 결과 폴더에 여러 프로세스가 동시에 쓰거나 다른 프로그램이 파일을 바꾸는 사용은 실습 범위 밖입니다.
7. CSV 텍스트와 해시의 한계를 확인합니다
CSV에는 외부 입력의 자유 텍스트를 그대로 전달하지 않습니다. ID는 엄격한 ASCII 식별자 규칙으로 제한하고, 나머지 셀은 프로그램이 만든 비음수 정수입니다. =1+1, +CMD, -CMD, @SUM처럼 시작하는 ID와 공백·탭·개행이 있는 ID는 거부합니다. CSV는 UTF-8 BOM과 LF 줄바꿈으로 저장합니다.
이 정책은 이번 코드가 내보내는 셀의 범위를 제한합니다. CSV 따옴표를 수식 차단 장치라고 설명하거나 모든 스프레드시트 앱에서 같은 해석을 보장하지 않습니다. 실제 Excel/Office의 수식 실행 여부를 시험하지 않았습니다. 결과 CSV를 수정하거나 외부 설명 열을 추가했다면 텍스트 안전정책을 다시 검토하세요.
SHA-256은 실제 읽은 입력 바이트와 만든 CSV 바이트의 일치를 대조하는 자료입니다. ZIP의 SHA256_MANIFEST.json도 배포 내부 파일의 바이트 확인용입니다. 파일과 manifest를 함께 바꾸는 사람을 인증하거나 입력의 업무상 정확성을 보증하지 않습니다. 디지털 서명이나 공급자 인증으로 취급하지 마세요.
파일 1MiB·작업 1,000개·관계 10,000개·정수 상한으로 처리 범위를 제한합니다. 입력과 그래프를 메모리에 보관하며 스트리밍 처리는 하지 않습니다. 고정 RAM 상한을 보장하는 프로그램도 아닙니다. 실행 코드에서 전체 경로를 열거하지 않아 동률 경로의 지수적 증가를 피합니다.
8. 전체 실행 코드를 확인합니다
다음은 ZIP의 cpm_schedule.py와 같은 전체 코드입니다. 이 파일 하나로 입력 검증, 시간 계산, CSV·summary 저장을 실행할 수 있습니다. 검증기·자동 시험·고정 기대값은 ZIP에 별도로 들어 있습니다.
#!/usr/bin/env python3
"""Bounded synthetic CPM: finish-to-start, zero lag, unlimited resources."""
import argparse
import csv
import hashlib
import heapq
import io
import json
from pathlib import Path
import re
import sys

MAX_BYTES = 1_048_576
MAX_TASKS = 1_000
MAX_EDGES = 10_000
MAX_DURATION = 1_000_000
MAX_DEPTH = 16
ID_PATTERN = re.compile(r"[A-Z0-9][A-Z0-9_-]{0,39}\Z")
TASK_HEADER = ["id", "duration", "ES", "EF", "LS", "LF", "total_float", "critical"]
LINK_HEADER = ["from_id", "to_id"]


class InputError(ValueError):
    """An input or output contract was not met."""


def safe_id(value):
    return type(value) is str and ID_PATTERN.fullmatch(value) is not None


def validate(data):
    if type(data) is not dict or set(data) != {"time_unit", "tasks"}:
        raise InputError("root keys must be exactly time_unit and tasks")
    if data["time_unit"] != "HOUR":
        raise InputError('time_unit must be "HOUR" (relative integer hours)')
    rows = data["tasks"]
    if type(rows) is not list or not 1 <= len(rows) <= MAX_TASKS:
        raise InputError(f"tasks must contain 1..{MAX_TASKS} rows")
    tasks, edges = {}, 0
    for row in rows:
        if type(row) is not dict or set(row) != {"id", "duration", "pred"}:
            raise InputError("each task needs exactly id, duration, pred")
        ident, duration, pred = row["id"], row["duration"], row["pred"]
        if not safe_id(ident):
            raise InputError("id must match [A-Z0-9][A-Z0-9_-]{0,39}")
        if ident in tasks:
            raise InputError(f"duplicate task id: {ident}")
        if type(duration) is not int or not 0 <= duration <= MAX_DURATION:
            raise InputError(f"{ident}: duration must be integer 0..{MAX_DURATION}; no Boolean")
        if type(pred) is not list or any(not safe_id(p) for p in pred):
            raise InputError(f"{ident}: pred must be a list of safe task ids")
        if len(set(pred)) != len(pred):
            raise InputError(f"{ident}: duplicate predecessor")
        if ident in pred:
            raise InputError(f"{ident}: self predecessor")
        edges += len(pred)
        if edges > MAX_EDGES:
            raise InputError(f"too many predecessor links; maximum {MAX_EDGES}")
        tasks[ident] = {"duration": duration, "pred": sorted(pred)}
    for ident, row in tasks.items():
        for p in row["pred"]:
            if p not in tasks:
                raise InputError(f"{ident}: unknown predecessor {p}")
    return tasks


def check_depth(text):
    depth, in_string, escaped = 0, False, False
    for char in text:
        if in_string:
            if escaped:
                escaped = False
            elif char == "\\":
                escaped = True
            elif char == '"':
                in_string = False
        elif char == '"':
            in_string = True
        elif char in "[{":
            depth += 1
            if depth > MAX_DEPTH:
                raise InputError(f"JSON nesting exceeds {MAX_DEPTH}")
        elif char in "]}":
            depth -= 1
    # Malformed bracket balance is checked by the JSON parser.


def unique_object(pairs):
    obj = {}
    for key, value in pairs:
        if key in obj:
            raise InputError("duplicate JSON object key")
        obj[key] = value
    return obj


def reject_number(value):
    raise InputError("JSON floats and non-standard numeric constants are not allowed")


def bounded_integer(value):
    if len(value.lstrip("-")) > 12:
        raise InputError("JSON integer has too many digits")
    return int(value)


def load_input(path):
    with Path(path).open("rb") as handle:
        raw = handle.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise InputError(f"input exceeds {MAX_BYTES} bytes")
    try:
        text = raw.decode("utf-8-sig")
        check_depth(text)
        data = json.loads(text, object_pairs_hook=unique_object,
                          parse_int=bounded_integer, parse_float=reject_number,
                          parse_constant=reject_number)
    except (UnicodeError, json.JSONDecodeError, RecursionError) as exc:
        raise InputError("invalid UTF-8 JSON") from exc
    validate(data)
    return data, hashlib.sha256(raw).hexdigest()


def calculate(data):
    tasks = validate(data)
    ids = sorted(tasks)
    succ = {i: [] for i in ids}
    indegree = {i: len(tasks[i]["pred"]) for i in ids}
    for i in ids:
        for p in tasks[i]["pred"]:
            succ[p].append(i)
    ready = [i for i in ids if indegree[i] == 0]
    heapq.heapify(ready)
    order, es, ef = [], {}, {}
    while ready:
        i = heapq.heappop(ready)
        order.append(i)
        es[i] = max((ef[p] for p in tasks[i]["pred"]), default=0)
        ef[i] = es[i] + tasks[i]["duration"]
        for j in succ[i]:
            indegree[j] -= 1
            if indegree[j] == 0:
                heapq.heappush(ready, j)
    if len(order) != len(ids):
        raise InputError("cycle detected; check predecessor links")
    finish = max(ef.values())
    ls, lf = {}, {}
    for i in reversed(order):
        lf[i] = min((ls[j] for j in succ[i]), default=finish)
        ls[i] = lf[i] - tasks[i]["duration"]
    critical = {i: ls[i] == es[i] for i in ids}
    links = [[i, j] for i in ids for j in succ[i]
             if critical[i] and critical[j] and ef[i] == es[j]]
    rows = [{"id": i, "duration": tasks[i]["duration"],
             "ES": es[i], "EF": ef[i], "LS": ls[i], "LF": lf[i],
             "total_float": ls[i] - es[i], "critical": critical[i]} for i in ids]
    return {"time_unit": "HOUR", "finish": finish, "tasks": rows,
            "critical_links": links,
            "critical_starts": [i for i in ids if not tasks[i]["pred"] and critical[i]],
            "critical_ends": [i for i in ids if not succ[i] and critical[i]]}


def csv_bytes(header, rows):
    stream = io.StringIO(newline="")
    writer = csv.writer(stream, lineterminator="\n")
    writer.writerow(header)
    writer.writerows(rows)
    return stream.getvalue().encode("utf-8-sig")


def run(input_path, output_path):
    data, input_hash = load_input(input_path)
    result = calculate(data)
    out = Path(output_path)
    if out.exists() or out.is_symlink():
        raise InputError("output already exists; choose a new folder name")
    if not out.parent.is_dir():
        raise InputError("output parent must already be a directory")
    payloads = {
        "task_times.csv": csv_bytes(TASK_HEADER, [
            [t[k] if k != "critical" else int(t[k]) for k in TASK_HEADER]
            for t in result["tasks"]]),
        "critical_links.csv": csv_bytes(LINK_HEADER, result["critical_links"]),
    }
    summary = {
        "complete": True, "time_unit": "HOUR", "finish": result["finish"],
        "task_count": len(data["tasks"]),
        "edge_count": sum(len(t["pred"]) for t in data["tasks"]),
        "critical_link_count": len(result["critical_links"]),
        "critical_starts": result["critical_starts"],
        "critical_ends": result["critical_ends"],
        "policy": "finish-to-start; lag=0; start=0; unlimited parallel resources; common finish for all sinks",
        "csv_text_policy": "strict ASCII task IDs; generated nonnegative integer cells only; no free-text passthrough",
        "python_version": sys.version.split()[0],
        "input_sha256": input_hash,
        "output_sha256": {name: hashlib.sha256(raw).hexdigest()
                          for name, raw in payloads.items()},
    }
    payloads["summary.json"] = (json.dumps(summary, ensure_ascii=False,
                                            sort_keys=True, indent=2) + "\n").encode("utf-8")
    out.mkdir()  # No parents and no exist_ok: never overwrite a previous result.
    created = []
    try:
        for name, raw in payloads.items():  # summary is written last.
            target = out / name
            with target.open("xb") as handle:
                created.append(target)
                handle.write(raw)
    except OSError:
        for target in reversed(created):
            try:
                target.unlink()
            except OSError:
                pass
        try:
            out.rmdir()  # Fails safely if any unowned file remains.
        except OSError:
            pass
        raise
    return summary


def main(argv=None):
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--input", required=True, help="synthetic JSON file")
    parser.add_argument("--out", required=True, help="new result directory")
    args = parser.parse_args(argv)
    try:
        summary = run(args.input, args.out)
    except (InputError, OSError) as exc:
        print(f"ERROR: {exc}", file=sys.stderr)
        return 2
    print(json.dumps({"finish": summary["finish"], "tasks": summary["task_count"],
                      "critical_links": summary["critical_link_count"],
                      "time_unit": summary["time_unit"]}, sort_keys=True))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
9. 자동 시험과 고정 기대값을 대조합니다
실습 폴더에서 다음 명령으로 자동 시험을 실행합니다.
python -m unittest -v제작 검증에서 시험 메서드 20개가 통과했습니다. 정상 기대값과 해시, 오류 뒤 재실행, 입력 보존, 순서 독립성, 1,000작업 연쇄, 단절·복수 종료·동률·0시간 및 입력 제한을 확인했습니다. 작은 합성 DAG 150개는 전진·후진 CPM 계산과 다른 전체 경로 열거 오라클에서 완료 길이·작업 시간·임계 연결을 구한 뒤 대조했습니다. 전체 경로 열거는 이 작은 시험에서만 사용합니다.
정상·경계·오류 입력 14개는 실제 명령행으로 실행하고 종료코드와 새 폴더 생성 여부를 대조했습니다. 압축해제본에서도 20시험과 내부 파일 해시를 확인했습니다. 이 검증은 합성 입력과 명시한 정책의 계산에 대한 것입니다. 실업무 소요시간의 정확성, 자원 배치 가능성, MS Project 실행 결과 일치와 최적 납기를 보장하지 않습니다.
주간 계획에 적용할 때는 계산한 선행관계와 실제로 비어 있는 작업 시간을 따로 확인하세요. 결과물·검토·회신 대기를 기록하는 방법은 주간 계획표의 마감과 완료 기준에서 이어서 볼 수 있습니다.
공식 참고 자료
- Microsoft: 프로젝트의 임계경로 관리: 임계경로와 총여유의 개념을 확인할 때 참고합니다.
- Python 3.12 graphlib: 위상정렬과 순환의 개념을 설명합니다. 이 실행 코드는 ID 순서를 고정한 자체 Kahn 처리를 사용하며 graphlib를 호출하지 않습니다.
- Python 3.12 json: JSON 읽기와 decoder hook, 입력 자원 제한 안내를 참고했습니다. 중복 키 거부·바이트 상한·정수시간 입력 계약은 이 실습이 정한 정책입니다.
- Python 3.12 heapq: 준비된 작업에서 ID 사전순을 고르는 최소 힙에 사용합니다.
작성자 소개
