표에 없던 열이 생겼을 때: 삭제 전에 원본과 값 보존하기
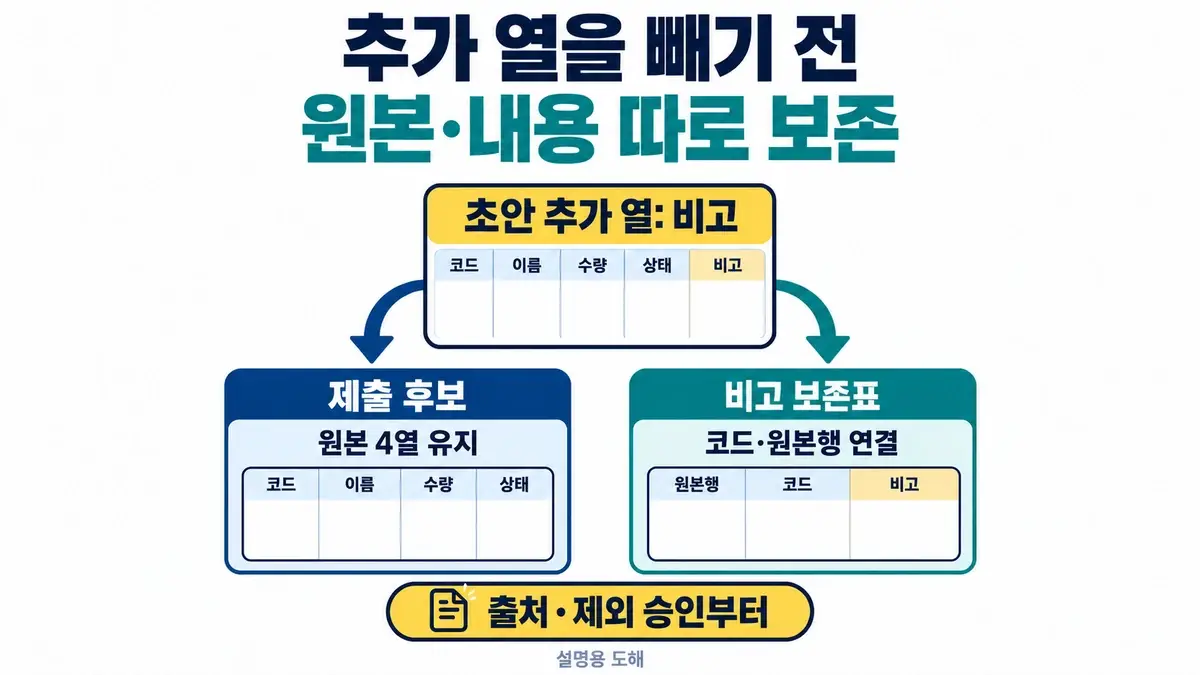
AI가 정리한 표에 “비고” 열이 생겼다고 바로 지우면 중요한 정보를 잃을 수 있습니다. AI가 새로 만든 설명인지, 원본 파일에서 가져온 열인지, 사람이 뒤에 추가한 업무 메모인지부터 확인해야 합니다. 원본을 보존하고 열의 출처를 대조한 뒤, 승인한 배포본에서만 제외하고 추가 내용은 별도로 남기세요.
이번 사례는 고정된 네 열만 받는 업무 시스템에 CSV를 넣기 전의 검수입니다. 열이 고정된 제출 양식과 원본 관리 파일은 용도가 다릅니다. 시스템에 필요 없는 열이라도 원본에서 없애야 한다는 뜻은 아닙니다.
먼저 기준과 비교 대상을 분리합니다
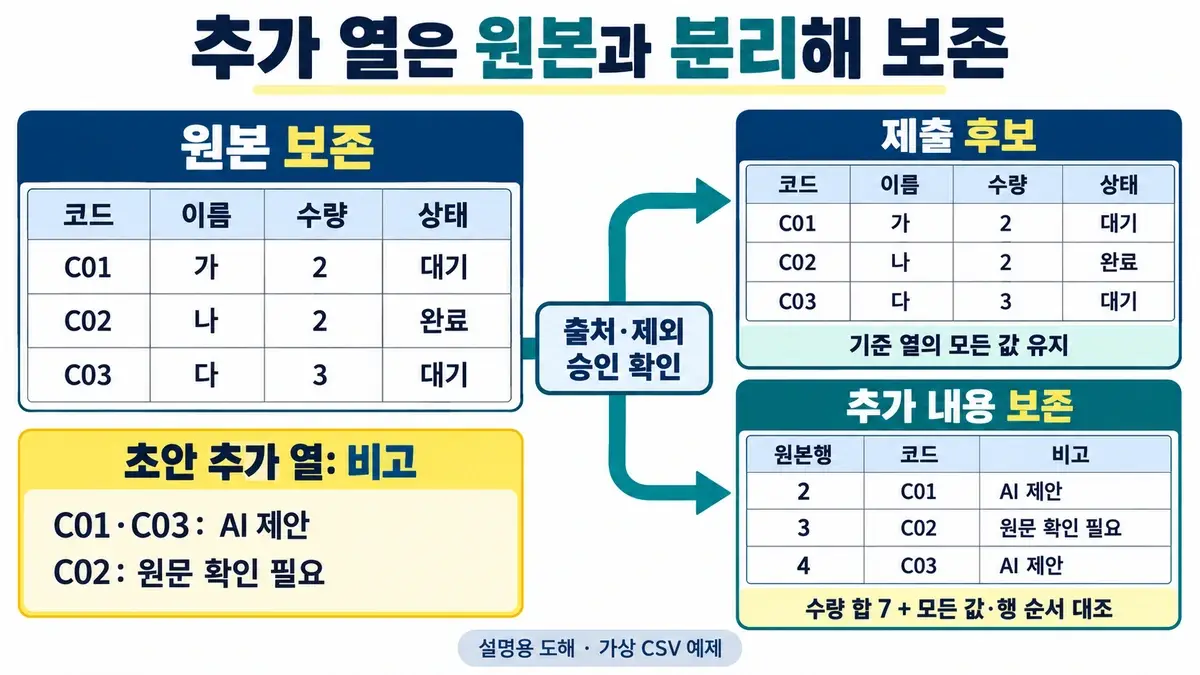
원본에는 코드·이름·수량·상태가 있으며 다음 세 행을 가정합니다.
| 코드 | 이름 | 수량 | 상태 |
|---|---|---|---|
| C01 | 가 | 2 | 대기 |
| C02 | 나 | 2 | 완료 |
| C03 | 다 | 3 | 대기 |
AI 초안에는 같은 네 열에 비고가 추가되었다고 가정합니다. C01·C03에는 “AI 제안”, C02에는 “원문 확인 필요”가 들어 있습니다. 이 값은 원본의 사실로 승격할 수 없지만, 누가 어떤 내용을 추가했는지 확인하는 검토 기록으로 보존할 수 있습니다.
| 열의 차이 | 판단 | 다음 처리 |
|---|---|---|
| 추가 열 비고 | 출처 확인 대상 | 내용과 생성 경위를 별도 보존 |
| 수량이 개수로 바뀜 | 이름 변경인지 필수 열 누락인지 미확인 | 자동 매핑하지 않고 확인 |
| 상태 열이 두 개 | 중복 헤더 | 어느 열이 원본인지 확인 전 중단 |
| 상태 값이 바뀜 | 기준 열 내용 변경 | 열 수가 맞아도 제출 보류 |
| 헤더 앞뒤 공백 | 정규화 후보 | 원안과 변경안 기록 후 승인 |
AI에는 삭제보다 차이표를 먼저 요청합니다
다음 원본과 AI 초안의 열·값 차이를 검토해 주세요.
원본 파일을 수정하거나 추가 열을 바로 삭제하지 마세요.

제출 시스템의 승인 헤더: 코드 / 이름 / 수량 / 상태
코드는 행 식별자이며 중복을 허용하지 않음
원본 행 순서와 기준 열의 문자열 값은 그대로 유지
추가 열은 출처를 확인한 뒤 승인된 제출본에서만 제외 가능
추가 내용은 코드·원본 행 번호와 연결해 별도 보존

원본:
코드,이름,수량,상태
C01,가,2,대기
C02,나,2,완료
C03,다,3,대기

초안:
코드,이름,수량,상태,비고
C01,가,2,대기,AI 제안
C02,나,2,완료,원문 확인 필요
C03,다,3,대기,AI 제안

출력:
추가·누락·중복 헤더 / 기준 열 값 변경 / 확인 질문 / 제출 후보 / 추가 내용 보존표
열 이름이 비슷해도 같은 의미라고 자동 매핑하지 마세요.
승인 전에는 삭제 완료나 제출 완료라고 쓰지 마세요.
기대 결과는 원본과 같은 네 열의 제출 후보와 비고를 담은 별도 검토표입니다. 제출 후보에는 원래 세 행의 값이 모두 그대로 있어야 합니다. 비고 보존표에는 원본행 2·3·4와 코드 C01·C02·C03이 연결되어 있어야 합니다.
엑셀과 Power Query에서 처리할 때
작업용 복사본이나 별도 쿼리에서 승인된 열만 선택해 제출본을 만듭니다. 원본 파일의 열을 직접 지우지 않고, 변경 단계가 무엇인지 남깁니다. 새로 고침으로 다시 열이 들어올 수 있으므로 새 파일마다 추가·누락 열을 확인해야 합니다.
Microsoft의 Table.SelectColumns 문서는 지정한 열만 지정 순서로 반환하며, 요청한 열이 없으면 기본적으로 오류가 발생한다고 설명합니다. MissingField.Ignore나 MissingField.UseNull을 쓰면 누락을 무시하거나 빈 값을 만들 수 있으므로, 필수 열 검수 단계에서 오류를 숨기는 용도로 사용하지 마세요. 추가 열 확인과 보존 여부를 결정한 다음 제출용 투영을 만듭니다.
CSV 작업을 반복한다면 실행 가능한 검수 예제
다음 Python 예제는 파일을 삭제하거나 덮어쓰지 않고, 메모리 안의 가상 원본과 초안을 비교합니다. 비고를 제출본에서 제외해도 된다는 승인을 코드의 {"비고"}로 명시했습니다. 실제 업무에서는 승인된 열 이름만 이 목록에 넣습니다.
import csv
from io import StringIO

EXPECTED = ["코드", "이름", "수량", "상태"]

def read_table(text):
    rows = list(csv.reader(StringIO(text), strict=True))
    if not rows:
        raise ValueError("빈 입력")
    header, data = rows[0], rows[1:]
    if any(not name.strip() for name in header):
        raise ValueError("빈 헤더")
    if len(header) != len(set(header)):
        raise ValueError("중복 헤더")
    if any(len(row) != len(header) for row in data):
        raise ValueError("행의 열 수 불일치")
    return header, data

def to_csv(header, data):
    stream = StringIO(newline="")
    writer = csv.writer(stream, lineterminator="\n")
    writer.writerow(header)
    writer.writerows(data)
    return stream.getvalue()

def review(original, draft, approved_extra_headers):
    base_header, base_rows = read_table(original)
    header, rows = read_table(draft)
    if base_header != EXPECTED:
        raise ValueError("기준 헤더 재확인 필요")
    missing = [name for name in EXPECTED if name not in header]
    extras = [name for name in header if name not in EXPECTED]
    if missing:
        raise ValueError("필수 열 누락: " + ", ".join(missing))
    if set(extras) - set(approved_extra_headers):
        raise ValueError("추가 열 처리 미승인")
    indices = [header.index(name) for name in EXPECTED]
    projected = [[row[i] for i in indices] for row in rows]
    for data in (base_rows, projected):
        keys = [row[0] for row in data]
        if any(not key for key in keys) or len(keys) != len(set(keys)):
            raise ValueError("코드 누락 또는 중복")
    if projected != base_rows:
        raise ValueError("원본 값 또는 행 순서 변경")
    extra_indices = [header.index(name) for name in extras]
    saved = [[str(n), row[indices[0]], *[row[i] for i in extra_indices]]
             for n, row in enumerate(rows, start=2)]
    return (to_csv(EXPECTED, projected),
            to_csv(["원본행", "코드", *extras], saved),
            sum(int(row[2]) for row in projected))

ORIGINAL = "코드,이름,수량,상태\nC01,가,2,대기\nC02,나,2,완료\nC03,다,3,대기\n"
DRAFT = "코드,이름,수량,상태,비고\nC01,가,2,대기,AI 제안\nC02,나,2,완료,원문 확인 필요\nC03,다,3,대기,AI 제안\n"

cleaned, saved, total = review(ORIGINAL, DRAFT, {"비고"})
print("[배포 후보]")
print(cleaned, end="")
print("[추가 열 보존]")
print(saved, end="")
print("수량 합:", total, "/ 기준 열의 모든 값과 행 순서 일치")

cases = [
    ("중복 헤더", DRAFT.replace("상태,비고", "상태,상태"), {"비고"}),
    ("필수 열 누락", DRAFT.replace("수량", "개수", 1), {"비고"}),
    ("미승인 추가 열", DRAFT, set()),
    ("합계가 같아도 값 변경", DRAFT.replace("C01,가,2", "C01,가,1").replace("C03,다,3", "C03,다,4"), {"비고"}),
]
for label, text, approved in cases:
    try:
        review(ORIGINAL, text, approved)
    except ValueError as error:
        print("차단 확인:", label, "->", error)
    else:
        raise AssertionError("차단되지 않은 오류: " + label)
Python csv 공식 문서의 reader·writer로 열을 읽고 출력합니다. 중복 헤더를 먼저 잡기 위해 헤더를 목록으로 검사한 뒤 열 위치를 매핑합니다. 코드·값·행 순서까지 대조하므로 수량 합계만 유지한 변조도 통과하지 않습니다.
2026-10-04 KST에 위 코드를 로컬 Python에서 가상 입력으로 실행했습니다. 출력된 제출 후보는 원본과 같은 네 열·세 행이고 수량 합계는 7입니다. 추가 열 보존표에는 세 행의 비고 값이 남습니다. 중복 헤더, 필수 열 누락, 미승인 추가 열, 합계는 같지만 개별 수량이 달라진 입력은 각각 중단되는 것을 확인했습니다. Excel이나 업무 시스템에 파일을 올린 시험은 아닙니다.
합계가 같아도 원본이 보존됐다고 볼 수 없습니다
C01의 수량을 2에서 1로, C03의 수량을 3에서 4로 바꾸면 합계는 여전히 7입니다. 이름이나 상태가 바뀌어도 합계 검사는 알아채지 못합니다. 그래서 제출 후보는 코드별 모든 기준 열을 원본과 대조해야 합니다. 행 순서를 유지해야 하는 양식이라면 순서도 확인합니다.
실제 파일의 코드는 001처럼 앞의 0이 중요할 수 있습니다. 코드를 숫자로 바꾸거나 날짜·빈칸·공백을 자동 변환하는 기능은 별도 검토 없이 끼워 넣지 않습니다. 위 예제도 수량 합산을 제외한 값 비교는 읽은 문자열 그대로 수행합니다.
추가 열에 실제 업무 정보가 있는지 판단되지 않으면 제출을 보류하고 열 작성자에게 묻습니다. 이미 작업본에서 삭제했다면 보존한 원본이나 정상적인 복구 기능에서 되돌린 뒤 차이를 다시 확인합니다. 원본을 잃은 상태에서 AI에게 값을 재생성하게 하면 복구 자료로 신뢰하기 어렵습니다.
최종 기록에는 기준 파일 버전, 승인 헤더, 제외한 열과 보존 위치, 기준 값 대조 결과, 제출본 이름을 남깁니다. 원본이 남아 있어야 열 구성이 바뀐 다음 달에도 다시 검토할 수 있습니다. 역할 분리는 Power Query와 AI의 역할 분리에서, 차이와 승인 기록은 엑셀 AI 결과 승인대장에서 이어서 볼 수 있습니다.
작성자 소개
