보고서 중복 문장 정리: 원문 위치와 추가 등장 수 확인하기
AI가 보고서에서 “중복 2개를 찾았다”고 답하면 무엇을 센 것인지 먼저 물어보세요. 같은 문장 묶음의 수, 처음 나온 문장을 제외한 추가 등장 수, 서로 비교할 수 있는 모든 쌍의 수는 다릅니다. 중복 문장을 바로 지우기보다 원문 행 번호와 비교 기준을 붙인 목록을 받으면 수정할 위치를 정확히 찾을 수 있습니다.
한 줄을 한 문장으로 준비합니다
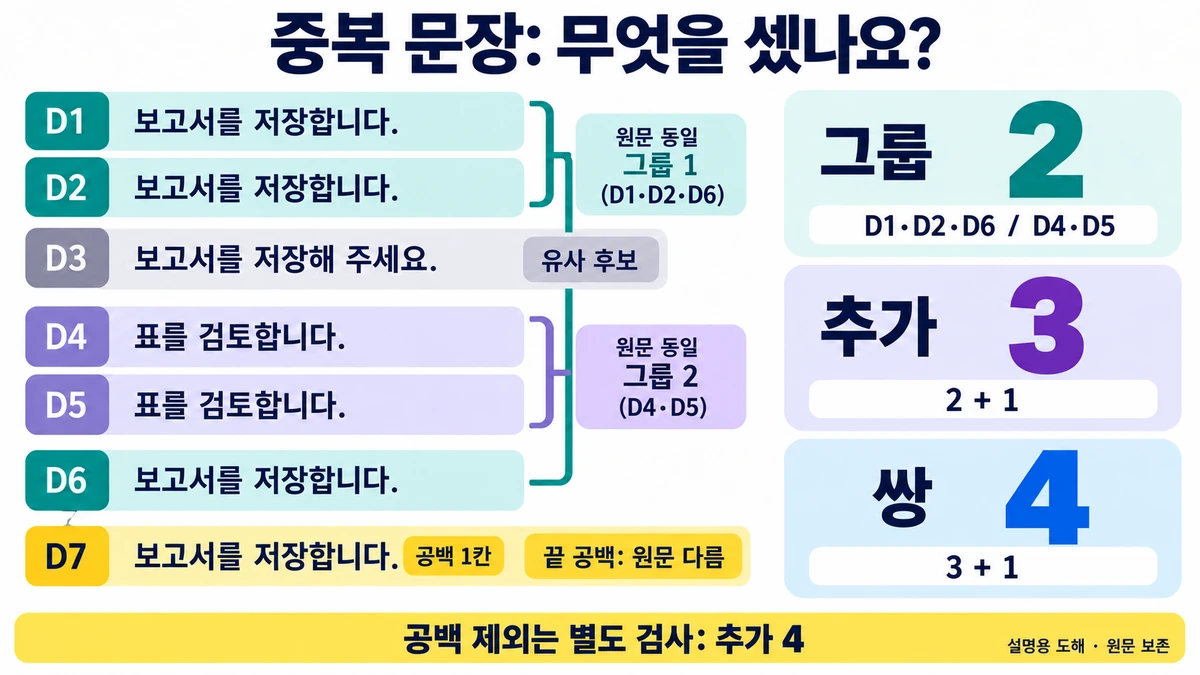
다음 일곱 줄은 가상 보고서 초안입니다. 마지막 줄에는 마침표 뒤 공백이 한 칸 있습니다. 복사 과정에서 공백이 사라질 수 있으므로, 표에서는 ␠로 위치를 표시했습니다. ␠ 문자를 실제 검사 데이터에 넣지는 않습니다.
| 행 ID | 원문 표시 | 판정의 기준 |
|---|---|---|
| D1 | 보고서를 저장합니다. | 첫 등장 |
| D2 | 보고서를 저장합니다. | D1과 글자 그대로 같음 |
| D3 | 보고서를 저장해 주세요. | 뜻이 비슷하지만 다른 문장 |
| D4 | 표를 검토합니다. | 첫 등장 |
| D5 | 표를 검토합니다. | D4와 글자 그대로 같음 |
| D6 | 보고서를 저장합니다. | D1·D2와 글자 그대로 같음 |
| D7 | 보고서를 저장합니다.␠ | 끝 공백 때문에 원문은 다름 |
처음 다섯 줄만 보면 중복 그룹 2개, 추가 등장 2회, 모든 일치 쌍 2개가 모두 같은 숫자입니다. D6를 넣으면 세 개의 지표가 달라집니다. D7을 넣으면 공백을 비교 전에 없애는지에 따라서도 달라집니다. 원문의 띄어쓰기나 말투를 미리 고치면 어떤 문장을 실제로 발견했는지 추적하기 어려워집니다.
중복 개수의 뜻을 결정합니다
| 보고할 지표 | 이 입력의 기대값 | 계산 |
|---|---|---|
| 중복 그룹 | 2 | D1·D2·D6 묶음, D4·D5 묶음 |
| 추가 중복 등장 | 3 | 세 번 나온 문장에서 2, 두 번 나온 문장에서 1 |
| 모든 일치 쌍 | 4 | 세 번 나온 문장 3쌍, 두 번 나온 문장 1쌍 |
편집할 때는 “추가 중복 등장”과 “남길 기준 행”을 받는 편이 실용적입니다. D1을 기준으로 남길 경우 D2·D6가 삭제 후보이고 D4를 남길 경우 D5가 후보입니다. 하지만 제목, 표제, 안전 안내처럼 반복을 의도한 문장이라면 후보를 그대로 보존할 수 있습니다. 숫자는 검토 대상의 규모이며 삭제 허가가 아닙니다.
AI에는 원문 일치와 유사 문장을 따로 요청합니다
아래 초안에서 한 줄을 한 문장으로 취급해 주세요.
D1~D7 원문과 행 ID를 바꾸지 마세요.
1. 공백·구두점·어미까지 같은 완전 일치 그룹을 찾으세요.
2. 그룹별 원문과 모든 행 ID를 출력하세요.
3. 중복 그룹 수와 첫 등장 제외 추가 중복 수를 따로 적으세요.
4. 공백을 제외하면 같은 문장은 별도 후보로 표시하세요.
5. 뜻만 비슷한 문장은 '유사 후보'로 두고 완전 일치 수에 넣지 마세요.
원문을 자동 삭제하거나 한 문장으로 합치지는 마세요.
D3을 D1의 완전 일치로 넣었다면 실패입니다. 어미가 달라 문자열이 같지 않습니다. D7을 D1과 같은 원문이라고 보고했다면 공백 비교 기준을 먼저 확인하세요. “읽을 때 비슷하다”와 “글자 그대로 같다”는 편집 목적에 따라 각각 쓸 수 있지만 같은 결과표 안에서 기준을 섞으면 안 됩니다.
Python으로 원문과 행 번호를 확인합니다
아래 코드는 문장 하나를 리스트 항목 하나로 넣습니다. 원문 검사에서는 strip을 사용하지 않고, 앞뒤 공백을 없앤 별도 후보 검사에서만 strip을 씁니다. 문장 분리 AI나 한국어 형태소 분석기는 사용하지 않습니다.
from collections import Counter, defaultdict
lines = ["보고서를 저장합니다.", "보고서를 저장합니다.",
         "보고서를 저장해 주세요.", "표를 검토합니다.",
         "표를 검토합니다.", "보고서를 저장합니다.",
         "보고서를 저장합니다. "]
positions = defaultdict(list)
for row_id, line in enumerate(lines, 1):
    positions[line].append(row_id)
counts = Counter(lines)
groups = {text: ids for text, ids in positions.items() if len(ids) > 1}
extra = sum(n - 1 for n in counts.values() if n > 1)
pairs = sum(n * (n - 1) // 2 for n in counts.values() if n > 1)
assert list(groups.values()) == [[1, 2, 6], [4, 5]]
assert (len(groups), extra, pairs) == (2, 3, 4)
trim_counts = Counter(line.strip() for line in lines)
trim_extra = sum(n - 1 for n in trim_counts.values() if n > 1)
assert trim_extra == 4
assert lines[2] not in groups
assert len(lines) == 7  # Never delete from the original.
print("원문 완전 일치: 그룹2 / 추가중복3 / 모든쌍4")
print("행번호:", list(groups.values()))
print("앞뒤공백 제외 별도 후보: 추가중복4")
로컬 실행에서 원문 완전 일치는 그룹 2개, 추가 등장 3회, 모든 일치 쌍 4개였고, 앞뒤 공백을 제외한 추가 등장은 4회였습니다. Python Counter 문서는 항목별 빈도를 세는 도구의 기준입니다. 결과의 문장 의미나 삭제 적절성은 이 코드가 판단하지 않습니다.
긴 문서에서는 위치부터 잃지 않게 합니다
긴 초안은 문단ID와 문장ID를 붙여 나눠 보내세요. “첫 부분과 끝부분이 같다”는 답만으로는 위치를 찾기 어렵습니다. 문단 경계에서 두 묶음에 겹쳐 넣은 문장이 실제 원문 중복인지, 전송 과정의 겹침인지도 구분해야 합니다.
한 문장에 줄바꿈이 들어가는 문서에서 줄마다 검사하면 문장 단위 결과가 아닙니다. 반대로 한 줄에 여러 문장이 있으면 이번 코드는 줄 전체가 같아야 중복으로 셉니다. 우선 줄 단위 중복인지 문장 단위 중복인지 정하고, 원문을 다시 자를 때는 원래 위치를 함께 보존하세요. 표·각주·머리말을 검사에서 제외했다면 결과에 제외 범위를 적습니다.
문서 버전:
검사 범위와 제외 범위:
분리 단위: 줄 / 문장 / 문단
비교 기준: 원문 그대로 / 앞뒤 공백 제외 / 기타
중복 원문:
그룹 행 ID:
남길 기준 행:
추가 등장 수:
유사하지만 제외한 행:
편집 결정: 보존 / 삭제 후보 / 재작성 후보
결정 이유와 확인자:
누락과 오탐이 생겼을 때 복구합니다
D6가 결과에서 빠졌다면 원본 ID 목록을 다시 대조해 모든 등장 위치를 보완합니다. D3까지 같은 그룹에 들어갔다면 완전 일치 결과를 다시 만들고 유사 후보를 별도로 옮깁니다. 공백 정리본으로 원본을 덮었다면 저장해 둔 원본 버전에서 다시 시작하세요.
작성·기술 기준일은 2026-10-04 KST입니다. 일곱 줄의 합성 입력과 위 Python 코드를 로컬에서 확인했습니다. 실제 AI 응답이나 Word 문서 전체를 시험하지 않았습니다. 최종 삭제 전에는 인용, 강조, 반복 안내의 역할도 사람이 읽어야 합니다.
수정 전후 숫자·이름까지 보존해야 한다면 AI 문장 교정 뒤 표기 대조를, 편집 결정을 기록하려면 AI 결과 승인대장을 참고하세요.
작성자 소개
