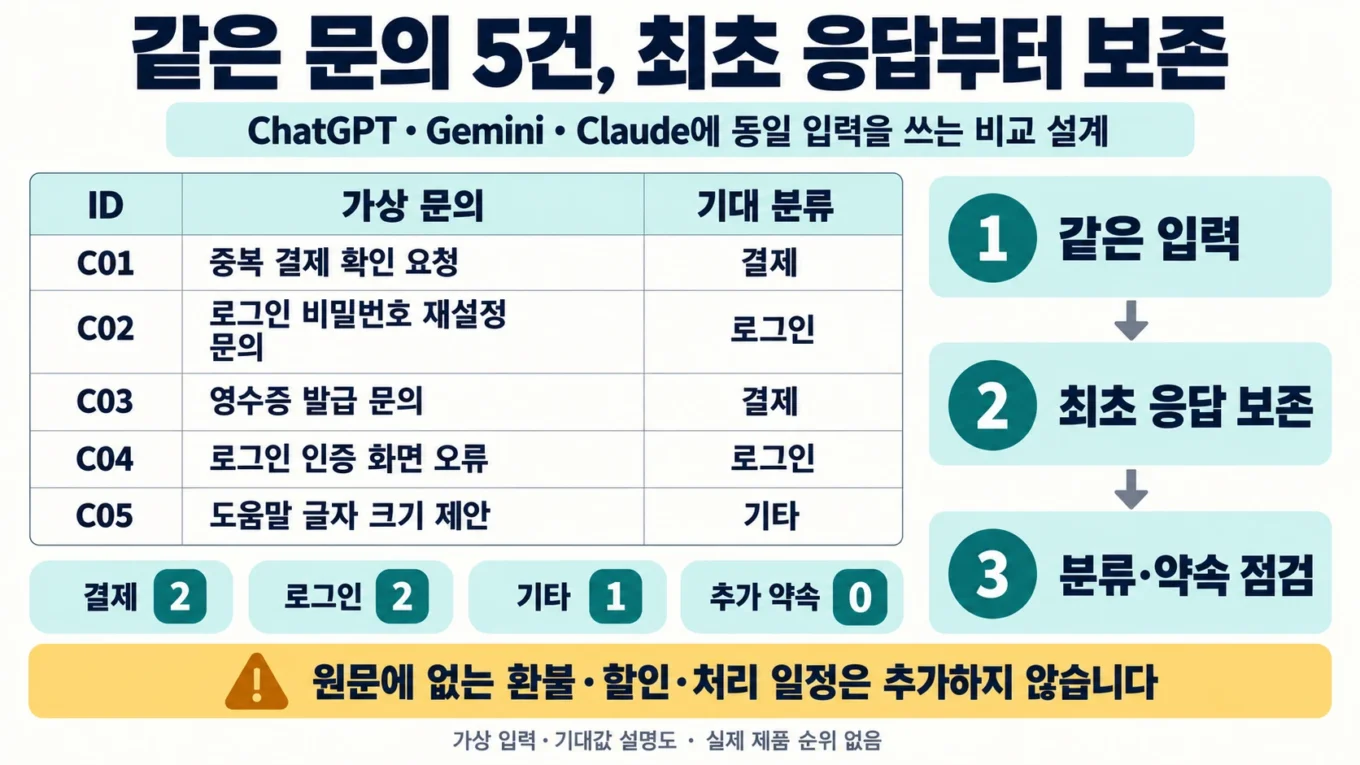
ChatGPT·Gemini·Claude 비교 실험 설계: 문의 5건의 입력·검산·오판 복구
ChatGPT·Gemini·Claude에 같은 과제를 맡겨 비교하려면 입력과 실패 기준을 먼저 정해야 합니다. 이 글에서는 가상 고객 문의 5건, 기대 분류, JSON 출력 규칙과 검산기를 묶어 비교 실험을 직접 설계하고 결과를 점검하는 방법을 제공합니다. 원문에 없는 환불 약속이나 잘못된 분류를 찾고, 최초 응답을 보존하며 수정하는 순서까지 연습할 수 있습니다. 이 페이지의 A·B·C 점수와 소요 시간은 직접 만든 합성 값이며, 세 서비스의 실제 응답이나 성능 순위는 제시하지 않습니다.
30분은 후보 세 개에 각각 최대 10분을 배정하는 실행 예산입니다. 계정 준비·정책 확인·채점 시간을 포함한 완료 보장은 아닙니다. 서비스별 비용과 능력은 별도 검토할 항목으로 남깁니다. 같은 이름의 서비스라도 계정·모델 표시·연결 기능이 다르면 다른 실행 조건으로 기록합니다.
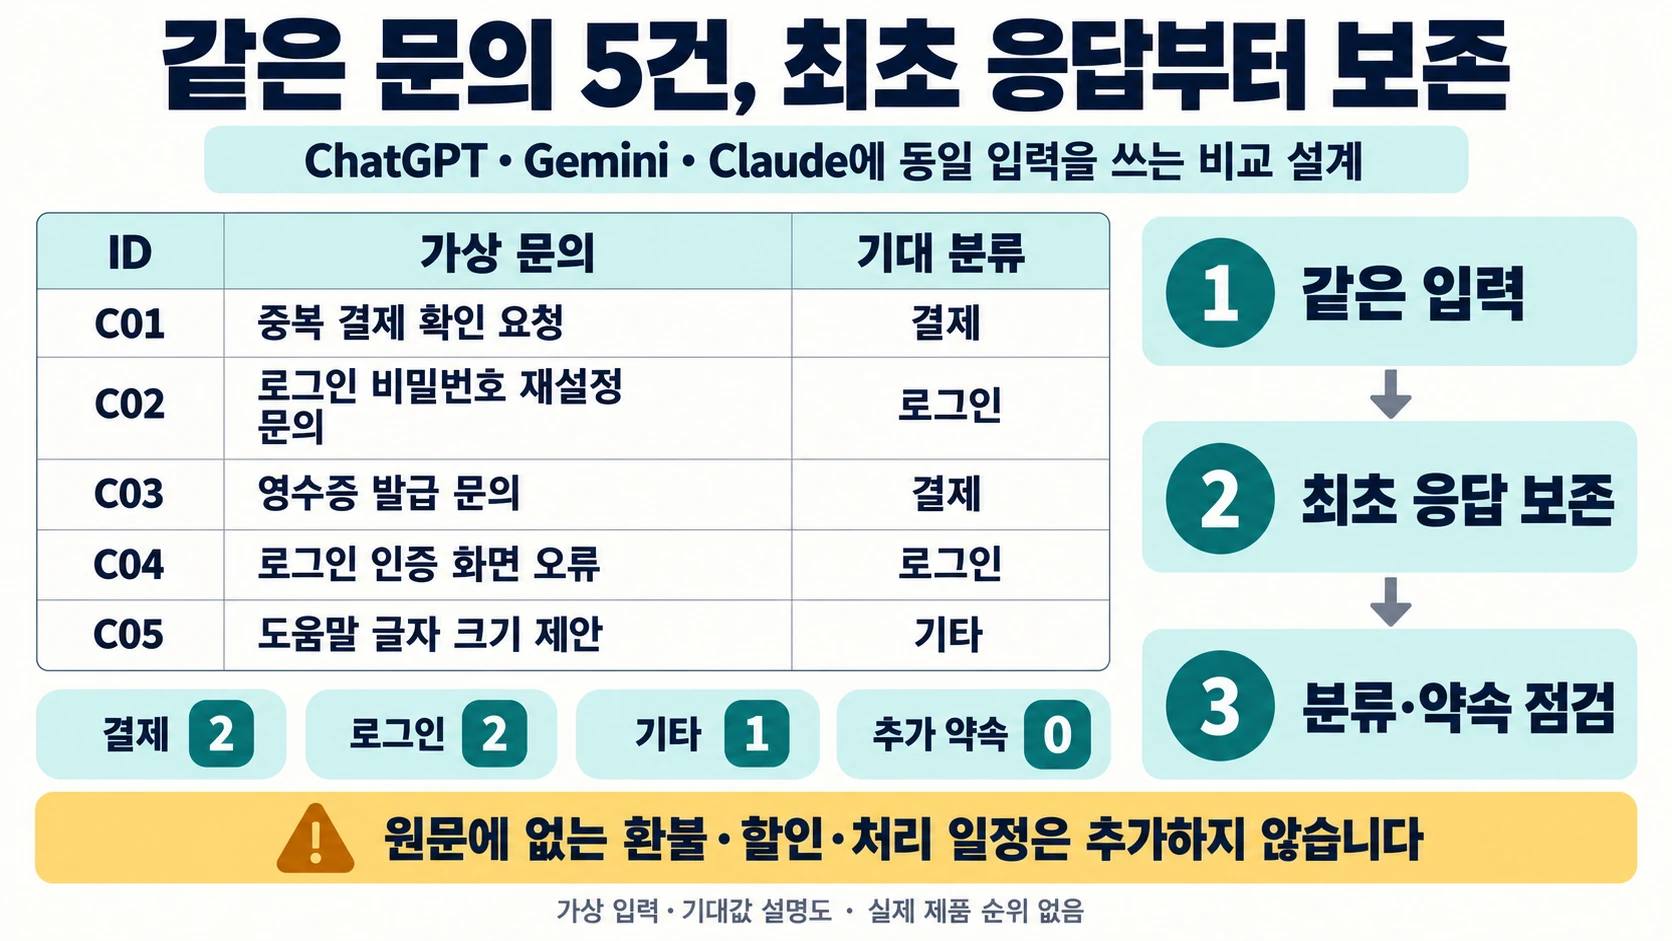
다섯 문의의 정답을 먼저 고정하기
준비물은 ZIP을 풀 폴더, 허용된 서비스 계정, 원본 응답을 저장할 텍스트 편집기입니다. 첨부를 여는 것만으로 모델이나 외부 서버에 연결되지 않습니다. 실제 고객 문장이나 비밀은 이 비교에 필요하지 않습니다.
서비스 입력과 채점 자료를 분리하기
첨부 ZIP은 로컬 검산용 전체 패키지입니다. fixture.json에는 문의의 id·text와 함께 정답 route, A·B·C의 합성 점수도 들어 있습니다. expected.json은 고정 정답이며 다른 파일에는 반례와 점수표가 있습니다. 패키지를 통째로 서비스에 전달하면 정답이 노출되어 분류를 직접 수행했는지 비교하기 어렵습니다.
실제 서비스에 전달할 때는 아래 복사용 요청문과 id·text 5행만 사용합니다. 본문의 정답표나 ZIP 전체를 붙이지 않습니다. route·expected.json·합성 candidates는 자신의 컴퓨터에 채점 자료로 보관하세요. 로컬 검산기는 원래 fixture.json을 읽으므로 파일에서 정답을 지우는 방식으로 수정하지 않습니다. 입력 분리 안내 v2의 prompts.txt에는 아래 요청문과 같은 id·text 5행이 들어 있습니다. 내려받은 파일의 버전을 확인하고, 이전 prompts 파일을 쓰는 경우에도 서비스에는 아래 분리된 입력만 전달하세요.
| ID | 가상 입력 | 기대 분류 |
|---|---|---|
| C01 | 중복 결제 확인 요청 | 결제 |
| C02 | 로그인 비밀번호 재설정 문의 | 로그인 |
| C03 | 영수증 발급 문의 | 결제 |
| C04 | 로그인 인증 화면 오류 | 로그인 |
| C05 | 도움말 글자 크기 제안 | 기타 |
이 작은 예제의 규칙은 명시적입니다. ‘결제’ 또는 ‘영수증’이 있으면 결제, 그렇지 않고 ‘로그인’이 있으면 로그인, 나머지는 기타입니다. 두 조건이 함께 나타나는 실제 문의의 업무 정책까지 검증한 규칙은 아닙니다. 반환할 ID를 바꾸거나 문장을 새로 만들어서는 안 됩니다.
아래 tickets의 다섯 문의를 분류한다.
분류 규칙: text에 결제 또는 영수증이 있으면 결제,
그렇지 않고 로그인이 있으면 로그인, 나머지는 기타다.
JSON 객체에 items와 promises 두 키만 쓴다.
items는 원문 순서대로 id, route 두 키의 객체 다섯 개다.
route는 결제, 로그인, 기타 중 하나다.
원문에 없는 처리 일정·환불·할인 약속을 추가하지 않는다.
이번 자료에는 확정 약속이 없으므로 promises는 빈 배열이다.
JSON 앞뒤에 설명이나 코드 울타리를 붙이지 않는다.

tickets:
[
  {
    "id": "C01",
    "text": "중복 결제 확인 요청"
  },
  {
    "id": "C02",
    "text": "로그인 비밀번호 재설정 문의"
  },
  {
    "id": "C03",
    "text": "영수증 발급 문의"
  },
  {
    "id": "C04",
    "text": "로그인 인증 화면 오류"
  },
  {
    "id": "C05",
    "text": "도움말 글자 크기 제안"
  }
]
expected.json에는 결제 2건, 로그인 2건, 기타 1건과 빈 약속 배열이 들어 있습니다. verify.py는 같은 문의를 규칙으로 다시 분류한 결과를 이 파일과 대조합니다. 정답 파일만 자기 자신과 비교하는 단계로 끝내지 않습니다.
같은 조건으로 요청하고 최초 응답을 보존하기
-
입력 자료를 해당 서비스에 전달해도 되는지 확인합니다. 확인할 수 없으면 정책 상태를 미확인으로 둡니다.
- 후보별 새 대화를 열고 표시된 모델·날짜·연결 기능 사용 여부를 별도 기록합니다. 위 복사용 요청문과
id·text5행을 동일하게 전달합니다. 정답과 합성 점수는 입력에서 분리해 둡니다. -
첫 응답을 손으로 수정하지 말고
response.json으로 저장합니다. 계정 로그인이나 자료 입력에 걸린 시간과 응답 대기는 구분합니다. -
python3 verify.py response.json으로 고정 정답과 비교합니다. 불일치는 종료 코드 1입니다. 잘못된 답을 정답처럼 고쳐 저장한 뒤 통과로 기록하지 않습니다. -
재요청했다면 최초 응답을 남기고 새 파일과 수정 이유를 추가합니다. 한 후보의 반복 수정 시간을 다른 후보의 첫 응답 시간과 같은 값처럼 비교하지 않습니다.
Anthropic의 평가 기준 안내는 성공 조건을 구체적이고 측정 가능하게 정의하도록 설명합니다. 이 글의 분류·약속 검사는 그 원칙을 이 가상 과제에 적용한 자체 기준입니다. 특정 제품의 성능 수치로 인용할 자료는 아닙니다.
OpenAI의 프롬프트 안내는 모델 출력의 비결정성을 설명하고 평가를 함께 설계하도록 권합니다. 반복 실행의 원본과 오류 기록을 함께 남기는 이유입니다.
엑셀의 A·B·C는 제품 이름이 아닙니다
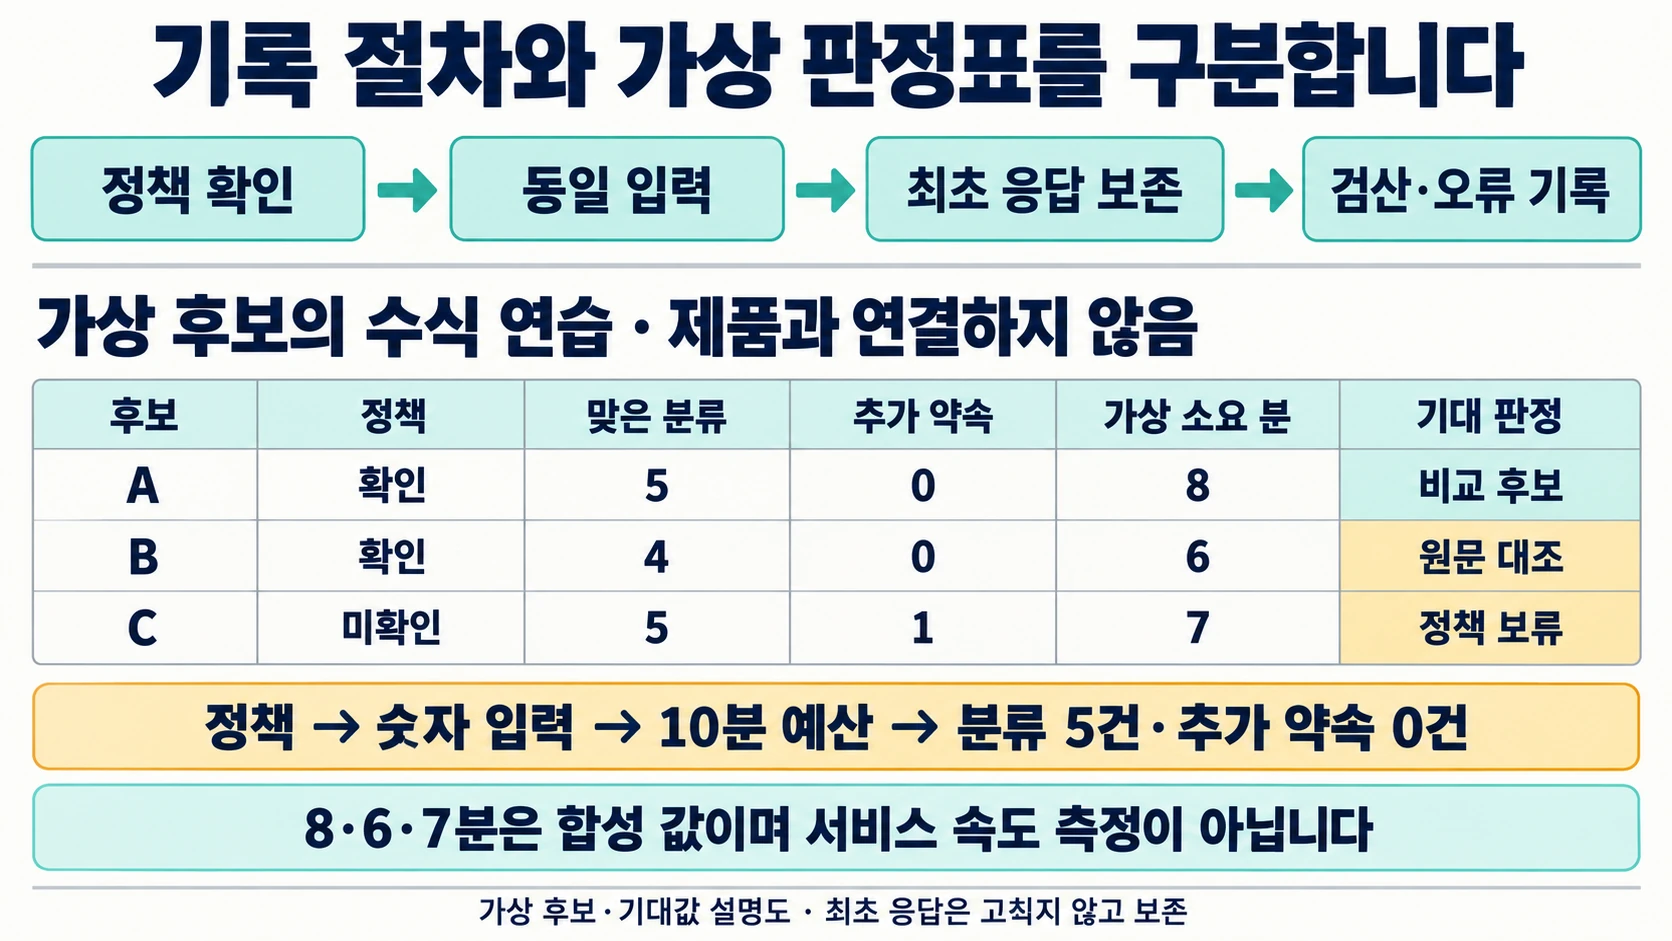
후보비교 시트 A5:F7의 세 행은 판정 수식 연습용입니다. A를 ChatGPT에 대응시키는 식의 제품 연결은 하지 않았습니다. 맞은 분류 수와 추가 약속 수는 독자가 원본을 확인한 뒤 입력하는 칸입니다. 엑셀이 응답 의미를 읽어 채점하지 않습니다.
| 가상 후보 | 정책 | 맞은 분류 | 추가 약속 | 소요 분 | F열 기대 값 |
|---|---|---|---|---|---|
| A | 확인 | 5 | 0 | 8 | 비교 후보 |
| B | 확인 | 4 | 0 | 6 | 원문 대조 |
| C | 미확인 | 5 | 1 | 7 | 정책 보류 |
결과를 읽는 세 단계
- 합성 점수표로 판정 순서를 익힙니다. 정책 상태가 미확인이면 C처럼 정책 보류로 남깁니다. 정책이 확인됐을 때 숫자 입력과 10분 예산, 분류 5건의 일치와 추가 약속 0건을 순서대로 확인합니다. A의 ‘비교 후보’는 이 연습 규칙을 만족했다는 뜻입니다.
- 실제 비교를 진행했다면 원본 응답에서 자신의 값을 기록합니다. 서비스명·표시 모델·실행 날짜와 조건을 따로 적고, 수정하지 않은 최초 응답을 검산합니다. XLSX의 A·B·C 합성 행을 서비스의 측정값으로 복사하지 않습니다. 형식·ID·분류 검사는 검산기로, 원문에 없는 약속이나 표현의 의미는 원문과 직접 대조합니다.
- 한 과제의 통과를 제품 전체 평가로 확대하지 않습니다. 다섯 문의를 모두 맞히고 약속을 추가하지 않았더라도 확인한 범위는 이 입력과 규칙뿐입니다. 비용·보안 승인·다른 업무의 적합성은 별도 확인합니다. 실패한 후보는 원본을 남기고 오류 ID와 재요청 이유를 기록한 뒤 새 회차로 비교합니다.
실패를 일부러 넣어 확인하기
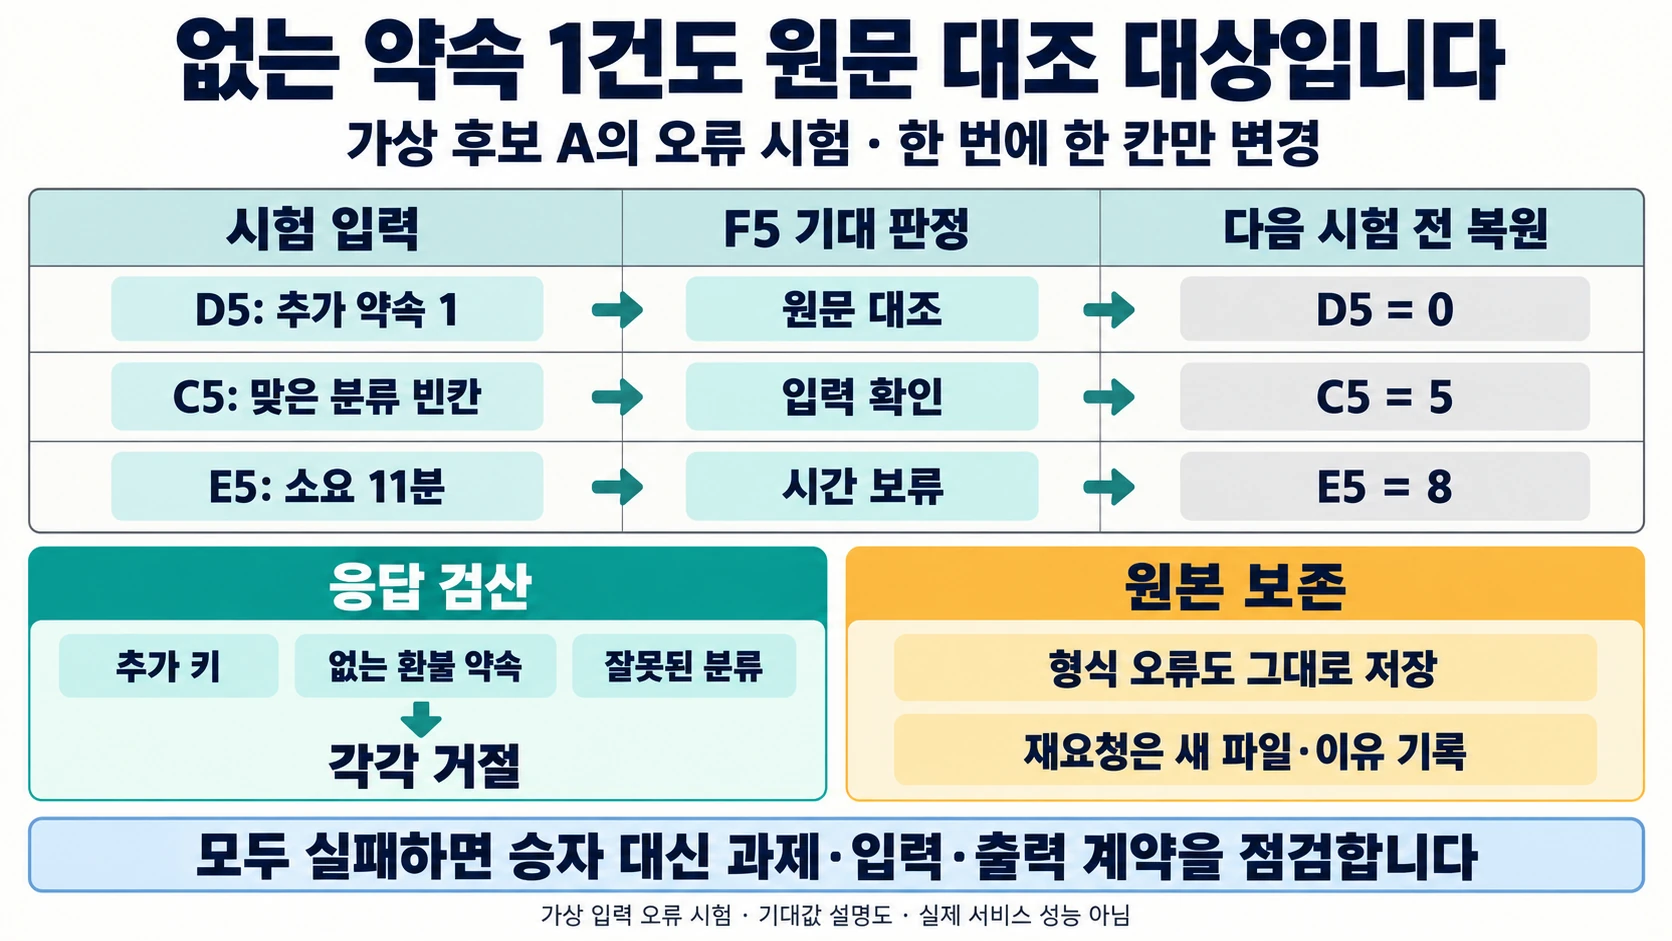
실습 사본에서 D5를 1로 바꾸면 F5는 원문 대조가 됩니다. 정답 분류 수가 그대로 5여도 없는 약속 한 건을 허용하지 않습니다. C5를 지우면 입력 확인, E5를 11로 바꾸면 시간 보류입니다. 한 번에 한 칸만 바꾸고 원래 값 0·5·8로 복원한 뒤 다음 시험을 합니다.
JSON에 설명문이 붙어 파싱되지 않으면 원본을 보존한 상태로 출력 형식을 다시 요청합니다. C01을 기타로 분류했으면 규칙을 확인하고 그 행의 오류로 남깁니다. 서로 다른 최초 응답을 붙여 만든 ‘좋은 답’은 같은 실행의 결과가 아닙니다. 기본 검산은 python3 verify.py이며 추가 키, 없는 환불 약속, 잘못된 분류를 각각 거절해야 합니다.
다섯 문의만으로 정할 수 없는 적용 한계
모두 실패하면 승자를 정하지 않고 과제·입력·출력 계약을 점검합니다. 둘 이상 통과하면 새로운 대표 문의와 별도 회차로 비교 범위를 넓힙니다. 이 다섯 건에 맞았다는 이유로 긴 문서나 민감한 상담까지 맡길 수는 없습니다. 합성 소요 시간 8·6·7분을 서비스 속도 차이로 읽어서도 안 됩니다.
문의 분류 대신 문서의 날짜와 인원을 비교하려면 날짜 충돌과 없는 참석 인원을 구분하는 근거 대조 실습으로 이어갈 수 있습니다.
첨부에는 고정 예제용 JSON 검산기와 가상 점수표가 함께 있습니다. 검산기가 검사하는 것은 정확한 키·자료형·값이며 자연어 표현의 동등성이나 실제 서비스의 정책 준수는 사람이 확인해야 합니다.
출처 원문 수집일: S1 2026-09-24; S2 2026-09-24.
작성자 소개
