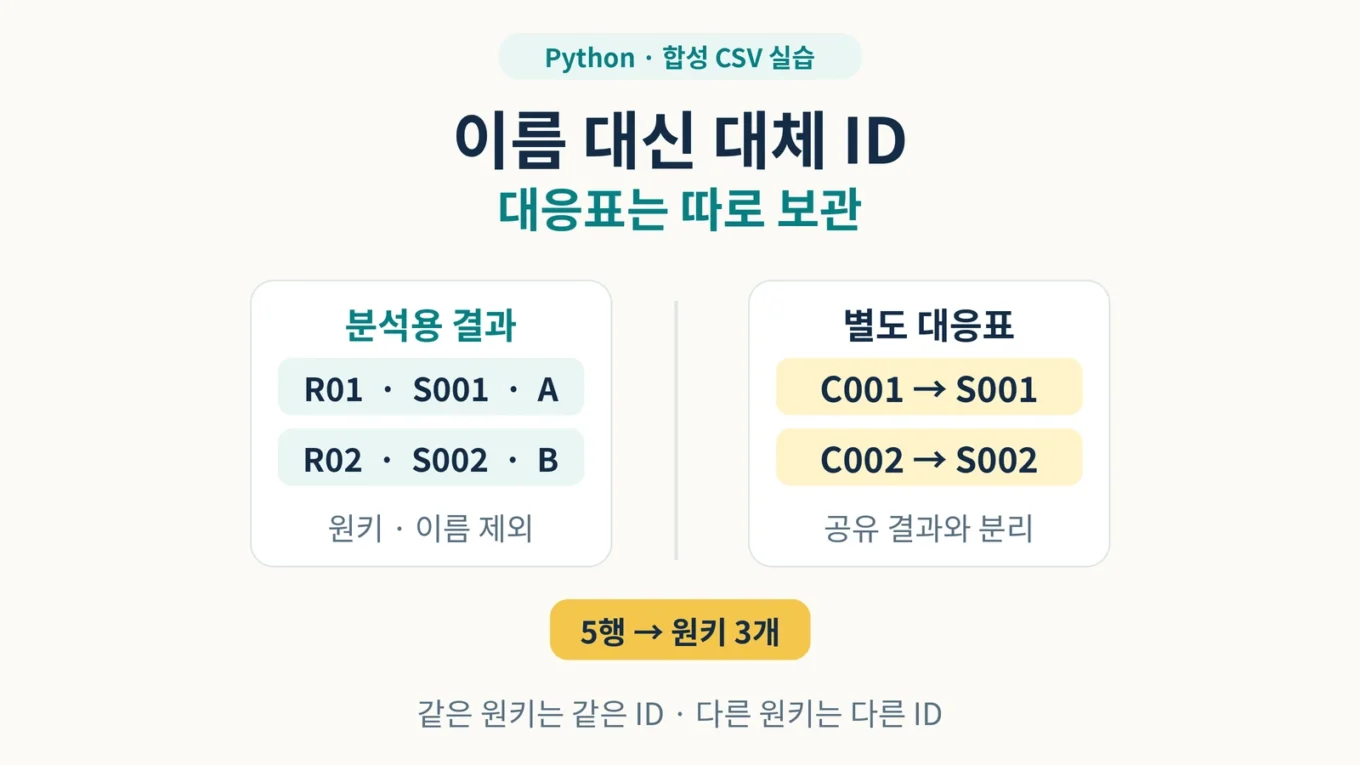
Python 대체 ID 만들기: 가상 명단과 대응표를 따로 저장하기
가상 명단에서 이름을 빼고 분석용 번호만 남기려면, 먼저 어떤 항목을 같은 대상으로 볼 것인지 정해야 합니다. 이름이 같은 두 행이 같은 대상이라는 보장은 없습니다. 반대로 하나의 대상이 여러 행에 나타나면, 행마다 새 번호를 붙이는 방식도 목적에 맞지 않습니다.
이 실습은 Python으로 로컬 CSV를 읽고 original_key를 미리 준비한 대체 ID에 연결합니다. 원본 명단과 대응표는 따로 두고, 결과에는 row_id, surrogate_id, value 세 열만 기록합니다. 같은 원본 키는 항상 같은 대체 ID를 사용하며, 입력 행을 재정렬해도 기존 대응표를 그대로 재사용합니다.
대체 ID와 대응표 분리 실습 ZIP 다운로드에는 실행 코드, 가상 명단, 고정 대응표, 기대 결과, 실패 연습 자료와 자동 검증 코드가 들어 있습니다. 이름·키·값은 모두 실습용으로 만든 가상 데이터입니다. 조사·실행 검수일은 2026년 10월 11일이며, 실제 검수 환경은 Linux의 CPython 3.12.14입니다. 사이트의 표시 게시일과 실제 조사·검수일을 구분해 기록합니다.
적용 범위: 이 글은 파일 구조와 CSV 변환을 배우는 예제입니다. 파일을 따로 저장하는 것만으로 암호화나 접근 제어가 적용되지는 않습니다. 이 결과는 검증된 익명화 자료가 아니며, 남겨 둔 행 번호와 값으로 원본이나 다른 자료에 다시 연결될 수 있습니다. 실제 개인정보를 가져와 실습하지 마세요.
1. 행 번호와 원본 키의 역할부터 구분하기
동봉한 명단은 5행이고, 원본 키는 C001, C002, C003 세 종류입니다. row_id는 각 기록을 구별하는 행 번호입니다. original_key는 여러 기록에 걸쳐 같은 대상을 연결하는 기준입니다. 대체 ID는 이 원본 키에 붙이는 별도의 표기입니다.
예를 들어 R01과 R03은 값이 각각 A와 C이지만 둘 다 C001의 기록입니다. 그러므로 두 행의 대체 ID는 S001로 같아야 합니다. R02와 R05도 C002의 기록이어서 S002를 함께 사용합니다. 행 수는 5개로 유지하고 대상에 붙인 ID는 3종류로 유지하는 것이 목표입니다.
가상민수라는 이름은 C001과 C002에 모두 나옵니다. 이름을 사전의 키로 사용하면 서로 다른 두 원본 키가 하나의 ID로 합쳐질 수 있습니다. 이번 코드는 이름을 식별 기준으로 사용하지 않습니다. 원본 키가 같으면 같은 ID, 원본 키가 다르면 다른 ID를 적용합니다.
이 기준은 원본 키가 이미 올바르게 정해졌다는 전제에서 작동합니다. 서로 다른 대상에 같은 C001을 적어 놓은 오류까지 이 변환 코드가 찾아내지는 못합니다. 이름이 같다는 이유로 합치거나 이름이 다르다는 이유로 나누기 전에, 데이터가 만들어진 단계에서 원본 키의 의미와 부여 규칙을 확인해야 합니다.
2. 가상 명단과 고정 대응표를 따로 준비하기
ZIP을 새 폴더에 풀면 id_mapping_example 폴더가 나옵니다. 명단은 synthetic_input/roster.csv, 대응표는 private_mapping/id_mapping.csv입니다. 두 파일을 아래 내용과 대조한 뒤 실습을 시작하세요. 쉼표로 구분된 CSV의 첫 줄은 열 이름입니다.
가상 명단 전체 내용
row_id,original_key,name,value
R01,C001,가상민수,A
R02,C002,가상민수,B
R03,C001,가상민수,C
R04,C003,가상유리,D
R05,C002,가상민수,E
고정 대응표 전체 내용
original_key,surrogate_id
C001,S001
C002,S002
C003,S003
이 실습은 대응표를 먼저 준비한 뒤 조회해서 사용합니다. 입력을 읽을 때마다 처음 나타난 이름이나 행 순서에 따라 새 번호를 발급하지 않습니다. S001은 C001에, S002는 C002에, S003은 C003에 연결한다는 약속을 파일로 남긴 것입니다.
대응표에는 같은 original_key를 두 번 적을 수 없습니다. 서로 다른 키에 같은 surrogate_id를 지정하는 것도 허용하지 않습니다. 전자는 한 키에 어떤 ID를 써야 할지 모호하게 만들고, 후자는 서로 다른 대상이 같은 ID로 합쳐지게 만듭니다. 명단에서 C001이 여러 번 나오는 것은 정상이고, 대응표에서 C001이 여러 번 나오는 것은 오류라는 차이를 기억하세요.
이 예제의 대체 ID 형식은 대문자 S 뒤에 ASCII 숫자 세 자리인 S001 형태로 고정합니다. 숫자 길이나 접두사가 달라지면 코드와 검증 기준도 함께 바꿔야 합니다. S001 자체에 비밀이나 무작위성을 부여한 것은 아닙니다. 원본 키와 대체 표기의 관계를 일정하게 유지하기 위한 작은 실습 규칙입니다.
private_mapping이라는 폴더 이름은 대응표의 용도를 설명할 뿐, 파일을 숨기거나 접근을 막는 설정은 아닙니다. 이 공개 ZIP에 명단과 대응표를 함께 넣은 것은 모든 자료가 가상이어서 내용을 대조할 수 있도록 한 것입니다. 실제 데이터 작업에서는 공개할 결과와 보관할 원본·대응표의 위치 및 접근 범위를 별도로 정해야 합니다.
3. Python으로 첫 결과 파일 만들기
터미널에서 압축을 푼 id_mapping_example 폴더를 작업 위치로 사용합니다. 명령을 실행하기 전에 replace_ids.py, synthetic_input, private_mapping이 같은 위치에 보이는지 확인하세요. 이번 코드는 Python 3.10 이상에서 사용할 수 있는 표준 라이브러리만 사용하므로 추가 패키지를 설치할 필요가 없습니다. 실습 ZIP의 public 폴더는 새 결과를 만들 수 있도록 비워 두었습니다. 별도로 파일을 준비했다면 결과의 상위 폴더가 먼저 있어야 하므로 mkdir public으로 만들고 실행하세요.
python --version
python replace_ids.py --input synthetic_input/roster.csv --mapping private_mapping/id_mapping.csv --output public/run_01
macOS나 Linux에서 Python 명령이 python3으로 제공되면 위 명령의 python을 python3으로 바꿉니다. Windows에서 Python Launcher를 사용한다면 py -3.12로 실행할 수 있습니다. 먼저 버전을 확인하고, 검수에 사용한 Python 3.12 계열에서 따라 하는 편이 결과를 비교하기 쉽습니다.
--input은 읽을 명단, --mapping은 재사용할 대응표, --output은 이번 실행의 새 결과 폴더입니다. 마지막 인수는 CSV 파일명이 아닙니다. 성공하면 종료 코드 0과 완료: 5행으로 시작하는 메시지가 나오고, 그 폴더 안에 analysis.csv 하나가 생성됩니다. 원본과 대응표는 읽기만 하고 다른 위치로 복사하거나 수정하지 않습니다. 대응표 폴더와 결과 폴더가 서로 포함되는 경로도 거부하므로, 두 위치를 나란히 구분해 두세요.
이 실습에서는 public 아래에 실행별 폴더를 둡니다. 이 이름 역시 웹에 자동 공개한다는 뜻이 아닙니다. 스크립트는 로컬 파일만 처리하며 업로드나 네트워크 전송을 하지 않습니다. 결과 폴더를 공유할 때 원본 폴더와 대응표 폴더를 함께 묶지 않도록 구조를 구분한 것입니다.
같은 public/run_01이 이미 있으면 변환을 거부합니다. 첫 결과를 확인한 뒤 다시 실행하려면 public/run_02처럼 새 폴더를 지정하세요. 이전 파일을 자동으로 덮어쓰지 않으므로 두 실행을 비교할 수 있고, 실수로 확인 중인 결과를 잃는 상황도 줄일 수 있습니다.
4. 5행과 3종류의 대체 ID가 맞는지 확인하기
아래는 정상 명단으로 생성한 public/run_01/analysis.csv의 기대 내용입니다. ZIP의 expected_results/run_01/analysis.csv에 실제 실행으로 얻은 비교 파일이 있습니다. 행별로 대조하세요. 이 예제는 결과 CSV를 UTF-8 BOM 포함 형식으로 작성하므로, 아래 표시에는 보이지 않는 BOM이 파일 맨 앞에 있습니다.
row_id,surrogate_id,value
R01,S001,A
R02,S002,B
R03,S001,C
R04,S003,D
R05,S002,E
성공 메시지만 보고 끝내지 말고 열 이름, 행 수, 행별 ID, 남겨 둔 값을 함께 확인합니다. 이름과 원본 키가 사라졌어도 ID를 잘못 붙였거나 행이 빠졌다면 실습 목표를 달성한 결과가 아닙니다.
- 열 순서가
row_id,surrogate_id,value인지 확인합니다. - R01부터 R05까지 5행이 남아 있고 value의 A부터 E가 원래 행과 연결되어 있는지 확인합니다.
- ID 순서가
S001,S002,S001,S003,S002인지 확인합니다. - R01과 R03은 같은 S001이고, R01과 R02는 이름이 같아도 서로 다른 ID인지 확인합니다.
- 결과에
original_key,name, C001 등의 원본 키와 가상 이름이 들어 있지 않은지 확인합니다.
원본 열을 일부만 남기는 작업은 코드의 csv.DictWriter에 지정한 열 목록으로 수행합니다. 명단에서 읽은 사전 전체를 저장하는 대신 결과용 사전을 새로 구성합니다. 입력에 있는 열을 무심코 모두 출력하는 실수를 줄이고, 결과 계약을 세 열로 명확히 하는 방식입니다.
출력에서 이름과 원본 키가 빠졌다는 확인은 특정 열이 제거됐다는 확인입니다. 행 번호 R01과 값 A를 원본과 비교하면 같은 기록임을 알 수 있습니다. 따라서 이 확인을 사람을 알아볼 수 없다는 증명으로 해석하면 안 됩니다. 어떤 열을 남길 수 있는지는 실제 자료의 맥락과 공유 목적을 따로 검토해야 합니다.
5. 입력 순서가 바뀌어도 같은 대응표 재사용하기
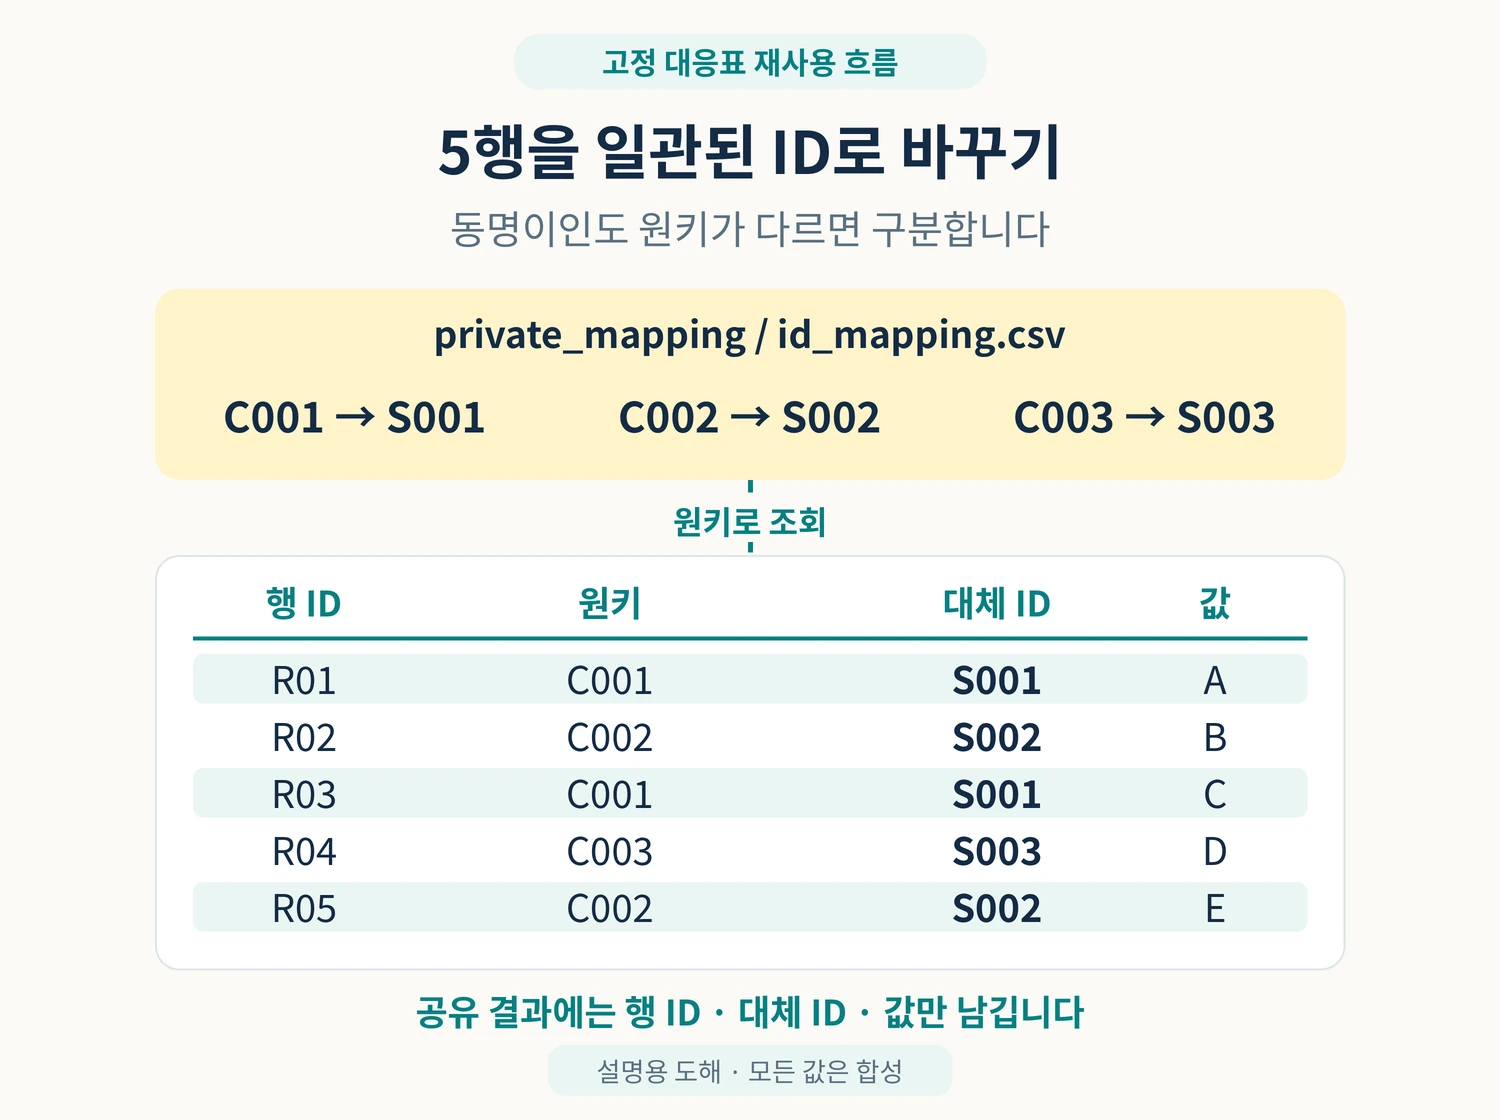
ZIP의 synthetic_input/roster_reordered.csv는 정상 명단의 다섯 행을 역순으로 배치한 파일입니다. R05가 맨 앞에 와도 C002는 S002여야 합니다. 다시 실행할 때 대응표를 새로 만들지 않고 앞서 사용한 private_mapping/id_mapping.csv를 그대로 지정합니다.
python replace_ids.py --input synthetic_input/roster_reordered.csv --mapping private_mapping/id_mapping.csv --output public/reordered_01기대 결과는 아래와 같습니다. ZIP의 expected_results/reordered/analysis.csv에서도 비교할 수 있습니다. 출력 행 순서는 재정렬된 입력을 따르지만, 각 원본 키에 붙는 대체 ID는 바뀌지 않습니다.
row_id,surrogate_id,value
R05,S002,E
R04,S003,D
R03,S001,C
R02,S002,B
R01,S001,A
여기서 유지하는 것은 키와 ID의 관계입니다. 행 순서까지 같아지는 것은 아닙니다. 두 결과를 비교할 때 파일의 첫 번째 행끼리 대조하면 R01과 R05가 섞입니다. row_id를 기준으로 같은 기록을 찾은 뒤 surrogate_id와 value를 대조해야 합니다.
새 키 C004가 추가되었을 때 이 코드는 자동으로 S004를 발급하거나 대응표를 확장하지 않습니다. 미등록 키로 거부하고 사용자가 대응 관계를 확인하게 합니다. 새 대상이 들어온 것인지, 기존 C001을 잘못 입력한 것인지 먼저 확인한 뒤 별도로 검토한 대응표를 준비해야 합니다. 오류를 통과시키려고 기존 키에 맞춰 값을 임의로 바꾸면 기록의 의미가 달라질 수 있습니다.
원본 명단이 달라져도 계속 같은 ID를 써야 하는 작업에서는, 어떤 대응표를 어느 실행에 사용했는지 남기는 것이 중요합니다. 이전 결과와 비교하려고 대응표를 재사용하면서 그 안의 S001 연결을 바꿔 버리면 안정적인 연결이 깨집니다. 이번 실습의 검증 코드는 변환 전후 원본과 대응표의 바이트가 그대로인지 확인합니다.
6. 잘못된 키와 덮어쓰기를 거부하는지 연습하기
정상 결과를 한 번 만든 뒤, 일부러 잘못된 가상 자료를 넣어 보세요. 코드가 일부 행만 내보내고 성공처럼 끝나는지, 아니면 검증을 통과할 때까지 결과 생성을 멈추는지 확인하는 단계입니다. 이 예제는 명단과 대응표를 모두 검사한 뒤에 새 결과 폴더를 만듭니다.
휴대폰에서는 표를 좌우로 움직여 모든 열을 확인하세요.
| 연습할 문제 | 왜 거부하는가 | 확인 후 복구하는 방법 |
|---|---|---|
| 명단의 original_key가 빈칸 | 어느 대응 관계를 사용할지 알 수 없음 | 가상 원본을 확인해 해당 행의 올바른 키를 채움 |
| 키 앞뒤에 공백 | 공백을 자동 제거해 잘못 연결하지 않도록 함 | 입력 내용을 확인하고 의도한 키로 수정 |
| 대응표의 original_key 중복 | 한 키에 여러 ID를 지정해 연결이 모호함 | 원본 키당 한 행만 남기고 올바른 관계를 확인 |
| 대응표의 surrogate_id 중복 | 서로 다른 키가 같은 ID로 합쳐짐 | 키마다 서로 다른 대체 ID가 되도록 검토 |
| 명단에 미등록 C004 등장 | 기존 대응표에 없는 키를 임의 발급하지 않음 | 오타인지 새 키인지 확인한 뒤 별도 대응표 준비 |
| 결과 폴더가 이미 존재 | 이전 결과를 덮어쓰지 않음 | 기존 결과를 보존하고 새로운 실행 폴더 지정 |
아래 명령은 정상 명단과 정상 대응표를 쓰지만 결과 폴더를 다시 지정합니다. 3절을 실행했다면 public/run_01이 이미 있으므로 종료 코드 2로 거부해야 합니다. analysis.csv의 기존 내용은 그대로 남아야 합니다.
python replace_ids.py --input synthetic_input/roster.csv --mapping private_mapping/id_mapping.csv --output public/run_01다른 오류는 ZIP의 실패 연습 파일로 재현할 수 있습니다. 각 명령은 새 결과 폴더를 지정하며, 검증 거부 시 그 폴더를 만들지 않습니다. 명단의 빈 키와 미등록 키, 대응표의 두 가지 중복을 하나씩 독립적으로 확인합니다.
네 가지 실패 재현 명령 보기
python replace_ids.py --input negative_cases/empty_key.csv --mapping private_mapping/id_mapping.csv --output public/rejected_empty
python replace_ids.py --input negative_cases/unknown_key.csv --mapping private_mapping/id_mapping.csv --output public/rejected_unknown
python replace_ids.py --input synthetic_input/roster.csv --mapping negative_cases/duplicate_original_mapping.csv --output public/rejected_duplicate_key
python replace_ids.py --input synthetic_input/roster.csv --mapping negative_cases/duplicate_surrogate_mapping.csv --output public/rejected_duplicate_id
오류 메시지의 핵심은 차례로 빈 값 또는 양끝 공백 포함 original_key, 미등록 original_key, 중복 original_key, 중복 surrogate_id입니다. 오류가 난 행과 열의 문제를 알려 주되, 원본 키의 실제 값이나 이름을 오류 메시지에 넣지는 않습니다.
빈 키를 0이나 임의의 공통 ID로 채워 통과시키지 마세요. 서로 관계없는 행이 같은 대상을 가리키게 될 수 있습니다. 중복 대응표도 첫 번째 행이나 마지막 행을 자동 채택하지 않습니다. 원본 키와 ID 중 어느 값이 맞는지 확인한 뒤 가상 연습 파일의 복사본에서 수정해야 합니다.
입력 열의 이름·순서가 다르거나 열 수가 맞지 않으면 거부합니다. 명단의 row_id도 빈 값이나 중복을 허용하지 않습니다. 원본 키는 여러 기록에서 반복될 수 있지만, 행 번호는 결과의 각 기록을 구별해야 하기 때문입니다. 빈 명단이나 빈 대응표도 성공한 0행 결과로 처리하지 않습니다.
실패 메시지를 확인한 뒤 정상 자료와 public/recovered_01 같은 새 폴더로 다시 실행해 보세요. 검증 단계에서 실패했다면 입력과 대응표는 수정되지 않으며, 실패용 결과도 생기지 않습니다. 쓰기 중 예상 가능한 예외가 발생하면 이번 실행이 새로 만든 결과 파일·폴더만 정리하도록 되어 있습니다. 다만 강제 종료, 디스크 장애 등 모든 상황에서 완전한 복구를 보장하는 장치는 아니므로, 재실행 전에 결과 위치를 확인하세요.
7. 검증 코드와 전체 Python 소스 읽기
정상 변환과 거부 동작을 함께 확인하려면 아래 명령을 실행합니다. 테스트는 임시 폴더에 가상 파일을 만들고, 기대 결과와 실제 결과를 비교합니다. 본문에서 만든 public/run_01을 테스트가 덮어쓰는 방식은 아닙니다.
python -m unittest discover -s tests -vCPython 3.12.14에서 자동 테스트 17개가 통과했습니다. 테스트는 5행의 정확한 변환, 동일 명단 재실행, 입력 역순 재사용, 빈 키, 미등록 키, 대응표 중복, 열 구조 오류, 기존 출력 보존, 실패 후 정상 재실행 등을 점검합니다. 이 검증은 동봉한 코드와 가상 자료의 기대 동작을 확인하는 것이며, 실제 정보의 익명성이나 접근 권한을 검증하는 테스트는 아닙니다.
CSV는 split(',')로 나누지 않고 표준 csv 모듈로 읽고 씁니다. 파일을 열 때 newline=''을 지정하는 기준은 Python 3.12 csv 공식 문서에 따릅니다. 인코딩도 명시해서 운영체제의 기본 문자 인코딩에 맡기지 않습니다. 입력과 출력은 utf-8-sig를 사용합니다.
파일 위치는 pathlib.Path로 다룹니다. 새 폴더를 만들 때 기존 위치를 허용하지 않는 동작은 Path.mkdir() 공식 설명에서 확인할 수 있습니다. 결과 CSV 역시 'x' 모드로 열어 기존 파일이 있으면 실패하게 합니다. open() 공식 문서는 'x'를 배타적인 새 파일 생성 모드로 설명합니다.
검사와 파일 생성을 구분한다고 해서 데이터베이스 트랜잭션이나 동시 실행 잠금이 생기는 것은 아닙니다. 이 코드는 한 번에 한 실행을 따라 하는 로컬 실습입니다. 자동 운영 환경에서 여러 작업이 같은 경로를 동시에 사용한다면 실행 격리와 장애 복구를 별도로 설계해야 합니다.
아래를 펼치면 ZIP의 replace_ids.py 전체 소스를 볼 수 있습니다. 명단과 대응표의 읽기, 검증, 결과 열 구성, 새 파일 작성, 오류 처리 순서로 읽어 보세요.
replace_ids.py 전체 소스 보기
"""합성 명단의 원키를 고정 대체 ID로 바꾼다. Python 3.10+, 외부 패키지 없음."""
import argparse
import csv
from pathlib import Path
import re
import sys

INPUT_COLUMNS = ["row_id", "original_key", "name", "value"]
MAP_COLUMNS = ["original_key", "surrogate_id"]
OUTPUT_COLUMNS = ["row_id", "surrogate_id", "value"]


def read_table(path, columns):
    """열 이름·순서와 행별 열 개수를 엄격히 검사한다."""
    with path.open("r", encoding="utf-8-sig", newline="") as handle:
        reader = csv.DictReader(handle, strict=True)
        if reader.fieldnames != columns:
            raise ValueError(f"{path.name}: 열 이름과 순서를 확인하세요.")
        rows = []
        for line, row in enumerate(reader, start=2):
            if None in row or any(value is None for value in row.values()):
                raise ValueError(f"{path.name} {line}행: 열 개수가 다릅니다.")
            rows.append(row)
    return rows


def nonempty_exact(text):
    """공백을 자동으로 없애 서로 다른 원키를 합치지 않는다."""
    return bool(text) and text == text.strip()


def load_mapping(path):
    """대응표는 읽기만 한다. 새 ID를 만들거나 기존 표를 갱신하지 않는다."""
    rows = read_table(path, MAP_COLUMNS)
    if not rows:
        raise ValueError("대응표가 비어 있습니다.")
    lookup, used_ids = {}, set()
    for line, row in enumerate(rows, start=2):
        key, sid = row["original_key"], row["surrogate_id"]
        if not nonempty_exact(key):
            raise ValueError(f"대응표 {line}행: 빈 값 또는 양끝 공백 포함 original_key입니다.")
        if not re.fullmatch(r"S[0-9]{3}", sid):
            raise ValueError(f"대응표 {line}행: surrogate_id는 S와 숫자 3자리여야 합니다.")
        if key in lookup:
            raise ValueError(f"대응표 {line}행: 중복 original_key입니다.")
        if sid in used_ids:
            raise ValueError(f"대응표 {line}행: 중복 surrogate_id입니다.")
        lookup[key] = sid
        used_ids.add(sid)
    return lookup


def convert(source, mapping, output):
    """검증이 모두 끝난 뒤 새 폴더에 analysis.csv를 한 번만 쓴다."""
    output = Path(output)
    # 깨진 심볼릭 링크도 '이미 있는 출력'으로 간주한다.
    if output.exists() or output.is_symlink():
        raise ValueError("출력 경로가 이미 있습니다. 새로운 폴더 이름을 사용하세요.")
    source = Path(source).resolve(strict=True)
    mapping = Path(mapping).resolve(strict=True)
    output = output.resolve()
    if output.is_relative_to(mapping.parent) or mapping.parent.is_relative_to(output):
        raise ValueError("대응표 폴더와 출력 폴더는 서로 포함되지 않도록 분리하세요.")
    if source.is_relative_to(output):
        raise ValueError("입력 파일을 출력 폴더 안에 두지 마세요.")
    if not output.parent.is_dir():
        raise ValueError("출력의 상위 폴더를 먼저 만드세요.")

    lookup = load_mapping(mapping)
    rows = read_table(source, INPUT_COLUMNS)
    if not rows:
        raise ValueError("입력 명단이 비어 있습니다.")
    public_rows, seen_rows = [], set()
    for line, row in enumerate(rows, start=2):
        row_id, key = row["row_id"], row["original_key"]
        if not nonempty_exact(row_id) or row_id in seen_rows:
            raise ValueError(f"입력 {line}행: row_id가 비었거나 중복되었거나 공백이 있습니다.")
        if not nonempty_exact(key):
            raise ValueError(f"입력 {line}행: 빈 값 또는 양끝 공백 포함 original_key입니다.")
        if key not in lookup:
            raise ValueError(f"입력 {line}행: 대응표에 미등록 original_key입니다.")
        seen_rows.add(row_id)
        # 이름·원키·기타 열을 통째로 복사하지 않고 허용한 3개 열만 만든다.
        public_rows.append({"row_id": row_id, "surrogate_id": lookup[key],
                            "value": row["value"]})

    # exist_ok=False와 'x' 모드: 기존 디렉터리나 파일을 덮어쓰지 않는다.
    output.mkdir(exist_ok=False)
    result, created_file = output / "analysis.csv", False
    try:
        with result.open("x", encoding="utf-8-sig", newline="") as handle:
            created_file = True
            writer = csv.DictWriter(handle, fieldnames=OUTPUT_COLUMNS)
            writer.writeheader()
            writer.writerows(public_rows)
    except BaseException:
        # 이번 실행에서 만든 불완전한 파일만 정리한다.
        if created_file:
            result.unlink(missing_ok=True)
        try:
            output.rmdir()
        except OSError:
            pass  # 다른 파일이 생겼다면 그 파일은 삭제하지 않는다.
        raise
    return result


def main():
    parser = argparse.ArgumentParser(description="합성 명단에 고정 대체 ID를 적용합니다.")
    parser.add_argument("--input", required=True, type=Path, help="합성 입력 CSV")
    parser.add_argument("--mapping", required=True, type=Path, help="분리 보관한 고정 대응표 CSV")
    parser.add_argument("--output", required=True, type=Path, help="아직 없는 새 출력 폴더")
    args = parser.parse_args()
    try:
        result = convert(args.input, args.mapping, args.output)
        count = len(read_table(result, OUTPUT_COLUMNS))
    except (ValueError, OSError, UnicodeError, csv.Error) as error:
        print(f"실패: {error}", file=sys.stderr)
        return 2
    print(f"완료: {count}행 → {result}")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
8. 파일 분리의 의미와 실습 마무리
실습을 마치면 명단에는 원본 키와 가상 이름이 있고, 대응표에는 원본 키와 대체 ID의 연결이 있으며, 분석 결과에는 행 번호·대체 ID·값만 있습니다. 변환에 필요한 관계를 대응표로 모으고 결과 열을 명시적으로 줄였다는 점을 확인하면 됩니다.
대응표가 있으면 S001이 C001에 연결된다는 사실을 조회할 수 있습니다. 대체 ID를 적용할 때 해시 함수를 사용하지 않으며, 원본과의 관계를 되돌릴 수 없게 만드는 설계도 아닙니다. 순차 ID를 사용했으므로 번호 자체에 무작위성이나 추측 방지 효과가 있다고 설명할 수 없습니다.
대응표를 결과 폴더에 넣지 않았어도 같은 상위 폴더를 통째로 공유하면 원본과 대응표까지 함께 전달할 수 있습니다. 백업, 동기화, 공유 링크와 첨부 범위를 확인하는 과정도 파일명과 폴더명만으로 대신할 수 없습니다. 이번 ZIP에는 학습용 가상 자료를 모두 넣었지만, 실제 자료를 공유할 때 같은 구성을 그대로 사용해서는 안 됩니다.
마지막으로 세 가지를 직접 설명할 수 있는지 확인하세요. 첫째, 같은 가상 이름을 가진 C001과 C002가 왜 다른 ID를 받는지. 둘째, 입력이 역순이 되어도 C001의 ID가 왜 S001로 남는지. 셋째, 결과에 이름이 없어도 왜 안전한 공개 자료라고 단정할 수 없는지입니다.
이 세 질문에 답하고 정상·재정렬·실패 결과를 모두 대조했다면, 이번 실습의 핵심인 원본 키 기준의 대체 ID 적용과 고정 대응표 재사용을 확인한 것입니다. 실제 작업으로 확장하기 전에는 대상의 식별 기준, 남길 열, 대응표 보관 위치, 공개 범위를 그 작업에 맞게 따로 검토하세요.
공식 참고 문서: csv의 읽기·쓰기와 newline 처리, pathlib의 파일 경로 처리, open()의 파일 생성 모드. 문서 확인일은 2026년 10월 11일입니다.
작성자 소개
