검증 오류 3건과 영향 원본 2행을 Python으로 따로 세기
검증 결과 CSV에 오류가 3줄 있으면 잘못된 원본도 3행일까요? 한 행의 날짜와 금액이 함께 틀렸다면 오류 두 건이 같은 원본을 가리킵니다. 이번 실습은 원본 3행·오류 3건·영향받은 원본 2행을 따로 계산하고, 여러 파일에서 같은 R1이 반복되어도 섞이지 않게 집계합니다.
이 글의 입력은 직접 만든 합성 자료입니다. 오류를 새로 검사하는 프로그램이 아니라, 이미 나온 검증 내역을 원본 목록과 대조하는 후처리입니다. 수량·날짜·금액의 실제 검사는 각 검증기에서 수행하고, 여기에서는 그 결과의 집계 단위를 확인합니다.
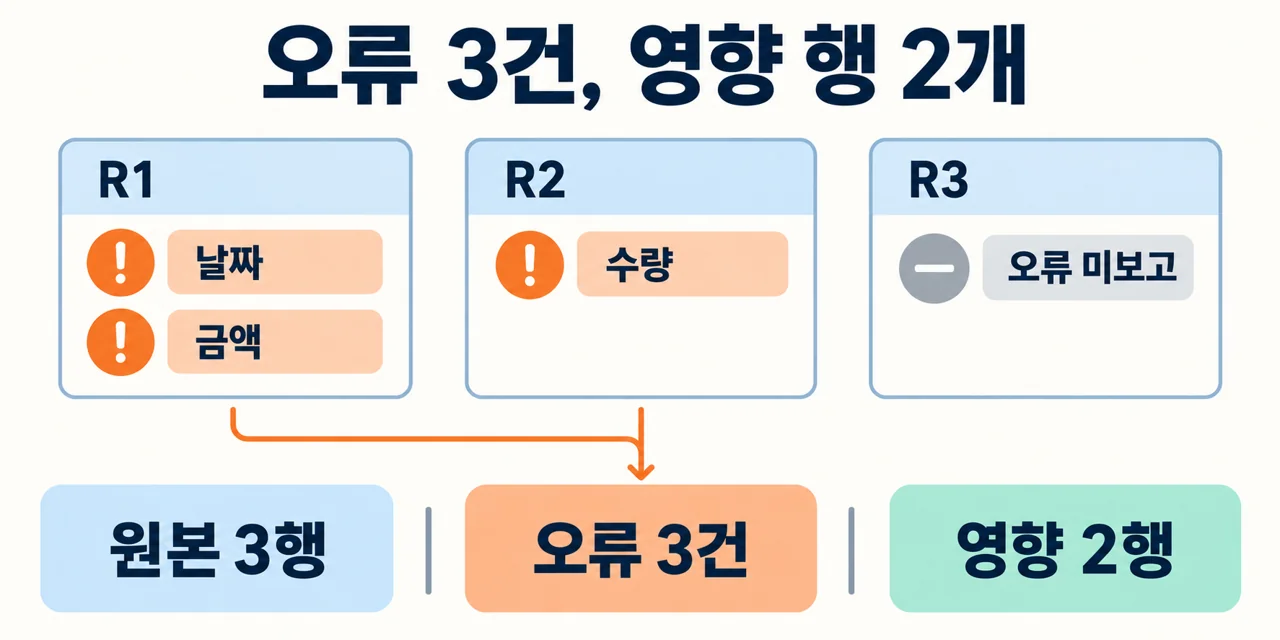
1. 분모가 될 원본 목록부터 고정합니다
첨부의 fixtures/population.csv에는 헤더를 제외하고 세 행이 있습니다. source_file은 코드를 통해 열 파일 경로가 아니라 원본 묶음의 식별 문자열입니다. 실제 원본 파일은 이 프로그램이 열지 않습니다.
source_file,row_id
a.csv,R1
a.csv,R2
a.csv,R3
fixtures/errors.csv에는 오류가 발견될 때마다 한 줄을 적습니다. R1은 날짜와 금액 두 규칙에 걸렸으므로 두 줄입니다.
source_file,row_id,rule
a.csv,R1,DATE
a.csv,R1,AMOUNT
a.csv,R2,QTY| 지표 | 세는 대상 | 기대값 |
|---|---|---|
| 원본 행 수 | population의 고유 source_file·row_id 쌍 | 3 |
| 오류 건수 | errors의 source_file·row_id·rule 조합 | 3 |
| 영향 행 수 | 오류가 하나 이상 보고된 원본 키 | 2 |
| 오류 미보고 행 수 | 원본에서 영향 행을 뺀 나머지 | 1 |
영향 비율의 분자는 2, 분모는 3이므로 약 66.7%입니다. 오류 건수 3을 분모 3으로 나눈 100%는 다른 지표입니다. 규칙이 더 많아지면 한 행에 여러 오류가 붙어 오류 건수가 원본 행 수보다 커질 수도 있습니다. 그래서 errors_by_rule의 합계를 영향 행 수와 같게 만들지 않습니다.
2. 같은 R1도 원본 파일이 다르면 다른 행입니다
두 번째 입력인 multifile_population.csv에는 a.csv/R1, b.csv/R1, b.csv/R2가 있습니다. multifile_errors.csv에는 a.csv/R1의 DATE, b.csv/R1의 DATE와 QTY가 들어 있습니다. 정답은 다시 오류 3건·영향 2행입니다.
row_id만 set에 넣으면 두 R1이 합쳐져 영향 1행으로 잘못 줄어듭니다. 코드는 (source_file, row_id) 튜플을 키로 씁니다. 같은 파일명이 다른 폴더나 보고 기간에도 반복된다면 source_file에 폴더 상대경로나 배치 식별자를 포함하는 등 먼저 고유한 기준을 정하세요. 파일 이름 두 개가 같다는 이유로 같은 원본으로 간주하면 안 됩니다.
rule 역시 같은 문자열이 같은 검사 기준을 뜻해야 합니다. 서로 다른 검증기의 CHECK1이 다른 규칙이라면 검사기 이름을 붙여 구별하세요. 같은 원본·행·규칙의 오류가 두 번 들어오면 이 실습은 DUPLICATE_ERROR로 중단합니다. 반복 실행 결과를 두 번 합친 것인지 독립된 검사 사건인지 확인하지 않고 자동 삭제하지 않습니다.
3. 전체 코드를 저장하고 실행합니다
아래 코드와 ZIP의 summarize.py는 같습니다. Python 3.12 표준 라이브러리만 사용하며 별도 패키지를 설치하지 않습니다. CSV는 UTF-8 또는 UTF-8 BOM, 헤더 이름과 순서가 예제와 같아야 합니다. 빈 식별자와 앞뒤 공백은 거부하며 대소문자나 유니코드 표기를 임의로 바꾸지 않습니다.
"""Count reported validation findings, never infer that unreported rows passed."""
import argparse
import csv
import hashlib
import io
import json
import platform
import sys
from collections import Counter
from pathlib import Path


def summarize(population, errors):
    def validate(rows, width):
        for row in rows:
            if len(row) != width:
                raise ValueError('BAD_ROW: wrong field count')
            if any(not value or value != value.strip() for value in row):
                raise ValueError('BAD_VALUE: empty or surrounding whitespace')
    validate(population, 2)
    validate(errors, 3)
    keys = [tuple(row) for row in population]
    if len(keys) != len(set(keys)):
        raise ValueError('DUPLICATE_SOURCE: repeated source_file,row_id')
    findings = [tuple(row) for row in errors]
    if len(findings) != len(set(findings)):
        raise ValueError('DUPLICATE_ERROR: repeated source_file,row_id,rule')
    universe = set(keys)
    affected = {item[:2] for item in findings}
    if not affected <= universe:
        raise ValueError('UNKNOWN_ROW: error refers outside population')
    by_rule = Counter(item[2] for item in findings)
    return {
        'counts': {'source_rows': len(keys), 'error_events': len(findings),
                   'affected_rows': len(affected),
                   'rows_without_reported_error': len(universe - affected)},
        'affected_rate': len(affected) / len(keys) if keys else None,
        'affected_keys': [list(key) for key in sorted(affected)],
        'without_reported_error_keys': [list(key) for key in sorted(universe - affected)],
        'errors_by_rule': dict(sorted(by_rule.items())),
        'coverage': 'NOT_PROVEN_BY_ERROR_LIST',
    }


def load(path, header):
    raw = Path(path).read_bytes()
    if len(raw) > 1_000_000:
        raise ValueError('INPUT_LIMIT: maximum 1,000,000 bytes per input')
    rows = list(csv.reader(io.StringIO(raw.decode('utf-8-sig'), newline=''), strict=True))
    if not rows or rows[0] != header:
        raise ValueError('BAD_HEADER: expected ' + ','.join(header))
    if len(rows) > 10001:
        raise ValueError('INPUT_LIMIT: maximum 10,000 data records')
    return rows[1:], hashlib.sha256(raw).hexdigest()


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('population')
    parser.add_argument('errors')
    parser.add_argument('new_report')
    args = parser.parse_args()
    try:
        population, population_sha = load(args.population, ['source_file','row_id'])
        errors, errors_sha = load(args.errors, ['source_file','row_id','rule'])
        result = summarize(population, errors)
        result['input_sha256'] = {'population': population_sha, 'errors': errors_sha}
        result['python'] = platform.python_version()
        # Exclusive creation preserves any existing report, including a symlink.
        with Path(args.new_report).open('x', encoding='utf-8') as out:
            json.dump(result, out, ensure_ascii=False, indent=2)
            out.write('\n')
        print(json.dumps(result['counts'], ensure_ascii=False))
        return 1 if result['counts']['affected_rows'] else 0
    except (OSError, ValueError, UnicodeError, csv.Error) as error:
        print('REPORT_FAILED: ' + str(error), file=sys.stderr)
        return 2


if __name__ == '__main__':
    sys.exit(main())
Python의 Counter 문서는 항목별 빈도를 세는 도구를 설명합니다. 여기서는 규칙별 오류 건수에 Counter를 쓰고, 영향 행 수에는 복합키의 집합을 사용합니다. csv 문서의 reader로 레코드를 읽으므로 따옴표 안 줄바꿈이 있는 파일에서 텍스트 줄 수를 원본 행 수로 세지 않습니다.
- ZIP을 새 연습 폴더에 풀고 README.txt와 fixtures를 확인합니다.
- 터미널에서 압축을 푼 폴더로 이동합니다.
- 다음 명령을 실행합니다. report-normal.json은 아직 없는 새 파일명이어야 합니다.
python3 summarize.py fixtures/population.csv fixtures/errors.csv report-normal.json출력은 source_rows 3, error_events 3, affected_rows 2, rows_without_reported_error 1입니다. JSON의 affected_keys는 a.csv/R1과 a.csv/R2이며 expected/normal_counts.json과 숫자를 대조합니다. 이 실행의 종료코드는 1입니다. 프로그램이 고장 나서 보고서가 없는 상태가 아니라, 완성된 보고서에 오류가 보고된 행이 있다는 뜻입니다.
| 종료코드 | 뜻 | 다음 확인 |
|---|---|---|
| 0 | 보고서 완료, 보고된 오류 없음 | 검사 범위·실행 완료 여부 별도 확인 |
| 1 | 보고서 완료, 오류가 보고된 행 있음 | affected_keys와 규칙별 내역 검토 |
| 2 | 입력·구조·경로·저장 오류 | 보고서를 완료 결과로 사용하지 않음 |
4. 오류가 없다는 목록과 검사 통과를 구별합니다
python3 summarize.py fixtures/population.csv fixtures/no_errors.csv report-no-errors.json헤더만 있는 오류 CSV에서는 영향 0행, 오류 미보고 3행, 종료 0입니다. 하지만 날짜 검사기가 아예 실행되지 않아도 이런 목록이 나올 수 있습니다. 그래서 JSON은 항상 coverage를 NOT_PROVEN_BY_ERROR_LIST로 표시합니다. 이 파일만으로 세 행이 정상이라고 결론 내리지 않습니다.
전체 검사를 완료했다고 보고하려면 원본 버전과 해시, 적용할 규칙 목록, 규칙별 실행 완료 기록, 검사 대상 범위를 별도로 대조해야 합니다. 이 예제에는 그 실행 증거가 없으므로 rows_without_reported_error를 passed_rows로 바꾸지 않았습니다. 원본 목록도 비어 있다면 affected_rate는 0%가 아니라 null입니다. 분모가 없는 비율을 정상률처럼 표시하지 않기 위해서입니다.
5. 중복·모집단 밖 오류를 직접 재현합니다
python3 summarize.py fixtures/population.csv fixtures/duplicate_errors.csv report-duplicate.json
python3 summarize.py fixtures/population.csv fixtures/unknown_errors.csv report-unknown.json
python3 summarize.py fixtures/multifile_population.csv fixtures/multifile_errors.csv report-multi.json
첫 명령은 같은 a.csv/R1/DATE가 두 번이라 DUPLICATE_ERROR, 둘째는 원본 목록에 없는 R9를 가리켜 UNKNOWN_ROW로 중단합니다. 두 경우 종료 2이며 새 보고서는 생성되지 않습니다. 셋째는 두 파일의 R1을 분리해 오류 3건·영향 2행으로 보고하고 종료 1입니다.
- DUPLICATE_SOURCE: 원본 키 정의가 충분한지, 원본 목록이 중복 합쳐졌는지 확인합니다.
- DUPLICATE_ERROR: 같은 검사 결과 파일을 중복 수집했는지 확인합니다. 필요한 경우 사본에서 근거를 남기고 정리합니다.
- UNKNOWN_ROW: 검증 결과와 모집단의 파일·배치·버전이 같은지 확인합니다. 원본에 오류 행을 임의 추가해 통과시키지 않습니다.
- BAD_HEADER·BAD_ROW·BAD_VALUE: 열 이름·개수, 누락된 식별자, 앞뒤 공백을 원자료와 대조합니다.
- File exists: 이전 보고서를 보존하고 report-normal-2.json처럼 새 파일명을 씁니다.
6. 확인한 결과와 남아 있는 한계
Linux CPython 3.12.14에서 단위 검사 12개와 CLI 실행 9개를 수행했습니다. 정상 집계, 다중 파일 키, 중복 원본·오류, 모집단 밖 참조, 빈 모집단, 오류 0건, 필드 수·공백, 순서 변경, 한 행의 오류 세 건을 검산했습니다. CLI에서는 기존 출력 보존, UTF-8 오류와 잘못된 따옴표 구문도 확인했습니다. 시험 전후 원본 fixture의 SHA-256은 같았습니다.
python3 test_summary.py첨부의 python3 test_cli.py로 CLI 반례 16개도 다시 실행할 수 있습니다. 기존 검사와 겹치는 사례를 포함한 별도 재실행 묶음이며 새 임시 폴더에서만 출력하고 원본·기대값·제공 로그를 덮어쓰지 않습니다.
실제 기록은 logs/unittest.txt와 logs/cli_actual.json에 있습니다. 입력 하나당 1,000,000바이트와 10,000레코드라는 수용 한도가 있지만 파일은 먼저 메모리로 읽으므로 대용량 메모리 제한 장치가 아닙니다. 동시에 다른 프로그램이 입력을 바꾸는 상황, Windows·macOS 실행, 저장 장치 장애는 검증하지 않았습니다. 쓰기 도중 실패하면 일부 새 JSON이 남을 수 있으므로 종료 2의 파일을 완료 보고서로 쓰지 마세요.
검증 내역을 만들기 전 금액 자체를 확인하려면 CSV 행별 수량×단가 검산을, 일반 합계·평균과 행 수의 차이는 pandas groupby 집계를 참고하세요. 이 글의 완료 기준은 오류 내역과 원본 목록의 관계를 검증하고, 사건 수와 원본 행 수를 다른 이름으로 보고하는 것입니다.
작성·검증 기준일: 2026년 10월 8일 KST. 실제 업무 자료나 고객 데이터는 사용하지 않았습니다.
작성자 소개
