여러 줄 오류 로그를 한 사건으로 묶어 CSV에 기록하기
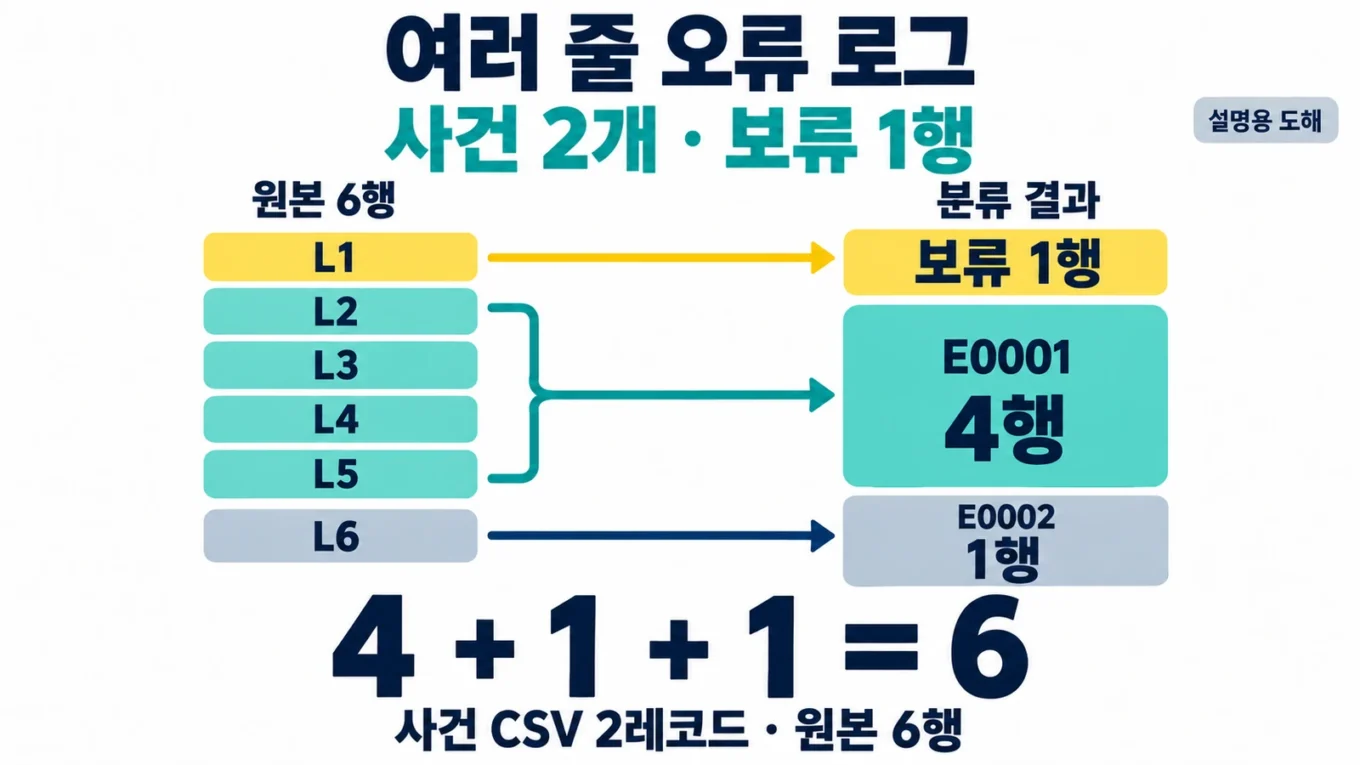
오류 로그를 한 줄씩 CSV로 옮기면 오류 한 건에 딸린 스택 세 줄이 서로 다른 사건처럼 보일 수 있습니다. 사건의 시작 형식과 이어 붙일 수 있는 줄의 형식을 먼저 정하세요. 이 실습은 시작 줄 뒤의 허용한 스택만 같은 사건에 묶고, 미식별 줄은 따로 보류한 다음 입력의 모든 물리행이 빠짐없이 대응되는지 확인합니다.
입력은 가상 애플리케이션 로그입니다. 사건 두 개를 묶는 작업과 장애 원인 판단은 별도입니다. OK-00 ready도 서비스 정상 여부를 입증하지 않으며, 코드의 뜻과 원인은 이 파일에서 추정하지 않습니다.
먼저 사건의 경계를 정합니다
이 글에서 물리행은 입력 파일의 LF 또는 CRLF로 구분한 한 줄입니다. 마지막 줄에 줄바꿈이 없어도 한 행으로 셉니다. 파일 끝의 줄바꿈 한 개를 빈 행으로 추가하지 않지만, 실제로 연속한 줄바꿈 사이의 빈 줄은 보류할 한 행입니다.
사건 시작 줄은 YYYY-MM-DDTHH:MM:SSZ 코드 메시지 형식입니다. 날짜와 시각의 숫자는 정해진 자릿수를 지켜야 하며 코드에는 ERR- 또는 OK- 다음 숫자 두 자리만 허용합니다. 세 항목 사이에는 공백 한 개가 있고 메시지는 한 글자 이상입니다. Z가 적힌 시작 줄만 받아들이고, 실제 날짜와 시각도 검사합니다.
연속행은 다음 두 형식만 허용합니다.
- 공백 또는 탭 하나 이상 뒤에
at 메서드(파일:행번호)가 오는 줄. 메서드는 영문자 또는 밑줄로 시작하며 영문자·숫자·밑줄·점만 허용합니다. 파일 이름에는 영문자·숫자·밑줄·점·하이픈, 행번호에는 숫자를 허용합니다 Caused by: 예외이름: 설명형식의 줄. 예외이름의 문자 규칙은 위 메서드와 같고 설명은 한 글자 이상입니다
이 형식은 실습에서 정한 좁은 계약입니다. 모든 Java 로그나 Python traceback에 공통으로 적용되는 규칙이 아닙니다. 실제 로그 형식의 문서와 대조해 시작·연속행 규칙을 바꾸고 반례를 다시 시험해야 합니다.
허용 연속행이어도 앞에 유효한 시작 사건이 없으면 ORPHAN_CONTINUATION으로 보류합니다. 잘못된 시각, 허용하지 않은 줄, 빈 줄이 나오면 현재 사건 연결을 끊습니다. 그 뒤의 스택을 이전 사건에 건너뛰어 붙이지 않습니다. 다음 유효한 시작 줄이 나올 때 다시 사건을 만듭니다. 시각 없는 스택에는 앞 사건의 시각을 새 발생 시각으로 채우지 않습니다. 연결된 사건 ID만 남깁니다.
정규식은 줄 전체가 맞는지 검사합니다. 일부 문자열만 우연히 맞는 것을 시작 줄로 받아들이지 않도록 fullmatch()를 사용합니다. Python 3.12 re 전체 일치 문서를 참고하세요. 날짜의 유효성은 datetime.strptime 문서에 따라 검사합니다. 코드의 Z는 고정 문법 검사 대상이며 별도의 시간대 변환이나 관측 시각 생성은 하지 않습니다.
가상 입력 6행을 준비합니다
실습 ZIP 다운로드에는 전체 코드, 아래 입력, 실패용 입력, 기대 CSV, 실행 기록과 README가 들어 있습니다. ZIP을 새 연습 폴더에 풀고 P22-reader 폴더에서 실행하세요. 운영 중인 로그가 계속 바뀌는 폴더에서 시작하지 않습니다.
fixtures/normal.log는 다음 내용입니다. 들여쓰기 네 칸과 파일 마지막 줄바꿈도 함께 들어 있습니다. 아래 블록의 맨 앞 줄은 사건 시작 형식이 없는 고아줄입니다.
orphan before first event
2026-10-05T09:15:00Z ERR-14 import failed
    at demo.Parser.read(Parser.java:12)
    at demo.Worker.run(Worker.java:44)
Caused by: ValueError: invalid count
2026-10-05T09:16:00Z OK-00 ready
행 번호를 파일 내용에 추가하지 마세요. 실제 대응은 다음과 같습니다.
- L1:
UNRECOGNIZED_LINE으로 보류합니다 - L2: E0001의 시작 줄입니다
- L3, L4, L5: 허용 연속행으로 E0001에 연결합니다
- L6: E0002의 시작 줄입니다
따라서 E0001은 4개 물리행, E0002는 1개 물리행이고 별도 보류는 1행입니다. 4 + 1 + 1 = 6이 입력 전체와 맞아야 합니다. 사건 수 2와 사건이 차지한 물리행 수 5를 같은 숫자로 취급하지 않습니다.
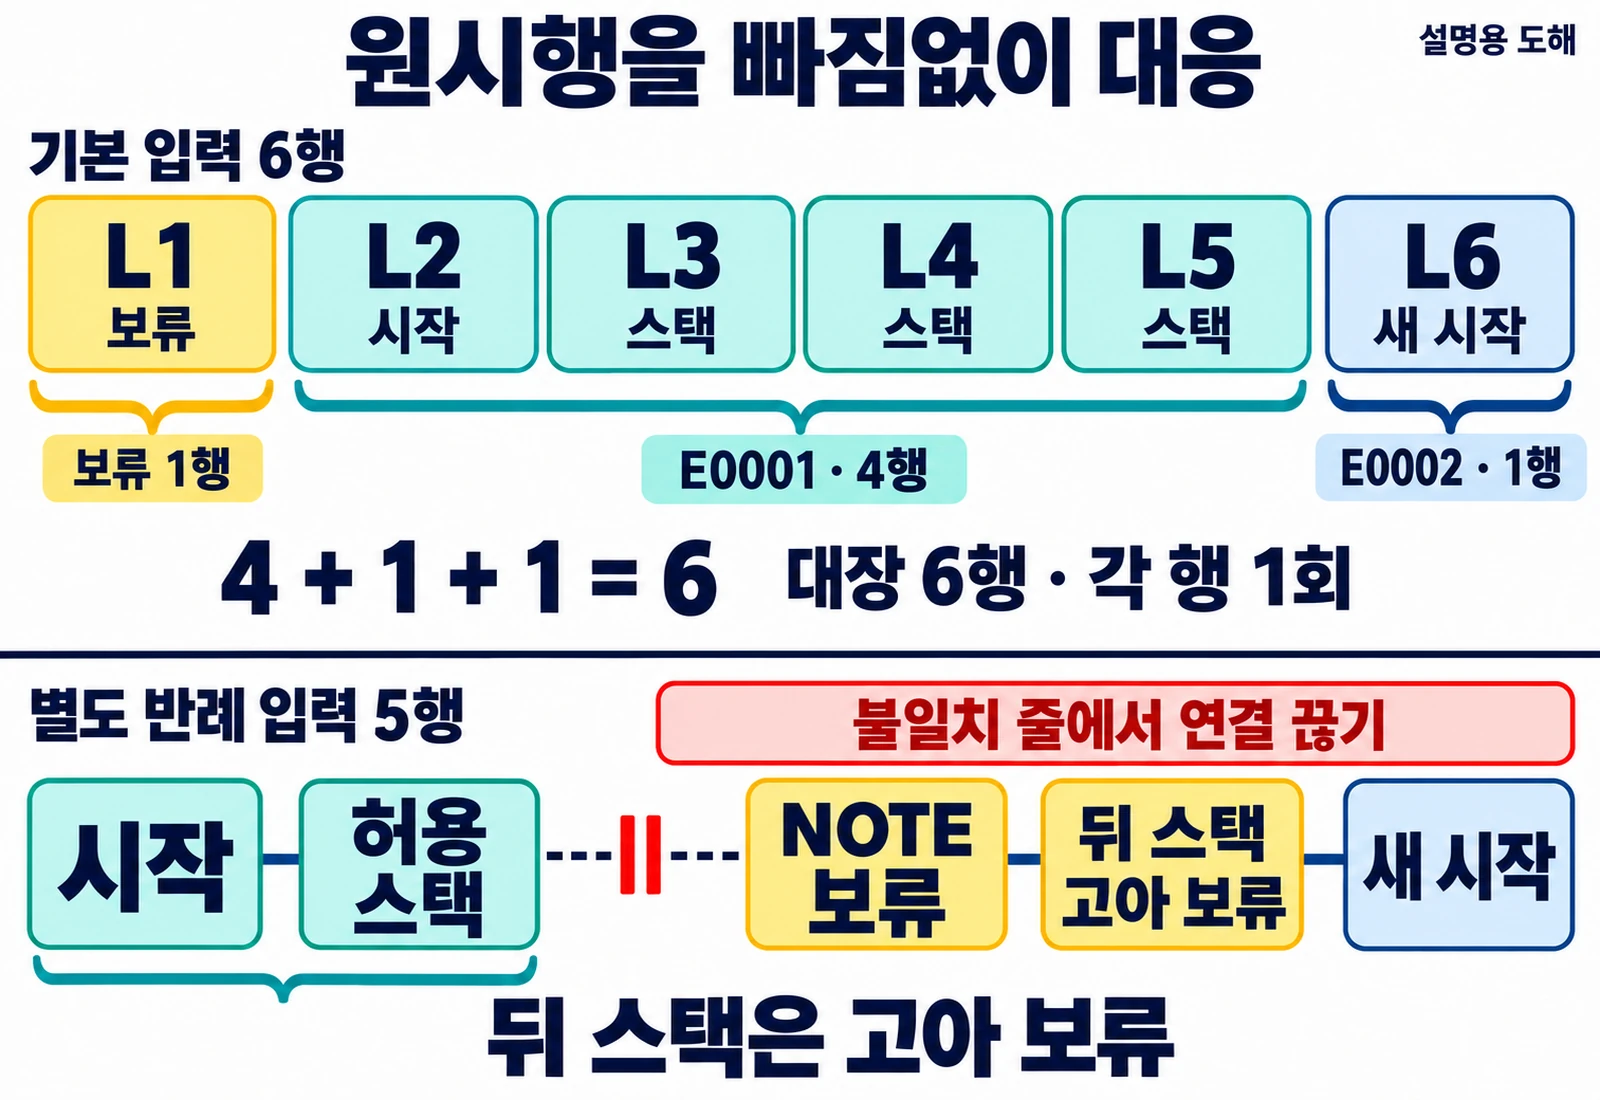
본문 도해: 사건 표와 보류표의 합이 원본 6행을 모두 덮으며, 보류행 뒤의 스택은 앞 사건에 건너뛰어 붙지 않습니다.
전체 코드로 새 출력 폴더에 저장합니다
다음 전체 코드를 group_logs.py로 저장합니다. 다운로드에 든 파일도 동일합니다. Python 표준 라이브러리만 사용하며 별도 패키지를 설치하지 않습니다.
입력은 최대 1,000,000바이트, 10,000행, 행별 본문 20,000바이트로 제한합니다. 각 읽기는 제한값보다 한 바이트 더 읽어 초과를 검출합니다. Python io의 read 문서를 참고하세요. 입력은 BOM 없는 UTF-8이고 LF·CRLF와 마지막 줄의 줄바꿈 생략을 지원합니다. 단독 CR과 탭을 제외한 U+0000~U+001F 제어문자는 중단 사유입니다. DEL(U+007F)과 C1 영역(U+0080~U+009F)은 이 검사에서 거부하지 않으며 원문으로 보존합니다.
출력은 입력 파일이 들어 있는 폴더와 그 하위 트리 밖의 새 폴더만 허용합니다. 부모 폴더는 이미 있어야 하며 새 폴더를 자동으로 중첩 생성하지 않습니다. 기존 폴더나 파일을 덮어쓰지 않습니다. Path.mkdir 문서의 exist_ok=False와 open 문서의 x 모드를 사용합니다. 입력을 수정·삭제·이동하는 코드는 없습니다.
"""Group a small, offline UTF-8 log using an explicit fictional grammar."""
import argparse
from collections import Counter
import csv
from datetime import datetime
import hashlib
import io
import json
import os
from pathlib import Path
import re
import sys

MAX_BYTES = 1_000_000
MAX_LINES = 10_000
MAX_LINE_BYTES = 20_000
MAX_OUTPUT_BYTES = 8_000_000
START = re.compile(
    r'(?P<stamp>[0-9]{4}-[0-9]{2}-[0-9]{2}T[0-9]{2}:[0-9]{2}:[0-9]{2}Z) '
    r'(?P<code>(?:ERR|OK)-[0-9]{2}) (?P<message>.+)')
CONTINUATION = re.compile(
    r'(?:[ \t]+at [A-Za-z_][A-Za-z0-9_.]*\([A-Za-z0-9_.-]+:[0-9]+\)'
    r'|Caused by: [A-Za-z_][A-Za-z0-9_.]*: .+)')
EVENT_FIELDS = ['event_id', 'timestamp_original', 'code', 'header_message_json',
                'source_start', 'source_end', 'raw_line_count',
                'source_lines_json', 'raw_text']
HELD_FIELDS = ['line_no', 'reason', 'raw_line_json', 'line_ending']
LEDGER_FIELDS = ['line_no', 'status', 'event_id', 'raw_line_json', 'line_ending']
ENDINGS = {'LF': '\n', 'CRLF': '\r\n', 'NONE': ''}


def bounded_bytes(path, limit):
    with path.open('rb') as handle:
        raw = handle.read(limit + 1)
    if len(raw) > limit:
        raise ValueError('File exceeds the practice size limit.')
    return raw


def load_lines(source):
    if source.is_symlink() or not source.is_file():
        raise ValueError('Input must be a regular file, not a final symlink.')
    raw = bounded_bytes(source, MAX_BYTES)
    if not raw:
        raise ValueError('Empty input is not a successful grouping.')
    if raw.startswith(b'\xef\xbb\xbf'):
        raise ValueError('Use UTF-8 without BOM for this input contract.')
    text = raw.decode('utf-8', errors='strict')
    pieces = text.split('\n')
    if pieces[-1] == '':
        pieces.pop()
    if len(pieces) > MAX_LINES:
        raise ValueError('Input exceeds the practice line limit.')
    lines = []
    for index, piece in enumerate(pieces):
        has_lf = index < len(pieces) - 1 or text.endswith('\n')
        ending = 'LF' if has_lf else 'NONE'
        if has_lf and piece.endswith('\r'):
            piece, ending = piece[:-1], 'CRLF'
        if '\r' in piece or any(ord(c) < 32 and c != '\t' for c in piece):
            raise ValueError(f'Unsupported control character at line {index + 1}.')
        if len(piece.encode('utf-8')) > MAX_LINE_BYTES:
            raise ValueError(f'Line {index + 1} exceeds the line byte limit.')
        lines.append({'line_no': index + 1, 'text': piece,
                      'line_ending': ending, 'raw': piece + ENDINGS[ending]})
    return raw, lines


def analyze(lines):
    events, held, ledger = [], [], []
    current = None
    for line in lines:
        number, text = line['line_no'], line['text']
        match = START.fullmatch(text)
        reason = ''
        if match:
            try:
                datetime.strptime(match['stamp'], '%Y-%m-%dT%H:%M:%SZ')
            except ValueError:
                reason = 'INVALID_TIMESTAMP'
            else:
                current = {
                    'event_id': f'E{len(events) + 1:04d}',
                    'timestamp_original': match['stamp'], 'code': match['code'],
                    'header_message_json': json.dumps(match['message'], ensure_ascii=False),
                    'source_start': number, 'source_end': number,
                    'raw_line_count': 1, 'source_lines_json': json.dumps([number]),
                    'raw_text': line['raw'],
                }
                events.append(current)
                status = 'EVENT_START'
        elif CONTINUATION.fullmatch(text):
            if current is None:
                reason = 'ORPHAN_CONTINUATION'
            else:
                current['source_end'] = number
                current['raw_line_count'] += 1
                numbers = json.loads(current['source_lines_json']) + [number]
                current['source_lines_json'] = json.dumps(numbers)
                current['raw_text'] += line['raw']
                status = 'CONTINUATION'
        else:
            reason = 'BLANK_LINE' if text == '' else 'UNRECOGNIZED_LINE'
        if reason:
            # Any held line breaks the grouping chain. Do not bridge across it.
            current = None
            held.append({'line_no': number, 'reason': reason,
                         'raw_line_json': json.dumps(text, ensure_ascii=False),
                         'line_ending': line['line_ending']})
            status = 'HOLD'
        ledger.append({'line_no': number, 'status': status,
                       'event_id': current['event_id'] if current else '',
                       'raw_line_json': json.dumps(text, ensure_ascii=False),
                       'line_ending': line['line_ending']})
    return events, held, ledger


def verify_coverage(raw, lines, events, held, ledger):
    def require(condition, message):
        if not condition:
            raise ValueError('Coverage check: ' + message)

    expected = list(range(1, len(lines) + 1))
    require([int(r['line_no']) for r in ledger] == expected,
            'ledger lines must appear exactly once in source order.')
    reconstructed = ''
    for original, entry in zip(lines, ledger):
        text = json.loads(entry['raw_line_json'])
        require(text == original['text'] and entry['line_ending'] == original['line_ending'],
                'raw line or line ending changed.')
        reconstructed += text + ENDINGS[entry['line_ending']]
    require(reconstructed.encode('utf-8') == raw, 'raw bytes are not fully covered.')
    claims = []
    ids = set()
    for event in events:
        event_id = event['event_id']
        require(event_id not in ids, 'duplicate event ID.')
        ids.add(event_id)
        numbers = json.loads(event['source_lines_json'])
        require(isinstance(numbers, list) and numbers
                and all(type(n) is int and 1 <= n <= len(lines) for n in numbers),
                'invalid event source lines.')
        require(numbers == list(range(numbers[0], numbers[-1] + 1)),
                'an event must use consecutive physical lines.')
        require(int(event['raw_line_count']) == len(numbers)
                and int(event['source_start']) == numbers[0]
                and int(event['source_end']) == numbers[-1], 'event counts disagree.')
        require(event['raw_text'] == ''.join(lines[n - 1]['raw'] for n in numbers),
                'event raw text changed or lost a line.')
        for index, number in enumerate(numbers):
            entry = ledger[number - 1]
            require(entry['event_id'] == event_id and entry['status'] ==
                    ('EVENT_START' if index == 0 else 'CONTINUATION'),
                    'event and ledger mapping disagree.')
        claims.extend(numbers)
    for item in held:
        number = int(item['line_no'])
        require(1 <= number <= len(lines), 'held line is outside source.')
        entry = ledger[number - 1]
        require(entry['status'] == 'HOLD' and entry['event_id'] == '',
                'held line was linked to an event.')
        require(item['raw_line_json'] == entry['raw_line_json']
                and item['line_ending'] == entry['line_ending'], 'held raw line changed.')
        claims.append(number)
    require(Counter(claims) == Counter(expected),
            'event and held claims must cover every line exactly once.')


def write_csv(target, fields, rows):
    with target.open('x', encoding='utf-8-sig', newline='') as handle:
        writer = csv.DictWriter(handle, fieldnames=fields, lineterminator='\n')
        writer.writeheader()
        writer.writerows(rows)
        handle.flush()
        os.fsync(handle.fileno())


def read_csv(target, fields):
    raw = bounded_bytes(target, MAX_OUTPUT_BYTES)
    csv.field_size_limit(MAX_OUTPUT_BYTES)
    reader = csv.DictReader(io.StringIO(raw.decode('utf-8-sig'), newline=''))
    if reader.fieldnames != fields:
        raise ValueError('CSV header changed during write/readback.')
    return list(reader), raw


def run(source, out_dir):
    if source.is_symlink():
        raise ValueError('Input final symlink is not supported.')
    source = source.resolve(strict=True)
    parent = out_dir.parent.resolve(strict=True)
    target = parent / out_dir.name
    if target.resolve().is_relative_to(source.parent):
        raise ValueError('Use a NEW output folder outside input directory tree.')
    raw, lines = load_lines(source)
    events, held, ledger = analyze(lines)
    verify_coverage(raw, lines, events, held, ledger)
    target.mkdir(exist_ok=False)
    actual = []
    csv_raw = None
    for name, fields, rows in [
        ('events.csv', EVENT_FIELDS, events),
        ('held.csv', HELD_FIELDS, held),
        ('line_ledger.csv', LEDGER_FIELDS, ledger),
    ]:
        path = target / name
        write_csv(path, fields, rows)
        reread, serialized = read_csv(path, fields)
        wanted = [{key: str(value) for key, value in row.items()} for row in rows]
        if reread != wanted:
            raise ValueError('CSV readback differs from grouped data.')
        actual.append(reread)
        if name == 'events.csv':
            csv_raw = serialized
    verify_coverage(raw, lines, *actual)
    if bounded_bytes(source, MAX_BYTES) != raw:
        raise ValueError('Input changed during run; preserve partial outputs for review.')
    summary = {
        'status': 'HOLD_PRESENT' if held else 'GROUPED',
        'input_name': source.name, 'input_bytes': len(raw),
        'input_sha256': hashlib.sha256(raw).hexdigest(),
        'physical_lines': len(lines), 'events': len(events),
        'event_source_lines': sum(e['raw_line_count'] for e in events),
        'held_lines': len(held), 'ledger_rows': len(ledger),
        'covered_lines': len(lines), 'events_csv_logical_records': len(events),
        'events_csv_physical_lines': csv_raw.count(b'\n'),
    }
    with (target / 'summary.json').open('x', encoding='utf-8', newline='') as handle:
        json.dump(summary, handle, ensure_ascii=False, indent=2)
        handle.write('\n')
        handle.flush()
        os.fsync(handle.fileno())
    return summary


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--input', type=Path, default=Path('fixtures/normal.log'))
    parser.add_argument('--out-dir', type=Path, default=Path('../run_01'))
    args = parser.parse_args()
    try:
        summary = run(args.input, args.out_dir)
    except (OSError, ValueError, csv.Error) as exc:
        print(f'STOP: {type(exc).__name__}: {exc}', file=sys.stderr)
        print('Keep input and any partial output. Review the cause and choose a new output folder.',
              file=sys.stderr)
        return 1
    print(json.dumps(summary, ensure_ascii=False))
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
analyze()가 묶는 부분이고 verify_coverage()가 검산하는 부분입니다. 보류행에서 current = None으로 연결을 끊는 줄이 특히 중요합니다. 불일치 줄을 이전 사건에 모두 넣는 else 분기로 바꾸면 형식이 다른 기록까지 같은 오류의 증거처럼 보이게 됩니다.
events.csv에는 사건별 한 레코드, held.csv에는 보류한 물리행별 한 레코드, line_ledger.csv에는 입력 물리행별 한 레코드를 기록합니다. 사건의 source_lines_json, raw_line_count와 원문 raw_text를 서로 대조합니다. 보류표에는 시각이나 코드를 만들어 넣지 않습니다.
자유 문장인 시작 메시지와 개별 원시행은 header_message_json, raw_line_json에 JSON 문자열로 보관합니다. 따옴표까지 데이터의 일부이며 원문은 json.loads()로 복원합니다. json.dumps 문서를 참고하세요. 사건의 raw_text는 시작 줄부터 스택까지 원래 줄바꿈을 포함한 전체 텍스트입니다. 실제 로그를 스프레드시트로 열 때는 가져오기에서 텍스트 열로 지정하고, 수식처럼 시작하는 값과 민감 정보를 먼저 확인하세요.
실행한 다음 숫자와 원문을 다시 확인합니다
다음은 Linux에서 검증한 명령입니다. python3 --version으로 자신의 실행 버전을 먼저 확인하세요. 출력 이름이 이미 있으면 다른 새 이름을 고릅니다.
python3 --version
python3 group_logs.py --input fixtures/normal.log --out-dir ../p22_run_01
python3 inspect_result.py --input fixtures/normal.log --out-dir ../p22_run_01
python3 -m unittest -v
python3 verify_practice.py
python3 verify_package.py
첫 실행이 성공하면 ../p22_run_01에 CSV 세 개와 summary.json이 만들어집니다. 기본 입력의 요약은 다음과 같습니다.
{
  "status": "HOLD_PRESENT",
  "input_name": "normal.log",
  "input_bytes": 217,
  "input_sha256": "53fd55e8bc6d1b8b3b61a58a74869649bcd22338c6aac3e49421f0148d23f347",
  "physical_lines": 6,
  "events": 2,
  "event_source_lines": 5,
  "held_lines": 1,
  "ledger_rows": 6,
  "covered_lines": 6,
  "events_csv_logical_records": 2,
  "events_csv_physical_lines": 8
}
status=HOLD_PRESENT는 파일 생성과 검산이 끝났으며 보류행이 남았다는 뜻입니다. 로그가 정상이라는 표시로 읽지 마세요. 이 입력의 SHA-256은 원본 217바이트에서 계산한 값입니다. hashlib.sha256 문서에 설명된 바이트 해시로 같은 입력인지 비교하며, 작성자 인증이나 로그 내용의 진실성을 입증하지는 않습니다.
검산용 inspect_result.py의 전체 코드는 아래와 같습니다. CSV를 다시 파싱하고 입력 바이트를 원시행 대장으로 재구성합니다. 출력 파일을 바꾸지 않습니다.
"""Read the generated CSV files and recheck source coverage without writing."""
import argparse
import hashlib
import json
from pathlib import Path

from group_logs import (EVENT_FIELDS, HELD_FIELDS, LEDGER_FIELDS,
                        MAX_OUTPUT_BYTES, bounded_bytes, load_lines,
                        read_csv, verify_coverage)


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--input', type=Path, default=Path('fixtures/normal.log'))
    parser.add_argument('--out-dir', type=Path, default=Path('../run_01'))
    args = parser.parse_args()
    raw, lines = load_lines(args.input)
    events, event_bytes = read_csv(args.out_dir / 'events.csv', EVENT_FIELDS)
    held, _ = read_csv(args.out_dir / 'held.csv', HELD_FIELDS)
    ledger, _ = read_csv(args.out_dir / 'line_ledger.csv', LEDGER_FIELDS)
    verify_coverage(raw, lines, events, held, ledger)
    summary = json.loads(bounded_bytes(args.out_dir / 'summary.json', MAX_OUTPUT_BYTES))
    expected_summary = {
        'status': 'HOLD_PRESENT' if held else 'GROUPED',
        'input_name': args.input.resolve().name, 'input_bytes': len(raw),
        'input_sha256': hashlib.sha256(raw).hexdigest(),
        'physical_lines': len(lines), 'events': len(events),
        'event_source_lines': sum(int(e['raw_line_count']) for e in events),
        'held_lines': len(held), 'ledger_rows': len(ledger),
        'covered_lines': len(lines), 'events_csv_logical_records': len(events),
        'events_csv_physical_lines': event_bytes.count(b'\n'),
    }
    if summary != expected_summary:
        raise ValueError('Output summary does not match input and CSV counts.')
    print(json.dumps({
        'input_physical_lines': len(lines),
        'event_records': len(events),
        'event_source_lines': sum(int(e['raw_line_count']) for e in events),
        'held_lines': len(held), 'ledger_rows': len(ledger),
        'events_csv_physical_lines': event_bytes.count(b'\n'),
        'byte_coverage': 'PASS',
    }, ensure_ascii=False))


if __name__ == '__main__':
    main()
검산 명령의 정상 출력은 다음과 같습니다.
{"input_physical_lines": 6, "event_records": 2, "event_source_lines": 5, "held_lines": 1, "ledger_rows": 6, "events_csv_physical_lines": 8, "byte_coverage": "PASS"}
event_records=2, event_source_lines=5, held_lines=1, ledger_rows=6을 확인하세요. 사건이 선언한 원시행 번호와 보류행 번호를 합쳐 각 번호 1부터 6까지 정확히 한 번 나타나는지 검사합니다. 대장의 JSON 원문과 LF·CRLF·NONE 표시로 복원한 바이트도 입력과 같아야 합니다.
CSV 텍스트 파일의 줄 수로 사건 수를 세면 안 됩니다. raw_text 셀에 원래 줄바꿈이 들어 있으므로 기본 events.csv는 헤더까지 물리행 8개지만 데이터 레코드는 2개입니다. 이 입력은 첫 사건 셀에 LF 4개, 둘째 사건 셀에 LF 1개가 있고 헤더와 레코드 끝의 LF 3개가 더해져 4 + 1 + 3 = 8입니다. csvreader.line_num 문서도 읽은 줄 수와 반환한 레코드 수를 구분합니다. CSV 입출력은 csv 모듈 문서에 따라 newline=''로 열어 인용된 셀 내부의 줄바꿈을 처리합니다.
경계가 깨지는 입력도 실행합니다
다음 여섯 명령은 서로 다른 새 출력 폴더를 사용합니다. 앞의 네 입력은 보류표를 만들고 종료 코드 0으로 끝납니다. 빈 파일과 잘못된 UTF-8은 종료 코드 1로 중단하고 출력 폴더를 만들지 않습니다.
python3 group_logs.py --input fixtures/invalid_time.log --out-dir ../p22_bad_time_01
python3 group_logs.py --input fixtures/unallowed.log --out-dir ../p22_unallowed_01
python3 group_logs.py --input fixtures/no_timezone.log --out-dir ../p22_no_timezone_01
python3 group_logs.py --input fixtures/blank_boundary.log --out-dir ../p22_blank_01
python3 group_logs.py --input fixtures/empty.log --out-dir ../p22_empty_01
python3 group_logs.py --input fixtures/invalid_utf8.log --out-dir ../p22_utf8_01
fixtures/invalid_time.log는 세 번째 줄의 25시 때문에 앞 사건을 닫습니다. 네 번째 줄은 이전 사건에 연결할 수 없는 고아 연속행입니다.
2026-10-05T09:15:00Z ERR-14 import failed
    at demo.Parser.read(Parser.java:12)
2026-10-05T25:16:00Z ERR-02 timeout
    at demo.Worker.run(Worker.java:44)
2026-10-05T09:17:00Z OK-00 ready
fixtures/unallowed.log는 들여쓰기만 있는 NOTE 줄을 스택으로 인정하지 않습니다. 네 번째 줄이 허용 형식이어도 보류 경계를 건너 앞 사건에 붙이지 않습니다.
2026-10-05T09:15:00Z ERR-14 import failed
    at demo.Parser.read(Parser.java:12)
    NOTE operator changed retry count
    at demo.Worker.run(Worker.java:44)
2026-10-05T09:17:00Z OK-00 ready
fixtures/no_timezone.log의 첫 줄에는 Z가 없습니다. UTC나 현재 컴퓨터 시간대를 넣지 않고 첫 줄과 뒤 스택을 보류합니다.
2026-10-05T09:15:00 ERR-14 import failed
    at demo.Parser.read(Parser.java:12)
2026-10-05T09:17:00Z OK-00 ready
fixtures/blank_boundary.log의 두 번째 물리행은 실제 빈 줄입니다. 이 실습 계약에서는 빈 줄도 연결을 끊습니다.
2026-10-05T09:15:00Z ERR-14 import failed

    at demo.Parser.read(Parser.java:12)
2026-10-05T09:17:00Z OK-00 ready
숫자를 비교할 때는 다음 기준을 사용하세요.
normal.log: 입력 6행, 사건 2개가 5행을 사용, 보류 1행, 대장 6행invalid_time.log: 입력 5행, 사건 2개가 3행을 사용, 보류 2행. 보류 사유는INVALID_TIMESTAMP,ORPHAN_CONTINUATIONunallowed.log: 입력 5행, 사건 2개가 3행을 사용, 보류 2행. 보류 사유는UNRECOGNIZED_LINE,ORPHAN_CONTINUATIONno_timezone.log: 입력 3행, 사건 1개가 1행을 사용, 보류 2행blank_boundary.log: 입력 4행, 사건 2개가 2행을 사용, 보류 2행. 빈 줄도 대장에 남아 있습니다empty.log: 0바이트이며 중단합니다invalid_utf8.log: 바이트 입력b'2026-10-05T09:15:00Z ERR-14 bad \xff\n'이며 UTF-8 해석 오류로 중단합니다
verify_practice.py는 가상 입력을 별도의 임시 폴더에서 실행해 정상·보류 결과 5종을 expected의 CSV와 바이트 단위로 비교하고, 빈 파일·UTF-8 오류 2종의 중단과 출력 미생성을 확인합니다. python3 -m unittest -v는 21개 테스트를 실행합니다. unittest 명령행 문서에 실행 방법이 있습니다. 테스트에는 대장의 행 하나 삭제, 사건의 원시행 중복 선언, 원시행 변경, 사건 텍스트의 스택 한 줄 유실을 넣어 커버리지 검사가 실제로 거부하는지도 포함했습니다.
실패했을 때는 원본을 남긴 채 복구합니다
시각·불일치·빈 줄이 보류됐으면 held.csv의 원시행 번호를 원본과 대조하세요. 날짜를 다음 날로 넘기거나 들여쓰기 있는 줄을 전부 스택으로 취급해 통과시키지 않습니다. 실제 형식 문서에 근거해 규칙을 바꿀 필요가 있으면 사본과 새 반례로 검증하고 결과를 새 출력 폴더에 기록합니다. 소속을 확인할 근거가 없으면 보류 상태를 유지합니다.
UTF-8 오류에서는 errors='ignore'나 replace로 바이트를 버리지 않습니다. 로그를 내보낸 시스템의 인코딩을 확인해 원본을 보존하고, 확인한 방법으로 별도의 UTF-8 사본을 준비한 뒤 다시 검사하세요. BOM과 단독 CR도 이 입력 계약에서 중단 대상입니다. 빈 파일이면 수집 범위와 실제 저장 여부를 확인하고 새 입력을 준비해야 합니다.
출력 폴더가 이미 있으면 FileExistsError로 멈춥니다. 다음 명령은 첫 실행의 폴더가 남아 있는 상태에서 종료 코드 1이 나와야 합니다.
python3 group_logs.py --input fixtures/normal.log --out-dir ../p22_run_01
기존 결과를 지우지 말고 새 폴더로 다시 실행합니다. 같은 입력이라면 두 새 폴더의 CSV와 요약 내용이 같아야 합니다. 다운로드 테스트가 원본 SHA-256과 결과 파일 바이트를 비교합니다.
python3 group_logs.py --input fixtures/normal.log --out-dir ../p22_run_02
파일 크기·행 수·행별 바이트 한도를 넘으면 먼저 읽기를 중단합니다. 더 큰 운영 로그를 임의로 잘라 사건 경계를 잃지 않도록, 원본 출처와 범위를 남긴 통제된 작은 사본으로 연습하세요. 입력 폴더 안에 출력을 지정하면 중단합니다. 출력 부모 폴더가 없거나 쓰기 권한이 없으면 기존의 허용된 외부 연습 위치와 새 이름을 지정하세요. 권한이나 보안 설정을 바꾸는 과정은 이 코드에 없습니다.
쓰기나 재읽기 검산 도중 실패하면 생긴 부분 출력은 유지합니다. STOP과 종료 코드 1을 확인하고 해당 폴더를 완료 결과로 쓰지 마세요. 원본과 부분 결과를 검토한 다음 새 폴더로 실행합니다. 완료를 확인하려면 실행 종료 코드 0, 정상 파싱되는 summary.json, CSV 재읽기·원시행 커버리지 검산을 함께 확인하세요. inspect_result.py는 요약의 수치와 원본 SHA-256이 CSV·입력과 맞는지도 대조합니다. CSV 세 개가 보인다는 이유만으로 완료를 판정하지 않습니다. 정상 실행은 재읽기와 원본 바이트 재비교를 마친 뒤 요약과 JSON 결과를 출력합니다.
확인한 범위와 실제 로그 적용 전 점검
검증 환경은 CPython 3.12.14, Linux x86_64이며 Python 표준 라이브러리만 사용했습니다. 위 다섯 결과 입력, 두 중단 입력, 출력 충돌·재실행·원본 보존·물리행 커버리지 반례를 격리 폴더에서 실제 실행했습니다. LF·CRLF·마지막 줄바꿈 없음, 시각 없는 줄, 빈 줄, 입력 최종 심볼릭 링크 거부, 요약의 사건 수를 고친 반례 거부도 테스트에 포함했습니다. Windows 실행은 이 검증 범위에 포함하지 않았습니다.
공식 Python 3.12 문서는 2026-10-05에 웹에서 확인했고 당시 페이지 제목은 3.12.15였습니다. 실행 환경의 3.12.14와 문서 페이지의 패치 버전 표기를 구분합니다. ZIP의 VERSION.json, TEST_RESULTS.txt, RUN_RESULTS.json에서 실행 범위와 결과를 확인할 수 있습니다. SHA256SUMS.txt는 자기 자신을 제외한 제공 파일의 SHA-256 목록입니다.
입력의 최종 심볼릭 링크는 거부하지만 resolve()는 조상 경로의 링크를 따라갈 수 있습니다. 조상 링크나 Windows junction을 모두 거부하는 구현은 아니며 junction은 실행 시험하지 않았습니다. 직접 만든 링크 없는 고정 연습 폴더에서 실행하세요.
이 코드는 입력을 두 번 제한 크기로 읽어 관찰된 변경을 검출하지만 파일을 잠그지는 않습니다. 실행 중 다른 프로세스가 파일이나 디렉터리를 바꾸는 경쟁 조건에 대해 완전한 안전을 보장하지 않습니다. 먼저 쓰기가 끝난 오프라인 사본을 개인 연습 폴더에 준비하세요. 보류가 없고 커버리지 검사가 통과해도 실제 사건의 동일성이나 장애 원인을 증명하는 것은 아닙니다. 서로 다른 스레드의 로그가 섞이는 형식이라면 요청 ID·스레드 ID 등 제품의 연결 기준을 별도로 정의해야 합니다.
한 줄에서 필드를 분리하는 기준은 로그 한 줄의 시각·코드·메시지 보존에서, 이미 저장된 순번 로그의 중복·누락 검산은 WebSocket 로그 감사에서 확인할 수 있습니다. 이번 실습에서는 사건 경계와 모든 원시행의 대응을 먼저 검증하세요.
작성자 소개
