폴더의 두 시점 목록에서 추가·삭제·변경을 구별하기
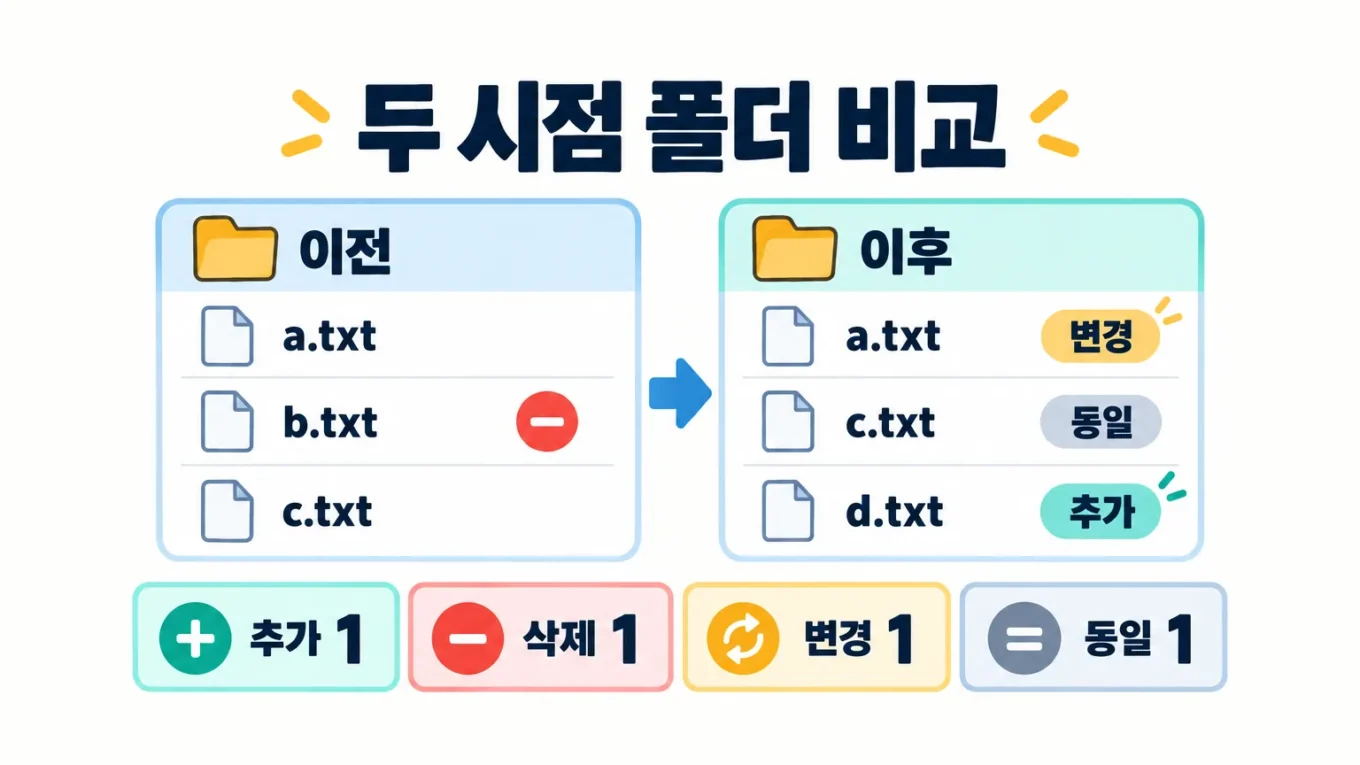
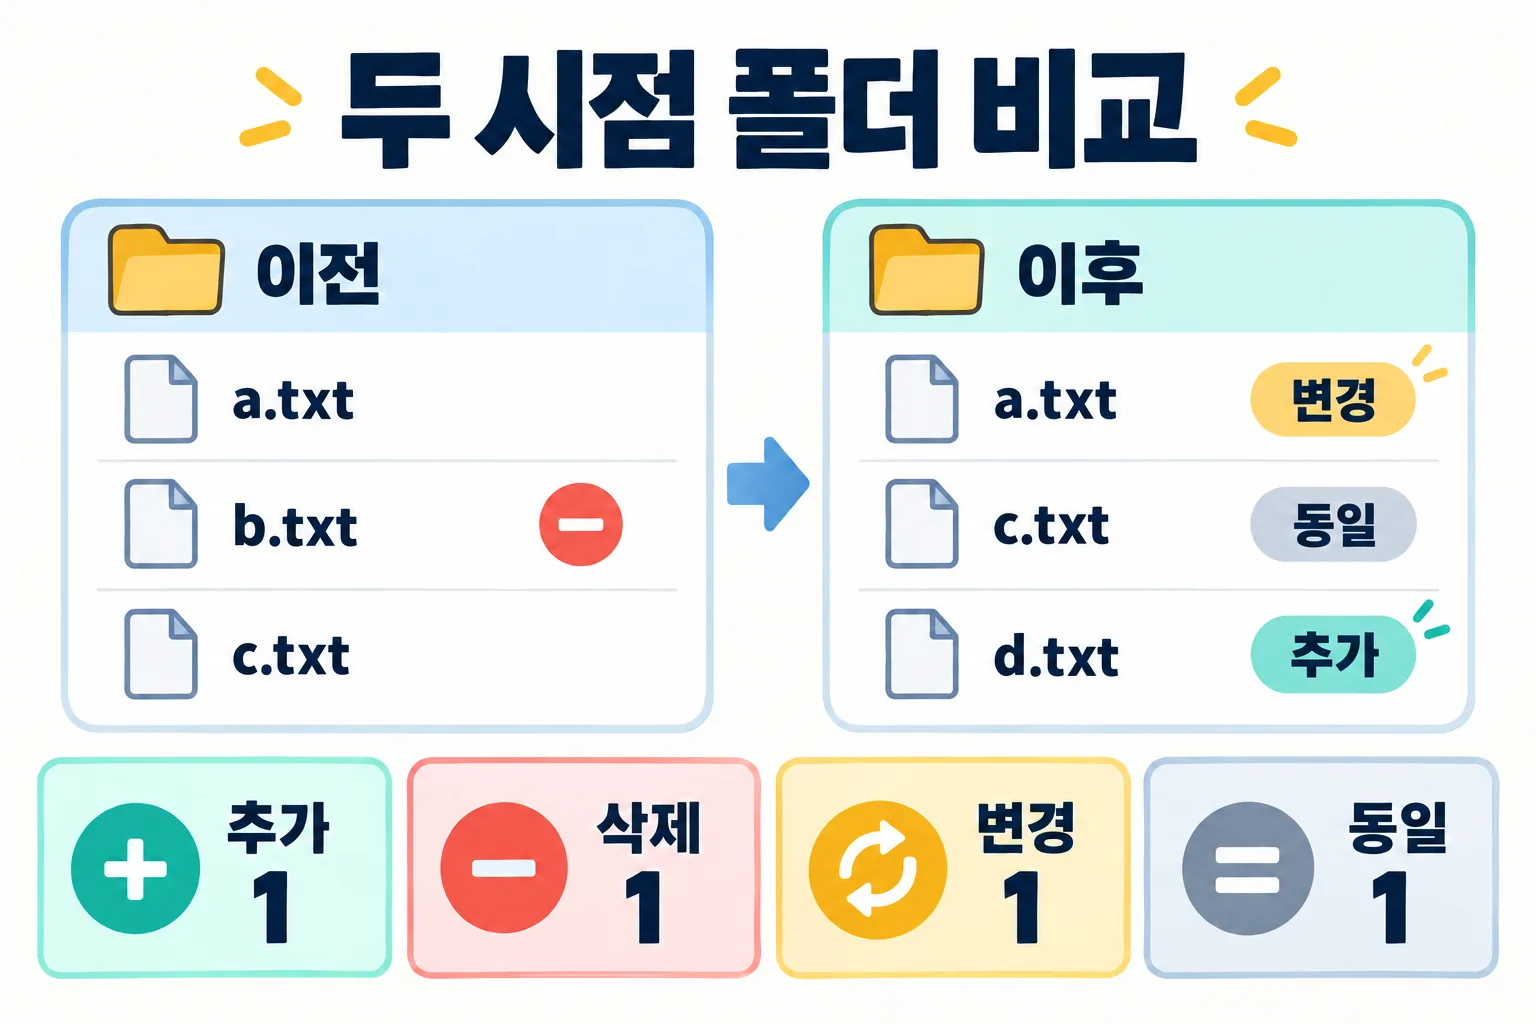
지난번 폴더에 a.txt·b.txt·c.txt가 있었고, 이번 폴더에는 a.txt·c.txt·d.txt가 있다면 무엇이 달라졌을까요? 이 실습은 두 시점의 상대 경로 목록을 비교해 추가 d.txt, 삭제 b.txt, 내용 변경 a.txt, 동일 c.txt를 각 1건으로 구별합니다. 파일을 옮기거나 지우지 않고 새 JSON 보고서만 만듭니다.
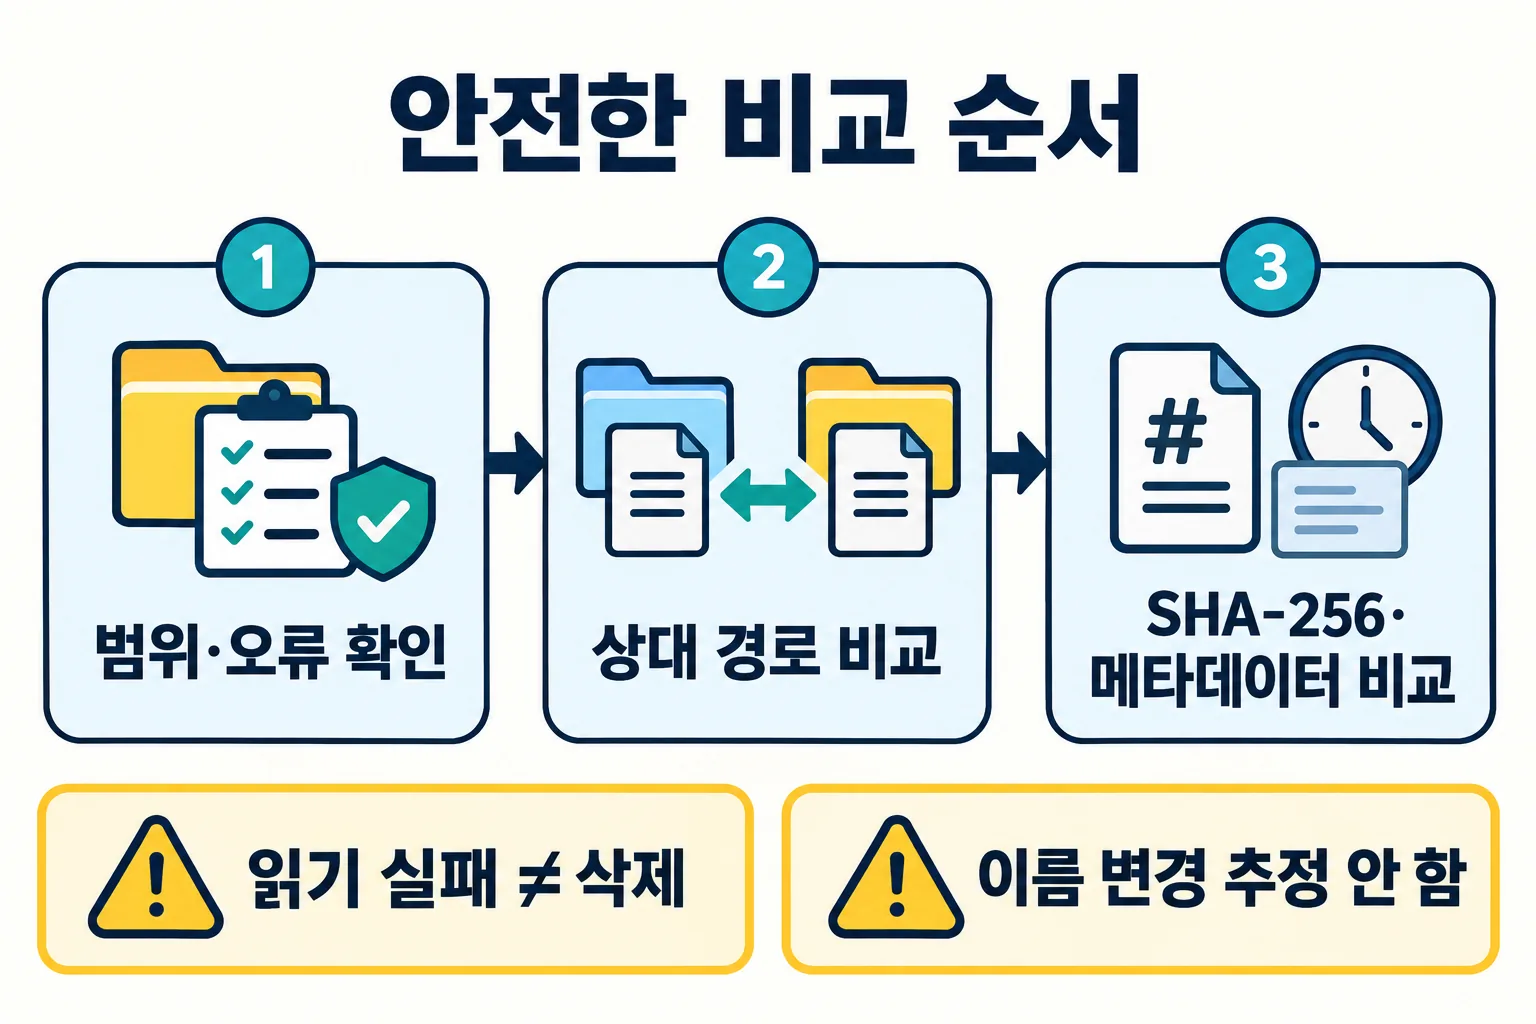
여기서 “삭제”는 이전 비교 범위에 있던 경로가 이후의 정상 수집 목록에 없다는 분류 이름입니다. 프로그램이 삭제한 파일은 없습니다. 읽지 못한 폴더를 빈 폴더처럼 취급하지 않도록, 오류가 있는 스냅샷은 비교부터 중단합니다.
1 두 폴더를 같은 기준으로 기록합니다
스냅샷은 파일마다 상대 경로·바이트 크기·mtime_ns·SHA-256을 저장한 JSON입니다. 예를 들어 sub/report.txt를 비교 키로 삼으며, 두 폴더의 절대 위치가 달라도 같은 상대 경로끼리 비교합니다. 이 글에서는 같은 논리적 폴더의 이전·이후 사본을 fixtures/before와 fixtures/after로 표현합니다. 실제 업무 폴더 대신 첨부의 가상 파일부터 사용하세요. 실행에는 Python 3.12 이상을 기준으로 합니다.
별개의 프로젝트 폴더를 지정해도 프로그램은 경로 차이를 계산할 뿐, 둘이 같은 업무 대상인지 판단하지 않습니다. 빈 폴더 자체, 권한·소유자·확장 속성, Excel 셀의 의미 차이는 이 비교의 대상에 포함하지 않습니다.
| 상대 경로 | 이전 | 이후 | 기대 분류 |
|---|---|---|---|
| a.txt | alpha before와 줄바꿈 | alpha after와 줄바꿈 | changed 1 |
| b.txt | beta removed와 줄바꿈 | 없음 | deleted 1 |
| c.txt | constant와 줄바꿈 | 같은 바이트·같은 수정 시각 | unchanged 1 |
| d.txt | 없음 | delta added와 줄바꿈 | added 1 |
2 새 연습 폴더에서 실습을 시작합니다
실습 ZIP 다운로드를 새 빈 폴더에 풉니다. README.md가 있는 최상위 위치에서 터미널을 열고 아래 명령을 한 줄씩 실행하세요. 별도 패키지는 설치하지 않습니다. python 명령이 없고 python3만 있다면 모든 명령의 python을 python3으로 바꿉니다.
ZIP을 푸는 도구는 수정 시각을 다르게 복원할 수 있습니다. 그래서 prepare_fixture.py로 제공된 가상 fixture만 고정 시각으로 준비한 뒤 기록합니다. 이 준비 스크립트는 제공된 여섯 파일의 바이트와 링크 여부를 먼저 확인한 뒤 파일 바이트를 바꾸지 않고 접근·수정 시각을 복원하는 단계이며, 실제 폴더를 읽는 folder_compare.py에는 원본 수정 기능이 없습니다.
python --version
python prepare_fixture.py
python folder_compare.py snapshot fixtures/before before.json
python folder_compare.py snapshot fixtures/after after.json
python folder_compare.py compare before.json after.json diff.json
python -m json.tool diff.json
python -m unittest discover -s tests -v
before.json과 after.json을 만든 명령에서 complete=True, files=3, errors=0을 확인합니다. 비교 명령의 counts가 added·deleted·changed·unchanged 각각 1이고 metadata_changed·unverified 각각 0이면 기본 사례를 통과한 것입니다. 결과의 경로 목록까지 expected/diff.json과 대조하세요.
같은 출력 이름으로 다시 실행하면 기존 파일을 덮어쓰지 않고 종료 코드 2로 멈춥니다. 다시 기록하려면 before-02.json·after-02.json·diff-02.json처럼 새 이름을 사용하고 compare의 입력도 함께 바꾸세요. snapshot 출력은 검사 폴더 바깥에 둡니다. 쉘의 >로 저장하면 쉘이 기존 파일을 덮어쓸 수 있으므로, 이 실습은 명령의 출력 인수를 사용합니다.
3 실제 기대 JSON을 검산합니다
{
  "schema": 1,
  "algorithm": "sha256",
  "counts": {
    "added": 1,
    "deleted": 1,
    "changed": 1,
    "unchanged": 1,
    "metadata_changed": 0,
    "unverified": 0
  },
  "added": [
    "d.txt"
  ],
  "deleted": [
    "b.txt"
  ],
  "changed": [
    {
      "path": "a.txt",
      "reason": "sha256_differs"
    }
  ],
  "unchanged": [
    "c.txt"
  ],
  "metadata_changed": [],
  "unverified": []
}
a.txt는 이전 13바이트에서 이후 12바이트로 내용과 크기가 달라집니다. 코드의 회귀 테스트에는 크기·시각이 같아도 해시가 달라지는 반례도 포함합니다. c.txt는 해시·크기·수정 시각이 모두 같아서 이 실습의 unchanged에 들어갑니다. 이 결과가 파일의 앞으로의 상태나 업무상 승인된 버전을 보증하는 것은 아닙니다.
4 내용 변경과 시각 변경을 구별합니다
- added·deleted: 같은 설정으로 정상 수집된 두 목록의 상대 경로 집합 차이입니다.
- changed: 같은 경로의 SHA-256이 다릅니다. 기록한 바이트에 차이가 있다는 판단이며 어느 내용이 맞는지는 정하지 않습니다.
- metadata_changed: SHA-256과 크기는 같지만 mtime_ns가 다릅니다. 내용 변경으로 세지 않습니다.
- unchanged: SHA-256·크기·mtime_ns가 모두 같습니다. 해시를 이용한 실용적 비교 결과이며 수학적으로 바이트 동일성을 증명하거나 두 원본의 바이트를 재대조한 결과는 아닙니다.
- unverified: 어느 한쪽의 SHA-256이 없으면 내용 동일 여부를 미확인으로 남깁니다. 시간과 크기만 같아도 unchanged로 올리지 않습니다.
같은 해시에 서로 다른 크기가 적혀 있으면 이 실습의 데이터 계약에 맞지 않는 기록으로 거부합니다. 잘못 수집하거나 편집한 JSON을 조용히 통과시키지 않기 위한 검증입니다. mtime_ns는 정수로 기록하지만 실제 시각 정밀도는 운영체제·파일 시스템에 따라 다릅니다. Python os.stat 공식 문서도 나노초 단위 표시가 나노초 정밀도를 보장하지 않는다고 설명합니다.
이름이 b.txt에서 d.txt로 바뀌었더라도 별도 근거가 없다면 삭제 1건·추가 1건으로 기록합니다. 해시가 우연히 같다는 이유로 이름 변경을 추정하거나 복구 명령을 만들지 않습니다.
5 읽기 오류와 제외 범위를 먼저 확인합니다
탐색을 시작한 뒤 하위 항목의 권한 부족, 파일 교체, 링크·reparse point, 특수 파일, 상한 초과가 발생하면 complete=False와 errors를 기록하고 snapshot이 종료 코드 2를 반환합니다. 저장된 JSON이 있어도 정상 비교 입력으로 사용하지 않습니다. root 자체·조상 경로의 링크나 상위 이동 표기처럼 시작 단계에서 거부되는 입력은 JSON 자체가 만들어지지 않을 수 있습니다. compare는 불완전 스냅샷에 대해 결과 파일을 만들지 않고 멈춥니다.
명시적 제외는 상대 경로 접두어 단위입니다. –exclude cache는 cache 자체와 cache/ 아래를 빼며 cache2를 빼지는 않습니다. 와일드카드·확장자 필터가 아닙니다. 제외 경로는 excluded에 남고, 두 스냅샷의 제외 목록·해시 설정·상한·링크 정책이 모두 같아야 비교합니다. 같은 제외 기준에서도 실제 제외 영역의 내용은 검사하지 않으므로 결과는 포함 범위에만 적용됩니다.
python folder_compare.py snapshot fixtures/before before-small.json --max-file-bytes 1
python folder_compare.py compare before-small.json after.json refused.json
위 두 명령은 실패를 확인하는 연습입니다. 첫 명령은 1바이트보다 큰 fixture 때문에 complete=False를 기록하고 코드 2로 끝납니다. 두 번째는 incomplete snapshot 메시지와 코드 2로 끝나며 refused.json이 생기지 않아야 합니다. 상한 설정도 서로 다르지만 이 사례에서는 불완전 상태 검사에서 먼저 멈춥니다. 권한 오류를 해결하려고 관리자 권한을 넓히기보다 필요한 작은 연습 폴더에 접근할 수 있는지부터 확인하세요.
6 파일이 읽는 도중 바뀌면 다시 기록합니다
코드는 lstat으로 경로를 확인하고, 파일을 연 뒤 fstat과 읽기 전후의 크기·시각·파일 식별 정보를 대조합니다. 검사한 디렉터리도 마지막에 다시 확인합니다. 흔한 동시 변경을 발견하면 changed_during_read로 멈춥니다. 운영체제가 제공할 때 O_NOFOLLOW도 사용하지만, 모든 플랫폼에서 같은 기능을 보장하지 않습니다.
이 절차는 폴더 전체의 원자적 스냅샷이나 악의적 경로 교체 방어를 완성하지 않습니다. os.scandir 공식 문서는 탐색 중 추가·삭제된 항목의 포함 여부가 정해져 있지 않다고 설명합니다. 동기화나 편집을 잠시 멈춘 작은 사본에서 다시 수집하세요. 변경이 감지되지 않았다는 사실만으로 탐색 시점 전체가 고정돼 있었다고 주장하지 않습니다.
원본을 읽기 전용으로 연다는 말은 프로그램이 원본 바이트를 쓰거나 이동·삭제하지 않는다는 뜻입니다. 운영체제가 파일 접근 시각을 갱신할 수는 있습니다. 증거 보존이나 감사가 필요한 원본은 이 교육용 도구로 직접 읽지 마세요.
7 입력 검증과 자원 상한을 확인합니다
기본 탐색 상한은 항목 10,000개, 파일당 10 MiB, 합계 100 MiB입니다. 읽고 쓰는 JSON도 16 MiB를 넘기지 않습니다. 항목 수에는 파일·디렉터리·제외 항목도 포함하며 총량은 읽기 시도의 예산으로 제한합니다. –max-entries·–max-file-bytes·–max-total-bytes로 더 작게 시험할 수 있습니다. 네트워크 읽기 시간이나 전체 실행 시간을 강제로 끊는 기한은 없으므로 대형·네트워크·변경 중인 폴더에 사용하지 않습니다.
비교 JSON은 16 MiB까지만 읽습니다. 중복 JSON 키, 알 수 없는 필드, 지원하지 않는 schema·algorithm, 잘못된 숫자·해시, 절대 경로·상위 이동·역슬래시 경로, 중복 경로를 거부합니다. 파일명은 NFC 형태와 대소문자 충돌 없는 휴대성 제한을 적용합니다. Windows 예약 이름·끝의 점/공백 등도 거부합니다. 모든 실제 파일 이름을 다 지원하는 범용 백업 목록이 아닙니다.
root나 출력 경로에 상위 이동을 나타내는 ..를 넣지 않습니다. 입력 root와 조상 경로의 링크·reparse point도 거부합니다. 출력은 새 파일을 독점 생성합니다. 권한·디스크 오류가 나면 코드 2로 종료하며 부분 JSON이 남을 수 있습니다. 원본이나 기존 보고서를 자동 삭제해 복구하지 않습니다. 실패한 새 출력의 상태를 확인하고, 원인을 해결한 뒤 다른 새 이름으로 재실행하세요. 출력 디렉터리도 신뢰할 수 있는 개인 연습 공간을 사용합니다.
8 전체 실습 코드를 확인합니다
아래 folder_compare.py는 ZIP의 같은 파일과 일치합니다. 입력 준비 스크립트·자동 테스트·가상 파일·기대 결과·실제 로그는 ZIP에 함께 있습니다. 긴 줄은 코드 영역 안에서 가로로 스크롤해서 읽을 수 있습니다.
folder_compare.py 전체 코드 펼치기
"""Read-only folder snapshots and strict comparisons (Python 3.12+)."""
import argparse
import hashlib
import json
import os
from pathlib import Path
import re
import stat
import sys
import unicodedata

MAX_JSON = 16 * 1024 * 1024
EMPTY_HASH = hashlib.sha256(b'').hexdigest()
REASONS = {'file_failed', 'scan_failed', 'limit', 'changed_during_read',
           'unsafe_path', 'link_or_reparse', 'special'}
BUCKETS = ('added', 'deleted', 'changed', 'unchanged', 'metadata_changed', 'unverified')


def require(condition, message):
    if not condition:
        raise ValueError(message)


def fields(value, names):
    require(type(value) is dict and set(value) == set(names.split()), 'invalid fields')


def integer(value, low, high):
    require(type(value) is int and low <= value <= high, 'invalid integer')


def safe_path(value):
    require(type(value) is str and 0 < len(value) <= 1024, 'unsafe path')
    require(unicodedata.normalize('NFC', value) == value, 'unsafe path normalization')
    parts = value.split('/')
    require(len(parts) <= 64, 'unsafe path depth')
    for part in parts:
        require(part not in ('', '.', '..') and not part.endswith((' ', '.')) and
                not re.search(r'[\x00-\x1f\x7f\ud800-\udfff<>:"\\|?*]', part) and
                not re.fullmatch(r'(?i:CON|PRN|AUX|NUL|COM[1-9¹²³]|LPT[1-9¹²³])(?:\..*)?', part),
                'unsafe path')
    return value


def excluded(path, prefixes):
    parts = path.split('/')
    return any('/'.join(parts[:i]) in prefixes for i in range(1, len(parts) + 1))


def validate_config(cfg):
    fields(cfg, 'exclude hash max_entries max_file_bytes max_total_bytes links')
    require(type(cfg['hash']) is bool and cfg['links'] == 'fail', 'invalid config')
    require(type(cfg['exclude']) is list, 'invalid exclude')
    for value in cfg['exclude']:
        safe_path(value)
    require(cfg['exclude'] == sorted(set(cfg['exclude'])), 'invalid exclude ordering')
    integer(cfg['max_entries'], 1, 100000)
    integer(cfg['max_file_bytes'], 1, 1024 ** 3)
    integer(cfg['max_total_bytes'], 1, 8 * 1024 ** 3)


def config(exclude=(), do_hash=True, max_entries=10000,
           max_file_bytes=10485760, max_total_bytes=104857600):
    cfg = dict(exclude=sorted(set(exclude)), hash=do_hash, max_entries=max_entries,
               max_file_bytes=max_file_bytes, max_total_bytes=max_total_bytes, links='fail')
    validate_config(cfg)
    return cfg


def validate(data):
    fields(data, 'schema algorithm config complete errors excluded files')
    require(type(data['schema']) is int and data['schema'] == 1 and
            data['algorithm'] == 'sha256', 'unsupported schema/algorithm')
    validate_config(data['config'])
    cfg = data['config']
    prefixes = set(cfg['exclude'])
    require(type(data['complete']) is bool, 'invalid complete')
    for name in ('files', 'errors', 'excluded'):
        limit = 2 * cfg['max_entries'] + 2 if name == 'errors' else cfg['max_entries']
        require(type(data[name]) is list and len(data[name]) <= limit,
                'invalid list or limit')
    require(data['complete'] == (not data['errors']), 'complete/errors conflict')
    error_keys = set()
    for item in data['errors']:
        fields(item, 'path reason')
        if item['path'] is not None:
            safe_path(item['path'])
        require(type(item['reason']) is str and item['reason'] in REASONS, 'invalid error reason')
        error_keys.add((item['path'], item['reason']))
    excluded_paths = set()
    for item in data['excluded']:
        fields(item, 'path reason')
        path = safe_path(item['path'])
        require(path not in excluded_paths, 'duplicate excluded path')
        excluded_paths.add(path)
        require(type(item['reason']) is str and item['reason'] in
                ('configured', 'link_or_reparse', 'special'), 'invalid exclusion')
        require(excluded(path, prefixes) if item['reason'] == 'configured' else
                (path, item['reason']) in error_keys, 'unaccounted exclusion')
    result, aliases, sizes = {}, set(), {}
    for item in data['files']:
        require(type(item) is dict and set(item) in
                ({'path', 'size', 'mtime_ns'}, {'path', 'size', 'mtime_ns', 'sha256'}), 'invalid file fields')
        path = safe_path(item['path'])
        require(path.casefold() not in aliases, 'duplicate path')
        aliases.add(path.casefold())
        require(not excluded(path, prefixes) and path not in excluded_paths, 'excluded file included')
        integer(item['size'], 0, cfg['max_file_bytes'])
        integer(item['mtime_ns'], -(2 ** 63), 2 ** 63 - 1)
        digest = item.get('sha256')
        require(digest is None or type(digest) is str and re.fullmatch('[0-9a-f]{64}', digest),
                'invalid sha256')
        require(cfg['hash'] or digest is None, 'hash/config conflict')
        if digest is not None:
            require((digest == EMPTY_HASH) == (item['size'] == 0), 'hash_size conflict')
            require(digest not in sizes or sizes[digest] == item['size'], 'hash_size conflict')
            sizes[digest] = item['size']
        result[path] = item
    require(len(result) <= cfg['max_entries'], 'entry limit')
    require(sum(item['size'] for item in result.values()) <= cfg['max_total_bytes'], 'total byte limit')
    for path in result:
        parts = path.split('/')
        require(not any('/'.join(parts[:i]).casefold() in aliases for i in range(1, len(parts))),
                'file ancestry conflict')
        require(not excluded(path, excluded_paths), 'excluded subtree included')
    return result


def unique_object(pairs):
    obj = {}
    for key, value in pairs:
        require(key not in obj, 'duplicate JSON key')
        obj[key] = value
    return obj


def load(path):
    flags = os.O_RDONLY | getattr(os, 'O_NONBLOCK', 0) | getattr(os, 'O_NOFOLLOW', 0) | getattr(os, 'O_BINARY', 0)
    with os.fdopen(os.open(path, flags), 'rb') as stream:
        require(stat.S_ISREG(os.fstat(stream.fileno()).st_mode), 'JSON input must be a regular file')
        raw = stream.read(MAX_JSON + 1)
    require(len(raw) <= MAX_JSON, 'JSON byte limit')
    data = json.loads(raw, object_pairs_hook=unique_object,
                      parse_constant=lambda _: require(False, 'invalid JSON constant'))
    validate(data)
    return data


def compare(before, after):
    left, right = validate(before), validate(after)
    require(before['complete'] and after['complete'], 'incomplete snapshot; comparison refused')
    require(before['config'] == after['config'], 'config mismatch; comparison refused')
    sizes = {}
    for item in [*left.values(), *right.values()]:
        digest = item.get('sha256')
        if digest is not None:
            require(digest not in sizes or sizes[digest] == item['size'], 'hash_size conflict')
            sizes[digest] = item['size']
    result = {name: [] for name in BUCKETS}
    result['added'], result['deleted'] = sorted(right.keys() - left.keys()), sorted(left.keys() - right.keys())
    for path in sorted(left.keys() & right.keys()):
        a, b = left[path], right[path]
        if a.get('sha256') is None or b.get('sha256') is None:
            bucket, reason = 'unverified', 'hash_missing'
        elif a['sha256'] != b['sha256']:
            bucket, reason = 'changed', 'sha256_differs'
        elif a['mtime_ns'] != b['mtime_ns']:
            bucket, reason = 'metadata_changed', 'mtime_ns_differs'
        else:
            result['unchanged'].append(path)
            continue
        result[bucket].append(dict(path=path, reason=reason))
    return dict(schema=1, algorithm='sha256', counts={name: len(result[name]) for name in BUCKETS}, **result)


def is_link(info):
    return stat.S_ISLNK(info.st_mode) or bool(getattr(info, 'st_file_attributes', 0) & 0x400)


def stamp(info):
    return tuple(getattr(info, name) for name in
                 ('st_dev', 'st_ino', 'st_mode', 'st_size', 'st_mtime_ns', 'st_ctime_ns'))


def read_file(path, info, remaining, cfg):
    require(info.st_size <= cfg['max_file_bytes'] and info.st_size <= remaining, 'limit')
    digest = None
    if cfg['hash']:
        flags = os.O_RDONLY | getattr(os, 'O_NOFOLLOW', 0) | getattr(os, 'O_NONBLOCK', 0) | getattr(os, 'O_BINARY', 0)
        with os.fdopen(os.open(path, flags), 'rb') as stream:
            opened = os.fstat(stream.fileno())
            require(stat.S_ISREG(opened.st_mode) and not is_link(opened) and stamp(opened) == stamp(info),
                    'changed_during_read')
            hasher, total = hashlib.sha256(), 0
            while total < info.st_size:
                block = stream.read(min(65536, info.st_size - total))
                if not block:
                    break
                total += len(block)
                hasher.update(block)
            require(total == info.st_size and stamp(os.fstat(stream.fileno())) == stamp(info), 'changed_during_read')
            digest = hasher.hexdigest()
    require(stamp(path.lstat()) == stamp(info), 'changed_during_read')
    return dict(size=info.st_size, mtime_ns=info.st_mtime_ns, sha256=digest)


def snapshot(root, cfg):
    validate_config(cfg)
    require('..' not in Path(root).parts, 'input parent hops are not allowed')
    root = Path(os.path.abspath(root))
    for ancestor in reversed((root, *root.parents)):
        require(not is_link(ancestor.lstat()), 'input root/ancestor is a link or reparse point')
    require(stat.S_ISDIR(root.lstat().st_mode), 'input must be a directory')
    data = dict(schema=1, algorithm='sha256', config=cfg, complete=True, errors=[], excluded=[], files=[])
    prefixes = set(cfg['exclude'])
    pending, directories, seen, aliases, used = [root], [], 0, set(), 0
    def error(path, reason):
        data['errors'].append(dict(path=path, reason=reason))
    while pending:
        directory = pending.pop()
        relative_dir = None if directory == root else directory.relative_to(root).as_posix()
        try:
            info = directory.lstat()
            require(stat.S_ISDIR(info.st_mode) and not is_link(info), 'changed_during_read')
            directories.append((directory, stamp(info)))
            with os.scandir(directory) as entries:
                for entry in entries:
                    seen += 1
                    if seen > cfg['max_entries']:
                        error(None, 'limit')
                        pending.clear()
                        break
                    path = Path(entry.path)
                    relative = path.relative_to(root).as_posix()
                    try:
                        safe_path(relative)
                        require(relative.casefold() not in aliases, 'unsafe_path')
                        aliases.add(relative.casefold())
                    except ValueError:
                        error(None, 'unsafe_path')
                        continue
                    try:
                        if excluded(relative, prefixes):
                            data['excluded'].append(dict(path=relative, reason='configured'))
                            continue
                        info = path.lstat()
                        if is_link(info) or not (stat.S_ISDIR(info.st_mode) or stat.S_ISREG(info.st_mode)):
                            reason = 'link_or_reparse' if is_link(info) else 'special'
                            data['excluded'].append(dict(path=relative, reason=reason))
                            error(relative, reason)
                        elif stat.S_ISDIR(info.st_mode):
                            pending.append(path)
                        else:
                            require(info.st_size <= cfg['max_file_bytes'] and
                                    info.st_size <= cfg['max_total_bytes'] - used, 'limit')
                            used += info.st_size  # Reserve even if reading later fails.
                            item = read_file(path, info, info.st_size, cfg)
                            data['files'].append(dict(path=relative, **item))
                    except (OSError, ValueError) as exc:
                        error(relative, str(exc) if str(exc) in ('limit', 'changed_during_read') else 'file_failed')
        except (OSError, ValueError) as exc:
            error(relative_dir, 'changed_during_read' if str(exc) == 'changed_during_read' else 'scan_failed')
    for directory, original in directories:
        try:
            require(stamp(directory.lstat()) == original, 'changed_during_read')
        except (OSError, ValueError):
            error(None if directory == root else directory.relative_to(root).as_posix(), 'changed_during_read')
    data['complete'] = not data['errors']
    for name in ('files', 'excluded'):
        data[name].sort(key=lambda item: item['path'])
    validate(data)
    return data


def outside(output, root):
    require(not Path(output).resolve().is_relative_to(Path(root).resolve()), 'output must be outside input')


def write_json(output, data, root=None):
    if root is not None:
        outside(output, root)
    encoded = (json.dumps(data, ensure_ascii=False, indent=2) + '\n').encode('utf-8')
    require(len(encoded) <= MAX_JSON, 'JSON byte limit')
    with open(output, 'xb') as stream:
        stream.write(encoded)


def main(argv=None):
    parser = argparse.ArgumentParser(description=__doc__)
    commands = parser.add_subparsers(dest='command', required=True)
    capture = commands.add_parser('snapshot')
    capture.add_argument('root'); capture.add_argument('output')
    capture.add_argument('--exclude', action='append', default=[])
    capture.add_argument('--no-hash', action='store_true')
    for name, default in (('max-entries', 10000), ('max-file-bytes', 10485760), ('max-total-bytes', 104857600)):
        capture.add_argument('--' + name, type=int, default=default)
    diff = commands.add_parser('compare')
    for name in ('before', 'after', 'output'):
        diff.add_argument(name)
    args = parser.parse_args(argv)
    try:
        if args.command == 'snapshot':
            outside(args.output, args.root)
            cfg = config(args.exclude, not args.no_hash, args.max_entries, args.max_file_bytes, args.max_total_bytes)
            data = snapshot(args.root, cfg)
            write_json(args.output, data, args.root)
            print(f"snapshot complete={data['complete']} files={len(data['files'])} errors={len(data['errors'])}")
            return 0 if data['complete'] else 2
        data = compare(load(args.before), load(args.after))
        write_json(args.output, data)
        print('compare ' + json.dumps(data['counts'], ensure_ascii=False))
        return 0
    except (OSError, ValueError, TypeError, RecursionError) as exc:
        print(f'error: {exc}', file=sys.stderr)
        return 2


if __name__ == '__main__':
    sys.exit(main())
9 검증 환경과 출처를 확인합니다
실제 조사·코드 검증은 2026년 10월 10일에 Python 3.12.14와 Linux 환경에서 수행했습니다. 동봉 테스트 48개와 별도 독립 테스트 49개가 통과했고 새 ZIP 추출본에서 기본 명령과 기대 JSON 3개를 바이트까지 대조했습니다. 글에 표시한 2026년 8월 3일은 신규 연재 배분일이며 당시 사용 경험을 뜻하지 않습니다. Windows·macOS·네트워크 공유·실제 업무 폴더의 성공까지 시험했다고 주장하지 않습니다. 권한·경합의 일부 오류 분기는 임시 fixture와 모의 오류로 검증했으며, 모든 현실의 동시 변경이나 악의적 공격을 재현한 것은 아닙니다.
- Python 3.12 os 공식 문서: 탐색·파일 열기·stat과 플랫폼별 제약
- Python 3.12 pathlib 공식 문서: 상대 경로·resolve·링크 관련 동작
- Python 3.12 hashlib 공식 문서: sha256과 해시 누적
- Microsoft 파일 이름 공식 문서: 예약 이름과 경로 이름 제한
- Python 3.12 json 공식 문서: 중복 키 기본 처리와 object_pairs_hook
기존 폴더 목록 깊이 기록은 한 시점에서 본 범위를 남깁니다. 동일 내용 파일 목록은 같은 시점의 중복 후보를 묶습니다. 수정 시각과 내용 비교는 지정한 두 파일을 살핍니다. 이번 글의 핵심은 두 시점의 경로 변화와 비교 가능한 수집 상태를 함께 확인하는 것입니다.
10 결과를 사용하기 전 마지막으로 확인합니다
- 두 목록은 같은 논리적 대상·같은 제외 기준에서 수집했나요?
- 두 snapshot 모두 complete=True이고 errors가 비었나요?
- 기본 사례에서 추가·삭제·변경·동일의 경로까지 각 1건인가요?
- 시각만 다른 항목과 해시 없는 항목을 별도 분류했나요?
- 변경 사유를 사람이 확인한 뒤 다음 작업을 결정하나요?
실습 ZIP SHA-256: 353a4ce3c82c9ce820b5eeb539df0399392468d424b53d2dd0c9781ff83eb9c3. 파일 크기 20492바이트. 가상 입력 전용이며 원본 삭제·이동·자동 복구 기능은 없습니다.
작성자 소개
