수정 시간이 최신인데 내용은 같은 파일 구별하기: Python mtime·SHA-256 실습
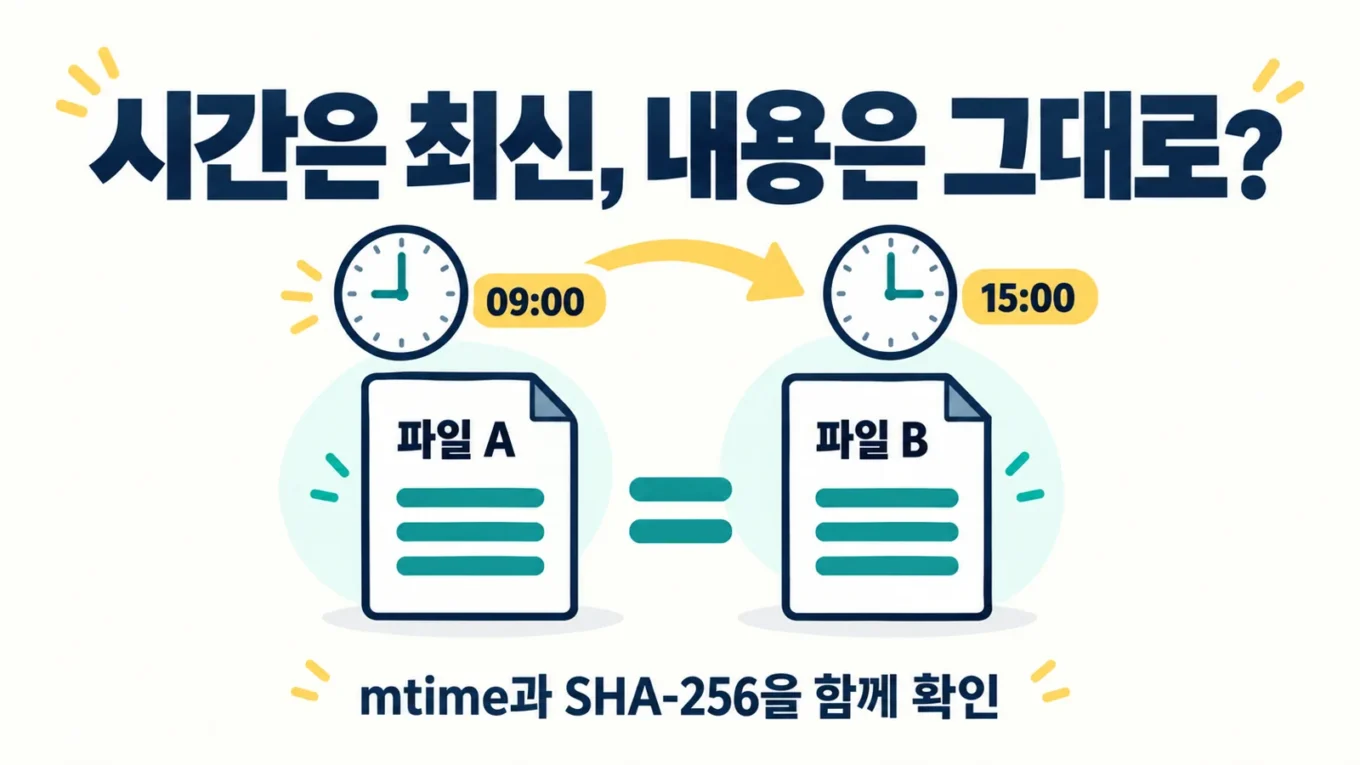
폴더를 수정 시간순으로 정렬했는데 가장 위의 파일이 아까 본 내용과 같다면, 새 버전으로 세기 전에 두 가지를 따로 확인해 보세요. 수정 시각이 늦다는 사실과 파일의 바이트가 달라졌다는 사실은 같은 판단이 아닙니다.
이 실습은 비교할 두 파일을 직접 지정해 수정 시간, 크기, SHA-256, 바이트 대조 결과를 각각 기록합니다. 같은 내용인데 시간만 다른 한 쌍과, 시간이 같아도 내용이 다른 한 쌍을 만듭니다. 결과만으로 최신 정답·승인된 업무 버전을 정하거나 파일을 삭제하지 않습니다.
1. 수정 시간으로만 새 버전을 세면 생기는 두 함정
mtime은 파일 시스템이 기록한 내용 수정 시각입니다. 복사 도구나 동기화 방식에 따라 바이트를 그대로 옮기면서 시각이 달라질 수도 있고, 원래 시각을 보존할 수도 있습니다. 예를 들어 Python의 shutil.copy 문서는 내용과 권한을 복사하지만 생성·수정 시간을 보존하지 않는다고 설명하고, copy2는 메타데이터 보존을 시도한다고 설명합니다. 따라서 모든 복사가 같은 시각 동작을 한다고 가정하지 마세요.
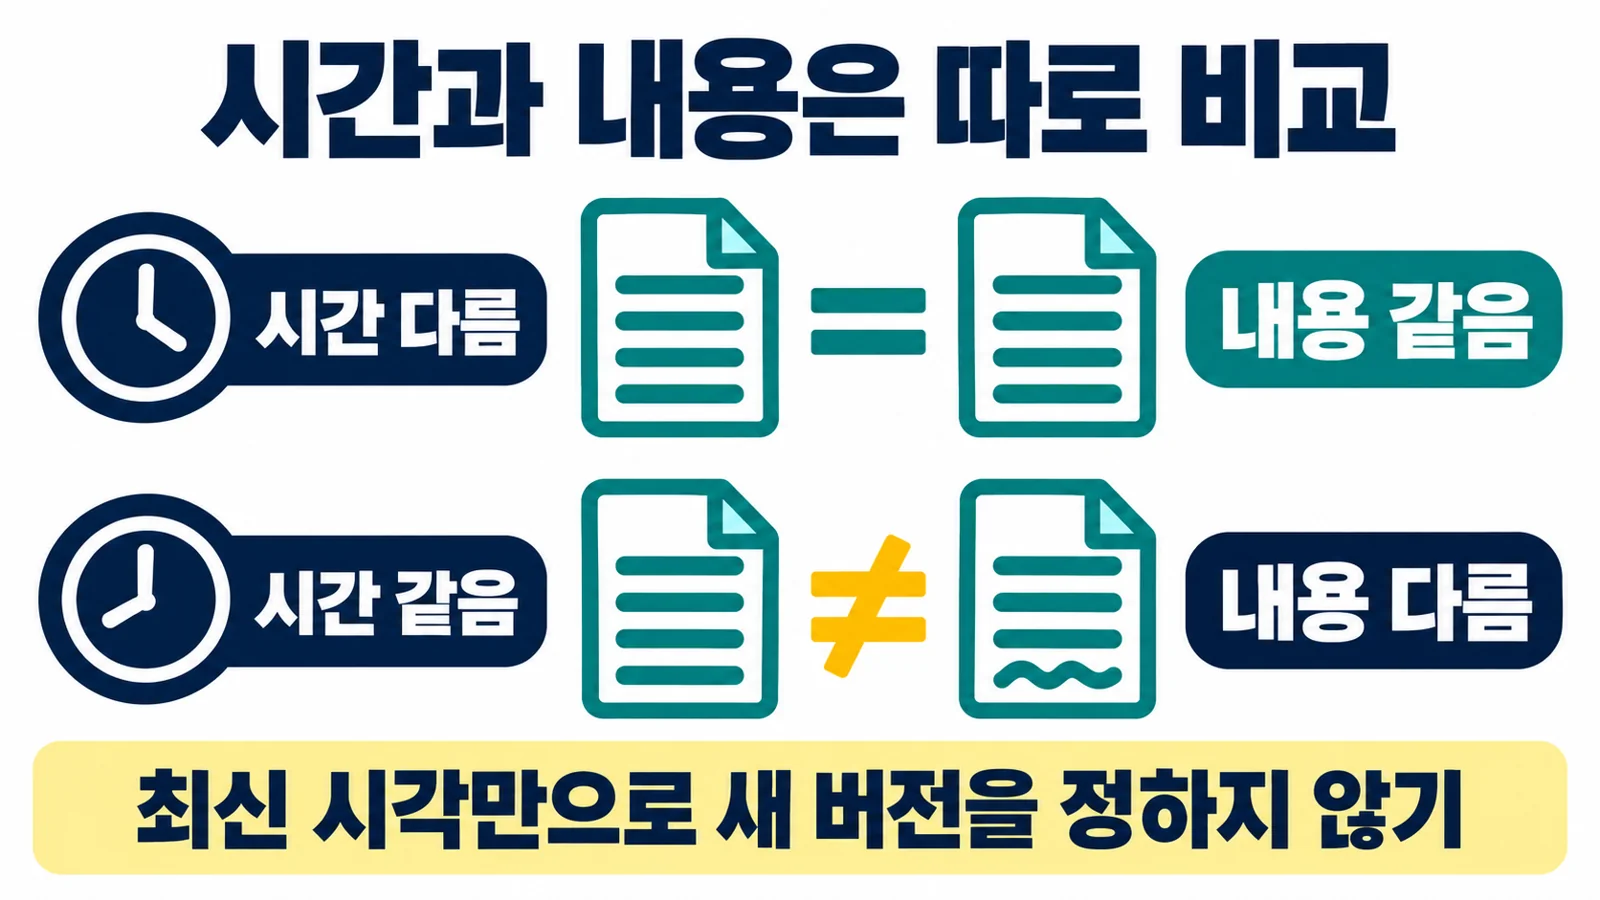
- 시간 다름 + 내용 같음: 수정 시간이 늦은 경로가 있어도 이 두 파일 사이에 바이트 차이는 없습니다. 시간 차이만을 새 내용의 증거로 세지 않습니다.
- 시간 같음 + 내용 다름: 수정 시각이 같아도 다른 바이트가 들어 있을 수 있습니다. 시간 일치만으로 변경 없음을 확정하지 않습니다.
- 시간 다름 + 내용 다름: 시각 순서와 바이트 차이는 모두 관측했지만, 어느 내용이 정확하거나 승인됐는지는 별도 정보가 필요합니다.
- 시간 같음 + 내용 같음: 이번에 읽은 두 사본의 시각·바이트가 일치합니다. 앞으로의 변경이나 업무상 동일한 보관 목적까지 보장하지는 않습니다.
2. 안전한 새 실습 폴더 준비하기
P39 코드·가상 입력·검산 기록 ZIP을 새 빈 폴더에 풀고 README.md가 있는 위치에서 터미널을 엽니다. 비교 코드는 Python 3.10 이상과 표준 라이브러리만 사용하며 추가 패키지는 설치하지 않습니다. 시간 고정 예제 생성기는 열린 파일의 FD로 시간을 설정하는 기능이 지원돼야 합니다. 미지원 환경에서는 새 폴더 생성 전에 멈춥니다. 실제로 검수한 예제 생성·비교 환경은 Linux이며, Windows에서 같은 생성 명령이 성공한다고 가정하지 마세요. 회사 원본, 네트워크 공유, 클라우드 동기화 폴더를 바로 지정하지 마세요.
먼저 아래 명령으로 버전을 확인하고 demo_01이라는 아직 없는 새 폴더에 합성 파일을 만듭니다. 생성기는 이 새 폴더의 가상 파일만 쓰고 수정 시간을 지정합니다. 같은 폴더를 다시 지정하면 덮어쓰지 않고 멈춥니다. 재실습할 때는 demo_02처럼 새 이름을 사용하세요.
python --version
python generate_demo.py demo_01
python -m unittest discover -s tests -v
명령이 없고 python3만 등록돼 있다면 모든 명령의 python을 python3으로 바꿉니다. ZIP은 파일 시각의 나노초 정밀도를 그대로 옮기는 보관 형식이 아니므로, 압축을 푼 참조 파일의 시각을 기준으로 결과를 맞추지 마세요. generate_demo.py가 만든 새 파일을 비교하고 fixture_manifest.json에 기록한 관측값을 확인합니다.
3. 네 파일의 입력과 기대값
생성기가 만드는 입력은 다음 네 개입니다. 줄 끝의 \n은 LF 줄바꿈 하나이며 모두 UTF-8입니다. 표기한 시각은 일부러 고정한 합성 입력의 값으로, 문서 작성·실험 날짜가 아닙니다.
same_content_old.txt: “이 파일은 수정 시간만 다릅니다.” 뒤에 줄바꿈. mtime_ns는1700000000000000000same_content_new.txt: 위 파일과 정확히 같은 바이트. mtime_ns는1700000010000000000, 즉 10초 늦음same_mtime_a.txt: “매출액: 120000” 뒤에 줄바꿈. mtime_ns는1700000000000000000same_mtime_b.txt: “매출액: 130000” 뒤에 줄바꿈. mtime_ns는 위 파일과 같음
첫 기준값을 UTC로 표시하면 2023-11-14 22:13:20, 한국시간으로는 다음 날 07:13:20입니다. 화면에 표시할 때만 시간대를 붙입니다. 비교 자체에는 부동소수점 초나 화면의 분 단위 표시 대신 정수 st_mtime_ns를 사용합니다. 단, 나노초 단위의 정수라는 사실이 파일 시스템의 실제 정밀도까지 나노초임을 뜻하지는 않습니다. Python 파일 상태 정보 문서
4. 두 쌍을 비교하고 새 CSV로 남기기
python compare_file_content.py demo_01/same_content_old.txt demo_01/same_content_new.txt --verify-bytes --output pair_01.csv
python compare_file_content.py demo_01/same_mtime_a.txt demo_01/same_mtime_b.txt --verify-bytes --output pair_02.csv
명령은 화면에 JSON을 출력하고 새 CSV도 만듭니다. CSV는 UTF-8 BOM을 붙이며 한 행에 두 파일의 경로·크기·수정 시간·해시·관계를 기록합니다. Excel에서 확인하려면 데이터 가져오기에서 first_mtime_ns·second_mtime_ns 열을 텍스트로 지정하세요. 19자리 값을 숫자로 열면 자릿수가 손실될 수 있습니다. 숫자처럼 보이는 두 값이 화면에서 같아졌다고 원래 정수까지 같다고 판정하지 마세요. Microsoft의 긴 숫자 보존 안내 --output을 생략하면 보고서 파일을 만들지 않고 화면으로만 확인합니다. 쉘의 >는 기존 파일을 덮어쓸 수 있으므로 여기서는 새 파일만 만드는 --output을 사용합니다.
아래는 전체 JSON 중 관계를 읽는 데 필요한 세 필드의 기대값입니다. 출력의 절대 경로는 독자가 압축을 푼 위치에 따라 달라집니다. 전체 필드와 입력 해시는 ZIP의 실행 기록·manifest에서 대조할 수 있습니다.
pair_01.csv
mtime_relation   = second_newer
digest_relation  = same
byte_relation    = same

pair_02.csv
mtime_relation   = same
digest_relation  = different
byte_relation    = different
second_newer는 두 번째 파일의 기록된 수정 시각이 늦다는 뜻입니다. 내용이 더 새롭거나 업무상 맞는 버전이라는 뜻은 아닙니다. 첫 쌍에서 바이트 관계까지 same이면 “새 수정 시각이지만 같은 내용”으로 정리하고, 둘째 쌍에서는 시각이 같아도 “다른 내용”으로 기록합니다.
5. SHA-256 일치와 바이트 확인을 구분하기
hashlib.sha256은 읽은 바이트의 해시를 만들고, update는 청크들을 순서대로 누적합니다. 코드의 기본 청크는 64KiB라 파일 전체를 한꺼번에 메모리에 올리지 않습니다. 화면에서 같은 글처럼 보여도 인코딩, LF·CRLF, 숨은 공백이 다르면 바이트 결과는 다를 수 있습니다.
기본 실행에서 digest_relation=same은 SHA-256 값 일치입니다. 그것만으로 수학적으로 완전한 동일성을 증명하지는 않습니다. 이 글의 두 명령은 모두 --verify-bytes를 넣습니다. 크기·해시가 같으면 두 파일을 끝까지 다시 읽어 실제 바이트를 확인합니다. 크기나 해시가 다르면 같은 바이트일 수 없으므로 byte_relation=different로 기록합니다. 옵션이 없으면 이 필드는 not_checked입니다.
실습 테스트는 해시를 일부러 같은 값으로 돌려주게 바꾼 뒤 다른 바이트를 판별하는지도 확인합니다. 이것은 실제 SHA-256 충돌을 만들어 냈다는 실험이 아닙니다. 짧게 읽힌 청크 길이가 달라져도 동일한 파일을 다르다고 오판하지 않도록, 요청한 길이 또는 실제 EOF까지 작은 버퍼를 채웁니다.
6. ZIP과 같은 전체 비교 코드
아래는 ZIP의 compare_file_content.py 전체입니다. 생성기와 자동 테스트는 ZIP에 함께 제공합니다. 코드에서 입력 파일은 읽기 전용으로 열고, 쓰기는 독자가 지정한 새 CSV에만 합니다.
#!/usr/bin/env python3
"""Compare two regular files without changing their bytes or choosing a winner.

Python 3.10+, standard library only. Deadline checks are cooperative.
"""
import argparse
import csv
import hashlib
import json
import math
import os
import stat
import sys
import time

VERSION = "1.0.0"
DEFAULT_MAX_BYTES = 64 * 1024 * 1024
DEFAULT_CHUNK_SIZE = 64 * 1024


class ComparisonError(Exception):
    """Unsafe path, changed file, exceeded limit, or operating-system error."""

def _linked(info):
    # Windows junctions and other reparse points are rejected too.
    return stat.S_ISLNK(info.st_mode) or bool(
        getattr(info, "st_file_attributes", 0) & 0x400)


def _key(info):
    return (info.st_dev, info.st_ino, info.st_size, info.st_mtime_ns,
            info.st_ctime_ns, info.st_nlink)


def _parent(path):
    """Walk original lexical components: inspect links BEFORE processing '..'."""
    try:
        raw = os.fspath(path)
    except TypeError as exc:
        raise ComparisonError("경로는 문자열 또는 Path여야 합니다.") from exc
    if not isinstance(raw, str) or not raw or "\0" in raw:
        raise ComparisonError("비어 있거나 잘못된 경로입니다.")
    if os.altsep:
        raw = raw.replace(os.altsep, os.sep)
    drive, tail = os.path.splitdrive(raw)
    if drive and not tail.startswith(os.sep):
        raise ComparisonError("드라이브 상대 경로는 지원하지 않습니다.")
    absolute = raw if os.path.isabs(raw) else os.path.join(os.getcwd(), raw)
    drive, tail = os.path.splitdrive(absolute)
    parts = [part for part in tail.split(os.sep) if part]
    if not parts or parts[-1] in (".", "..") or raw.endswith(os.sep):
        raise ComparisonError("일반 파일 이름까지 지정하세요.")
    root = drive + os.sep
    fd = None
    chain = []
    try:
        if os.name == "posix":
            fd = os.open(root, os.O_RDONLY | os.O_DIRECTORY | os.O_NOFOLLOW)
            info = os.fstat(fd)
        else:
            info = os.lstat(root)
        if _linked(info) or not stat.S_ISDIR(info.st_mode):
            raise ComparisonError("루트 경로가 안전한 디렉터리가 아닙니다.")
        chain.append((info.st_dev, info.st_ino))
        current = root
        for part in parts[:-1]:
            current = os.path.join(current, part)
            info = (os.stat(part, dir_fd=fd, follow_symlinks=False)
                    if fd is not None else os.lstat(current))
            if _linked(info) or not stat.S_ISDIR(info.st_mode):
                raise ComparisonError("상위 경로의 링크/일반 파일은 허용하지 않습니다.")
            if fd is not None:
                next_fd = os.open(part, os.O_RDONLY | os.O_DIRECTORY |
                                  os.O_NOFOLLOW, dir_fd=fd)
                opened = os.fstat(next_fd)
                if (opened.st_dev, opened.st_ino) != (info.st_dev, info.st_ino):
                    os.close(next_fd)
                    raise ComparisonError("경로가 검사 중 바뀌었습니다.")
                os.close(fd)
                fd = next_fd
            chain.append((info.st_dev, info.st_ino))
        return fd, parts[-1], absolute, tuple(chain)
    except BaseException:
        if fd is not None:
            os.close(fd)
        raise


def _open_file(path, new=False):
    parent_fd, leaf, absolute, chain = _parent(path)
    fd = None
    try:
        target = leaf if parent_fd is not None else absolute
        options = {"dir_fd": parent_fd} if parent_fd is not None else {}
        try:
            before = os.stat(target, follow_symlinks=False, **options)
        except FileNotFoundError:
            if not new:
                raise
            before = None
        if before is not None:
            if _linked(before) or not stat.S_ISREG(before.st_mode):
                raise ComparisonError("링크와 일반 파일 이외의 대상은 허용하지 않습니다.")
            if new:
                raise ComparisonError("CSV 대상이 이미 있습니다. 새 이름을 지정하세요.")
        flags = (os.O_WRONLY | os.O_CREAT | os.O_EXCL if new else os.O_RDONLY)
        flags |= getattr(os, "O_NOFOLLOW", 0) | getattr(os, "O_BINARY", 0)
        if not new:
            flags |= getattr(os, "O_NONBLOCK", 0)
        fd = os.open(target, flags, 0o600, **options)
        opened = os.fstat(fd)
        if _linked(opened) or not stat.S_ISREG(opened.st_mode):
            raise ComparisonError("열린 대상이 안전한 일반 파일이 아닙니다.")
        if before is not None and _key(before) != _key(opened):
            raise ComparisonError("파일이 열리는 동안 바뀌었습니다.")
        return fd, opened, absolute, chain
    except BaseException:
        if fd is not None:
            os.close(fd)
        raise
    finally:
        if parent_fd is not None:
            os.close(parent_fd)


def _verify(handle):
    fd, initial, path, chain = handle
    if _key(os.fstat(fd)) != _key(initial):
        raise ComparisonError("파일이 읽는 동안 바뀌었습니다. 다시 비교하세요.")
    fresh = _open_file(path)
    try:
        if _key(fresh[1]) != _key(initial) or fresh[3] != chain:
            raise ComparisonError("원래 경로의 파일/상위 디렉터리가 바뀌었습니다.")
    finally:
        os.close(fresh[0])


def compare_files(first, second, *, verify_bytes=False, output=None,
                  max_bytes=DEFAULT_MAX_BYTES, chunk_size=DEFAULT_CHUNK_SIZE,
                  timeout=10.0):
    """Read exactly two files; optionally create one NEW UTF-8-BOM CSV."""
    try:
        timeout = float(timeout) if type(timeout) in (int, float) else float("nan")
    except (ValueError, OverflowError) as exc:
        raise ComparisonError("시간 한도가 유한한 숫자가 아닙니다.") from exc
    if (type(max_bytes) is not int or max_bytes <= 0 or
            type(chunk_size) is not int or not 0 < chunk_size <= 1024 * 1024 or
            isinstance(timeout, bool) or not isinstance(timeout, (int, float)) or
            not math.isfinite(timeout) or timeout <= 0):
        raise ComparisonError("양의 바이트 한도, 1~1048576 청크 크기, 유한한 시간을 지정하세요.")
    deadline = time.monotonic() + timeout
    handles = []

    def check_time():
        if time.monotonic() >= deadline:
            raise ComparisonError("시간 한도를 초과했습니다. 결과를 확정하지 않습니다.")

    def read_block(fd, amount):
        data = bytearray()
        while len(data) < amount:
            check_time()
            part = os.read(fd, amount - len(data))
            check_time()
            if not part:
                break
            data.extend(part)
        return data

    def digest(handle):
        sha = hashlib.sha256()
        total = 0
        while True:
            check_time()
            data = os.read(handle[0], min(chunk_size, max_bytes - total + 1))
            check_time()
            total += len(data)
            if total > max_bytes:
                raise ComparisonError("파일당 바이트 한도를 초과했습니다.")
            if not data:
                break
            sha.update(data)
        if total != handle[1].st_size:
            raise ComparisonError("읽은 크기가 처음 크기와 다릅니다.")
        _verify(handle)
        return sha.hexdigest()

    try:
        for path in (first, second):
            check_time()
            handles.append(_open_file(path))
            if handles[-1][1].st_size > max_bytes:
                raise ComparisonError("파일당 바이트 한도를 초과했습니다.")
        a, b = handles
        first_hash, second_hash = digest(a), digest(b)
        same_digest = first_hash == second_hash
        byte_relation = "not_checked"
        if verify_bytes:
            byte_relation = "different"
            if a[1].st_size == b[1].st_size and same_digest:
                os.lseek(a[0], 0, os.SEEK_SET)
                os.lseek(b[0], 0, os.SEEK_SET)
                count = 0
                while True:
                    check_time()
                    amount = min(chunk_size, max_bytes - count + 1)
                    left, right = read_block(a[0], amount), read_block(b[0], amount)
                    check_time()
                    count += max(len(left), len(right))
                    if count > max_bytes:
                        raise ComparisonError("바이트 확인 한도를 초과했습니다.")
                    if left != right:
                        break
                    if not left:
                        if count != a[1].st_size:
                            raise ComparisonError("바이트 확인 중 읽은 크기가 다릅니다.")
                        byte_relation = "same"
                        break
        for handle in handles:
            check_time()
            _verify(handle)
        mtime_a, mtime_b = a[1].st_mtime_ns, b[1].st_mtime_ns
        result = {"first_path": os.path.abspath(a[2]), "second_path": os.path.abspath(b[2]),
                  "first_size": a[1].st_size, "second_size": b[1].st_size,
                  "first_mtime_ns": mtime_a, "second_mtime_ns": mtime_b,
                  "mtime_relation": "same" if mtime_a == mtime_b else
                  ("first_newer" if mtime_a > mtime_b else "second_newer"),
                  "first_sha256": first_hash, "second_sha256": second_hash,
                  "digest_relation": "same" if same_digest else "different",
                  "byte_relation": byte_relation}
        check_time()
        if output is not None:
            report = _open_file(output, new=True)
            with os.fdopen(report[0], "w", encoding="utf-8-sig", newline="") as stream:
                writer = csv.DictWriter(stream, fieldnames=list(result))
                writer.writeheader()
                writer.writerow(result)
                stream.flush()
                _verify((report[0], os.fstat(report[0]), report[2], report[3]))
                check_time()
        return result
    except OSError as exc:
        raise ComparisonError(f"운영체제 오류: {exc}") from exc
    finally:
        for handle in handles:
            os.close(handle[0])


def main(argv=None):
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("first")
    parser.add_argument("second")
    parser.add_argument("--verify-bytes", action="store_true")
    parser.add_argument("--output", help="존재하지 않는 새 CSV 경로")
    parser.add_argument("--max-mib", type=int, default=64)
    parser.add_argument("--chunk-kib", type=int, default=64)
    parser.add_argument("--timeout", type=float, default=10.0)
    args = parser.parse_args(argv)
    try:
        result = compare_files(args.first, args.second, verify_bytes=args.verify_bytes,
                               output=args.output, max_bytes=args.max_mib * 1024 * 1024,
                               chunk_size=args.chunk_kib * 1024, timeout=args.timeout)
    except ComparisonError as exc:
        print(f"비교 중단: {exc}", file=sys.stderr)
        return 2
    print(json.dumps(result, ensure_ascii=False, indent=2))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
7. 오류가 나면 결과를 확정하지 않기
- 기존 CSV가 있음: 기존 보고서는 그대로 두고
--output pair_03.csv처럼 새 이름을 씁니다. 입력과 같은 경로·하드 링크 별칭도 기존 파일이므로 덮어쓰지 않습니다. - 파일을 찾을 수 없음: 터미널 위치와
demo_01생성 성공을 확인합니다. 공백이 들어간 경로는 큰따옴표로 감쌉니다. - 링크·재분석 지점·일반 파일 이외의 대상: 링크를 따라가지 않고 멈춥니다. 링크 폴더 뒤에
..를 붙여도 먼저 링크를 검사합니다. 자신이 새로 만든 일반 파일의 직접 경로를 지정하세요. - 읽는 동안 파일이나 경로가 바뀜: 쓰기·저장·동기화를 멈춘 로컬 사본으로 다시 실행합니다. 원래 두 파일과 기존 보고서는 보존합니다.
- 읽기 권한·잠금 오류: 자신에게 읽기 권한이 있는 실습 사본인지 확인하고 파일을 사용하는 앱을 닫습니다. 관리자 권한이나 보안 설정 변경으로 우회하지 않습니다.
- 64MiB 또는 시간 한도 초과: 기본은 파일당 64MiB, 전체 비교의 협조적 시간 점검 10초입니다. 우선 작은 합성 예제로 확인하고, 필요한 로컬 사본에 한해서 명시한 옵션을 조정합니다. 무제한 검사 옵션은 없습니다.
python compare_file_content.py "내 연습/파일 A.txt" "내 연습/파일 B.txt" --verify-bytes --max-mib 16 --chunk-kib 64 --timeout 5
종료 코드 0은 이번 비교 완료, 2는 인수·경로·읽기·한도·저장 오류입니다. 두 파일의 내용이 달라도 비교를 정상 완료했다면 0입니다. 저장 중 오류 뒤 새 CSV의 일부가 남을 수 있으므로, 오류가 난 출력은 완료 보고서로 쓰지 말고 새 이름으로 재실행합니다. 코드는 실패한 부분 파일을 자동 삭제하지 않습니다.
시간 제한은 읽기·검사 사이에서 확인하는 협조적 한도입니다. 운영체제 안에서 멈춘 읽기·열기 자체를 정해진 초에 강제 중단하는 장치가 아닙니다. 따라서 네트워크 파일, 특수 파일, 적대적인 동시 경로 교체를 안전하게 검사하는 도구로 쓰지 마세요.
8. 실제 검수 범위와 원본 보존
2026-10-10 한국시간에 CPython 3.12.14·Linux에서 합성 입력과 47개 자동 테스트를 실제 실행했습니다. 같은 내용·다른 시간, 같은 시간·다른 내용, 빈 파일, 한글 경로, 같은 크기의 다른 바이트, 청크 경계, 짧은 읽기, 링크 조상과 .., 특수 파일, 입력/출력 별칭, 읽는 중 변경, 크기·시간 한도, 생성기 재실행 거부를 확인했습니다. Windows·macOS·Excel 실환경 실행은 하지 않았습니다.
정상 비교·CSV 저장 및 오류 시험 전후에 합성 입력의 SHA-256을 대조해 바이트 보존을 확인했습니다. 운영체제가 읽기에 따라 접근 시간(atime)을 갱신할 수 있으므로 모든 메타데이터가 불변이라고 표현하지 않습니다. Windows 재분석 지점을 거부하는 분기는 작성했지만 Linux 링크 시험을 Windows 성공으로 대신 주장하지 않습니다.
파일 상태의 재확인은 관측된 변경을 찾는 방어입니다. 원자적 스냅샷이나 잠금이 아니므로 검사 뒤의 변경, 내용이 바뀌었다가 돌아온 경우, 낮은 시각 정밀도까지 모두 찾는다고 보장하지 않습니다. 두 XLSX의 바이트가 다르더라도 시트 값이 같은지까지 알 수 없습니다. 이 글은 문서 의미 비교가 아니라 두 파일의 바이트 변경 여부를 확인합니다.
9. 다음 판단과 참고 자료
폴더 전체에서 같은 바이트의 경로를 묶고 싶다면 내용이 같은 파일의 중복 목록 만들기를 참고하세요. 이 글은 비교할 두 파일을 지정하고 시간과 내용의 불일치를 확인합니다. 내용은 읽지 않고 폴더 범위를 기록하는 깊이별 파일 목록, 버전 문자열의 규칙을 비교하는 v1.9와 v1.10 버전 비교와도 판단 대상이 다릅니다.
업무상 정답을 고를 때는 수정 시간 외에 승인자, 저장 이력, 원본 출처, 변경 이유를 함께 확인하세요. 같은 바이트의 파일 두 개에도 별도 보관 이유가 있을 수 있습니다. 이 비교 보고서만으로 자동 삭제·덮어쓰기·최종본 승인을 연결하지 않습니다.
실습 ZIP 다운로드: 전체 비교 코드, 새 합성 폴더 생성기, 기대 CSV, 47개 테스트, 실제 실행 기록, 파일 목록과 SHA-256을 제공합니다. 공식 자료는 2026-10-10 KST에 Python 3.12 계열 문서로 재확인했습니다. 문서 페이지 표기는 3.12.15이며 실제 실행한 인터프리터는 3.12.14입니다.
- Python os: st_mtime_ns, 파일 시각의 정밀도와 상태 정보
- Python hashlib: SHA-256과 update·hexdigest
- Python shutil: copy·copy2의 메타데이터 차이
- Python os.open: 읽기 전용 열기와 O_CREAT·O_EXCL 플래그
작성자 소개
