Python으로 반품 CSV 검산하기: 품목 합계는 맞아도 원판매 수량을 넘긴 반품 찾기
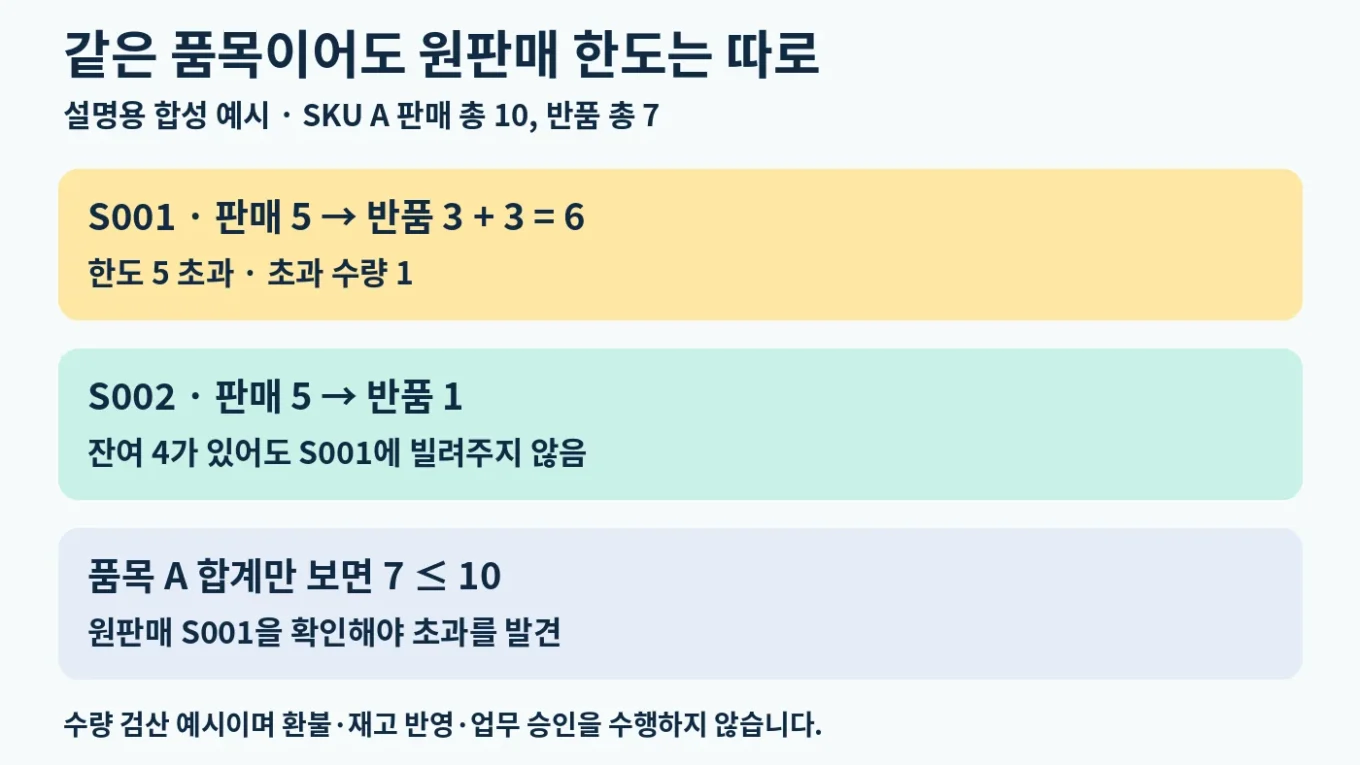
같은 품목 A를 두 번에 나누어 5개씩 팔았다고 해봅시다. 첫 번째 판매 행 S001에 반품 3개와 3개가 연결되고, 두 번째 판매 행 S002에는 반품 1개가 연결됐습니다. 품목 A만 합치면 판매 10개, 반품 7개입니다. 반품 한 건도 5개를 넘지 않습니다. 그런데 S001에는 판매한 5개보다 많은 6개가 돌아온 것으로 기록돼 있습니다.
이 오류는 판매 합계 - 반품 합계만 계산해서는 찾을 수 없습니다. 반품이 가리키는 원판매 행별로 누적 수량을 확인해야 합니다. 같은 SKU라는 이유로 S002의 남은 수량을 S001에 보태면 안 됩니다. 이번 실습에서는 Python 표준 라이브러리로 이 검사를 만들고, 문제가 있는 원판매 행과 연결된 반품 ID를 함께 남깁니다.
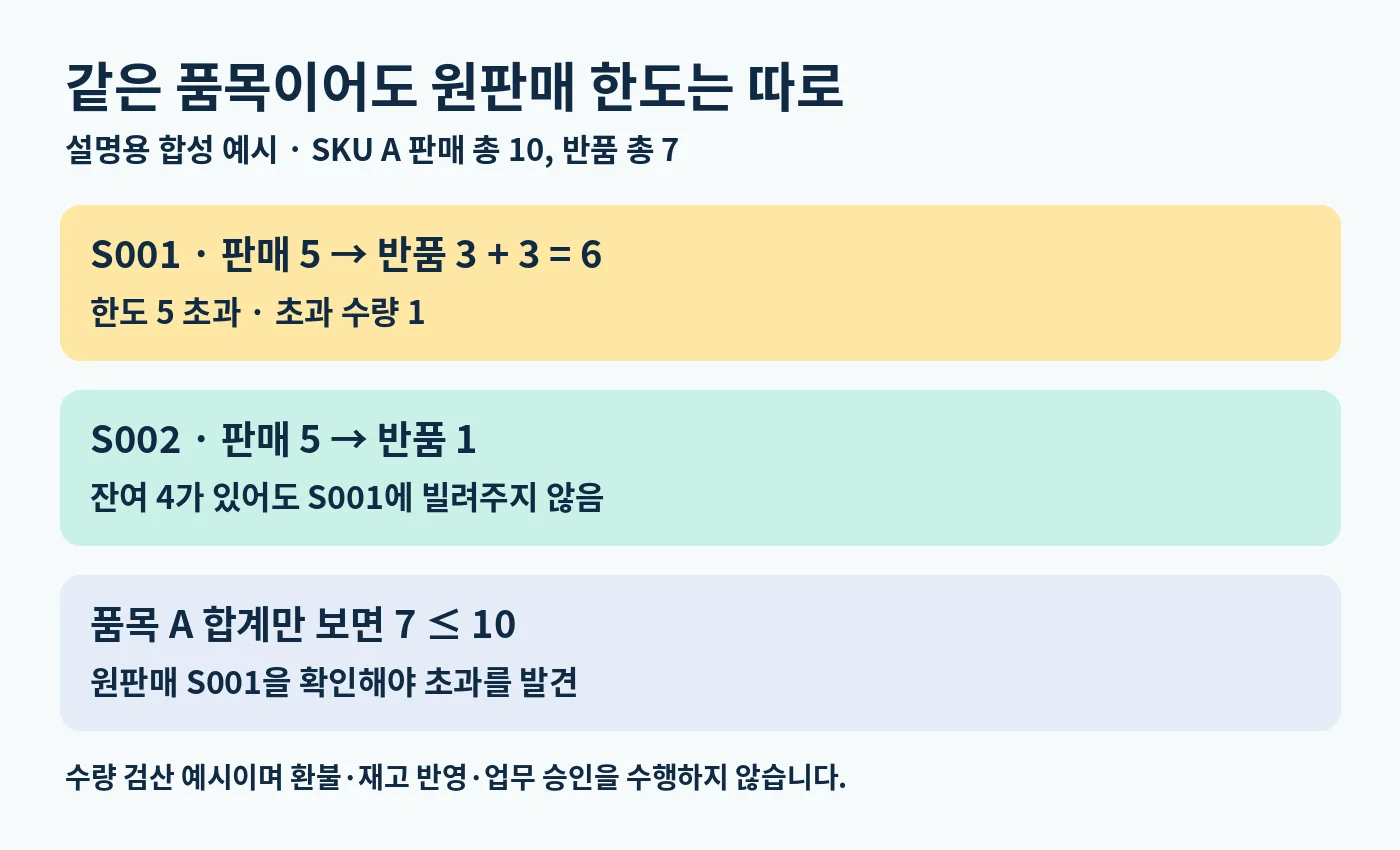
그림 1. 같은 SKU의 판매 두 건은 서로의 반품 한도를 빌려 쓸 수 없습니다. 가상 예제 설명도입니다.
어떤 자료를 검사하나요
판매 한 줄의 고유 번호를 sale_line_id라고 부르겠습니다. 주문번호 하나에 여러 품목이 들어갈 수 있으므로, 여기서는 주문 전체가 아닌 판매 행 하나를 정확히 가리키는 번호가 필요합니다. sku는 품목 코드입니다.
아래 자료는 모두 가상 데이터입니다. 단위는 EA(개) 하나이며, 수량은 양의 정수만 허용합니다. 판매와 반품은 이 실습에서 이미 확정된 기록으로 가정합니다. 프로그램이 반품의 실제 승인 여부를 판단하지는 않습니다.
또한 반품 파일은 해당 원판매 행에 대한 검사 시점까지의 누적 전체 자료여야 합니다. 이번 달 반품만 넣고 지난달 반품을 빠뜨리면 이 프로그램이 누락된 수량을 알아낼 수 없습니다. 수량이 소수인 중량 상품, 박스와 낱개가 섞인 자료는 단위와 규칙부터 별도로 정해야 합니다.
fixtures/sales.csv의 내용입니다.
sale_line_id,sku,sold_qty
S001,A,5
S002,A,5
S003,B,4
각 열은 원판매 행 ID, 품목 코드, 판매 수량입니다. 정상 반품 자료인 fixtures/returns_normal.csv는 다음과 같습니다.
return_id,sale_line_id,sku,return_qty
R001,S001,A,3
R002,S001,A,2
R003,S002,A,1
R004,S003,B,4return_id는 반품 기록의 고유 번호입니다. R001과 R002는 서로 다른 반품이지만 같은 원판매 행 S001을 가리킵니다. 따라서 두 수량을 합친 5개를 S001의 판매 수량 5개와 비교합니다. SKU만으로 원판매 행을 추정하거나, 빈 ID에 다른 판매를 임의로 연결하지 않습니다.
검사는 원판매 행에서 시작합니다
검사 순서는 다음과 같습니다.
- 판매 파일의 열과 값을 검사하고, 중복 없는 원판매 행 목록을 만듭니다.
- 반품 ID의 중복, 원판매 행 존재 여부, SKU 일치, 수량 형식을 확인합니다.
- 같은 원판매 행에 연결된 반품을 모두 모아 수량을 합칩니다.
- 반품 합계가 원판매 수량을 넘으면 해당 원판매 행 전체를 HOLD로 표시합니다.
- 보류·오류가 하나도 없을 때만 전체 최종 합계를 제공합니다.
Microsoft의 Dynamics 365 Sales returns 문서도 반품 행에서 원래 청구된 판매 행을 참조하고, 그 참조로 판매 수량을 넘는 반품 주문을 검증한다고 설명합니다. 여기서는 그 관계를 참고해 간단한 CSV 실습 규칙을 정했습니다. Dynamics 365의 기능을 그대로 재현하거나 실제 시스템에서 검증한 프로그램은 아닙니다.
반품 수량을 양수로 읽는 일과 업무 관계를 검사하는 일은 다릅니다. Python 3.14의 csv 문서는 CSV 행을 읽고 쓰는 방법을 설명합니다. 원판매 행의 존재, SKU 일치, 누적 수량 상한은 우리가 따로 구현해야 합니다.
실습 파일을 준비하고 실행합니다
원판매 행별 반품 검산 실습 ZIP 내려받기 (9 KB)
실습 ZIP에는 실행 코드, 정상·초과 CSV, 예상 결과 JSON, README와 자동 시험 파일이 들어 있습니다. Python 3.10 이상에서 사용할 수 있도록 작성됐으며, 아래 검증에 실제 사용한 버전은 3.12.14입니다. ZIP을 내려받아 압축을 풉니다. 폴더 안의 validate_returns.py와 fixtures 폴더를 함께 둡니다. 실행 파일 하나만 다른 폴더로 옮기면 아래 상대 경로가 맞지 않습니다. 별도 패키지를 설치하지 않고 Python으로 실행하는 예제입니다.
Windows에서는 압축을 푼 폴더를 열고 주소 표시줄에 powershell을 입력해 터미널을 열 수 있습니다. 먼저 아래 명령으로 Python 실행 여부를 확인합니다.
python --versionpython 명령을 찾지 못하지만 Python 실행기 py가 설치돼 있다면 아래 명령들의 맨 앞 python을 py -3으로 바꿉니다. 둘 다 없다면 Python을 설치한 뒤 새 터미널에서 다시 확인합니다. 이 글의 Windows 명령 안내는 실행 방법이며, 별도의 Windows 실기 검증 결과를 뜻하지 않습니다.
정상 자료부터 실행합니다. 명령은 한 줄로 입력합니다.
python validate_returns.py --sales fixtures/sales.csv --returns fixtures/returns_normal.csv --output report_normal.json출력 이름은 아직 없는 파일명을 지정합니다. 기존 결과를 덮어쓰지 않도록 만든 프로그램이므로 재실행할 때는 report_normal_2.json처럼 새 이름을 씁니다. 원본 CSV를 출력 경로로 지정하지 않습니다.
기본 입력 인코딩은 UTF-8이며 BOM이 있는 UTF-8도 읽습니다. Excel에서 저장한다면 CSV UTF-8 형식을 선택하고 열 이름과 ID가 바뀌지 않았는지 텍스트로 확인합니다. 실제로 CP949로 저장한 파일을 읽어야 한다면 명령 끝에 --encoding cp949를 붙입니다. 깨진 글자를 억지로 무시하거나 자동으로 인코딩을 추측하지 않습니다.
정상 결과에서 세 가지 합계를 맞춥니다
정상 자료의 원판매 행별 결과는 다음과 같습니다. 순서대로 판매 수량 / 누적 반품 수량 / 남은 수량입니다.
- S001: 5 / 5 / 0
- S002: 5 / 1 / 4
- S003: 4 / 4 / 0
SKU A는 10 / 6 / 4, SKU B는 4 / 4 / 0입니다. 전체는 판매 14개, 반품 10개, 남은 수량 4개가 됩니다. 남은 수량은 이 자료에서 판매 수량에서 반품 수량을 뺀 값입니다. 창고 재고나 현재 판매 가능 수량을 뜻하지 않습니다.
실행 메시지가 COMPLETE이면 결과 JSON에서 complete가 true인지, final_totals가 다음 값인지 확인합니다.
"final_totals": {
  "remaining_qty": 4,
  "return_qty": 10,
  "sold_qty": 14
}
위 내용은 JSON 일부입니다. 반품 추적 자료에서는 R001부터 R004까지 각 ID가 정확히 한 번씩 나타나야 합니다. 합계만 맞는지 보지 말고, R001과 R002가 둘 다 S001에 연결돼 있는지도 확인합니다.
R002를 3개로 바꾸면 왜 보류되나요
오류 예제인 fixtures/returns_overlimit.csv는 정상 자료에서 R002의 수량만 2에서 3으로 바꾼 파일입니다. 직접 만들 때도 원본을 수정하기보다 복사본을 사용합니다.
python validate_returns.py --sales fixtures/sales.csv --returns fixtures/returns_overlimit.csv --output report_overlimit.json이 경우 S001의 누적 반품은 R001 3개 + R002 3개 = 6개입니다. 원판매 5개보다 1개 초과합니다. S001에 연결된 R001과 R002를 모두 보류하고, 조사할 때 두 ID와 초과 수량을 함께 확인할 수 있게 합니다.
그런데 품목 A의 반품 합계는 7개이고 판매 합계는 10개입니다. 전체 판매 14개에서 반품 11개를 빼도 3개가 남습니다. 이 숫자가 음수가 아니라고 해서 자료가 유효한 것은 아닙니다. S002의 여유 수량은 S001의 상한을 늘려 주지 않습니다.
실행 메시지는 FINDINGS: final_totals withheld입니다. 결과의 complete는 false이고, held에는 S001의 RETURN_CAPACITY_EXCEEDED 사유와 excess_qty: 1이 남습니다. 이때 final_totals는 null입니다. 최종 합계를 확정할 수 없다는 뜻입니다. 보류되지 않은 S002·S003만 모은 부분 합계는 판매 9개, 반품 5개, 남은 수량 4개지만, 이것을 전체 결과로 사용하면 안 됩니다. S001이 빠진 범위라는 점이 중요합니다.
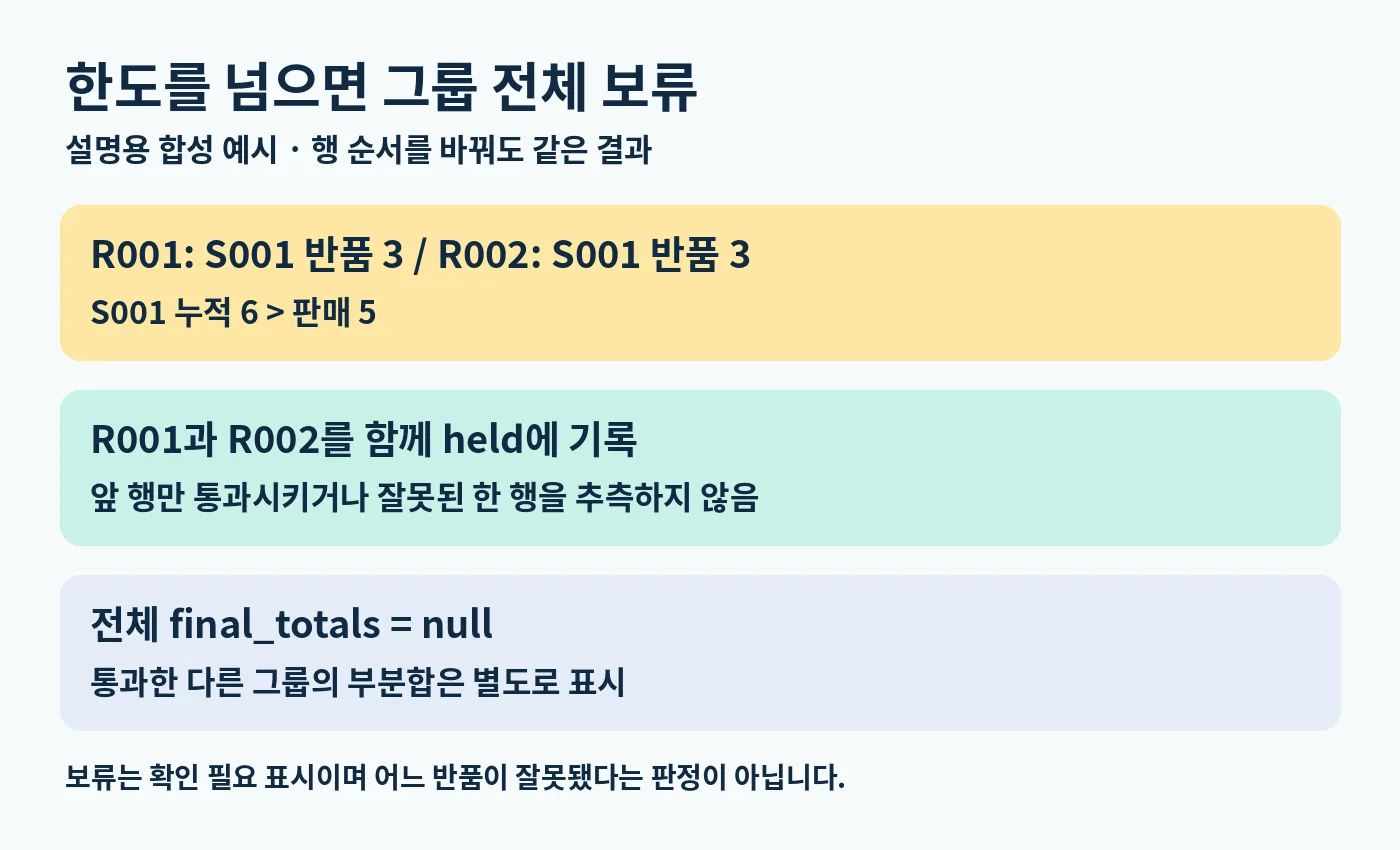
그림 2. 초과 그룹의 모든 반품 ID를 조사 대상으로 남깁니다. 실제 앱 화면이 아닌 가상 예제 설명도입니다.
R001을 먼저 읽었으니 통과시키고, 나중의 R002만 잘못됐다고 정하지도 않습니다. 파일 순서를 뒤집어도 같은 원판매 행과 두 반품 ID가 보류돼야 합니다. 수량 초과는 찾았지만 둘 중 어느 기록이 잘못됐는지는 이 자료만으로 알 수 없기 때문입니다.
수량 초과와 입력 오류를 구분합니다
프로그램의 종료 코드는 세 가지입니다. PowerShell에서는 실행 직후 $LASTEXITCODE로 확인할 수 있습니다.
0: 정해 둔 검사를 통과했고 최종 합계가 있습니다.1: 진단 결과 파일이 만들어졌지만 보류나 검증 문제가 있어 최종 합계는 없습니다.2: 파일·헤더·판매 기준 자료·출력 경로 등에 문제가 있어 정상 보고서를 만들지 못했습니다. 이 코드로 끝난 결과는 사용하지 않습니다. 저장장치 오류라면 생성 중인 파일이 불완전하게 남을 수도 있습니다.
오류가 났다면 먼저 메시지와 결과 파일 생성 여부를 봅니다. 예전 실행에서 만든 파일을 이번 결과로 착각하지 않도록 실행마다 새 출력 이름을 쓰세요.
다음 항목도 검사 대상입니다.
- 없는 원판매 행 ID: 비슷한 번호에 자동 연결하지 말고 원자료에서 관계를 확인합니다.
- SKU 불일치: 판매 행은 A인데 반품에 B가 적혔다면 품목 코드나 참조 ID를 확인합니다.
- 중복 반품 ID: 같은 기록을 두 번 가져왔는지 확인합니다. 프로그램이 임의로 한 줄을 지우지 않습니다.
- 중복 원판매 행 ID: 기준 자료의 행을 하나로 특정할 수 없으므로 판매 파일부터 고칩니다.
- 빈 값이나 잘못된 수량:
0, 음수,1.5,NaN,True는 허용하지 않습니다.
수량 문자열은 첫 자리가 1~9인 ASCII 숫자만 허용하며 최대 100자리입니다. 01, +1, 1.0, 1,000, 앞뒤 공백도 자동 변환하지 않습니다. ID는 대소문자를 구분하고 앞자리 0을 보존합니다. 공백을 지우거나 SKU 대소문자를 통일하려면 원자료 기준을 먼저 확인해야 합니다.
헤더만 있는 반품 파일은 반품 0건으로 처리할 수 있습니다. 정상 판매 14개가 있다면 반품 0개, 남은 수량 14개입니다. 반면 헤더만 있는 판매 파일은 기준 판매 행이 없으므로 종료 코드 2로 중단하고 결과 파일을 만들지 않습니다. 빈 줄, 헤더 순서 변경, 여분 열도 허용하지 않습니다.
고칠 때는 합계를 맞추기보다 원자료를 확인합니다
S001이 보류되면 판매 수량을 6으로 늘리거나 R002를 S002로 옮겨 숫자만 맞추지 않습니다. 원판매 내역과 R001·R002의 근거를 확인해 판매 수량, 반품 수량, 참조 ID 중 무엇이 잘못됐는지 판단합니다. 이 예제에서는 교육용으로 R002를 2로 되돌리면 정상 자료와 같아집니다. 실제 자료에서 같은 수정이 맞다는 뜻은 아닙니다.
수정한 CSV는 새 이름으로 보관하고, 새 결과 파일로 다시 실행합니다. 최종 합계가 생겼는지, 해당 원판매 행의 누적 수량이 한도 안인지, 반품 ID가 빠지지 않았는지 확인합니다. PASS 역시 주어진 자료와 이 실습 규칙을 통과했다는 뜻이며, 원자료의 완전성이나 실제 반품 승인까지 증명하지 않습니다.
코드에서 중요한 부분
전체 실행 코드는 ZIP의 validate_returns.py에 있습니다. 아래는 실행 파일에서 원판매 행별 누적 수량과 보류 사유를 만드는 실제 부분입니다. 앞에서 만든 sales, rows, issues 등을 사용하므로 이 발췌만으로는 실행되지 않습니다. 입력 검증과 결과 저장까지 포함된 전체 파일은 ZIP을 사용하세요.
        known_sum = sum(int(row['raw_return_qty']) for row in rows if QUANTITY.fullmatch(row['raw_return_qty']))
        # Partial numeric sums do not become validated totals if any row is invalid.
        qty = known_sum if not issues else None
        excess = max(0, qty - sale['sold_qty']) if qty is not None else None
        if excess: issues.append('RETURN_CAPACITY_EXCEEDED')
핵심은 누적 반품을 모두 합친 다음 원판매 수량과 비교한다는 점입니다. 이 전에 원판매 행이 존재하고 SKU가 맞는지 검사해야 합니다. SKU 합계는 원판매 행 검사를 통과한 뒤 결과를 대조하는 용도로 씁니다.
청구서와 입금액을 연결해 잔액을 구하는 예제에서는 초과 입금도 기록할 수 있는 계산 결과입니다. 이번 실습의 규칙에서는 원판매 행의 판매 수량이 반품 수량의 상한입니다. 같은 품목의 다른 판매 행에서 남은 수량을 가져올 수도 없습니다. 따라서 단순히 두 파일을 연결하고 차이를 구하는 데서 검사를 끝내면 안 됩니다.
실습을 마치며 확인할 것
- 정상 자료에서 전체 14 / 10 / 4가 나오는가
- R002가 3이면 S001과 R001·R002가 함께 보류되는가
- 보류 결과의
final_totals가null인가 - 같은 반품 행의 순서만 바꿔도 판정과 수량은 같은가
- 없는 원판매 행, SKU 불일치, 중복 ID를 임의로 고치지 않는가
품목 합계는 전체 규모를 확인하는 데 유용합니다. 반품이 실제로 어느 판매 행의 수량을 사용했는지는 더 작은 단위로 확인해야 합니다. 이 두 검사를 구분하는 것이 이번 실습의 목적입니다.
첨부 프로그램은 Linux의 Python 3.12.14에서 15개 자동 시험 메서드를 실행했습니다. 정상·초과 예제, 중복 ID와 관계 오류, 수량 형식, 인코딩, 출력 덮어쓰기 방지, 입력 파일 불변 등을 확인했습니다. 정상 및 초과 반품 자료 각각 24가지 행 순열도 같은 JSON 결과인지 검사했습니다. Windows, Excel, ERP에서의 실행 결과는 아닙니다.
ZIP을 푼 폴더에서 python test_validator.py를 실행하면 이 자동 시험을 재현할 수 있습니다. 시험이 실패했다면 실무 자료에 적용하기 전에 오류를 확인하세요.
자료 및 코드 확인 기준일: 2026년 10월 15일(KST). 공식 문서 확인일과 실제 실행 검증 범위는 발행 날짜와 별도로 관리합니다.
작성자 소개
