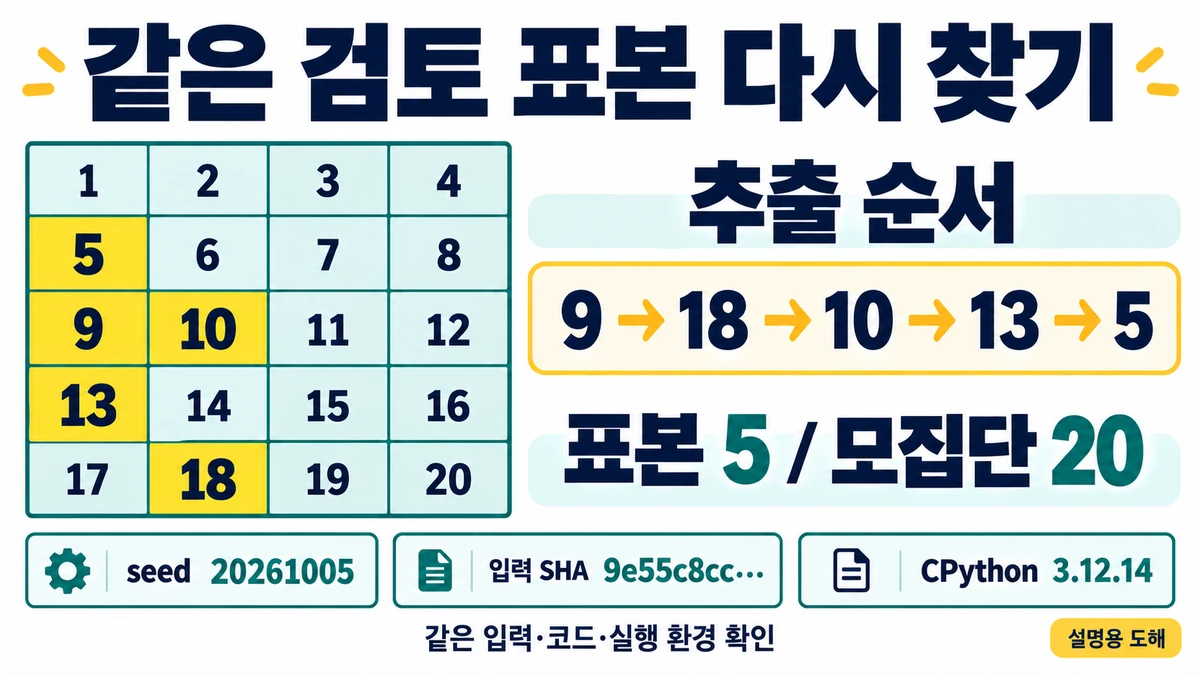
Python으로 검토 표본 5행을 뽑고 같은 행 다시 찾기
20행 중 5행을 골라 검토했는데 다음 날 다시 실행하니 다른 행이 나왔다면, 검토 결과를 비교하기 어렵습니다. 정수 seed와 입력 파일의 SHA256, Python 실행 환경, 선택된 ID를 함께 남기면 같은 조건의 표본을 다시 확인할 수 있습니다. seed만 같다고 재현이 끝난 것은 아닙니다.
이 실습에서는 ID 1~20의 가상 모집단에서 5행을 중복 없이 뽑고, 원행번호와 함께 CSV로 저장합니다. 기록을 이용해 같은 표본을 다시 만들고, 입력 순서나 값이 바뀌었을 때 예전 기록을 재사용하지 못하도록 막습니다. 패키지 설치나 외부 서비스 연결은 필요 없습니다.
검토할 모집단을 먼저 고정하기
ZIP의 fixtures/population_v1.csv는 아래 20행입니다. item과 amount는 직접 만든 가상 값이며 실제 업무 자료가 아닙니다. id는 숫자 계산용 값이 아니라 행을 구별하는 텍스트 식별자로 읽습니다.
id,item,amount
1,검토항목01,1000
2,검토항목02,2000
3,검토항목03,3000
4,검토항목04,4000
5,검토항목05,5000
6,검토항목06,6000
7,검토항목07,7000
8,검토항목08,8000
9,검토항목09,9000
10,검토항목10,10000
11,검토항목11,11000
12,검토항목12,12000
13,검토항목13,13000
14,검토항목14,14000
15,검토항목15,15000
16,검토항목16,16000
17,검토항목17,17000
18,검토항목18,18000
19,검토항목19,19000
20,검토항목20,20000
헤더 순서는 id,item,amount입니다. 빈 ID, ID 앞뒤 공백, 중복 ID, 열 수가 다른 행은 추출 전에 거부합니다. 같은 고객에게 여러 거래가 있다면 고객 ID만으로는 행을 고유하게 식별할 수 없으므로 거래 행 ID 같은 별도 기준이 필요합니다. 중복을 없애겠다고 먼저 행을 삭제하지 마세요.
이 예제는 입력 파일을 한 번 바이트로 읽은 뒤 그 스냅샷에서 SHA256과 CSV를 함께 만듭니다. 같은 표라도 행 순서, 줄바꿈이나 UTF-8 BOM이 달라지면 다른 입력 버전으로 봅니다. hashlib 공식 문서는 바이트에서 SHA256 요약을 얻는 사용법을 설명합니다. 해시는 입력 식별용이며 작성자 인증이나 데이터의 사실성 검증을 대신하지 않습니다.
첫 표본을 새 폴더에 저장하기
ZIP을 새 연습 폴더에 풀고 그 폴더에서 터미널을 엽니다. Python 명령이 없다면 설치 상태부터 확인하고, 자신의 환경에서 쓰는 python3 같은 명령으로 일관되게 바꿉니다. 아래 work, run1, run2는 아직 없는 이름을 사용합니다.
python --version
mkdir work
python code/sample_review.py sample fixtures/population_v1.csv work/run1 --n 5 --seed 20261005
검증한 Linux CPython 3.12.14에서는 ID가 9, 18, 10, 13, 5 순서로 뽑혔습니다. 선택 순서를 보존하며 ID순으로 다시 정렬하지 않습니다.
| 추출 순서 | 원행번호 | ID | item | amount |
|---|---|---|---|---|
| 1 | 10 | 9 | 검토항목09 | 9000 |
| 2 | 19 | 18 | 검토항목18 | 18000 |
| 3 | 11 | 10 | 검토항목10 | 10000 |
| 4 | 14 | 13 | 검토항목13 | 13000 |
| 5 | 6 | 5 | 검토항목05 | 5000 |
원행번호는 헤더를 1행으로 세는 CSV 논리 레코드 번호입니다. 첫 데이터는 2행이며 ID 9는 10행입니다. 값 안에 줄바꿈이 들어가면 텍스트 편집기의 물리적인 줄 번호와 다를 수 있습니다. csv 모듈로 필드를 읽고 쓰므로 쉼표·따옴표·필드 안 줄바꿈을 단순 문자열 나누기로 처리하지 않습니다. csv 공식 문서
work/run1에는 두 파일이 생깁니다.
- sample.csv: 추출 순서·원행번호·원래 세 열의 값을 담은 UTF-8 BOM CSV
- sample_record.json: 모집단 버전과 재현 조건을 담은 기록
기록에는 입력 SHA256, 입력 크기 477바이트, 모집단 20행, 표본 5행, seed 20261005, Python 구현·버전·빌드, random 모듈 SHA, 코드 SHA, 표본 ID와 원행번호, 출력 CSV SHA가 들어갑니다. 이 입력의 SHA256은 다음과 같습니다.
9e55c8cc1b2e31a553545bf48ad12dfe0ac742727ecdece77e073426a9706028파일 크기나 ID만 맞다고 기록을 바꾸지 않습니다. 다음 단계에서 처음 저장한 기록 전체를 대조합니다.
저장한 기록으로 같은 표본 다시 만들기
python code/sample_review.py replay fixtures/population_v1.csv work/run1/sample_record.json work/run2
python tests/compare_runs.py work/run1 work/run2
replay는 기록의 seed와 표본 크기로 새 결과를 계산한 뒤 입력 SHA, Python 런타임, 코드 SHA, 선택된 ID·원행번호·출력 SHA를 대조합니다. 하나라도 다르면 새 결과 저장 전에 중단합니다. 같은 조건에서는 두 폴더의 sample.csv와 sample_record.json이 바이트까지 같아야 합니다.
표본 선택에는 전역 random 상태 대신 새로 만든 random.Random(seed)를 사용합니다. 다른 코드에서 난수를 한 번 사용했더라도 이 추출의 시작 상태가 달라지지 않습니다. random.sample 공식 문서에 따르면 sample은 원본을 바꾸지 않고 비복원 표본을 새 목록으로 반환합니다. 함수 자체는 중복 원소도 허용하므로 이 예제의 고유 ID 검사는 추출 전에 별도로 합니다.
모든 Python 버전에서 같은 ID가 나온다는 뜻은 아닙니다. Python 공식 문서는 random 모듈의 대부분의 알고리즘이 버전 사이에 바뀔 수 있다고 설명합니다. 호환 seed 방식과 random() 난수열에 관한 보장은 random.sample 결과의 버전 간 불변 보장이 아닙니다. 재현성 안내
이 코드는 Python 버전 외에도 구현 이름, 빌드 문자열, random.py의 SHA를 확인합니다. 다른 빌드에서 같은 ID가 우연히 나와도 예전 기록의 재현으로 승인하지 않습니다. 기존 환경을 확보하거나 변경된 환경에서 새 작업으로 표본과 기록을 함께 만드세요.
입력 순서와 값 변경을 나누어 확인하기
population_reversed.csv는 원래 20행의 순서만 뒤집은 파일입니다. 같은 seed를 쓰더라도 같은 위치에 다른 ID가 있으므로, 검증 환경의 새 표본은 12, 3, 11, 8, 16입니다.
python code/sample_review.py sample fixtures/population_reversed.csv work/reversed --n 5 --seed 20261005
python code/sample_review.py replay fixtures/population_reversed.csv work/run1/sample_record.json work/reject_reversed
첫 명령은 새 입력의 표본을 만듭니다. 둘째 명령은 입력 SHA 불일치로 종료 코드 2를 반환하며 work/reject_reversed를 만들지 않습니다. 모집단을 자동 정렬해 이전 순서처럼 보이게 하거나 기록의 해시만 바꾸지 않습니다.
population_changed.csv는 ID 20의 amount만 20000에서 20001로 바꾼 파일입니다. 이 행은 이번 5행에 뽑히지 않았으므로 새 추출의 ID는 그대로 9, 18, 10, 13, 5입니다. 그래도 입력 SHA가 달라 예전 기록으로 replay하면 중단합니다. 선택된 ID가 같다는 사실과 모집단 버전이 같다는 사실을 따로 확인해야 합니다.
python code/sample_review.py sample fixtures/population_changed.csv work/changed --n 5 --seed 20261005
python code/sample_review.py replay fixtures/population_changed.csv work/run1/sample_record.json work/reject_changed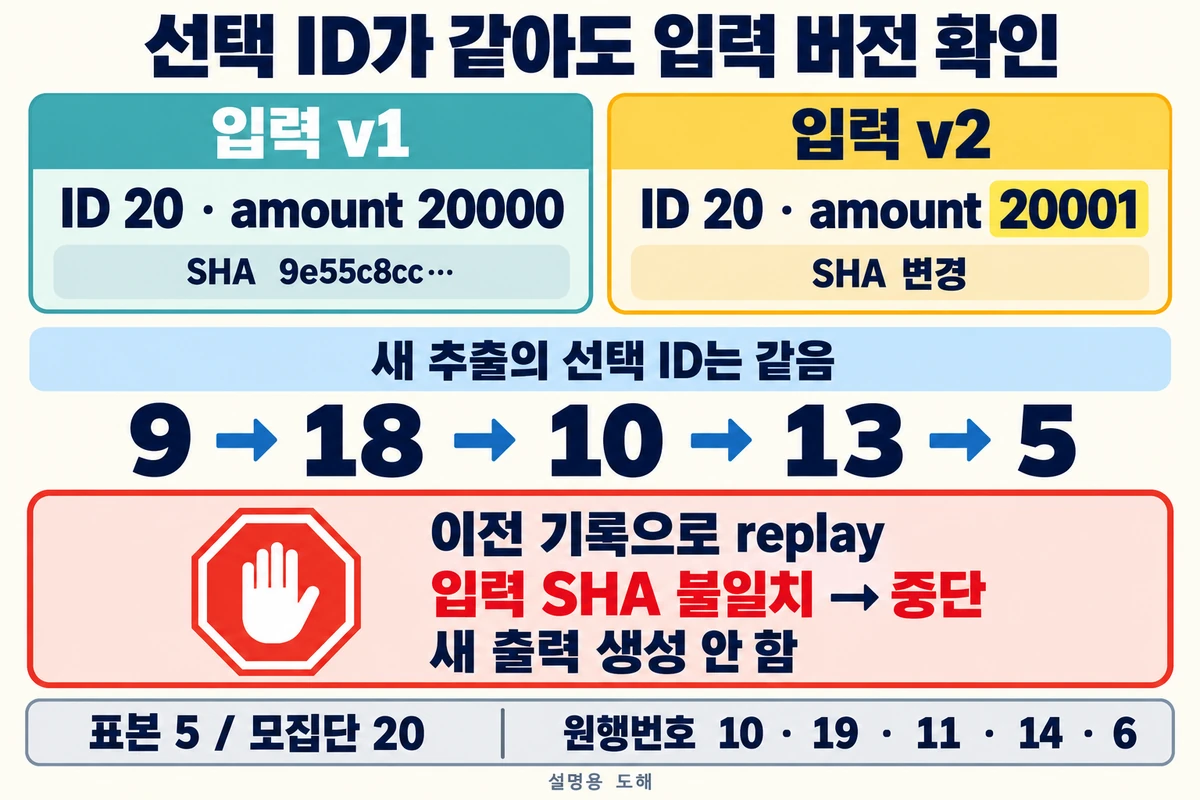
표본 수와 저장 경로 오류에서 복구하기
| 상황 | 기대 처리 | 확인할 것 |
|---|---|---|
| 20행에서 n=21 요청 | 저장 전 중단 | 요청 표본 수와 모집단 행 수 |
| n=-1 요청 | 저장 전 중단 | 0 이상의 정수 여부 |
| ID가 두 번 등장 | 저장 전 중단 | 고유한 행 식별 기준 |
| 빈 파일 | 헤더 오류로 중단 | 올바른 입력 파일인지 |
| 헤더만 있고 데이터 없음 | 빈 모집단으로 중단 | 데이터 행이 있는지 |
| 출력 폴더가 이미 존재 | 덮어쓰지 않고 중단 | 새 출력 폴더명 |
| 출력 경로가 원본 파일과 같음 | 원본 쓰기 없이 중단 | 입력·출력 경로 구분 |
비어 있지 않은 모집단에서 n=0은 헤더만 있는 표본 CSV로 허용합니다. 빈 모집단에서 n=0은 이 실습의 입력 계약에 따라 거부합니다. 표본 수가 크다는 이유로 무조건 줄이거나 중복 추출로 바꾸지 말고 검토 목적에 맞는 요청을 정하세요.
아래 두 명령은 각각 종료 코드 2가 나오는 것이 정상입니다. 첫 명령이 실패해도 둘째 명령을 개별 실행합니다.
python code/sample_review.py sample fixtures/population_v1.csv work/too_many --n 21 --seed 20261005
python code/sample_review.py sample fixtures/population_v1.csv work/run1 --n 5 --seed 20261005
두 번째는 이미 만든 run1을 보호하는 시험입니다. 원본이나 기존 결과를 지우지 말고 run3 같은 새 이름으로 실행하세요. 디스크 오류가 저장 도중 발생하면 새 폴더에 일부 파일만 남을 수 있습니다. 종료 코드 0과 두 결과 파일을 확인하기 전에는 완료로 쓰지 말고, 불완전 결과도 남겨 둔 채 다른 폴더에서 재시도합니다.
전체 실행 코드
아래 코드는 ZIP의 code/sample_review.py와 같습니다. 실행 코드에는 외부 통신·추가 패키지·원본 수정·기존 결과 덮어쓰기 기능이 없습니다. 입력 전체를 메모리에 읽는 작은 CSV 실습이므로 대용량 처리 성능을 보장하지 않습니다.
"""Draw and replay a recorded CSV sample with the standard library only."""
import argparse
import csv
import hashlib
import io
import json
from pathlib import Path
import platform
import random
import sys

HEADER = ['id', 'item', 'amount']
ALGORITHM = 'random.Random(integer_seed).sample(row_indices, sample_size)'


def sha256(data):
    return hashlib.sha256(data).hexdigest()


def runtime_info():
    return {
        'implementation': platform.python_implementation(),
        'python_version': platform.python_version(),
        'python_build': sys.version,
        'random_module_sha256': sha256(Path(random.__file__).read_bytes()),
    }


def build_sample(source, n, seed):
    if type(n) is not int or n < 0:
        raise ValueError('표본 수는 0 이상의 정수여야 합니다.')
    if type(seed) is not int:
        raise ValueError('seed는 정수여야 합니다.')
    raw = Path(source).read_bytes()
    reader = csv.reader(io.StringIO(raw.decode('utf-8-sig'), newline=''), strict=True)
    if next(reader, None) != HEADER:
        raise ValueError('헤더는 id,item,amount 순서여야 합니다.')
    population, seen = [], set()
    for row_number, row in enumerate(reader, start=2):
        if len(row) != len(HEADER):
            raise ValueError(f'CSV {row_number}행의 열 수가 다릅니다.')
        if not row[0] or not row[0].strip():
            raise ValueError(f'CSV {row_number}행의 ID가 비었습니다.')
        if row[0] != row[0].strip():
            raise ValueError(f'CSV {row_number}행의 ID 앞뒤 공백을 확인하세요.')
        if row[0] in seen:
            raise ValueError(f'중복 ID: {row[0]}')
        seen.add(row[0])
        population.append((row_number, row))
    if not population:
        raise ValueError('모집단이 비어 있습니다. 데이터 행을 확인하세요.')
    if n > len(population):
        raise ValueError(f'표본 수 {n}이 모집단 {len(population)}행보다 큽니다.')
    indices = random.Random(seed).sample(range(len(population)), n)
    selected, output_rows = [], []
    for order, index in enumerate(indices, start=1):
        row_number, row = population[index]
        selected.append({'draw_order': order, 'original_row_number': row_number,
                         'id': row[0]})
        output_rows.append([order, row_number] + row)
    buffer = io.StringIO(newline='')
    writer = csv.writer(buffer, lineterminator='\n')
    writer.writerow(['draw_order', 'original_row_number'] + HEADER)
    writer.writerows(output_rows)
    sample_bytes = buffer.getvalue().encode('utf-8-sig')
    record = {
        'schema_version': 1,
        'algorithm': ALGORITHM,
        'runtime': runtime_info(),
        'code_sha256': sha256(Path(__file__).read_bytes()),
        'input_sha256': sha256(raw),
        'input_bytes': len(raw),
        'input_header': HEADER,
        'population_count': len(population),
        'sample_size': n,
        'seed': seed,
        'row_number_definition': 'CSV logical record number, header = 1',
        'selected': selected,
        'sample_csv_sha256': sha256(sample_bytes),
        'quality_guarantee': False,
    }
    return record, sample_bytes


def _save(source, output, record, sample_bytes):
    output = Path(output)
    if output.resolve() == Path(source).resolve():
        raise ValueError('출력 경로가 원본 파일과 같습니다.')
    if output.exists() or output.is_symlink():
        raise ValueError('출력 경로가 이미 존재합니다. 새 폴더명을 쓰세요.')
    try:
        output.mkdir()
    except FileExistsError as error:
        raise ValueError('출력 경로가 이미 존재합니다. 새 폴더명을 쓰세요.') from error
    with (output / 'sample.csv').open('xb') as file:
        file.write(sample_bytes)
    # The record is written last. An I/O error can leave an incomplete new folder.
    with (output / 'sample_record.json').open('x', encoding='utf-8', newline='\n') as file:
        json.dump(record, file, ensure_ascii=False, indent=2, sort_keys=True)
        file.write('\n')
    return record


def save_run(source, output, n, seed):
    record, sample_bytes = build_sample(source, n, seed)
    return _save(source, output, record, sample_bytes)


def replay_run(source, record_path, output):
    recorded = json.loads(Path(record_path).read_text(encoding='utf-8'))
    if not isinstance(recorded, dict):
        raise ValueError('표본 기록은 JSON 객체여야 합니다.')
    current, sample_bytes = build_sample(source, recorded.get('sample_size'),
                                         recorded.get('seed'))
    if current['input_sha256'] != recorded.get('input_sha256'):
        raise ValueError('입력 SHA 불일치: 같은 모집단 버전의 재현이 아닙니다.')
    if current['runtime'] != recorded.get('runtime'):
        raise ValueError('Python 런타임 불일치: 기록한 실행 환경을 확인하세요.')
    if current['code_sha256'] != recorded.get('code_sha256'):
        raise ValueError('코드 SHA 불일치: 기록한 코드 버전을 확인하세요.')
    # Canonical JSON comparison also distinguishes true from 1.
    if json.dumps(current, sort_keys=True) != json.dumps(recorded, sort_keys=True):
        raise ValueError('표본 기록 불일치: ID, 원행번호, 크기와 출력 SHA를 확인하세요.')
    return _save(source, output, current, sample_bytes)


def main():
    parser = argparse.ArgumentParser(description='원본을 바꾸지 않는 검토 표본 추출과 재현')
    commands = parser.add_subparsers(dest='command', required=True)
    sample = commands.add_parser('sample')
    sample.add_argument('source', type=Path)
    sample.add_argument('output', type=Path)
    sample.add_argument('--n', type=int, required=True)
    sample.add_argument('--seed', type=int, required=True)
    replay = commands.add_parser('replay')
    replay.add_argument('source', type=Path)
    replay.add_argument('record', type=Path)
    replay.add_argument('output', type=Path)
    args = parser.parse_args()
    try:
        if args.command == 'sample':
            record = save_run(args.source, args.output, args.n, args.seed)
        else:
            record = replay_run(args.source, args.record, args.output)
    except (OSError, ValueError, csv.Error) as error:
        print(f'중단: {error}', file=sys.stderr)
        return 2
    ids = ','.join(row['id'] for row in record['selected'])
    print(f"표본 {record['sample_size']}행, ID(추출 순서): {ids}")
    print(f"입력 SHA256: {record['input_sha256']}")
    print('sample.csv와 sample_record.json 저장 완료')
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
자동 테스트로 정상과 반례 확인하기
python -m unittest discover -s tests -v
python tests/verify_examples.py
검증한 Linux CPython 3.12.14에서는 회귀 테스트 30건을 통과했고, 새 임시 폴더에서 정상·실패 CLI 14건을 확인했습니다. 같은 입력의 반복 추출과 기록 재현은 바이트가 같았고, 입력 순서 변경·값 변경·표본 초과·음수·중복 ID·빈 입력·원본 및 기존 결과 충돌은 지정한 조건에서 중단했습니다. 모든 가상 입력 파일의 SHA256이 실행 전후 같았습니다.
다른 Python 런타임에서는 저장된 기대 ID에 대한 환경 전용 테스트가 건너뛰어질 수 있습니다. 그때는 제공된 기대 ID를 강제로 맞추지 말고 자신의 환경에서 만든 기록으로 반복 추출과 replay를 확인합니다. Windows와 Microsoft Office 앱에서는 시험하지 않았으며, CSV가 특정 Excel 화면에서 원하는 형식으로 열렸다는 주장도 하지 않습니다.
표본 검사로 알 수 없는 것
이 스크립트는 검토할 5행을 고르는 데 쓰입니다. amount를 숫자로 계산하지 않고 원래 문자열로 옮기며, 품목 누락이나 업무 규칙의 적합성도 판단하지 않습니다. ID·열 구조 검사는 표본을 추적하기 위한 최소 입력 조건입니다.
5행에 문제가 없다고 나머지 15행이나 모집단 전체의 품질이 보증되지는 않습니다. 위험도가 높은 행을 별도로 포함할지, 부서별로 나눌지, 검토 범위를 얼마나 늘릴지는 업무 목적에 맞게 결정해야 합니다. 표본 5라는 수는 재현 실습용이며 통계적 대표성이나 감사 충분성을 입증하는 기준이 아닙니다.
입력 해시는 한 번 읽은 스냅샷을 식별합니다. 파일 잠금이나 이후 변경 감시 기능이 아니므로 신뢰할 원본·표본·기록을 함께 보관하세요. random은 암호학적 보안용 난수 생성기가 아니며 비밀번호나 보안 토큰 생성에 사용하지 않습니다.
실습 자료와 공식 문서
압축을 푼 뒤 README의 명령을 위에서부터 실행하세요. 실패 확인용 파일은 가상 반례이며 실제 업무 파일에 덮어쓰지 않습니다.
공식 문서 확인일: 2026-10-05
작성자 소개
