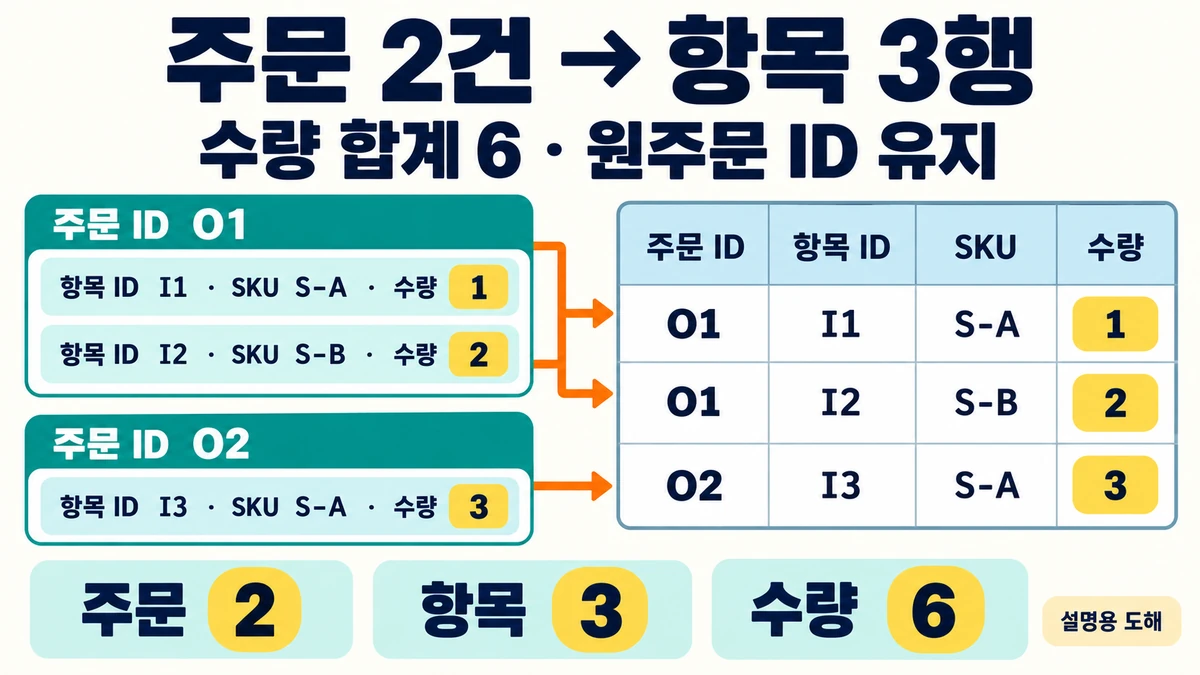
중첩 JSON에서 주문 항목을 CSV 행으로 꺼내기
주문 JSON에 주문 두 건이 있어도, 품목 CSV는 세 행이 될 수 있습니다.
한 주문 안에 두 품목이 들어 있기 때문입니다. 주문 수, 항목 행
수, 수량 합계는 서로 다른 숫자로 검산해야 합니다.
이 실습은 가상 주문 O1·O2를 주문 2건 → 항목 3행 → 수량 합계
6으로 펼칩니다. 각 행에 원주문 ID와 JSON 안의 위치를 남깁니다.
잘못된 주문은 별도 파일에 보존하고, 원본이나 기존 결과를 덮어쓰지
않습니다. Python 표준 라이브러리만 사용하며 실제 주문·계정·API는
필요하지 않습니다.
1. CSV 한 행이 무엇을
뜻하는지 정하기
이번 CSV의 한 행은 주문 한 건이 아니라 주문 안의 항목 한
개입니다. O1에는 I1·I2, O2에는 I3가 있습니다. 같은 상품 S-A가
서로 다른 주문에 나타나도 별개의 항목입니다. 상품 코드가 같다는 이유로
두 행을 하나로 합치지 않습니다.
| 원주문 | 항목 ID | 상품 코드 | 수량 |
|---|---|---|---|
| O1 | I1 | S-A | 1 |
| O1 | I2 | S-B | 2 |
| O2 | I3 | S-A | 3 |
- 주문 수: O1·O2 두 건
- 항목 행 수: I1·I2·I3 세 행
- 수량 합계: 1 + 2 + 3 = 6
len(주문목록)은 2이고, 각 주문의 items
개수를 더하면 3입니다. 수량 합계는 항목의 qty를 더한
6입니다. 출력 CSV의 행 수 3을 주문 건수로 보고하면 주문 한 건을 더 센
셈이 됩니다.
2. 입력 구조와 빈 목록의
의미 확인하기
함께 제공한 ZIP의 fixtures/orders.json은 다음 가상
자료입니다.
[
  {
    "order_id": "O1",
    "items": [
      {"item_id": "I1", "sku": "S-A", "qty": 1},
      {"item_id": "I2", "sku": "S-B", "qty": 2}
    ]
  },
  {
    "order_id": "O2",
    "items": [
      {"item_id": "I3", "sku": "S-A", "qty": 3}
    ]
  }
]
입력의 맨 바깥은 주문 배열입니다. 주문은 order_id,
items만 갖고, 항목은 item_id,
sku, qty만 갖도록 연습 규칙을 정했습니다. 다른
키가 있으면 임의로 버리지 않고 그 주문을 격리합니다. 실제 주문 파일의
메모·배송지까지 자동으로 처리하는 범용 변환기는 아닙니다.
ID와 상품 코드는 영문·숫자로 시작하고, 나머지는
영문·숫자·점·밑줄·하이픈으로 이루어진 1~64자 문자열만 받습니다.
대소문자를 구분하며 앞뒤 공백을 지우거나 숫자로 바꾸지 않습니다. 수량은
1 이상의 정수입니다. "2", true, 0, 음수,
소수는 보류합니다. 실제 자료의 한글 상품명이나 다른 코드 형식이 필요하면
먼저 입력 규칙과 시험 자료를 함께 바꿔야 합니다.
| 입력 | 처리 | 이유 |
|---|---|---|
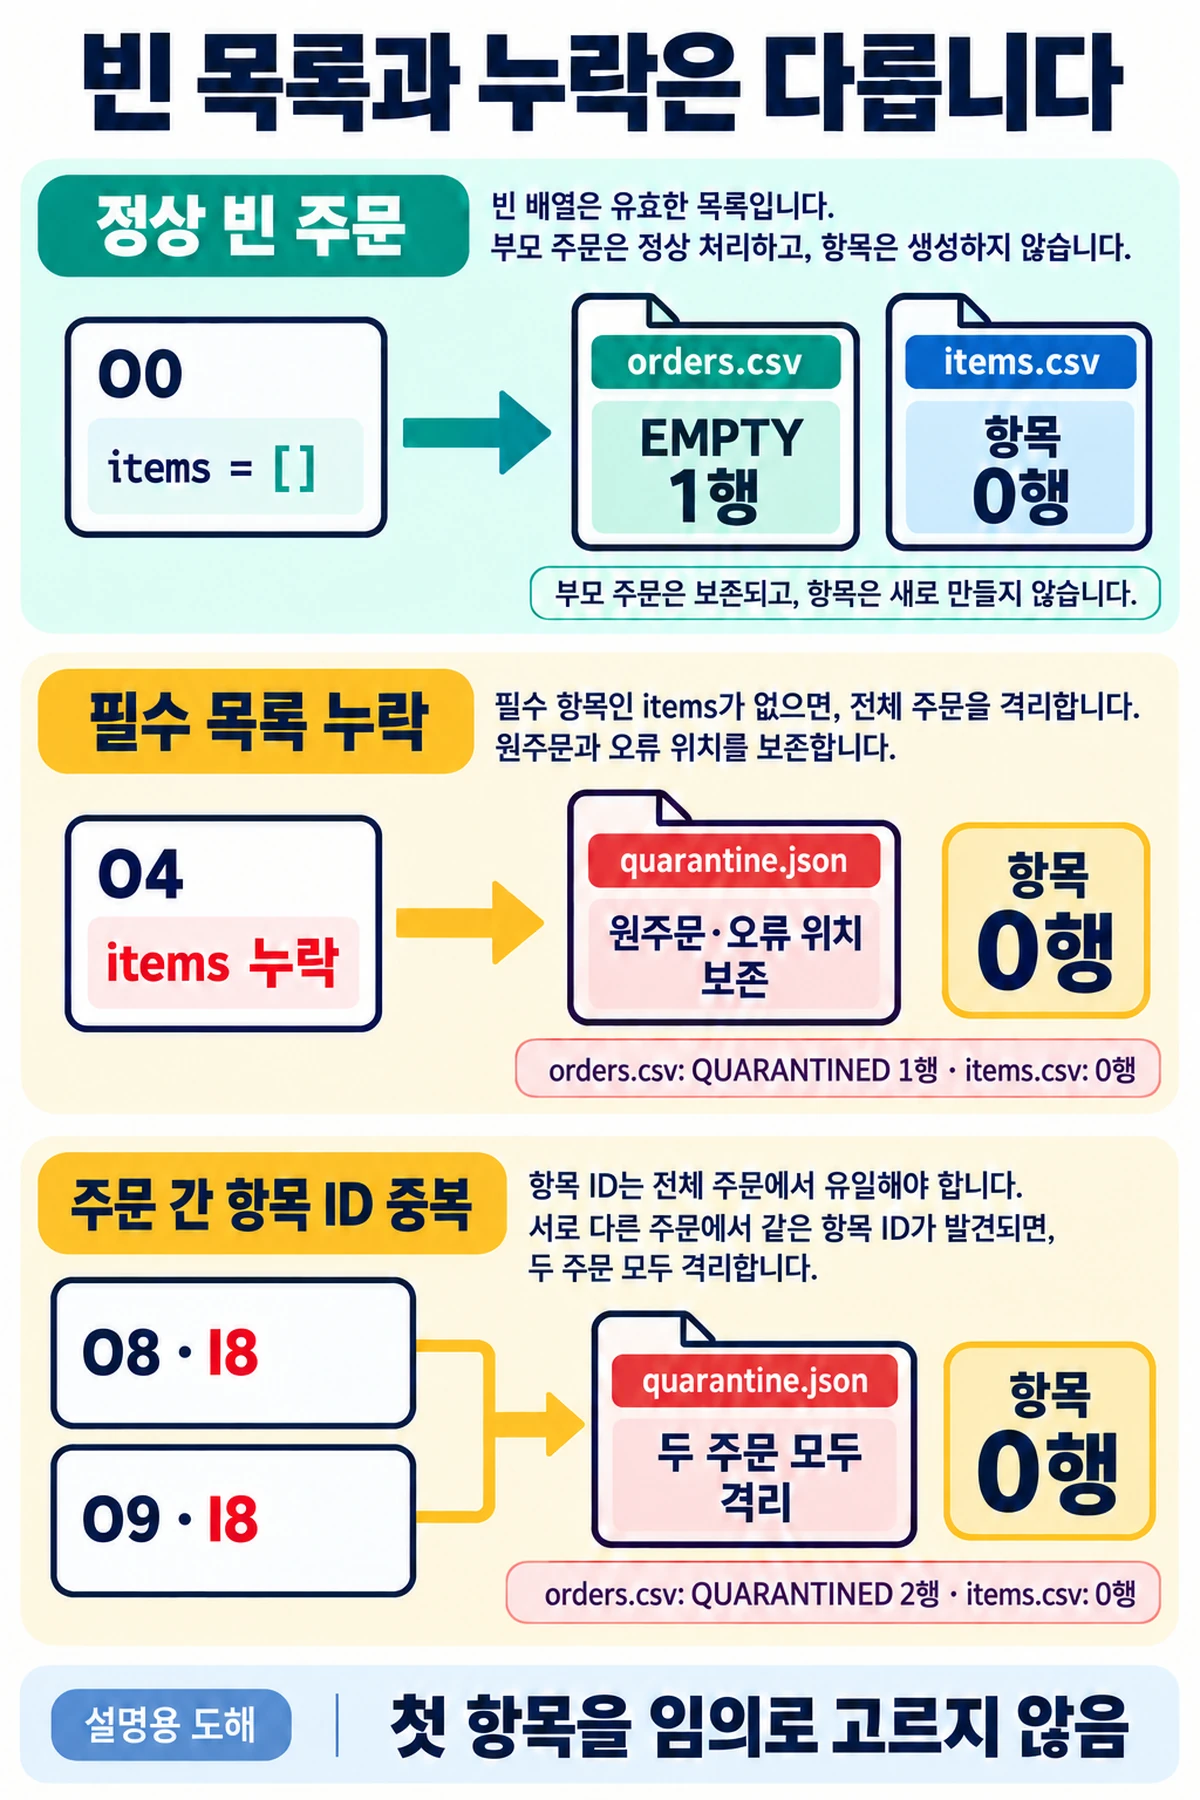
"items": [] |
주문은 남기고 항목 0행 | 목록이 있고 길이가 0임 |
items 키 없음 |
주문 전체 격리 | 항목이 없다는 뜻인지, 자료가 빠졌는지 알 수 없음 |
"items": null 또는 객체·문자열 |
주문 전체 격리 | 항목 배열 형식이 아님 |
같은 item_id 두 번 |
관련 주문 모두 격리 | 먼저 나온 항목을 임의로 정답으로 고를 수 없음 |
빈 목록에 수량 0인 가짜 품목 행을 만들지 않습니다. 빈 주문 O0는
orders.csv에 EMPTY로 남고,
items.csv에는 한 행도 추가되지 않습니다.
order_id는 입력 전체에서 고유하고, item_id도
입력 파일 전체에서 고유하다는 규칙입니다. 다른 주문에 같은
item_id가 있어도 두 주문을 모두 격리합니다.
3. 새 폴더에서 실행하고
네 결과 파일 읽기
ZIP 전체를 새 빈 폴더에 풀고 터미널 작업 위치를 그 폴더로 정합니다.
Python 3 실행 명령을 아래처럼 사용합니다. 환경에 따라 첫 단어를
python3로 바꾸면 됩니다. 패키지는 설치하지 않습니다.
python code/flatten_orders.py --input fixtures/orders.json --out-dir runs/orders정상 실행의 콘솔 출력은 다음과 같습니다. 종료 코드는 0입니다.
주문 2 / 항목 3 / 수량 6 / 격리 주문 0runs/orders 안에 네 파일이 생깁니다.
| 파일 | 확인할 내용 |
|---|---|
items.csv |
정상 주문의 항목만 한 행씩, 원주문 ID와 원문 위치 포함 |
orders.csv |
원래 주문마다 한 행, 상태와 내보낸 항목 수·수량 |
quarantine.json |
격리한 주문의 파싱된 검토 사본과 오류 위치·코드 |
report.json |
주문·항목·수량 검산과 읽은 원본의 SHA-256 |
정상 예제의 items.csv는 다음과 같습니다. 맨 윗줄은
머리글이므로 항목 행 수에 포함하지 않습니다.
source_order_index,source_item_index,source_path,order_id,item_id,sku,qty
0,0,$[0].items[0],O1,I1,S-A,1
0,1,$[0].items[1],O1,I2,S-B,2
1,0,$[1].items[0],O2,I3,S-A,3source_order_index, source_item_index는
0부터 시작합니다. $[0].items[1]은 첫 주문의 두 번째
항목입니다. 이 위치는 JSON 배열의 논리적 위치이며
텍스트 파일의 줄 번호나 바이트 위치가 아닙니다. 원본을 다른 순서로 다시
정렬하면 같은 위치 표시는 다른 항목을 가리킬 수 있으므로,
report.json의 해시와 그 실행에 사용한 원본을 함께
보관합니다.
orders.csv에는 O1·O2 두 행만 남습니다. O1의
emitted_item_count는 2, emitted_qty는 3입니다.
O2는 각각 1과 3입니다. 부모 주문 표에서 항목 수를 더하면 3, 수량을
더하면 6이어야 합니다.
4. 주문 한 건의 일부만 꺼내지
않기
O1의 첫 항목이 정상이어도 두 번째 항목의 수량이 잘못됐다면 O1 전체를
격리합니다. 첫 항목만 CSV에 넣으면 O1을 완전히 변환했다고 오해하기 쉽기
때문입니다. 다른 정상 주문은 변환할 수 있지만, 격리가 하나라도 있으면
종료 코드 2로 알립니다.
다음 세 명령으로 빈 목록과 오류 반례를 확인합니다. 각 출력 경로는
아직 존재하지 않아야 합니다.
python code/flatten_orders.py --input fixtures/empty.json --out-dir runs/empty
python code/flatten_orders.py --input fixtures/errors.json --out-dir runs/errors
python code/flatten_orders.py --input fixtures/duplicate_across.json --out-dir runs/duplicate-across| 입력 파일 | 원주문 수 | 정상으로 받은 주문 수 | 빈 주문 수 | 격리 주문 수 | 항목 행 수 | 수량 합계 | 종료 코드 |
|---|---|---|---|---|---|---|---|
orders.json |
2 | 2 | 0 | 0 | 3 | 6 | 0 |
empty.json |
1 | 1 | 1 | 0 | 0 | 0 | 0 |
errors.json |
7 | 3 | 1 | 4 | 3 | 6 | 2 |
duplicate_across.json |
2 | 0 | 0 | 2 | 0 | 0 | 2 |
’정상으로 받은 주문 수’에는 빈 목록 주문도 포함합니다. 따라서
errors.json에서 정상 주문 3건과 격리 주문 4건을 더하면
원주문 7건이고, 빈 주문 1건을 다시 더하지 않습니다. 항목 3행·수량 6은
정상 주문에서 내보낸 부분의 합계입니다. 격리 주문에 수량이 더 있을 수
있으므로 원본 전체의 확정 수량이라고 부르지 않습니다.
quarantine.json의 raw_order는 JSON을 읽어
만든 주문 객체의 검토 사본입니다. 원본의 공백·숫자 표기·전체 바이트를
그대로 담은 조각은 아닙니다. 원문은 그대로 보존한 입력 파일에서
source_sha256, source_path와 함께
대조합니다.
errors.json은 O1·O2 외에 빈 O0, items가
빠진 O4, 객체형 items의 O5, I6가 두 번인 O6, 수량
true의 O7을 담고 있습니다. O4~O7 네 주문의 항목은 모두
CSV에서 빠지고 quarantine.json의 raw_order에
남습니다.
5. 전체 변환 코드
아래 코드는 ZIP의 code/flatten_orders.py와 같습니다.
배열을 바로 펼치기 전에 ID 중복을 전체 입력에서 셉니다. 그다음 주문별
오류를 확인하고, 오류 없는 주문만 항목 행으로 만듭니다.
"""Expand synthetic order items; preserve input and reject existing output folders."""
import argparse
from collections import Counter
import csv
import hashlib
import json
import math
from pathlib import Path
import re
import sys

MAX_BYTES = 1_000_000
ITEM_FIELDS = ["source_order_index", "source_item_index", "source_path",
               "order_id", "item_id", "sku", "qty"]
ORDER_FIELDS = ["source_order_index", "source_path", "order_id", "status",
                "declared_item_count", "emitted_item_count", "emitted_qty"]
IDENTIFIER = re.compile(r"[A-Za-z0-9][A-Za-z0-9._-]{0,63}\Z")


def unique_keys(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("JSON object has a duplicate key")
        result[key] = value
    return result


def reject_constant(value):
    raise ValueError("non-finite JSON number: " + value)


def finite_float(text):
    value = float(text)
    if not math.isfinite(value):
        raise ValueError("JSON float converts to a non-finite value")
    return value


def check_utf8_strings(value):
    # Decoded escapes may contain surrogates even when source bytes are UTF-8.
    if isinstance(value, str):
        value.encode("utf-8", errors="strict")
    elif isinstance(value, dict):
        for key, item in value.items():
            check_utf8_strings(key)
            check_utf8_strings(item)
    elif isinstance(value, list):
        for item in value:
            check_utf8_strings(item)


def valid_id(value):
    return isinstance(value, str) and IDENTIFIER.fullmatch(value) is not None


def read_snapshot(path):
    with path.open("rb") as file:
        raw = file.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise ValueError("input exceeds 1,000,000 bytes")
    data = json.loads(raw.decode("utf-8"), object_pairs_hook=unique_keys,
                      parse_constant=reject_constant, parse_float=finite_float)
    check_utf8_strings(data)
    if not isinstance(data, list):
        raise ValueError("top-level JSON must be an array of orders")
    return data, hashlib.sha256(raw).hexdigest()


def flatten_orders(data):
    # Count first, so a duplicate cannot be resolved by choosing the first row.
    order_ids = Counter()
    item_ids = Counter()
    for order in data:
        if not isinstance(order, dict):
            continue
        if valid_id(order.get("order_id")):
            order_ids[order["order_id"]] += 1
        if isinstance(order.get("items"), list):
            for item in order["items"]:
                if isinstance(item, dict) and valid_id(item.get("item_id")):
                    item_ids[item["item_id"]] += 1

    rows, parents, quarantine = [], [], []
    for oi, order in enumerate(data):
        path = f"$[{oi}]"
        issues = []

        def issue(code, location):
            issues.append({"code": code, "path": location})

        items = None
        order_id = ""
        if not isinstance(order, dict):
            issue("ORDER_TYPE", path)
        else:
            if set(order) != {"order_id", "items"}:
                issue("ORDER_KEYS", path)
            if valid_id(order.get("order_id")):
                order_id = order["order_id"]
                if order_ids[order_id] > 1:
                    issue("DUPLICATE_ORDER_ID", path + ".order_id")
            else:
                issue("ORDER_ID", path + ".order_id")
            if "items" not in order:
                issue("MISSING_ITEMS", path + ".items")
            elif not isinstance(order["items"], list):
                issue("ITEMS_TYPE", path + ".items")
            else:
                items = order["items"]
                for ii, item in enumerate(items):
                    ip = f"{path}.items[{ii}]"
                    if not isinstance(item, dict):
                        issue("ITEM_TYPE", ip)
                        continue
                    if set(item) != {"item_id", "sku", "qty"}:
                        issue("ITEM_KEYS", ip)
                    if not valid_id(item.get("item_id")):
                        issue("ITEM_ID", ip + ".item_id")
                    elif item_ids[item["item_id"]] > 1:
                        issue("DUPLICATE_ITEM_ID", ip + ".item_id")
                    if not valid_id(item.get("sku")):
                        issue("SKU", ip + ".sku")
                    if type(item.get("qty")) is not int or item["qty"] <= 0:
                        issue("QTY", ip + ".qty")

        emitted = []
        if issues:
            status = "QUARANTINED"
            quarantine.append({"source_order_index": oi, "source_path": path,
                               "order_id": order_id, "issues": issues,
                               "raw_order": order})
        else:
            status = "EMPTY" if not items else "ACCEPTED"
            for ii, item in enumerate(items):
                emitted.append({"source_order_index": oi,
                                "source_item_index": ii,
                                "source_path": f"{path}.items[{ii}]",
                                "order_id": order_id,
                                "item_id": item["item_id"],
                                "sku": item["sku"], "qty": item["qty"]})
            rows.extend(emitted)
        parents.append({"source_order_index": oi, "source_path": path,
                        "order_id": order_id, "status": status,
                        "declared_item_count": len(items) if items is not None else "",
                        "emitted_item_count": len(emitted),
                        "emitted_qty": sum(row["qty"] for row in emitted)})

    summary = {
        "source_order_count": len(data),
        "accepted_order_count": len(data) - len(quarantine),
        "empty_order_count": sum(p["status"] == "EMPTY" for p in parents),
        "quarantined_order_count": len(quarantine),
        "item_row_count": len(rows),
        "quantity_total": sum(row["qty"] for row in rows),
        "issue_count": sum(len(q["issues"]) for q in quarantine),
    }
    assert summary["accepted_order_count"] + len(quarantine) == len(parents)
    assert sum(p["emitted_item_count"] for p in parents) == len(rows)
    assert sum(p["emitted_qty"] for p in parents) == summary["quantity_total"]
    return rows, parents, quarantine, summary


def write_bundle(output, rows, parents, quarantine, report):
    # mkdir without exist_ok claims a NEW folder; an existing folder is rejected.
    output.mkdir(parents=True, exist_ok=False)
    for name, fields, values in [("items.csv", ITEM_FIELDS, rows),
                                 ("orders.csv", ORDER_FIELDS, parents)]:
        with (output / name).open("x", encoding="utf-8", newline="") as file:
            writer = csv.DictWriter(file, fieldnames=fields, lineterminator="\n")
            writer.writeheader()
            writer.writerows(values)
    for name, value in [("quarantine.json", quarantine), ("report.json", report)]:
        with (output / name).open("x", encoding="utf-8") as file:
            json.dump(value, file, ensure_ascii=False, indent=2, allow_nan=False)
            file.write("\n")


def main(argv=None):
    parser = argparse.ArgumentParser(description="주문 JSON을 항목 행으로 펼칩니다")
    parser.add_argument("--input", required=True, type=Path)
    parser.add_argument("--out-dir", required=True, type=Path)
    args = parser.parse_args(argv)
    try:
        data, digest = read_snapshot(args.input)
        rows, parents, quarantine, summary = flatten_orders(data)
        report = {"source_name": args.input.name, "source_sha256": digest,
                  "policy": "whole-order quarantine; globally unique item_id",
                  "source_positions": "zero-based logical JSON array indexes",
                  **summary}
        write_bundle(args.out_dir, rows, parents, quarantine, report)
    except (OSError, ValueError, UnicodeError, RecursionError) as error:
        print("중단: " + str(error), file=sys.stderr)
        return 4
    print(f"주문 {summary['source_order_count']} / 항목 {summary['item_row_count']} / "
          f"수량 {summary['quantity_total']} / 격리 주문 {len(quarantine)}")
    return 2 if quarantine else 0


if __name__ == "__main__":
    raise SystemExit(main())
Python
json 공식 문서는 JSON을 Python 객체로 읽는 동작을 설명합니다. 기본
파서는 같은 객체 안의 중복 키에서 마지막 값을 남길 수 있습니다. 이
코드는 object_pairs_hook으로 중복 키를 거절하고
parse_constant로 NaN·Infinity 같은 비유한 숫자를
거절합니다. 잘린 JSON, 무효 UTF-8, 바깥이 배열이 아닌 입력도 결과 폴더를
만들기 전에 중단합니다.
먼저 결과를 UTF-8 JSON으로 보존할 수 있는 입력인지도 검사합니다.
1e309는 JSON 숫자 문법에 맞지만 Python의
float로 읽으면 무한대가 될 수 있습니다. json의
parse_float 안내와 math.isfinite
안내를 바탕으로, 이런 비유한 변환은 입력 전체를 종료 코드
4로 거절하고 결과 폴더를 만들지 않습니다.
parse_int는 바꾸지 않아 정상의 큰 정수를 float로 바꾸지
않습니다. 유한 소수 1.5는 읽을 수 있지만 수량이 정수가 아니므로 해당
주문을 QTY로 격리합니다.
원본 바이트가 UTF-8이어도 문자열의 \ud800 같은
이스케이프가 파싱 후 고립 surrogate라는 표현 불가능한 문자로 남을 수
있습니다. JSON
문자 인코딩 안내와 str.encode의
strict 동작에 따라 모든 키와 문자열 값을 UTF-8로 엄격하게 인코딩할
수 있는지 미리 확인합니다. 실패하면 입력 전체를 종료 4로 거절하며 결과
폴더는 0개입니다. 문자를 지우거나 대체하지 않습니다. 올바른 surrogate
쌍으로 표현한 문자는 이 검사 때문에 거절하지 않습니다.
이 두 입력 오류는 주문별 격리를 시작하기 전의 중단 조건입니다. 같은
추가 키라도 문자열을 안전하게 보존할 수 있으면 기존처럼
ORDER_KEYS로 주문 전체를 격리합니다. 거절된 파일의 원문은
그대로 남으므로 입력을 새 사본에서 확인합니다.
Python
자료형 문서의 불리언과 정수 관계 때문에 수량은
type(value) is int로 검사합니다. true를 수량
1로 받지 않으려는 선택입니다. 수량이 비었다고 0을 넣거나 문자열을 정수로
자동 변환하지 않습니다.
CSV
공식 문서에 따라 fieldnames로 열 순서를 정하고, 파일을
newline=""로 엽니다. UTF-8과 줄 끝 \n을
명시했습니다. 이 실습 CSV의 ID 규칙은 =1+1 같은 수식 모양
값을 거절하지만 모든 외부 CSV를 안전하게 여는 보편적 보증은 아닙니다.
다른 입력으로 확장할 때는 스프레드시트 가져오기 방식과 필드 규칙을
별도로 검토합니다.
6. 오류 위치에서
원본을 찾아 새 사본으로 복구하기
quarantine.json에서 source_path,
issues, raw_order를 나란히 읽습니다. 오류가
생겼다는 이유로 원본의 수량을 0으로 바꾸거나 중복 항목 하나를 지우지
않습니다.
| 오류 코드 | 먼저 확인할 곳 | 복구할 때 주의할 점 |
|---|---|---|
MISSING_ITEMS |
해당 주문의 .items |
누락인지 실제 빈 목록인지 원자료에서 확인 |
ITEMS_TYPE |
.items의 자료형 |
객체를 무조건 배열로 감싸지 않기 |
DUPLICATE_ITEM_ID |
표시된 항목 위치들 | 다른 주문의 같은 ID도 확인, 임의 첫 행 선택 금지 |
DUPLICATE_ORDER_ID |
원주문 ID | 두 주문이 같은 건인지 확인, 행 병합 금지 |
QTY |
해당 항목의 .qty |
수량의 의미·단위를 확인, 불리언·문자열 자동 변환 금지 |
ORDER_KEYS·ITEM_KEYS |
실제 키 목록 | 추가 필드를 버리지 말고 처리 규칙부터 정하기 |
ORDER_ID·ITEM_ID·SKU |
원래 식별 문자열 | 공백 제거·대소문자 통일로 몰래 맞추지 않기 |
수정이 필요하면 원본 담당자가 확인한 내용을 새 입력 사본에 반영하고,
새 출력 폴더로 다시 실행합니다. 기존 출력 폴더가 있으면 빈 폴더여도
거절합니다. 파일
열기 공식 문서의 x 모드는 이미 있는 파일을 덮어쓰지
않는 생성 모드입니다. 코드에서는 새 결과 폴더 생성과 각 파일의
x 모드를 함께 사용합니다.
쓰기 도중 권한·저장 공간 오류가 나면 새 폴더에 일부 파일이 남을 수
있습니다. 이 경우 종료 코드 4이며 완료 결과로 사용하지 않습니다. 원본과
기존 결과를 유지한 채 저장 상태를 확인하고 또 다른 새 경로에서
실행하세요. 네 파일을 한 번에 교체하는 트랜잭션 기능은 없습니다.
7. 결과 숫자와 원본
보존을 다시 검산하기
ZIP에는 구현 코드와 별도로 작성한 기대 파일이 있습니다. 다음 명령은
가상 입력을 새 임시 폴더에서 실행하고 정상 결과·격리 결과를
expected와 바이트 단위로 대조합니다.
python -m unittest discover -s tests -v
python tests/verify_examples.py
첫 명령은 36개 테스트가 OK여야 합니다. 두 번째 명령의
기대 출력은 다음과 같습니다.
주문 2 / 항목 3 / 수량 6 / 빈 항목 0행 / 오류 주문 격리 / 원본 SHA-256 일치검사는 정상 2주문, 빈 목록, 누락·타입 오류, 주문 안과 주문 사이의
중복, 불리언 수량, 기존 출력·원본 경로 보호를 확인합니다. 깨진 JSON·중복
JSON 키·NaN도 거절합니다. verify_examples.py는 네 결과
묶음과 여섯 거부 입력을 확인하고, 원본 가상 파일 열 개의 실행 전후
SHA-256을 대조합니다.
hashlib
공식 문서의 SHA-256으로 읽은 바이트를 기록합니다. 해시 일치는 이
시험 전후의 바이트 보존을 확인하는 근거이며, 파일의 출처 인증이나 이후
변경 감시·잠금 기능은 아닙니다. 입력 크기는 1,000,000바이트로 제한하지만
악의적 JSON에 대한 완전한 자원 보호 도구로 쓰지 않습니다.
8. 완료 기준과 적용 범위
완료는 원주문 기록 2행, 항목 3행, 수량 6, 격리 0, 원본 해시
일치를 각각 확인한 상태입니다. 빈 items를 처리한
경우에는 부모 주문 기록은 남고 자식 항목 행은 0이라는 점도 따로
확인합니다.
검산은 Linux·Python 3.12.14에서 가상 자료로 수행했습니다. Windows나
Excel·Office 앱 실행은 검증하지 않았습니다. 결과는 로컬 CSV·JSON이며
출고·환불·주문 시스템 변경이나 외부 API 호출을 하지 않습니다. 항목
행으로 바꾸는 작업이 끝났다고 실제 주문의 내용이나 처리 권한까지 승인된
것은 아닙니다.
실습 ZIP에는 전체 코드, 가상 입력, 기대 결과, 오류 테스트와 README가
들어 있습니다. 새 빈 폴더에 풀고 README의 명령부터 실행하세요. 공식 문서
확인 기록과 실행 환경은 함께 제공한 sources.json,
test_results에 기록했습니다.
전체 코드·가상 주문·기대 결과·테스트 ZIP 다운로드
작성자 소개
