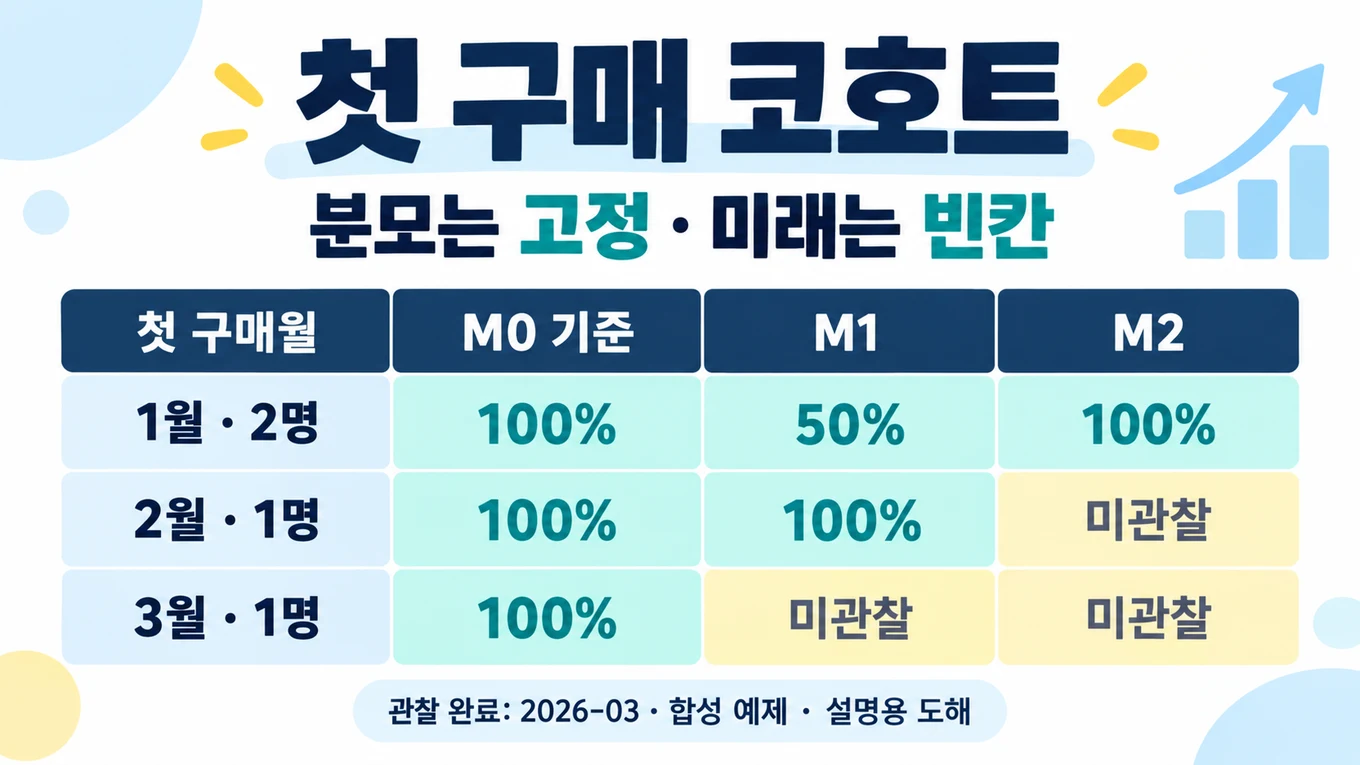
파이썬으로 첫 구매 코호트 만들기 월별 재구매와 미관측 빈칸 구분
같은 달에 처음 구매한 고객을 묶고, 그 고객들이 다음 달에도 구매했는지 살펴보면 월별 코호트 표를 만들 수 있습니다. 이때 주문 건수를 고객 수로 착각하거나 아직 끝나지 않은 달을 0%로 채우면 결과가 달라집니다.
이번 실습에서는 Python 표준 라이브러리만으로 CSV를 읽어 첫 구매 코호트를 만듭니다. 첫 구매월의 고객 수를 분모로 고정하고, 한 고객이 같은 달에 여러 번 주문해도 분자에는 한 번만 넣습니다. 관측이 끝난 달의 0%와 아직 관측할 수 없는 달의 빈칸도 구분합니다.
Excel을 실행할 필요는 없습니다. 결과는 일반 CSV이므로 스프레드시트 프로그램에서 살펴볼 수 있지만, 이 글에서 Excel 앱으로 실행하거나 호환성을 시험한 것은 아닙니다. 합성 자료를 사용한 로컬 변환 실습이며 쇼핑몰의 실제 고객 분석 결과는 아닙니다.
실습에서 확인할 결과
입력은 고객 4명과 주문 10건입니다. 중복 주문을 고객·월 기준으로 묶으면 8개 조합이 됩니다. 첫 구매 코호트 3개와 경과월 M0·M1·M2를 조합해 9개 셀을 만듭니다.
| 첫 구매월 | 최초 고객 수 | M0 첫 구매월 참여 | M1 한 달 뒤 구매 | M2 두 달 뒤 구매 |
|---|---|---|---|---|
| 2026-01 | 2 | 100.00% | 50.00% | 100.00% |
| 2026-02 | 1 | 100.00% | 100.00% | 미관측 |
| 2026-03 | 1 | 100.00% | 미관측 | 미관측 |
2026년 1~3월을 완전히 수집한 기간으로 지정합니다. 따라서 2월 코호트의 M2인 4월, 3월 코호트의 M1·M2인 4월·5월은 빈칸입니다. 9개 중 관측 셀은 6개, 미관측 셀은 3개입니다.
M0와 M1 이후를 따로 읽기
M0는 첫 구매월에 구매한 고객의 참여 기준선입니다. 이 실습에서는 고객 마스터에 있는 모든 고객에게 첫 구매월 주문이 있는지 검증하므로 M0가 100%가 됩니다. 이 수치를 재구매율이라고 부르지 않습니다.
M1부터는 최초 고객 중 해당 달력월에 다시 구매한 고객의 비율입니다. 1월 코호트 M1은 2월 구매 고객 수를 1월 최초 고객 수로 나눕니다. M2는 3월 구매 고객 수를 같은 분모로 나눕니다. 30일 단위나 누적 재구매가 아니라 달력월 기준입니다.
C002는 2월에 구매하지 않고 3월에 돌아옵니다. 따라서 1월 코호트의 M1은 50%, M2는 100%입니다. 매달 연속으로 남아 있는 고객을 세는 유지율이라면 이런 계산을 그대로 쓰면 안 됩니다. 구독 이탈률, 생존확률 또는 특정 캠페인의 인과효과도 이 표만으로 판단할 수 없습니다.
Shopify 고객 코호트 보고서도 첫 주문 시점을 기준으로 고객을 묶습니다. 여기서는 그 묶음 개념만 참고합니다. Shopify의 기간 0에는 반복 주문에 관한 별도 정의가 있으므로, 이 글의 M0 참여 기준선과 같은 지표로 해석하지 않습니다.
주문 건수 대신 고객과 월을 세기
C001은 2월에 O002와 O003 두 건을 주문합니다. 그러나 1월 코호트의 M1 분자는 2가 아니라 1입니다. 세는 단위가 주문이 아니라 해당 월에 구매한 고유 고객이기 때문입니다.
집계에는 (customer_id, purchase_month) 조합을 사용합니다. 코드의 Counter는 조합마다 주문 수를 세고, 코호트·목표월별 활성 고객은 집합으로 모읍니다. 같은 고객을 그 집합에 여러 번 넣어도 한 항목만 남습니다. Python 집합 문서는 집합을 중복 없는 원소의 모음으로 설명합니다. 계산에 쓰는 집합과 별개로 주문 10건은 감사용 파일에 모두 보존합니다.
각 셀의 계산은 다음과 같습니다.
- 분모: 그 첫 구매월에 속한 최초 고객 수
- 분자: 그 코호트의 고객 중 목표 달력월에 구매한 고유 고객 수
- 비율: 분자 ÷ 고정 분모
- 퍼센트: 비율 × 100을 소수 둘째 자리까지 반올림한 표시값
예를 들어 2026-01 코호트의 M1은 C001 한 명 ÷ C001·C002 두 명 = 1/2 = 50.00%입니다. 이후 달에 신규 고객이 늘어나도 이 코호트의 분모 2는 바뀌지 않습니다.
먼저 확인해야 하는 두 가지 자료 조건
스크립트가 형식을 검사하는 것과 원자료가 완전하다는 것은 별개의 조건입니다. 다음 두 조건은 자료 담당자가 원천 시스템과 대조해 확인해야 합니다.
- 고객 마스터의 첫 구매월이 전체 과거 이력을 기준으로 진짜 첫 구매월인가
- 관측 기간에 속한 모든 달의 주문 수집이 완료되었는가
제한된 주문 추출본에서 가장 오래된 주문을 찾는 것만으로 진짜 첫 구매월을 알 수는 없습니다. 또한 마지막 주문이 3월에 있다고 해서 3월 자료가 완전히 수집되었다고 판단할 수는 없습니다. 주문이 없는 달은 빠진 자료일 수도 있고 실제 구매가 0건인 달일 수도 있습니다.
이번 합성 예제는 고객 마스터를 전체 이력과 대조했다는 가정과, 2026년 1월부터 3월까지 완전한 수집 범위임을 확인했다는 가정으로 구성합니다. policy.json은 확인된 범위를 선언하는 파일입니다. 코드가 이 두 사실을 증명해 주지는 않습니다. 부분 수집 중인 현재 월을 완료 월로 적으면 빈칸이어야 할 셀이 0%나 불완전한 비율로 표시될 수 있습니다.
실습 파일과 실행 환경
ZIP에는 스크립트, 합성 입력 자료, 자동 테스트, 기대 결과와 실행 증거가 들어 있습니다. 압축을 새 작업 폴더에 풀고 그 폴더에서 명령을 실행하세요. 필요한 모듈은 모두 Python 표준 라이브러리에 있으므로 pip 설치 명령은 없습니다.
이 글의 실제 연구·검증일은 2026-10-13입니다. 실행 검증 환경은 Linux의 CPython 3.12.14입니다. 아래 명령도 이 환경에서 검증합니다. Windows·macOS 또는 실제 Excel 앱에서 실행했다는 의미는 아닙니다. 다른 환경에서는 Python 실행 파일 이름과 터미널 문법을 확인해야 합니다.
먼저 ZIP 최상위 폴더에서 Python 버전을 확인하고 정상 예제를 실행합니다. output_normal은 아직 존재하지 않아야 하며, 그 부모인 현재 작업 폴더는 이미 있어야 합니다.
python --version
python code/cohort.py --customers input/customers.csv --orders input/orders.csv --policy input/policy.json --out output_normal
검증 환경의 버전은 Python 3.12.14이며 정상 실행 메시지는 다음과 같습니다.
OK: customers=4 orders=10 pairs=8 observed=6 unobserved=3
출력 경로 이름은 바꿀 수 있습니다. 이미 존재하는 폴더나 파일, 심볼릭 링크를 출력 경로로 지정하면 거절합니다. 직접 파일을 만드는 경우에는 code와 input 폴더를 먼저 만들고, 아래 입력과 전체 코드를 각각 저장한 뒤 같은 실행 명령을 사용하세요. 자동 테스트·기대값 비교까지 재현하려면 ZIP에 포함된 테스트와 기대 파일도 필요합니다.
입력 1 고객 마스터
input/customers.csv에는 고객 ID와 진짜 첫 구매월을 적습니다. 고객 ID마다 한 행만 있어야 합니다.
customer_id,first_purchase_month
C001,2026-01
C002,2026-01
C003,2026-02
C004,2026-03
C001·C002가 1월 코호트, C003이 2월 코호트, C004가 3월 코호트입니다. 여기의 첫 구매월은 주문 파일에서 자동 추측하지 않습니다.
입력 2 완료 주문
input/orders.csv에는 주문 ID, 고객 ID, 구매월, 주문 상태를 적습니다.
order_id,customer_id,purchase_month,order_state
O001,C001,2026-01,COMPLETED
O002,C001,2026-02,COMPLETED
O003,C001,2026-02,COMPLETED
O004,C001,2026-03,COMPLETED
O005,C002,2026-01,COMPLETED
O006,C002,2026-03,COMPLETED
O007,C003,2026-02,COMPLETED
O008,C003,2026-03,COMPLETED
O009,C004,2026-03,COMPLETED
O010,C004,2026-03,COMPLETED
O002·O003은 같은 고객의 같은 달 주문입니다. O009·O010도 마찬가지입니다. 두 쌍을 각각 하나로 집계하므로 10건이 8개 고객·월 조합이 됩니다. 주문 ID가 중복된 경우에는 집계하지 않고 오류로 중단합니다. 서로 다른 주문 두 건과 같은 주문이 중복 수록된 경우를 구분하기 위해서입니다.
이 예제에서 order_state는 정확히 COMPLETED만 허용합니다. 취소·대기 주문을 넣으면 오류입니다. 원천 주문을 무조건 삭제하기보다는 어떤 거래를 구매로 인정할지 업무 기준을 먼저 정하고, 그 기준에 따라 완료 주문 추출본을 별도로 준비하세요. 여기서는 취소, 반품, 부분 환불 등 실제 쇼핑몰의 여러 상태를 판정하는 기능을 구현하지 않습니다.
입력 3 관측 완료 범위
input/policy.json은 다음 내용입니다.
{
  "complete_from": "2026-01",
  "complete_through": "2026-03",
  "max_offset": 2
}
complete_from과 complete_through 사이의 모든 월에 대해 자료 수집이 완료되었다고 선언합니다. 중간에 빠진 월을 허용하는 설정이 아닙니다. max_offset이 2이므로 M0·M1·M2까지 출력합니다.
코호트의 목표월이 complete_through를 지나면 UNOBSERVED로 기록합니다. 그 셀의 분모는 보존하되 분자, 비율, 퍼센트는 빈 문자열로 출력합니다. 관측 범위 안의 목표월에 구매 고객이 없으면 OBSERVED이며 분자가 0이 됩니다.
전체 스크립트
다음 코드는 ZIP의 code/cohort.py와 같은 전체 코드입니다. 직접 실습 폴더를 만들 경우에는 code 폴더를 만들고 cohort.py로 저장하세요. 앞의 세 입력은 input 폴더에 지정한 이름으로 저장합니다.
"""Synthetic monthly purchase cohorts; Python 3.12 standard library only."""
import argparse
import csv
import hashlib
import io
import json
import re
import shutil
import sys
from collections import Counter, defaultdict
from fractions import Fraction
from pathlib import Path

MAX_BYTES = 2 * 1024 * 1024
MAX_ROWS = 10000
ID_RE = re.compile(r'[A-Za-z0-9][A-Za-z0-9_-]{0,31}\Z')
MONTH_RE = re.compile(r'20[0-9]{2}-(0[1-9]|1[0-2])\Z')
CELL_HEADER = ['cohort_month', 'months_after_first', 'target_month',
               'cohort_customers', 'active_customers', 'ratio',
               'percent', 'observability', 'metric']
PAIR_HEADER = ['customer_id', 'cohort_month', 'purchase_month',
               'months_after_first', 'order_count', 'in_horizon']
AUDIT_HEADER = ['order_id', 'customer_id', 'purchase_month', 'order_state',
                'cohort_month', 'months_after_first', 'in_horizon']


def month_index(value):
    if not isinstance(value, str) or not MONTH_RE.fullmatch(value):
        raise ValueError(f'Invalid month: {value!r}; expected YYYY-MM, 2000..2099')
    year, month = map(int, value.split('-'))
    return year * 12 + month - 1


def month_text(index):
    year, month = divmod(index, 12)
    return f'{year:04d}-{month + 1:02d}'


def percentage(active, denominator):
    hundredths, remainder = divmod(active * 10000, denominator)
    if remainder * 2 >= denominator:
        hundredths += 1
    return f'{hundredths // 100}.{hundredths % 100:02d}'


def check_id(value, label):
    if not ID_RE.fullmatch(value):
        raise ValueError(f'Invalid {label}: {value!r}; ASCII letter/digit first')


def read_bytes(path):
    # A bounded read also catches a file growing after a size check.
    with path.open('rb') as handle:
        data = handle.read(MAX_BYTES + 1)
    if len(data) > MAX_BYTES:
        raise ValueError(f'Input exceeds {MAX_BYTES} bytes: {path.name}')
    return data


def read_csv(data, header, label):
    try:
        reader = csv.reader(io.StringIO(data.decode('utf-8-sig'), newline=''),
                            strict=True)
        if next(reader, None) != header:
            raise ValueError(f'{label}: exact header required: {header}')
        rows = []
        for row in reader:
            if len(row) != len(header):
                raise ValueError(f'{label}: row {reader.line_num} has wrong width')
            rows.append(row)
            if len(rows) > MAX_ROWS:
                raise ValueError(f'{label}: exceeds {MAX_ROWS} data rows')
        if not rows:
            raise ValueError(f'{label}: at least one data row required')
        return rows
    except (UnicodeError, csv.Error) as error:
        raise ValueError(f'{label}: invalid UTF-8 or CSV: {error}') from error


def unique_json_object(pairs):
    obj = {}
    for key, value in pairs:
        if key in obj:
            raise ValueError(f'Duplicate JSON key: {key}')
        obj[key] = value
    return obj


def load_inputs(customer_path, order_path, policy_path):
    paths = [Path(p).resolve() for p in [customer_path, order_path, policy_path]]
    if len(set(paths)) != 3:
        raise ValueError('Input paths must be three distinct files')
    data = [read_bytes(path) for path in paths]
    try:
        policy = json.loads(data[2].decode('utf-8-sig'),
                            object_pairs_hook=unique_json_object)
    except (UnicodeError, json.JSONDecodeError, RecursionError) as error:
        raise ValueError(f'Invalid policy JSON: {error}') from error
    if not isinstance(policy, dict) or set(policy) != {
            'complete_from', 'complete_through', 'max_offset'}:
        raise ValueError('Policy requires exactly complete_from/complete_through/max_offset')
    start = month_index(policy['complete_from'])
    end = month_index(policy['complete_through'])
    horizon = policy['max_offset']
    if end < start or end - start >= 24:
        raise ValueError('Complete coverage must be 1..24 consecutive months')
    if type(horizon) is not int or not 0 <= horizon <= 12:
        raise ValueError('max_offset must be an integer 0..12, not boolean')
    customers = {}
    for cid, first in read_csv(data[0], ['customer_id', 'first_purchase_month'], 'customers'):
        check_id(cid, 'customer_id')
        first_index = month_index(first)
        if cid in customers:
            raise ValueError(f'Duplicate customer_id: {cid}')
        if not start <= first_index <= end:
            raise ValueError(f'First purchase outside complete coverage: {cid}')
        customers[cid] = first
    orders, seen_ids, first_evidence = [], set(), set()
    header = ['order_id', 'customer_id', 'purchase_month', 'order_state']
    for oid, cid, month, state in read_csv(data[1], header, 'orders'):
        check_id(oid, 'order_id')
        check_id(cid, 'customer reference')
        index = month_index(month)
        if oid in seen_ids:
            raise ValueError(f'Duplicate order_id: {oid}')
        if cid not in customers:
            raise ValueError(f'Unknown customer_id: {cid}')
        if state != 'COMPLETED':
            raise ValueError(f'Only COMPLETED orders allowed: {oid}')
        first_index = month_index(customers[cid])
        if index < first_index or index > end:
            raise ValueError(f'Order before first purchase or after cutoff: {oid}')
        seen_ids.add(oid)
        if index == first_index:
            first_evidence.add(cid)
        orders.append((oid, cid, month, state))
    missing = sorted(set(customers) - first_evidence)
    if missing:
        raise ValueError(f'Missing first-month order evidence: {missing}')
    hashes = {key: hashlib.sha256(raw).hexdigest() for key, raw in
              zip(['customers', 'orders', 'policy'], data)}
    return customers, orders, policy, hashes


def build_tables(customers, orders, policy):
    horizon = policy['max_offset']
    cutoff = month_index(policy['complete_through'])
    members = defaultdict(set)
    for cid, first in customers.items():
        members[first].add(cid)
    pair_counts = Counter((cid, month) for _, cid, month, _ in orders)
    active = defaultdict(set)
    pairs, audit = [], []
    in_horizon = 0
    for (cid, month), count in sorted(pair_counts.items()):
        first = customers[cid]
        offset = month_index(month) - month_index(first)
        within = offset <= horizon
        in_horizon += int(within)
        active[(first, offset)].add(cid)
        pairs.append([cid, first, month, offset, count, int(within)])
    for oid, cid, month, state in sorted(orders):
        first = customers[cid]
        offset = month_index(month) - month_index(first)
        audit.append([oid, cid, month, state, first, offset, int(offset <= horizon)])
    cells = []
    observed = 0
    for first in sorted(members):
        denominator = len(members[first])
        for offset in range(horizon + 1):
            target = month_index(first) + offset
            metric = 'BASELINE_PURCHASE' if offset == 0 else 'MONTHLY_REPURCHASE'
            if target > cutoff:
                cells.append([first, offset, month_text(target), denominator,
                              '', '', '', 'UNOBSERVED', metric])
                continue
            numerator = len(active[(first, offset)])
            if not 0 <= numerator <= denominator:
                raise ValueError('Numerator outside fixed cohort denominator')
            cells.append([first, offset, month_text(target), denominator, numerator,
                          str(Fraction(numerator, denominator)),
                          percentage(numerator, denominator), 'OBSERVED', metric])
            observed += 1
    summary = {
        'customers': len(customers), 'orders': len(orders),
        'customer_month_pairs': len(pairs), 'cohorts': len(members),
        'observed_cells': observed, 'unobserved_cells': len(cells) - observed,
        'in_horizon_pairs': in_horizon, 'off_horizon_pairs': len(pairs) - in_horizon,
        'duplicate_customer_month_orders': len(orders) - len(pairs),
        'policy': policy,
        'coverage_is_input_assertion_not_proven': True,
        'first_purchase_master_is_input_assertion_not_proven': True,
    }
    if sum(row[4] for row in cells if row[7] == 'OBSERVED') != in_horizon:
        raise ValueError('Cell numerator total differs from in-horizon customer-month pairs')
    return cells, pairs, audit, summary


def write_csv(path, header, rows):
    with path.open('x', encoding='utf-8', newline='') as handle:
        writer = csv.writer(handle, lineterminator='\n')
        writer.writerow(header)
        writer.writerows(rows)


def run(customer_path, order_path, policy_path, output_path):
    requested = Path(output_path)
    if requested.is_symlink():
        raise ValueError('Output symlink refused; choose a new directory')
    output = requested.resolve()
    if output.exists():
        raise ValueError('Output already exists; choose a new directory')
    customers, orders, policy, hashes = load_inputs(customer_path, order_path, policy_path)
    cells, pairs, audit, summary = build_tables(customers, orders, policy)
    summary['source_sha256'] = hashes
    output.mkdir()  # Parent must already exist. No overwrite or exist_ok.
    try:
        write_csv(output / 'cohort_cells.csv', CELL_HEADER, cells)
        write_csv(output / 'customer_months.csv', PAIR_HEADER, pairs)
        write_csv(output / 'order_audit.csv', AUDIT_HEADER, audit)
        with (output / 'summary.json').open('x', encoding='utf-8') as handle:
            json.dump(summary, handle, ensure_ascii=False, indent=2, sort_keys=True)
            handle.write('\n')  # Written last: completion marker, not an atomic bundle.
    except Exception:
        shutil.rmtree(output)
        raise
    return summary


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('--customers', required=True, type=Path)
    parser.add_argument('--orders', required=True, type=Path)
    parser.add_argument('--policy', required=True, type=Path)
    parser.add_argument('--out', required=True, type=Path)
    args = parser.parse_args()
    try:
        summary = run(args.customers, args.orders, args.policy, args.out)
    except (OSError, ValueError) as error:
        print(f'ERROR: {error}', file=sys.stderr)
        return 2
    print(f"OK: customers={summary['customers']} orders={summary['orders']} "
          f"pairs={summary['customer_month_pairs']} observed={summary['observed_cells']} "
          f"unobserved={summary['unobserved_cells']}")
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
결과 파일을 확인하기
정상 실행은 output_normal 아래에 다음 네 파일을 만듭니다. CSV 행 수는 헤더를 제외한 데이터 행 수입니다.
| 파일 | 정상 행 수 | 내용 |
|---|---|---|
| cohort_cells.csv | 9 | 코호트와 경과월별 분자·분모·비율·관측 상태 |
| customer_months.csv | 8 | 고객·구매월별 조합과 그 달의 원주문 수 |
| order_audit.csv | 10 | 모든 원주문에 코호트·경과월·출력 범위 표시를 추가한 감사 자료 |
| summary.json | 해당 없음 | 집계 건수·정책·입력 SHA-256과 검증 가정 |
다음 명령으로 셀과 고객·월 조합을 확인합니다.
cat output_normal/cohort_cells.csv
cat output_normal/customer_months.csv
cat output_normal/summary.json
cohort_cells.csv의 전체 내용은 다음과 같습니다.
cohort_month,months_after_first,target_month,cohort_customers,active_customers,ratio,percent,observability,metric
2026-01,0,2026-01,2,2,1,100.00,OBSERVED,BASELINE_PURCHASE
2026-01,1,2026-02,2,1,1/2,50.00,OBSERVED,MONTHLY_REPURCHASE
2026-01,2,2026-03,2,2,1,100.00,OBSERVED,MONTHLY_REPURCHASE
2026-02,0,2026-02,1,1,1,100.00,OBSERVED,BASELINE_PURCHASE
2026-02,1,2026-03,1,1,1,100.00,OBSERVED,MONTHLY_REPURCHASE
2026-02,2,2026-04,1,,,,UNOBSERVED,MONTHLY_REPURCHASE
2026-03,0,2026-03,1,1,1,100.00,OBSERVED,BASELINE_PURCHASE
2026-03,1,2026-04,1,,,,UNOBSERVED,MONTHLY_REPURCHASE
2026-03,2,2026-05,1,,,,UNOBSERVED,MONTHLY_REPURCHASE
months_after_first는 M0·M1·M2에 해당하는 0·1·2입니다. target_month는 실제 달력월입니다. cohort_customers가 고정 분모이고 active_customers가 그 달의 고유 구매 고객 수입니다. observability는 OBSERVED 또는 UNOBSERVED, metric은 M0의 BASELINE_PURCHASE 또는 M1 이후의 MONTHLY_REPURCHASE입니다.
customer_months.csv는 다음 8개 조합입니다. order_count=2인 두 행에서 중복 주문이 어떻게 한 고객·월로 집계되었는지 확인할 수 있습니다. in_horizon=1은 요청한 M0~M2 출력 범위 안이라는 뜻이고 0은 그 범위 밖이라는 뜻입니다.
customer_id,cohort_month,purchase_month,months_after_first,order_count,in_horizon
C001,2026-01,2026-01,0,1,1
C001,2026-01,2026-02,1,2,1
C001,2026-01,2026-03,2,1,1
C002,2026-01,2026-01,0,1,1
C002,2026-01,2026-03,2,1,1
C003,2026-02,2026-02,0,1,1
C003,2026-02,2026-03,1,1,1
C004,2026-03,2026-03,0,2,1
summary.json의 핵심 건수는 다음 기대값과 일치합니다. 실제 요약에는 정책, 입력 세 파일의 SHA-256, 수집 완전성과 첫 구매 마스터가 입력 가정이라는 표시도 들어갑니다.
{
  "customers": 4,
  "orders": 10,
  "customer_month_pairs": 8,
  "cohorts": 3,
  "observed_cells": 6,
  "unobserved_cells": 3,
  "in_horizon_pairs": 8,
  "off_horizon_pairs": 0,
  "duplicate_customer_month_orders": 2
}
주문 파일의 행 순서와 관계없이 결과를 정렬해 출력합니다. 출력 범위보다 뒤지만 완료 관측 범위 안에 있는 유효 주문은 customer_months.csv와 order_audit.csv에 남고 in_horizon=0이 됩니다. summary.json의 off_horizon_pairs에서 그 고객·월 조합 수를 확인할 수 있습니다. 정상 예제의 범위 밖 조합은 0개입니다.
숫자를 읽을 때는 분자와 분모를 먼저 보세요. ratio는 정확한 기약분수 텍스트이고 percent는 100을 곱한 수치 텍스트입니다. percent의 50.00은 화면 설명에서 50.00%로 읽지만 CSV 값 자체에는 % 기호가 없습니다. percent의 50.00은 이미 100을 곱한 표시값이며 비율 원값 0.5와 다르므로 분자·분모를 함께 확인하세요. 프로그램의 자동 형변환·표시 서식은 이 실습에서 검증하지 않았습니다. 미관측 셀은 계산 전에 observability부터 확인하고, 숫자 빈칸을 0으로 바꾸지 마세요.
정확한 비율에는 Python Fraction을 사용합니다. 표시용 퍼센트는 이진 부동소수점 계산 대신 정수 연산으로 소수 둘째 자리까지 half-up 반올림합니다. 분자·분모도 정수 열에 함께 남겨 표시값만 보고 판단하는 일을 줄입니다.
실제 0퍼센트와 아직 모르는 빈칸 비교
합성 주문에서 O008, 즉 C003의 3월 구매 한 건만 뺀 파일로 다시 실행해 봅니다. 고객 마스터와 관측 정책은 그대로 둡니다. 이 변형은 3월 자료가 완전히 수집되었지만 C003의 구매가 없었다는 상황을 나타냅니다.
ZIP의 input/orders_observed_zero.csv는 아래 전체 내용입니다. 직접 재현할 때도 이 이름으로 저장하세요.
order_id,customer_id,purchase_month,order_state
O001,C001,2026-01,COMPLETED
O002,C001,2026-02,COMPLETED
O003,C001,2026-02,COMPLETED
O004,C001,2026-03,COMPLETED
O005,C002,2026-01,COMPLETED
O006,C002,2026-03,COMPLETED
O007,C003,2026-02,COMPLETED
O009,C004,2026-03,COMPLETED
O010,C004,2026-03,COMPLETED
새 출력 폴더 output_zero로 실행합니다.
python code/cohort.py --customers input/customers.csv --orders input/orders_observed_zero.csv --policy input/policy.json --out output_zero
cat output_zero/cohort_cells.csv
실행 메시지는 다음과 같습니다.
OK: customers=4 orders=9 pairs=7 observed=6 unobserved=3
달라지는 셀과 바로 다음 미관측 셀을 비교하면 차이가 분명합니다.
cohort_month,months_after_first,target_month,cohort_customers,active_customers,ratio,percent,observability,metric
2026-02,1,2026-03,1,0,0,0.00,OBSERVED,MONTHLY_REPURCHASE
2026-02,2,2026-04,1,,,,UNOBSERVED,MONTHLY_REPURCHASE
정확한 비율은 정규형 문자열로 기록합니다. 0/1은 ratio=0, 1/1과 2/2는 ratio=1, 1/2는 ratio=1/2가 됩니다.
변형에서는 2월 코호트의 M1이 0/1 = 0.00%가 됩니다. 같은 코호트의 M2는 4월이라 여전히 미관측 빈칸입니다. 전체 주문은 9건, 고유 고객·월 조합은 7개가 되고 9개 코호트 셀과 미관측 3개 셀은 유지됩니다.
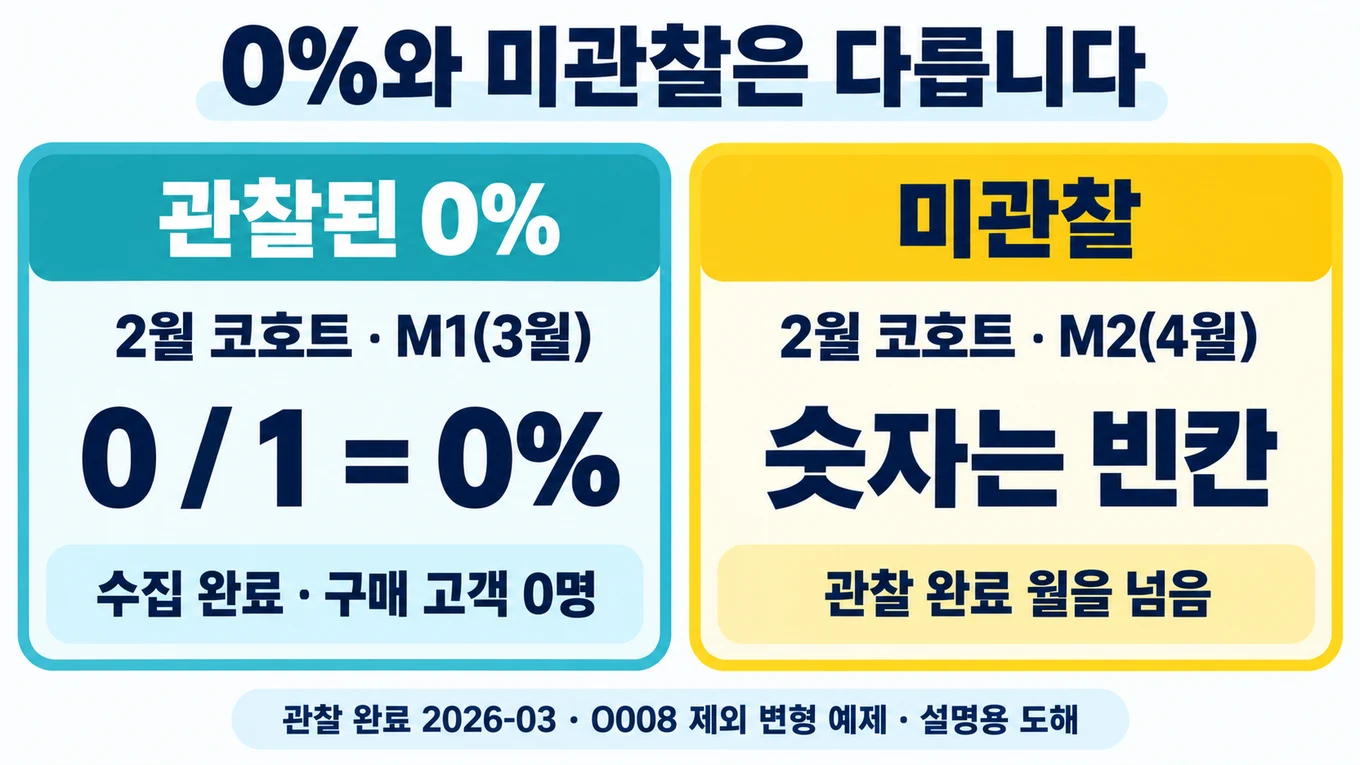
그림 2. 정상 입력에서 O008을 제외한 변형입니다. 2월 코호트의 M1은 관측된 0/1=0.00%이고 M2는 아직 관측하지 않은 4월이라 빈칸입니다.
0%는 완료된 관측 기간에 구매 고객이 없었다는 결과입니다. 빈칸은 해당 월이 관측 완료 범위 밖에 있다는 뜻입니다. 보고서에서 둘을 같은 색이나 같은 0으로 바꾸면 아직 얻지 못한 정보를 구매 실패로 해석하게 됩니다.
잘못된 자료는 고친 뒤 새 폴더로 실행하기
스크립트는 입력을 모두 검증한 뒤 새 출력 폴더를 만듭니다. ID 앞뒤 공백을 제거하거나 잘못된 월을 자동 수정하지 않습니다. 이렇게 해야 원자료와 계산값의 연결을 확인할 수 있습니다.
| 검증 항목 | 중단되는 예 | 확인할 내용 |
|---|---|---|
| 파일과 구조 | 빈 파일, 헤더 오타, 열이 빠진 행, 추가 열 | 지정된 열과 UTF-8 인코딩 확인 |
| ID | 중복 고객 ID 또는 주문 ID, 공백 포함 ID | 원천의 고유 ID와 중복 추출 여부 확인 |
| 고객 연결 | 고객 마스터에 없는 주문 고객 | 마스터와 추출 범위 대조 |
| 첫 구매 근거 | 완료 범위 밖 첫 구매월, 첫 구매월보다 앞선 주문, 첫 구매월 주문이 없는 고객 | 전체 이력과 마스터 재검증 |
| 주문 상태 | COMPLETED가 아닌 상태 | 완료 주문 추출 기준 확인 |
| 관측 범위 | 완료 범위 뒤의 주문, 잘못된 월 또는 정책 | 월별 수집 완료 여부와 설정 확인 |
| 출력 경로 | 이미 있는 폴더, 입력 파일과 같은 경로 | 사용하지 않은 새 출력 경로 선택 |
예를 들어 input/failures/orders_cancelled.csv는 정상 주문 10건 뒤에 다음 행을 추가한 오류 재현용 파일입니다.
O011,C001,2026-03,CANCELLED
다음 실행은 종료 코드 2로 중단하며 output_cancelled를 만들지 않습니다. 아래 echo 명령은 Linux 셸에서 바로 앞 명령의 종료 코드를 보여 줍니다.
python code/cohort.py --customers input/customers.csv --orders input/failures/orders_cancelled.csv --policy input/policy.json --out output_cancelled
echo $?
ERROR: Only COMPLETED orders allowed: O011
2
복구하려면 원천의 상태를 확인해 올바른 완료 주문 추출본을 준비해야 합니다. 오류를 없애려고 CANCELLED를 무조건 COMPLETED로 바꾸면 안 됩니다. 예제에서는 검증된 정상 입력으로 돌아가 새 폴더에 실행합니다.
python code/cohort.py --customers input/customers.csv --orders input/orders.csv --policy input/policy.json --out output_normal_rerun
정상 실행했던 output_normal을 다시 지정해도 중단합니다.
python code/cohort.py --customers input/customers.csv --orders input/orders.csv --policy input/policy.json --out output_normal
echo $?
ERROR: Output already exists; choose a new directory
2
코드는 존재하는 출력 파일을 덮어쓰지 않습니다. 출력의 부모 폴더가 없다면 먼저 별도로 만들거나 이미 있는 현재 폴더 아래의 새 이름을 사용하세요. 입력 세 경로도 서로 다른 파일이어야 합니다. 심볼릭 링크 출력은 별도로 거절합니다.
이미 있는 출력 폴더는 비어 있어도 덮어쓰지 않습니다. 재실행은 out-normal-rerun 같은 새 이름을 사용하세요. 입력 경로와 출력 경로가 겹치는 경우도 거절합니다. 입력 오류를 고칠 때는 출처를 확인한 복사본을 수정하고 원본 주문 파일을 보존하는 편이 안전합니다.
출력 쓰기가 실패하면 이번 실행이 새로 만든 부분 출력 폴더만 정리합니다. 입력 파일이나 기존 출력 폴더를 삭제하지 않습니다. summary.json은 마지막에 쓰는 완료 표시입니다. 다만 여러 파일 전체가 한 번에 원자적으로 공개되거나 동시에 다른 프로그램이 읽는 상황까지 보장하지는 않습니다. 종료 코드 0과 summary.json을 확인한 후 결과를 이용하세요.
입력 한도와 실제 업무에서의 한계
이 실습은 작은 CSV를 메모리에서 처리합니다. 입력 파일은 각각 2MiB 이하이고, 각 CSV의 데이터 행은 10,000개 이하입니다. 월은 YYYY-MM 형식이며 연도는 2000~2099만 허용합니다. 완료 관측 범위는 최대 24개월, max_offset은 정수 0~12입니다. ID는 영문자 또는 숫자로 시작하며 이후에는 영문자·숫자·밑줄·하이픈을 쓸 수 있고 길이는 32자 이하입니다. UTF-8 파일의 BOM은 허용하지만 임의의 다른 인코딩을 자동 감지하지 않습니다.
이 한도는 파일·행·기간의 크기를 제한합니다. 실행 시간이나 실제 메모리 사용량의 절대 상한을 보증하는 장치는 아닙니다. 큰 거래 자료, 여러 통화, 시간대별 날짜 변환, 고객 계정 병합, 주문 상태 변경, 반품 정책, 추출 누락 검출은 별도 설계가 필요합니다.
입력에는 이미 확정한 구매월을 사용합니다. 날짜나 시각에서 월을 정하는 업무 규칙은 포함하지 않습니다. 고객 마스터의 진짜 첫 구매와 월별 수집 완전성도 코드가 자동으로 확인할 수 없습니다. 또한 관측된 구매 참여율을 장기 고객 가치나 고객 이탈의 원인으로 곧바로 확대 해석하지 않습니다.
검증 범위와 다음 실습
ZIP 최상위 폴더에서 자동 검증을 실행할 수 있습니다.
python -m unittest discover -s code -v
python code/verify_examples.py
실제 검증에서는 회귀 테스트 43개가 모두 통과했습니다. 테스트에는 정상 집계, 관측 0%, 달력월 경계, 반올림, 입력 형식·한도, 중복과 고객 연결, 출력 거절, 쓰기 실패 후 복구 등이 포함됩니다.
verify_examples.py는 임시 폴더에서 실제 CLI 15개를 실행합니다. 정상·관측 0% 두 경우, 잘못된 입력 파일 12개, 기존 출력 거절 한 경우입니다. 기대 CSV와 핵심 요약 건수를 비교하고, 감사 파일에서 주문 10건의 고유 주문 ID를 확인합니다. 입력 파일 16개의 실행 전후 SHA-256도 같았습니다. 출력의 status는 PASS, cli_checks는 15, source_files_preserved는 16입니다.
evidence 폴더에는 회귀 결과, CLI 검증 기록, 정상·관측 0% 실제 출력과 런타임 정보가 포함됩니다. 이 기록은 지정한 합성 자료와 테스트 조건의 검증 증거입니다. 모든 실제 업무 자료의 정확성이나 모든 운영체제의 동작을 보증하지는 않습니다.
공식 Python 참고 문서는 Python 3.12 계열 문서이며 조사 당시 문서의 패치 표시는 3.12.15였습니다. 실제 실행에 사용한 CPython은 3.12.14로 구분합니다.
결과를 응용할 때는 먼저 분석 대상과 완료 기간을 정하고, 전체 이력으로 검증한 고객 마스터를 준비하세요. 그 다음 동일 고객·월 중복을 줄이고 고정 분모로 계산합니다. 마지막으로 관측 상태를 보존한 채 표를 읽습니다.
다음 단계에서는 max_offset을 늘릴 수 있습니다. 다만 완료 범위를 넘어선 셀은 여전히 빈칸이어야 합니다. 출력 범위보다 나중의 유효 주문도 감사 자료에서 보존하고 요약의 범위 밖 집계 건수로 확인합니다. 시각화를 추가하더라도 M0의 의미와 0%·미관측의 구분을 유지하세요.
참고 자료
- Python 3.12 csv 문서: CSV 읽기·쓰기와 newline 처리. 스크립트는 UTF-8 BOM을 허용하는 인코딩 설정과 정확한 열 검증을 함께 사용합니다.
- Python 3.12 집합 문서: 중복 없는 고객·월 조합을 만드는 자료구조.
- Python 3.12 Fraction 문서: 정수 분자·분모를 기반으로 정확한 비율을 보존하는 자료형.
- Shopify 고객 보고서: 첫 주문 시점으로 고객을 묶는 개념 참고. 이 글의 지표와 Shopify 지표의 동등성을 뜻하지 않습니다.
작성자 소개
