Python으로 구역형 보고서 CSV 펼치기: 구분 빈행 뒤에는 이전 구역을 이어 붙이지 않기
구역 A의 두 번째 품목에 구역명이 비어 있다면 위의 A를 내려 채울 수 있습니다. 그런데 구분 빈행을 지난 다음 품목에도 구역명이 없다면 어떨까요? 여기까지 A를 이어 붙이면 품목 수와 수량 합계가 모두 맞아도 소속 구역이 틀린 표가 됩니다.
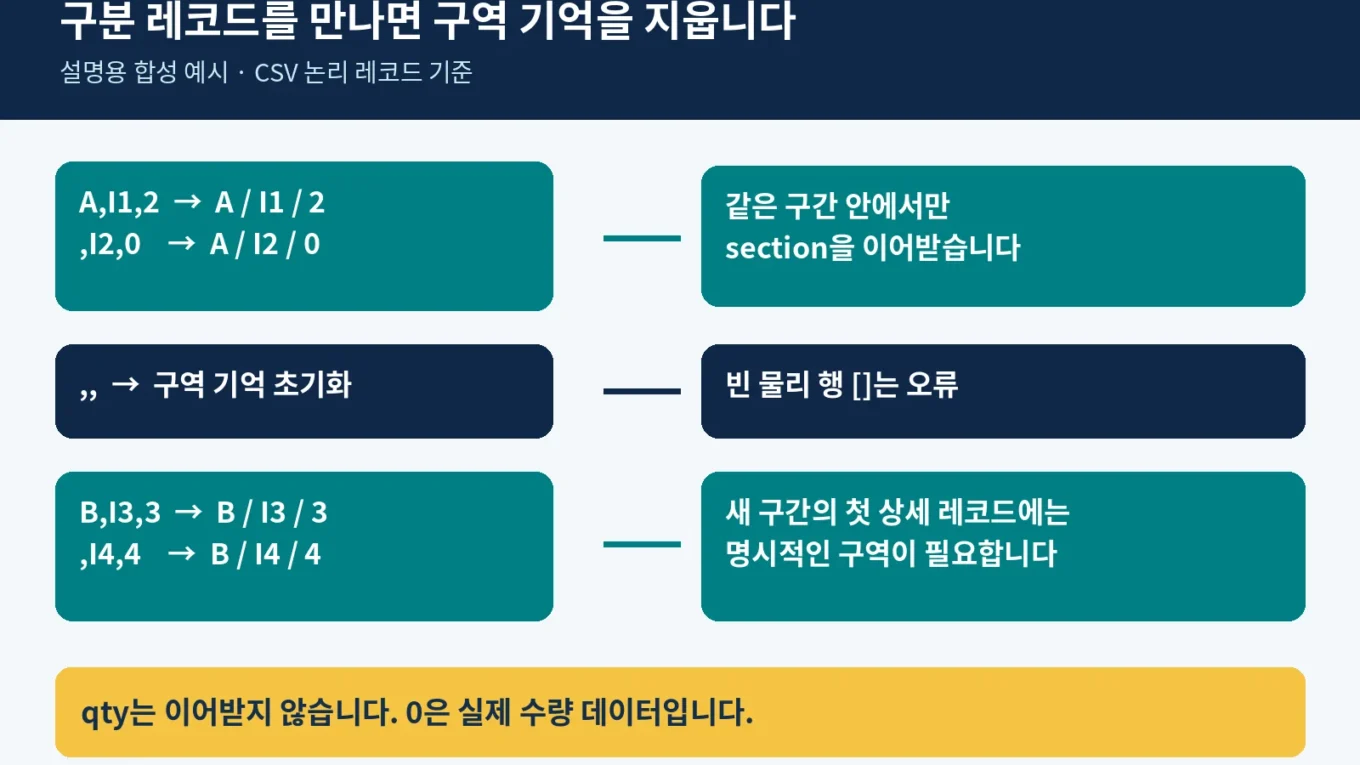
이번 실습은 이 차이를 Python으로 처리합니다. 같은 구역 안에서는 구역명만 이어받고, 구분 레코드를 만나면 기억하던 구역명을 지웁니다. 새 구역의 첫 품목에 제목이 없으면 추측하지 않고 전체 변환을 멈춥니다. 수량의 빈칸은 별도로 검사하며, 이전 수량을 내려 채우지 않습니다.
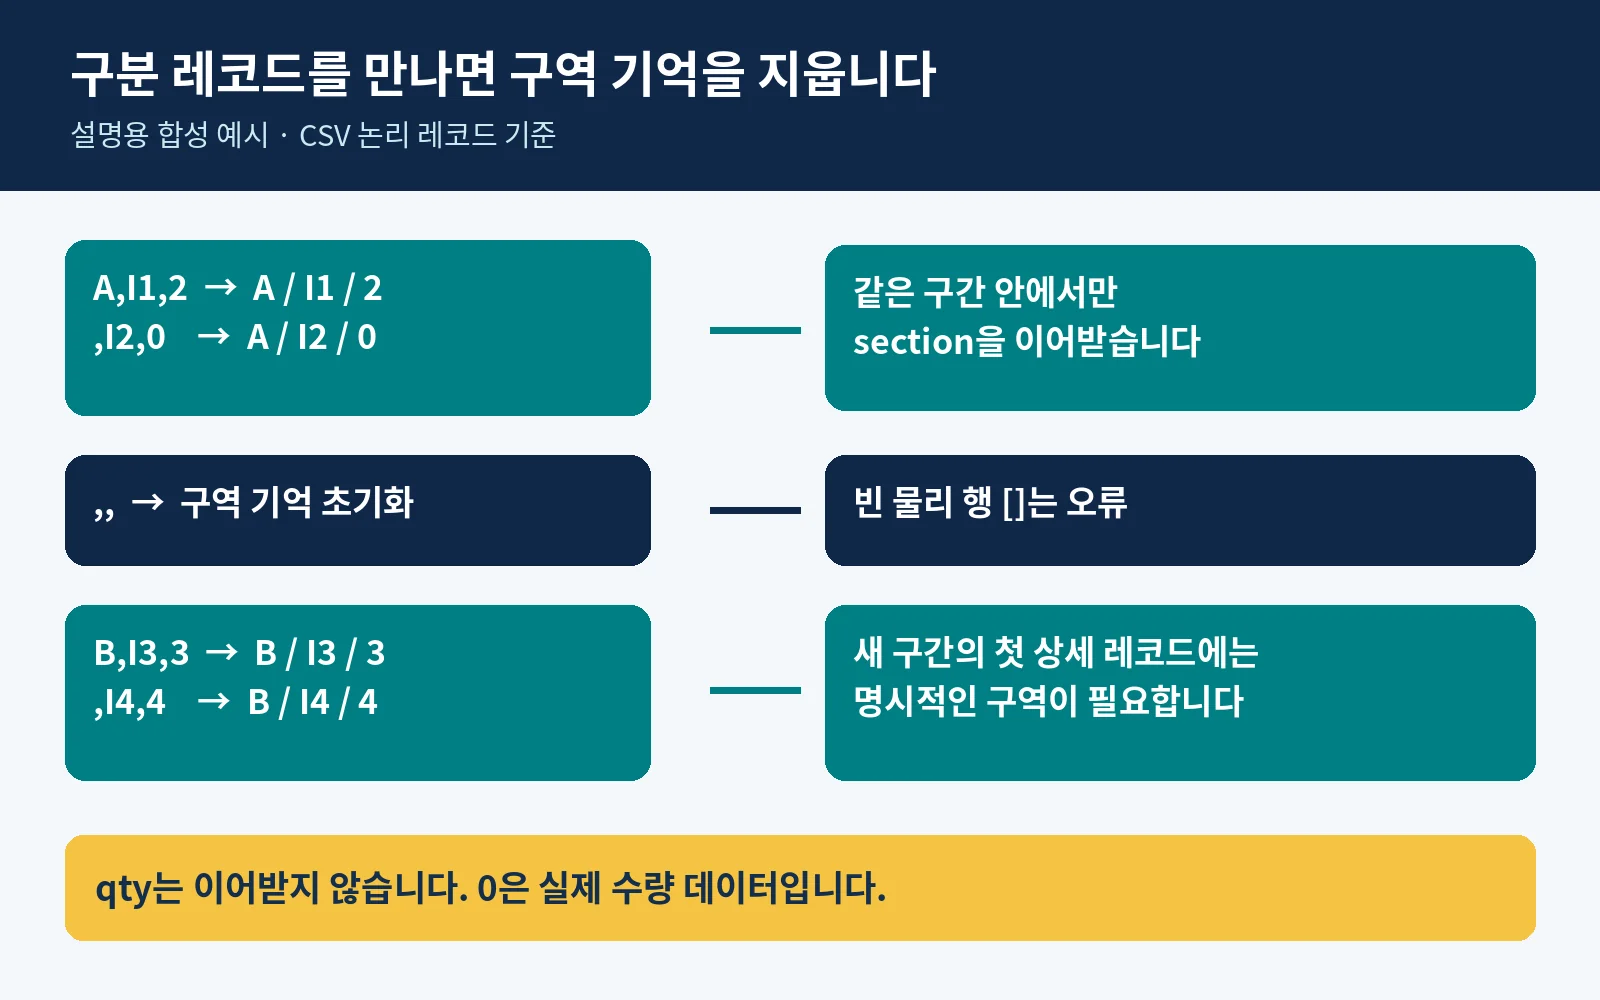
그림 1. 구분 레코드 뒤에서는 새로운 구역명이 필요합니다. 가상 데이터 설명도입니다.
먼저 CSV의 모양부터 정합니다
이 코드는 준비된 CSV를 읽습니다. 엑셀 파일의 셀 병합, 색상, 들여쓰기나 제목 위치를 해석하지 않습니다. 병합된 보고서를 그대로 CSV로 저장하면 필요한 제목이 사라질 수 있으므로, 아래 구조를 먼저 만들 수 있는 자료에 사용하세요.
- 첫 레코드의 열 이름과 순서는
section,item_id,qty입니다. section은 구역명,item_id는 파일 전체에서 중복되지 않는 품목 기록 ID입니다.- 구역명은 각 구역의 첫 품목과 같은 레코드에 넣습니다.
A,,처럼 제목만 있는 레코드는 지원하지 않습니다. - 쉼표 두 개로 표현한
,,는 세 필드가 모두 비어 있는 구분 레코드입니다. 이때만 구역의 경계를 인정합니다. - 텍스트 편집기에서 Enter만 눌러 생긴 완전히 빈 줄은 구분 레코드로 쓰지 않습니다. CSV 파서가 이를 빈 목록
[]으로 읽으면 오류로 처리합니다.
구역명이 비어 있다는 뜻은 빈 문자열입니다. 공백만 넣은 구역명·ID는 오류로 처리합니다. 다른 문자가 함께 있는 값의 앞뒤 공백은 그대로 보존하며, 자동으로 정리하지 않습니다. 예를 들어 A와 A는 서로 다른 문자열입니다. 자동 정리로 다른 코드가 같은 값이 되는 일을 피하기 위해서입니다.
자료를 준비할 때는 원본 통합문서를 보관하고, 별도 작업용 시트에 세 열을 만드세요. 합계·주석·독립 제목 행을 제외하고, 구역 첫 품목에 구역명을 명시합니다. 구역 사이에는 세 셀이 모두 빈 행을 한 줄 둡니다. 그 시트를 UTF-8 CSV 사본으로 내보낸 다음, 텍스트 편집기에서 첫 레코드와 ,,를 확인합니다. 프로그램이 읽는 것은 이 CSV 사본입니다. UTF-8 파일 시작의 BOM은 허용하지만, 다른 문자 인코딩은 자동 추정하지 않습니다. 내보내기 결과에 완전히 빈 줄이 생겼다면 해당 경계를 확인하고 ,,로 표현해야 합니다. 이 글에서 엑셀이나 Power Query의 내보내기 동작을 직접 실행한 것은 아닙니다.
정상 입력과 정답을 먼저 비교하세요
실습 파일은 모두 가상 데이터입니다. 정상 입력의 내용은 다음과 같습니다.
section,item_id,qty
A,I1,2
,I2,0
,,
B,I3,3
,I4,4
I2의 수량 0은 실제 값입니다. 구역명만 A를 이어받습니다. ,, 뒤의 I3는 B를 명시하고, I4는 그 B를 이어받습니다.
정상 결과에서 확인할 다섯 값은 원본 레코드 번호, 구역 블록 번호, 구역명, 품목 ID, 수량입니다.
2 / 1 / A / I1 / 2
3 / 1 / A / I2 / 0
5 / 2 / B / I3 / 3
6 / 2 / B / I4 / 4
원본 레코드 번호는 헤더와 구분 레코드를 포함합니다. CSV의 따옴표 안에 줄바꿈이 있으면 한 레코드가 여러 화면 줄에 걸칠 수 있으므로, 단순한 텍스트 줄 번호와는 다릅니다. 구역 블록 번호는 같은 이름의 구역이 나중에 다시 나타나도 별도 블록으로 추적하기 위한 값입니다.
정상 결과는 품목 4개, A 수량 2개, B 수량 7개, 전체 9개입니다. 여기서 합계만 보지 말고 위의 네 레코드를 모두 비교해야 합니다.
합계 9개가 같아도 틀릴 수 있습니다
이제 B 구역의 첫 품목에서 B만 지운 사본을 생각해 보겠습니다.
section,item_id,qty
A,I1,2
,I2,0
,,
,I3,3
,I4,4
구분 레코드를 무시한 채 마지막 구역명을 계속 내려 채우면 I3와 I4까지 A에 들어갑니다. 품목은 여전히 4개이고 수량도 여전히 9개라서, 전체 건수와 합계로는 이 오류를 발견할 수 없습니다. 구역별로 보면 올바른 A 2개·B 7개가 잘못된 A 9개로 바뀝니다.
이 실습의 올바른 결과는 B를 복원한 표가 아닙니다. 원본 레코드 5와 6에 ORPHAN_DETAIL을 기록하고, 최종 정규화 CSV를 만들지 않는 것입니다. 이 오류는 “현재 블록에서 이어받을 구역명이 없다”는 뜻입니다. 프로그램은 빠진 제목이 B였는지 C였는지 알 수 없습니다.
수정할 때도 오류가 난 원본을 덮어쓰지 마세요. 담당자가 확인한 근거가 있을 때 별도 사본의 I3에 B를 복원하고, 새 출력 폴더로 다시 실행합니다. 이 가상 실습에서는 정상 입력에 B가 있었으므로 복원할 값을 알고 있습니다. 실제 자료에서는 추측으로 B를 넣으면 안 됩니다.
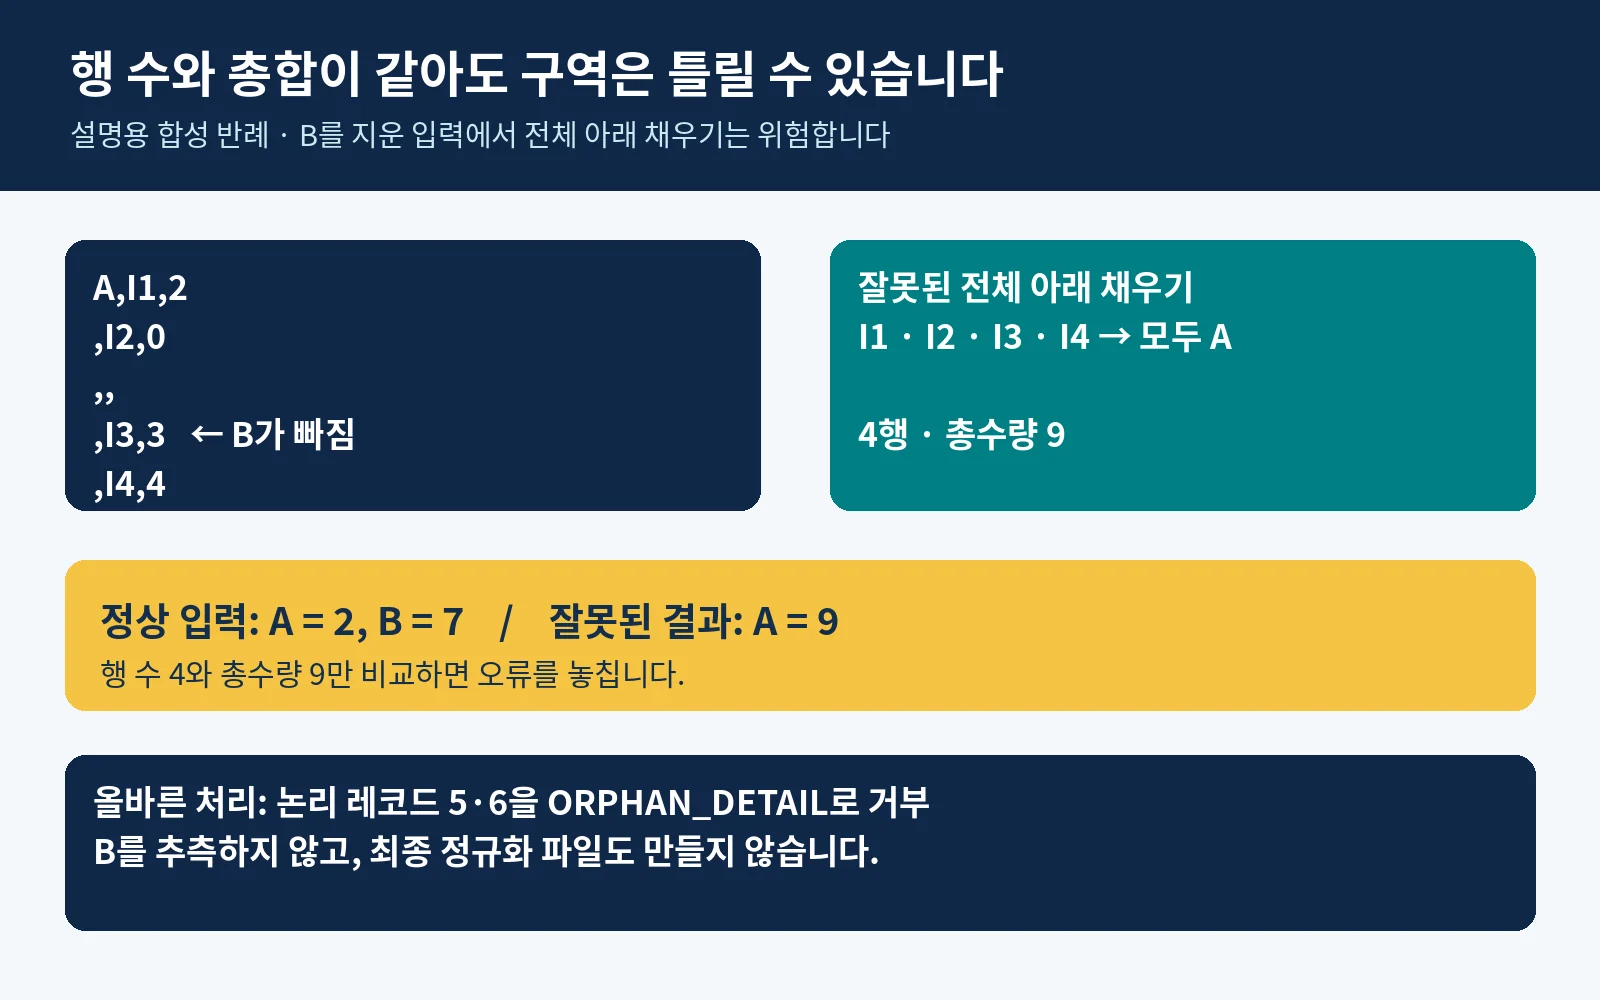
그림 2. 건수와 합계가 같아도 구역 소속이 맞는지는 별도로 확인해야 합니다.
수량 빈칸은 구역명 빈칸과 다릅니다
정상 입력에서 마지막 ,I4,4를 ,I4,로 바꾸면 I4의 구역은 B라고 판단할 수 있습니다. 그러나 수량은 알 수 없습니다. 앞 품목의 3을 가져오거나 0으로 바꾸지 않고 오류로 처리해야 합니다.
이 실습의 수량은 ASCII 숫자로 적은 0 이상 999999999999 이하의 정수입니다. 0 또는 0이 아닌 숫자로 시작하는 최대 12자리만 허용합니다. 00·03 같은 선행 0 표기, 음수, 소수, 공백이 붙은 숫자, True 같은 문자열은 받지 않습니다. 품목 ID의 선행 0은 문자열로 보존합니다. 수량 규칙이 다른 업무라면 그 규칙을 먼저 정해야 합니다. 단위가 다른 수량이나 소수 중량을 이 코드에 억지로 맞추지 마세요.
또한 구분 레코드 없이 A 다음에 B를 명시하면 제목 변경 오류로 거절합니다. 이 자료에서 구역 전환을 알리는 약속은 ,,이기 때문입니다. 같은 블록에서 A를 다시 명시하는 것은 허용하고, 구분 레코드 다음에 A가 다시 나오는 것은 새 블록으로 남깁니다. 연속 구분 레코드나 마지막 구분 레코드는 품목으로 세지 않습니다.
압축파일을 풀고 첫 실행하기
구역 경계 CSV 정규화 실습 ZIP 내려받기 (15 KB)
실습 ZIP에는 실행 코드, 정상·오류·복원 입력, 기대 결과, 테스트와 사용 설명서를 함께 담습니다. 아래 명령은 ZIP을 풀어 실행 파일이 있는 폴더에서 사용합니다. Python이 설치되어 있어야 하며 추가 패키지는 필요하지 않습니다.
- ZIP을 풀고 터미널에서
normalize_sections.py가 있는 폴더로 이동합니다. Windows에서는 해당 폴더에서 터미널을 열고py --version, 다른 환경에서는python --version으로 Python 3 설치를 확인하세요. 아래의python명령을 찾지 못하면 환경에 맞게py또는python3로 바꿉니다. 다음 예는 실행 방법 안내이며 Windows 실행 검증 결과는 아닙니다. - 정상 입력을 새 출력 폴더에 실행합니다.
python normalize_sections.py fixtures/normal.csv results-normal정상 종료 코드는 0입니다. results-normal에 normalized.csv와 report.json이 생깁니다. 정규화 CSV의 실제 기대 내용은 다음과 같습니다.
source_record,segment,section,item_id,qty
2,1,A,I1,2
3,1,A,I2,0
5,2,B,I3,3
6,2,B,I4,4
보고서의 status는 approved, detail_rows는 4, quantity_total은 9, segments는 2입니다. 여기서 approved는 이 실습의 입력 규칙을 통과했다는 뜻입니다. 원본 업무 사실을 승인하거나 데이터가 현실과 일치함을 보증하지 않습니다. input_sha256은 읽은 입력의 해시입니다.
- 제목이 빠진 입력을 다른 폴더 이름으로 실행합니다.
python normalize_sections.py fixtures/orphan_after_separator.csv results-orphan이 실행은 종료 코드 2로 끝나며 다음 진단을 표준 오류에 출력합니다. JSON의 공백 표시 방식은 환경에 따라 보이는 폭만 달라질 수 있습니다.
{"status":"rejected","errors":[{"record":5,"code":"ORPHAN_DETAIL"},{"record":6,"code":"ORPHAN_DETAIL"}]}이때 results-orphan 폴더 자체를 만들지 않습니다. 따라서 부분 성공 CSV나 정상 완료 보고서도 없습니다. 오류 입력에 대한 별도 진단 파일을 자동 저장하지 않으므로 터미널의 메시지를 확인하세요.
- 수량 누락과 복원 입력도 각각 새 이름으로 실행합니다.
python normalize_sections.py fixtures/missing_qty.csv results-missing
python normalize_sections.py fixtures/recovered.csv results-recovered
수량 누락 입력은 원본 레코드 6의 INVALID_QTY로 거절됩니다. 복원 입력은 위 정상 결과의 네 레코드와 같아야 합니다. 같은 출력 폴더를 다시 지정하면 OUTPUT_EXISTS로 거절하므로, 재실행할 때는 results-normal-2처럼 아직 없는 이름을 사용합니다.
2026년 10월 15일 Linux의 Python 3.12.14에서 패키지 테스트를 실행했습니다. 14개 테스트 메서드와 그 하위 사례에서 정상·오류·복원, 레코드 경계와 인용, 수량 형식, 새 출력 경로를 확인했습니다. 입력 해시 불변도 검사했습니다. 실제 결과는 ZIP의 테스트 로그에서 확인할 수 있습니다. Excel이나 Power Query를 실행한 테스트는 아닙니다.
첫 실행에서는 정상 입력을 선택합니다. 생성된 정규화 CSV의 네 레코드를 위 정답과 대조한 다음, 구역 제목 누락 입력과 수량 누락 입력을 각각 새로운 출력 폴더로 실행하세요. 오류 실행에서 최종 정규화 CSV가 생기지 않는지도 확인합니다. 마지막으로 복원 입력을 다시 별도 폴더에 실행해 정상 정답으로 돌아오는지 봅니다.
출력 폴더나 파일이 이미 있다면 새 이름을 사용하세요. 이전 성공 결과를 오류 실행의 결과로 오인하지 않도록, 입력을 고칠 때마다 결과 위치도 구분하는 편이 안전합니다.
코드에서 중요한 부분은 구역 기억을 지우는 순서입니다
다음은 전체 코드의 구역 상태 처리 부분을 일부 생략해 발췌한 것입니다. 파일 열기, 진단 수집, 입력 검사와 안전한 저장까지 포함한 실행용 전체 코드는 ZIP을 사용하세요.
if fields == ['', '', '']:
    section = None
    boundary = True
    continue

# 중간의 필드 수·제목 등 검사 생략
if section is None:
    error(record, 'ORPHAN_DETAIL')
핵심은 “빈칸이면 무조건 이전 값을 가져온다”가 아니라, 구역 경계를 만난 순간 이전 값을 사용할 권한을 없애는 것입니다. 실제 코드는 필드 수와 빈 물리 레코드도 먼저 검사하고, 잘못된 자료가 하나라도 있으면 정상 행만 따로 내보내지 않습니다.
Python 공식 문서는 CSV 파일을 newline=''로 열고, csv.reader가 각 필드를 문자열로 반환한다고 설명합니다. 그래서 이 실습은 CSV 파서로 레코드를 읽은 뒤 열 개수와 수량 형식을 직접 검사합니다. 문자열을 쉼표로 단순 분리하면 따옴표 안의 쉼표나 줄바꿈을 제대로 처리할 수 없습니다.
Microsoft의 Power Query 설명에서 아래 채우기는 다음 값이 나올 때까지 null을 채우는 작업입니다. 문서는 빈 것처럼 보이는 값과 null도 구분합니다. 다만 “세 필드가 빈 레코드를 구역 경계로 삼는다”는 규칙은 이번 가상 자료에 정한 업무 약속입니다. Microsoft가 모든 보고서에 이 규칙을 요구한다는 뜻은 아닙니다.
내 자료에 적용하기 전 확인할 것
- 구역의 첫 품목과 제목이 같은 레코드에 있나요? 제목만 있는 행, 중간 합계, 여러 단계 제목이 있다면 먼저 별도 설계가 필요합니다.
- 구역 경계가 반드시 세 빈 필드로 남아 있나요? 빈 레코드를 미리 제거하면 경계 정보를 잃습니다.
- 품목 ID가 빠지거나 중복되지 않았나요? 서로 다른 품목 기록을 구분할 수 있어야 합니다.
- 수량 0과 미입력을 구분하나요? 빈 수량을 0으로 바꾸지 마세요.
- 전체 합계뿐 아니라 원본 레코드·블록·구역·품목·수량을 함께 비교했나요?
엑셀의 병합 셀이 지정 범위에 걸치는지 확인하는 작업, 여러 지점 CSV를 한 표로 합치는 작업, 문자 코드를 정리하는 작업과는 입력 조건이 다릅니다. 이 글의 목적은 준비된 구역형 CSV에서 제목을 이어받을 범위를 지키고, 경계 뒤의 누락을 드러내는 것입니다.
확인 범위와 참고 문서
공식 문서는 2026년 10월 15일에 확인했습니다. 코드 실행 환경과 실제 검증 결과는 위 실습 안내에 명시합니다. Windows, Excel, Power Query에서 직접 실행한 결과로 표현하지 않습니다. 합성 입력을 처리하는 Python 실습이므로 다른 모양의 보고서를 자동 변환한다고 보장하지 않습니다.
- Python 3.12 csv 공식 문서: 문자열 필드, newline 처리, 인용된 필드와 레코드의 차이
- Microsoft Learn: Fill values in a column: 아래 채우기와 null의 의미
작성자 소개
