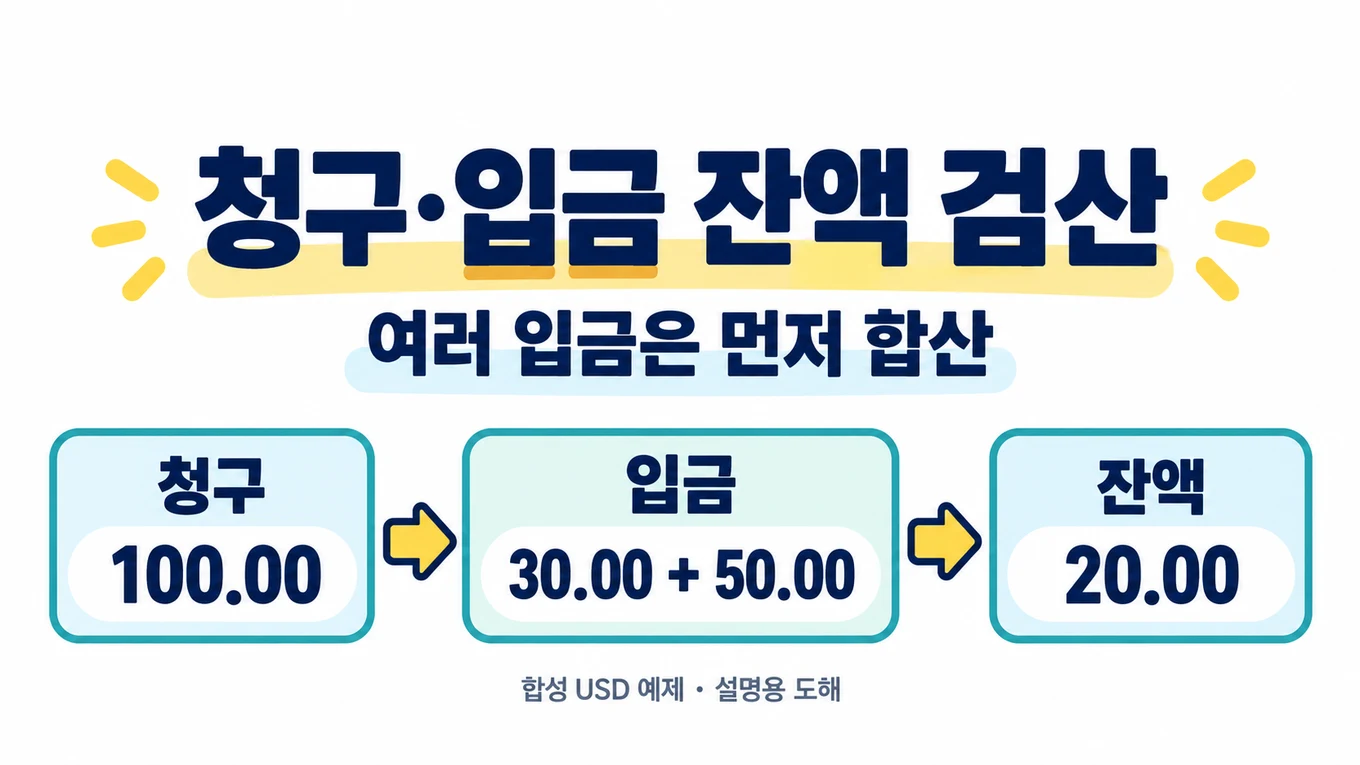
한 청구서에 여러 입금이 있을 때 잔액과 미배정 입금을 따로 검산하기
100.00 청구서에 30.00과 50.00이 나누어 입금되었다면 남은 금액은 20.00입니다. 첫 입금 한 건만 가져오면 70.00이 남았다고 잘못 판단하게 됩니다. 반대로 입금 두 건에 청구액 100.00을 각각 붙인 뒤 합계를 내면 청구액이 두 번 더해집니다.
이 글에서는 청구 CSV 4건과 입금 CSV 6건을 Python으로 대조합니다. 결과는 청구 280.00, 입금 245.00, 청구에 배정한 입금 230.00, 미배정 입금 15.00입니다. 청구별로 아직 받을 금액은 60.00, 초과입금은 10.00이며, 둘의 차이인 부호 있는 잔액 합계는 50.00입니다. 이 숫자들을 따로 남겨 두어 입금 누락과 청구액 중복을 찾는 것이 실습의 목표입니다.
계산은 Python 표준 라이브러리만 사용합니다. 예제의 USD와 CONFIRMED는 합성 데이터의 약속이며, 실제 은행 기록 확인이나 취소·환불·회계처리를 보증하는 표시가 아닙니다.
1. 청구 4건과 입금 6건을 먼저 읽어 보세요
input/invoices.csv에는 다음 청구서가 있습니다. 금액 단위는 모두 USD입니다.
| invoice_id | currency | amount |
|---|---|---|
| I001 | USD | 100.00 |
| I002 | USD | 80.00 |
| I003 | USD | 60.00 |
| I004 | USD | 40.00 |
| 합계 | USD | 280.00 |
input/payments.csv에는 다음 입금이 있습니다. CONFIRMED는 이 예제에서 계산 대상으로 받겠다는 상태값입니다.
| payment_id | invoice_id | currency | amount | payment_state |
|---|---|---|---|---|
| R001 | I001 | USD | 30.00 | CONFIRMED |
| R002 | I001 | USD | 50.00 | CONFIRMED |
| R003 | I002 | USD | 80.00 | CONFIRMED |
| R004 | I003 | USD | 70.00 | CONFIRMED |
| R005 | 비어 있음 | USD | 10.00 | CONFIRMED |
| R006 | I999 | USD | 5.00 | CONFIRMED |
| 합계 | USD | 245.00 |
I001에는 입금이 두 번 있었습니다. I002는 금액이 정확히 맞고, I003은 청구보다 10.00이 더 들어왔습니다. I004는 입금이 없습니다. R005는 청구번호가 없고, R006의 I999는 청구 목록에 존재하지 않습니다. 이 두 입금은 어느 청구서의 잔액에서도 차감하지 않습니다.
R005와 R006의 합계 15.00도 원본 입금 245.00의 일부이므로 버리지 않고 확인 목록으로 남깁니다. ‘배정’은 적힌 청구번호가 청구 목록과 정확히 일치한다는 뜻입니다. 거래처명이나 금액으로 추정해 연결하지 않습니다.
2. 조회와 상세 결합에서 생기는 두 가지 오류
I001을 검색하여 첫 번째 값 하나만 가져왔다고 생각해 보세요. R001의 30.00만 잡히면 100.00 − 30.00 = 70.00입니다. R002의 50.00까지 합산해야 실제 예제 잔액인 20.00이 나옵니다. 청구 한 건에 입금 여러 건이 붙는 자료에서는 한 건을 찾았다는 사실만으로 집계가 끝나지 않습니다.
이번에는 청구 4건을 모두 유지하면서 입금 상세를 붙였다고 생각해 보세요. I001은 입금 두 건 때문에 두 행이 되고, I002·I003·I004는 각각 한 행이 됩니다. 이 상세표에서 청구액 열을 합산하면 100.00 + 100.00 + 80.00 + 60.00 + 40.00 = 380.00입니다. 원본 청구 합계 280.00과 100.00 차이가 납니다. 입금 내역을 보려 만든 표에서 청구액까지 더해 버린 결과입니다.
첨부 코드는 청구번호마다 합계 칸을 하나 만들고 입금을 누적한 뒤, 원본 청구를 한 번씩 순회해 잔액을 계산합니다. 청구별 결과는 4행, 입금별 결과는 6행입니다. 두 번째 입금을 살리면서 청구액의 반복도 피합니다.
3. 첨부파일을 풀고 정상 예제를 실행하세요
ZIP을 새 폴더에 풀면 code, input, expected, evidence 폴더가 있습니다. code/reconcile.py가 실행 파일이고, input은 합성 원본, expected는 정상 예제의 기대 결과입니다. 터미널에서 압축을 푼 폴더로 이동하세요. code 폴더 안으로 들어가지 않고 그 상위 폴더에서 실행합니다.
먼저 아래 명령으로 사용 중인 Python을 확인합니다. Python이 없다면 Python 공식 다운로드에서 설치 안내를 확인하세요. 이 실습을 실제 검증한 환경은 Linux의 CPython 3.12.14입니다. 다른 버전이나 Windows·macOS에서 실행한 결과는 확인하지 않았습니다.
python --version
명령을 찾을 수 없고 python3 --version은 실행된다면 이후 명령의 맨 앞을 python3로 바꾸세요. 추가 패키지는 필요하지 않습니다.
정상 예제는 아래 한 줄로 실행합니다. result_normal은 아직 존재하지 않아야 하며, 명령 실행 전에 직접 만들지 마세요.
python code/reconcile.py --invoices input/invoices.csv --payments input/payments.csv --out result_normal
정상 실행의 종료 코드는 0이고, 화면에는 다음 두 줄이 나옵니다.
청구 280.00 / 입금 245.00 / 배정 230.00 / 미배정 15.00 / 미결 60.00 / 초과 10.00
보고서 생성 완료, 추가 검토 필요: True
‘추가 검토 필요: True’는 미결 청구·초과입금·미배정 입금이 있어 사람이 확인해야 한다는 뜻입니다. 보고서 생성 완료만으로 정산이 끝났다고 판단하지 마세요.
4. 결과 파일 네 개는 서로 역할이 다릅니다
result_normal/balances.csv는 청구별 결과입니다. 화면에서 비교하기 쉽도록 주요 열만 정리하면 다음과 같습니다.
| 청구번호 | 청구액 | 입금 건수 | 배정액 | 부호 잔액 | 미결액 | 초과액 | 상태 |
|---|---|---|---|---|---|---|---|
| I001 | 100.00 | 2 | 80.00 | 20.00 | 20.00 | 0.00 | PARTIAL |
| I002 | 80.00 | 1 | 80.00 | 0.00 | 0.00 | 0.00 | SETTLED |
| I003 | 60.00 | 1 | 70.00 | -10.00 | 0.00 | 10.00 | OVERPAID |
| I004 | 40.00 | 0 | 0.00 | 40.00 | 40.00 | 0.00 | UNPAID |
| 합계 | 280.00 | 4 | 230.00 | 50.00 | 60.00 | 10.00 |
invoice_amount는 원본 청구액, payment_count는 해당 청구에 연결된 입금 건수, applied_amount는 연결된 입금 전액의 합계입니다. 청구액까지만 배정하고 초과분을 잘라 내는 방식이 아닙니다. 그래서 I003의 배정액은 70.00입니다.
signed_balance는 청구액에서 배정액을 뺀 값입니다. 음수도 그대로 남깁니다. outstanding_amount에는 양수 잔액만, excess_amount에는 음수 잔액의 크기만 기록합니다. status는 입금 없음 UNPAID, 일부 입금 PARTIAL, 금액 일치 SETTLED, 초과입금 OVERPAID를 구분합니다. 이 상태는 합성 입력의 계산 결과이지 실제 지급·회수 여부를 확인한 판정은 아닙니다.
result_normal/payments.csv는 원본 입금 6건 모두의 처리 결과입니다. R001부터 R004는 APPLIED이고, R005와 R006는 UNASSIGNED입니다. assignment가 배정 여부, reason이 미배정 사유입니다. result_normal/unassigned.csv에는 이 중 확인이 필요한 두 건만 들어갑니다.
| 입금번호 | 청구번호 | 금액 | assignment | reason |
|---|---|---|---|---|
| R005 | 비어 있음 | 10.00 | UNASSIGNED | MISSING_INVOICE_ID |
| R006 | I999 | 5.00 | UNASSIGNED | UNKNOWN_INVOICE_ID |
MISSING_INVOICE_ID는 청구번호 누락, UNKNOWN_INVOICE_ID는 적힌 번호가 청구 목록에 없다는 뜻입니다. 둘은 수정할 근거가 다르므로 나누어 둡니다. unassigned.csv는 전체 입금표의 부분 목록입니다. 두 파일의 금액을 다시 합치면 미배정 입금을 중복 계산하게 됩니다.
source_record는 원본 CSV 레코드 위치입니다. 머리글을 1로 세므로 I001은 2, R005는 6으로 돌아가 확인합니다. 따옴표 안 줄바꿈이 있으면 물리 줄과 레코드 번호가 다르므로 구문 오류의 ‘읽은 물리 줄’과 구별하세요. Python CSV 공식 문서는 line_num이 물리 줄 수를 센다고 설명합니다.
result_normal/summary.json은 건수·금액 합계와 검산 결과, 원본 및 출력 CSV의 SHA-256, 완료 표시를 담습니다. CSV는 UTF-8 BOM으로 저장되지만, 이 글에서 Excel 가져오기나 다시 열기까지 실행해 검증한 것은 아닙니다. 먼저 첨부된 기대 CSV와 Python 검증 결과로 내용이 맞는지 확인하세요.
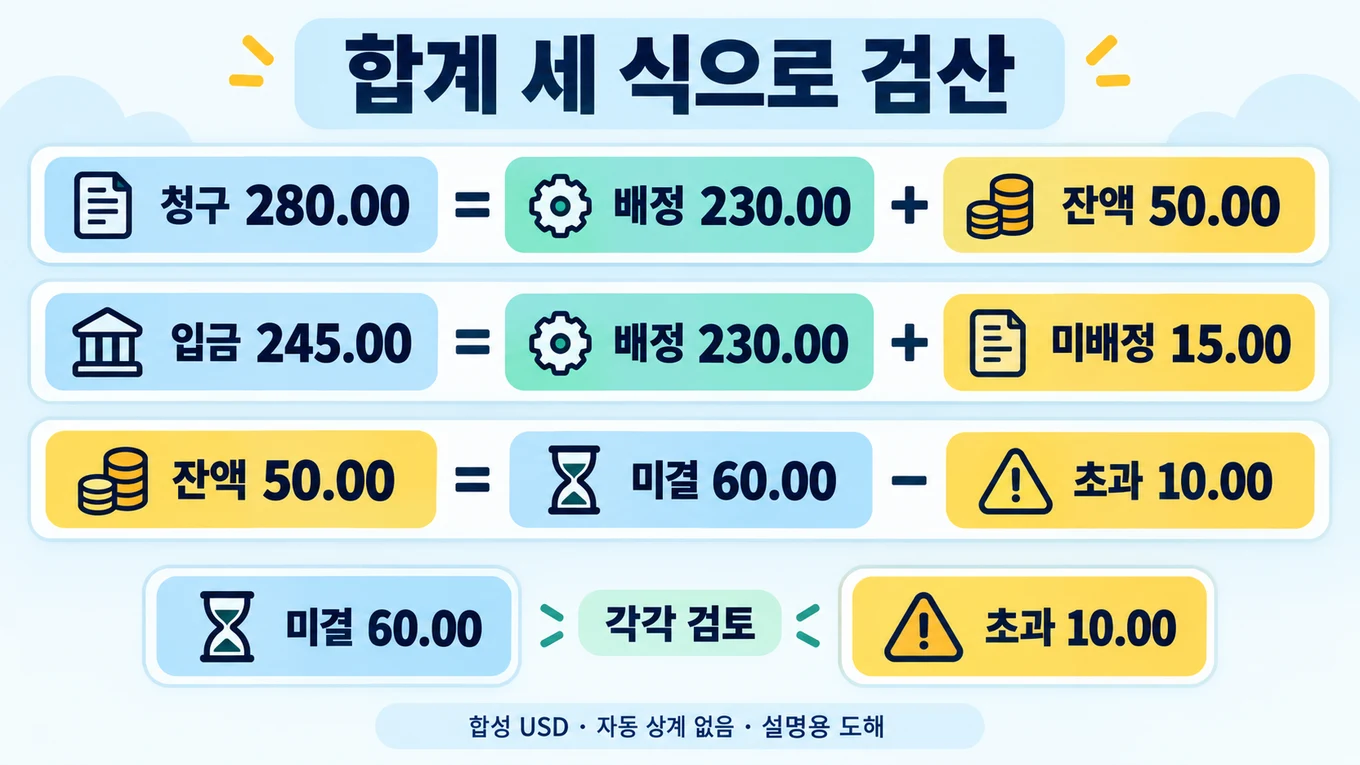
5. 합계 세 식과 입금 건수를 함께 맞춰 보세요
첫째, 청구 합계는 배정액과 부호 있는 잔액의 합계여야 합니다.
280.00 = 230.00 + 50.00
청구 합계 = 배정액 합계 + 부호 잔액 합계
둘째, 입금 합계는 배정액과 미배정액으로 빠짐없이 나뉘어야 합니다.
245.00 = 230.00 + 15.00
입금 합계 = 배정액 합계 + 미배정액 합계
셋째, 부호 있는 잔액은 미결액에서 초과액을 뺀 값입니다.
50.00 = 60.00 - 10.00
부호 잔액 합계 = 미결액 합계 - 초과액 합계
이 세 식이 성립해도 잔액 50.00만 보고하면 I001의 20.00과 I004의 40.00, I003의 초과입금 10.00이 가려집니다. 미결 60.00과 초과 10.00은 따로 검토하며, 다른 청구의 초과입금이나 미배정 입금을 자동으로 옮겨 잔액을 줄이지 않습니다.
금액에 더해 건수도 확인합니다. 원본 입금 6건은 배정 4건과 미배정 2건으로 나뉩니다. 청구번호가 같은 두 입금은 정상일 수 있지만, 같은 payment_id가 두 번 나오면 중복으로 거부합니다. 코드의 checks에는 세 금액 식과 payment_rows_partitioned_once가 들어 있으며, 어느 하나라도 거짓이면 확정 출력을 보류합니다. 이 검산은 입력 사이의 일관성 검사입니다. 원본 거래가 빠졌거나 잘못 적힌 경우까지 실제 은행 자료와 대조해 주지는 않습니다.
6. 전체 코드와 입력 조건을 확인하세요
아래는 첨부된 code/reconcile.py 전체입니다. 그대로 저장하면 같은 실습을 실행할 수 있습니다. CSV는 UTF-8 또는 UTF-8 BOM, 쉼표 구분이어야 하며 머리글 이름과 순서가 정확히 맞아야 합니다. 청구 머리글은 invoice_id,currency,amount, 입금 머리글은 payment_id,invoice_id,currency,amount,payment_state입니다.
ID는 영문 대·소문자, 숫자, 밑줄, 하이픈만으로 1~32자이며 첫 글자는 영문 또는 숫자여야 합니다. 대소문자를 구별하며 앞뒤 공백을 자동 제거하지 않습니다. 금액은 0보다 크고 999999.99 이하인 일반 소수 두 자리 문자열만 받습니다. 30.00은 가능하지만 30, 30.001, -30.00, 1e2는 거부합니다. 청구 목록은 데이터 1행 이상 필요하고, 입금 목록은 정확한 머리글만 있는 0행도 허용합니다.
통화는 USD 하나만, 입금 상태는 CONFIRMED만 받습니다. CANCELLED·PENDING, 0금액, 다른 통화, 중복 ID나 잘못된 금액이 한 행이라도 있으면 전체를 중단합니다. 문제가 있는 행만 조용히 제외하거나 금액을 반올림하지 않습니다. 미배정 입금도 이 검사를 통과해야 하므로, 청구번호가 없다는 이유로 다른 통화나 취소 상태를 허용하지 않습니다.
read_rows는 원본을 읽고 이 조건을 검사합니다. CSV의 strict=True로 구문 오류를 확인하면서 머리글·열 수·값의 규칙은 별도로 검사합니다. CSV 쓰기 때 newline=''을 사용하는 이유도 Python CSV 공식 문서에서 확인할 수 있습니다.
reconcile은 문자열에서 Decimal을 만들고 정밀도 28의 계산 문맥을 사용합니다. 중간에 float로 바꾸지 않으므로 0.10과 0.20도 예제의 십진값대로 합산합니다. Inexact와 FloatOperation 트랩은 해당 신호가 생겼을 때 오류로 처리하기 위한 장치입니다. 생성과 계산 문맥의 차이는 Decimal 공식 문서에 설명되어 있습니다. 이 코드의 허용 금액과 행 수 범위에서 계산을 검증했으며, 모든 규모의 계산을 보증하는 설정은 아닙니다.
write_outputs는 존재하지 않는 새 출력 폴더만 받습니다. 파일을 x 모드로 생성하여 이미 있는 파일에 덮어쓰지 않습니다. Python open 공식 문서의 배타적 생성 모드에 해당합니다. 결과 CSV 세 개를 쓴 뒤 해시를 기록하고, 마지막에 summary.json에 completed: true를 씁니다.
"""Reconcile fictional one-invoice-to-many-payments ledgers without editing inputs."""
import argparse
import csv
import hashlib
import io
import json
import re
import sys
from decimal import Context, Decimal, DecimalException, FloatOperation, Inexact, localcontext
from pathlib import Path

INVOICE_HEADER = ['invoice_id', 'currency', 'amount']
PAYMENT_HEADER = ['payment_id', 'invoice_id', 'currency', 'amount', 'payment_state']
BALANCE_HEADER = ['invoice_id', 'currency', 'invoice_amount', 'payment_count',
                  'applied_amount', 'signed_balance', 'outstanding_amount',
                  'excess_amount', 'status', 'source_record']
AUDIT_HEADER = ['payment_id', 'invoice_id', 'currency', 'amount', 'payment_state',
                'assignment', 'reason', 'source_record']
ID_RE = re.compile(r'[A-Za-z0-9][A-Za-z0-9_-]{0,31}\Z')
AMOUNT_RE = re.compile(r'(?:0|[1-9][0-9]{0,5})\.[0-9]{2}\Z')
CURRENCY = 'USD'
MAX_ROWS = 10_000
MAX_BYTES = 2_000_000
ZERO = Decimal('0.00')
MAX_AMOUNT = Decimal('999999.99')


def read_rows(path, header, kind):
    path = Path(path)
    with path.open('rb') as f:
        raw = f.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise ValueError(f'{path.name}: 바이트 한도 {MAX_BYTES} 초과')
    try:
        text = raw.decode('utf-8-sig', errors='strict')
    except UnicodeDecodeError as e:
        raise ValueError(f'{path.name}: UTF-8 해석 실패') from e
    rows, seen = [], set()
    reader = csv.reader(io.StringIO(text, newline=''), strict=True)
    try:
        if next(reader, None) != header:
            raise ValueError(f'{path.name}: 머리글은 {",".join(header)} 순서여야 합니다')
        for number, fields in enumerate(reader, 2):
            where = f'{path.name} 레코드 {number}'
            if len(fields) != len(header):
                raise ValueError(f'{where}: 열 수는 {len(header)}개여야 합니다')
            row = dict(zip(header, fields))
            ident = row[header[0]]
            if not ID_RE.fullmatch(ident):
                raise ValueError(f'{where}: ID 형식 확인')
            if ident in seen:
                raise ValueError(f'{where}: 중복 ID {ident}')
            seen.add(ident)
            if kind == 'payment' and row['invoice_id'] and not ID_RE.fullmatch(row['invoice_id']):
                raise ValueError(f'{where}: 참조 ID 형식 확인')
            if kind == 'payment' and row['payment_state'] != 'CONFIRMED':
                raise ValueError(f'{where}: 입금 상태는 CONFIRMED만 허용합니다; 취소·미확정은 별도 검토')
            if row['currency'] != CURRENCY:
                raise ValueError(f'{where}: 통화는 {CURRENCY}만 허용합니다')
            if not AMOUNT_RE.fullmatch(row['amount']):
                raise ValueError(f'{where}: 금액은 양수 일반 소수 2자리여야 합니다')
            amount = Decimal(row['amount'])
            if not ZERO < amount <= MAX_AMOUNT:
                raise ValueError(f'{where}: 금액은 0보다 크고 {MAX_AMOUNT} 이하여야 합니다')
            row['decimal_amount'], row['source_record'] = amount, number
            rows.append(row)
            if len(rows) > MAX_ROWS:
                raise ValueError(f'{path.name}: 행 한도 {MAX_ROWS} 초과')
    except csv.Error as e:
        raise ValueError(f'{path.name}: CSV 구문 오류, 읽은 물리 줄 {reader.line_num}: {e}') from e
    if kind == 'invoice' and not rows:
        raise ValueError('청구서 데이터는 1행 이상 필요합니다')
    return rows, hashlib.sha256(raw).hexdigest()


def money(value):
    return format(value, '.2f')


def reconcile(invoices_path, payments_path):
    invoices, invoice_hash = read_rows(invoices_path, INVOICE_HEADER, 'invoice')
    payments, payment_hash = read_rows(payments_path, PAYMENT_HEADER, 'payment')
    try:
        with localcontext(Context(prec=28)) as context:
            context.traps[FloatOperation] = True
            context.traps[Inexact] = True
            # Each invoice exists once. Payments are summed into this unique-key map.
            applied = {r['invoice_id']: ZERO for r in invoices}
            counts = {r['invoice_id']: 0 for r in invoices}
            audit, unassigned = [], []
            for r in payments:
                ref = r['invoice_id']
                reason = ('MISSING_INVOICE_ID' if ref == '' else
                          'UNKNOWN_INVOICE_ID' if ref not in applied else '')
                a = {k: r[k] for k in AUDIT_HEADER if k in r}
                a['assignment'] = 'UNASSIGNED' if reason else 'APPLIED'
                a['reason'] = reason
                audit.append(a)
                if reason:
                    unassigned.append(a.copy())
                else:
                    applied[ref] += r['decimal_amount']
                    counts[ref] += 1
            balances = []
            for r in invoices:
                ident = r['invoice_id']
                paid = applied[ident]
                balance = r['decimal_amount'] - paid
                status = ('UNPAID' if counts[ident] == 0 else
                          'PARTIAL' if balance > ZERO else
                          'OVERPAID' if balance < ZERO else 'SETTLED')
                balances.append({
                    'invoice_id': ident, 'currency': CURRENCY,
                    'invoice_amount': r['amount'], 'payment_count': counts[ident],
                    'applied_amount': money(paid), 'signed_balance': money(balance),
                    'outstanding_amount': money(max(balance, ZERO)),
                    'excess_amount': money(max(-balance, ZERO)),
                    'status': status, 'source_record': r['source_record'],
                })
            invoice_total = sum((r['decimal_amount'] for r in invoices), ZERO)
            payment_total = sum((r['decimal_amount'] for r in payments), ZERO)
            applied_total = sum(applied.values(), ZERO)
            unassigned_total = sum((Decimal(r['amount']) for r in unassigned), ZERO)
            signed_total = sum((Decimal(r['signed_balance']) for r in balances), ZERO)
            outstanding_total = sum((Decimal(r['outstanding_amount']) for r in balances), ZERO)
            excess_total = sum((Decimal(r['excess_amount']) for r in balances), ZERO)
            checks = {
                'invoice_equals_applied_plus_signed_balance': invoice_total == applied_total + signed_total,
                'payment_equals_applied_plus_unassigned': payment_total == applied_total + unassigned_total,
                'signed_balance_equals_outstanding_minus_excess': signed_total == outstanding_total - excess_total,
                'payment_rows_partitioned_once': len(payments) == sum(counts.values()) + len(unassigned),
            }
            if not all(checks.values()):
                raise ValueError('내부 검산 실패: 확정 출력 보류')
            summary = {
                'currency': CURRENCY, 'invoice_count': len(invoices), 'payment_count': len(payments),
                'applied_payment_count': sum(counts.values()),
                'unassigned_payment_count': len(unassigned),
                'invoice_total': money(invoice_total), 'payment_total': money(payment_total),
                'applied_total': money(applied_total), 'unassigned_total': money(unassigned_total),
                'signed_balance_total': money(signed_total),
                'outstanding_total': money(outstanding_total), 'excess_total': money(excess_total),
                'review_required': bool(unassigned) or any(r['status'] != 'SETTLED' for r in balances),
                'checks': checks,
                'sources_sha256': {'invoices': invoice_hash, 'payments': payment_hash},
                'policy': {'matching': 'exact_case_sensitive_invoice_id',
                           'id_first_character': 'ASCII_letter_or_digit',
                           'one_payment_to_one_invoice': True, 'automatic_reassignment': False,
                           'payment_state': 'CONFIRMED_only_cancelled_pending_rejected',
                           'negative_or_refund_amounts': 'rejected',
                           'amount': 'positive_decimal_exactly_2_places_no_rounding',
                           'max_amount': str(MAX_AMOUNT), 'max_rows_per_file': MAX_ROWS,
                           'max_bytes_per_file': MAX_BYTES, 'decimal_precision': 28},
                'source_changes_written': 0,
            }
    except DecimalException as e:
        raise ValueError('Decimal 계산 실패: 입력·정밀도 계약을 확인하세요') from e
    return {'balances': balances, 'payments': audit, 'unassigned': unassigned, 'summary': summary}


def write_csv(path, header, rows):
    created = False
    try:
        with Path(path).open('x', encoding='utf-8-sig', newline='') as f:
            created = True
            writer = csv.DictWriter(f, fieldnames=header, lineterminator='\n')
            writer.writeheader()
            writer.writerows(rows)
    except OSError:
        if created:
            Path(path).unlink(missing_ok=True)
        raise


def write_outputs(invoices_path, payments_path, output_dir):
    output_dir = Path(output_dir)
    if output_dir.exists() or output_dir.is_symlink():
        raise ValueError('기존 출력 보존: 존재하지 않는 새 --out 폴더 이름을 지정하세요')
    if not output_dir.parent.is_dir():
        raise ValueError('출력의 상위 폴더가 먼저 존재해야 합니다')
    result = reconcile(invoices_path, payments_path)
    output_dir.mkdir()  # Exclusive directory creation; no exist_ok.
    created = []
    try:
        for name, header, rows in [
            ('balances.csv', BALANCE_HEADER, result['balances']),
            ('payments.csv', AUDIT_HEADER, result['payments']),
            ('unassigned.csv', AUDIT_HEADER, result['unassigned']),
        ]:
            path = output_dir/name
            write_csv(path, header, rows)
            created.append(path)
        summary = result['summary'].copy()
        summary['output_sha256'] = {p.name: hashlib.sha256(p.read_bytes()).hexdigest() for p in created}
        summary['completed'] = True
        path = output_dir/'summary.json'
        with path.open('x', encoding='utf-8', newline='\n') as f:
            created.append(path)
            f.write(json.dumps(summary, ensure_ascii=False, indent=2) + '\n')
    except (OSError, ValueError):
        # Cleanup only this run's new files; interruption/cleanup failure is not covered.
        for path in reversed(created):
            path.unlink(missing_ok=True)
        output_dir.rmdir()
        raise
    return summary


def main():
    parser = argparse.ArgumentParser(description='합성 청구서와 일대다 입금 잔액 검산')
    parser.add_argument('--invoices', required=True)
    parser.add_argument('--payments', required=True)
    parser.add_argument('--out', required=True)
    args = parser.parse_args()
    try:
        s = write_outputs(args.invoices, args.payments, args.out)
    except (ValueError, OSError) as e:
        print('오류: ' + str(e), file=sys.stderr)
        return 2
    print(f"청구 {s['invoice_total']} / 입금 {s['payment_total']} / 배정 {s['applied_total']} / "
          f"미배정 {s['unassigned_total']} / 미결 {s['outstanding_total']} / 초과 {s['excess_total']}")
    print(f"보고서 생성 완료, 추가 검토 필요: {s['review_required']}")
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
7. 취소·음수·중복이 있으면 계산을 중단합니다
정상 결과를 본 다음 실패 예제도 실행해 보세요. 아래 네 명령은 각각 다른 새 출력 폴더 이름을 사용합니다. 각 명령은 종료 코드 2로 끝나며 출력 폴더가 생성되지 않는 것이 이 예제의 기대 결과입니다.
python code/reconcile.py --invoices input/invoices.csv --payments input/failures/cancelled_payment.csv --out result_cancelled
python code/reconcile.py --invoices input/invoices.csv --payments input/failures/negative_payment.csv --out result_negative
python code/reconcile.py --invoices input/failures/duplicate_invoice.csv --payments input/payments.csv --out result_duplicate_invoice
python code/reconcile.py --invoices input/invoices.csv --payments input/failures/duplicate_payment.csv --out result_duplicate_payment
첫 명령은 cancelled_payment.csv 레코드 2의 CANCELLED 상태를 거부합니다. 둘째는 negative_payment.csv 레코드 2의 -30.00을 거부합니다. 셋째는 duplicate_invoice.csv 레코드 3: 중복 ID I001, 넷째는 duplicate_payment.csv 레코드 3: 중복 ID R001을 알려 줍니다. 첫 두 명령의 메시지는 각각 ‘입금 상태는 CONFIRMED만 허용합니다’와 ‘금액은 양수 일반 소수 2자리여야 합니다’입니다.
취소 입금과 음수 금액은 원자료와 업무 규칙부터 확인해야 합니다. 실패를 없애려고 CANCELLED를 CONFIRMED로 바꾸거나 마이너스를 지우시면 안 됩니다. 이 프로그램에는 취소·환불 반영 절차가 없으므로 실제 상태를 확인한 별도 집계 대상 자료가 필요합니다.
중복도 먼저 원자료를 확인합니다. 같은 거래가 두 번 내려받힌 것인지, 서로 다른 거래에 같은 ID가 잘못 붙었는지에 따라 수정이 달라집니다. 수정 근거를 확인했다면 원본은 보관하고 별도의 사본을 만들어 고치세요. 새 사본으로 실행할 때는 --invoices 또는 --payments 경로를 그 사본으로 바꿉니다. 한 입금을 여러 청구에 나누어 배정하는 기능은 없으므로 임의로 복제하여 해결하지 않습니다.
8. 재실행과 불완전한 결과 폴더를 구별하세요
정상 명령을 같은 result_normal로 한 번 더 실행하면 ‘기존 출력 보존: 존재하지 않는 새 –out 폴더 이름을 지정하세요’ 오류와 종료 코드 2가 나옵니다. 원래 만들어진 결과는 유지됩니다. 다시 계산하려면 아래처럼 새 이름을 지정하세요.
python code/reconcile.py --invoices input/invoices.csv --payments input/payments.csv --out result_again
오류가 났다는 이유만으로 이전 결과나 입력을 지울 필요는 없습니다. 단, 화면 메시지나 폴더 존재 여부만으로 어느 실행의 결과인지 판단하지 마세요. 일반 입력 오류는 폴더 생성 전에 잡히지만, 쓰기 도중 강제 종료나 정전이 생기면 일부 파일만 남을 가능성이 있습니다. 새 폴더에 다시 실행하고 이전 폴더는 불완전한 결과로 분리해 두는 편이 안전합니다.
아래 한 줄은 정상 원본과 result_normal을 대조합니다. summary.json의 완료 표시와 네 검산, 출력 CSV·현재 원본의 해시, 정상 기대값과 CSV 내용이 모두 맞아야 합니다.
python -c "import json,hashlib; from pathlib import Path; r=Path('result_normal'); s=json.loads((r/'summary.json').read_text(encoding='utf-8')); e=json.loads(Path('expected/summary_expected.json').read_text(encoding='utf-8')); h=lambda p:hashlib.sha256(p.read_bytes()).hexdigest(); assert s['completed'] is True and len(s['checks'])==4 and all(v is True for v in s['checks'].values()); assert all(s[k]==v for k,v in e.items()); assert all(h(r/n)==s['output_sha256'][n] and (r/n).read_bytes()==(Path('expected')/n).read_bytes() for n in ('balances.csv','payments.csv','unassigned.csv')); assert s['sources_sha256']=={'invoices':h(Path('input/invoices.csv')),'payments':h(Path('input/payments.csv'))}; print('정상 예제 대조 OK')"
정상 예제는 마지막에 확인 문구가 나옵니다. 파일이 없거나 JSON 해석·해시·기대값 비교가 실패하면 완료된 정상 결과로 보지 마세요. 수정한 입력은 정상 예제의 기대값과 달라지는 것이 자연스럽습니다. 그때는 새 기대값을 원자료에서 별도로 검산해야 하며, 위 명령의 경로만 바꾸고 같은 기대값을 억지로 맞추어서는 안 됩니다.
SHA-256은 읽고 쓴 바이트의 대조 기록입니다. 계산 내용의 정답 보증이나 파일 잠금 기능은 없으며 동시 수정도 막지 않습니다. hashlib 공식 문서의 해시 기능과 이 코드의 검산 절차를 함께 읽어 두세요.
9. 검증된 범위와 처리 한계를 알아 두세요
첨부에는 41개 회귀 테스트와 실제 명령행 실행을 확인하는 스크립트가 있습니다. 아래 명령으로 다시 실행할 수 있습니다. 테스트 검색 명령은 unittest 공식 문서의 discover 방식입니다.
python -m unittest discover -s code -p "test_reconcile.py" -v
python code/verify_examples.py
Linux CPython 3.12.14에서 회귀 테스트 41개가 통과했고, verify_examples.py의 CLI 실행 12회도 통과했습니다. 12회에는 정상 실행, 같은 폴더 재실행 거부, 실패 CSV 9개, 입금 0건 실행이 들어 있습니다. 정상 결과 CSV 세 개와 요약 기대값을 비교하고 출력 해시를 확인했으며, 입력 CSV 12개의 실행 전후 SHA-256이 같았습니다. 정상 입력 2개에 실패 입력 9개와 머리글만 있는 입금 파일 1개를 더한 수입니다. 이 스크립트는 임시 폴더에 새 출력을 만들어 검사합니다. 이미 만든 result_normal의 직접 검사는 앞 절의 명령으로 진행하세요.
회귀 테스트에는 두 번의 부분입금, 완납·미결·초과입금, 누락·미등록 청구번호 구분, 모든 입금 ID의 1회 처리, 0.10 + 0.20의 정확한 계산, 입력 형식 오류, 기존 출력 보존, 잡힌 쓰기 오류의 새 파일 정리가 포함됩니다. 10,000건의 입금은 허용하고 10,001건은 거부하는 경계도 확인합니다. 테스트 통과는 이 범위의 확인 결과이며, 실제 거래·Excel 가져오기·취소 처리까지 검증했다는 의미는 아닙니다.
입력 파일마다 데이터 최대 10,000행, 최대 2,000,000바이트인 약 2MB까지 받습니다. 행 제한에 머리글은 포함하지 않지만 바이트 제한에는 머리글과 BOM도 포함합니다. 입력과 결과를 전부 메모리에 올리므로 대용량 스트리밍 도구로 쓰기에는 맞지 않습니다. 여러 통화, 환율 환산, 환불·취소 처리, 한 입금의 여러 청구 분할 배정도 지원하지 않습니다.
코드가 잡은 쓰기 오류에서 새 출력 파일을 정리하는 동작은 테스트했습니다. 프로세스 강제 종료, 정전, 동시 실행, 정리 자체의 실패까지 안전하게 복구하는지는 검증하지 않았습니다. 그런 상황에서는 완료 표시·해시·기대값 확인을 통과하기 전까지 남은 폴더를 완성된 보고서로 사용하지 마세요. 공식 자료 확인일은 2026년 10월 13일입니다.
10. 자주 묻는 질문
청구번호가 빈 입금을 금액이 같은 청구에 붙여도 되나요
이 코드에서는 붙이지 않습니다. R005는 10.00의 미배정 입금으로 남습니다. 원자료에서 참조 관계를 확인한 뒤 사본의 청구번호를 수정하고 새 폴더에 다시 실행하세요. 금액만 같다는 근거로 자동 연결하는 기능은 없습니다.
초과입금 10.00을 미결 60.00에서 빼면 더 간단하지 않나요
차이는 부호 잔액 50.00으로 이미 계산됩니다. 다만 확인할 대상은 미결 청구와 초과입금 각각입니다. 합계 차이만 남기면 어느 청구를 확인해야 하는지 흐려지므로 60.00과 10.00을 별도 열과 합계로 보관합니다.
정상 완료인데 왜 review_required가 true인가요
완료 표시는 보고서 쓰기가 끝났다는 뜻입니다. review_required는 미배정 입금이 있거나 청구 상태가 전부 SETTLED가 아닐 때 참입니다. 정상 예제에는 두 미결 청구, 초과입금 한 건, 미배정 입금 두 건이 남아 있습니다.
입금 파일에 머리글만 있어도 실행되나요
정확한 입금 머리글이 있으면 데이터 0행을 허용합니다. 첨부의 input/header_only_payments.csv로 실행하면 청구 280.00 전체가 미결로 남습니다. 빈 파일이나 머리글이 다른 파일은 허용하지 않습니다.
입금 상세는 모두 살리고, 청구액은 한 번만 세고, 미배정과 초과입금은 확인할 대상으로 남겨 두세요. 이 세 가지를 지킨 뒤 합계 식과 원본 건수를 함께 맞추면 청구·입금 CSV를 정리할 때 놓치기 쉬운 숫자를 더 쉽게 찾을 수 있습니다.
작성자 소개
