여러 CSV를 같은 작업 묶음끼리 짝지어 처리하기
대표 사진은 AI로 만든 연출 이미지이며, 실제 CSV 승인·보류 결과를 보여 주지 않습니다.
주문 CSV의 작업 묶음이 B2이고 기준정보 CSV의 작업 묶음이 B1이면, 파일이 두 개 있어도 처리할 한 쌍은 없습니다. 같은 batch 안에 orders와 master가 각각 정확히 하나씩 있을 때만 승인하도록 정하면, 다른 작업의 파일을 잘못 붙이거나 중복 파일 중 하나를 임의로 고르는 일을 막을 수 있습니다.
이번 실습은 여러 입력 파일을 처리 전에 묶는 단계입니다. 가상 CSV와 각 파일의 선언 JSON을 읽어 승인 쌍과 보류 파일을 새 보고서에 남깁니다. 주문 행을 기준정보 행과 조인하거나, 수량 합계를 계산하거나, 입력 파일을 합치지는 않습니다.
1 파일마다 역할과 작업 묶음을 선언합니다
batch는 파일이 속한 작업 묶음의 식별자이고, role은 파일의 역할입니다. 이 예제에서는 B1, B2처럼 B 뒤에 1 이상의 정수가 오는 식별자와 소문자 orders, master 두 역할만 허용합니다. 큰 batch 번호가 더 최신이라는 뜻은 없습니다.
CSV와 선언 파일을 같은 폴더에 둡니다. 선언 파일의 이름은 CSV 이름 뒤에 .meta.json을 붙입니다. 예를 들어 정상 사례의 두 CSV에는 다음 선언이 붙습니다.
orders_v1.9.csv.meta.json:{"batch":"B2","role":"orders"}master_v1.10.csv.meta.json:{"batch":"B2","role":"master"}
v1.9와 v1.10은 파일을 구별하는 이름일 뿐입니다. 두 파일을 묶는 근거는 선언의 B2입니다. 코드에서 이름을 정렬하는 부분은 보고서의 표시 순서를 일정하게 만들기 위한 것이며, 높은 버전이나 최근 수정 파일을 선택하는 절차가 아닙니다.
주문 CSV의 내용은 다음과 같습니다.
batch,order_id,qty
B2,O1,2
기준정보 CSV의 내용은 다음과 같습니다.
batch,item_id,name
B2,I1,가상 품목
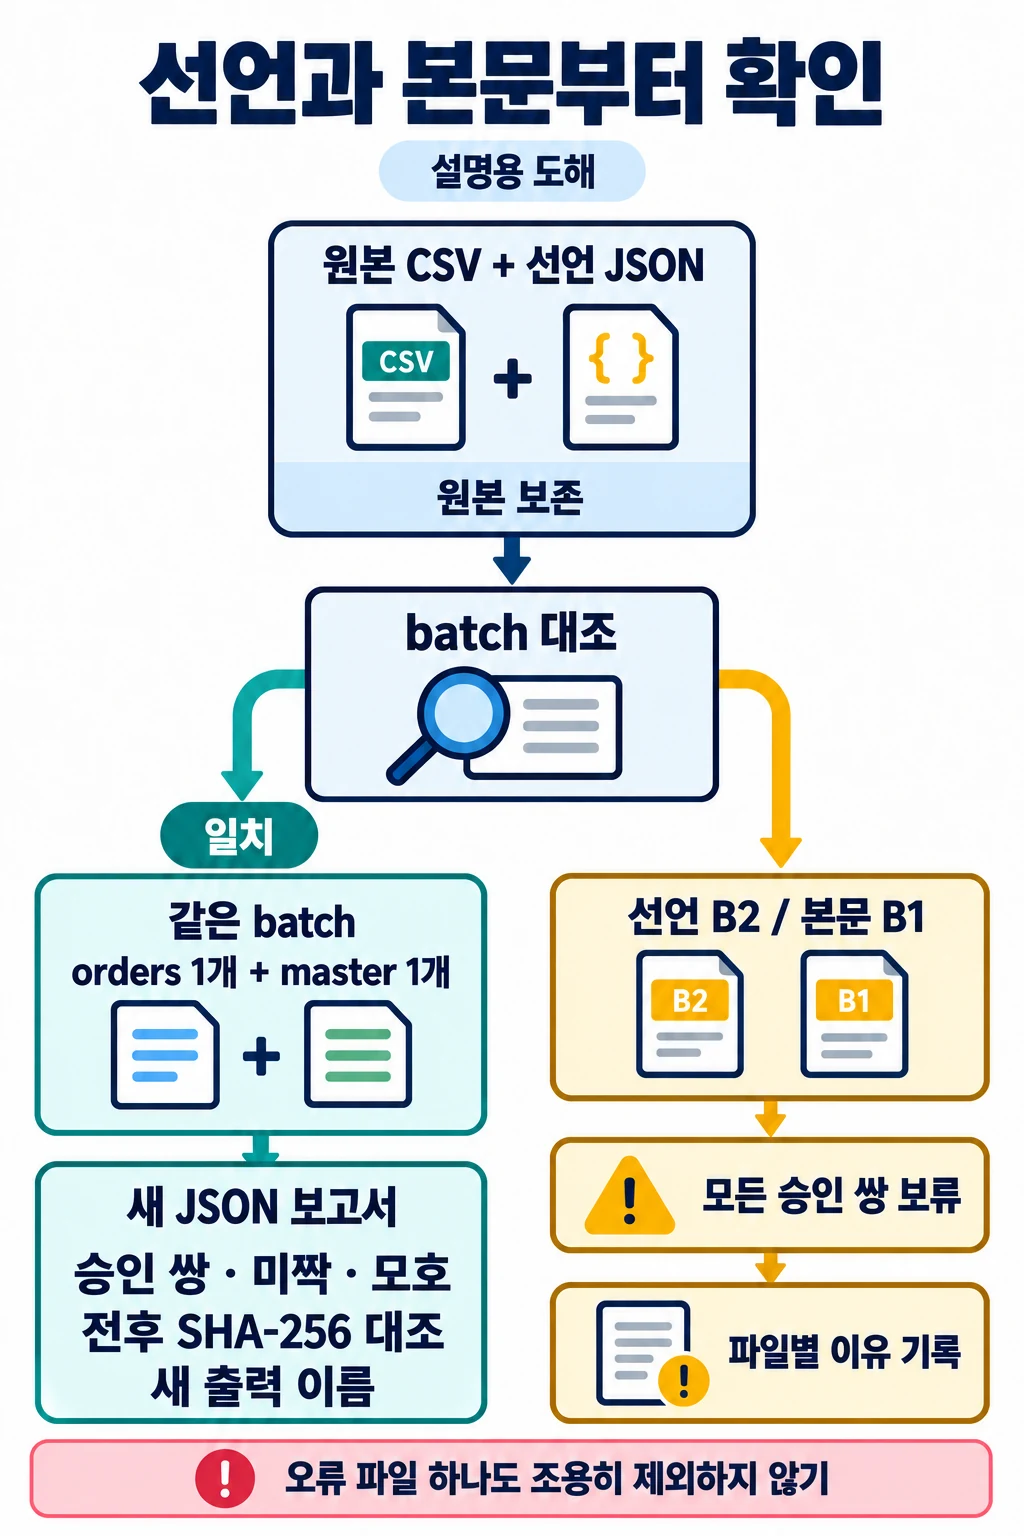
본문의 모든 데이터 행에도 batch를 적습니다. 선언이 B2인데 본문이 B1이거나 빈칸이면, 어느 작업의 파일인지 확인되지 않았으므로 승인하지 않습니다. JSON에는 batch, role 두 필드만 있어야 하며, 필드 누락·추가·중복도 보류합니다.
2 입력 파일을 빠짐없이 세 가지 상태로 남깁니다
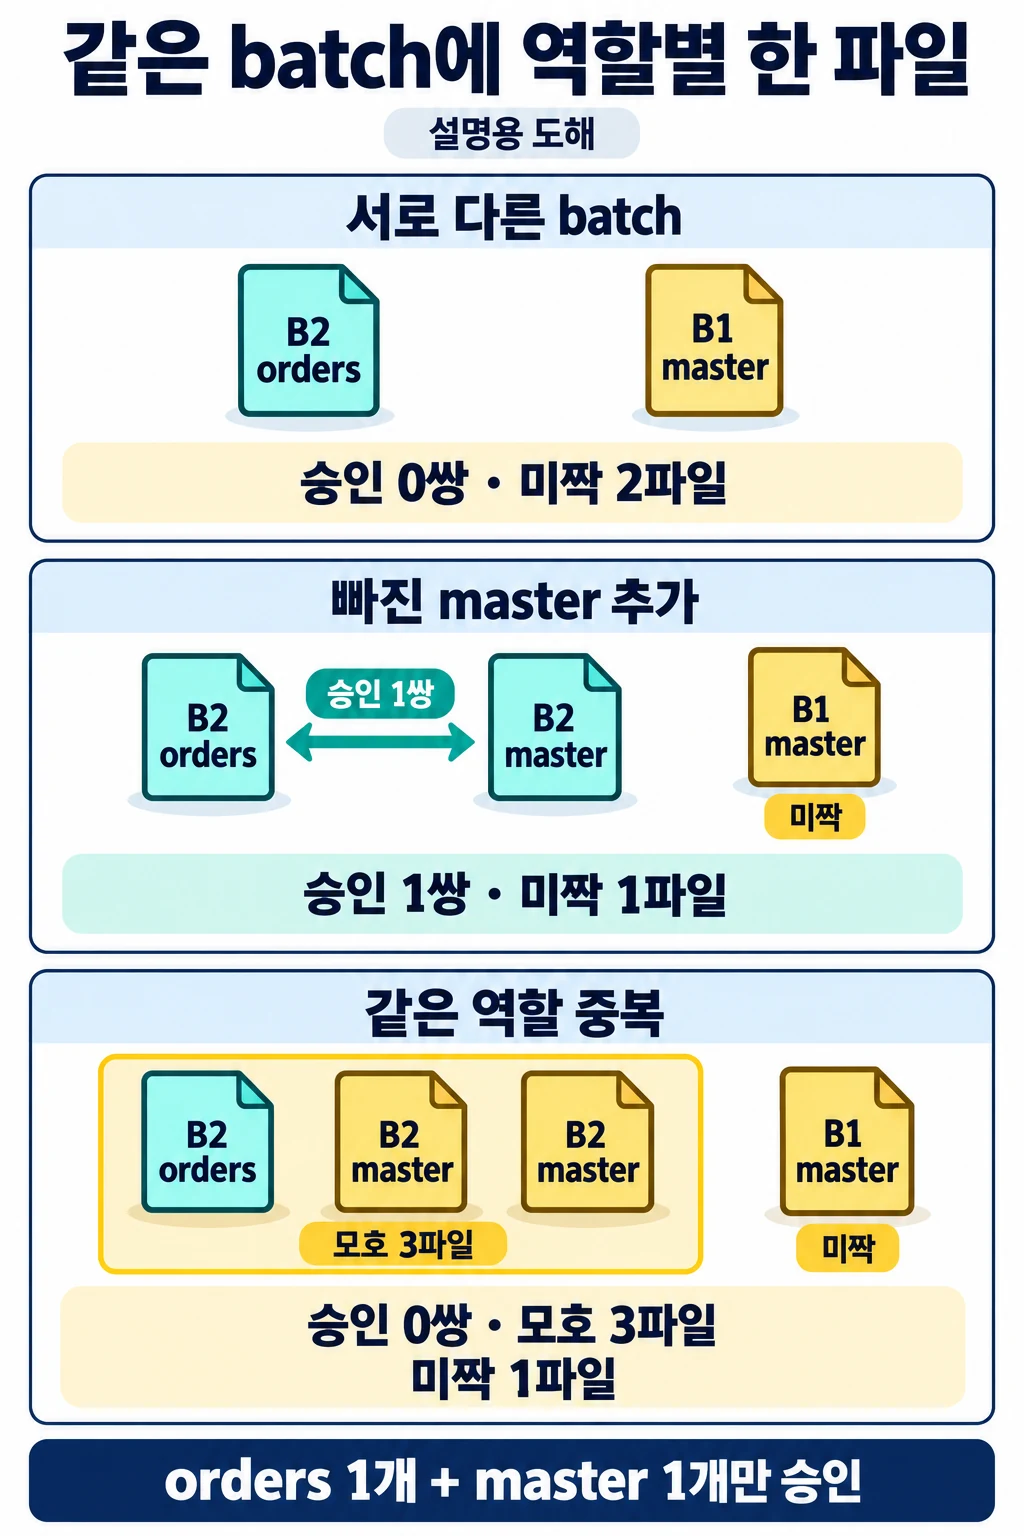
보고서의 files에는 검사한 CSV마다 한 항목이 있습니다. 상태는 서로 겹치지 않습니다.
| 상태 | 뜻 | 다음 처리 |
|---|---|---|
| approved | 같은 batch에 orders 1개와 master 1개 | approved_pairs에서 파일 두 개 확인 |
| unpaired | 같은 batch의 반대 역할 파일이 없음 | 빠진 역할의 파일 요청 |
| ambiguous | 같은 역할 중복 또는 입력 검증 오류 | 선언과 실제 파일을 확인한 뒤 재검사 |
선언과 본문이 모두 정상인 경우에는 batch별로 독립적으로 판정합니다. B2가 정상 한 쌍이어도 B1의 외로운 master는 미짝으로 남습니다. 원래 있던 파일을 보고서에서 없애지 않습니다.
다만 선언 누락·본문 불일치·인코딩 오류처럼 입력 자체를 신뢰할 수 없는 CSV가 하나라도 있으면 그 실행의 모든 승인 쌍을 보류합니다. 그 파일이 다른 정상 쌍의 중복일 수도 있기 때문입니다. 문제 CSV에는 구체적인 오류 이유를 남기고, 나머지 CSV에는 invalid_input_blocks_pair를 남깁니다. 오류 파일을 조용히 제외한 뒤 남은 두 개를 승인하지 않습니다.
다음은 ZIP에 있는 가상 사례의 기대 결과입니다. 승인 파일 수는 승인 쌍 수의 두 배입니다.
| 입력 폴더 | CSV 수 | 승인 쌍 | 승인 파일 | 미짝 | 모호성 보류 |
|---|---|---|---|---|---|
| normal | 2 | 1 | 2 | 0 | 0 |
| missing | 2 | 0 | 0 | 2 | 0 |
| repaired | 3 | 1 | 2 | 1 | 0 |
| duplicate | 4 | 0 | 0 | 1 | 3 |
| body_mismatch | 2 | 0 | 0 | 0 | 2 |
| missing_metadata | 2 | 0 | 0 | 0 | 2 |
missing에는 B2 orders와 B1 master가 있습니다. repaired에는 여기에 B2 master를 추가했습니다. B2 한 쌍은 승인되지만, 기존 B1 master 한 개는 계속 미짝입니다. duplicate에서는 B2 master 두 개가 생겨 B2 orders까지 세 파일 모두 모호성 보류입니다. 두 master의 내용이 같아도 파일 수는 두 개로 셉니다.
3 빈 연습 폴더에서 먼저 실행합니다
CSV 작업 묶음 실습 ZIP을 새 빈 폴더에 풀고, 그 안의 README.md를 먼저 읽습니다. 파일 이름과 폴더 구조는 그대로 두세요. 자료는 모두 가상이며 실제 주문이나 고객 정보가 없습니다.
터미널의 작업 위치를 ZIP을 푼 폴더로 옮깁니다. 아래 명령은 직접 확인한 Linux 터미널의 python3 기준입니다. CPython 3.12.14에서 실행했으며 외부 패키지는 필요하지 않습니다. 먼저 버전을 확인하고 입력 폴더 바깥에 출력 폴더를 만듭니다. -B는 바이트코드 캐시 파일을 만들지 않는 옵션입니다.
python3 --version
python3 -c "from pathlib import Path; Path('out').mkdir(exist_ok=True)"
python3 -B pair_batches.py fixtures/normal out/normal.json
마지막 명령의 실제 콘솔 출력은 다음과 같습니다.
{"input_csv": 2, "approved_pairs": 1, "approved": 2, "unpaired": 0, "ambiguous": 0}out/normal.json을 텍스트 편집기로 열고 approved_pairs에 다음 파일 두 개가 함께 들어 있는지 확인합니다.
[{"batch":"B2","orders":"orders_v1.9.csv","master":"master_v1.10.csv"}]종료 코드 0은 보고서가 저장됐고 모든 CSV가 승인되었다는 뜻입니다. 종료 코드 1은 보고서는 저장됐지만 미짝이나 모호성 보류가 있다는 뜻입니다. 종료 코드 1이어도 승인 쌍이 있을 수 있으므로 approved_pairs와 보류 파일 목록을 함께 읽습니다. 종료 코드 2는 경로·입출력 등 실행 실패입니다. 이때 생성 중 남은 파일을 완료 보고서로 사용하지 않습니다.
4 다른 batch와 같은 역할의 중복을 구별합니다
다음 명령을 각각 실행합니다. 출력 이름은 모두 새 이름입니다.
python3 -B pair_batches.py fixtures/missing out/missing.json
python3 -B pair_batches.py fixtures/repaired out/repaired.json
python3 -B pair_batches.py fixtures/duplicate out/duplicate.jsonmissing.json의 files에서 B2 주문은 missing_master, B1 기준정보는 missing_orders입니다. 서로 다른 batch라는 이유만으로 두 파일을 한 쌍으로 만들지 않습니다.
repaired.json의 승인 쌍은 orders_B2.csv와 master_B2.csv입니다. master_B1.csv의 상태와 이유는 그대로 미짝입니다. 콘솔의 input_csv=3, approved_pairs=1, unpaired=1을 함께 확인하세요.
duplicate.json에서는 B2의 master_B2_v1.9.csv, master_B2_v1.10.csv와 주문 파일의 이유가 모두 duplicate_role입니다. approved_pairs는 빈 목록입니다. 수정 시각을 바꾸거나 파일 이름의 버전 숫자가 더 커도 중복이 해소되지 않습니다.
복구하려면 전달 담당자에게 B2의 유효한 기준정보 파일과 선언을 확인합니다. 확인된 파일들만 담은 새 연습 입력 폴더를 따로 만들고 새 보고서 이름으로 검사하세요. 원래 중복 폴더와 이전 보고서는 보존합니다. 고정 실습에서는 fixtures/normal이 이미 준비된 정상 한 쌍입니다.
5 선언과 본문이 다르면 모든 승인 쌍을 보류합니다
python3 -B pair_batches.py fixtures/body_mismatch out/body_mismatch.json
python3 -B pair_batches.py fixtures/missing_metadata out/missing_metadata.json
첫 사례는 master 선언이 B2인데 본문은 B1입니다. 해당 파일의 이유는 body_batch_mismatch_or_missing이며, 정상인 주문 파일에도 invalid_input_blocks_pair가 남습니다. 둘째 사례는 master의 선언 JSON이 빠졌으므로 missing_metadata입니다. 두 실행 모두 승인 0쌍·모호성 보류 2파일·종료 코드 1입니다.
오류가 났다고 선언의 batch를 본문에 맞춰 자동으로 바꾸지 않습니다. 작업 묶음이 무엇인지 확인한 후 정정된 CSV와 선언 JSON을 새 폴더에 받습니다. 이름만 바꾸면 본문 불일치가 그대로 남습니다.
입력은 BOM 없는 UTF-8을 엄격하게 해석합니다. 잘못된 바이트를 건너뛰거나 대체 문자로 바꾸지 않습니다. 따옴표 해석 후 orders 머리글은 batch,order_id,qty, master 머리글은 batch,item_id,name의 정확한 이름과 순서입니다. 앞뒤 공백·대소문자·열 순서·추가 열을 자동 보정하지 않습니다. UTF-8 BOM이 붙은 CSV도 이 머리글 계약에서는 bad_header입니다. 오류 인코딩과 BOM의 처리는 Python 파일 열기의 encoding과 errors 설명을 참고하세요.
각 CSV에는 본문이 한 행 이상 있어야 합니다. 모든 행의 열 수, 선언과 같은 batch, 나머지 필드의 빈 문자열 여부를 검사합니다. 수량은 이 단계에서 문자열로만 읽으며, 정수 범위·중복 주문 ID·품목 간 연결 관계는 검사하지 않습니다. Python csv.reader 문서는 기본 읽기 결과가 문자열 목록임을 설명합니다. CSV의 엄격한 구문 검사에는 strict=True를 사용합니다.
JSON의 같은 키를 두 번 적으면 기본 처리에서 앞 값이 사라질 수 있습니다. 이 코드는 object_pairs_hook으로 중복 키를 직접 거부합니다. Python JSON의 중복 이름 처리와 object_pairs_hook 설명을 확인할 수 있습니다.
6 ZIP과 같은 전체 검사 코드
다음 전체 코드는 ZIP의 pair_batches.py와 같습니다. 입력 폴더는 CSV와 해당 선언 JSON만 있는 평평한 폴더입니다. CSV 파일명은 영문 또는 숫자로 시작하며 영문·숫자·밑줄·점·하이픈과 소문자 .csv만 사용합니다. CSV 최대 100개, 전체 항목 최대 200개, 파일당 최대 1 MiB로 제한합니다. CSV 파서의 필드 길이 한도도 적용되며, 확인한 실행 환경의 기본값은 131,072자였습니다.
하위 폴더·심볼릭 링크·원본 CSV 없는 선언 JSON·다른 확장자가 있으면 실행을 중단합니다. 입력 및 출력 경로의 상위 구성요소에 링크나 연결 지점이 있는 경우도 거부합니다. 경로 순회와 링크 조회는 Python pathlib 공식 문서를 따릅니다. 이는 작업 중 다른 프로그램이 경로를 바꾸는 상황까지 차단하는 잠금 장치가 아닙니다.
"""Pair synthetic CSV files by declared batch and role; never modify inputs."""
import argparse
import csv
import hashlib
import io
import json
from pathlib import Path
import re
import sys

HEADERS = {
    "orders": ["batch", "order_id", "qty"],
    "master": ["batch", "item_id", "name"],
}
MAX_BYTES = 1024 * 1024
MAX_CSV = 100
NAME = re.compile(r"[A-Za-z0-9][A-Za-z0-9_.-]*\.csv")
BATCH = re.compile(r"B[1-9][0-9]*")


def unique_object(pairs):
    result = {}
    for key, value in pairs:
        if key in result:
            raise ValueError("duplicate_metadata_key")
        result[key] = value
    return result


def snapshot(root):
    paths = sorted(root.iterdir(), key=lambda p: p.name)
    if len(paths) > MAX_CSV * 2:
        raise ValueError("too_many_input_files")
    names = {p.name for p in paths}
    csv_names = [p.name for p in paths if NAME.fullmatch(p.name)]
    if not csv_names or len(csv_names) > MAX_CSV:
        raise ValueError("csv_count_out_of_range")
    result = {}
    for path in paths:
        if path.is_symlink() or path.is_junction() or not path.is_file():
            raise ValueError("input_must_be_regular_flat_files")
        is_meta = path.name.endswith(".meta.json")
        if is_meta and path.name[:-10] not in names:
            raise ValueError("orphan_metadata")
        if path.name not in csv_names and not (
                is_meta and path.name[:-10] in csv_names):
            raise ValueError("unexpected_input_file")
        with path.open("rb") as handle:
            raw = handle.read(MAX_BYTES + 1)
        if len(raw) > MAX_BYTES:
            raise ValueError("input_file_too_large")
        result[path.name] = raw
    return result


def sha_map(data):
    return {name: hashlib.sha256(raw).hexdigest()
            for name, raw in data.items()}


def inspect_csv(name, data):
    record = {"file": name, "batch": None, "role": None, "rows": 0,
              "status": "ambiguous", "reason": "not_checked"}
    try:
        meta_name = name + ".meta.json"
        if meta_name not in data:
            raise ValueError("missing_metadata")
        try:
            meta = json.loads(data[meta_name].decode("utf-8", errors="strict"),
                              object_pairs_hook=unique_object)
        except (json.JSONDecodeError, RecursionError):
            raise ValueError("bad_metadata_json") from None
        if not isinstance(meta, dict) or set(meta) != {"batch", "role"}:
            raise ValueError("bad_metadata_fields")
        batch, role = meta["batch"], meta["role"]
        if not isinstance(batch, str) or not BATCH.fullmatch(batch):
            raise ValueError("bad_metadata_batch")
        if not isinstance(role, str) or role not in HEADERS:
            raise ValueError("bad_metadata_role")
        record.update(batch=batch, role=role)
        text = data[name].decode("utf-8", errors="strict")
        reader = csv.reader(io.StringIO(text, newline=""), strict=True)
        if next(reader, None) != HEADERS[role]:
            raise ValueError("bad_header")
        for row in reader:
            if len(row) != len(HEADERS[role]):
                raise ValueError("bad_row_width")
            if row[0] != batch:
                raise ValueError("body_batch_mismatch_or_missing")
            if any(value == "" for value in row[1:]):
                raise ValueError("empty_body_field")
            record["rows"] += 1
        if record["rows"] == 0:
            raise ValueError("empty_body")
        record["reason"] = "validated"
    except UnicodeDecodeError:
        record["reason"] = "invalid_utf8"
    except csv.Error:
        record["reason"] = "bad_csv_syntax"
    except ValueError as error:
        record["reason"] = str(error)
    return record


def make_report(data):
    records = [inspect_csv(name, data) for name in data
               if NAME.fullmatch(name)]
    pairs = []
    has_invalid = any(r["reason"] != "validated" for r in records)
    if has_invalid:
        for record in records:
            if record["reason"] == "validated":
                record["reason"] = "invalid_input_blocks_pair"
    else:
        batches = sorted({r["batch"] for r in records})
        for batch in batches:
            group = [r for r in records if r["batch"] == batch]
            roles = {role: [r for r in group if r["role"] == role]
                     for role in HEADERS}
            orders, master = roles["orders"], roles["master"]
            if len(orders) > 1 or len(master) > 1:
                status, reason = "ambiguous", "duplicate_role"
            elif not orders or not master:
                status = "unpaired"
                reason = "missing_orders" if not orders else "missing_master"
            else:
                status, reason = "approved", "exactly_one_each"
                pairs.append({"batch": batch, "orders": orders[0]["file"],
                              "master": master[0]["file"]})
            for record in group:
                record.update(status=status, reason=reason)
    summary = {"input_csv": len(records), "approved_pairs": len(pairs)}
    for status in ("approved", "unpaired", "ambiguous"):
        summary[status] = sum(r["status"] == status for r in records)
    return {"schema_version": 1, "report_complete": True,
            "policy": "declared_batch_exactly_one_orders_and_master",
            "summary": summary, "approved_pairs": pairs, "files": records}


def plain_path(value):
    path = Path(value).absolute()
    for part in (path, *path.parents):
        if part.is_symlink() or part.is_junction():
            raise ValueError("no_symlink_or_junction_paths")
    return path.resolve()


def run(input_dir, output_file):
    source = plain_path(input_dir)
    output = plain_path(output_file)
    if source.is_symlink() or not source.is_dir():
        raise ValueError("input_directory_required_no_symlink")
    source = source.resolve(strict=True)
    if source == output.resolve() or source in output.resolve().parents:
        raise ValueError("output_must_be_outside_input")
    if output.exists() or output.is_symlink():
        raise ValueError("output_already_exists")
    if not output.parent.is_dir():
        raise ValueError("output_parent_directory_required")
    before = snapshot(source)
    report = make_report(before)
    after = snapshot(source)
    if before != after:
        raise ValueError("input_changed_during_check")
    report["source_sha256_before"] = sha_map(before)
    report["source_sha256_after"] = sha_map(after)
    payload = json.dumps(report, ensure_ascii=False, indent=2) + "\n"
    with output.open("x", encoding="utf-8", errors="strict", newline="\n") as handle:
        handle.write(payload)
    print(json.dumps(report["summary"], ensure_ascii=False))
    return 1 if report["summary"]["unpaired"] or report["summary"]["ambiguous"] else 0


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("input_dir")
    parser.add_argument("output_file")
    args = parser.parse_args()
    try:
        return run(args.input_dir, args.output_file)
    except (OSError, ValueError) as error:
        print("ERROR: " + str(error), file=sys.stderr)
        return 2


if __name__ == "__main__":
    sys.exit(main())
make_report()는 선언과 본문 검사를 마친 파일을 batch별로 모읍니다. len(orders) == 1이고 len(master) == 1인 경우에만 파일명 두 개를 승인 목록에 넣습니다. 이 승인 목록은 이후 별도 처리 단계가 읽을 입력 목록입니다. 승인되었다고 CSV의 모든 업무 값이 맞거나 공개해도 된다는 뜻은 아닙니다.
7 기존 보고서를 보존하고 새 이름으로 재실행합니다
앞에서 만든 out/normal.json과 같은 출력 이름으로 실행하면 종료 코드 2와 output_already_exists가 나옵니다. 기존 파일의 내용은 바뀌지 않습니다. 새 이름을 사용합니다.
python3 -B pair_batches.py fixtures/normal out/normal_02.json같은 입력으로 만든 두 보고서의 바이트가 같은 것을 확인했습니다. open("x")는 기존 파일이 있을 때 실패하는 배타적 생성 모드입니다. Python open의 x 모드가 이 동작을 설명합니다. 출력 폴더는 먼저 만들어야 하며, 입력 폴더 안을 출력 위치로 지정할 수 없습니다.
보고서의 source_sha256_before와 source_sha256_after에는 읽은 CSV와 선언 JSON의 바이트 해시가 모두 있습니다. Python hashlib 문서는 SHA-256과 16진수 요약을 설명합니다. 검사 전후 파일 목록과 바이트도 다시 비교하며, 다르면 새 보고서를 만들지 않습니다. 해시는 내용 대조용이며 작성자 인증이나 자료의 사실성을 보증하지 않습니다. 파일을 읽으면 운영체제의 접근 시각이 바뀔 수 있으므로 바이트 보존과 모든 파일 속성의 보존은 구분해야 합니다.
디스크 부족·권한 오류·프로세스 중단으로 저장이 끝나지 않으면 부분 출력이 남을 수 있습니다. 이 코드는 그 파일을 자동으로 삭제하지 않습니다. 오류가 난 출력은 그대로 보존하고 저장 위치를 확인한 뒤 새 이름으로 실행합니다. 성공한 종료 코드 0 또는 1, 파싱 가능한 JSON, report_complete=true를 함께 확인하세요.
입력 폴더는 실행 중 다른 프로그램이 쓰지 않는 가상 사본으로 사용합니다. 전후 비교만으로 모든 동시 변경을 잡거나 검사 이후 변경을 막을 수는 없습니다. 업무에 연결할 때는 전달 완료 신호와 변경 금지 절차가 추가로 필요합니다.
8 기대 보고서와 실제 실행 기록을 대조합니다
ZIP의 expected에는 미리 정한 요약과 사례별 전체 기대 JSON이 있고, actual_reports에는 실제 실행에서 저장한 JSON이 있습니다. logs/fixture_runs.json에는 16개 고정 사례의 명령·종료 코드·콘솔·전후 입력 해시가 있습니다. logs/rerun_and_output_failures.json은 기존 출력 충돌, 새 이름 재실행, 입력 안 출력 거부, 출력 부모 폴더 누락을 기록합니다.
python3 -B -m unittest -vCPython 3.12.14, Linux x86_64에서 13개 시험 메서드가 모두 통과했습니다. 그중 고정 자료 시험은 16개 사례의 전체 보고서와 입력 해시를 각각 대조합니다. 선언 누락, 본문 batch 누락·불일치, 같은 역할 중복, 잘못된 UTF-8, BOM, CSV 구문·머리글·열 수, 빈 본문, JSON 중복 키, 역할 오류, 지나치게 깊게 중첩된 JSON을 포함합니다. 같은 출력 이름 재실행과 새 이름 재실행, 링크 경로와 입력 안 출력도 검사했습니다.
이 실습은 Python 표준 라이브러리만 사용합니다. SQLite와 openpyxl은 사용하지 않았으며 Windows·macOS 실행 결과는 확인하지 않았습니다. 공식 자료는 실행한 Python과 같은 3.12 계열 문서입니다. 온라인 문서는 3.12의 후속 패치판 표시로 갱신될 수 있으므로 실제 실행 버전은 ZIP의 runtime.json으로 따로 기록합니다.
파일이 날짜별로 모두 도착했는지 확인하려면 날짜별 받아야 할 파일 수신 대조처럼 수신 목록 검사가 먼저 필요합니다. 여기서는 도착한 CSV의 선언과 본문을 확인한 뒤, 같은 batch에서 서로 다른 역할을 정확히 한 개씩 묶는 것을 완료 기준으로 삼습니다.
작성자 소개
