AI가 만든 정규식, 주문 번호를 정확히 찾는지 확인하기
AI에 주문 번호를 찾는 정규식을 부탁했다면, 주문 번호 한 개를 찾았다고 바로 사용하지 마세요. 날짜나 전화번호를 잘못 찾는지, 긴 코드의 일부만 가져오는지, 한국어에 붙은 번호를 빠뜨리는지도 확인해야 합니다.
정규식은 문자열에서 정해 둔 모양을 찾는 규칙입니다. 이 글은 Python을 사용하는 독자를 위한 실습으로, 가상 주문 코드의 맞는 예와 틀린 예를 함께 넣어 결과를 비교합니다. 문장에서 번호를 찾는 검사와 셀 전체가 올바른 번호인지 보는 검사도 나눕니다.
규칙과 예제는 직접 작성했습니다. Python 표준 re에서 추출 사례 18개와 셀 검사 사례 8개를 실행한 결과이며, 실제 AI에 규칙을 요청하거나 고객 주문을 조회한 기록은 아닙니다. 공식 문서 확인과 Python 실행일은 2026년 10월 4일 KST입니다.
정규식보다 먼저 정할 주문 코드 규칙
코드의 규칙은 정규식이 만들어 내는 것이 아니라 원본 시스템에서 확인해야 합니다. 이번 실습의 고정 규칙은 다음과 같습니다. 실제 판매처의 주문 번호 규칙을 대신하지 않습니다.
- 본체는 대문자 ORD, ASCII 하이픈, ASCII 숫자 네 자리, ASCII 하이픈, ASCII 숫자 여섯 자리입니다.
- 네 자리 구간은 연도처럼 보여도 이번 규칙에서는 숫자 코드일 뿐입니다. 0000도 형식상 허용합니다.
- 문장 속에서 찾을 때 바로 앞뒤가 ASCII 영문자·숫자·밑줄·하이픈이면 더 긴 토큰의 일부로 보고 제외합니다.
- 한국어 설명에 붙은 코드는 허용합니다. 따라서 주문번호ORD-2026-000001확인은 한 개를 찾아야 합니다.
- 소문자, 전각 숫자, 하이픈과 비슷한 문자는 자동으로 바꾸지 않습니다.
- 등장 순서를 보존하며 같은 코드가 두 번 있으면 두 번 반환합니다.
한국어에 붙은 코드를 허용한다는 조건은 이번 예제의 선택입니다. 실제 시스템이 공백·구두점으로 분리된 코드만 허용한다면 경계 규칙과 정답을 함께 바꿔야 합니다. 또 형식에 맞는 문자열을 찾는 것과 주문이 실제로 존재하는지 확인하는 것은 별개의 작업입니다.
AI 요청문에 경계와 반례를 함께 넣기
아래 요청문에는 엔진과 출력 조건을 넣었습니다. 실제 데이터 대신 가상의 정상·반례 문자열만 전달할 수 있는 형태입니다. 실제 AI 응답을 얻거나 실행한 요청문은 아닙니다.
Python 표준 re에서 사용할 주문 코드 추출 패턴을 제안해 주세요.
코드 본체는 대문자 ORD + ASCII 하이픈 + ASCII 숫자 4자리 + 하이픈 + 숫자 6자리입니다.
네 자리 숫자는 연도 유효성을 검사하지 않는 코드 구간입니다.
바로 앞뒤의 ASCII 영문자·숫자·밑줄·하이픈에 붙은 부분 문자열은 제외합니다.
한국어 설명에 붙은 코드는 허용합니다. 대소문자·전각 숫자·유사 하이픈을 자동 교정하지 마세요.
한 문장의 모든 코드를 원문 순서대로 찾고 반복 등장도 그대로 유지합니다.
날짜 2026-08-24, 전화 010-1234-5678은 제외합니다.
주문번호ORD-2026-000001확인은 하나, ORD-2026-000001-77은 0개여야 합니다.
정규식, 경계 조건 설명, 예상 오탐·누락 사례를 나누어 제안하세요.
코드를 실행하거나 주문 시스템을 변경하지 마세요.
AI가 제안한 코드를 곧바로 실행하지 않습니다. 우선 정규식 문자열과 플래그만 검토하고, 파일 읽기·외부 전송·임의 명령 실행이 들어 있지 않은 별도 검사 코드에 넣습니다. AI의 설명이 맞아 보여도 기대값과 실제 목록을 대조한 뒤 사용 범위를 결정합니다.
짧은 후보 패턴에서 드러나는 네 반례
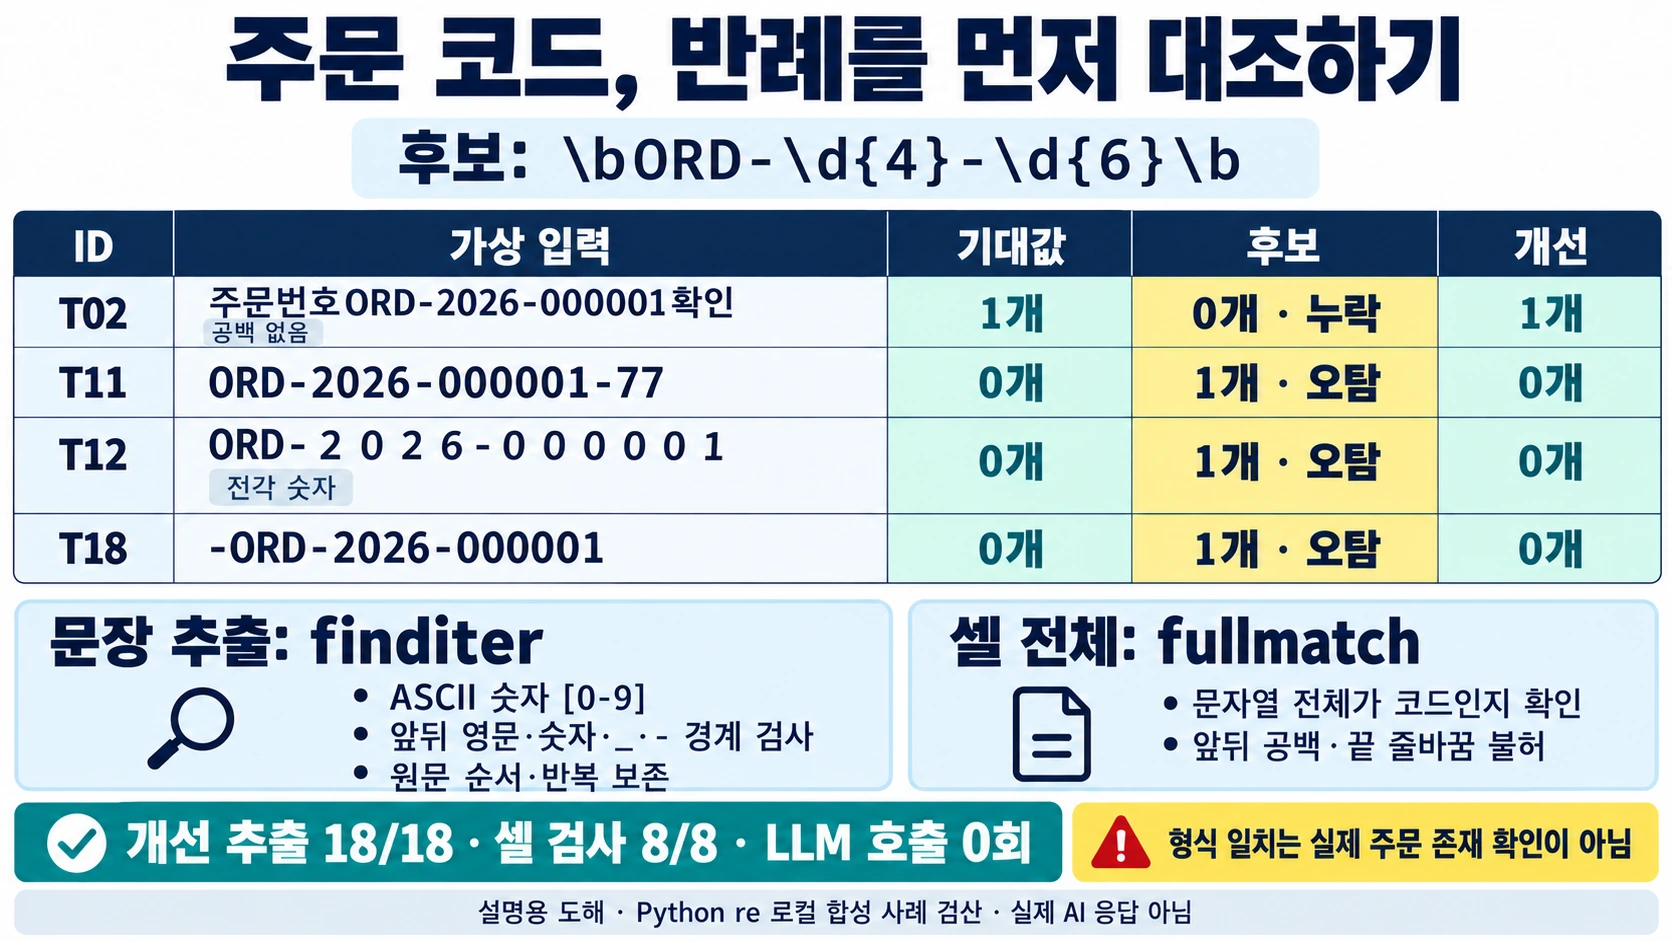
검토할 후보는 \bORD-\d{4}-\d{6}\b입니다. 공백으로 분리된 정상 코드는 찾지만 아래 네 경우에서 이번 규칙과 다르게 움직였습니다. 이것은 직접 만든 후보의 Python 실행 결과이며, 어떤 AI 제품의 품질이나 오류율을 측정한 자료가 아닙니다.
| 검사 | 입력 | 기대 결과 | 후보 결과 |
|---|---|---|---|
| T02 | 주문번호ORD-2026-000001확인 | ORD-2026-000001 한 개 | 누락 |
| T11 | ORD-2026-000001-77 | 빈 목록 | 앞부분 ORD-2026-000001 오탐 |
| T12 | ORD-2026-000001 | 빈 목록 | 전각 숫자 코드 오탐 |
| T18 | -ORD-2026-000001 | 빈 목록 | ORD-2026-000001 오탐 |
Python re 공식 문서는 유니코드 문자열의 \d가 ASCII 0~9 외의 십진 숫자도 포함한다고 설명합니다. ASCII 숫자만 허용하려면 이번 예제처럼 [0-9]로 범위를 드러냅니다. 전각 숫자를 몰래 일반 숫자로 바꾸어 테스트를 통과시키지 않습니다.
또 \b는 단어 문자와 비단어 문자의 경계입니다. 기본 유니코드 문자열에서 한국어도 단어 문자에 속할 수 있어, 한국어에 붙은 ORD 코드에 원하는 경계가 생기지 않습니다. 하이픈은 그 경계의 바깥 문자여서 긴 하이픈 연결 토큰의 앞부분을 잡을 수도 있습니다. 이번 규칙에서는 앞뒤에서 금지할 문자를 직접 지정합니다.
문장 추출과 셀 전체 검사를 나누기
문장에서 여러 코드를 찾는 작업은 본체 패턴 앞뒤에 경계 검사를 붙여 finditer로 처리합니다. 이 예제의 개선 패턴은 (?<![A-Za-z0-9_-])ORD-[0-9]{4}-[0-9]{6}(?![A-Za-z0-9_-])입니다. 앞쪽은 금지 문자가 바로 앞에 없는지, 뒤쪽은 금지 문자가 바로 뒤에 없는지 확인합니다. 경계 문자를 결과 코드에 포함하지 않습니다.
반면 셀 하나가 코드 자체인지 검사하려면 본체 패턴 ORD-[0-9]{4}-[0-9]{6}에 fullmatch를 사용합니다. Python fullmatch 설명은 문자열 전체가 맞는지 검사하는 동작을 안내합니다. 문장 추출 함수를 그대로 쓰면 셀 앞에 불필요한 글자가 있어도 안쪽 코드 하나를 찾아 통과시킬 수 있습니다.
이번 셀 검사는 앞뒤 공백과 마지막 줄바꿈을 허용하지 않습니다. 입력을 정리해야 하는 업무라면 원본 보존·정리 규칙·정리 후 값을 따로 남깁니다. strip()이나 전각 숫자 정규화를 무조건 앞에 넣으면 원본 형식 오류가 사라져 정답 계약이 달라집니다.
그대로 저장해서 실행할 전체 예제
아래 전체 코드를 UTF-8 텍스트로 저장하고 파일명을 regex_order_checks.py로 정합니다. Python 3이 준비된 환경에서 표준 라이브러리만 사용합니다. 이 코드는 외부 서비스에 연결하지 않고 원본 주문 자료를 읽거나 수정하지 않습니다. 파일에 실제 주문을 붙여 넣을 필요도 없습니다.
import json
import re

CORE = r"ORD-[0-9]{4}-[0-9]{6}"
NAIVE = re.compile(r"\bORD-\d{4}-\d{6}\b")
EXTRACT = re.compile(r"(?<![A-Za-z0-9_-])" + CORE + r"(?![A-Za-z0-9_-])")

CASES = [
    ("T01", "주문 ORD-2026-000001 접수", ["ORD-2026-000001"]),
    ("T02", "주문번호ORD-2026-000001확인", ["ORD-2026-000001"]),
    ("T03", "(ORD-2026-000001), ORD-2025-000002", ["ORD-2026-000001", "ORD-2025-000002"]),
    ("T04", "ORD-2026-000001 / ORD-2026-000001", ["ORD-2026-000001", "ORD-2026-000001"]),
    ("T05", "일자 2026-08-24", []),
    ("T06", "전화 010-1234-5678", []),
    ("T07", "ORD-2026-0000017", []),
    ("T08", "XORD-2026-000001", []),
    ("T09", "ORD-2026-000001A", []),
    ("T10", "_ORD-2026-000001", []),
    ("T11", "ORD-2026-000001-77", []),
    ("T12", "ORD-2026-000001", []),
    ("T13", "ord-2026-000001", []),
    ("T14", "ORD–2026–000001", []),
    ("T15", "ORD-2026-00001", []),
    ("T16", "ORD-0000-000001", ["ORD-0000-000001"]),
    ("T17", "", []),
    ("T18", "-ORD-2026-000001", []),
]

CELL_CASES = [
    ("ORD-2026-000001", True),
    ("ORD-0000-000001", True),
    (" ORD-2026-000001", False),
    ("ORD-2026-000001\n", False),
    ("ORD-2026-000001A", False),
    ("ORD-2026-000001", False),
    ("", False),
    (None, False),
]

def extract_orders(text):
    if not isinstance(text, str):
        raise TypeError("추출 입력은 문자열이어야 합니다")
    return [match.group(0) for match in EXTRACT.finditer(text)]

def valid_cell(value):
    return isinstance(value, str) and re.fullmatch(CORE, value) is not None

def main():
    naive_failures = []
    for case_id, text, expected in CASES:
        naive_result = [match.group(0) for match in NAIVE.finditer(text)]
        if naive_result != expected:
            naive_failures.append(case_id)
        actual = extract_orders(text)
        if actual != expected:
            raise AssertionError(f"{case_id}: {actual!r} != {expected!r}")
        for match in EXTRACT.finditer(text):
            if text[match.start():match.end()] != match.group(0):
                raise AssertionError(f"{case_id}: 원문 위치 불일치")
    for value, expected in CELL_CASES:
        if valid_cell(value) != expected:
            raise AssertionError(f"셀 검사: {value!r}")
    if naive_failures != ["T02", "T11", "T12", "T18"]:
        raise AssertionError(f"후보 패턴 반례가 달라짐: {naive_failures}")
    print(json.dumps({"extraction_cases": len(CASES),
                      "naive_failures": naive_failures,
                      "improved_passed": len(CASES),
                      "whole_cell_cases_passed": len(CELL_CASES),
                      "live_ai_calls": 0, "result": "PASS"},
                     ensure_ascii=False))

if __name__ == "__main__":
    main()
저장한 폴더에서 아래 명령을 실행합니다. 자신의 환경에서 Python 실행 명령이 다르면 동일한 Python 3 인터프리터를 가리키는 명령으로 바꿉니다. 명령을 못 찾는 경우 정규식 오류로 처리하지 않고 설치·실행 환경을 먼저 확인합니다.
python regex_order_checks.pyLinux의 Python 3.12.14에서 실행한 출력은 다음과 같습니다. 코드가 통과한 개선 패턴과, 의도적으로 남긴 후보의 실패 ID를 함께 보입니다.
{"extraction_cases": 18, "naive_failures": ["T02", "T11", "T12", "T18"], "improved_passed": 18, "whole_cell_cases_passed": 8, "live_ai_calls": 0, "result": "PASS"}개선 패턴의 추출 18개 사례와 셀 검사 8개 사례가 기대값과 맞았습니다. 날짜·전화번호·긴 코드·소문자·유사 하이픈·빈 문자열도 각각 독립적으로 검사합니다. T04의 같은 코드 두 번은 두 건 그대로 남습니다. set()으로 중복을 없애면 등장 횟수와 원문 순서를 보존하려는 이번 목적이 달라집니다.
각 매치의 시작·끝 위치로 잘라 낸 원문이 반환 코드와 같은지도 확인합니다. 이 위치는 Python 문자열의 문자 인덱스이며 파일 바이트 위치나 엑셀 셀 주소가 아닙니다. 위치가 필요한 실무에서는 원문 레코드 ID와 함께 보관합니다.
실패를 고칠 때는 규칙과 기대값을 먼저 보기
개선 패턴이 T02를 놓쳤다면 다른 언어의 경계 규칙을 가져왔는지, 실제 문자열이 본문과 같은지 확인합니다. T12가 잡힌다면 [0-9] 대신 \d를 썼는지 봅니다. T11이 잡힌다면 뒤쪽 경계에서 하이픈을 제외했는지 확인합니다. T07의 일곱 자리 숫자에서 여섯 자리만 잘라 나오면 뒤쪽 숫자 경계가 빠진 것입니다.
에러 메시지가 정규식 컴파일 실패라면 패턴 문자열과 실행 엔진부터 확인합니다. 본문의 Python용 패턴을 다른 앱이나 언어에 그대로 옮기지 않습니다. 특히 뒤쪽 조건 검사와 앞쪽 조건 검사의 지원 여부, 유니코드 처리, 반환 그룹 방식은 사용 엔진에서 다시 확인해야 합니다.
후보 패턴의 네 실패를 없애기 위해 정상 사례의 기대값을 빈 목록으로 바꾸거나 전각 숫자의 기대값을 임의로 허용하지 않습니다. 실제 주문 시스템의 규칙이 달라진 경우에만 규칙 버전을 올리고 관련 기대값을 바꿉니다. 수정 뒤에는 실패했던 한 건만 돌리지 말고 기존 반례 전체를 다시 검사합니다.
복사해서 쓰는 빈 반례 기록
다음 기록을 한 사례마다 작성합니다. 실행하지 않은 후보는 실제 결과 칸을 비워 둡니다. 문장 추출과 셀 전체 검사를 같은 판정으로 섞지 않습니다.
검사 ID:
규칙 버전:
사용 언어·정규식 엔진·버전:
작업: 문장 추출 / 셀 전체 검사
입력 문자열:
사람이 정한 기대 코드 목록:
후보 패턴과 플래그:
실제 추출 목록과 원문 위치:
판정: 일치 / 오탐 / 누락 / 순서·중복 오류
원인 확인:
수정한 조건:
기존 반례 전체 재검사 결과:
새로운 오탐이나 누락을 발견하면 문제 문자열과 사람이 정한 코드 목록을 CASES에 추가합니다. 셀의 형식 오류라면 CELL_CASES에 넣습니다. 이 예제는 마지막 숫자 여섯 자리의 값 자체를 제한하지 않으므로, 000000 금지나 발급 연도 제한이 필요한 시스템에서는 그 조건의 반례를 별도로 추가해야 합니다.
검증 범위와 실무 적용 한계
2026-10-04 KST에 Python 3.12 계열 공식 문서를 확인하고 Python 3.12.14에서 위 전체 코드를 실행했습니다. 본문 코드와 저장한 예제 코드는 같으며 실제 LLM 호출은 0회입니다. 정상 예제와 반례를 통과한 결과는 이 가상 규칙에 한정합니다.
형식 검사만으로 실재 주문·주문 상태·결제 승인·개인정보 적합성을 확인할 수 없습니다. 실제 적용에서는 승인된 주문 시스템의 키 목록과 대조해야 합니다. 대량 로그의 처리 속도나 매우 긴 입력에서의 성능은 측정하지 않았습니다. AI 제안은 후보로 남기고, 사용할 엔진의 실행 결과와 업무 규칙이 일치한 범위만 적용합니다.
함께 확인할 작업
후보 정규식을 프로그램에 넣기 전에 로컬·웹·API의 실행 경로 구분도 확인하세요. 이 글의 Python 정규식 검사는 AI 서비스 호출이나 실제 주문 자료 전송 없이 로컬에서 수행합니다.
작성자 소개
