AI에 오류 기록을 보내기 전 필요한 내용만 따로 정리하기
프로그램 오류를 AI에 물어볼 때는 프로그램이 남긴 오류 기록(로그)을 통째로 붙여 넣지 마세요. 오류 메시지 옆에 계정 정보나 비밀 키, 사용자 이름이 들어간 폴더 경로가 함께 적혀 있을 수 있습니다. AI에게 지워 달라고 보내면 제거 전에 이미 내용을 전달한 상태가 됩니다.
먼저 오류를 설명하는 데 필요한 내용만 새 사본에 옮기고, 비공개 정보가 남지 않았는지 확인합니다. 이 글에서는 CSV 파일의 열 개수 오류를 예로 들어 오류 내용과 질문을 짧게 정리하는 순서를 설명합니다. 어떤 값을 숨겨야 하는지 모르면 그대로 보내지 말고 담당자에게 확인하세요.
본문의 오류 기록과 비밀 값 표시는 모두 가상 자료입니다. 필요한 값을 남기는 코드는 컴퓨터에서 검사했지만, 실제 로그·인증키·환경변수를 읽거나 AI에 보내지는 않았습니다. 작성·공식 출처 확인·Python 검사 기준일은 2026년 10월 4일 KST입니다.
먼저 오류 질문의 범위를 한 줄로 정하기
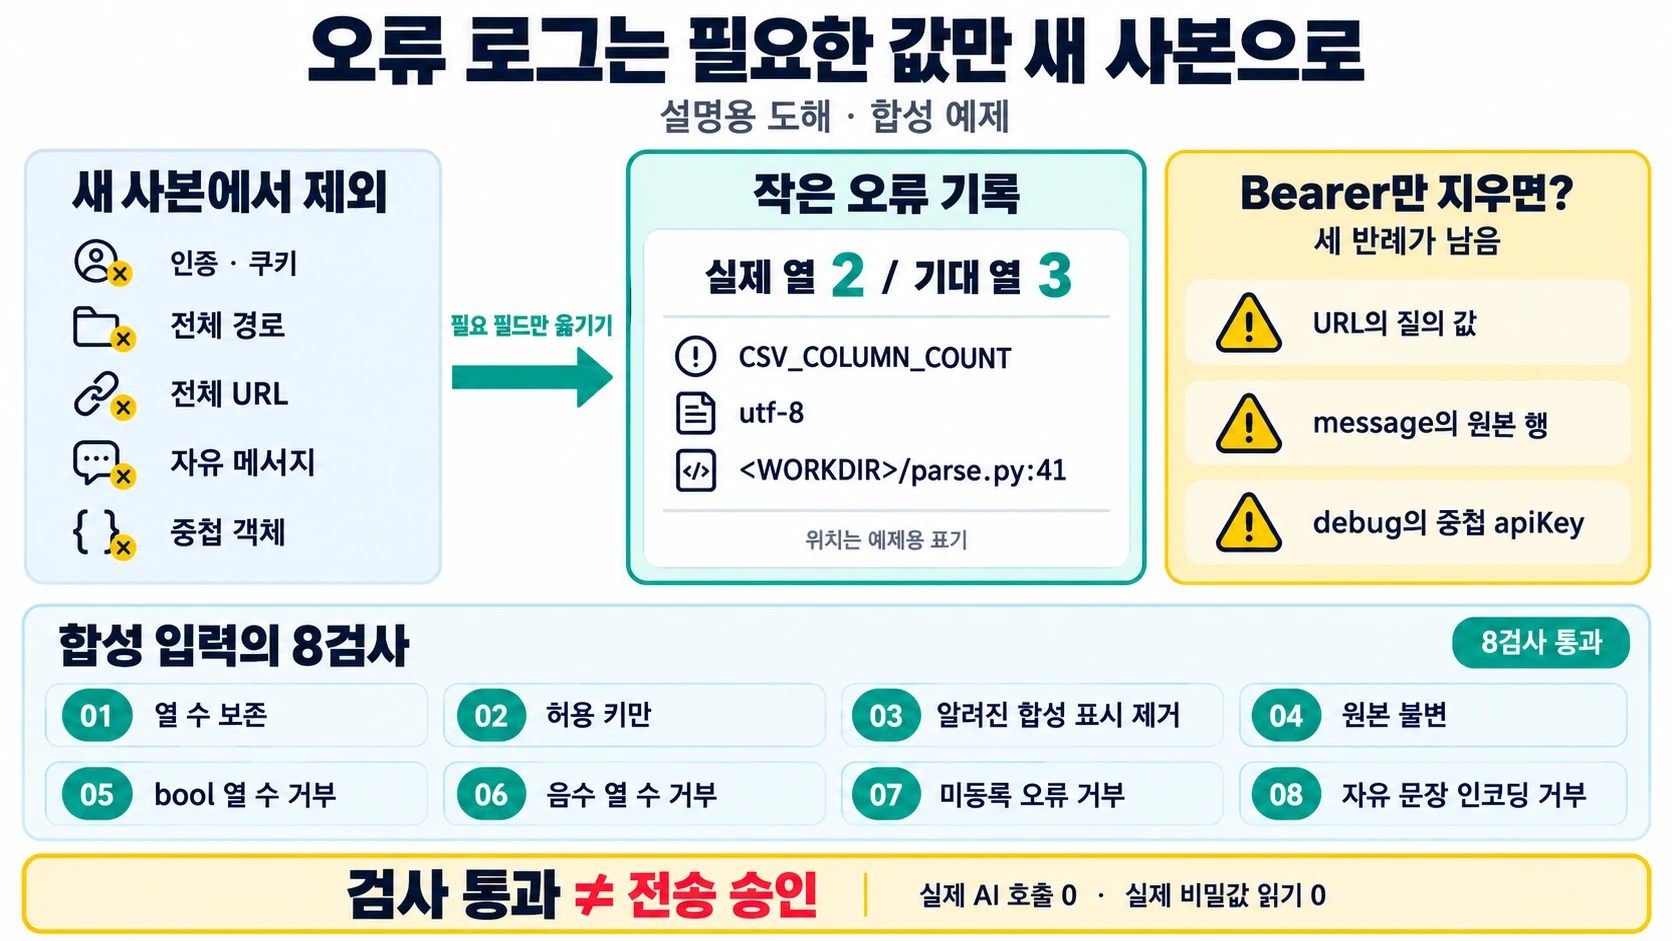
질문은 “세 열을 기대하는 CSV 파서가 두 열을 읽었을 때 어디를 확인할까”로 정합니다. 인증 실패나 특정 사용자의 거래 내역을 조사하는 질문은 아닙니다. 필요한 값은 오류 종류, 기대 열 수 3, 실제 열 수 2, 인코딩 utf-8, 문제가 난 코드 위치입니다.
정확한 사용자 이름·고객 폴더·세션·업로드 URL은 이번 질문에 필요하지 않습니다. 작업 파일의 위치는 실제 절대경로 대신 <WORKDIR>/parse.py:41이라는 설명용 표기로 남깁니다. 이 줄 번호와 파일 이름은 예제에서 정한 값이며 실제 스택 추적에서 수집한 위치가 아닙니다.
실무에서는 파일 이름도 프로젝트나 고객을 드러낼 수 있습니다. 줄 번호·파일 역할이 필요하면 권한 있는 담당자가 대조해 parser_module:line N처럼 필요한 정도만 남깁니다. 경로 문제 자체를 조사한다면 구분자·상대경로 구조를 보존한 작은 합성 경로로 먼저 재현하세요. 무조건 파일 이름만 남기는 규칙으로 모든 경로 오류를 진단할 수는 없습니다.
OWASP 로그 지침은 접근 토큰·비밀번호·연결 문자열 등은 로그에 직접 기록하지 않도록 하고, 경로·내부 주소도 별도 취급이 필요할 수 있다고 설명합니다. 여기서 필요한 필드만 옮기는 방식은 그 안내를 바탕으로 정한 이 예제의 입력 축소 설계입니다.
합성 원본에서 무엇을 남길지 대조하기
아래는 연습 자료의 주요 값입니다. 실제 서비스의 로그 형식이나 유효한 자격 증명을 흉내 내지 않았습니다. URL의 example.invalid도 서비스 접속용 주소가 아닙니다.
원본 필드: error_code
- 합성 값 또는 내용: CSV_COLUMN_COUNT
- 이번 사본의 처리: 허용한 오류 코드만 유지
원본 필드: actual_columns / expected_columns
- 합성 값 또는 내용: 2 / 3
- 이번 사본의 처리: 정수형·음수 여부 검사 후 유지
원본 필드: encoding
- 합성 값 또는 내용: utf-8
- 이번 사본의 처리: 정한 인코딩 목록 안의 값만 유지
원본 필드: source_path
- 합성 값 또는 내용: C:\Users\SYNTHETIC_USER\SYNTHETIC_CLIENT\parse.py
- 이번 사본의 처리: 원본을 넘기지 않고 설명용 위치 사용
원본 필드: authorization
- 합성 값 또는 내용: Bearer SYNTHETIC_TOKEN_NOT_VALID_001
- 이번 사본의 처리: 필드를 새 사본에 넣지 않음
원본 필드: cookie
- 합성 값 또는 내용: session=SYNTHETIC_SESSION_NOT_VALID_002
- 이번 사본의 처리: 필드를 새 사본에 넣지 않음
원본 필드: request_url
- 합성 값 또는 내용: token=SYNTHETIC_QUERY_NOT_VALID_003 포함
- 이번 사본의 처리: 전체 필드를 제외
원본 필드: message / debug
- 합성 값 또는 내용: 원본 행과 중첩 apiKey 표시 포함
- 이번 사본의 처리: 자유 문장과 중첩 객체를 제외
오류 메시지도 무조건 안전한 값은 아닙니다. “입력값이 잘못됐다” 뒤에 입력 문자열 전체가 붙는 경우가 있기 때문입니다. 이번 코드는 message를 전달하지 않고 확인된 error_code와 열 개수로 질문을 다시 구성합니다. 메시지가 원인 분석에 꼭 필요하면 합성 자료로 같은 오류를 재현하고, 그때 얻은 작은 메시지를 검토합니다.
AI 계정의 데이터 설정이나 회사의 사용 승인도 별도 확인 대상입니다. 사본을 줄였다고 외부 전송 권한이 생기지 않습니다. 계정·목적·자료 범위가 승인되지 않았으면 보내지 않고 담당자 확인 단계로 남깁니다.
Bearer 문자열 하나만 지우면 남는 세 반례
다음 패턴은 한계를 보여 주려고 만든 짧은 후보입니다. 일반 로그 마스킹 도구로 사용하지 않습니다.
re.sub(r"Bearer [A-Za-z0-9_]+", "Bearer <REMOVED>", text)이 후보를 합성 원본의 JSON 문자열에 적용했을 때 Bearer 뒤의 표시만 지워졌고, URL의 SYNTHETIC_QUERY_NOT_VALID_003, message의 SYNTHETIC_PRIVATE_ROW_004, 중첩 debug의 SYNTHETIC_NESTED_NOT_VALID_005는 남았습니다. 세 값이 남았는지 실제 Python 검사에 포함했습니다.
필드 이름이 다르거나 값이 여러 줄·인코딩된 문자열로 들어오면 다른 누락도 생길 수 있습니다. 알려진 문자열을 찾는 검사는 알려진 사례에만 답합니다. 이 글은 정규식 목록을 더 길게 붙여 완전한 비식별화를 보장하지 않습니다. 작은 사본을 만든 뒤에도 사람이 읽으며 남길 필요와 공유 가능 여부를 확인해야 합니다.
필요한 값만 새 객체로 만드는 전체 코드
다음 코드를 UTF-8 파일 log_minimum_check.py로 저장합니다. Python 3의 표준 라이브러리만 사용합니다. 파일을 읽는 기능이나 네트워크 요청이 없으므로 연습하면서 실제 로그나 키를 가져올 필요가 없습니다.
import copy
import json
import re

# Every value is synthetic. This program does not read logs or environment values.
SAMPLE = {
    "error_code": "CSV_COLUMN_COUNT",
    "actual_columns": 2,
    "expected_columns": 3,
    "encoding": "utf-8",
    "source_path": r"C:\Users\SYNTHETIC_USER\SYNTHETIC_CLIENT\parse.py",
    "authorization": "Bearer SYNTHETIC_TOKEN_NOT_VALID_001",
    "cookie": "session=SYNTHETIC_SESSION_NOT_VALID_002",
    "request_url": "https://example.invalid/upload?token=SYNTHETIC_QUERY_NOT_VALID_003",
    "message": "row rejected: SYNTHETIC_PRIVATE_ROW_004",
    "debug": {"apiKey": "SYNTHETIC_NESTED_NOT_VALID_005"},
}

def minimum_record(record):
    if record.get("error_code") != "CSV_COLUMN_COUNT":
        raise ValueError("this example handles only CSV_COLUMN_COUNT")
    for key in ("actual_columns", "expected_columns"):
        if type(record.get(key)) is not int or record[key] < 0:
            raise ValueError("column counts must be non-negative integers")
    if record.get("encoding") not in ("utf-8", "cp949"):
        raise ValueError("encoding needs separate review")
    return {
        "example": "synthetic",
        "error_type": "ValueError",
        "error_code": "CSV_COLUMN_COUNT",
        "actual_columns": record["actual_columns"],
        "expected_columns": record["expected_columns"],
        "encoding": record["encoding"],
        "code_location": "<WORKDIR>/parse.py:41",
    }

def main():
    original = copy.deepcopy(SAMPLE)
    output = minimum_record(SAMPLE)
    checks = []
    checks.append(("R01_counts_preserved", output["actual_columns"] == 2 and output["expected_columns"] == 3))
    checks.append(("R02_allowlist_only", set(output) == {"example", "error_type", "error_code", "actual_columns", "expected_columns", "encoding", "code_location"}))
    text = json.dumps(output, ensure_ascii=False)
    checks.append(("R03_known_synthetic_markers_absent", "SYNTHETIC_" not in text))
    checks.append(("R04_original_unchanged", SAMPLE == original))
    for case_id, field, value in [
        ("R05_bool_count_rejected", "actual_columns", True),
        ("R06_negative_count_rejected", "expected_columns", -1),
        ("R07_unknown_error_rejected", "error_code", "OTHER"),
        ("R08_free_text_encoding_rejected", "encoding", "utf-8 SYNTHETIC_SECRET"),
    ]:
        bad = copy.deepcopy(SAMPLE)
        bad[field] = value
        try:
            minimum_record(bad)
        except ValueError:
            checks.append((case_id, True))
        else:
            checks.append((case_id, False))
    if not all(ok for _, ok in checks):
        raise AssertionError(checks)
    # A deliberately narrow regex is NOT a production redactor.
    naive = re.sub(r"Bearer [A-Za-z0-9_]+", "Bearer <REMOVED>", json.dumps(SAMPLE))
    missed = ["SYNTHETIC_QUERY_NOT_VALID_003", "SYNTHETIC_PRIVATE_ROW_004", "SYNTHETIC_NESTED_NOT_VALID_005"]
    if not all(marker in naive for marker in missed):
        raise AssertionError("counterexample changed")
    print(json.dumps({"minimum_record": output, "checks_passed": len(checks),
                      "naive_redaction_missed": missed, "live_ai_calls": 0,
                      "real_secret_reads": 0, "result": "PASS"}, ensure_ascii=False))

if __name__ == "__main__":
    main()
python log_minimum_check.py실제 실행 환경은 Linux Python 3.12.14입니다. 여덟 검사는 열 수 보존, 허용 키 집합, 알려진 합성 표시 제거, 원본 불변, bool·음수 열 수 거부, 미등록 오류 거부, 자유 문장이 붙은 인코딩 거부를 확인합니다. 출력의 핵심 값은 다음과 같습니다.
checks_passed: 8
naive_redaction_missed: URL 표시 / 원본 행 표시 / 중첩 apiKey 표시 3개
live_ai_calls: 0
real_secret_reads: 0
result: PASS
이것은 콘솔 JSON의 주요 값을 읽기 쉽게 적은 기록입니다. 실제 출력에는 남은 세 합성 문자열과 minimum_record 객체가 함께 나옵니다. type(value) is int 검사로 True를 열 개수 1로 받아들이지 않습니다. 오류 코드를 바꾸면 알 수 없는 오류의 자유 메시지를 억지로 전달하지 않고 중단합니다. 복사 후에도 SAMPLE은 바뀌지 않는지 확인합니다.
AI에 보낼 질문도 작은 재현으로 작성하기
검사에서 만든 minimum_record의 값으로 다음 요청을 준비할 수 있습니다. 이것은 요청 예시이며 실제 모델에 보낸 내용이나 응답 기록이 아닙니다.
합성 CSV 파서의 열 개수 오류를 검토해 주세요.
error_type: ValueError
error_code: CSV_COLUMN_COUNT
expected_columns: 3
actual_columns: 2
encoding: utf-8
code_location: <WORKDIR>/parse.py:41 (예제용 표기)
재현 입력: A,12
처리 가정: 쉼표로 분리하면 ['A', '12']가 됨

원인 후보와 로컬에서 확인할 순서를 제안하세요.
인증값, 전체 로그, 환경변수, 실제 고객 행을 추가로 요구하는 해결책은 제안하지 마세요.
열 정의와 입력 행의 계약이 부족하면 어떤 정보를 확인해야 하는지 질문으로 남기세요.
이 두 열을 세 열로 바꾸는 업무 규칙은 아직 정하지 않았습니다.
추가 열을 빈 값으로 채우면 파서가 통과할 수 있지만 업무적으로 올바른지는 다른 질문입니다. AI가 “세 번째 열을 자동으로 채우라”고 답했다면 어떤 열이 필수인지 원본 계약에서 확인합니다. 이번 자료만으로 누락 열의 실제 값을 추정하지 않습니다. 설명을 얻기 위해 로그 범위를 계속 넓히는 대신, 부족한 정의를 비밀값 없는 짧은 문장으로 보완합니다.
사본 검토 기록과 중단 기준
다음 양식을 사본마다 복사해서 사용합니다. 원본 위치는 내부 기록에만 남기고 외부 질문에 함께 붙이지 않습니다. 승인란이 비어 있으면 코드 검사 통과를 전송 승인으로 해석하지 않습니다.
오류 질문과 필요한 범위:
원본의 내부 보관 위치와 권한 확인:
사본 버전:
남긴 필드와 필요한 이유:
제외한 필드 종류: 인증 / 개인 정보 / 경로 / 원본 행 / 기타
합성 위치로 바꾼 부분:
알려진 민감 표시 검사 결과:
자유 메시지·URL·중첩 객체 직접 검토:
아직 불확실한 필드:
사용할 AI 계정·자료 전송 승인 확인:
판정: 전송 범위 검토 완료 / 추가 축소 / 담당자 확인 대기
검토자·확인 시각:
사본에서 알려진 표시가 남으면 처음부터 전송하지 않고 제외 규칙을 고칩니다. 검사가 오류를 내면 잘못된 타입이나 미등록 코드를 먼저 확인하고, 오류가 안 나도록 원본 값을 임의 변환하지 않습니다. 원본과 사본을 덮어쓰지 않고 새 사본에서 재검사합니다.
실제 인증값이 이미 외부에 노출됐다고 의심되는 경우에는 단순히 대화 문장을 지우는 것으로 해결됐다고 판단하지 않습니다. 조직의 사고 대응 절차와 해당 발급자의 공식 폐기·교체 안내를 따라야 합니다. 이 연습 코드는 인증값을 회수하거나 계정 설정을 변경하지 않습니다.
확인한 범위와 함께 읽을 글
공식 출처 확인·작성·Python 실행은 2026-10-04 KST에 수행했습니다. 실제 LLM 요청, 실제 로그 검토, 계정의 데이터 처리 설정 변경은 수행하지 않았습니다. 정해 둔 여덟 검사를 통과해도 알려지지 않은 식별자나 업무 맥락에 의한 재식별 가능성을 모두 배제하지는 못합니다.
요청에 기대 결과를 넣는 방법은 AI에 Excel 수식·VBA를 요청하기 전 검산하는 글과 연결됩니다. 그 글은 업무 계산의 기대값을 정하는 작업이며, 이 글의 완료 기준은 비밀값을 읽지 않은 합성 실습에서 필요한 오류 정보만 남기는 방법을 재현하고 실제 전송은 별도 승인 범위로 판단하는 것입니다.
작성자 소개
