AI 문서 버전 비교: GPT·Claude·Gemini로 번호가 바뀐 조항 찾기
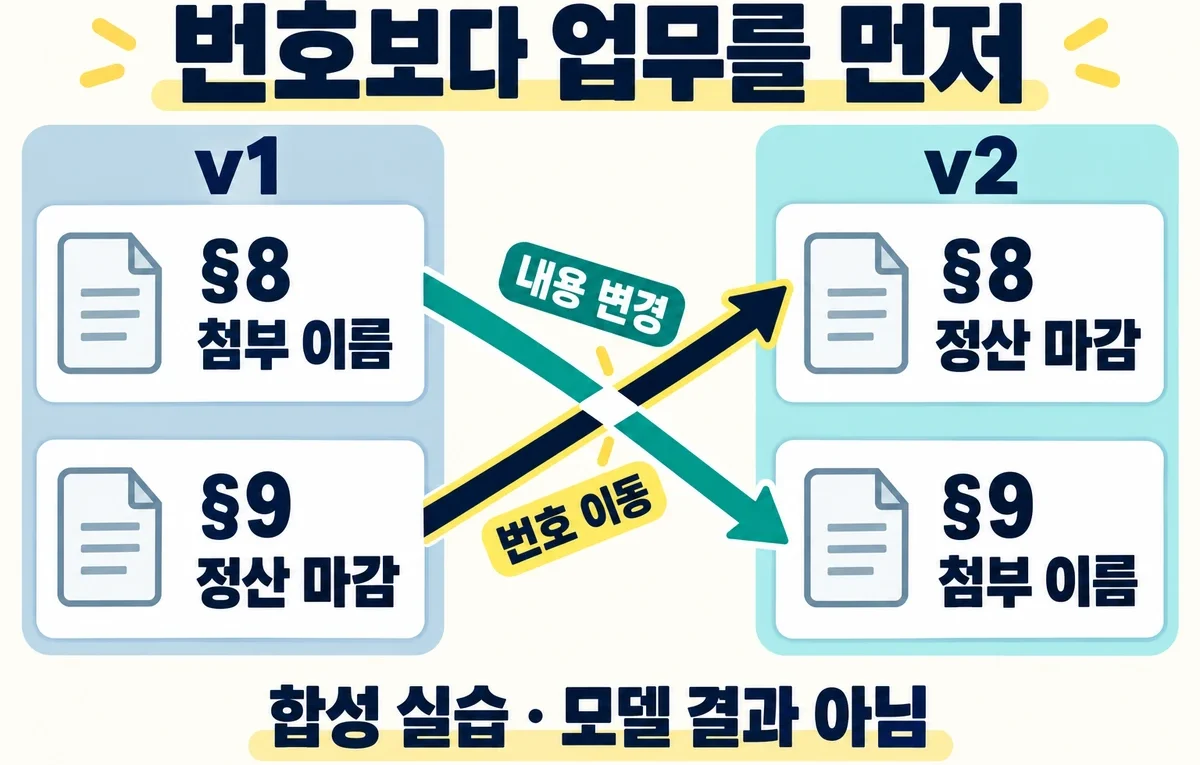
업무 매뉴얼의 개정 전후를 AI로 비교할 때는 조항 번호보다 업무 내용을 먼저 맞춰야 합니다. 예전 §9가 새 문서의 §8로 옮겨졌다면 삭제와 신설로 두 번 세면 안 됩니다. 같은 §7 번호가 전혀 다른 업무에 쓰였다면 두 문장을 한 항목의 변경으로 뭉뚱그려서도 안 됩니다.
이번 글은 GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash를 문서 버전 비교에 쓰는 방법을 다룹니다. 반복 검수의 시작 후보는 단가가 낮은 Flash, 원문 위치를 자동으로 붙이는 흐름은 Claude의 내장 인용, OpenAI 기반 후속 자동화에 연결하는 흐름은 Sol의 구조화 출력을 검토할 수 있습니다. 세 모델 중 어느 것이 한국어 개정 비교를 가장 잘하는지는 같은 자료의 첫 답과 수정 비용을 보고 결정해야 합니다.
조사·자료 검산 기준일은 2026년 10월 7일 한국시간입니다. 게시 전 공식 사양과 가격을 다시 확인하고 가상 실습의 기대 답을 검산했습니다. 세 모델을 실제 API로 호출한 성능·속도 결과는 없습니다. 아래 가격은 유료 API의 텍스트 요금이며 앱 구독료와 별개입니다.
대표 이미지 설명: 합성 실습의 조항 정렬 개념도입니다. 모델 실행 결과가 아닙니다.
문서 버전 비교 실습 ZIP 다운로드 · 가상 매뉴얼 2개 버전, 누락본, 공통 요청과 정답 검수표
어떤 비교가 필요한가
단순히 “달라진 내용을 요약해 줘”라고 하면 금액 변경은 찾고 적용 단위 변경은 놓칠 수 있습니다. 예를 들어 25,000원이 그대로여도 ‘1일당’이 ‘1식당’으로 바뀌면 조건이 달라집니다. 조항 번호가 옮겨지거나 새 버전 안에서 요약표와 본문이 충돌할 때도 요약 한 문장으로는 검수하기 어렵습니다.
결과를 받기 전에 비교 기준을 정하세요.
- 업무 항목을 기준으로 개정 전후를 한 행에 연결합니다
- 금액, 적용 단위, 기한, 승인 주체를 따로 확인합니다
- 내용이 그대로이고 번호·위치만 달라졌으면 ‘이동’으로 기록합니다
- 같은 버전 안의 값이 충돌하면 두 근거를 남기고 결론을 보류합니다
- 삭제는 새 버전 전체가 제공됐을 때만 확정합니다
이 글의 가상 자료는 그 기준을 연습하는 작은 예제입니다. 수십만 토큰의 문서를 생성하거나 실제 모델의 장문 정확도를 시험한 자료는 아닙니다.
세 모델의 사양과 장단점
세 모델 모두 이번 텍스트 실습의 후보입니다. 아래의 유리한 점은 공식 기능과 단가를 바탕으로 한 선택 기준이며, 실제 응답을 측정한 품질 순위가 아닙니다.
| 모델 | 문서 비교 흐름에서 유리한 점 | 선택 전에 확인할 점 |
|---|---|---|
| GPT-6.1 Sol | JSON Schema 기반 구조화 출력을 지원해 정해진 필드로 결과를 넘기는 흐름을 만들 수 있습니다 | 입력 272,000토큰을 넘으면 요청 전체에 장문 할증이 적용됩니다. 형식이 맞아도 인용과 의미가 맞는지는 검수해야 합니다 |
| Claude Sonnet 5.5 | 내장 Citations를 사용하면 텍스트의 문자 범위나 PDF의 페이지 근거를 결과에 붙일 수 있습니다 | 내장 Citations와 구조화 JSON을 한 요청에서 동시에 사용할 수 없습니다. 두 방식 중 하나를 고르거나 별도 단계로 나눠야 합니다 |
| Gemini 3.8 Flash | 현재 기본 텍스트 단가가 낮아 같은 입력으로 반복 비교를 시작하기 좋습니다. 구조화 출력을 지원합니다 | 소개 요금의 종료일을 확인해야 합니다. JSON의 값이 원문과 맞는지 검수하고, 문서 근거와 웹 검색 근거를 구별해야 합니다 |
공식 모델 ID는 gpt-6.1-sol, claude-sonnet-5-5, gemini-3.8-flash입니다. Sol의 컨텍스트 창은 1,050,000토큰, Sonnet은 1,000,000토큰이며 둘의 최대 출력은 128,000토큰입니다. Flash의 최대 입력은 1,048,576토큰, 최대 출력은 65,536토큰입니다. ‘컨텍스트 창’과 ‘최대 입력’은 서로 다른 항목이므로 문서 길이를 넣을 때 출력 여유와 해당 API 한도도 확인하세요. 큰 한도는 해당 길이에서 누락 없이 비교한다는 보장이 아닙니다. Sol 모델 사양, Claude Sonnet 모델 사양, Flash 모델 사양
출처가 달린 답과 JSON은 따로 확인하기
Claude의 내장 Citations는 일반 텍스트 문서의 문자 위치, PDF의 페이지, 사용자 지정 콘텐츠 블록 등의 근거 정보를 제공합니다. 그러나 output_config.format으로 구조화 JSON을 지정하면서 Citations를 켜면 400 오류가 납니다. 출처가 달린 설명을 먼저 받고 별도 단계에서 표로 옮기거나, 내장 인용 없이 이번 실습처럼 원문 위치 표식을 JSON 필드로 받는 방법을 선택할 수 있습니다. 두 번째 방법의 위치·인용문은 사람이 다시 대조해야 합니다. Claude Citations, Claude 구조화 출력
Sol과 Flash의 구조화 출력도 결과의 형태를 정하는 기능입니다. schema에 맞는 답이 나왔다고 해서 ‘1일당’과 ‘1식당’을 올바르게 구별했거나 인용문을 정확히 가져왔다고 판단하면 안 됩니다. 모델이 만든 위치 문자열은 원문 근거와 대조하세요. OpenAI 구조화 출력, Gemini 구조화 출력
이번 공통 실습은 세 모델 모두 같은 텍스트와 위치 표식을 직접 입력하는 조건입니다. 웹 검색, File Search, OCR, 각 서비스의 내장 인용은 사용하지 않습니다. 이 기능을 추가한 비교는 사용한 입력·도구·비용을 별도로 기록해야 합니다.
긴 입력은 단가보다 요청 전체 비용 보기
Standard 비캐시 텍스트 요금은 다음과 같습니다. 단위는 미국 달러/100만 토큰입니다.
| 모델 | 입력 | 출력 | 장문·기간 조건 |
|---|---|---|---|
| GPT-6.1 Sol | $2.00 | $10.00 | 입력이 272,000토큰을 넘으면 요청 전체 입력 $4.00, 출력 $15.00 |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M 컨텍스트까지 장문 추가 요금 없음 |
| Gemini 3.8 Flash | $0.75 | $3.75 | 2026-12-31까지 소개 요금. 2027-01-01부터 $1.50/$7.50 |
요금은 Sol 가격과 장문 조건, Claude 가격, Gemini Standard 가격에서 확인했습니다.
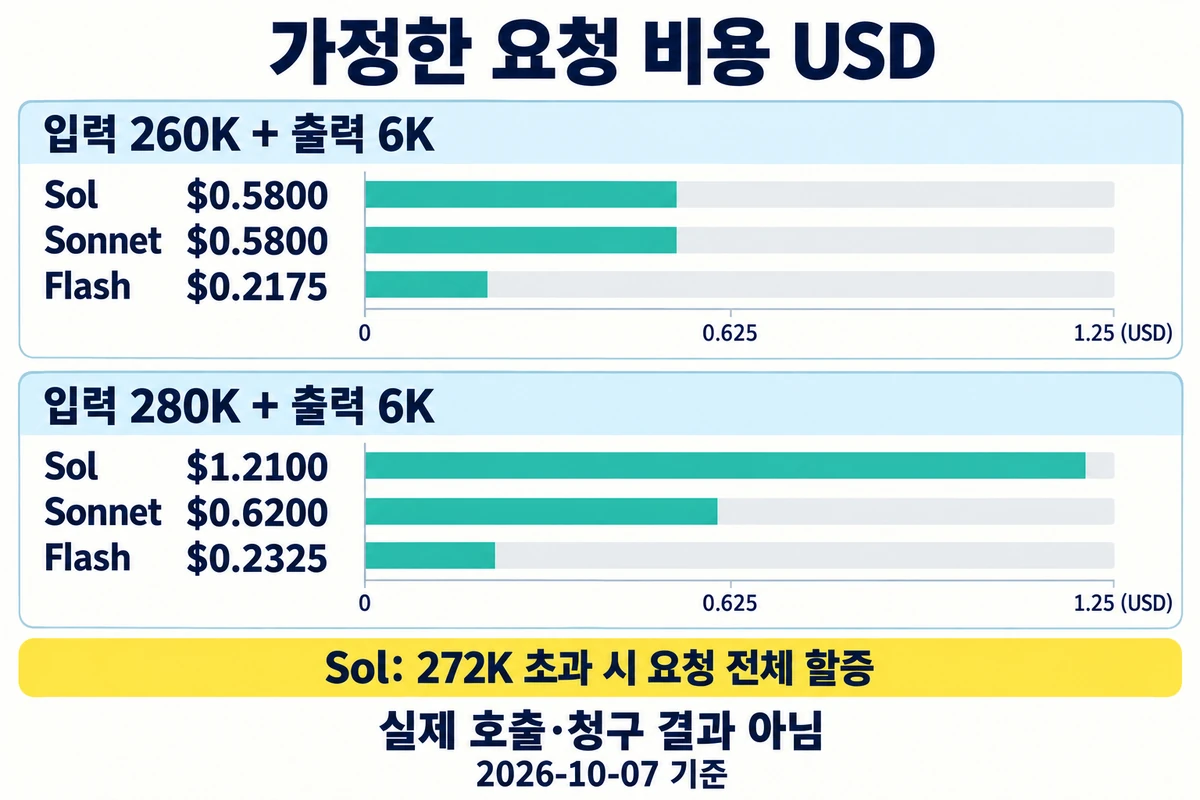
문서·지시문을 합쳐 과금 입력 260,000토큰, 과금 출력 6,000토큰이라고 가정하면 Sol과 Sonnet은 각각 $0.58, Flash는 $0.2175입니다. 입력만 280,000토큰으로 늘리면 Sol은 $1.21, Sonnet은 $0.62, Flash는 $0.2325입니다. Sol의 할증은 272,000을 넘은 부분에만 붙는 방식이 아니라 요청 전체에 적용됩니다.
| 가정한 과금 토큰 | Sol | Sonnet | Flash |
|---|---|---|---|
| 입력 260,000 + 출력 6,000 | $0.5800 | $0.5800 | $0.2175 |
| 입력 280,000 + 출력 6,000 | $1.2100 | $0.6200 | $0.2325 |
계산식은 ‘입력 토큰 × 입력 단가 ÷ 1,000,000 + 출력 토큰 × 출력 단가 ÷ 1,000,000’입니다. Sol의 두 번째 행은 $1.12 + $0.09 = $1.21입니다. 모두 가정한 과금량의 산술 예이며 실제 요청·청구 결과는 아닙니다. 같은 한국어 문서도 모델별 토큰 수가 다르고, 화면에 보이는 답변 외의 추론 토큰이 출력 과금에 포함될 수 있습니다. OpenAI usage의 output_tokens에는 reasoning_tokens가 이미 포함되므로 별도로 더하지 않습니다. 캐시, Batch, 속도 옵션, 도구 호출, 지역 요금, 세금과 환율은 제외했습니다. 추론 토큰의 과금은 OpenAI 안내, Claude 컨텍스트 안내, Gemini 출력 요금에서 확인할 수 있습니다.
최종 비용은 첫 요청에 수정 요청들의 비용을 더해 계산하세요. 싼 첫 답에서 단위 누락이나 허위 인용이 반복되면 수정 비용과 사람의 검수 시간이 늘어납니다. 실제 usage와 수정 횟수를 함께 남겨야 내 업무에서 어느 모델이 경제적인지 알 수 있습니다.
실습 자료의 조항 번호부터 대조하기
가상의 출장비 매뉴얼 v1과 v2를 비교하겠습니다. 모든 이름·규칙은 실습용이며 실제 회사의 정책이나 개인정보가 아닙니다. 위치 표식의 p와 L은 이 예제에서 정한 페이지·줄 표시입니다. 실제 PDF에서 추출한 좌표가 아닙니다.
다음 네 줄이 번호만으로 비교할 때 생기는 문제를 보여줍니다.
| 자료 위치 | 원문 |
|---|---|
| v1:p4:L03, §8 | 첨부파일 이름은 출장일_사번_영수증으로 작성한다. |
| v2:p4:L03, §9 | 첨부파일 이름은 출장일_부서코드_영수증으로 작성한다. |
| v1:p4:L05, §9 | 매월 정산 마감은 마지막 영업일 17:00이다. |
| v2:p2:L09, §8 | 매월 정산 마감은 마지막 영업일 17:00이다. |
첨부 이름 규칙은 §8에서 §9로 옮겨졌고 식별 항목도 바뀌었습니다. 정산 마감은 §9에서 §8로 옮겨졌지만 조건은 같습니다. 따라서 전자는 ‘변경’, 후자는 ‘이동’으로 기록합니다. 번호가 바뀌었다는 사실만으로 두 항목을 모두 삭제·신설로 세지 않습니다.
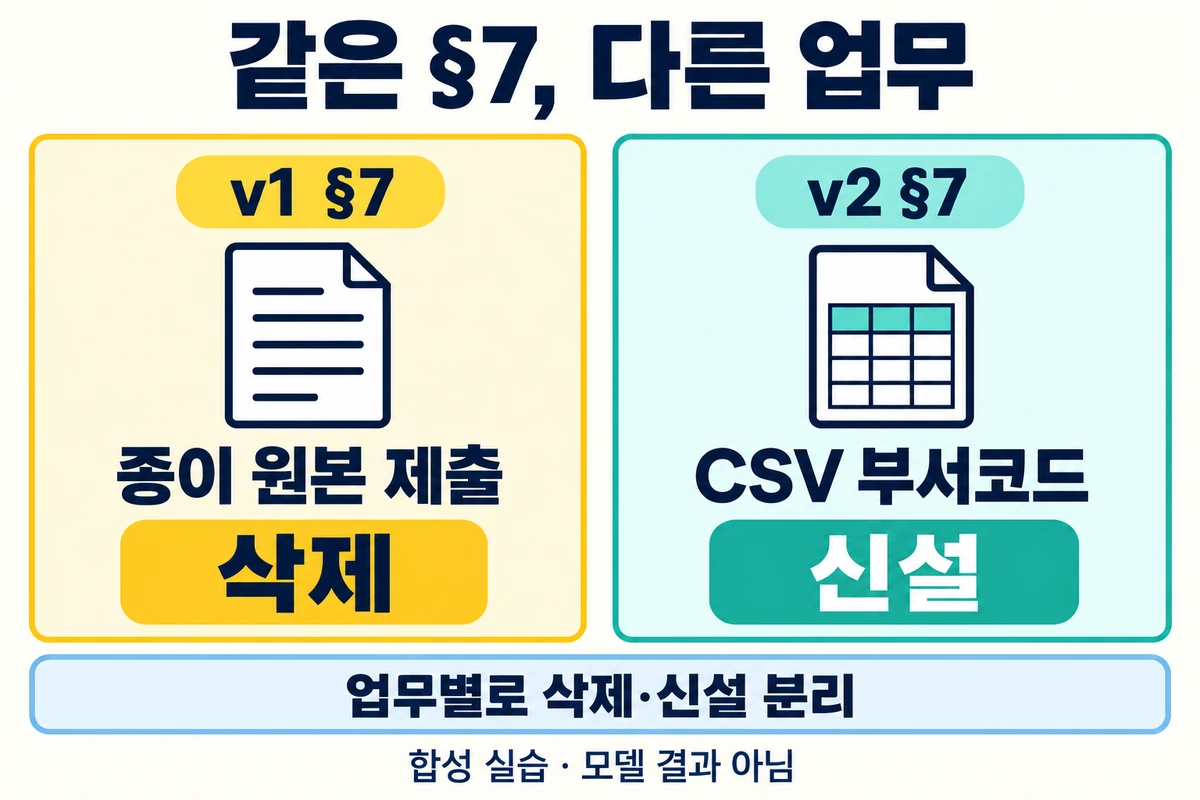
§7은 별도의 함정입니다. v1의 §7은 ‘종이 영수증 원본 제출’, v2의 §7은 ‘CSV에 부서코드 포함’입니다. 이번 요청은 업무 항목별로 비교하므로 종이 제출은 삭제, CSV 항목은 신설로 기록합니다. 같은 번호라는 이유로 두 업무를 합치지 않습니다.
같은 입력으로 첫 답 받기
첨부 ZIP의 manual_v1.txt, manual_v2.txt, source_manifest.json, topics.csv를 각 모델의 새 대화에 넣고 prompt.txt의 요청을 사용하세요. 기대 답 파일은 모델에 보여주지 않습니다. 앱을 쓰면 파일에서 추출된 내용·선택 모델·도구 상태가 같았는지도 확인하세요. API라면 정확한 모델 ID, 고정 버전이 있으면 그 버전, 추론 설정과 실제 usage를 기록합니다.
요청의 핵심은 다음과 같습니다.
topics.csv의 업무 항목을 기준으로 v1과 v2를 연결한다. 원문 번호가 달라도 같은 업무면 한 행에 기록하고, 같은 번호가 다른 업무에 재사용되면 합치지 않는다. 각 항목에 검수용 ID, 분류, 변경 설명, 이전·이후 원문 위치와 짧은 인용문, 추가 검수 여부를 남긴다. 내용은 같고 번호·위치만 바뀌면 이동이다. 같은 버전의 값이 충돌하면 두 근거를 남기고 최종 규칙을 선택하지 않는다. 누락 페이지가 있으면 삭제를 확정하지 않는다.
TR-01부터 TR-10까지의 ID는 검수표를 위한 업무 항목 ID입니다. 원문 조항 번호와 다릅니다. 번호를 안정적인 ID로 착각하지 않도록 이 둘을 구분합니다. 공통 요청은 순수 JSON 답을 요구하지만 API의 Structured Outputs 기능을 자동으로 켜는 것은 아닙니다.
기대 답 10개와 중요한 실패 항목
완전본의 기대 답은 다음과 같습니다. 모델이 실제로 낸 답이 아니라 가상 자료에서 미리 정한 정답 기준입니다.
| 검수 ID와 업무 | 기대 분류 | 확인할 값·조건 |
|---|---|---|
| TR-01 교통비 한도 | 변경 | 90,000원 → 110,000원 |
| TR-02 숙박비 한도 | 동일 | 1박당 140,000원 유지 |
| TR-03 영수증 제출 | 변경 | 5영업일 → 7영업일 |
| TR-04 식비 | 변경 | 25,000원은 같고 1일당 → 1식당 |
| TR-05 택시 승인 | 변경 | 팀장 → 부서장 사전승인 |
| TR-06 교육 교통비 | 충돌 | v2 요약표 14일, 본문 7일. 최종 기한 미확정 |
| TR-07 종이 원본 제출 | 삭제 | 완전한 v2에서 해당 업무가 사라짐 |
| TR-08 첨부 이름 | 변경 | §8 → §9 이동, 사번 → 부서코드 |
| TR-09 정산 마감 | 이동 | §9 → §8, 마지막 영업일 17:00 유지 |
| TR-10 CSV 부서코드 | 신설 | v2 §7에서 새로 요구 |
변경 5건·동일 1건·이동 1건·충돌 1건·삭제 1건·신설 1건으로 총 10개 업무 항목입니다. 그중 변경·충돌·삭제·신설은 8건입니다. ‘변경 8건’이라고 요약하면 서로 다른 상태를 숨기므로 분류를 나눠 기록하세요.
TR-06의 올바른 답은 14일과 7일을 모두 적고, 각각 v2:p1:L07과 v2:p3:L03을 근거로 남기는 것입니다. 요약표나 본문이 우선한다는 규칙은 이 자료에 없습니다. 어느 한쪽을 임의로 고르면 실패입니다.
틀린 답은 실패 유형별로 고치기
- TR-04를 동일이라고 했다면 두 원문의 적용 단위를 다시 인용하도록 요청합니다
- TR-08과 TR-09를 뒤바꿨다면 조항 번호를 빼고 ‘첨부 이름’과 ‘정산 마감’의 문장을 먼저 연결하게 합니다
- TR-06의 기한을 확정했다면 두 출처와 충돌 상태만 다시 작성하게 합니다
- 인용문이 원문에 없다면 해당 위치의 실제 문장으로 교체하고, 그 인용에 의존한 판단도 다시 확인합니다
수정 후 결과가 맞아져도 첫 답의 실패를 지우지 마세요. 첫 답, 수정 요청, 최종 답을 따로 보관하고 재시도 비용을 더합니다.
페이지가 빠졌을 때는 삭제를 확정하지 않기
별도의 새 대화에서 v2를 manual_v2_page4_missing.txt로 바꿔 보세요. v2의 전체 페이지 수는 4인데 제공된 페이지는 1~3뿐입니다. manifest도 누락본용 source_manifest_page4_missing.json으로 바꿉니다.
이 입력으로는 TR-08의 새 이름 규칙과 TR-10의 신설을 확인할 수 없습니다. TR-07이 보이지 않는다고 삭제라고 단정해서도 안 됩니다. 빠진 p4에 있을 가능성을 확인하지 못했기 때문입니다. 이 세 항목은 source_missing, 즉 ‘자료 누락으로 확정 불가’로 남겨야 합니다. 이미 보이는 TR-01의 한도 변경이나 TR-06의 충돌은 관찰된 근거로 기록할 수 있습니다.
업무에 맞는 선택은 합격한 답의 총비용으로
반복 비교를 시작할 때는 Flash로 위 자료를 시험하고, 단위 변화·번호 재사용·충돌·허위 인용 같은 실패가 있으면 Sol과 Sonnet의 첫 답도 같은 조건에서 비교할 수 있습니다. Flash가 이 업무를 더 잘한다는 실험 결과가 아니라 현재 단가를 고려한 시험 순서입니다.
원문 위치를 서비스가 제공하는 인용 메타데이터로 남기는 것이 중요하면 Claude Citations를 검토하세요. 정해진 JSON 형식으로 결과를 전달하려면 Sol이나 Flash의 구조화 출력, 또는 Claude의 구조화 출력 방식을 선택할 수 있습니다. Claude에서 내장 인용까지 필요하면 한 요청으로 결합할 수 없다는 제약을 설계에 반영합니다.
입력이 272,000토큰을 넘는 OpenAI 요청은 장문 요금을 먼저 확인하세요. 문서를 줄일 때는 비교에 필요한 조항과 인용 근거가 함께 남아 있는지도 확인해야 합니다. 단가를 줄이려고 자료를 빼서 삭제 판단이 불가능해지면 작업 결과도 달라집니다.
모델별로 기록할 것은 첫 답의 필수검사 통과 여부, 치명 오류, 수정 횟수, 전체 API 비용, 사람 검수 시간입니다. 첨부 rubric.csv의 적용사례에 따라 완전본은 R01~R08·R10의 9개, p4 누락본은 R01~R05·R08·R09의 7개를 채점합니다. 해당 사례의 필수검사를 모두 통과하고 치명 오류가 없을 때 합격으로 기록합니다. TR-01~TR-10의 업무 항목 10개와 필수검사 수는 다른 단위이며, 적용되지 않는 검사는 합격수나 분모에 넣지 않습니다. 이번 자료에서는 근거 없는 기한 확정·허위 인용·누락본의 삭제 단정을 치명 오류로 봅니다. 합격하지 못한 답을 ‘필수검사 중 몇 개를 통과했다’는 숫자만으로 채택하지 마세요.
실습 자료 구성
AI_Document_Version_Comparison_Practice_20261007_scoring_v2.zip 다운로드 (12,469바이트, 15개 파일)
SHA-256: 8a882d154f5665c52d74ec2ca5e5a2c7c73ab0d8db8b9da72275672202ab9d59
실습 ZIP에는 두 버전의 가상 매뉴얼, p4 누락본, 업무 항목표, 공통 요청, 오류 복구 요청, 기대 답 JSON, 필수검사 CSV, 빈 모델 실행 기록표, 가격 계산 예와 공식 출처 목록을 넣었습니다. 파일에는 매크로·API 키·유료 API 자동 호출 기능이 없습니다. 첨부를 열어도 모델 비교가 자동 실행되지 않습니다.
자주 묻는 질문
컨텍스트가 100만 토큰이면 긴 매뉴얼을 한 번에 넣으면 되나요
입력 한도 안에 들어가는 것과 모든 변경을 찾는 것은 별개의 검수 항목입니다. 출력 여유·도구의 실제 입력 처리·과금량을 확인하고, 일부를 나눠 넣으면 업무 항목과 출처의 연결이 유지되는지 확인하세요. 이 작은 실습의 통과가 긴 원본에서의 정확도를 입증하지는 않습니다.
JSON이 정상으로 나왔으면 검수가 끝난 건가요
아닙니다. 업무 항목이 전부 있는지, 인용문과 위치가 실제 입력에 있는지, 충돌을 임의로 해결하지 않았는지 확인해야 합니다. 구조화 출력은 형식을 맞추는 기능이고 정답 판정은 기대 값과 근거 대조로 합니다.
Gemini 4 Argon이나 상위 모델을 바로 비교하면 더 좋지 않나요
Argon은 공식 발표된 모델입니다. Google의 글로벌·한국 공식 발표는 Fairwind 우선 배포로 설명하며, 기준일 공개 API 목록과 요금표에서 일반 호출 ID를 확인하지 못했습니다. 이번 글은 일반 독자가 재현할 수 있는 Flash를 비교 후보로 택했습니다. Sol·Sonnet·Flash에서 실패한 항목을 확인한 뒤 상위 모델을 추가해 같은 기준으로 시험할 수 있습니다. 아직 직접 비교하지 않은 상위 모델의 정답률을 추정하지 않습니다. Google Argon 글로벌 발표, 한국 공식 배포 안내, 공개 Gemini API 모델 목록
오늘의 정리
문서 두 버전을 비교할 때는 번호가 아니라 업무 항목을 먼저 맞추세요. 그다음 변경·이동·삭제·신설·충돌을 나누고 각각의 원문 위치를 남깁니다. 모델 선택은 API 기능과 장문 요금으로 후보를 좁힌 뒤, 같은 자료의 첫 답과 수정까지 포함한 비용으로 확인하는 것이 좋습니다.
작성자 소개
