pandas.read_html로 표 하나를 골라 Excel로 저장하고 30,500 검산하기
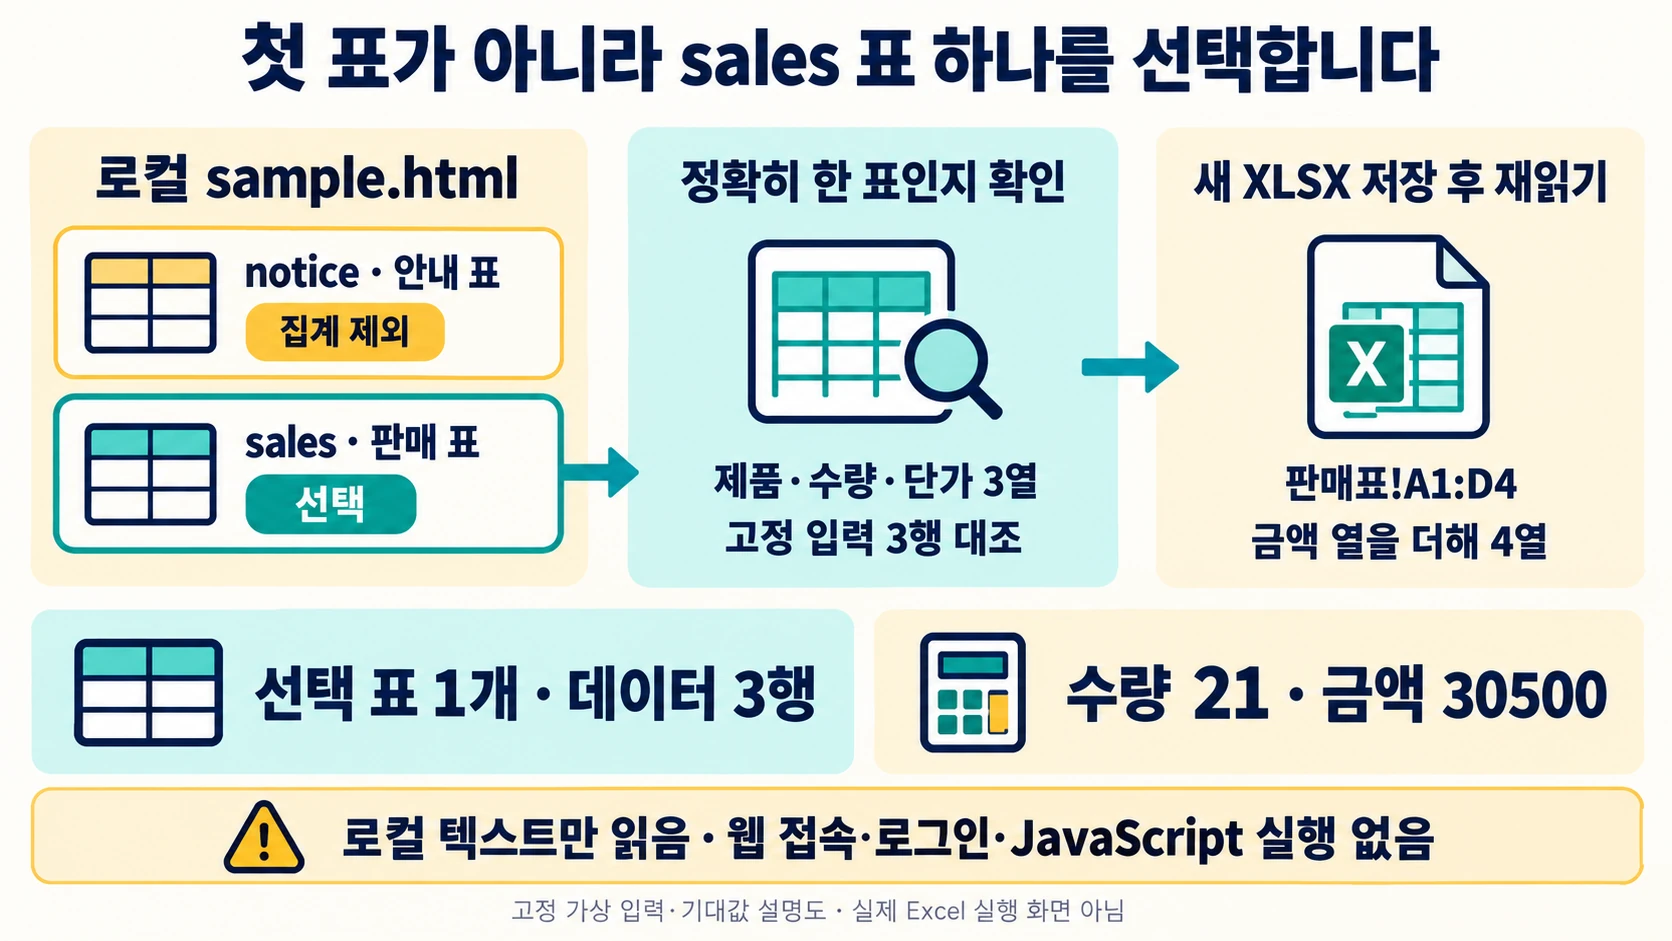
웹 페이지에서 첫 번째 표를 바로 저장하면 안내 문구를 데이터로 착각할 수 있습니다. 이 실습에서는 안내 표와 판매 표를 함께 둔 HTML 파일을 직접 제공하고 id="sales"인 표만 선택합니다. 인터넷 주소를 읽지 않으므로 사이트 변경이나 접속 상태와 무관하게 선택·계산·저장 과정을 확인할 수 있습니다.
준비: 표 두 개가 있는 HTML
sample.html을 아래 내용 그대로 저장합니다. 제품 A·B·C는 가상 품목입니다. Python과 pandas, lxml, openpyxl이 필요한 예제이며 실제 사용 환경은 첨부의 verification.json에 기록했습니다. 다른 환경에서의 동일 동작은 별도 확인 대상입니다.
<!doctype html>
<html lang="ko"><meta charset="utf-8"><title>가상 판매 표 실습</title>
<body>
<table id="notice"><tr><th>안내</th></tr><tr><td>이 표는 집계 대상이 아닙니다.</td></tr></table>
<table id="sales">
<thead><tr><th>제품</th><th>수량</th><th>단가</th></tr></thead>
<tbody>
<tr><td>A</td><td>10</td><td>1200</td></tr>
<tr><td>B</td><td>7</td><td>1500</td></tr>
<tr><td>C</td><td>4</td><td>2000</td></tr>
</tbody></table>
</body></html>
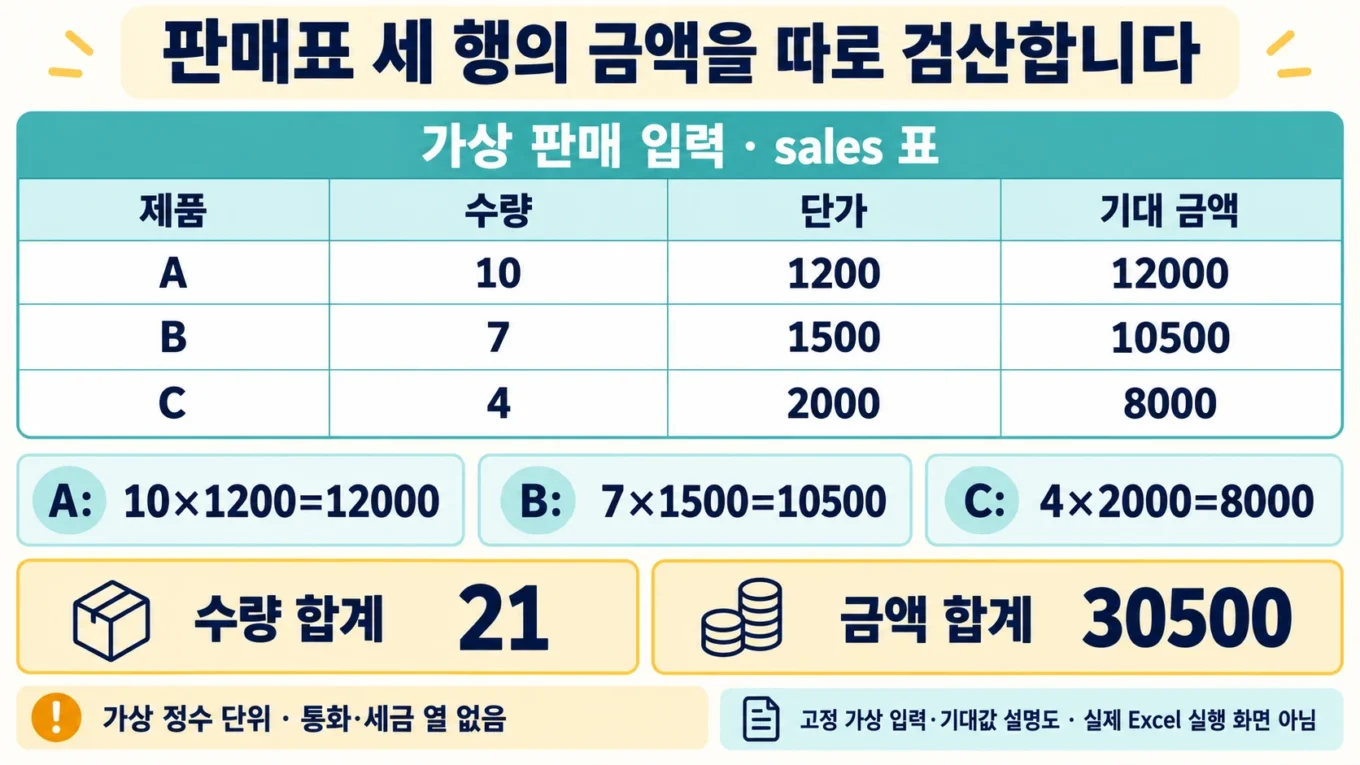
A는 10×1200=12000, B는 7×1500=10500, C는 4×2000=8000입니다. 수량 합계 21과 금액 합계 30500을 독립 계산 기준으로 둡니다. 통화나 세금 열은 없고 단가와 금액은 가상 정수 단위입니다.
전체 코드: 표 선택과 엄격한 비교
pandas.read_html()은 HTML 표를 DataFrame 목록으로 읽습니다. 따라서 반환값에 표가 정확히 하나 있는지 먼저 확인합니다. StringIO에는 로컬에서 읽은 텍스트만 전달합니다. ID가 같은 판매 표가 두 개이면 어느 쪽을 쓸지 추측하지 않습니다. pandas.read_excel()은 Excel 파일을 DataFrame으로 읽습니다. 저장 후에는 그 함수로 다시 읽은 행이 미리 계산한 세 행과 같은지 비교합니다.
import argparse
import io
import json
from pathlib import Path
import pandas as pd
from openpyxl import load_workbook
from openpyxl.styles import Font, PatternFill

EXPECTED = [
    {'제품': 'A', '수량': 10, '단가': 1200, '금액': 12000},
    {'제품': 'B', '수량': 7, '단가': 1500, '금액': 10500},
    {'제품': 'C', '수량': 4, '단가': 2000, '금액': 8000},
]

def parse_fixture(source):
    with Path(source).open('rb') as handle:
        raw = handle.read(1_000_001)
    if len(raw) > 1_000_000:
        raise ValueError('Practice HTML exceeds 1 MB.')
    # StringIO supplies local text. No URL is passed to pandas.
    tables = pd.read_html(io.StringIO(raw.decode('utf-8')),
                          attrs={'id': 'sales'}, header=0,
                          flavor='lxml', keep_default_na=False)
    if len(tables) != 1:
        raise ValueError('Expected exactly one table with id=sales.')
    frame = tables[0]
    if list(frame.columns) != ['제품', '수량', '단가'] or len(frame) != 3:
        raise ValueError('Fixture header or row count differs.')
    for name in ['수량', '단가']:
        frame[name] = pd.to_numeric(frame[name], errors='raise')
    frame['금액'] = frame['수량'] * frame['단가']
    # This is a locked regression fixture, not an arbitrary commerce importer.
    if frame.to_dict('records') != EXPECTED:
        raise ValueError('Fixture values differ from the independently calculated rows.')
    return frame

def convert(source, target):
    target = Path(target)
    if target.suffix.lower() != '.xlsx':
        raise ValueError('Use a NEW .xlsx filename.')
    frame = parse_fixture(source)
    # Author to memory; reserve the destination only after validation.
    buffer = io.BytesIO()
    frame.to_excel(buffer, sheet_name='판매표', index=False, engine='openpyxl')
    buffer.seek(0)
    wb = load_workbook(buffer)
    ws = wb['판매표']
    for cell in ws[1]:
        cell.font = Font(name='Arial', bold=True, color='FFFFFF')
        cell.fill = PatternFill('solid', fgColor='17365D')
    for letter in 'ABCD':
        ws.column_dimensions[letter].width = 16
    for row in ws.iter_rows(min_row=2, min_col=2):
        for cell in row:
            cell.number_format = '#,##0'
    ws.freeze_panes = 'A2'
    ws.auto_filter.ref = ws.dimensions
    with target.open('xb') as handle:
        wb.save(handle)
    check = pd.read_excel(target, sheet_name='판매표', engine='openpyxl', keep_default_na=False)
    if check.to_dict('records') != EXPECTED:
        raise RuntimeError('Readback differs; keep output for inspection.')
    return {'selected_tables': 1, 'rows': 3, 'columns': 4,
            'quantity_sum': int(frame['수량'].sum()),
            'amount_sum': int(frame['금액'].sum()), 'readback_equal': True}

def main():
    parser = argparse.ArgumentParser()
    parser.add_argument('--input', default='sample.html')
    parser.add_argument('--out', default='web_table_result.xlsx')
    args = parser.parse_args()
    print(json.dumps(convert(args.input, args.out)))

if __name__ == '__main__':
    main()
실행과 예상 결과
python3 read_html_check.py
python3 -m unittest -v test_example.py
새 파일 web_table_result.xlsx의 판매표 시트에는 아래 A1:D4가 들어갑니다. 안내 표는 결과에 없어야 합니다.
| 제품 | 수량 | 단가 | 금액 |
|---|---|---|---|
| A | 10 | 1200 | 12000 |
| B | 7 | 1500 | 10500 |
| C | 4 | 2000 | 8000 |
JSON 결과는 selected_tables=1, rows=3, columns=4, quantity_sum=21, amount_sum=30500, readback_equal=true입니다. 실제 Python 실행과 저장값 재읽기, 테스트 5개로 확인했습니다. Excel 앱을 실행해 계산한 결과는 아니며 금액 셀은 Python에서 계산한 값입니다.
입력이 바뀌면 중단하는 이유
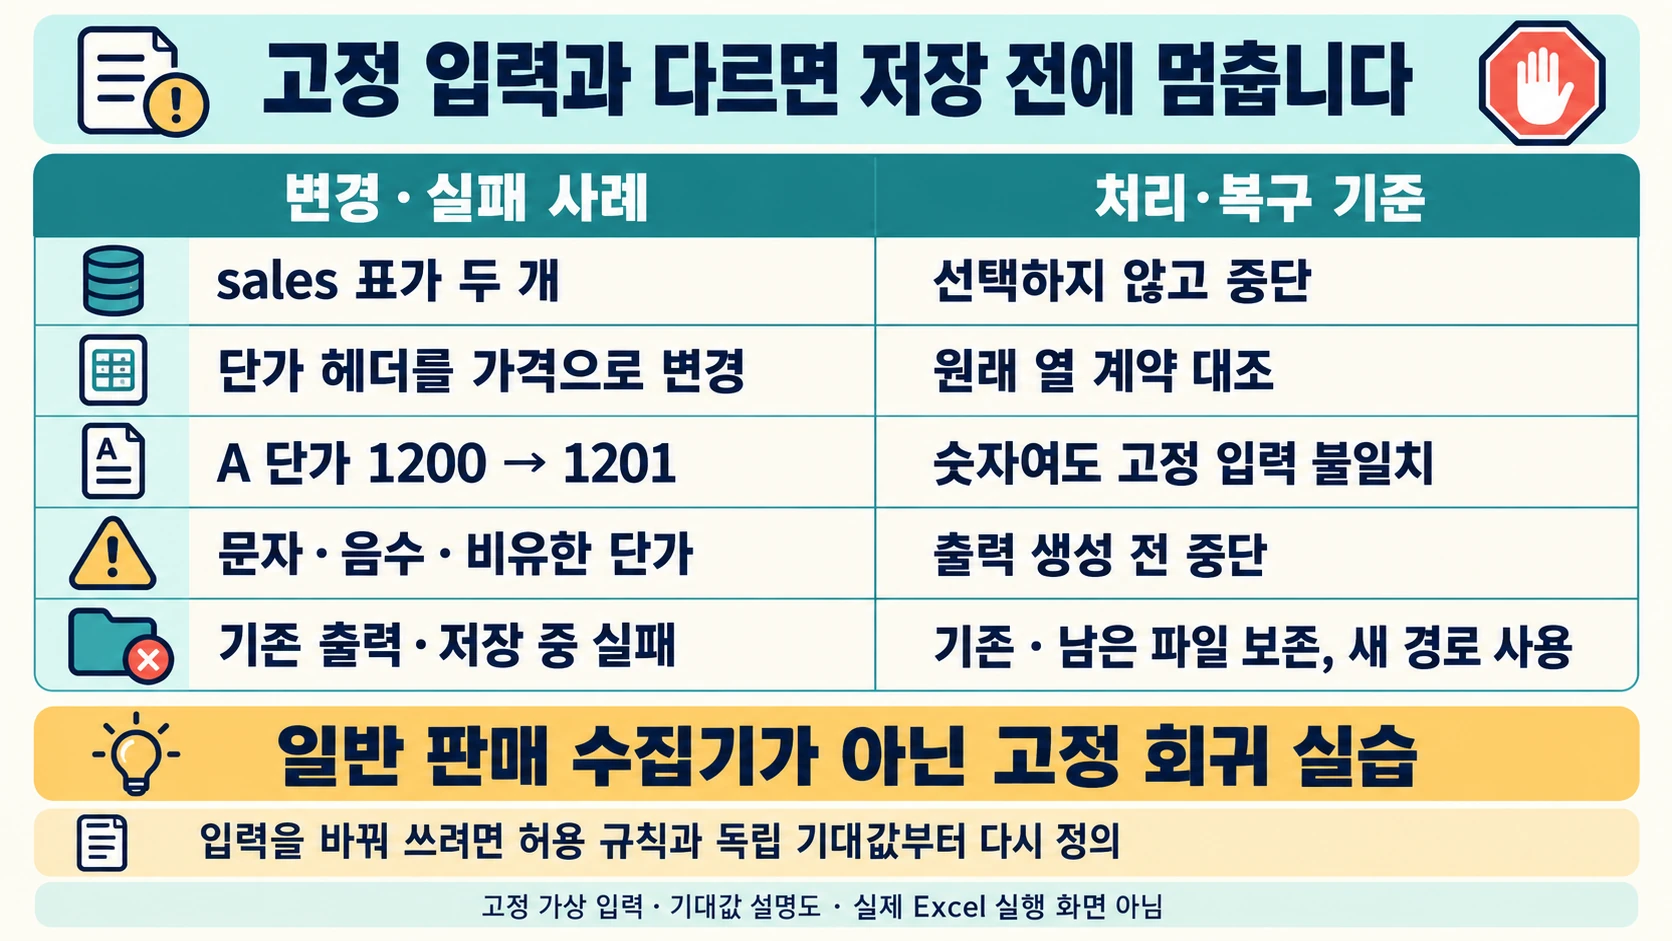
단가 헤더를 다른 이름으로 바꾸면 열 계약이 달라져 중단합니다. A 단가를 1201로 바꾸면 숫자로는 정상이어도 이 고정 자료와 다른 입력이므로 중단합니다. 이것은 판매 데이터 일반 수집기가 아니라 표 선택과 저장을 확인하는 회귀 실습이기 때문입니다. 실제 데이터용으로 확장할 때는 허용 열과 값 규칙, 비교 기준을 다시 정해야 합니다.
중복 sales 표, 숫자 아닌 단가, 음수나 비유한 값의 변형을 테스트했고 출력이 만들어지지 않는지 확인했습니다. 기존 출력 파일은 xb로 보호합니다. 결과를 남겨둔 채 다시 확인하려면 --out second_result.xlsx를 사용하세요. 실패 파일을 덮어써 원인을 없애지 않습니다.
한계: HTML과 동적 페이지는 다르다
브라우저 로그인이나 JavaScript 실행, 페이지 넘김은 이 예제에 없습니다. 파일에 완성된 HTML 표가 들어 있다는 전제입니다. 머리글 병합, 소수 금액, 여러 통화, 누락 행을 자동 보정하지 않습니다. 다운로드의 비교용 XLSX와 입력 HTML을 함께 보면서 선택된 셀만 확인하면 되는 범위로 좁혔습니다.
실행 순서 정리
-
sample.html의 두 표와 sales ID를 확인하고 read_html_check.py를 같은 폴더에 저장합니다.
-
python3 read_html_check.py를 실행해 새 web_table_result.xlsx를 생성합니다.
-
판매표 A1:D4와 금액 합계 30500을 비교하고 test_example.py로 중복 표와 변경값 거부를 확인합니다.
예제 흐름 그림

공식 자료
pandas.read_html — pandas 3.0.6 documentation
pandas.read_excel — pandas 3.0.6 documentation
출처 원문 수집일: S1 2026-09-24; S2 2026-09-24.
작성자 소개
