여러 엑셀 파일을 pandas로 합치고 결과를 검산하는 방법
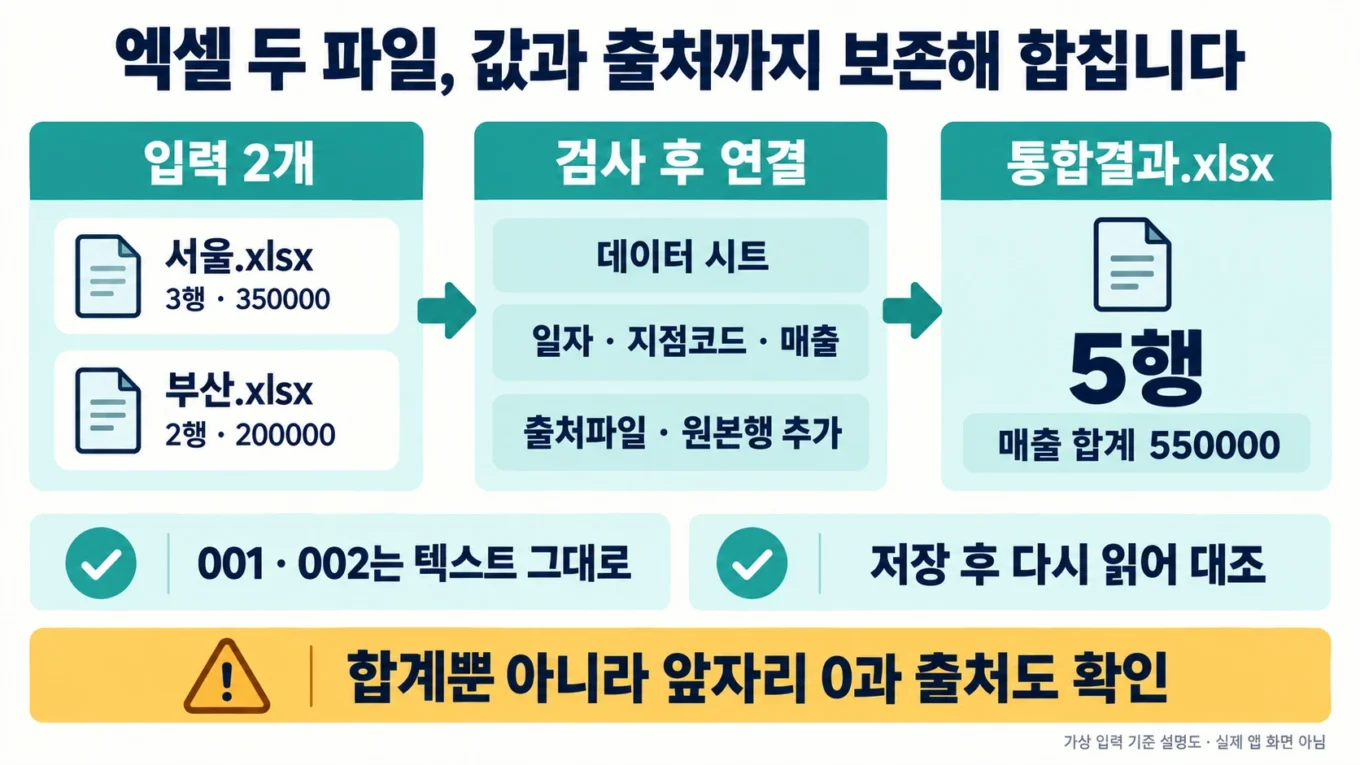
서로 다른 지점의 파일을 합친 뒤 합계만 맞으면 충분할까요? 지점코드 001이 1로 바뀌거나 한 파일의 열 순서가 다르면 합계가 같아도 사용하기 어려운 결과가 됩니다. 여기서는 데이터 시트의 세 열을 검사하고 출처 파일과 원본 행을 붙인 통합결과.xlsx를 만듭니다.
서울·부산 입력은 실제 매출이 아닌 가상 값입니다. Python 3.12.14에서 첨부 코드를 실행해 저장 후 재읽기까지 확인했습니다. “30개를 1초” 같은 속도 측정이나 Microsoft Excel 앱 실행은 하지 않았습니다.
입력 두 파일에서 보존할 것
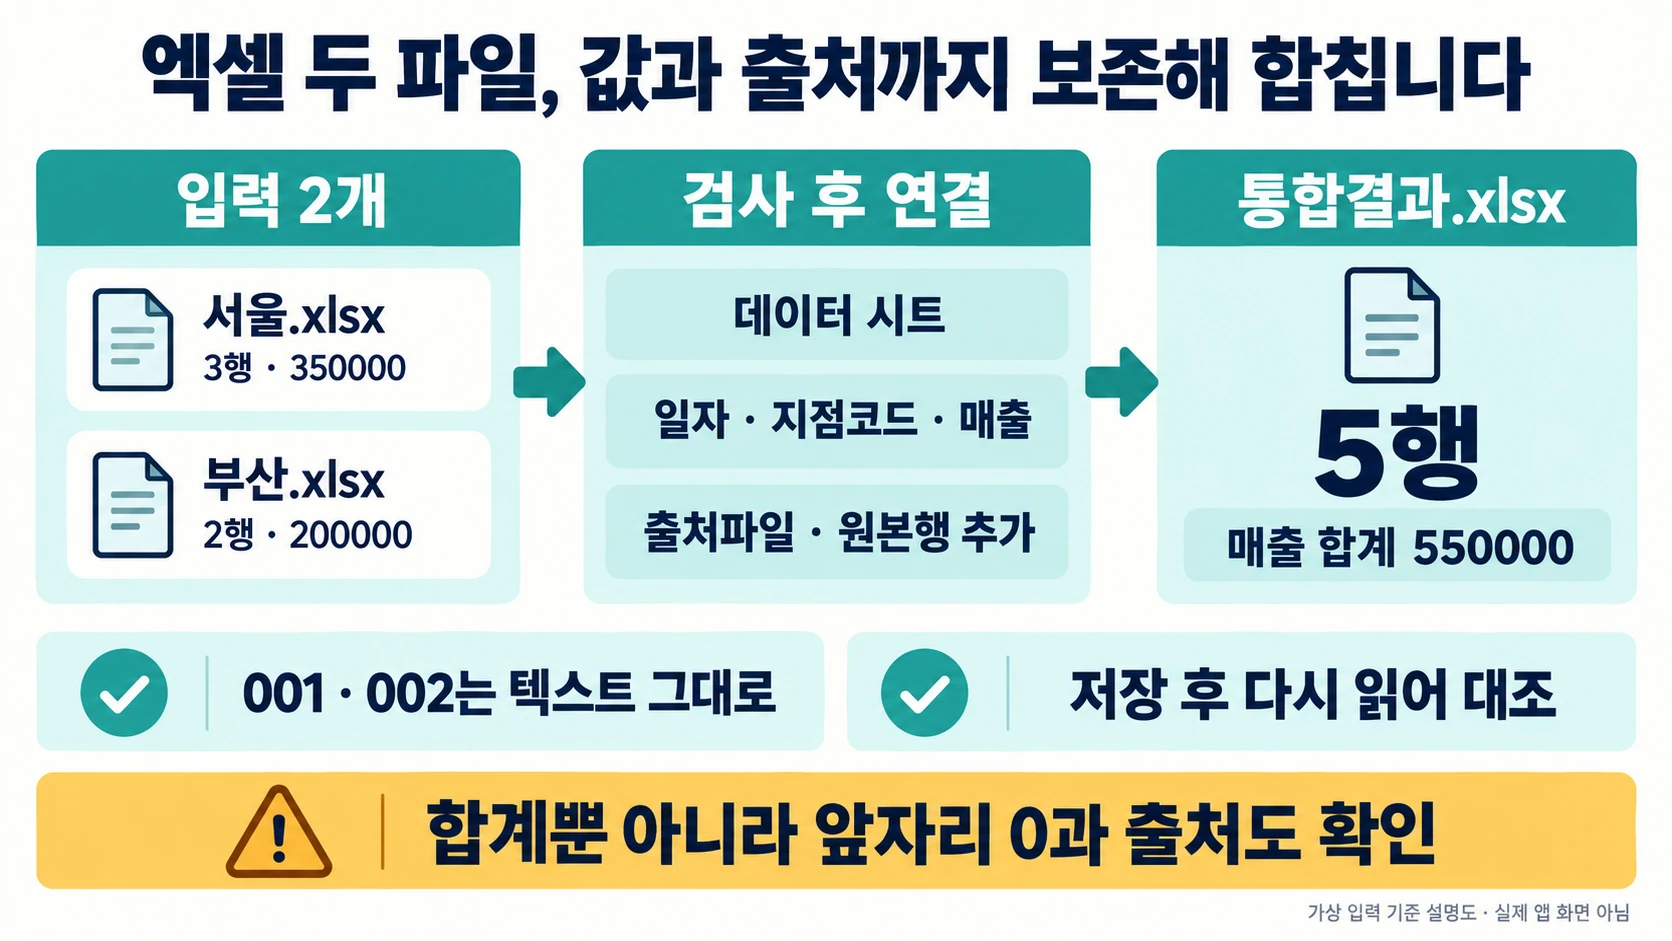
| 파일 | 일자 | 지점코드(텍스트) | 매출(정수) |
|---|---|---|---|
| 서울.xlsx | 2026-08-01 | 001 | 120000 |
| 서울.xlsx | 2026-08-02 | 001 | 80000 |
| 서울.xlsx | 2026-08-03 | 002 | 150000 |
| 부산.xlsx | 2026-08-01 | 101 | 90000 |
| 부산.xlsx | 2026-08-02 | 101 | 110000 |
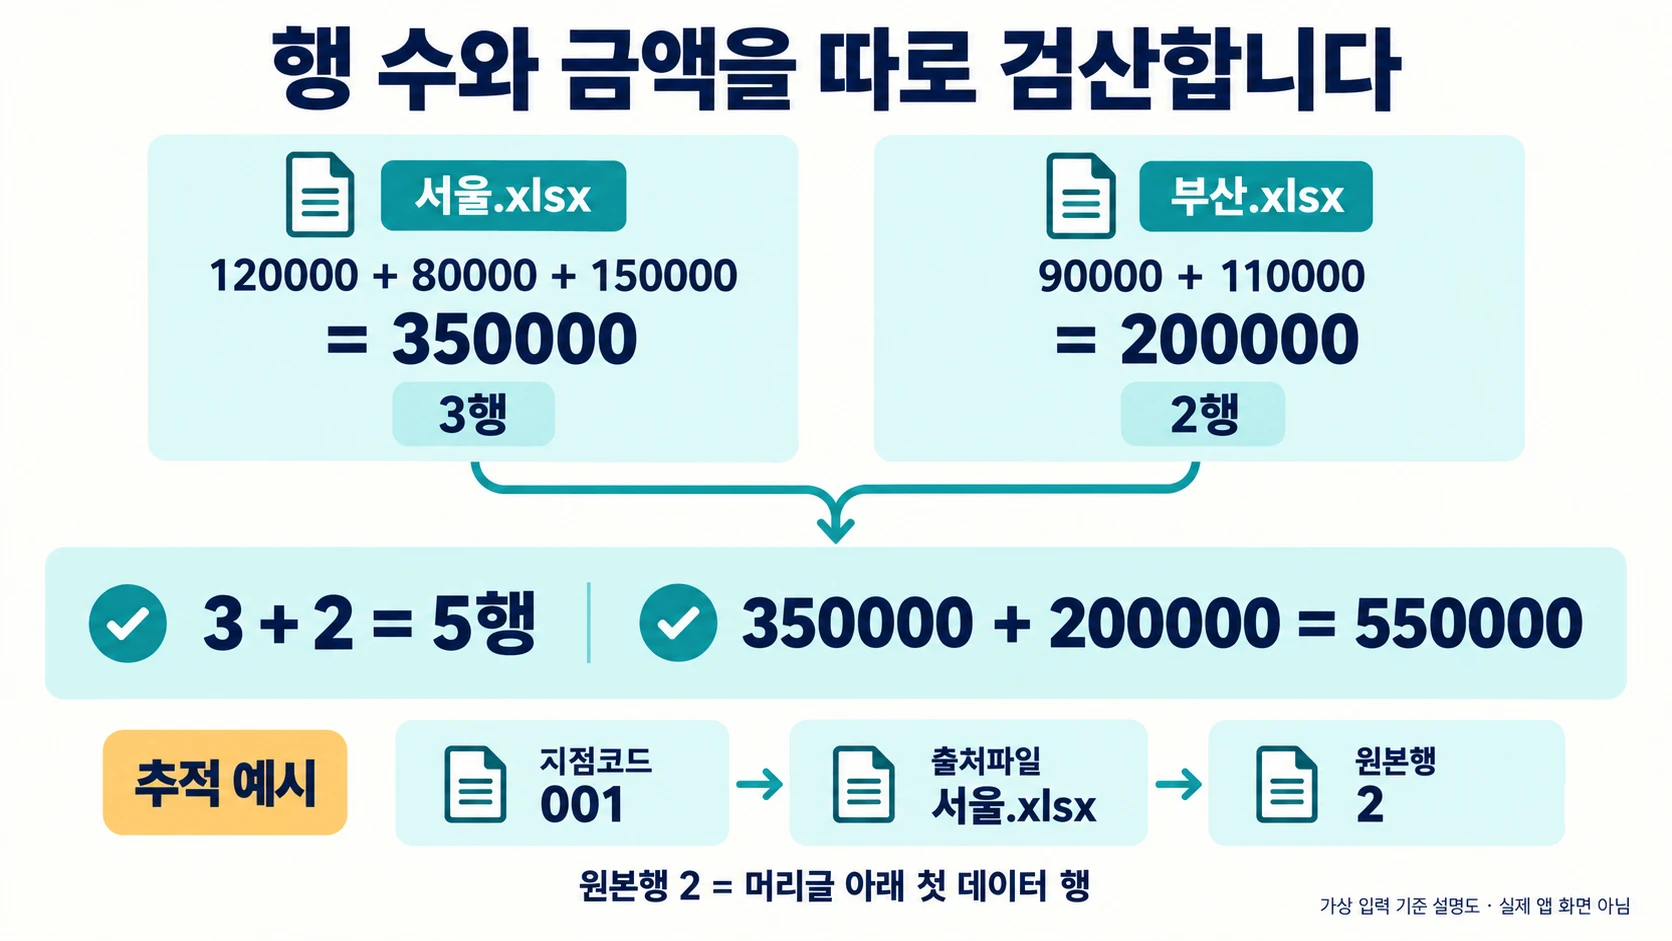
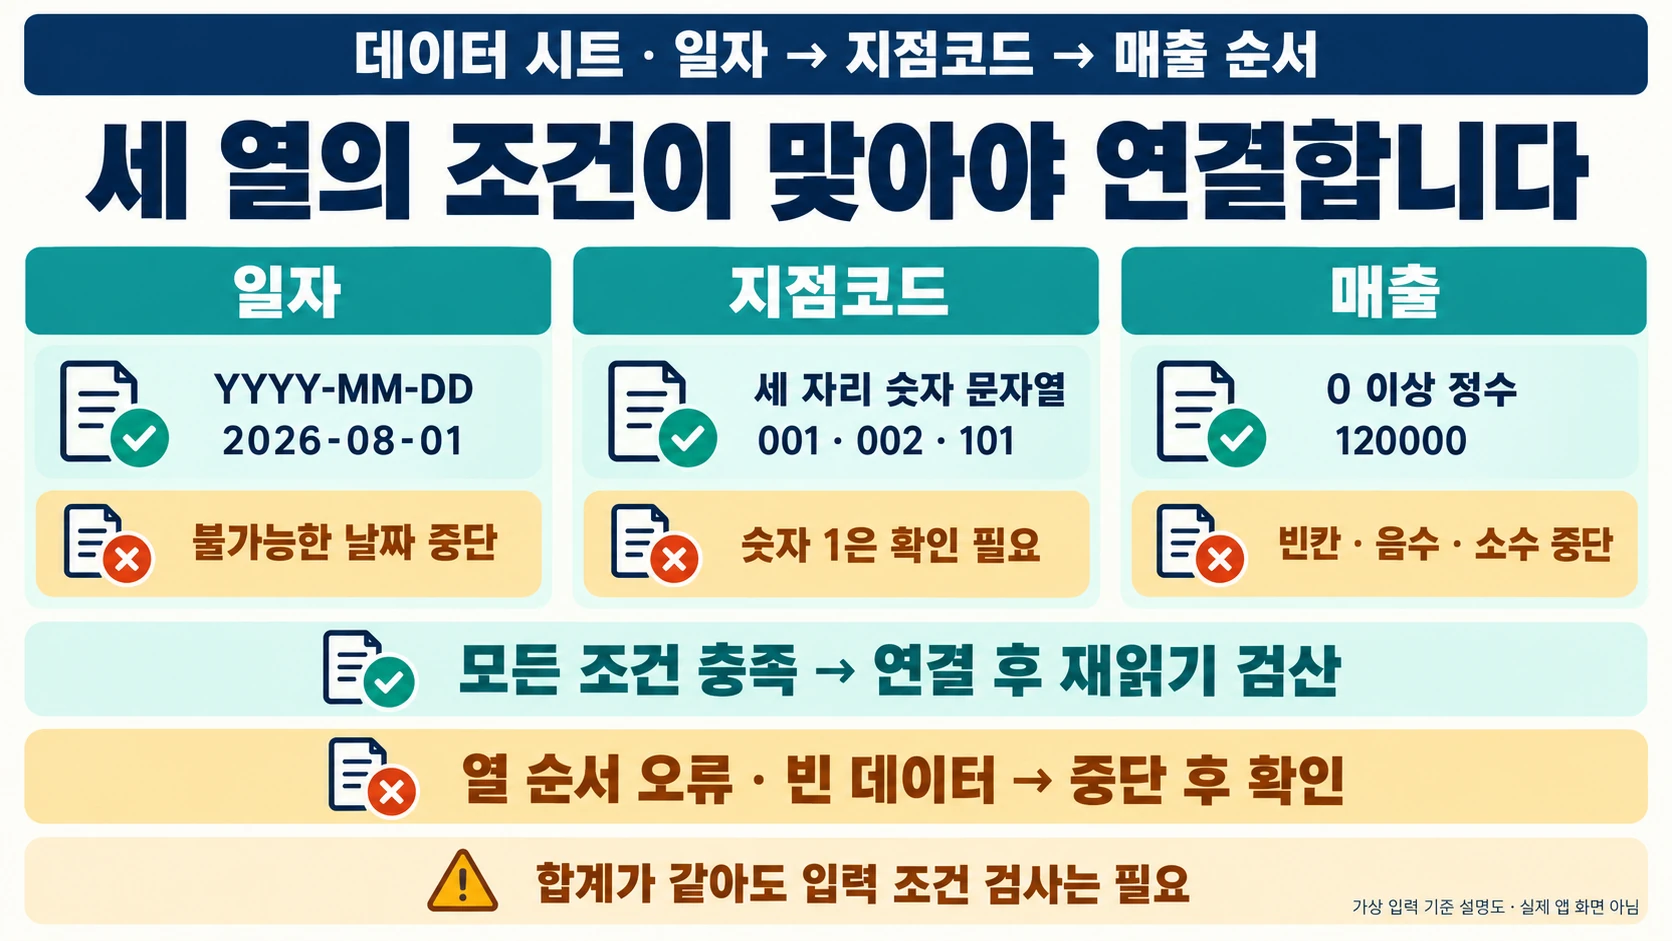
완료 조건은 입력 2개, 결과 5행, 매출 합계 550000입니다. 출력 열은 일자·지점코드·매출·출처파일·원본행 순서입니다. 001과 002는 계산할 숫자가 아니라 식별자이므로 문자열로 보존합니다. 원본행 2는 머리글 아래 첫 데이터 행을 뜻합니다.
pandas.read_excel은 Excel 파일을 DataFrame으로 읽습니다. pandas.concat은 지정한 축을 따라 pandas 객체들을 연결합니다. 이 예제는 읽기 단계에서 문자열로 받아 각 열을 검증하고, 매출 열만 정수로 바꾼 뒤 연결합니다.
준비와 실행 순서
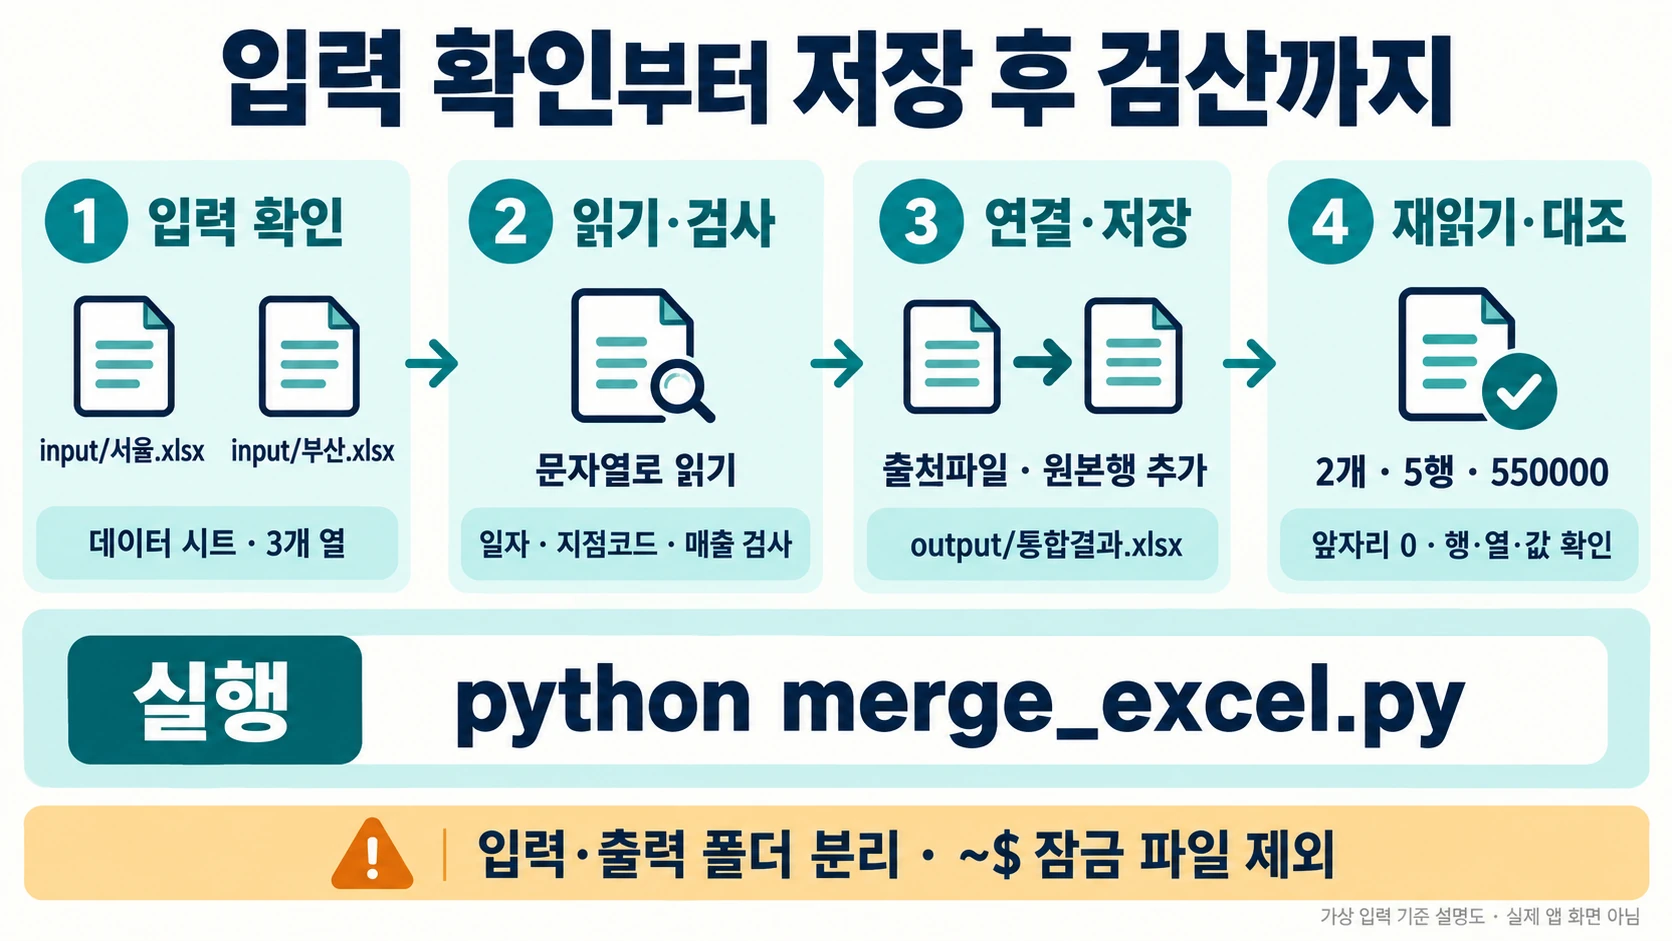
첨부 ZIP을 빈 폴더에 풀고 그 폴더를 터미널의 작업 위치로 사용합니다. Python 3.12.14와 pandas·openpyxl이 필요합니다. 패키지 설치는 별도 준비 과정이며 아래 코드 실행에는 인터넷이 필요하지 않습니다.
-
ZIP의
input/서울.xlsx,input/부산.xlsx와 위 표를 대조합니다. 제공된 입력이 있으므로make_sample.py를 다시 실행할 필요는 없습니다. -
python merge_excel.py를 실행합니다. -
콘솔의
files: 2,rows: 5,sales_sum: 550000을 확인합니다. -
output/통합결과.xlsx에서 지점코드의 앞자리 0과 출처파일·원본행 열을 확인합니다. -
재실행할 때는
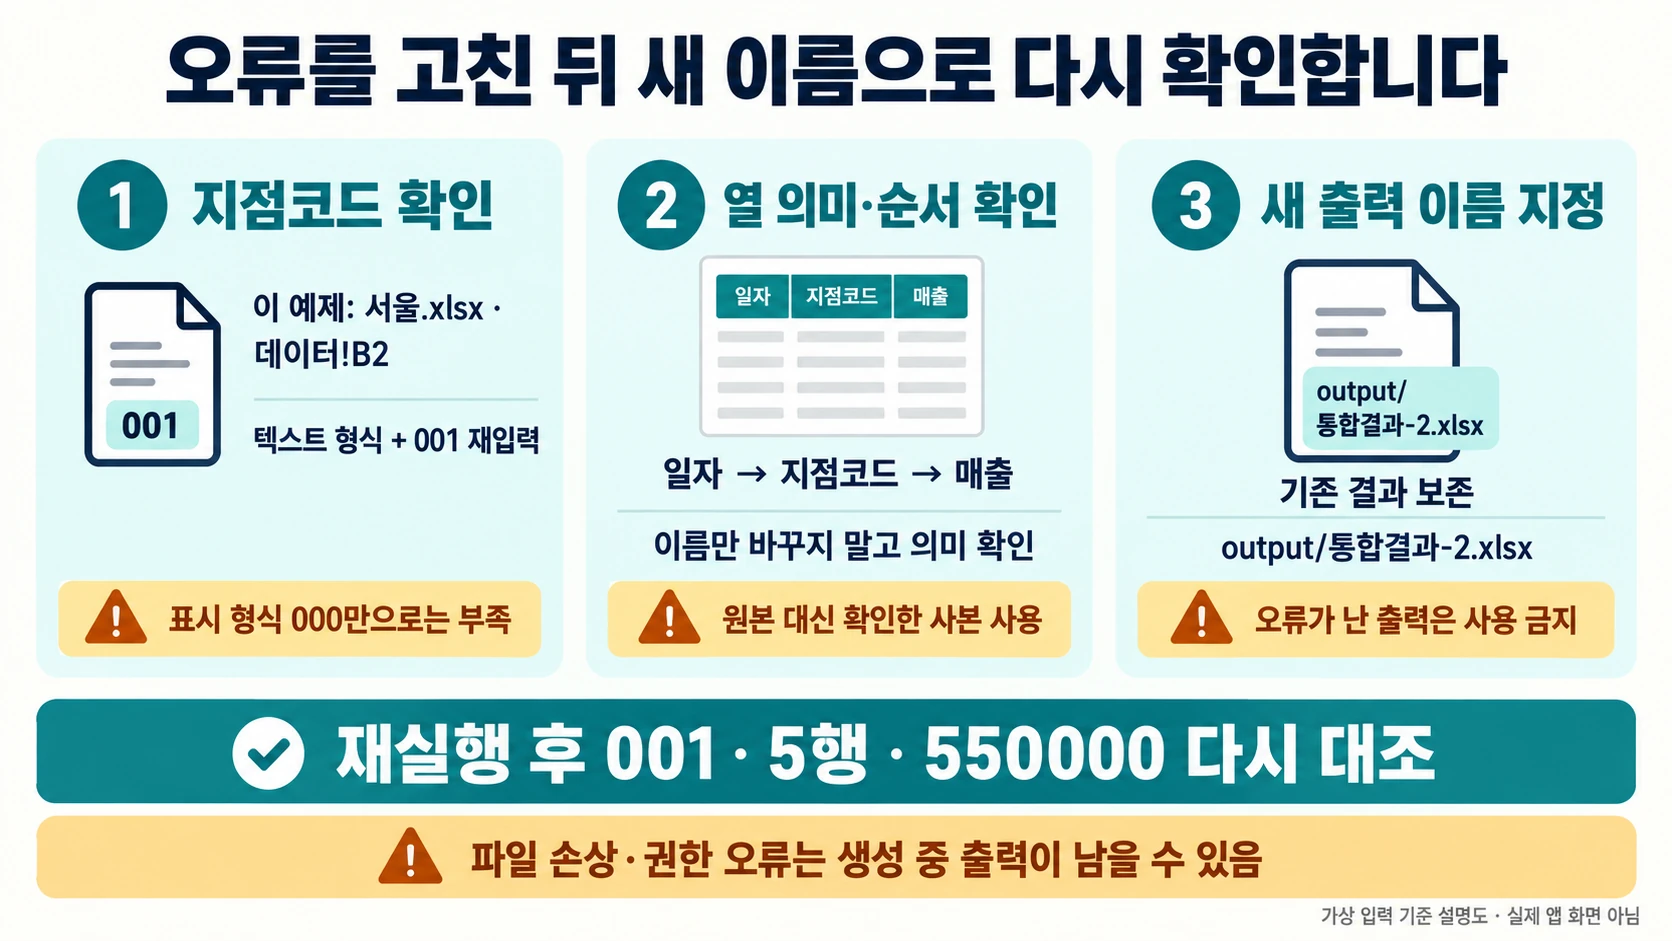
python merge_excel.py --output output/통합결과-2.xlsx처럼 새 이름을 지정합니다.
ZIP과 동일한 전체 병합 코드
merge_excel.py입니다. .xlsx 파일을 이름 순으로 읽으며 Excel 잠금 파일의 ~$ 접두어는 제외합니다. 입력과 출력 폴더를 분리하므로 이전 결과를 다음 입력으로 다시 읽지 않습니다.
from pathlib import Path
from datetime import date
import argparse
import re
import pandas as pd

COLUMNS = ["일자", "지점코드", "매출"]

def merge(input_dir, output):
    input_dir, output = Path(input_dir).resolve(), Path(output).resolve()
    if output.parent == input_dir:
        raise ValueError("결과는 입력 폴더 밖에 저장하세요")
    if output.exists():
        raise FileExistsError("기존 결과 보존: 새 출력 이름을 지정하세요")
    files = sorted(p for p in input_dir.glob("*.xlsx")
                   if not p.name.startswith("~$") and p.is_file())
    if not files:
        raise ValueError("입력 .xlsx 파일이 없습니다")
    frames = []
    for path in files:
        frame = pd.read_excel(path, sheet_name="데이터", dtype=str, keep_default_na=False)
        if list(frame.columns) != COLUMNS or frame.empty:
            raise ValueError(f"{path.name}: 열 순서/빈 데이터 확인")
        for row_number, row in enumerate(frame.itertuples(index=False, name=None), 2):
            day, branch, sales = row
            if date.fromisoformat(day).isoformat() != day:
                raise ValueError(f"{path.name}:{row_number} 날짜 형식 오류")
            if not re.fullmatch(r"[0-9]{3}", branch):
                raise ValueError(f"{path.name}:{row_number} 지점코드는 세 자리 문자열")
            if not re.fullmatch(r"[0-9]+", sales):
                raise ValueError(f"{path.name}:{row_number} 매출은 0 이상 정수")
        frame["매출"] = frame["매출"].map(int)
        frame["출처파일"] = path.name
        frame["원본행"] = range(2, len(frame) + 2)
        frames.append(frame)
    result = pd.concat(frames, ignore_index=True)
    output.parent.mkdir(parents=True, exist_ok=True)
    with output.open("xb") as stream:
        with pd.ExcelWriter(stream, engine="openpyxl") as writer:
            result.to_excel(writer, index=False, sheet_name="통합")
            sheet = writer.sheets["통합"]
            for column, width in {"A": 16, "B": 14, "C": 16, "D": 20, "E": 12}.items():
                sheet.column_dimensions[column].width = width
            for cell in sheet["B"][1:]:
                cell.number_format = "@"
    saved = pd.read_excel(output, sheet_name="통합", dtype={"지점코드": str})
    pd.testing.assert_frame_equal(saved, result, check_dtype=False)
    return {"files": len(files), "rows": len(result), "sales_sum": int(result["매출"].sum())}

if __name__ == "__main__":
    parser = argparse.ArgumentParser()
    parser.add_argument("--input", default="input")
    parser.add_argument("--output", default="output/통합결과.xlsx")
    args = parser.parse_args()
    print(merge(args.input, args.output))
입력을 새로 생성할 때
다음은 ZIP의 make_sample.py입니다. ZIP에 들어 있는 fixture.json의 값이 위 표와 같습니다. 별도 빈 사본 폴더에서 실행해야 하며, 이미 같은 파일이 있으면 덮어쓰지 않고 중단합니다.
import json
from pathlib import Path
import pandas as pd

base = Path(__file__).resolve().parent
samples = json.loads((base / "fixture.json").read_text(encoding="utf-8"))
folder = base / "input"
folder.mkdir(exist_ok=True)
for name, rows in samples.items():
    with (folder / name).open("xb") as stream:
        with pd.ExcelWriter(stream, engine="openpyxl") as writer:
            pd.DataFrame(rows, columns=["일자", "지점코드", "매출"]).to_excel(
                writer, sheet_name="데이터", index=False)
            sheet = writer.sheets["데이터"]
            for column in ("A", "B", "C"):
                sheet.column_dimensions[column].width = 18
            for cell in sheet["B"][1:]:
                cell.number_format = "@"
print("created 2 synthetic input files")
행 수와 금액을 독립적으로 검산하기
서울은 120000+80000+150000=350000, 부산은 90000+110000=200000입니다. 두 합계의 합은 550000이고 행 수는 3+2=5입니다. 본문 표의 계산과 스크립트 출력이 일치해야 합니다. 저장한 결과를 다시 읽어 메모리의 결과와 행·열·값을 비교하는 검사도 코드에 포함되어 있습니다.
ZIP의 python -m unittest -v test_example.py는 5개 테스트를 실행합니다. 성공 데이터뿐 아니라 잘못된 금액·불가능한 날짜·열 이름 변경·기존 출력 파일·잠금 파일을 확인합니다. 잘못된 금액은 빈칸, 음수, 문자열, 소수를 포함하며 출력 파일을 만들기 전에 중단됩니다.
실패했을 때 원본을 고치기 전에 확인할 것
지점코드는 세 자리 문자열 오류가 나면 원본의 셀 값이 이미 숫자 1인지 확인합니다. 화면의 표시 형식만 000인 값은 문자열 001과 다릅니다. 코드가 임의로 앞에 0을 채워 의미를 추측하지 않으므로, 원본 담당자가 식별자를 확인한 사본에서 다시 실행하세요. 이 고정 예제를 복구할 때는 서울.xlsx의 데이터 시트 B2를 텍스트 형식으로 바꾸고 001을 다시 입력한 뒤, 새 결과에서 001이 남는지 대조합니다.
열 순서/빈 데이터 확인은 날짜 열을 일자로 이름만 바꿔 자동으로 해결될 문제가 아닙니다. 열 의미와 순서를 위 계약에 맞추고, 실제 데이터가 없는 파일을 제외할 근거가 있는지 확인합니다. 기존 결과 보존 오류라면 출력 파일을 지우기보다 다른 결과 이름으로 실행해 이전 결과와 대조하세요.
적용 한계
이 코드는 .xlsx의 한 시트와 정확한 세 열에 한정합니다. 매출은 0 이상 정수만 허용하므로 반품 음수·소수 통화가 필요한 작업은 별도 계약이 필요합니다. 중복 거래를 찾아 제거하지 않으며, Excel 수식·서식·병합 셀·매크로를 원본 그대로 보존하는 병합 도구도 아닙니다. 파일 손상이나 권한 오류가 발생하면 생성 도중의 출력이 남을 수 있으므로 오류가 난 파일은 성공 결과로 사용하지 말고 다른 이름으로 재실행합니다.
Python 3.12.14 문서를 참고 자료로 사용했습니다. ZIP에 실행 기록을 함께 넣었습니다.
같은 형식의 파일을 Excel에서 매달 새로 고치며 취합하려면 Power Query 폴더 결합 절차도 비교해 보세요. 원본 파일 수·행 수·합계를 따로 검산하며, 사용 환경에서 메뉴와 새로 고침 결과를 직접 확인하는 절차입니다.
공식 자료
pandas.read_excel — pandas 2.2.3 documentation
pandas.concat — pandas 2.2.3 documentation
pathlib — Object-oriented filesystem paths
출처 원문 수집일: S1 2026-09-23; S2 2026-09-23; S3 2026-09-23.
작성자 소개
