큰 CSV를 나눠 정렬하고 같은 시각의 행 순서까지 검산하기
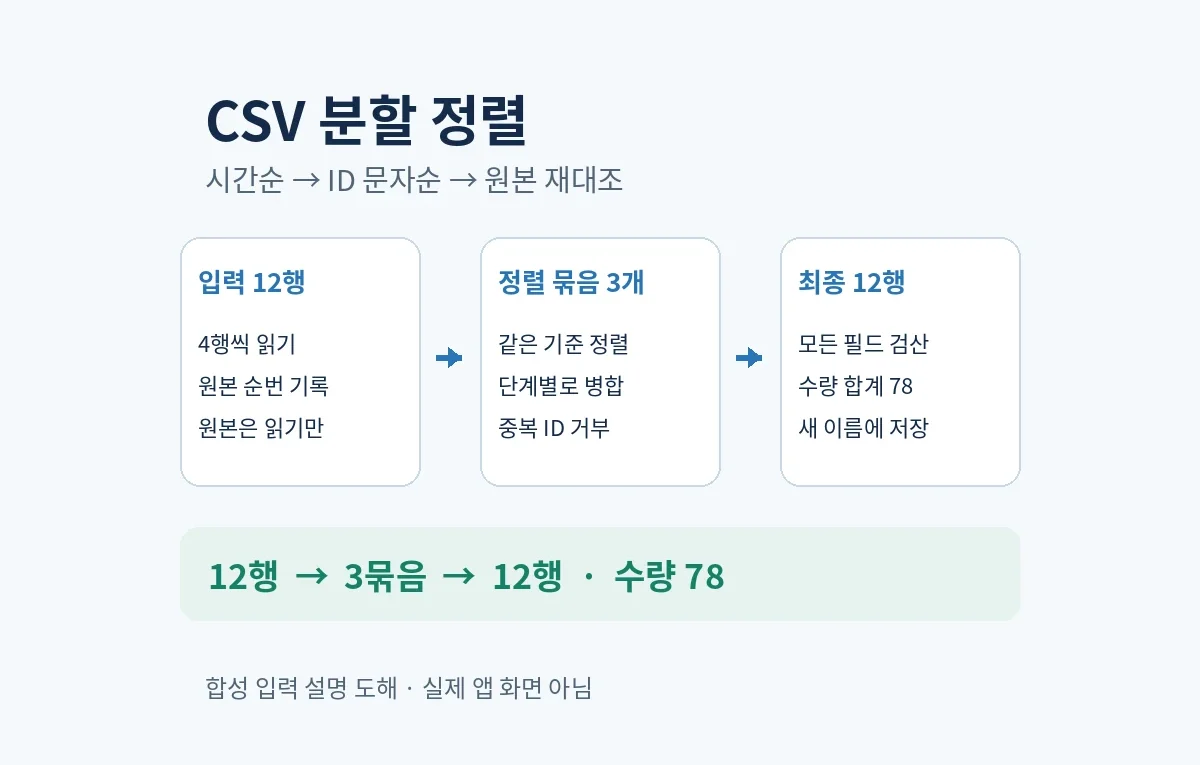
시간순으로 정렬할 CSV가 크다면, 일부 행을 먼저 정렬해 파일로 저장한 뒤 같은 기준으로 합칠 수 있습니다. 여기서는 가상 기록 12행을 4행씩 나눠 정렬하고, 세 묶음을 병합해 한 CSV를 만듭니다. 같은 시각의 행은 ID 문자순으로 놓고, 저장한 결과를 원본과 행별로 다시 대조합니다.
원본의 시간·ID·수량·메모는 유지하고, 어디에서 온 행인지 확인할 source_row만 추가합니다. 실습의 완료 조건은 입력 12행, 출력 12행, 수량 합계 78이며 모든 ID와 메모도 같아야 합니다. 실제 회사 자료를 사용하지 않았고, RAM보다 큰 파일의 성능을 측정한 사례는 아닙니다.
1. 먼저 같은 시각의 순서를 정합니다
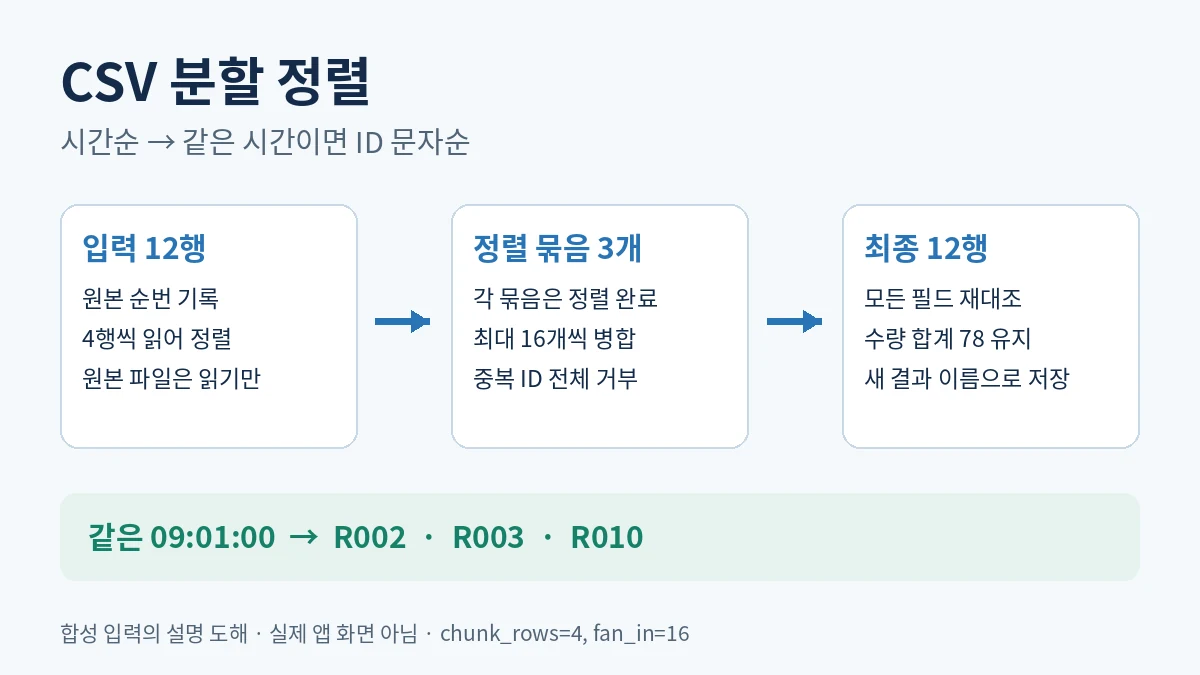
첫 번째 기준은 time 오름차순, 두 번째 기준은 id의 대소문자를 구별하는 문자순입니다. R002·R003·R010의 시간이 모두 09:01:00이면 이 순서로 나옵니다. 숫자처럼 보이는 ID도 숫자로 바꾸지 않으므로 10은 2보다 먼저이고, A는 a보다 먼저입니다. 숫자순이 필요한 업무라면 그 계약을 별도로 설계해야 합니다.
ID는 전체 입력에서 고유해야 합니다. 같은 ID가 서로 다른 묶음이나 다른 시각에 다시 나타나도 DUPLICATE_ID로 중단합니다. 자동으로 한 행을 삭제하거나 수량을 합치지 않습니다. 따라서 같은 시간과 같은 ID의 두 행이 성공 결과에 남을 일은 없습니다.
time은 같은 시간대와 같은 시계 기준의 YYYY-MM-DDTHH:MM:SS 형식입니다. 이번 코드는 시차를 계산하지 않습니다. Z나 UTC 오프셋, 소수초, 2026-9-1 같은 표기는 거부합니다. 서로 다른 시간대의 원본은 먼저 명시한 규칙으로 통일해야 합니다. 고정 길이와 실제 달력 검사를 통과한 이 입력에서 문자열 시간순을 사용합니다.
2. 제공된 12행을 그대로 실행합니다
ZIP을 새 빈 연습 폴더에 풀면 fixtures/events.csv가 있습니다. 헤더 이름과 순서는 time,id,qty,memo입니다. R002의 메모는 두 줄이지만 한 레코드입니다. source_row는 헤더를 제외한 CSV 레코드 순번이며, 텍스트 편집기의 물리적인 줄 번호와 다를 수 있습니다.
time,id,qty,memo
2026-09-01T09:03:00,R009,9,가상 메모 9
2026-09-01T09:01:00,R010,10,"쉼표, 메모"
2026-09-01T09:01:00,R002,2,"두 줄
메모"
2026-09-01T09:02:00,R006,6,가상 메모 6
2026-09-01T09:00:00,R001,1,가상 메모 1
2026-09-01T09:04:00,R012,12,가상 메모 12
2026-09-01T09:02:00,R004,4,가상 메모 4
2026-09-01T09:01:00,R003,3,가상 메모 3
2026-09-01T09:04:00,R011,11,가상 메모 11
2026-09-01T09:02:00,R005,5,가상 메모 5
2026-09-01T09:03:00,R008,8,가상 메모 8
2026-09-01T09:03:00,R007,7,가상 메모 7
입력은 UTF-8 또는 UTF-8 BOM이어야 합니다. ID는 ASCII 영숫자로 시작하는 1~32자이며 영숫자·밑줄·하이픈만 허용합니다. 수량은 0 또는 앞자리 0 없는 1~9자리 비음수 정수입니다. 음수·소수·빈칸·01은 거부합니다. 메모는 10,000자 이하이며 쉼표와 줄바꿈을 CSV 규칙대로 보존합니다. 빈 줄과 열 수가 다른 행도 건너뛰지 않습니다.
하드 링크를 지원하는 쓰기 가능한 로컬 파일시스템에서 실행하세요. 완성한 임시 파일에 새 결과 이름을 붙일 때 os.link를 사용하므로 지원이나 권한이 없으면 HARDLINK 오류로 멈춥니다. 동기화 폴더·네트워크 공유·다른 프로그램이 쓰는 입력은 이번 연습에서 피하세요. 실패하면 원본을 보존하고, 하드 링크를 지원하는 로컬 디스크의 새 연습 폴더와 새 결과 이름으로 다시 실행합니다. 보안 설정을 바꾸거나 덮어쓰기로 우회하지 않습니다.
Python 3.12 표준 라이브러리만 쓰며 별도 패키지 설치나 인터넷 연결은 필요 없습니다. 터미널을 ZIP을 푼 폴더에서 열고 다음 명령을 차례로 실행합니다. output이 이미 있다면 기존 내용부터 확인하고 새 연습 폴더에서 시작하세요.
python3 --version
mkdir output
python3 external_sort.py fixtures/events.csv output/sorted.csv --chunk-rows 4 --fan-in 16
python3 verify_practice.py
python3 -m unittest test_external_sort -v
python3가 없는 환경은 설치된 Python 3.12 실행 명령으로 바꿔야 합니다. Windows의 py -3.12 사용 가능 여부는 해당 환경에서 확인하세요. 실제 검산은 Linux 클라우드에서 수행했으며 Windows 터미널·UI나 Excel 재열기는 실기기로 시험하지 않았습니다.
3. 나눈 파일을 그대로 이어 붙이면 정렬되지 않습니다
각 묶음 안에서만 정렬한 뒤 첫 파일·두 번째 파일·세 번째 파일 순서로 이어 붙이면, 두 번째 묶음의 R001(09:00:00)이 첫 번째 묶음 뒤에 놓입니다. 이 실습은 각 묶음에서 다음으로 작은 행을 골라 병합합니다. Python의 heapq.merge 문서도 입력들이 이미 정렬되어 있어야 한다고 설명합니다. 원본을 바로 merge에 넘기지 않는 이유입니다.
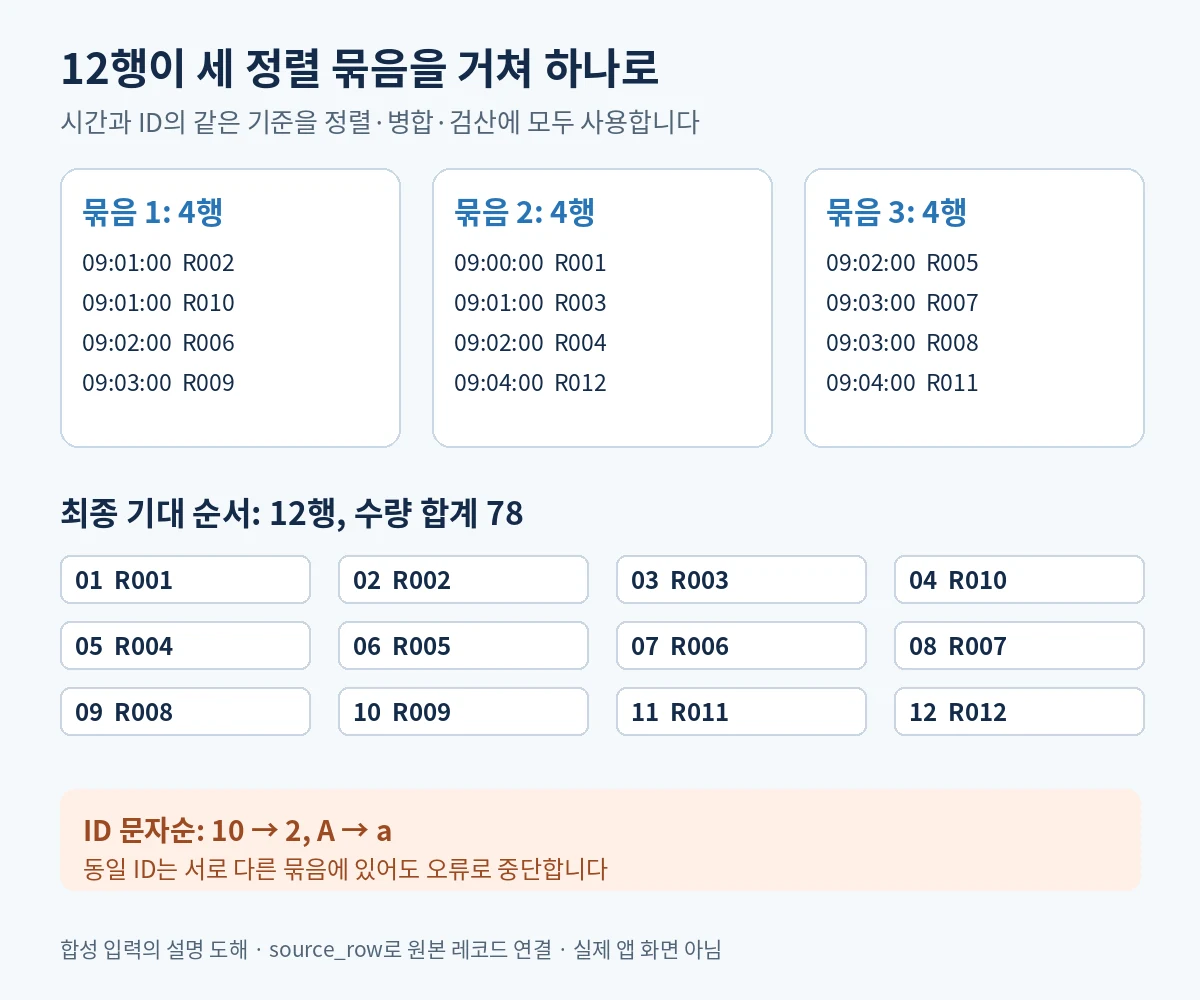
chunk_rows는 한 번에 정렬할 행 수입니다. fan_in은 한 병합에서 읽을 입력 스트림 수이며 이 코드는 2~64로 제한합니다. 묶음이 fan_in보다 많으면 여러 단계로 나눠 병합합니다. 한 번에 모든 파일을 열지 않고, 원본 전체 행을 Python 목록 하나에 쌓지 않습니다. 다만 행 수 제한은 메모리 바이트 상한과 다릅니다. 메모 길이, CSV 파서, SQLite 캐시도 메모리를 사용합니다.
ID 중복과 원본 필드 대조에는 실행마다 만든 임시 SQLite 검사표를 사용합니다. 전체 ID와 모든 메모를 메모리 set이나 dict에 쌓는 대신 디스크에 보관합니다. 이는 업무 데이터베이스에 적재하는 결과물이 아닙니다. 검사 DB와 각 병합 단계의 사본 때문에 임시 디스크는 원본보다 큰 공간이 필요하므로 여유 공간을 확인하고 작은 사본으로 먼저 시험하세요.
4. 행 수가 같아도 원본과 대조해야 합니다
정상 실행의 JSON 출력에서 다음 값을 확인합니다. 전체 실제 출력에는 Python·SQLite 버전과 입력·결과 SHA-256도 있습니다.
{
  "input_rows": 12,
  "output_rows": 12,
  "qty_sum": 78,
  "initial_runs": 3,
  "merge_passes": 1,
  "chunk_rows": 4,
  "fan_in": 16
}
최종 ID 순서는 R001, R002, R003, R010, R004, R005, R006, R007, R008, R009, R011, R012입니다. source_row 순서는 5, 3, 8, 2, 7, 10, 4, 12, 11, 1, 9, 6입니다. expected/sorted.csv와 모든 필드를 비교하면 메모의 줄바꿈과 쉼표도 확인할 수 있습니다.
검산기는 저장한 CSV를 다시 읽고 ID별 source_row·시간·수량·메모가 임시 검사표와 정확히 같은지 확인합니다. 같은 행을 두 번 내보냈는지, 빠진 행은 없는지, 정렬 순서와 전체 수량이 맞는지도 따로 검사합니다. 행 수와 합계만 맞는 잘못된 사본은 통과시키지 않습니다.
verify_practice.py는 임시 연습 폴더에서 9개 CLI 사례를 실행합니다. 묶음 크기와 병합 수를 4/16, 1/2, 5/3, 12/16으로 바꿔도 정상 CSV 바이트가 모두 같았고, 제공한 입력 파일의 SHA-256도 실행 전후 같았습니다. unittest는 27개 테스트이며, 19행을 한 행씩 나눠 여러 단계로 병합하는 사례도 포함합니다. 이 결과를 훨씬 큰 파일의 처리 속도나 최대 메모리 보장으로 확대해 해석하지 마세요.
5. 실패 파일과 복구 방법도 실행합니다
duplicate_across_chunks.csv
- 확인할 결과: DUPLICATE_ID, 종료 코드 2. 서로 다른 묶음의 중복도 거부
- 다음 행동: ID가 업무상 고유한지 원본에서 확인. 자동 삭제 금지
bad_time.csv
- 확인할 결과: TIME_CALENDAR, 종료 코드 2. 2026-02-30 거부
- 다음 행동: 원본 기록을 확인하고 별도 수정 사본으로 재실행
bad_qty.csv
- 확인할 결과: QTY, 종료 코드 2. -1 거부
- 다음 행동: 비음수 정수 계약과 실제 업무 값이 맞는지 확인
이미 있는 output/sorted.csv
- 확인할 결과: OUTPUT_EXISTS, 기존 바이트 유지
- 다음 행동: 새 결과 파일 이름 사용
하드 링크 미지원·권한 제한
- 확인할 결과: HARDLINK, 기존 파일을 덮지 않음
- 다음 행동: 지원하는 쓰기 가능한 로컬 디스크의 새 연습 폴더 사용
python3 external_sort.py fixtures/duplicate_across_chunks.csv output/duplicate.csv --chunk-rows 4 --fan-in 2
python3 external_sort.py fixtures/bad_time.csv output/bad-time.csv --chunk-rows 4
python3 external_sort.py fixtures/bad_qty.csv output/bad-qty.csv --chunk-rows 4
위 세 실패에서는 새 최종 파일이 생기지 않았습니다. 기존 결과가 있는 경우의 보존, 병합 중 I/O 오류와 검산 실패, 마지막 순간 다른 프로세스가 결과 이름을 먼저 만든 경우도 테스트했습니다. I/O 오류와 하드 링크 미지원은 실제 디스크를 망가뜨린 시험이 아니라 테스트에서 해당 함수의 예외를 주입한 사례입니다.
6. 최종 저장과 중간 파일의 경계
실행 중 출력 폴더에 .p17-로 시작하는 임시 폴더를 만듭니다. 그 안에서 정렬·병합·재읽기 검산을 끝낸 뒤, 같은 파일시스템에서 os.link로 완성 파일에 새 결과 이름을 연결합니다. 기존 이름은 교체하지 않습니다. 이 코드의 원본은 읽기만 하며, 최종 연결 직전에 입력 SHA-256을 다시 대조합니다.
검증과 최종 연결 전에 오류가 나면 새 최종 파일을 만들지 않습니다. 정상 종료와 이번에 시험한 일반 예외에서는 자신이 만든 임시 폴더만 정리합니다. 강제 종료·전원 장애·권한 변경으로 정리가 실패하면 임시 폴더가 남을 수 있습니다. 최종 연결 후 정리 단계에서 오류가 나면 검산된 결과가 이미 있을 수도 있습니다. 종료 코드만 보고 덮어쓰지 말고 원본·정답과 확인한 뒤 새 이름을 사용하세요.
하드 링크는 불완전한 내용을 최종 이름으로 쓰지 않기 위한 공개 경계입니다. fsync를 통한 전원 장애 내구성, 동시 입력 수정 방지, 악의적인 공유 폴더 변경까지 보장하지 않습니다. CSV 메모도 원문대로 보존하므로 수식처럼 보이는 문자열이 있을 때 스프레드시트 앱의 자동 실행이나 변환을 막는 기능은 아닙니다. 검산은 첨부의 텍스트 읽기 도구로 수행하세요.
전체 실행 코드
다음 코드는 ZIP의 external_sort.py와 같습니다. 정상·실패 입력, 전체 정답, 자동 시험, 실제 로그, 버전과 체크섬은 ZIP에 함께 들어 있습니다.
"""Sort CSV in disk-backed runs; publish only a verified new destination."""
import argparse
import csv
import hashlib
import heapq
import json
import os
import platform
import re
import sqlite3
import sys
import tempfile
from contextlib import ExitStack, closing
from datetime import datetime
from pathlib import Path

INPUT_FIELDS = ['time', 'id', 'qty', 'memo']
OUTPUT_FIELDS = ['source_row', *INPUT_FIELDS]


def file_sha256(path):
    digest = hashlib.sha256()
    with path.open('rb') as f:
        for block in iter(lambda: f.read(1024 * 1024), b''):
            digest.update(block)
    return digest.hexdigest()


def key(row):
    return row[1], row[2]  # Fixed-width time, then case-sensitive lexical ID.


def write_rows(path, rows):
    with path.open('x', encoding='utf-8', newline='') as f:
        writer = csv.writer(f, lineterminator='\n')
        writer.writerow(OUTPUT_FIELDS)
        writer.writerows(rows)


def validated_rows(source, db):
    with source.open(encoding='utf-8-sig', newline='') as f:
        reader = csv.reader(f, strict=True)
        if next(reader, None) != INPUT_FIELDS:
            raise ValueError('HEADER: expected time,id,qty,memo')
        for number, row in enumerate(reader, 1):
            if len(row) != 4:
                raise ValueError(f'FIELDS: source_row={number}')
            time, ident, qty, memo = row
            if not re.fullmatch(r'[0-9]{4}-[0-9]{2}-[0-9]{2}T[0-9]{2}:[0-9]{2}:[0-9]{2}', time):
                raise ValueError(f'TIME_FORMAT: source_row={number}')
            try:
                datetime.strptime(time, '%Y-%m-%dT%H:%M:%S')
            except ValueError as exc:
                raise ValueError(f'TIME_CALENDAR: source_row={number}') from exc
            if not re.fullmatch(r'[A-Za-z0-9][A-Za-z0-9_-]{0,31}', ident):
                raise ValueError(f'ID: source_row={number}')
            if not re.fullmatch(r'0|[1-9][0-9]{0,8}', qty):
                raise ValueError(f'QTY: source_row={number}')
            if len(memo) > 10000:
                raise ValueError(f'MEMO_LENGTH: source_row={number}')
            try:
                db.execute('INSERT INTO seen VALUES (?, ?, ?, ?, ?, 0)',
                           (ident, str(number), time, qty, memo))
            except sqlite3.IntegrityError as exc:
                raise ValueError(f'DUPLICATE_ID: source_row={number}, id={ident}') from exc
            yield [str(number), *row]


def make_runs(source, folder, db, chunk_rows):
    folder.mkdir()
    chunk, count, total, qty_sum = [], 0, 0, 0
    for row in validated_rows(source, db):
        chunk.append(row)
        total += 1
        qty_sum += int(row[3])
        if len(chunk) == chunk_rows:
            chunk.sort(key=key)
            write_rows(folder / f'{count}.csv', chunk)
            count += 1
            chunk.clear()
    if chunk or count == 0:
        chunk.sort(key=key)
        write_rows(folder / f'{count}.csv', chunk)
        count += 1
    db.commit()
    return count, total, qty_sum


def merge_runs(paths, target):
    with ExitStack() as stack:
        readers = []
        for path in paths:
            f = stack.enter_context(path.open(encoding='utf-8', newline=''))
            reader = csv.reader(f, strict=True)
            if next(reader, None) != OUTPUT_FIELDS:
                raise ValueError('TEMP_HEADER')
            readers.append(reader)
        write_rows(target, heapq.merge(*readers, key=key))


def verify_output(path, db, expected_count, expected_qty):
    count, qty_sum, previous = 0, 0, None
    with path.open(encoding='utf-8', newline='') as f:
        reader = csv.reader(f, strict=True)
        if next(reader, None) != OUTPUT_FIELDS:
            raise ValueError('VERIFY_HEADER')
        for row in reader:
            if len(row) != 5:
                raise ValueError('VERIFY_FIELDS')
            source_row, time, ident, qty, memo = row
            expected = db.execute(
                'SELECT source_row, time, qty, memo, checked FROM seen WHERE id=?',
                (ident,)).fetchone()
            if expected != (source_row, time, qty, memo, 0):
                raise ValueError('VERIFY_CONTENT_OR_DUPLICATE')
            current = key(row)
            if previous is not None and previous > current:
                raise ValueError('VERIFY_ORDER')
            previous = current
            db.execute('UPDATE seen SET checked=1 WHERE id=?', (ident,))
            count += 1
            qty_sum += int(qty)
    remaining = db.execute('SELECT COUNT(*) FROM seen WHERE checked=0').fetchone()[0]
    if (count, qty_sum, remaining) != (expected_count, expected_qty, 0):
        raise ValueError('VERIFY_MISSING_OR_TOTAL')
    return count


def sort_csv(source, output, chunk_rows=100000, fan_in=16):
    source, output = Path(source).absolute(), Path(output).absolute()
    if chunk_rows < 1 or not 2 <= fan_in <= 64:
        raise ValueError('PARAMETERS: chunk_rows>=1; 2<=fan_in<=64')
    if output.exists() or output.is_symlink():
        raise FileExistsError(f'OUTPUT_EXISTS: choose a new name: {output}')
    if source.is_symlink() or not source.is_file():
        raise ValueError('INPUT_FILE: use a regular CSV file, not a symbolic link')
    if not output.parent.is_dir():
        raise FileNotFoundError('OUTPUT_FOLDER: create the output folder first')
    before_sha = file_sha256(source)
    with tempfile.TemporaryDirectory(prefix='.p17-', dir=output.parent) as name:
        work = Path(name)
        with closing(sqlite3.connect(work / 'seen.db')) as db:
            db.execute('CREATE TABLE seen (id TEXT PRIMARY KEY, source_row TEXT, '
                       'time TEXT, qty TEXT, memo TEXT, checked INTEGER)')
            folder = work / 'level0'
            count, total, qty_sum = make_runs(source, folder, db, chunk_rows)
            initial_runs, level, passes = count, 0, 0
            while count > fan_in:
                next_folder = work / f'level{level + 1}'
                next_folder.mkdir()
                next_count = 0
                for start in range(0, count, fan_in):
                    paths = [folder / f'{i}.csv'
                             for i in range(start, min(start + fan_in, count))]
                    merge_runs(paths, next_folder / f'{next_count}.csv')
                    next_count += 1
                folder, count = next_folder, next_count
                level += 1
                passes += 1
            staged = work / 'complete.csv'
            merge_runs([folder / f'{i}.csv' for i in range(count)], staged)
            passes += 1
            verified = verify_output(staged, db, total, qty_sum)
        if file_sha256(source) != before_sha:
            raise ValueError('SOURCE_CHANGED: keep input fixed and retry in a new folder')
        report = {'input_rows': total, 'output_rows': verified, 'qty_sum': qty_sum,
                  'initial_runs': initial_runs, 'merge_passes': passes,
                  'chunk_rows': chunk_rows, 'fan_in': fan_in,
                  'input_sha256': before_sha, 'output_sha256': file_sha256(staged),
                  'sort_key': ['time', 'id_lexical_case_sensitive'],
                  'python': platform.python_version(), 'platform': platform.system(),
                  'sqlite': sqlite3.sqlite_version}
        try:
            os.link(staged, output)  # Same filesystem; never replace an existing name.
        except FileExistsError:
            raise
        except OSError as exc:
            raise OSError('HARDLINK: publication failed. Use a writable local '
                          'filesystem supporting hard links and a new output name; '
                          'do not overwrite existing files.') from exc
    return report


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('source', type=Path)
    parser.add_argument('output', type=Path)
    parser.add_argument('--chunk-rows', type=int, default=100000)
    parser.add_argument('--fan-in', type=int, default=16)
    args = parser.parse_args()
    try:
        report = sort_csv(args.source, args.output, args.chunk_rows, args.fan_in)
    except (ValueError, OSError, UnicodeError, csv.Error, sqlite3.Error) as exc:
        print(f'ERROR: {exc}', file=sys.stderr)
        return 2
    print(json.dumps(report, ensure_ascii=False, indent=2))
    return 0


if __name__ == '__main__':
    raise SystemExit(main())
공식 자료와 이어서 읽을 글
CSV의 인용과 줄바꿈 처리는 Python 3.12 csv 문서, 검사 DB의 연결·매개변수와 예외는 sqlite3 문서, 임시 폴더의 정리 범위는 TemporaryDirectory 문서, 달력 검사는 datetime.strptime 문서에서 확인했습니다. 공식 문서의 동작과 이 실습에서 정한 ID·수량·시간 형식 계약은 구별해야 합니다.
원래 순서를 유지하면서 행 수만 나누려면 CSV를 일정한 행 수로 분할하고 누락을 검산하는 실습을 참고하세요. 이번 글은 분할한 자료를 전체 시간순으로 다시 만드는 목적입니다. 서로 다른 시간대의 반복 시각을 다루는 문제는 현지 시각과 UTC를 구별하는 실습에서 따로 다룹니다.
실제 조사·검산일: 2026년 10월 8일. Linux 클라우드의 Python 3.12.14·SQLite 3.53.1에서 합성 입력과 제공 코드를 실행했습니다. Windows UI·Excel 재열기·RAM보다 큰 데이터의 처리 성능은 검증하지 않았습니다.
작성자 소개
