GPT·Claude·Gemini 도구 호출 비교: API 제어와 재고·배송 연결 검증
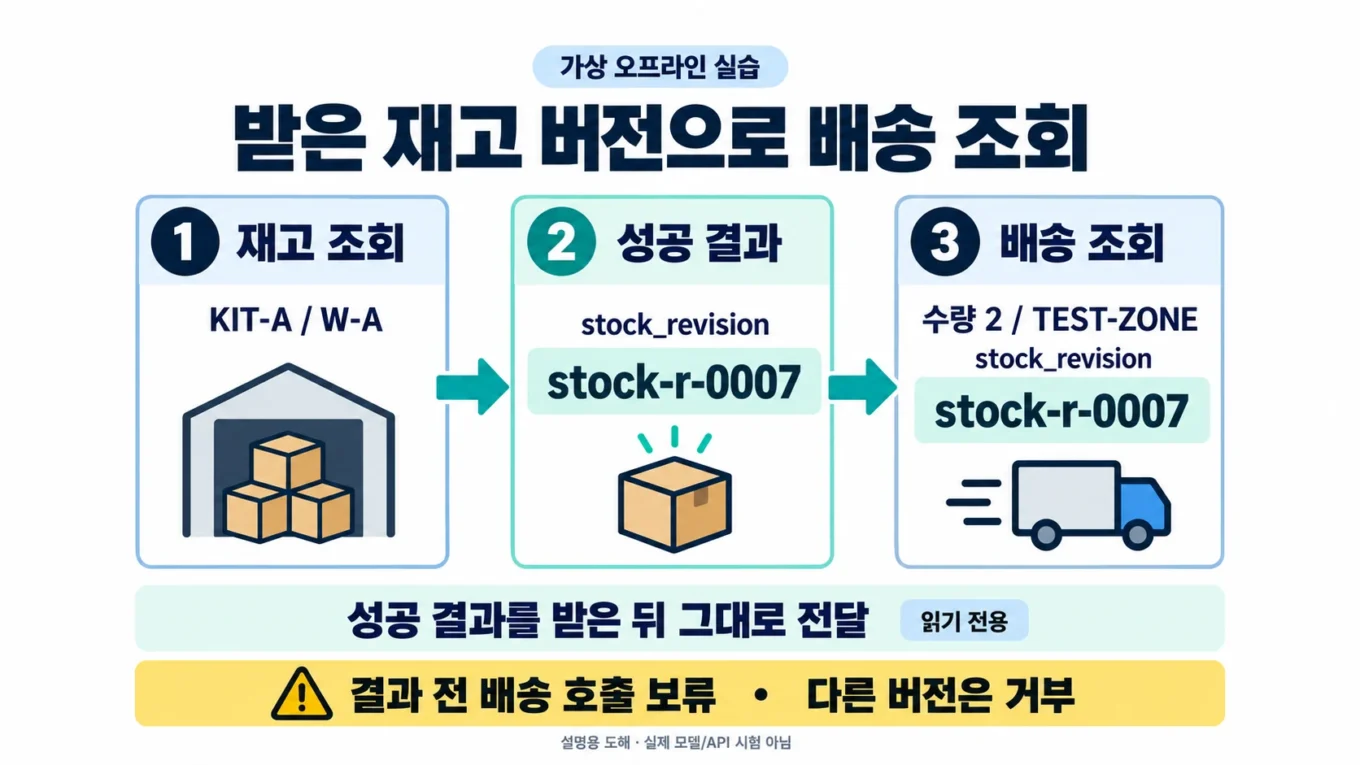
AI에 “이 상품 2개의 재고를 확인한 뒤 배송비를 알려 주세요”라고 요청했다고 해 보겠습니다. 재고 조회와 배송 조회를 한 번씩 실행했어도, 배송 조회가 방금 받은 재고 정보를 사용했는지 확인해야 합니다. AI가 먼저 짐작해서 채운 값으로 두 함수를 차례로 실행하면 조회 결과가 서로 다른 시점을 가리킬 수 있습니다.
이번 AI 도구 호출 비교에서는 gpt-6.1-sol, claude-sonnet-5-5, gemini-4-argon의 공식 API가 제공하는 제어와 대화 이어가기 방식을 살펴봅니다. 핵심은 첫 번째 도구가 실제로 반환한 재고 버전값을 두 번째 도구의 입력에 정확히 연결하는 것입니다. API 키 없이 실행하는 오프라인 검증 실습도 함께 준비했습니다.
공식 문서 확인 기준일은 한국시간 2026년 10월 17일입니다. 세 모델을 실제로 호출한 정확도·속도 시험은 하지 않았습니다. 아래의 재고·배송 정보와 호출 기록은 작성자가 만든 가상 자료이며, 모델 원응답이나 실제 물류 정보가 아닙니다. 비교 대상은 제공사 네이티브 API의 사용자 정의 읽기 전용 함수입니다. 소비자용 앱, 제휴 플랫폼, 주문·결제 자동화는 다루지 않습니다.
배송 조회에 필요한 값은 재고 결과에서 가져옵니다
도구 호출에서는 모델이 함수 이름과 인수를 제안하고, 애플리케이션이 이를 검사해 함수를 실행합니다. 실행 결과를 모델에 돌려주면 다음 호출이나 최종 답변을 받을 수 있습니다. 함수 실행 권한과 실행 전 검사는 애플리케이션이 맡아야 합니다.
다음 두 함수와 stock_revision 연결 규칙은 이 글을 위해 작성한 애플리케이션 계약입니다. 제공사가 내장한 함수나 모든 배송 API에 적용되는 공통 요구사항이 아닙니다. 공식 문서는 함수 호출 방식의 근거이며, 업무 규칙은 이 실습에서 별도로 정했습니다. 두 함수 모두 읽기 전용이며 주문, 재고 예약, 결제 기능은 없습니다.
get_current_stock
- 입력: sku, warehouse_id
- 이 글에서 확인하는 결과: 상품·창고, 가용 수량, stock_revision, 조회 시각
get_shipping_estimate
- 입력: sku, warehouse_id, quantity, destination_postcode, stock_revision
- 이 글에서 확인하는 결과: 같은 상품·창고·수량·재고 버전에 연결된 가상 배송 예상값과 조회 시각
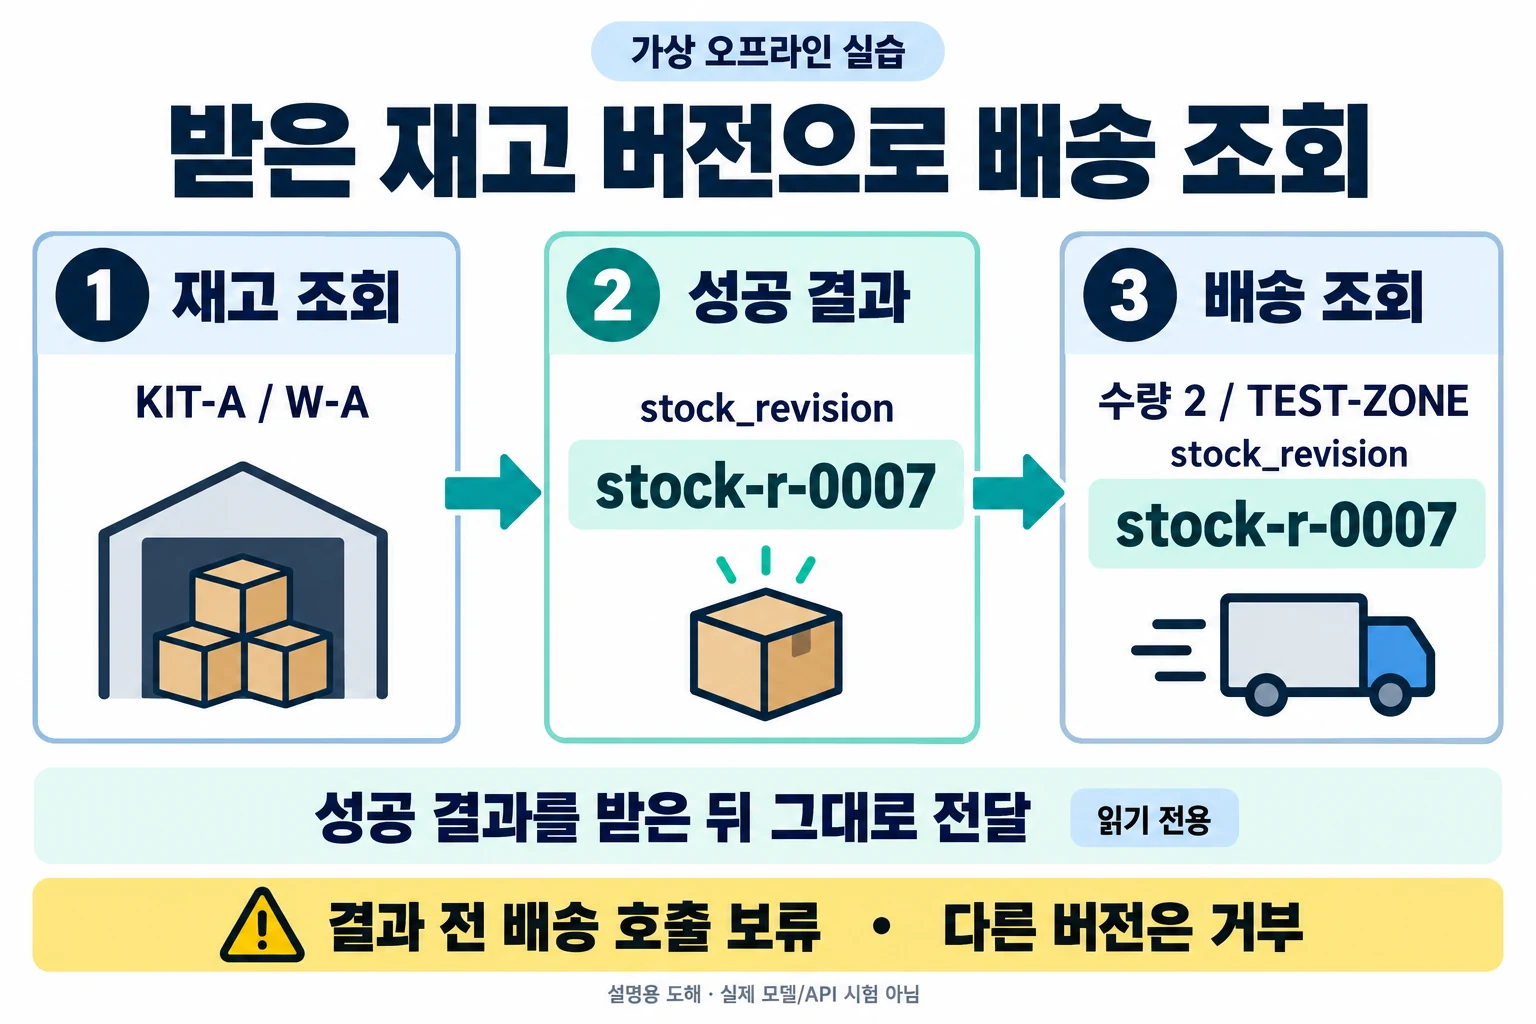
stock_revision은 재고 조회가 반환하는 업무용 버전 표지입니다. 이 글에서는 내용을 해석하거나 새로 만들지 않고 그대로 전달하는 불투명한 문자열로 취급합니다. 비밀번호나 인증 토큰은 아닙니다.
두 번째 호출은 첫 번째의 성공 결과를 받은 뒤에 제안되어야 하며, 이 실행에서 반환된 stock_revision과 정확히 같은 값을 써야 합니다. 같은 상품·창고인지, 수량이 충분한지도 확인합니다. stock_revision이 문자열이라는 JSON 조건만 통과해서는 이 관계를 확인할 수 없습니다.
예를 들어 한 응답에 재고 조회와 배송 조회가 함께 나왔고, 배송 인수에 이미 어떤 재고 버전이 들어 있다면 어떻게 할까요? 실행기가 재고 함수를 먼저 실행하더라도 그 값은 아직 받지 않은 결과를 바탕으로 작성된 것입니다. 미리 제안된 배송 호출은 보류하고, 실제 재고 결과를 받은 뒤 유효한 새 호출을 받아야 합니다. 순서대로 실행하는 큐만으로는 인수의 출처를 바로잡을 수 없습니다.
세 종류의 식별자를 따로 보관합니다
제공사의 응답 ID, 도구 호출과 결과를 연결하는 ID, 업무 데이터의 재고 버전은 용도가 다릅니다.
응답 또는 대화 이어가기
- OpenAI Responses: response.id를 previous_response_id에 사용
- Claude Messages: response.id는 응답 식별자. 다음 요청에는 대화 이력을 다시 전달
- Gemini Interactions: interaction.id를 previous_interaction_id에 사용
도구 호출과 결과 연결
- OpenAI Responses: function_call.call_id → function_call_output.call_id
- Claude Messages: tool_use.id → tool_result.tool_use_id
- Gemini Interactions: function_call.id → function_result.call_id
업무상 재고 버전
- OpenAI Responses: 세 경로 모두 실제 재고 결과의 stock_revision을 별도로 검사
- Claude Messages: 동일
- Gemini Interactions: 동일
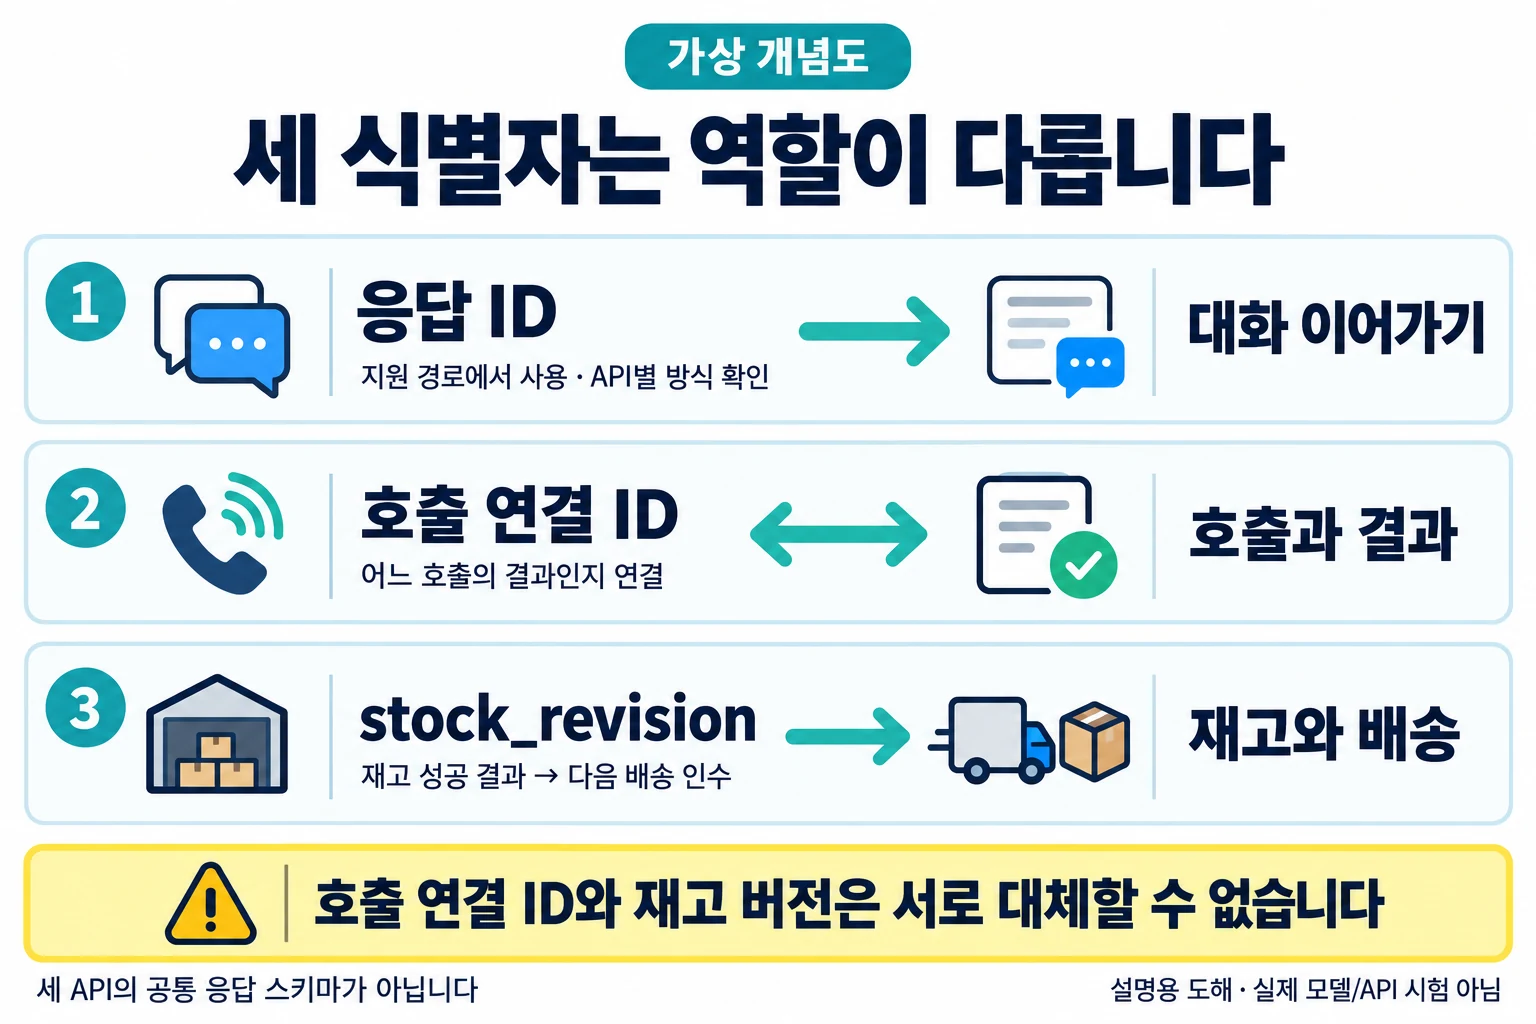
OpenAI의 function_call에는 별도의 출력 항목 id도 있습니다. 결과를 연결할 때 필요한 call_id와 바꾸어 쓰지 마세요. Claude에서는 응답의 msg ID 대신 해당 tool_use 블록의 id를 사용합니다. Gemini에서는 interaction ID 대신 해당 function_call 단계의 id를 사용합니다. OpenAI 함수 호출, Claude 도구 결과 처리, Gemini 함수 호출
호출 연결 ID가 맞으면 “어느 호출의 결과인지”를 확인할 수 있습니다. stock_revision까지 맞아야 “어느 재고 조회에 근거한 배송 예상값인지”를 확인할 수 있습니다. 둘 중 하나를 다른 값으로 대신하지 마세요.
API가 제공하는 호출 제어를 비교합니다
다음은 공식 문서에 확인되는 지원 차이입니다. 실제 모델의 업무 성공률 순위가 아닙니다.
이번 네이티브 경로
- GPT-6.1 Sol: Responses API
- Claude Sonnet 5.5: Messages API
- Gemini 4 Argon: Interactions API
호출 선택
- GPT-6.1 Sol: auto, required, none, 특정 함수 선택 등
- Claude Sonnet 5.5: auto와 none. any·특정 함수 강제는 해당 모델에서 오류
- Gemini 4 Argon: auto, any, none, validated와 허용 함수 지정
한 응답의 호출 수 제한
- GPT-6.1 Sol: parallel_tool_calls=false이면 0개 또는 1개
- Claude Sonnet 5.5: tool_choice 안의 disable_parallel_tool_use=true이면 최대 1개
- Gemini 4 Argon: 확인한 Interactions 문서에서 동등한 병렬 비활성화 스위치를 찾지 못함
스키마 제약의 용도
- GPT-6.1 Sol: strict로 인수 구조 검사
- Claude Sonnet 5.5: strict로 도구 이름·인수 구조 검사
- Gemini 4 Argon: validated로 스키마 준수 제어
별도로 필요한 검사
- GPT-6.1 Sol: 실제 첫 결과를 사용했는지, 업무 상태가 유효한지
- Claude Sonnet 5.5: 동일
- Gemini 4 Argon: 동일
Sol은 도구 호출에 Responses를 사용합니다
gpt-6.1-sol의 도구 호출은 Responses API 경로를 사용합니다. 이 모델을 Chat Completions에서 사용할 수 있다는 안내를 도구 호출 지원으로 확대해서 읽으면 안 됩니다. GPT-6.1 Sol 모델 문서
parallel_tool_calls=false는 한 차례 응답의 도구 호출을 0개 또는 1개로 제한합니다. 그 설정만으로 호출을 반드시 하게 만들거나 올바른 재고→배송 순서를 보장하지는 않습니다. required나 특정 함수 선택은 호출 선택을 제어하며, 재고 버전 검사는 애플리케이션이 담당합니다. strict=true를 명시하고 객체의 additionalProperties=false와 필수 속성 규칙도 맞춰야 합니다. OpenAI 호출 선택·병렬 호출·strict 안내
Sonnet 5.5는 강제 호출 설정을 그대로 복사하면 안 됩니다
claude-sonnet-5-5는 tool_choice의 auto와 none을 지원합니다. any나 특정 tool을 강제하는 설정은 400 invalid_request_error를 반환한다고 안내합니다. 다른 Claude 모델의 예제를 그대로 옮기기 전에 해당 모델의 제약을 확인하세요. Sonnet 5.5의 도구 호출 변경 사항
병렬 호출을 끄는 필드는 tool_choice 안에 둡니다. auto와 disable_parallel_tool_use=true를 함께 쓰면 최대 한 개의 도구를 사용할 수 있지만, 텍스트만 반환할 수도 있습니다. strict=true로 인수 구조를 제한해도 Sonnet 5.5의 호출 자체를 강제하지는 못합니다. Claude 병렬 호출 제어, Claude strict 도구 사용
Argon은 Interactions의 설정과 응답 구조를 확인합니다
gemini-4-argon은 Interactions 경로로 비교합니다. any는 함수 호출을 요구하고, validated는 스키마 준수를 제어합니다. 허용 함수 이름을 하나로 좁히는 설정과 호출 개수를 한 개로 제한하는 설정은 구분해야 합니다. 확인한 가이드·참조 문서에서 parallel_tool_calls=false와 같은 단일 호출 제한 스위치는 검증하지 못했습니다. 존재하지 않는 필드를 만들어 요청에 넣지 마세요. Gemini 호출 모드, Interactions API 참조
따라서 애플리케이션에서는 반환된 함수 호출을 모두 검사하고, 아직 재고 결과가 없는 배송 호출은 실행 전에 막아야 합니다. Interactions는 현재 Python의 자동 함수 실행을 제공하지 않으므로 자체 호출 루프도 필요합니다. 이는 문서에 근거한 연동 설계 판단이며, Argon의 순서 준수 성능을 측정한 결과는 아닙니다. Interactions 개요와 현재 제한
결과를 돌려줄 때 대화와 설정도 이어갑니다
함수 결과만 새 요청으로 보내면 이전 호출과 연결되는 정보가 빠질 수 있습니다. 제공사별로 결과의 위치와 이어가기 방식을 맞추세요.
OpenAI Responses: previous_response_id에 직전 response.id를 지정하고, 해당 call_id의 function_call_output을 보냅니다. 이전 응답 ID를 지정해도 이전 최상위 instructions는 자동으로 이어지지 않으므로 다시 전달합니다. 사용할 tools와 현재 설정도 요청에 명시적으로 관리하세요. 수동으로 이력을 구성한다면 함수 결과와 함께 이전 출력 항목, 추론 항목을 보존합니다. Responses 다중 턴 전환, OpenAI 추론 이력 처리
Claude Messages: 전체 messages 이력을 다시 보냅니다. 모델의 assistant 블록을 보존하고, 바로 다음 user 메시지에서 해당 tool_use_id의 tool_result를 전달합니다. 그 메시지에서는 도구 결과 블록을 일반 텍스트보다 앞에 둡니다. thinking 블록도 변경 없이 유지해야 합니다. Sonnet 5.5의 thinking 블록은 모델·대화 접두부·계정과 연결되는 제약이 있으므로, 중간 이력을 편집한 뒤 계속 쓸 수 있다고 가정하지 마세요. Claude Messages 이력, Claude 결과 배치 규칙, Sonnet 5.5 thinking 변경
Gemini Interactions: 기본 저장 경로에서는 previous_interaction_id로 이어가며, 서버가 이력과 thought·서명을 보존합니다. tools, system_instruction, generation_config는 매 요청 범위의 설정이므로 이어갈 때도 다시 전달합니다. store=false를 사용하면 ID 이어가기를 할 수 없으며 전체 이력과 변경하지 않은 thought·서명을 재전달해야 합니다. Interactions의 서명은 별도의 thought 단계에 있습니다. 과거 generateContent 예제의 functionCall·thoughtSignature 배치를 옮겨 쓰지 마세요. Interactions 상태와 요청 설정, Gemini thought와 서명
이력 보존은 대화 프로토콜을 잇기 위한 조건입니다. 재고가 그대로 유지된다는 보장은 별도입니다. 실무 연동에서는 배송 조회의 원천 시스템도 해당 재고 버전을 유효한 것으로 받아들이는지 확인해야 합니다.
같은 가상 입력으로 연결 관계를 검증합니다
다음은 실습용 공통 요청입니다. 제공사에 보내 본 프롬프트나 모델 출력이 아닙니다.
W-A 창고에서 KIT-A 2개의 현재 재고를 확인한 뒤, TEST-ZONE의 배송 예상값을 조회하세요. 배송 조회에는 이번 재고 조회 결과가 실제로 반환한 stock_revision을 그대로 사용하세요. 읽기 전용 조회만 하며 주문·예약·결제는 하지 마세요. 확인하지 못한 항목은 확인되지 않았다고 답하세요.
destination_postcode는 실습 애플리케이션이 정의한 필드입니다. TEST-ZONE은 실제 우편번호나 주소가 아닌 가상 표지이며, 세 제공사의 기본 API 파라미터라는 뜻도 아닙니다. 모델의 최초 입력에는 아래 기대 재고 버전이나 기대 답을 넣지 않습니다.
재고 호출
- 작성한 입력 또는 반환값: sku=KIT-A, warehouse_id=W-A
- 확인할 연결: 지정 상품·창고만 조회
재고 성공 결과
- 작성한 입력 또는 반환값: available_qty=7, stock_revision=stock-r-0007, observed_at=2026-10-17T00:00:00Z
- 확인할 연결: 이 결과를 받은 뒤에만 배송 호출 가능
배송 호출
- 작성한 입력 또는 반환값: 같은 상품·창고, quantity=2, destination_postcode=TEST-ZONE, stock_revision=stock-r-0007
- 확인할 연결: 실제 받은 버전과 정확히 일치
배송 성공 결과
- 작성한 입력 또는 반환값: fee=3500, currency=KRW, min_business_days=2, max_business_days=3, estimated_at=2026-10-17T00:00:01Z, 같은 재고 버전
- 확인할 연결: 요청한 조건 및 재고 결과와 대응
수량 7개, 배송비 3,500원, 2~3영업일과 두 시각은 모두 작성자가 정한 고정 실습값입니다. 실측 시각이나 실제 상품 재고·운임·배송 약속이 아닙니다.
이 자료로 만든 정상 기대 답은 다음 내용을 포함해야 합니다. “가상 재고 조회에서는 W-A의 KIT-A 가용 수량이 7개여서 요청한 2개 조건을 충족합니다. 같은 stock-r-0007을 사용한 가상 배송 조회 결과는 TEST-ZONE 기준 3,500원, 2~3영업일입니다. 두 결과의 기준 시각은 각각 2026-10-17T00:00:00Z와 2026-10-17T00:00:01Z입니다.” 주문·예약·결제 완료나 도착 보장 문구를 덧붙이지 않습니다.
실행 전에 멈춰야 하는 경우와 다시 확인할 자료
실패한 기록을 정상처럼 고치기보다, 어느 단계에서 근거가 끊겼는지 남기세요. 아래 복구 방향은 실제 연동을 설계할 때의 확인 순서입니다. 첨부 검증기가 API 재호출이나 자동 복구를 수행한다는 뜻은 아닙니다.
재고 결과보다 먼저 배송 호출을 제안함
- 즉시 처리: 배송 실행 보류
- 이어서 확인할 내용: 원래 제안을 남기고 재고 성공 결과를 전달한 뒤 새 배송 호출 확인
버전 누락·짐작한 값·다른 실행의 버전
- 즉시 처리: 배송 어댑터 실행 전 거부
- 이어서 확인할 내용: 해당 실행의 실제 재고 결과와 인수를 다시 대조. 실행기가 몰래 수정하지 않음
상품·창고·수량이 조건과 다름
- 즉시 처리: 실행 보류
- 이어서 확인할 내용: 원요청, 재고 결과, 배송 인수의 대응 확인
재고 조회 오류·필수 값 누락·수량 부족
- 즉시 처리: 종속 배송 단계 중단
- 이어서 확인할 내용: 확인된 상태와 미확인 항목을 답변에 남김
원천 시스템이 재고 버전 만료·변경을 알림
- 즉시 처리: 기존 버전으로 배송 예상값을 확정하지 않음
- 이어서 확인할 내용: 새 재고를 조회한 뒤 새 버전에 근거한 배송 요청 검토
결과의 호출 연결 ID가 다르거나 결과가 먼저 도착함
- 즉시 처리: 정상 상태에 반영하지 않음
- 이어서 확인할 내용: 원래 호출·결과·이력 순서를 조사
같은 호출 결과가 두 번 도착함
- 즉시 처리: 덮어쓰거나 두 번째 결과를 조용히 채택하지 않음
- 이어서 확인할 내용: 중복 원인을 확인하고 원본 두 기록 보존
함수 조회 없이 최종 문장만 나옴
- 즉시 처리: 조회 완료로 인정하지 않음
- 이어서 확인할 내용: 실제 도구 호출·성공 결과가 있는지 확인
재고 부족으로 배송을 보류한 결과와, 모델이 필요한 도구 호출을 빠뜨린 결과도 구분해야 합니다. 앞의 경우에는 업무 조건에 따라 종속 단계를 멈춘 것입니다. 무조건 두 함수를 모두 실행했는지로 채점하면 올바른 보류까지 실패로 처리하게 됩니다.
오프라인 검증기를 실행하는 방법
실습 파일은 작성한 정규화 호출 기록을 검사합니다. 검증기는 재고 성공 결과를 확인한 다음에만 배송 도구를 허용하는 단계별 실행 제어를 사용합니다. 세 제공사의 네이티브 원응답을 읽거나 변환하는 API 클라이언트가 아닙니다. 네이티브 call_id·tool_use_id·thought 보존을 이 파일 실행만으로 검증할 수는 없습니다. 실제 연동에는 원응답을 보존하면서 검증용 기록으로 옮기는 별도 어댑터와 검토가 필요합니다.
재고·배송 도구 연결 오프라인 실습 ZIP 다운로드 (23,970바이트)
실습 ZIP을 새 폴더에 풀고 tool_dependency_offline 폴더의 README.md를 읽으세요. Python 표준 라이브러리만 사용하는 로컬 실습이며, API 키나 유료 호출은 필요하지 않습니다. 압축을 푼 폴더에서 다음 명령을 실행합니다.
python3 -m unittest -v
python3 run_fixtures.py --check
첫 번째 명령은 검증 로직의 단위검사를 실행합니다. 두 번째 명령은 fixtures.json의 작성 사례를 검사하고 expected_results.json의 기대 판정과 대조합니다. 정규화 기록이 정상 흐름인지, 어떤 위반 때문에 거부되는지 확인하세요. 거부되어야 할 사례가 예상대로 거부된 것도 검증기 검사 통과에 포함됩니다.
출력의 accepted, code, shipping_dispatches를 함께 보세요. 예를 들어 accepted=false라는 판정이 나왔다면 전체 기록은 채택되지 않은 것입니다. 다만 배송 결과 자체의 오류나 최종 문장의 오류는 배송 함수 실행 뒤에 발견될 수 있으므로, 모든 거부 사례에서 shipping_dispatches=0이 되는 것은 아닙니다.
valid_openai·valid_anthropic·valid_google
- 기대 code: VERIFIED_ESTIMATE
- 배송 함수 실행 수: 각각 1
missing_revision
- 기대 code: ARGUMENT_SCHEMA
- 배송 함수 실행 수: 0
stale_revision
- 기대 code: REVISION_MISMATCH
- 배송 함수 실행 수: 0
snapshot_expired
- 기대 code: SNAPSHOT_EXPIRED
- 배송 함수 실행 수: 0
source_revision_changed
- 기대 code: SOURCE_REVISION_CHANGED
- 배송 함수 실행 수: 0
mismatched_snapshot_sku·mismatched_snapshot_warehouse
- 기대 code: SNAPSHOT_IDENTITY_MISMATCH
- 배송 함수 실행 수: 각각 0
both_calls_before_first_return
- 기대 code: BOTH_CALLS_BEFORE_STOCK_RETURN
- 배송 함수 실행 수: 0
wrong_native_correlation
- 기대 code: NATIVE_CORRELATION_MISMATCH
- 배송 함수 실행 수: 0
duplicate_stock_result·out_of_order_result
- 기대 code: DUPLICATE_RESULT·OUT_OF_ORDER_RESULT
- 배송 함수 실행 수: 각각 0
shipping_result_snapshot_mismatch
- 기대 code: TOOL_RESULT_MISMATCH
- 배송 함수 실행 수: 1
fabricated_final_claim·fabricated_order_claim
- 기대 code: FINAL_CLAIM_MISMATCH
- 배송 함수 실행 수: 각각 1
stale_revision은 실제 반환된 stock-r-0007 대신 stock-r-0006을 넣은 사례입니다. snapshot_expired는 작성자가 정한 60초 유효기간을 61초로 넘긴 사례이고, source_revision_changed는 가상 원천 버전이 stock-r-0008로 바뀐 사례입니다. 60초는 이 실습의 고정 규칙이며 제공사나 물류 시스템의 공통 유효기간이 아닙니다.
valid_openai·valid_anthropic·valid_google라는 이름은 문서의 ID 대응 관계를 정규화 필드로 표현한 세 사례를 구분합니다. 실제 API 응답을 통과시켰다는 뜻이 아닙니다. 검증기는 첫 위반에서 멈추고 기록을 거부하며, 이벤트를 재정렬하거나 인수를 수정해 복구하지 않습니다.
Python 3.12.14의 로컬 실행에서 단위검사 23개가 모두 통과했습니다. 작성 사례 23개의 판정도 정상 승인 3개·거부 20개로 기대값과 정확히 일치했습니다. 실행 출력의 요약은 cases=23, accepted=3, rejected=20, exact_expected_match=True입니다. 이는 검증기와 유한한 가상 사례의 검사 결과이며, 세 모델을 23회 시험한 결과가 아닙니다.
이 검증기의 정상 최종 상태는 가상 배송 예상값까지 확인한 VERIFIED_ESTIMATE입니다. 재고 부족 등에 대한 모든 보류 답변 유형을 구현한 운영용 상태 머신은 아닙니다. 확인할 수 있는 범위는 고정한 기록 형식과 준비한 가상 사례입니다. 실제 AI의 도구 선택 능력, SDK 호환성, 서비스의 재고 최신성·배송 정확도나 보안을 검증한 결과로 확대하지 마세요.
실제 모델 비교와 단계별 실행 제어는 분리합니다
나중에 실제 API 시험을 한다면 두 가지 목적을 나누어 기록하세요.
모델의 자연스러운 의존 관계 처리를 비교할 때: 같은 공통 요청과 두 도구를 처음부터 제공하고, 세 경로 모두 auto로 시작합니다. 재고 결과 전 배송 제안, 도구 생략, 버전 불일치, 근거 없는 완료 주장을 따로 기록합니다. 강제 호출이 가능한 한쪽에만 강제 설정을 쓰고 다른 쪽의 auto 결과와 같은 조건이라고 하지 마세요.
운영용 실행기를 만들 때: 처음에는 재고 도구만 보여 주고, 성공 결과와 업무 조건을 확인한 뒤 배송 도구를 보여 주는 단계별 제어를 사용할 수 있습니다. 실행 전에도 모든 인수를 검사합니다. 이렇게 애플리케이션이 순서를 강제한 결과는 운영 제어의 효과를 보여 줍니다. 모델이 두 도구의 의존 관계를 스스로 잘 계획했다는 증거로 사용하지 마세요.
설정 이름이 같아도 계산량이 일치하는 것은 아닙니다. 현재 기본 추론 설정은 Sol이 medium, Sonnet 5.5가 adaptive의 high, Argon이 medium으로 안내됩니다. 기본값 비교인지 명시적 설정 비교인지 정하고, 요청·반환 모델 ID, SDK 버전, 전체 설정, 재시도와 중단 상태를 남기세요. Sol 추론 설정, Sonnet 5.5 기본 설정, Gemini 최신 모델 설정
단가가 같아도 전체 조회 비용은 달라집니다
2026년 10월 17일 확인한 Standard 텍스트 공시 단가입니다. 소비자 앱 구독료나 실제 측정 청구액이 아닙니다.
GPT-6.1 Sol
- 입력 100만 토큰: $2
- 출력 100만 토큰: $10
- 이번 비교에서 함께 볼 조건: 입력 272,000토큰을 초과하면 전체 요청에 장문 단가 적용: 입력 $4, 출력 $15
Claude Sonnet 5.5
- 입력 100만 토큰: $2
- 출력 100만 토큰: $10
- 이번 비교에서 함께 볼 조건: 표준 전역 처리 기준. 도구 선언·호출·결과도 토큰 사용량에 반영
Gemini 4 Argon
- 입력 100만 토큰: $2
- 출력 100만 토큰: $10
- 이번 비교에서 함께 볼 조건: 2026년 11월 30일까지 소개 요금. 12월 1일부터 입력 $4, 출력 $20
Sol 장문 조건은 초과분에만 곱하는 계산으로 바꾸지 마세요. Argon의 출력 단가에는 thinking이 포함됩니다. Claude의 도구 사용에도 일반 토큰 요금이 적용되며 도구용 프롬프트 부담이 있습니다. 세 모델의 현재 기본 단가가 같다는 사실만으로 이 재고·배송 작업의 총비용이 같아지지는 않습니다. Sol 가격과 장문 조건, Claude 가격과 도구 사용, Gemini 가격과 적용 기간
재고 호출 요청, 결과를 넣은 다음 요청, 배송 결과를 반영한 최종 요청까지 각 차례의 과금 입력·출력·추론·캐시 사용량과 재시도를 합산하세요. 이어가기 ID를 썼다는 이유로 이전 이력의 과금이 없어졌다고 가정하면 안 됩니다. OpenAI는 연결한 이전 입력도 과금에 포함된다고 설명합니다. 추론 토큰의 사용량도 응답의 표시 문장 길이와 다를 수 있습니다. OpenAI 대화 상태와 과금, OpenAI 추론 토큰, Claude thinking 과금, Gemini thinking 과금
실측값이 없는 이 글에서는 처리 시간, 한 번의 총비용, 성공률이나 저렴한 모델 순위를 제시하지 않습니다. 실제 시험에서는 조회 연결이 검수된 완료 건수와 전체 비용을 함께 기록해야 선택에 도움이 됩니다.
내 연동에서 먼저 확인할 것
기존 Responses 연동을 쓰며 호출 선택을 세밀하게 제어하려면 Sol의 도구 선택·호출 수 설정을 확인하세요. Claude Messages 연동에서는 Sonnet 5.5의 강제 호출 제한과 assistant·tool_result·thinking 보존부터 점검합니다. Argon Interactions 연동에서는 매 차례 설정을 다시 전달하고, 반환된 모든 함수 호출을 애플리케이션이 검사하는 경로를 준비합니다.
어느 경로든 마지막에 확인할 질문은 같습니다. 배송 조회가 이번 재고 성공 결과를 받은 뒤 제안되었고, 그 결과의 재고 버전을 그대로 사용했는가? 그리고 그 연결을 확인한 내용만 최종 답변에 남겼는가? 이 두 가지를 먼저 검증한 뒤 실제 사용량과 복구 부담을 비교하세요.
모델의 공개 성능·가격을 넓게 살펴보려면 기존 GPT·Claude·Gemini 5종 비교를 이어서 볼 수 있습니다. 독립 요청을 대량 제출한 뒤 결과를 맞추는 작업은 Batch 결과의 누락·중복 확인에서 별도로 다룹니다. 이번 글은 첫 도구의 반환값이 다음 호출의 필수 입력이 되는 연결에 초점을 두었습니다.
작성자 소개
