Python으로 Excel 파일의 선택한 시트만 CSV로 내보내기
한 Excel 파일에 외부로 전달할 표와 내부 검토용 시트가 함께 있는 경우가 있습니다. 파일을 마지막으로 저장할 때 내부 시트가 열려 있었다면, 활성 시트를 기준으로 내보내는 코드가 엉뚱한 표를 읽을 수 있습니다. 내보낼 시트 이름과 셀 범위를 직접 지정하면 이 실수를 줄일 수 있습니다.
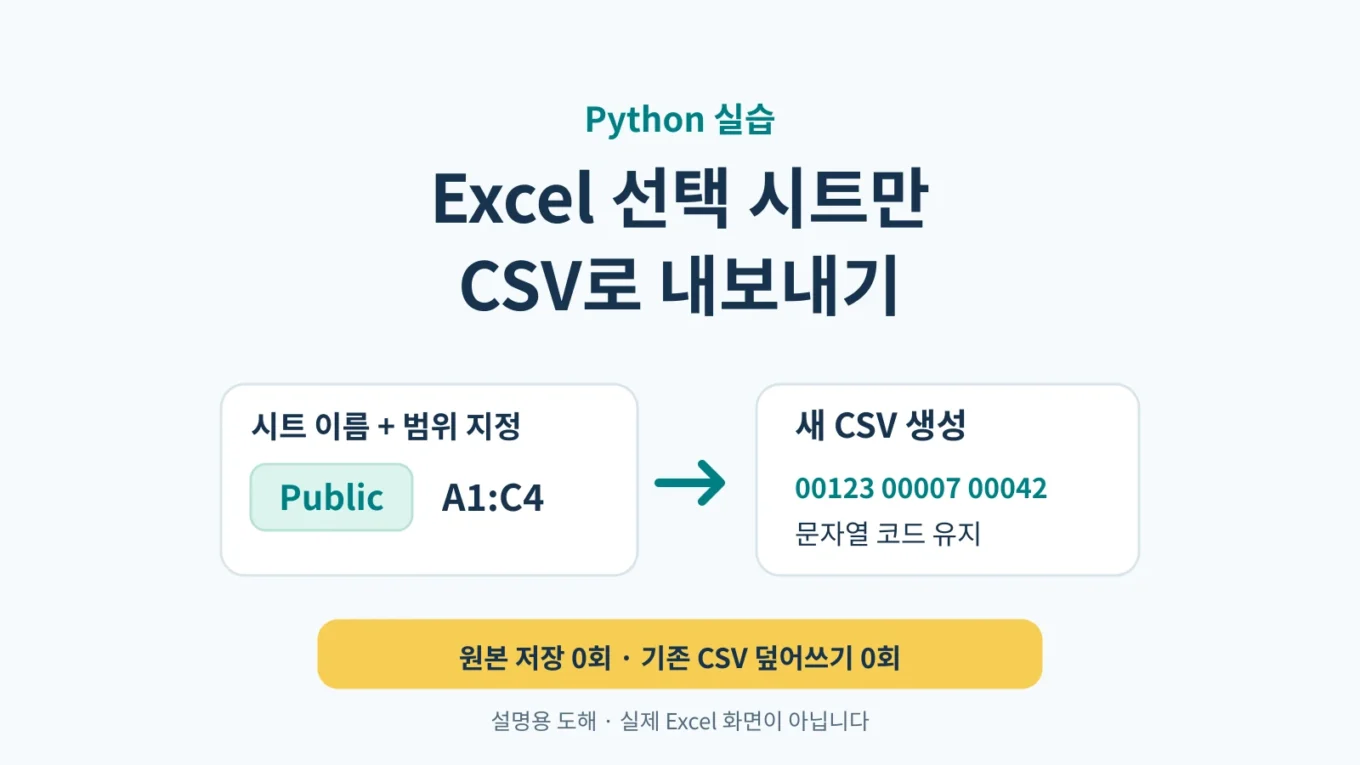
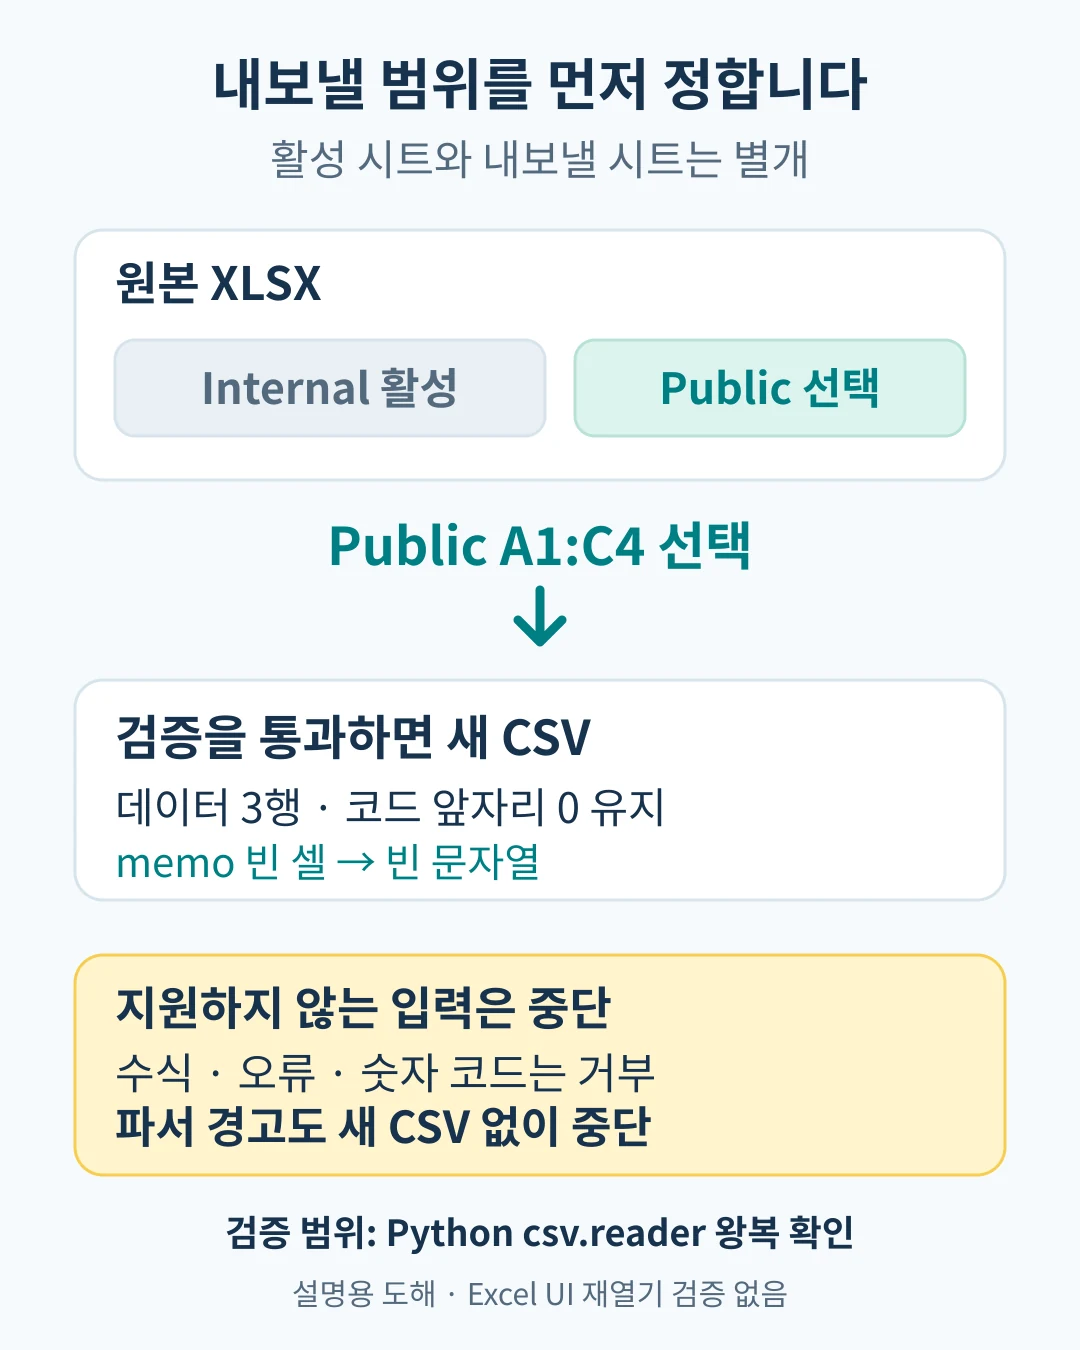
이번 실습에서는 Public 시트의 A1:C4만 읽어 새 CSV를 만듭니다. 입력 파일의 활성 시트는 Internal로 설정했습니다. 원본은 저장하지 않고, 기존 CSV가 있는 경로에는 결과를 쓰지 않습니다. 코드 00123·00007·00042는 저장된 문자열 그대로 내보냅니다.
1. 먼저 입력과 내보낼 범위를 확인하세요
실습 파일은 모두 설명을 위해 만든 합성 데이터입니다. Public에는 아래 표가 있고, Internal에는 내보내지 않을 합성 표식이 있습니다. A1:C4의 첫 행은 헤더, 나머지 세 행은 데이터입니다.
| code | name | memo |
|---|---|---|
| 00123 | 연필 | 빈 셀 |
| 00007 | 노트,파랑 | 담당자 확인 |
| 00042 | 파일 홀더 | 첫 줄 둘째 줄 “확인” |
code는 실제로 저장된 5자리 ASCII 숫자 문자열이어야 합니다. 숫자 123에 표시 형식 00000을 적용한 셀은 이 예제에서 거부합니다. 화면에 00123이 보인다는 사실만으로 저장된 값이 문자열이라고 판단할 수는 없습니다.
name은 비어 있지 않은 텍스트, memo는 텍스트 또는 빈 셀만 허용합니다. memo의 None은 CSV의 빈 문자열로 바꿉니다. 이 과정에서 ‘원래 빈 셀이었는지, 빈 문자열이었는지’는 CSV만으로 구분할 수 없습니다. code와 name의 빈 셀은 같은 방식으로 바꾸지 않고 중단합니다.
2. 실습 파일을 풀고 새 CSV를 만드세요
선택 시트 CSV 내보내기 실습 ZIP 다운로드에는 전체 코드, 합성 XLSX, 실제 생성 결과와 예상 CSV, 결과 확인 스크립트, 실패 입력이 들어 있습니다. ZIP을 풀고 터미널에서 해당 폴더로 이동하세요.
python -m pip install -r requirements.txt
python export_selected_sheet.py sample_public_internal.xlsx public_new.csv --sheet Public --range A1:C4
python verify_result.py public_new.csv
public_new.csv는 ZIP에 없는 새 출력 이름입니다. 실행을 반복할 때는 public_new_2.csv처럼 다른 이름을 지정하세요. ZIP에 포함된 public_result.csv는 검증 환경에서 실제로 만든 결과이고, expected_public.csv는 비교용 예상 파일입니다.
시트와 범위를 생략하면 실행되지 않습니다. 다른 위치의 표를 내보내려면 첫 행이 code,name,memo인 3열 범위를 명시하세요. 예를 들어 첨부한 shifted_success.xlsx에서는 Public B3:D6을 지정하면 같은 표를 얻습니다.
3. 예상 CSV와 실제 결과를 비교하세요
예상 CSV는 다음과 같습니다. 파일 앞에는 UTF-8 BOM이 있으며, 아래 표시에는 BOM을 생략했습니다. memo 안에 개행이 있으므로 데이터는 세 행이지만 텍스트 파일의 물리적인 줄 수는 더 많습니다.
code,name,memo
00123,연필,
00007,"노트,파랑",담당자 확인
00042,파일 홀더,"첫 줄
둘째 줄 ""확인"""
csv.writer는 쉼표가 들어 있는 ‘노트,파랑’을 큰따옴표로 감싸고, memo 안의 큰따옴표를 두 번 써서 인용합니다. 결과를 csv.reader로 읽었을 때 각 데이터 행은 정확히 세 필드로 복원됩니다. Python csv 공식 문서도 CSV 파일을 열 때 newline=''을 지정하고 인코딩을 명시하는 방식을 설명합니다.
기본 샘플을 실제 실행한 결과는 데이터 3행, code 문자열 00123·00007·00042, 비선택 시트의 합성 표식 0개였습니다. 실행 전후 원본 XLSX의 SHA-256도 같았습니다. verify_result.py는 이 샘플의 예상값을 csv.reader로 대조합니다. 다른 업무 데이터의 검증기로 그대로 사용할 수는 없습니다.
CSV에는 Excel 열 형식이 없습니다. 파일 안에 00123이 있어도 Excel에서 자동으로 숫자로 읽으면 앞자리 0이 사라질 수 있습니다. Excel로 가져올 때 code 열을 텍스트로 지정하세요. Microsoft의 앞자리 0 보존 안내에서 텍스트 가져오기 방법과 숫자 자동 변환을 확인할 수 있습니다. 이번 실습에서는 Excel UI로 CSV를 다시 열지는 않았습니다.
4. 전체 내보내기 코드
아래 코드를 export_selected_sheet.py로 저장합니다. 실습 ZIP의 같은 파일과 일치하는 전체 코드입니다. 파일 형식과 요청 범위의 값·구조를 검증한 뒤에만 새 CSV를 배타적으로 생성합니다.
"""명시한 시트의 3열 텍스트 범위만 새 CSV로 내보냅니다."""
import argparse
import csv
import hashlib
import io
import json
import re
import sys
import unicodedata
import warnings
from pathlib import Path
from xml.etree import ElementTree as ET
from zipfile import ZipFile

from openpyxl import load_workbook
from openpyxl.utils.cell import range_boundaries
from openpyxl.worksheet.worksheet import Worksheet

HEADERS = ["code", "name", "memo"]
MAIN_NS = "http://schemas.openxmlformats.org/spreadsheetml/2006/main"
XLSX_TYPE = "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet.main+xml"


class ExportError(Exception):
    """값이나 다른 시트 이름을 포함하지 않는 계약 오류."""


def fail(reason):
    raise ExportError(reason)


def bounds(cell_range):
    if not re.fullmatch(r"[A-Z]{1,3}[1-9][0-9]*:[A-Z]{1,3}[1-9][0-9]*", cell_range):
        fail("범위는 A1:C4처럼 두 셀 주소로 지정하세요.")
    left, top, right, bottom = range_boundaries(cell_range)
    if not (1 <= left <= right <= 16384 and 1 <= top < bottom <= 1048576):
        fail("범위에는 헤더와 데이터 행이 필요하며 시트 한계 안이어야 합니다.")
    if right - left != 2 or bottom - top > 1000:
        fail("이 예제는 3열과 최대 1000개 데이터 행만 지원합니다.")
    return left, top, right, bottom


def intersects(a, b):
    return a[0] <= b[2] and b[0] <= a[2] and a[1] <= b[3] and b[1] <= a[3]


def check_package(raw, sheet, area):
    with ZipFile(io.BytesIO(raw)) as archive:
        parts = archive.infolist()
        if len(parts) > 500 or sum(p.file_size for p in parts) > 50 * 1024 * 1024:
            fail("지원 파일 크기를 초과했습니다.")
        if len({p.filename for p in parts}) != len(parts) or any(p.flag_bits & 1 for p in parts):
            fail("중복 ZIP 항목이나 암호화된 파일은 지원하지 않습니다.")
        if archive.testzip() is not None:
            fail("입력 ZIP 무결성을 확인하지 못했습니다.")
        root = ET.fromstring(archive.read("xl/workbook.xml"))
        if root.tag != f"{{{MAIN_NS}}}workbook":
            fail("일반 XLSX만 지원합니다. Strict OOXML 등 다른 형식은 지원하지 않습니다.")
        types = ET.fromstring(archive.read("[Content_Types].xml"))
        workbook_types = [p.attrib.get("ContentType") for p in types
                          if p.attrib.get("PartName") == "/xl/workbook.xml"]
        if workbook_types != [XLSX_TYPE]:
            fail("매크로 또는 템플릿 형식은 지원하지 않습니다.")
        for part in parts:
            if part.filename.startswith("xl/worksheets/") and part.filename.endswith(".xml"):
                worksheet = ET.fromstring(archive.read(part.filename))
                if worksheet.tag != f"{{{MAIN_NS}}}worksheet":
                    fail("워크시트 형식이 일반 XLSX 지원 범위와 다릅니다.")
        selected = [s for s in root.findall(f"{{{MAIN_NS}}}sheets/{{{MAIN_NS}}}sheet")
                    if s.attrib.get("name") == sheet]
        if selected:
            rid = selected[0].attrib.get(
                "{http://schemas.openxmlformats.org/officeDocument/2006/relationships}id")
            rels = ET.fromstring(archive.read("xl/_rels/workbook.xml.rels"))
            targets = [r.attrib.get("Target", "") for r in rels if r.attrib.get("Id") == rid]
            if len(targets) != 1:
                fail("요청한 시트의 패키지 연결을 확인하지 못했습니다.")
            target = targets[0].lstrip("/") if targets[0].startswith("/") else "xl/" + targets[0]
            selected_xml = ET.fromstring(archive.read(target))
            for formula in selected_xml.iter(f"{{{MAIN_NS}}}f"):
                if formula.attrib.get("t") in {"array", "dataTable"}:
                    ref = formula.attrib.get("ref")
                    if not ref or intersects(area, range_boundaries(ref)):
                        fail("요청 범위와 겹치는 다중 셀 수식은 지원하지 않습니다.")


def text_value(cell, allow_blank=False):
    if cell.data_type in {"f", "e"}:
        fail("요청 범위의 수식 또는 오류 셀은 지원하지 않습니다.")
    if cell.value is None and allow_blank:
        return ""
    if not isinstance(cell.value, str):
        fail("요청 범위는 텍스트 값만 허용합니다. 빈 셀은 memo 열만 허용합니다.")
    value = cell.value
    probe = unicodedata.normalize("NFKC", value)
    if probe.startswith(("\t", "\r", "\n")) or probe.lstrip().startswith(("=", "+", "-", "@")):
        fail("요청 범위의 CSV 수식처럼 보이는 문자열은 지원하지 않습니다.")
    if any(unicodedata.category(c) in {"Cc", "Cf"} and c not in "\t\r\n" for c in value):
        fail("요청 범위의 제어 문자는 지원하지 않습니다.")
    return value


def export_csv(source, output, sheet, cell_range):
    source, output = Path(source), Path(output)
    area = bounds(cell_range)
    if source.suffix.lower() != ".xlsx" or not source.is_file():
        fail("존재하는 .xlsx 입력 파일을 지정하세요.")
    if output.suffix.lower() != ".csv" or output.exists() or output.is_symlink():
        fail("출력은 아직 존재하지 않는 .csv 경로여야 합니다.")
    if source.stat().st_size > 10 * 1024 * 1024:
        fail("이 예제의 입력 한계는 10 MiB입니다.")
    raw = source.read_bytes()
    digest = hashlib.sha256(raw).hexdigest()
    workbook = None
    try:
        check_package(raw, sheet, area)
        # 경고를 숨기고 성공시키지 않습니다. 원래 경고문도 출력하지 않습니다.
        with warnings.catch_warnings():
            warnings.simplefilter("error")
            workbook = load_workbook(io.BytesIO(raw), data_only=False, keep_links=False)
        if sheet not in workbook.sheetnames:
            fail("요청한 시트가 없습니다. 명시한 시트 이름을 확인하세요.")
        ws = workbook[sheet]
        if not isinstance(ws, Worksheet) or ws.sheet_state != "visible":
            fail("요청한 시트는 표시 상태의 일반 워크시트여야 합니다.")
        if any(intersects(area, range_boundaries(ref)) for ref in ws.array_formulae.values()):
            fail("요청 범위와 겹치는 배열 수식은 지원하지 않습니다.")
        structures = list(ws.merged_cells.ranges) + [
            table.ref for table in ws.tables.values()
        ]
        if ws.auto_filter.ref:
            structures.append(ws.auto_filter.ref)
        if any(intersects(area, range_boundaries(str(r))) for r in structures):
            fail("요청 범위와 겹치는 병합 셀, 표, 필터는 지원하지 않습니다.")
        left, top, right, bottom = area
        if any(ws.row_dimensions[r].hidden for r in range(top, bottom + 1)):
            fail("요청 범위의 숨긴 행은 지원하지 않습니다.")
        if any(d.hidden and d.min <= right and left <= d.max
               for d in ws.column_dimensions.values()):
            fail("요청 범위의 숨긴 열은 지원하지 않습니다.")
        rows = []
        for number, cells in enumerate(ws.iter_rows(min_row=top, max_row=bottom,
                                                    min_col=left, max_col=right)):
            row = [text_value(c, allow_blank=(number > 0 and i == 2))
                   for i, c in enumerate(cells)]
            if number == 0:
                if row != HEADERS:
                    fail("요청 범위의 첫 행은 code,name,memo 순서와 정확히 같아야 합니다.")
            elif not re.fullmatch(r"[0-9]{5}", row[0]) or not row[1].strip():
                fail("요청 범위의 code는 텍스트 5자리 숫자, name은 비어 있지 않은 텍스트여야 합니다.")
            rows.append(row)
    except ExportError:
        raise
    except Warning:
        fail("입력 파서 경고가 발생해 내보내기를 중단했습니다. 일반 XLSX 복사본을 확인하세요.")
    except Exception:
        fail("입력 XLSX를 해석하지 못했습니다. 형식과 지원 범위를 확인하세요.")
    finally:
        if workbook is not None:
            workbook.close()
    if hashlib.sha256(source.read_bytes()).hexdigest() != digest:
        fail("검증 중 입력 파일이 변경됐습니다. 작업을 멈추고 다시 확인하세요.")
    # 모든 입력 검증 뒤에만 배타적으로 생성합니다. 기존 파일은 열지 않습니다.
    try:
        with output.open("x", encoding="utf-8-sig", newline="") as f:
            csv.writer(f, lineterminator="\r\n").writerows(rows)
    except FileExistsError:
        fail("출력이 이미 존재합니다. 새 파일 이름을 지정하세요.")
    except OSError:
        fail("CSV 쓰기에 실패했습니다. 부분 파일이 있다면 사용하지 말고 새 경로로 다시 실행하세요.")
    return {"data_rows": len(rows) - 1, "source_sha256": digest}


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("source")
    parser.add_argument("output")
    parser.add_argument("--sheet", required=True)
    parser.add_argument("--range", dest="cell_range", required=True)
    args = parser.parse_args()
    try:
        result = export_csv(args.source, args.output, args.sheet, args.cell_range)
    except (ExportError, OSError):
        # OSError의 파일명/내용도 출력하지 않아 비선택 정보가 새지 않게 합니다.
        error = sys.exception()
        message = str(error) if isinstance(error, ExportError) else "입출력 경로를 확인하세요."
        print("중단: " + message, file=sys.stderr)
        return 2
    print(json.dumps({"status": "created", **result}, ensure_ascii=False))
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
5. 중단 메시지가 나오면 이렇게 확인하세요
입력 검증에서 중단하면 새 CSV는 만들지 않습니다. 아래 실패 입력은 모두 별도의 합성 파일이므로 원본 업무 파일을 바꾸지 않고 동작을 확인할 수 있습니다. 예를 들어 failure_inputs/formula.xlsx를 입력하면 요청 범위의 수식 때문에 종료 코드 2로 중단합니다.
python export_selected_sheet.py failure_inputs/formula.xlsx formula_probe.csv --sheet Public --range A1:C4

중단: 요청 범위의 수식 또는 오류 셀은 지원하지 않습니다.- 시트가 없거나 헤더가 다를 때: 지정한 시트 이름과 범위의 첫 행을 확인하세요. 헤더는 code,name,memo 순서 및 대소문자까지 같아야 합니다. 다른 시트 목록이나 셀 값은 오류문에 출력하지 않습니다.
- 숫자 코드, 날짜, bool, 오류, 수식이 있을 때: 별도 복사본에서 업무 규칙에 따라 확정된 텍스트 표를 준비하세요. 이미 빠진 코드 앞자리 0을 이 코드가 추측해 채우지는 않습니다.
- 병합, 표, 필터, 숨김 또는 다중 셀 수식이 있을 때: 요청 범위와 겹치지 않는 단순한 텍스트 표를 복사본에 준비하세요. 코드가 숨김을 풀거나 수식을 계산하지 않습니다.
- 출력이 이미 있을 때: 새 CSV 이름을 지정하세요. 기존 결과를 삭제하거나 덮어쓰지 않습니다.
- 파일 형식 또는 파서 경고로 중단할 때: 경고를 무시하지 말고 일반 XLSX 복사본의 지원 범위를 확인하세요. 결과 파일이 없다는 사실만으로 성공이라고 판단하지 마세요.
- CSV 쓰기 자체가 실패할 때: 디스크 공간, 상위 폴더, 권한을 확인하세요. 쓰기 도중 생긴 부분 파일은 사용하지 말고 새 출력 이름으로 다시 실행하세요.
수식처럼 보이는 문자열도 별도로 거부합니다. 저장된 텍스트가 =, +, -, @로 시작하거나 공백 뒤 이런 문자가 나오면 미지원입니다. 전각 형태를 검사하고 탭·CR·LF로 시작하는 문자열도 중단합니다. 그 밖의 Unicode 제어·서식 문자도 보수적으로 거부합니다. 입력에 따옴표나 접두사를 붙여 내용을 바꾸는 방식은 사용하지 않습니다.
이 거부 규칙은 CSV를 모든 앱에서 안전하게 열 수 있다는 보증이 아닙니다. 필요한 문자열이 거부된다면 이 예제의 범위를 넓히기보다 수신 시스템의 정책과 다른 전달 형식을 먼저 검토하세요. OWASP의 CSV Injection 안내에서도 스프레드시트 앱과 재저장 방식에 따라 동작이 달라질 수 있음을 설명합니다.
6. 실행 범위와 지원 한계를 확인하세요
이 예제는 일반 Transitional OOXML .xlsx의 표시 상태 일반 워크시트에서, 헤더를 포함한 3열 범위와 최대 1000개 데이터 행을 처리합니다. 입력은 10 MiB까지, ZIP 내부 총 비압축 크기는 50 MiB까지, 항목 수는 500개까지 제한했습니다. Strict OOXML, 암호화 파일, .xls·.xlsb·.xlsm·템플릿 형식은 지원하지 않습니다. 모든 Excel 기능을 판별하는 범용 변환기가 아닙니다.
openpyxl은 workbook을 파서로 읽습니다. Excel 앱을 실행하거나 원본에 저장하지 않습니다. 선택하지 않은 시트도 파서가 읽을 수 있지만, CSV에 사용하는 값은 명시한 시트와 범위뿐입니다. 통합문서를 읽는 동안 발생한 파서 경고는 비선택 시트에서 나와도 중단합니다. 내부 시트 이름이나 셀 내용을 로그에 출력하지 않습니다.
data_only=False로 수식 자체를 확인해 요청 범위의 수식을 거부합니다. data_only=True로 바꾸면 마지막으로 저장된 계산값을 읽는 동작이 되어, 수식이 없다고 잘못 판단할 수 있습니다. openpyxl load_workbook 공식 문서는 이 옵션의 의미를 설명하며, 수식 문서는 openpyxl이 수식을 계산하지 않는다고 명시합니다.
원본 SHA-256은 CSV 생성 전에 다시 비교합니다. 다만 파일을 잠그는 기능은 없으므로 실행 중 다른 프로그램에서 원본을 수정하지 않는 로컬 폴더에서 사용하세요. 네트워크 공유 폴더의 동시 수정이나 임의의 대용량·손상 파일까지 안전성을 보장하지는 않습니다.
실제 검증 환경은 Linux, Python 3.12.14, openpyxl 3.1.5입니다. 기본·좌표 이동 성공 2개와 거부 조건 35개, 총 37개 CLI 시나리오를 실행했습니다. 비선택 시트의 합성 extLst로 실제 파서 경고 1개가 발생하는 경우도 중단되는 것을 확인했습니다. 별도의 기본 단위 테스트는 1개입니다. 이 수치를 Excel 호환성 테스트 수로 해석하면 안 됩니다.
검증은 Python csv.reader의 값 왕복 대조, 원본 SHA 불변, 비선택 표식과 출력 부재 확인까지입니다. Microsoft Excel UI의 재열기·계산, Windows·macOS 실행, 실제 Excel에서 만든 Strict OOXML 파일의 호환성은 검증하지 않았습니다. 지원 형식 경계 테스트의 Strict namespace 입력은 workbook.xml namespace를 바꾼 합성 파일입니다.
공식 출처
- Python 3.12 csv 문서
- openpyxl load_workbook 문서
- openpyxl 수식 처리 문서
- Microsoft 앞자리 0 보존 안내
- OWASP CSV Injection 안내
출처 확인일: 2026년 10월 11일. 공식 문서 페이지의 표시 버전과 실습 실행 버전은 다를 수 있습니다. 실행 버전은 위에 기록한 환경을 기준으로 합니다.
작성자 소개
